
TL;DR
Google ogłosiło Gemini 4 Argon 30 września 2026 jako czołowy model do złożonych, długotrwałych przepływów pracy. Opublikowane wyniki pokazują wyraźny wzorzec: mocną wydajność w profesjonalnej pracy wiedzochłonnej, zadaniach z długim kontekstem oraz wybranych ewaluacjach inżynierii oprogramowania, przy słabszych rezultatach na niektórych benchmarkach terminalowych i „computer-use”. Google wprowadza model etapowo. Niezależnie, CometAPI raportuje dostępność w katalogu od 1 października; przed wdrożeniem należy sprawdzić uprawnienia konta i wykonać udane żądanie testowe. Bardziej użyteczna opowieść o wydajności to miejsca, w których pojawiają się zyski.
Argon osiąga 68,9% na Vals Index, 65,4% na Vals Finance Agent v2, 77,9% na DeepSWE v1.1, 91,7% na LVBench i 84,2% na GraphWalks przy kontekście 256K–1M. Jednocześnie ustępuje konkurencyjnym czołowym modelom na FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science i OSWorld-2.0.
Wyniki sprzyjają spojrzeniu na Argon przez pryzmat konkretnych obciążeń. Najsilniejsze rezultaty grupują się wokół profesjonalnej pracy wiedzochłonnej, bardzo długiego kontekstu oraz wybranych ewaluacji wielomodalnych i programistycznych. Inne modele zachowują przewagi w kilku testach terminalowych i korzystania z komputera.
Key Takeaways
- Gemini 4 Argon jest najsilniejszy w pracy wiedzochłonnej klasy enterprise, rozumowaniu w długim kontekście, rozumieniu wielomodalnym oraz kilku długohoryzontowych ewaluacjach kodowania.
- Maksymalny limit wyjścia 1 miliona tokenów zapewnia większy zapas generowania dla długich trajektorii rozumowania; nie ustanawia publicznej specyfikacji limitu kontekstu wejściowego.
- Argon prowadzi w kilku opublikowanych wynikach dotyczących pracy wiedzochłonnej i długiego kontekstu, ale GPT-6 Astra i Claude Opus 5.5 pozostają z przodu w wybranych ewaluacjach kodowania i „computer-use”.
- Wyniki benchmarków opisują konkretne konfiguracje modelu i agenta. Metryki, warunki wejścia i ustawienia oceny są równie ważne jak nagłówkowe procenty.
- Wdrożenie Google i dostęp przez CometAPI to oddzielne deklaracje dostępności. Zweryfikuj aktywną trasę, identyfikator modelu i uprawnienia konta przed migracją ruchu.
What Is Gemini 4 Argon?
Gemini 4 Argon to nowy czołowy model Gemini od Google DeepMind, zbudowany wokół trudnych przepływów pracy wymagających rozumowania przez wiele kroków zamiast odpowiedzi na jedno krótkie polecenie.
Oficjalne pozycjonowanie Google podkreśla rzeczywistą inżynierię oprogramowania, pracę wiedzochłonną w przedsiębiorstwach (np. prawo i finanse), defensywne cyberbezpieczeństwo, rozumienie wielomodalne oraz długotrwałe zadania agentowe.
To istotne odróżnienie od ostatnich wydań Flash. Gemini 3.8 Flash API w CometAPI zaprojektowano jako tańszy model roboczy dla zadań agentowych na skalę. Argon reprezentuje natomiast czołowy kraniec stosu Google, stawiając na głębię i utrzymaną realizację.
Model Specifications
| Specification | Gemini 4 Argon |
|---|---|
| Developer | Google DeepMind |
| Announced | 30 września 2026 |
| Model family | Gemini 4 |
| Positioning | Czołowe rozumowanie i model długohoryzontowy |
| Maximum output | 1,000,000 tokens |
| Long-context evaluation | Testowany w zakresie 256K–1M na GraphWalks |
| Public input context limit | Na starcie brak formalnej specyfikacji w standardowej publicznej tabeli API |
| Multimodal understanding | Tak; obejmuje wykresy, dokumenty i ewaluację długich wideo |
| Agentic coding | Tak |
| Computer use | Ewaluowany |
| Cybersecurity | Wyspecjalizowane możliwości defensywne |
| Google public API model ID | Nie ogłoszono w początkowej publicznej dokumentacji Google; CometAPI używa gemini-4-argon jako identyfikatora w katalogu. |
Output Budget and Trade-offs
Google ogłasza maksymalny limit wyjścia 1 miliona tokenów dla Argon, podnosząc go z poprzedniego limitu 64K cytowanego w ogłoszeniu startowym. Daje to zapas dla dłuższych trajektorii rozumowania. Nie należy tego interpretować jako gwarantowanego całkowitego budżetu dla całej wieloetapowej sesji agenta ani jako dowodu, że każde zadanie się poprawi.
Maksymalne wyjście to nie to samo co inteligencja. Dodatkowy budżet tokenów nie czyni modelu automatycznie bardziej zdolnym; usuwa jedno potencjalne wąskie gardło. Model nadal musi produktywnie wykorzystać ten budżet.
Istnieje też kompromis kosztów i opóźnień. Model, który rzeczywiście generuje setki tysięcy tokenów, może być drogi i wolny, nawet jeśli nominalna cena per token wygląda atrakcyjnie.

Wybrane wyniki benchmarków odtworzone z artykułu. Porównuj modele w obrębie każdego wiersza; metryki i warunki ewaluacji różnią się. Ten wykres zastępuje dekoracyjny gradient i nie stanowi niezależnego testu.
Maksymalny limit wyjścia i okno kontekstu wejściowego opisują różne możliwości. Zakres ewaluacji GraphWalks jest dowodem dotyczącym testowanych wejść, a nie substytutem publicznej specyfikacji API.
How Does Gemini 4 Argon Perform on Benchmarks?
Tabela wydajności Google DeepMind obejmuje przepływy pracy agentów, profesjonalną pracę wiedzochłonną i zadania wielomodalne. Poniższe wartości odtwarzają opublikowane porównanie. Mierzą one skuteczność zadania, a nie przepustowość tokenów czy opóźnienie odpowiedzi; „—” oznacza, że wynik nie został zgłoszony w tym porównaniu.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Evaluation conditions |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | Zbiór prywatny; tabela Zapier |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | harness mini-swe; źródła mieszane |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Tabela Proximal |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Tabela Vals AI |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | Autotest / tabela wyników |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10 h; jedna H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Limit czasu weryfikatora ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Narzędzia Linuksa; internet |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Tabela Surge |
| GraphWalks up to 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 elementów |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 elementów |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | Binarny wynik zaliczenia; ALE-Claw; 5 h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | Częściowy wynik offline; best of 3 runs |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | Bez narzędzi; tabela Surge |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | Bez narzędzi; próbkowanie klatek zależne od modelu |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4 rozstrzyga remisy |
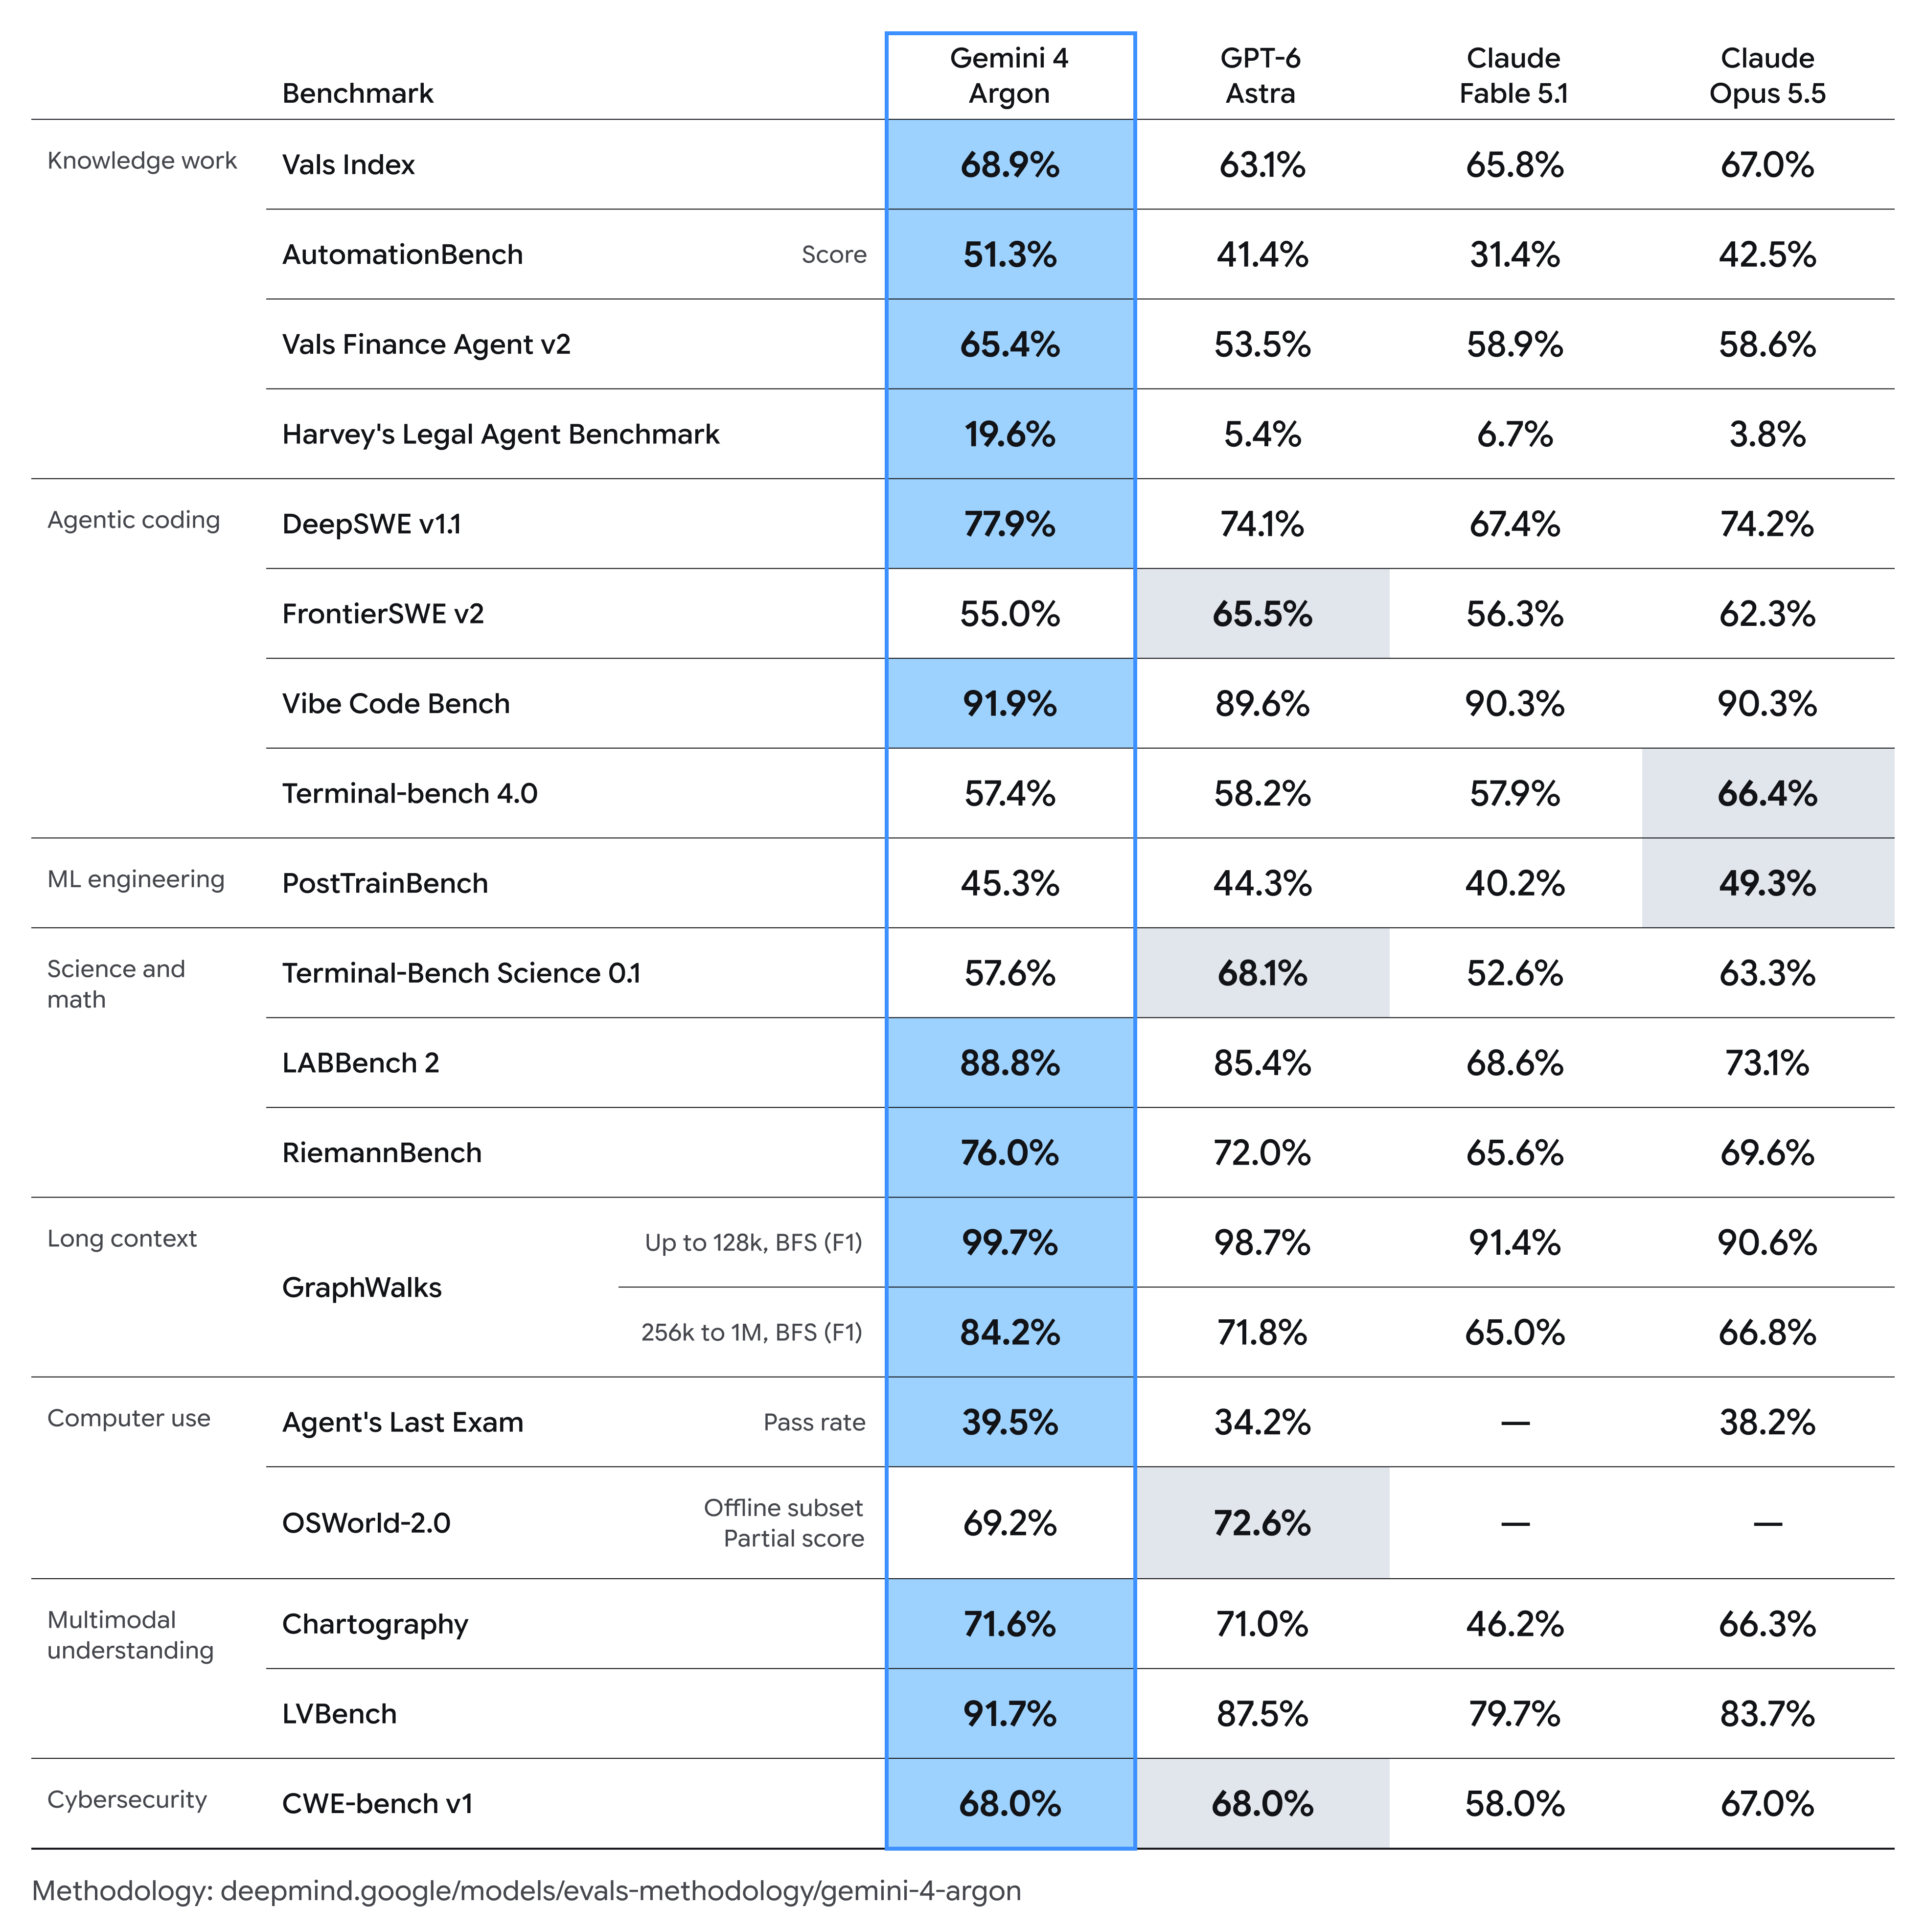
Oficjalne porównanie benchmarków Gemini 4 Argon od Google
O ile nie zaznaczono inaczej, wyniki Argon używają jednej próby i najwyższego ustawienia „myślenia”. Wyniki innych modeli pochodzą zazwyczaj z raportów dostawców, z wyjątkami specyficznymi dla benchmarków. LVBench używa 1 FPS dla Gemini, 800 klatek dla GPT-6 Astra, 300 dla Fable 5.1 i 600 dla Opus 5.5. Te wejścia nie są identyczne, więc porównuj zgłoszone konfiguracje, zamiast traktować każdy wiersz jako kontrolowaną powtórkę.
Evaluation Conditions and Limitations
Tabela jest użyteczna, ale nie należy jej interpretować jako niezależnej, uniwersalnej tabeli wyników.
- Wybór benchmarków to wybór Google.
- Ustawienia oceny specyficzne dla benchmarku różnią się między wierszami, obejmując frameworki agentów, limity czasu, narzędzia i próbkowanie wejść.
- Oficjalna metodologia wskazuje wyniki konkurentów raportowane przez dostawców jako domyślne, z wyjątkami opartymi o tabele wyników i samodzielne obliczenia.
- Najwyższe ustawienie benchmarku może nie odzwierciedlać domyślnej konfiguracji inferencji w produkcji.
- Sam nagłówkowy wynik benchmarku nie ujawnia użycia tokenów, wywołań narzędzi, ponownych prób, czasu trwania ani interwencji człowieka.
W systemach produkcyjnych lepszą metryką jest często koszt na pomyślnie ukończone zadanie, a nie cena za token czy jeden procent z tabeli.
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
Najbardziej wyrazisty wzorzec w wynikach Argon pojawia się w profesjonalnej, wieloetapowej pracy wiedzochłonnej.
Na Vals Index Argon osiąga 68,9%, w porównaniu z 67,0% dla Claude Opus 5.5. Różnica liczbowo jest umiarkowana, ale wzorzec staje się wyraźniejszy w wyspecjalizowanych przepływach pracy.
- Vals Finance Agent v2: 65,4%, o 6,5 pkt powyżej najsilniejszego konkurenta w tabeli Google.
- AutomationBench: 51,3%, o 8,8 pkt powyżej Claude Opus 5.5.
- Harvey's Legal Agent Benchmark: 19,6% w porównaniu z 6,7% dla kolejnego najwyższego zgłoszonego modelu.
Profil wydajności sugeruje, że Argon najbardziej zyskuje, gdy model musi zebrać informacje, zachować stan, rozumować przez kilka etapów i dostarczyć profesjonalny artefakt, a nie tylko odpowiedzieć na zamknięte pytanie.
Ważny jest też niski bezwzględny wynik agenta prawnego. Sam wynik 19,6% nie ujawnia, ile kryteriów czy pełnych przepływów nie zadziałało. Użyteczny wniosek jest taki, że Argon pokazuje dużą poprawę względną w tej ewaluacji, ale wynik nie ustanawia niezawodnej automatyzacji pracy prawniczej.
Long-Context Reasoning
Najbardziej uderzająca przewaga Argon może dotyczyć wersji GraphWalks 256K–1M.
- Gemini 4 Argon: 84,2%
- GPT-6 Astra: 71,8%
- Claude Opus 5.5: 66,8%
- Claude Fable 5.1: 65,0%
To przewaga 12,4 pkt nad najbliższym modelem w opublikowanym porównaniu.
Różnica jest znacznie mniejsza przy krótszych długościach kontekstu: na GraphWalks do 128K Argon ma 99,7%, a GPT-6 Astra 98,7%. Sugeruje to, że Argon degraduje się mniej gwałtownie niż porównywane modele w tej konkretnej ewaluacji bardzo długiego kontekstu.
Google nie ujawniło wystarczających informacji architektonicznych, by przypisać tę różnicę konkretnemu mechanizmowi uwagi, systemowi wyszukiwania, recepturze treningowej czy strategii w czasie inferencji. Twierdzenia typu „Gemini 4 wprowadza nową architekturę uwagi” wykraczałyby poza publiczne dowody.
Coding Performance
Oficjalna tabela benchmarków nie wspiera prostego „tak”.
Argon wypada bardzo dobrze w niektórych formach kodowania i wyraźnie przegrywa w innych. Na DeepSWE v1.1 osiąga 77,9% wobec 74,2% dla Claude Opus 5.5 i 74,1% dla GPT-6 Astra. Jego wynik w Vibe Code Bench jest również silny: 91,9%.
- FrontierSWE v2: 55,0% dla Argon vs 65,5% dla GPT-6 Astra.
- Terminal-Bench 4.0: 57,4% dla Argon vs 66,4% dla Claude Opus 5.5.
- Terminal-Bench Science 0.1: 57,6% dla Argon vs 68,1% dla GPT-6 Astra.
Ten podział jest istotny dla deweloperów. Argon wydaje się szczególnie mocny, gdy kodowanie staje się długim procesem inżynieryjnym z dużym kontekstem i planowaniem, podczas gdy zorientowane na terminal wykonanie pozostaje bardziej konkurencyjne. Benchmark migracji repozytorium i interaktywny benchmark terminalowy nie powinny być traktowane jako zamienne miary „umiejętności kodowania”.
Defensive Cybersecurity
Cyberbezpieczeństwo to kluczowy obszar wdrożeń. Pozycjonowanie Google w zakresie cyberbezpieczeństwa defensywnego obejmuje autonomiczne wykrywanie luk, walidację i łataniem. To deklaracja możliwości dostawcy; poniższy wynik CWE-bench mierzy naprawę podatności w ramach własnej ewaluacji.
Na CWE-bench v1 Argon osiąga 68%, remisując z GPT-6 Astra i nieznacznie wyprzedzając Claude Opus 5.5 z 67%.
Google podkreśla też silniejsze zabezpieczenia przed nadużyciami, pośrednim wstrzyknięciem promptów, ryzykownym zachowaniem agentów i kompromitacją środowiska wykonawczego. To sprawia, że Argon jest równie mocno wydaniem „security for agents”, co konwencjonalnym ulepszeniem modelu.
Multimodal Understanding
Argon osiąga 71,6% na Chartography i 91,7% na LVBench dla rozumienia długich wideo. Wynik na LVBench jest o 4,2 pkt wyższy niż GPT-6 Astra w tabeli Google. Ponieważ modele otrzymują różne konfiguracje próbkowania klatek, jest to porównanie zgłoszonych ustawień, a nie czysto modelowej przewagi.
Ma to znaczenie, ponieważ wiele profesjonalnych przepływów pracy nie jest wyłącznie tekstowych. Agent do badań finansowych może potrzebować przeanalizować wykres; asystent korporacyjny może łączyć raporty, PDF-y i zrzuty ekranu; system analizy wideo może musieć zachować wydarzenia w długiej sekwencji, zamiast przetwarzać pojedyncze klatki niezależnie.
Połączenie percepcji wielomodalnej i utrzymanego rozumowania w Argon jest zatem bardziej istotne niż sama obsługa modality.
Science and Mathematics Performance
Wyniki są mieszane, ale generalnie mocne. Argon osiąga 88,8% na LABBench 2 i 76,0% na RiemannBench, wyprzedzając porównane modele w tabeli Google. Jednak na Terminal-Bench Science 0.1 GPT-6 Astra osiąga 68,1% wobec 57,6% Argon.
Ta różnica wskazuje na szerszy wzorzec: Argon wydaje się silniejszy w rozumowaniu nad informacją naukową niż w każdej formie narzędziowego wykonywania zadań naukowych.
Computer-Use Performance
W Agent's Last Exam Argon uzyskuje 39,5% binarnego wskaźnika zaliczenia, przed GPT-6 Astra (34,2%) i Claude Opus 5.5 (38,2%). W offline’owym podzbiorze OSWorld-2.0 jego wynik cząstkowy to 69,2%, poniżej 72,6% GPT-6 Astra. Wartość OSWorld nie jest wskaźnikiem pełnego sukcesu zadania, a brak wpisów dla Claude nie implikuje braku możliwości.
Obecne dane nie pokazują przewagi w „computer-use” na całej linii. Do wdrożeń produkcyjnych wyniki benchmarków należy uzupełniać testami na poziomie zadań: dokładnością nawigacji, błędnymi kliknięciami, częstością ponownych prób, niezamierzonymi działaniami, czasem ukończenia i wskaźnikiem korekt przez człowieka.
Gemini 4 Argon vs GPT-6 Astra and Claude
| Dimension | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Knowledge work | Bardzo silny | Silny | Bardzo silny | Silny |
| Long-context benchmark | Najsilniejszy opublikowany wynik | Silny | Umiarkowanie silny | Umiarkowany |
| Long-horizon coding | Bardzo silny | Bardzo silny | Bardzo silny | Silny |
| Terminal coding | Konkurencyjny | Silny | Najsilniejszy w wybranym teście | Konkurencyjny |
| Scientific terminal agents | Konkurencyjny | Najsilniejszy w wybranym teście | Silny | Konkurencyjny |
| Multimodal understanding | Bardzo silny | Bardzo silny | Silny | Konkurencyjny |
| Computer use | Konkurencyjny | Silny | Mieszany / ograniczone porównanie | Ograniczone porównanie |
| Cybersecurity | Remis na szczycie w CWE-bench v1 | Remis na szczycie | Bardzo blisko | Niżej |
Argon wyróżnia się w tym porównaniu w pracy z długim kontekstem, opartej na dokumentach i profesjonalnej pracy agentów. Deweloperzy mogą porównać go z GPT-6 Astra, Claude Opus 5.5 i Claude Fable 5.1 poprzez CometAPI.
Performance-based selection
Powyższe jakościowe etykiety podsumowują wybraną tabelę benchmarków, a nie uniwersalny ranking. Preferuj Argon w pilotażu, gdy praca przypomina jego wiodące ewaluacje; przetestuj Astrę i Opusa przy obciążeniach terminalowych przed wyborem domyślnej opcji.
Specifications and deployment constraints
To porównanie wydajności nie ustanawia przewagi architektonicznej ani ogólnego zwycięzcy pod względem ceny do wydajności. Liczba parametrów i architektura Argon nie są określone w przeglądanych materiałach startowych Google. Jego publiczny limit kontekstu wejściowego wymaga oficjalnej dokumentacji API. CometAPI raportuje trasę gemini-4-argon; potwierdź obsługiwane parametry i dostęp do konta niezależnie od szerszego wdrożenia Google. Porównaj limity każdej trasy i rzeczywiste koszty zadań przed wdrożeniem.
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI raportuje model jako dostępny pod gemini-4-argon. Użyj panelu konta, aby utworzyć klucz API, wybierz ten identyfikator w playgroundzie i uruchom żądanie testowe przed integracją. Przykład zgodny z OpenAI używa bazowego URL https://api.cometapi.com/v1. Potwierdź obsługiwany endpoint i parametry w dokumentacji konta; sama plakietka w katalogu nie potwierdza udanego wywołania.
- Utwórz konto w CometAPI i wygeneruj klucz API w panelu.
- Wybierz gemini-4-argon i zweryfikuj reprezentatywne żądanie w playgroundzie.
- Skonfiguruj kompatybilnego klienta z bazowym URL CometAPI, swoim kluczem i identyfikatorem modelu; potwierdź obsługiwany schemat żądania i rozliczenia przed wdrożeniem.
CometAPI and official pricing
Google ogłosiło cenę wprowadzającą $2 za milion tokenów wejściowych i $10 za milion tokenów wyjściowych, przy buforowanym wejściu wycenionym o 95% taniej względem stawki wejściowej. Po okresie wprowadzającym ogłoszone stawki to $4 za wejście i $20 za wyjście na milion tokenów. To stawki ogłoszone przez Google, a nie ceny CometAPI ani potwierdzenie natychmiastowego, powszechnego dostępu przez publiczne API.
| Billing basis | Gemini 4 Argon API in CometAPI | Google official announcement | Comparison |
|---|---|---|---|
| Input / 1M tokens | $3.20 | $4.00 po okresie wprowadzającym | o 20% poniżej ogłoszonej stawki po okresie wprowadzającym |
| Output / 1M tokens | $16.00 | $20.00 po okresie wprowadzającym | o 20% poniżej ogłoszonej stawki po okresie wprowadzającym |
Conclusion
Profil benchmarków Gemini 4 Argon jest ciekawszy niż proste roszczenie do podium.
Najsilniejsze wyniki w tym porównaniu grupują się wokół profesjonalnej pracy wiedzochłonnej, długiego kontekstu i utrzymanej realizacji zadań agentowych. Ten wzorzec jest użyteczny przy doborze obciążeń, ale nie identyfikuje leżącej u podstaw architektury ani nie dowodzi, który mechanizm spowodował zyski.
Zgłoszone wyniki finansowe, prawne, dotyczące długich wideo i inżynierii oprogramowania wspierają ukierunkowany pilotaż dla tych obciążeń. Czy ta sama przewaga utrzyma się w produkcji, zależy od miksu wejść, frameworka agenta, ustawień inferencji i wymagań weryfikacyjnych.
Jednocześnie wyniki pokazują, że wydajność czołowych modeli staje się coraz bardziej wyspecjalizowana. Argon może prowadzić na DeepSWE, a jednocześnie ustępować na FrontierSWE; prowadzić na Agent's Last Exam, a ustępować na OSWorld; prowadzić na LABBench, a ustępować Terminal-Bench Science. Te benchmarki stresują różne części systemu agenta.
Dla deweloperów najważniejsza lekcja brzmi: wybór modelu coraz częściej musi następować na poziomie obciążenia, a nie marki czy rodziny.
FAQ
How should developers validate Gemini 4 Argon on their own workloads?
Zbuduj reprezentatywny zestaw zadań z jednoznacznymi kryteriami akceptacji. Utrzymuj porównywalne narzędzia, limity czasu, przygotowanie wejść i polityki ponownych prób między modelami. Rejestruj ukończone zadania, łączne tokeny, czas trwania i korekty człowieka. Zacznij od małego pilotażu i przeanalizuj przypadki porażek przed skierowaniem ruchu produkcyjnego.
Can Gemini 4 Argon's benchmark percentages be averaged into one score?
Nie. Tabela łączy różne metryki, w tym F1, wskaźniki zaliczenia i wyniki cząstkowe. Używaj kryteriów specyficznych dla zadania, zamiast uśredniać wszystkie procenty.
Should a Gemini 4 Argon agent always use its full output budget?
Nie. Wybierz najmniejszy przetestowany budżet, który spełnia wymagania jakości i niezawodności. Maksymalny limit wyjścia to sufit, a nie cel.
How should teams evaluate Gemini 4 Argon access through CometAPI?
Zacznij od sprawdzenia dostępności na poziomie konta i małego żądania z użyciem udokumentowanej trasy CometAPI. Zmierz jakość odpowiedzi, opóźnienia, limity i rozliczone tokeny, a następnie zastosuj te same testy akceptacyjne co dla alternatywnych modeli. Traktuj deklarację dostępu CometAPI oddzielnie od szerszego wdrożenia Google i utrzymuj konfigurowalne trasowanie, dopóki trasa nie spełni Twoich wymagań.