
TL;DR
GLM-5.3 Flash to lepszy domyślny wybór dla większości środowisk produkcyjnych: dodaje natywny input wizualny i kontekst o długości 1 mln tokenów, a jego standardowa cena katalogowa jest dramatycznie niższa. GLM-5.3 pozostaje silniejszym wyborem, gdy maksymalna głębokość kodowania, trudne rozumowanie długohoryzontalne lub wydajność w cyberbezpieczeństwie są ważniejsze niż koszt jednostkowy.
To nie jest historia „mały kontra duży model”. Flash to 320B-łącznych/18B-aktywnych MoE wytrenowany na nowej multimodalnej bazie z hybrydową uwagą rzadką i liniową. Model flagowy to 744B-łącznych/40B-aktywnych MoE, którego GLM-5.3 zyskuje dzięki skalowanemu post-trainingowi na bazie GLM-5.2.
Najważniejsze wnioski
- Wybierz Flash do multimodalnego kodowania, zrozumienia dokumentów, agentów przeglądarkowych lub GUI, automatyzacji na dużą skalę i zastosowań wrażliwych na koszt.
- Wybierz model flagowy do najtrudniejszych zadań inżynierii na poziomie repozytoriów, głębszego rozumowania wspieranego narzędziami oraz defensywnych badań bezpieczeństwa.
- Oba modele wspierają kontekst 1 mln tokenów, zawsze włączone rozumowanie, wywołania funkcji, streaming i wdrażanie z otwartymi wagami.
- Na dopasowanych benchmarkach raportowanych przez Z.ai model flagowy prowadzi w DeepSWE, NL2Repo, HLE z narzędziami i Agents’ Last Exam; Flash prowadzi w AutomationBench, Toolathlon i GDPval-AA v2.
- Niezależne testy dają modelowi flagowemu wyższy wskaźnik Intelligence Index i szybszą emisję tokenów, podczas gdy Flash ma nieco lepszy czas do pierwszego tokena i znacznie niższy koszt mieszany.
GLM-5.3 Flash vs GLM-5.3 w skrócie
| Wymiar | GLM-5.3 Flash | GLM-5.3 | Wynik praktyczny |
|---|---|---|---|
| Pozycjonowanie | Wydajny, natywnie multimodalny model do kodowania i agentów | Flagowy model do rozumowania tekstowego, kodowania, agentów długohoryzontalnych, cyberbezpieczeństwa | Zależne od obciążenia |
| Rozmiar modelu | 320B łącznie / 18B aktywnych | 744B łącznie / 40B aktywnych | Flash aktywuje o 55% mniej parametrów |
| Model bazowy | Nowo wytrenowana multimodalna baza na 30T tokenów | Ta sama baza co GLM-5.2; zyski z post-trainingu | Różne ścieżki rozwoju |
| Wejście / wyjście | Tekst + wejścia wizualne / wyjście tekstowe | Wejście tekst / wyjście tekst | Flash do przepływów wizualnych |
| Kontekst / maks. wyjście | 1M / 128K | 1M / 128K | Remis |
| Nakład rozumowania | low, high, max; rozumowanie zawsze włączone | low, high, max; rozumowanie zawsze włączone | Remis |
| Niezależny Intelligence Index | 57 | 60 przy maksymalnym wysiłku | GLM-5.3 |
| Niezależna szybkość wyjścia | 50.2 tokens/s | 76.6 tokens/s | GLM-5.3 w testowanym API |
| Oficjalna cena wej./wyj. | $0.15 / $0.50 za 1M tokenów | $1.40 / $4.40 za 1M tokenów | Flash |
| Najlepsze dopasowanie | Domyślne trasowanie, agenci multimodalni, skala | Najbardziej wymagające złożone zadania tekstowe i bezpieczeństwo | Używaj selektywnego trasowania |
Źródła: Dokumentacja modeli Z.ai oraz porównanie Artificial Analysis.
Czym jest GLM-5.3 Flash?
Z.ai pozycjonuje Flash jako pierwszy natywny model multimodalny w serii GLM-5. Ma 320B łącznych parametrów i 18B aktywnych parametrów, ale „Flash” nie należy odczytywać jako „mały”. Pełny checkpoint pozostaje bardzo dużym modelem; jego wydajność wynika z aktywowania mniejszego podzbioru ekspertów i przeprojektowania stosu uwagi.
Model bazowy został wytrenowany na multimodalnym korpusie o wielkości 30 bilionów tokenów. Natywna wizja jest zintegrowana z pętlą kodowania, co pozwala modelowi inspektować zrzuty ekranu, renderowane interfejsy, wykresy, układy stron i inne sprzężenia wizualne przed dopracowaniem kolejnego działania.
Specyfikacje GLM-5.3 Flash
| Specyfikacja | GLM-5.3 Flash |
|---|---|
| Deweloper | Z.ai / Zhipu AI |
| ID modelu | glm-5.3-flash |
| Typ modelu | Natywnie multimodalny model Mixture-of-Experts |
| Parametry łącznie / aktywne | 320B / 18B |
| Warstwy | 45 |
| Architektura | Hybrydowa uwaga rzadka + uwaga liniowa; mHC; MTP |
| Korpus treningowy | Multimodalny korpus pre-treningowy 30T tokenów |
| Modalności wejścia | Wejścia tekstowe i wizualne, w tym obrazy oraz wspierane przepływy wideo/pliki |
| Modalność wyjścia | Tekst |
| Kontekst / maks. wyjście | 1M / 128K tokenów |
| Rozumowanie | Zawsze włączone; low, high, max |
| Narzędzia | Wywołania funkcji, strumieniowe wywołania narzędzi, ustrukturyzowane przepływy |
| Wagi / licencja | Otwarte wagi; Apache-2.0 w oficjalnym repozytorium |
Źródła: Dokumentacja Flash Z.ai oraz oficjalne repozytorium GLM-5.
Czym jest GLM-5.3?
Model flagowy jest zoptymalizowany pod kątem złożonej inżynierii oprogramowania, agentów długohoryzontalnych i cyberbezpieczeństwa. Z.ai podaje, że korzysta z tej samej bazy co GLM-5.2; ulepszenie pochodzi ze skalowanego post-trainingu, a nie z nowego pre-trainingu.
Oficjalne repozytorium podaje checkpoint o 744B łącznych parametrach i 40B aktywnych. W porównaniu z Flash aktywuje ponad dwukrotnie więcej parametrów na token i przydziela więcej pojemności najtrudniejszemu, wieloetapowemu rozumowaniu.
Specyfikacje GLM-5.3
| Specyfikacja | GLM-5.3 |
|---|---|
| Deweloper | Z.ai / Zhipu AI |
| ID modelu | glm-5.3 |
| Typ modelu | Flagowy tekstowy model Mixture-of-Experts |
| Parametry łącznie / aktywne | 744B / 40B |
| Model bazowy | Baza GLM-5.2; wszystkie zyski GLM-5.3 z post-trainingu |
| Wejście / wyjście | Tekst / tekst |
| Kontekst / maks. wyjście | 1M / 128K tokenów |
| Rozumowanie | Zawsze włączone; low, high, max |
| Narzędzia | Wywołania funkcji, strumieniowe wywołania narzędzi, cache kontekstu, ustrukturyzowane wyjście |
| Główny fokus | Złożone kodowanie, agenci długohoryzontalni, inżynieria, cyberbezpieczeństwo |
| Wagi / licencja | Otwarte wagi na osobnej licencji GLM-5.3; kod repozytorium wspierającego na Apache-2.0 |
Źródła: dokumentacja flagowca Z.ai i oficjalne repozytorium GLM-5.
Architektura: dlaczego Flash jest tańszy, nie będąc małym
Flash przeplata bloki uwagi liniowej z blokami uwagi rzadkiej i używa mHC wokół komponentów uwagi i MoE. Mechanizm IndexPool kompresuje cztery wektory kluczy indeksujących do jednego. Z.ai raportuje 3,01× niższy koszt obliczeń uwagi na warstwę i 4,44× mniejszy cache KV na warstwę niż w modelu flagowym przy sekwencji o długości 1 mln tokenów.
To porównania na poziomie architektury, a nie gwarantowane mnożniki opóźnień end-to-end. Rzeczywista szybkość API zależy także od sprzętu, kwantyzacji, batchingu, długości rozumowania, oprogramowania serwującego i obciążenia dostawcy.
Hybrydowa architektura uwagi GLM-5.3-Flash oraz porównanie obliczeń/cache dla długiego kontekstu.
Źródło: oficjalna dokumentacja architektury Z.ai
Wydajność w benchmarkach: gdzie który model wygrywa
Najczystsze porównanie oddziela benchmarki vendorowe od niezależnych pomiarów API. Nawet gdy nazwy benchmarków się pokrywają, wersje harnessów, konfiguracje narzędzi, zarządzanie kontekstem i poziom wysiłku rozumowania mogą się różnić. Poniższa tabela wykorzystuje najbliżej dopasowane wartości z ewaluacji flagowca i ewaluacji Flash, traktując niewielkie luki jako kierunkowe, a nie definitywne.
| Benchmark | GLM-5.3 Flash | GLM-5.3 | Wyższy wynik | Co testuje |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 88.2 | GLM-5.3 | Kodowanie terminalowe i agentowe |
| DeepSWE v1.1 | 63.4 | 66.9 | GLM-5.3 | Inżynieria oprogramowania |
| NL2Repo | 56.3 | 58.0 | GLM-5.3 | Generowanie repozytoriów |
| Toolathlon Verified | 78.4 | 73.0 | Flash | Użycie narzędzi |
| AutomationBench | 48.8 | 48.2 | Remis / Flash | Automatyzacja obsługi komputera |
| Agents’ Last Exam | 26.3 | 28.5 | GLM-5.3 | Rozumowanie agentów długiego horyzontu |
| HLE with tools | 55.3 | 62.5 | GLM-5.3 | Trudne rozumowanie z narzędziami |
| GDPval-AA v2 | 1773 Elo | 1769 Elo | Remis / Flash | Profesjonalna praca wiedzoznawcza |
Źródła: ewaluacja flagowca i Flash. Porównuj kierunkowo, ponieważ ustawienia ewaluacji mogą się różnić.
Kodowanie i inżynieria repozytoriów
Model flagowy ma wyższy sufit wydajności. Wyprzedza Flash o 3,5 pkt w DeepSWE i 1,7 pkt w NL2Repo. Na Z.ai Code Bench v1.0, przy ewaluacji obu modeli z Claude Code 2.1.207, flagowiec osiąga 34,5% przy maksymalnym wysiłku, podczas gdy Flash osiąga 29,0% — przewaga 5,5 pkt.
Flash pozostaje jednak wystarczająco konkurencyjny, by być pierwszym testowanym modelem do rutynowej konserwacji repozytoriów, generowania testów, debugowania, refaktoryzacji i wysokowolumenowych agentów kodujących. Eskaluj tylko najtrudniejsze zadania lub nieudane trajektorie do modelu flagowego.
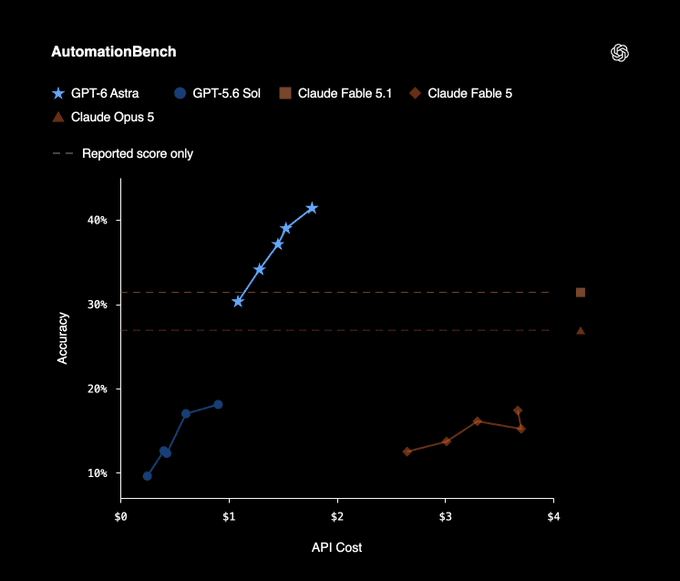
Sześciobenchmarkowa ewaluacja GLM-5.3-Flash Z.ai oraz innych modeli do kodowania/agentów.
Źródło: oficjalna dokumentacja Flash Z.ai
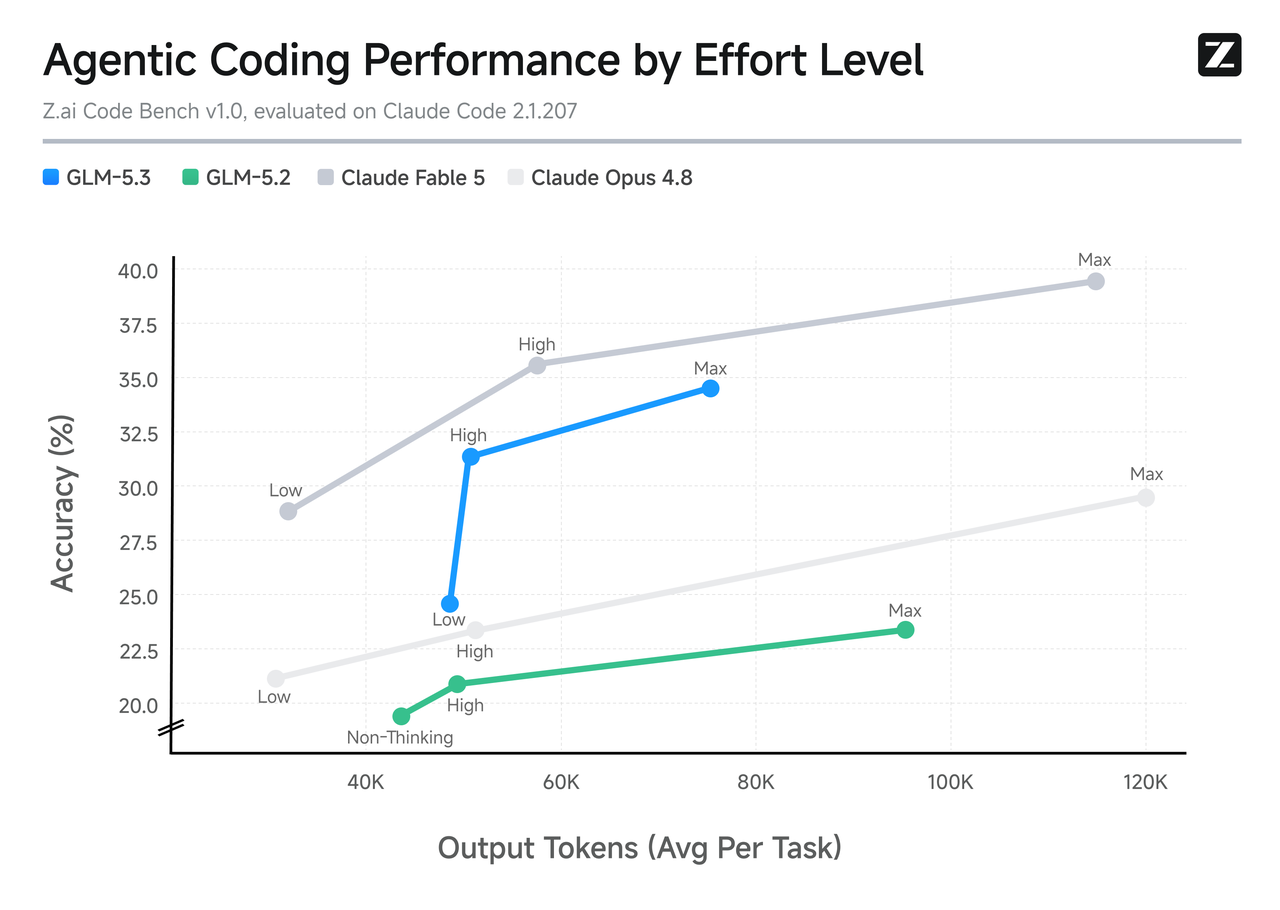
Dokładność kodowania agentowego GLM-5.3 i użycie tokenów wyjściowych na różnych poziomach wysiłku rozumowania.
Źródło: oficjalna dokumentacja flagowca Z.ai
Użycie narzędzi, automatyzacja i praca wiedzoznawcza
Flash nie jest jednolicie słabszy. Uzyskuje 78.4 w Toolathlon Verified wobec 73.0 dla flagowca i minimalnie wygrywa w AutomationBench 48.8 do 48.2. Jest zasadniczo remisowy w GDPval-AA v2. To czyni Flash szczególnie atrakcyjnym, gdy zadanie mniej polega na jednej skrajnie trudnej ścieżce rozumowania, a bardziej na niezawodnej koordynacji narzędzi w wielu tanich żądaniach.
Inteligencja, szybkość i latencja w niezależnych pomiarach
| Niezależny pomiar | GLM-5.3 Flash | GLM-5.3 (max) | Wynik |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 57 | 60 | GLM-5.3 |
| Szybkość wyjścia | 50.2 tokens/s | 76.6 tokens/s | GLM-5.3 |
| Czas do pierwszego tokena | 1.49 s | 1.61 s | Flash |
| Okno kontekstu | 1M | 1M | Remis |
| Cena mieszana w porównaniu AA | $0.10 / 1M tokenów | $0.90 / 1M tokenów | Flash |
Źródło: dopasowane porównanie API Artificial Analysis.
Wynik niezależny dodaje ważną korektę do założenia „Flash znaczy szybszy”. Flash odpowiada nieco szybciej na początku, ale testowany endpoint flagowca generuje tokeny szybciej po rozpoczęciu wyjścia. Traktuj te pomiary jako migawki specyficzne dla dostawcy, a nie niezmienne właściwości modeli.
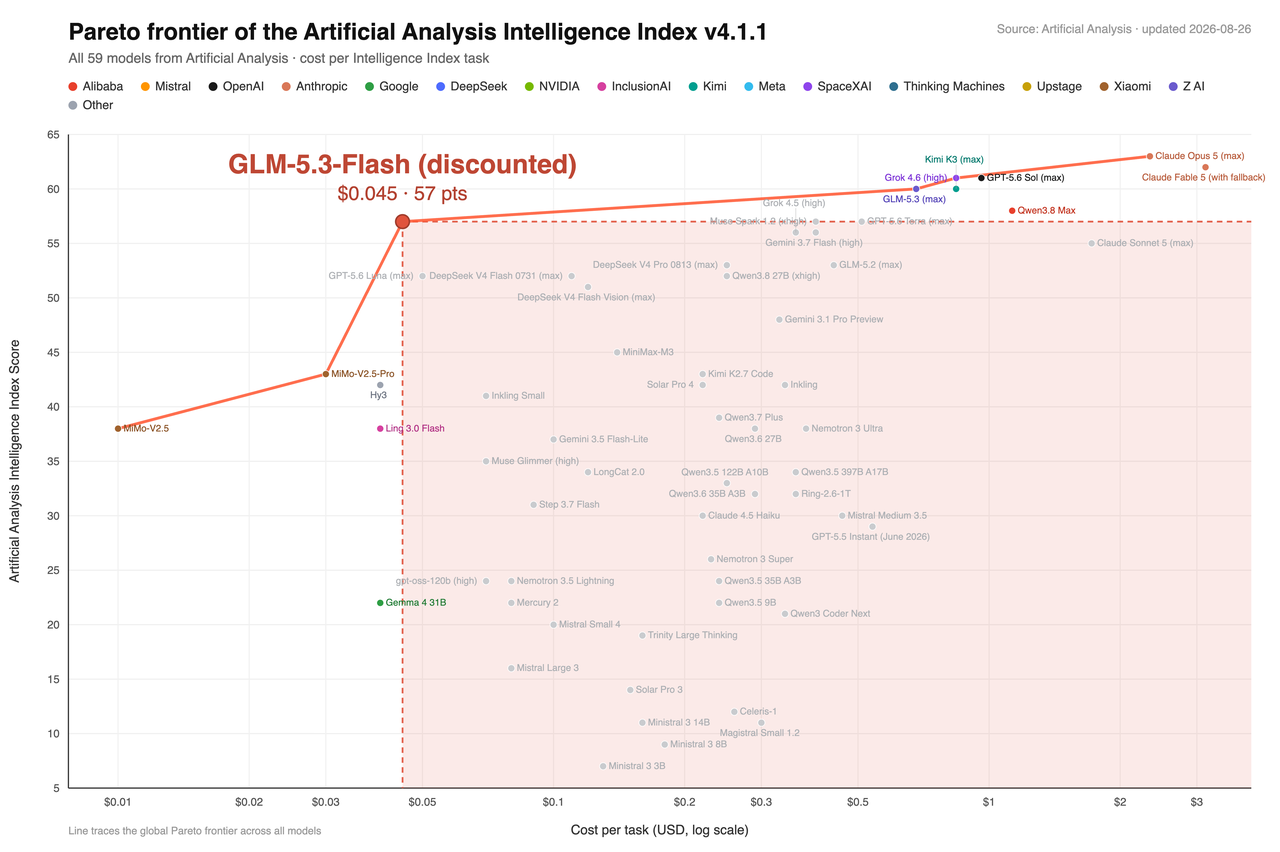
Granica koszt–inteligencja Artificial Analysis odtworzona w oficjalnej dokumentacji Flash Z.ai.
Źródło: oficjalna dokumentacja Flash Z.ai
Multimodalność: Flash ma wyraźną przewagę
Flash akceptuje wejścia wizualne i integruje je z agentowymi przepływami pracy. Może inspektować zrzuty ekranu, obrazy stron, wykresy, stany interfejsów, nagrania ekranu i wspierane pliki, a następnie wykorzystać dowody wizualne podczas kodowania lub obsługi narzędzi. Model flagowy obecnie wspiera tylko input tekstowy.
- Frontend i design-to-code: Flash może inspektować referencyjny zrzut ekranu i weryfikować wyrenderowaną implementację.
- Dokumenty i Office: Flash rozumie strukturę strony, wykresy, układ i rozmieszczenie obrazów.
- Przeglądarka i obsługa komputera: Flash łączy stan wizualny z wywołaniami narzędzi i iteracyjnymi korektami.
- Praca w repozytorium tekstowym: model flagowy pozostaje preferowany, gdy wejściem jest kod i tekst oraz gdy zadanie wymaga maksymalnej głębokości rozumowania.
Długi kontekst i kontrola rozumowania
GLM-5.3 Flash obsługuje okno kontekstu 1 mln tokenów i do 128K tokenów wyjściowych; GLM-5.3 zapewnia te same limity. Oba utrzymują włączone rozumowanie i akceptują poziomy low, high i max. Z.ai rekomenduje max dla trudnego kodowania i reprodukcji benchmarków.
Pojemność kontekstu nie jest więc głównym wyróżnikiem. Różnica polega na tym, jak ekonomicznie każdy model obsługuje długie sekwencje i jaką pojemność rozumowania może wnieść do najtrudniejszych zadań. Flash jest architektonicznie tańszy przy długim kontekście; flagowiec ma silniejszy sufit jakości.
Cyberbezpieczeństwo: GLM-5.3 to specjalista
Cyberbezpieczeństwo to najbardziej wyróżniająca się kompetencja flagowca. Z.ai raportuje 84.5 w CyberGym i 54.4 w ExploitBench. Przy znormalizowanych budżetach dwóch i sześciu godzin ukończył odpowiednio 105 i 130 zadań ExploitGym.
Flash nie ma równoważnego nacisku na starcie ani dopasowanego publicznego zestawu cyber. Do przeglądu kodu, bezpiecznego developmentu i autoryzowanego wykrywania podatności używaj flagowca jako głównego modelu, a w przepływie utrzymuj zatwierdzanie przez człowieka, izolowane narzędzia, dzienniki audytowe i kontrolę ujawnień.
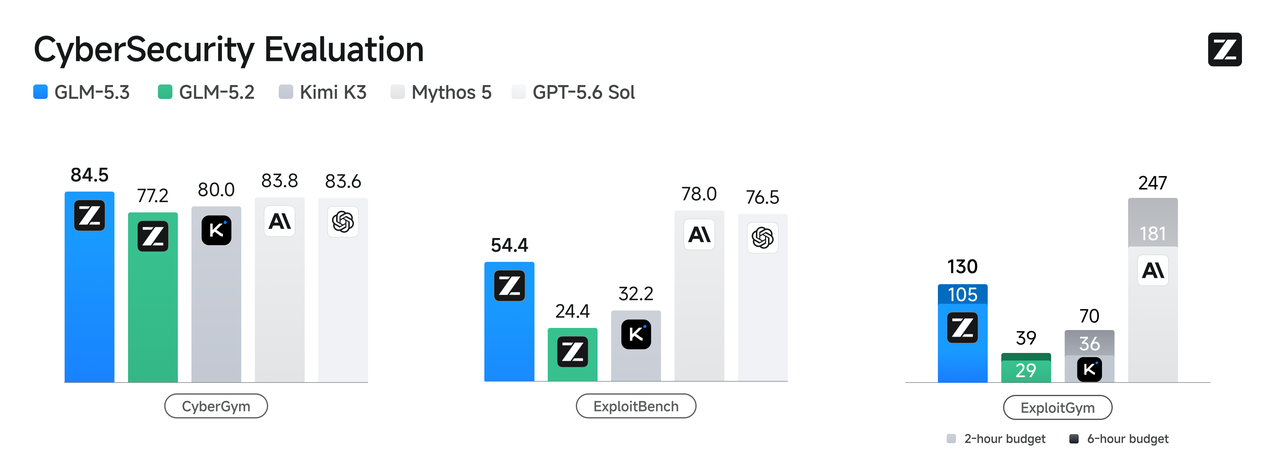
Wydajność GLM-5.3 w zakresie wykrywania podatności i benchmarków eksploatacyjnych.
Źródło: oficjalna dokumentacja cyberbezpieczeństwa Z.ai
Koszt i wdrożenie
Cennik API
Z.ai wycenia Flash na $0.15 za milion tokenów wejściowych i $0.50 za milion tokenów wyjściowych przed promocjami, w porównaniu z $1.40 i $4.40 dla flagowca.
| Ścieżka dostępu | Wejście Flash | Cache Flash | Wyjście Flash | Wejście 5.3 | Cache 5.3 | Wyjście 5.3 |
|---|---|---|---|---|---|---|
| Standardowa lista Z.ai | $0.15 | $0.03 | $0.50 | $1.40 | $0.26 | $4.40 |
| Promocyjna stawka Flash Z.ai | $0.075 | $0.015 | $0.25 | $1.40 | $0.26 | $4.40 |
| Ścieżka CometAPI | $0.06 | Sprawdź na żywo | $0.20 | $1.12 | Sprawdź na żywo | $3.528 |
Ceny w USD za 1M tokenów. Źródła: cennik Z.ai, trasa Flash i trasa GLM-5.3. Promocje mogą się zmieniać.
Przykładowy miesięczny koszt
Dla obciążenia zużywającego 100M tokenów wejścia i 20M tokenów wyjścia, bieżące stawki CometAPI dają szacunkowo $10.00 dla Flash kontra $182.56 dla flagowca, przed efektami cache lub opłatami za narzędzia. Flash redukuje rachunek za tokeny o około 94,5% w tym przykładzie.
| Składnik kosztu | GLM-5.3 Flash | GLM-5.3 |
|---|---|---|
| Koszt wejścia | 100 × $0.06 = $6.00 | 100 × $1.12 = $112.00 |
| Koszt wyjścia | 20 × $0.20 = $4.00 | 20 × $3.528 = $70.56 |
| Razem | $10.00 | $182.56 |
Otwarte wagi i self-hosting
Oba modele mają dostępne do pobrania checkpointy FP8 i BF16. Wagi GLM-5.3 Flash są wydane na licencji MIT. GLM-5.3 używa osobnej licencji GLM-5.3, która wymaga przeglądu bezpieczeństwa przed komercyjnym użyciem przez operatorów Model-as-a-Service, których łączny przychód przekracza 10 mld USD w dowolnych kolejnych 12 miesiącach. Wspierające repozytorium GLM-5 na GitHubie jest licencjonowane na Apache-2.0.
Flash jest łatwiejszy do serwowania niż flagowiec, ale nie jest modelem na GPU konsumenckie. Checkpoint 320B, komponenty multimodalne, cache KV i kontekst 1M wciąż wymagają poważnej infrastruktury. Self-hosting jest najbardziej atrakcyjny, gdy kontrola danych, niestandardowe serwowanie lub utrzymane wysokie wykorzystanie uzasadniają koszt operacyjny.
Który model wybrać?
Wybierz GLM-5.3 Flash, jeśli:
- Potrzebujesz zrozumienia obrazów, zrzutów ekranu, wykresów, dokumentów, przeglądarki lub GUI.
- Prowadzisz wysokowolumenowych agentów kodujących, przepływy badawcze lub automatyzację biznesową.
- Chcesz silnego użycia narzędzi i wydajności w pracy wiedzoznawczej przy najniższym koszcie tokena.
- Potrzebujesz okna kontekstu 1M, ale nie chcesz ekonomiki flagowca przy każdym żądaniu.
- Planujesz self-hosting i 320B/18B jest bardziej praktyczne niż 744B/40B.
Wybierz GLM-5.3, jeśli:
- Rozwiązujesz najtrudniejsze zadania inżynierii na poziomie repozytoriów lub długohoryzontalne zadania inżynierskie.
- Twoja ewaluacja nagradza głębsze rozumowanie bardziej niż niski koszt jednostkowy.
- Potrzebujesz silniejszego wyniku w DeepSWE, HLE z narzędziami lub Agents’ Last Exam.
- Budujesz autoryzowane przepływy defensywnego bezpieczeństwa lub wykrywania podatności.
- Wyższy odsetek sukcesów może zrównoważyć około rząd wielkości wyższą cenę tokena.
Matryca decyzji wg przypadku użycia
| Obciążenie | Rekomendowany model startowy | Dlaczego |
|---|---|---|
| Chat i automatyzacja na dużą skalę | GLM-5.3 Flash | Znacznie niższy koszt; silne użycie narzędzi |
| Kodowanie wizualne i debugowanie UI | GLM-5.3 Flash | Natywny input wizualny |
| Analiza dokumentów, wykresów i Office | GLM-5.3 Flash | Multimodalne profesjonalne przepływy |
| Rutynowa konserwacja repozytoriów | Start z Flash | Eskaluj niepowodzenia lub nietypowo trudne zadania |
| Trudna inżynieria na poziomie repozytorium | GLM-5.3 | Wyższy sufit kodowania |
| Długohoryzontalne badania z narzędziami | GLM-5.3 | Silniejszy wynik HLE z narzędziami |
| Bezpieczeństwo defensywne i wykrywanie podatności | GLM-5.3 | Dedykowany trening i benchmarki cyber |
| Self-hosting wrażliwy na koszty | GLM-5.3 Flash | Mniejszy aktywny i łączny ślad |
| Niepewne mieszane obciążenie | Trasowanie hybrydowe | Flash domyślnie; eskalacja do flagowca |
Lepsza strategia produkcyjna: trasuj, nie zastępuj
Dla większości zespołów najsilniejszym projektem nie jest wybór wyłączny. Używaj Flash jako domyślnej trasy, a następnie eskaluj tylko zadania o wysokiej złożoności, niezdane walidacje, wrażliwe bezpieczeństwo lub oczekiwaną wartość ekonomiczną, która uzasadnia premię flagowca.
- Kieruj zadania wizualne, rutynowe i wysokowolumenowe do Flash.
- Mierz współczynnik akceptacji, tokeny, latencję, awarie narzędzi i interwencje człowieka.
- Eskaluj nieudane lub wysokiego ryzyka zadania tekstowe do flagowca.
- Trasuj prace wrażliwe bezpieczeństwem przez dodatkowe autoryzacje i kontrolowane sandboxy.
- Optymalizuj koszt na zaakceptowany wynik, a nie tylko ranking benchmarków czy cenę.
Jak testować oba modele przez CometAPI
CometAPI wystawia trasę GLM-5.3 Flash i trasę GLM-5.3 za tym samym bazowym URL kompatybilnym z OpenAI. Utwórz klucz API, a następnie uruchom to samo zadanie tekstowe dla obu ID modeli. Dla uczciwego testu utrzymaj stałe: prompt, poziom wysiłku rozumowania, definicje narzędzi, maksymalne wyjście i rubrykę akceptacji.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Przejrzyj ten plan migracji i wskaż trzy najbardziej ryzykowne założenia.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Dla ewaluacji multimodalnej użyj dokumentacji live trasy Flash, aby zweryfikować wspierany schemat treści obrazów. Porównanie z flagowcem powinno używać odpowiednika wyłącznie tekstowego, ponieważ nie akceptuje on inputu wizualnego.
Ograniczenia tego porównania
- Kilka wyników kodowania i agentów pochodzi od dostawcy. Niezależna reprodukcja może używać innych narzędzi, promptów i ustawień inferencji.
- Dopasowane nazwy benchmarków nie zawsze gwarantują identyczne wersje harnessów lub strategie zarządzania kontekstem.
- Redukcje obliczeń uwagi i cache KV na poziomie architektury nie przewidują bezpośrednio latencji API.
- Ceny, promocje, dostępność modeli, limity i możliwości tras mogą się zmieniać; weryfikuj live strony modeli przed wdrożeniem.
- Otwarte wagi nie czynią żadnego checkpointu tanim w self-hostingu przy pełnym kontekście.
- Zdolności cyberbezpieczeństwa mają charakter dual-use i wymagają autoryzacji, sandboxów, logowania, ekspertyzy i odpowiedzialnego ujawniania.
Konkluzja
GLM-5.3 Flash to praktyczny domyślny wybór. Zachowuje długi kontekst, dodaje natywną wizję, osiąga silne wyniki w użyciu narzędzi i pracy zawodowej oraz na tyle zmienia ekonomikę, by wspierać znacznie szersze wdrożenia. GLM-5.3 to model eskalacyjny–specjalista: droższy, tylko tekstowy, ale silniejszy w najtrudniejszych zadaniach kodowania, rozumowania i cyberbezpieczeństwa.
Ostateczny werdykt jest więc zależny od obciążenia: zacznij od Flash, mierz realny współczynnik akceptacji i trasuj do flagowca tylko wtedy, gdy jego dodatkowa pojemność rozumowania przynosi tyle dodatkowych udanych wyników, by uzasadnić premię.
Najczęściej zadawane pytania
Czy GLM-5.3 Flash jest lepszy niż GLM-5.3?
Nie uniwersalnie. Flash jest lepszy pod kątem ceny, multimodalności i kilku benchmarków narzędzi/automatyzacji. Flagowiec jest silniejszy w najtrudniejszych zadaniach kodowania, rozumowania z narzędziami i cyberbezpieczeństwa.
Czy GLM-5.3 Flash to mały model?
Nie. Ma 320B łącznych parametrów i aktywuje 18B na token. Jest bardziej wydajny niż flagowiec 744B/40B, ale nadal wymaga znaczącej infrastruktury do self-hostingu.
Który model jest tańszy?
Flash jest dramatycznie tańszy. Standardowa cena katalogowa Z.ai to około jedna dziesiąta ceny flagowca, a obecne trasy CometAPI pokazują jeszcze większą różnicę przy aktywnych promocjach.
Który model jest szybszy?
To zależy od metryki i dostawcy. Artificial Analysis zmierzył nieco niższy czas do pierwszego tokena dla Flash, ale wyższą szybkość generacji dla flagowca.
Który model wspiera obrazy?
Flash wspiera natywny input wizualny. Flagowiec obecnie wspiera wyłącznie input tekstowy.
Czy oba modele wspierają kontekst 1 mln tokenów?
Tak. Flash wspiera kontekst 1M i do 128K wyjścia; flagowiec zapewnia te same limity.
Który model jest lepszy do kodowania?
Używaj Flash do rutynowych i wysokowolumenowych agentów kodujących. Używaj flagowca do najtrudniejszych zadań inżynierii na poziomie repozytoriów lub gdy koszt porażki przewyższa różnicę w cenie.
Który model jest lepszy do cyberbezpieczeństwa?
Flagowiec. Z.ai specyficznie trenował i ewaluował go pod kątem wykrywania podatności i rozumowania nad łańcuchami eksploatacji. Używaj tylko w autoryzowanych, kontrolowanych środowiskach.
Czy oba modele można self-hostować?
Tak. Repozytorium Z.ai listuje checkpointy do pobrania i wspierane frameworki serwujące, ale oba pozostają dużymi projektami infrastrukturalnymi.
Jaka jest najlepsza strategia wdrożenia?
Używaj Flash jako domyślnej trasy i eskaluj trudne, nieudane lub wrażliwe bezpieczeństwem zadania tekstowe do flagowca. Mierz koszt na zaakceptowany wynik.