
Aktualizacja wydania Grok 4.7: od prognoz do oficjalnej dostępności
Informacje zweryfikowane: 16 października 2026 r.
Grok 4.7 został oficjalnie wydany 21 września 2026 r. Wcześniejsze odniesienia do premiery 12 września były szacunkami przedpremierowymi i nie powinny być traktowane jako faktyczna data wydania.
Oficjalne ogłoszenie premiery opisuje ulepszenia w zakresie kodowania, pracy z wiedzą, dłużej działających zadań oraz weryfikacji własnych wyników modelu. Potwierdza dostępność poprzez Grok API, Cursor i Grok Build. Aby poznać dokładny identyfikator modelu w API, wspierane funkcje, limity kontekstu i bieżące ceny, skonsultuj oficjalną dokumentację Grok 4.7.
Oficjalne wyniki pokazują wymierny postęp względem Grok 4.6. Na przykład porównanie w dniu premiery raportuje wynik Terminal-Bench 4.0 na poziomie 37.6% dla Grok 4.7 przy wysiłku xhigh, w porównaniu z 20.3% dla Grok 4.6 przy wysiłku high. Są to wyniki zgłoszone przez dostawcę w zadeklarowanych ustawieniach ewaluacyjnych; wydajność w aplikacjach zależeć będzie od promptów, narzędzi, wysiłku rozumowania i trudności zadania.
Źródło: Oficjalne ogłoszenie wydania Grok 4.7.
Najważniejsze wnioski
- Oczekiwana data 12 września została wywnioskowana z dziesięciodniowego odliczania Muska, a nie z osobno opublikowanego kalendarza xAI.
- Deklaracje o skali 2.1T i danych SpaceX pochodzą z okresu przed premierą; aktywne parametry, routing, architektura i metoda treningu pozostają nieopublikowane.
- Grok 4.6 już wykazuje silne wyniki w pracy z wiedzą i trybach agentowych, w tym 61.3% na FrontierCode v1.1 (Extended), ale ustępuje na kilku trudnych benchmarkach kodowania względem najmocniejszego modelu porównawczego.
- Grok 4.7 należy oceniać poprzez odsetek przyjętych zadań, niezawodność w długim horyzoncie, efektywność tokenową, opóźnienia i koszt na udany wynik — a nie wyłącznie liczbę parametrów.
- CometAPI zintegruje Grok 4.7, gdy tylko xAI oficjalnie udostępni model i produkcyjny endpoint; deweloperzy powinni mimo to zweryfikować na żywo identyfikator modelu, cenę i zachowanie odpowiedzi przed migracją.
Czym jest Grok 4.7?
Grok 4.7 to zapowiedziany następca Grok 4.6 i oczekuje się, że będzie kontynuować nacisk xAI na kodowanie, inżynierię, długotrwałe agentowe procesy oraz profesjonalną pracę z wiedzą. Obecne dowody publiczne składają się głównie z wypowiedzi założycieli i odliczania do premiery, a nie pełnego pakietu technicznego startu.
Najważniejsze jest rozróżnienie trzech obiektów: zapowiedzianego modelu Grok 4.7, sygnałów przedpremierowych opisujących jego możliwą skalę i trening oraz działającej produkcyjnej bazy Grok 4.6. Deweloperzy powinni traktować Grok 4.7 jako kandydata do ewaluacji aż do momentu, gdy xAI opublikuje finalną dokumentację i gdy produkcyjne żądanie zakończy się sukcesem na wydanym endpointcie.
Data wydania Grok 4.7 i oś czasu
Kiedy Grok 4.7 ma zostać wydany?
Wrześniowa wypowiedź Muska z dnia 2, że model pojawi się za dziesięć dni, wskazuje na około 12 września 2026 r.
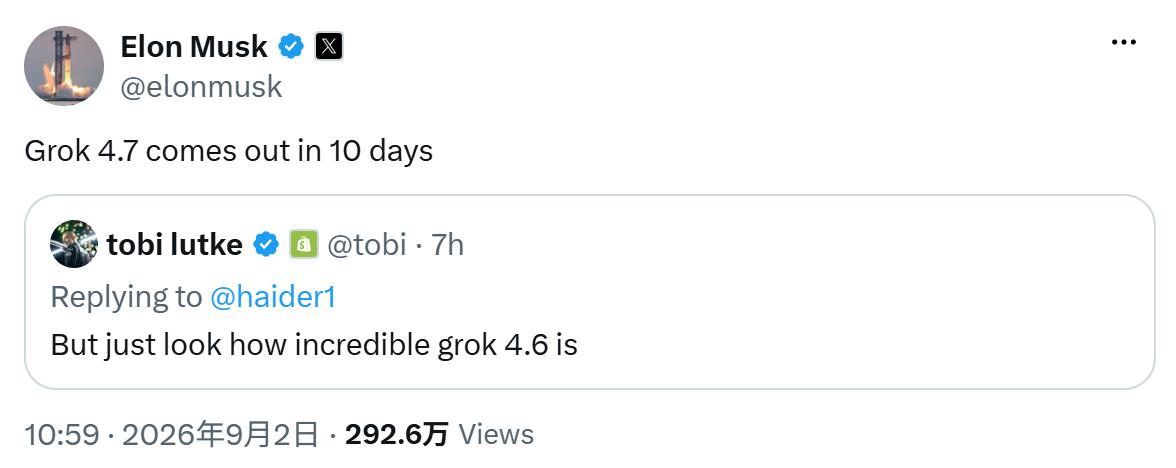
Źródło: Elon Musk na X, 2 września 2026 r.
Oś czasu wydania Grok 4.7
| Data | Sygnał publiczny | Interpretacja |
|---|---|---|
| Koniec lipca 2026 | Musk opisał model o skali około 2.1T, poprawioną efektywność tokenową i nieco wolniejsze serwowanie. | Oczekiwania co do skali i efektywności, zadeklarowane przez założyciela. |
| 12 sierpnia 2026 | Opisano zakończenie wstępnego treningu; trening uzupełniający miał obejmować znaczące dane firmowe SpaceX. | Aktualizacja postępu treningu, nie potwierdzenie wydania. |
| 2 września 2026 | „Grok 4.7 wyjdzie za 10 dni.” | Jak dotąd najjaśniejsze publiczne odliczanie do premiery. |
| 12 września 2026 | Data kalendarzowa wyprowadzona z odliczania. | Oczekiwany cel; finalna dostępność wymaga ogłoszenia xAI i działającego endpointu. |
Specyfikacja Grok 4.7: informacje potwierdzone vs niepotwierdzone
Najbardziej użytecznym sposobem czytania obecnych informacji o Grok 4.7 jest oddzielenie bezpośrednich wypowiedzi założyciela od specyfikacji, których xAI nie opublikowało. Nowy wpis potwierdza jedynie nazwę modelu i odliczanie do premiery; nie dodaje parametrów technicznych ani wyników benchmarków.
| Specyfikacja | Obecny status Grok 4.7 | Poziom wiarygodności |
|---|---|---|
| Termin wydania | Około 12 września, wywnioskowane z dziesięciodniowego odliczania 2 IX | Cel ogłoszony przez założyciela |
| Skala modelu | Około 2.1T parametrów | Deklaracja założyciela |
| Trening wstępny | Opisany jako zakończony do 12 sierpnia | Deklaracja założyciela |
| Trening uzupełniający | Obejmuje znaczące dane firmowe SpaceX | Deklaracja założyciela |
| Jakość względna | Deklarowana znaczna poprawa względem Grok 4.6 | Niezweryfikowane twierdzenie |
| Efektywność tokenowa | Deklarowana poprawa względem Grok 4.6 | Niezweryfikowane twierdzenie |
| Prędkość serwowania | Oczekiwane nieco wolniejsze działanie | Deklaracja założyciela |
| Okno kontekstu | Nieopublikowane przez xAI | Nieznane |
| Modalności we/wy | Nieopublikowane przez xAI | Nieznane |
| Finalny ID modelu w API | Niepotwierdzony w dokumentacji xAI | Nieznane |
| Oficjalne ceny | Nieopublikowane przez xAI | Nieznane |
| Oficjalne benchmarki | Brak opublikowanych dla Grok 4.7 | Nieznane |
Twierdzenie o około 2.1T parametrach nie ujawnia aktywnych parametrów, rzadkości, routingu ekspertów, kosztu inferencji ani efektywnego nakładu obliczeń treningowych. Sama liczba parametrów nie może przesądzać o jakości produkcyjnej.
Dlaczego sygnał o szkoleniu na danych SpaceX może mieć większe znaczenie niż 2.1T
Bardziej istotnym ujawnieniem może być uzupełnienie danymi firmowymi SpaceX. Wysokiej jakości korpus inżynieryjny mógłby poprawić rozumowanie techniczne, projektowanie, debugowanie, optymalizację i pracę agentów w długim horyzoncie, gdzie dystrybucja zadań i jakość potreningowa często znaczą więcej niż sama skala.
Ten kierunek jest spójny ze strategią wydanych modeli xAI. Raport treningu Grok 4.6 opisuje dłuższy przebieg treningu uzupełniającego z wysokiej jakości danymi inżynieryjnymi, po którym nastąpiło nadzorowane dostrajanie i uczenie przez wzmocnienie obejmujące kodowanie, STEM, web development, optymalizację jąder i projektowanie wspomagane komputerowo.
To sprawia, że twierdzenie dotyczące Grok 4.7 jest technicznie plausybilne, lecz nie udowodnione. Realna przewaga powinna stać się widoczna po wydaniu, w odtwarzalnych testach inżynieryjnych, wskaźnikach ukończenia zadań, opóźnieniach oraz koszcie na udany wynik.
Grok 4.7 vs Grok 4.6: co pokazuje punkt odniesienia
Brak jeszcze oficjalnych wyników Grok 4.7. Odpowiednim punktem porównawczym jest opublikowana przez xAI ewaluacja Grok 4.6. Pełny przegląd modelu znajduje się w szczegółowym opisie Grok 4.6 w CometAPI; tabela poniżej zachowuje jedynie najistotniejsze dla decyzji wiersze benchmarków.
| Oficjalny benchmark | Grok 4.6 High | Grok 4.5 High | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54.0% | 73.0% | 70.0% |
| FrontierCode v1.1 (Extended) | 61.3% | 56.6% | 60.6% | 63.6% |
| Terminal-Bench v3.0 | 26.0% | 15.7% | 34.6% | 34.1% |
Wynik bazowy: Grok 4.6 wykazuje realną przewagę nad Grok 4.5 we wszystkich pokazanych wierszach. Dorównuje GPT-5.6 Sol w ogólnym indeksie inteligencji, prowadzi w tej grupie na GDPVal-AA v2 i minimalnie wyprzedza GPT-5.6 Sol na FrontierCode. Jego główne opublikowane luki pozostają na DeepSWE i Terminal-Bench.
Te wyniki wyznaczają konkretny standard dla Grok 4.7. Jeśli większy model i ukierunkowany na inżynierię trening uzupełniający przełożą się na produkcję, spodziewanym przełomem będzie silniejsze kodowanie na poziomie repozytorium i wykonywanie zadań terminalowych bez utraty mocnych stron Grok 4.6 w pracy z wiedzą. Wiarygodnym celem ambitnym jest osiągnięcie konkurencyjności względem wydanego Claude Fable 5.1 w kodowaniu i długotrwałych przepływach agentowych. To prognoza do weryfikacji, a nie bieżące roszczenie benchmarkowe.
Grok 4.7 vs Grok 4.6: oczekiwane przełomy i wskazówki dotyczące aktualizacji
Sygnały wycieków i deklaracje założyciela sugerują pięć obszarów potencjalnej poprawy Grok 4.7. Ponieważ xAI nie opublikowało finalnych danych ewaluacyjnych, każdą z tych oczekiwań należy przekształcić w mierzalny test akceptacyjny.
Programowanie na poziomie repozytorium
Grok 4.6 jest już mocny w CursorBench i FrontierCode, ale jego wyniki na DeepSWE i Terminal-Bench pozostawiają wyraźne pole do poprawy. Grok 4.7 powinien wykazać wyższy odsetek przyjętych łatek, mniej regresji i lepsze odzyskiwanie na wierszu poleceń na tych samych repozytoriach, zanim zastąpi 4.6.
Niezawodność agentów w długim horyzoncie
Sygnał o danych SpaceX i dotychczasowy kierunek treningu agentów w xAI sugerują koncentrację na wieloetapowej pracy inżynieryjnej. Mierz ukończone przepływy, nieudane wywołania narzędzi, ponowienia, interwencje człowieka oraz odzyskiwanie po błędach — nie tylko jakość końcowego tekstu.
Praca wiedzochłonna i rozumowanie techniczne
Grok 4.6 prowadzi w zestawieniu na GDPVal-AA v2. Grok 4.7 powinien utrzymać tę przewagę, jednocześnie poprawiając transfer do przeglądów projektowych, syntezy badań, debugowania, optymalizacji i innych złożonych zadań technicznych.
Efektywność tokenowa
Większy model może być tańszy na zadanie zakończone sukcesem, jeśli dochodzi do poprawnych wyników w mniejszej liczbie kroków. Porównuj łączną liczbę tokenów wejściowych, tokenów z cache, tokenów wyjściowych, ponowień oraz koszt dotarcia do tego samego zaakceptowanego rezultatu.
Kompromisy wydajnościowe podczas serwowania
Jeśli Grok 4.7 jest wolniejszy, zyski jakościowe muszą przewyższać opóźnienia. Rejestruj czas do pierwszego tokena, przepustowość ciągłą, całkowity czas realizacji zadania, współczynnik błędów i koszt przy realistycznej współbieżności.
Benchmarki Grok 4.7: 5 testów weryfikujących realny postęp względem Grok 4.6
- Sukces w inżynierii oprogramowania: mierz rozwiązane problemy, testy przechodzące, wskaźnik regresji i przyjęcia łatek na reprezentatywnych repozytoriach.
- Niezawodność agentów w długim horyzoncie: śledź ukończone przepływy, błędy wywołań narzędzi, ponowienia, odzyskiwanie i interwencje człowieka w przebiegach wieloetapowych.
- Transfer do realnej inżynierii: testuj projektowanie, debugowanie, optymalizację, rozumowanie naukowe i zadania związane z CAD z ujawnionymi kryteriami oceny.
- Efektywność tokenowa na udane zadanie: porównuj łączną liczbę tokenów i wydatki potrzebne do uzyskania tego samego zaakceptowanego rezultatu.
- Opóźnienia i koszt pod obciążeniem produkcyjnym: oceniaj czas do pierwszego tokena, przepustowość, łączny czas wykonania, wskaźnik błędów i koszt przy realistycznej współbieżności.
Co deweloperzy powinni zrobić przed 12 września — i jak wpisuje się w to CometAPI
Przedpremierowa lista kontrolna dla deweloperów
- Zbuduj stały zestaw ewaluacyjny z realnych przepływów kodowania, badań, inżynierii i agentów.
- Uruchom go na Grok 4.6 i zarejestruj wskaźnik sukcesu, ponowienia, wywołania narzędzi, opóźnienia, tokeny i łączny koszt.
- Utrzymuj konfigurowalny wybór modelu i unikaj hardcodowania tymczasowego identyfikatora Grok 4.7.
- Obserwuj informacje o wydaniach xAI oraz stronę modelu w CometAPI pod kątem potwierdzonej dostępności.
- Po premierze zweryfikuj kontekst, modalności, kontrolę rozumowania, ceny, limity zapytań i zakres rollout’u.
- Odtwórz ten sam zestaw ewaluacyjny przed przekierowaniem ruchu produkcyjnego.
CometAPI zapewnia ujednoliconą warstwę API do dostępu do wielu dostawców modeli AI przez jedno konto i wzorzec integracji. Strona śledząca Grok 4.7 jest już dostępna. CometAPI zintegruje Grok 4.7, gdy tylko xAI oficjalnie go wyda i pojawi się dostęp do produkcyjnego endpointu.
Do tego czasu traktuj wszelkie identyfikatory, ceny czy pola możliwości z okresu przedpremierowego jako tymczasowe. Zanim wyślesz ruch produkcyjny, potwierdź, że trasa jest aktywna, prawdziwe żądanie kończy się sukcesem, zwrócony model jest zamierzoną wersją, a aktualne ceny są widoczne w konsoli.
Perspektywa cen Grok 4.7 vs Grok 4.6
Opublikowana stawka standardowa Grok 4.6 wynosi $2 za 1 milion tokenów wejściowych i $6 za 1 milion tokenów wyjściowych poniżej progu długiego kontekstu. Notatki wydawnicze xAI podają wyższe stawki dla żądań przekraczających 200 000 tokenów promptu. Ceny Grok 4.7 nie zostały oficjalnie ogłoszone.
| Podstawa opublikowanego cennika | Wejście / 1M | Wyjście / 1M | Status |
|---|---|---|---|
| Grok 4.6, prompt poniżej 200K | $2 | $6 | Opublikowane |
| Grok 4.6, prompt powyżej 200K | $4 | $12 | Opublikowany próg długiego kontekstu |
| Grok 4.7 | Nie ogłoszono | Nie ogłoszono | Potwierdzić po oficjalnym wydaniu |
Trzy kierunki cen są nadal możliwe: parytet z Grok 4.6 w celu przyspieszenia adopcji, wyższa półka cenowa, jeśli koszt serwowania jest istotnie większy, lub osobne stawki w zależności od długości kontekstu i szybkości. To scenariusze planistyczne, a nie prognoza xAI.
Przedpremierowa lista kontrolna
- Zbuduj stały zestaw ewaluacyjny z realnych przepływów kodowania, badań, inżynierii i agentów.
- Uruchom go na Grok 4.6 i zarejestruj wskaźnik sukcesu, ponowienia, wywołania narzędzi, opóźnienia, tokeny i łączny koszt.
- Utrzymuj konfigurowalny wybór modelu i unikaj hardcodowania tymczasowego identyfikatora Grok 4.7.
- Obserwuj informacje o wydaniach xAI oraz stronę modelu w CometAPI pod kątem potwierdzonej dostępności.
- Po premierze zweryfikuj kontekst, modalności, kontrolę rozumowania, ceny, limity zapytań i zakres rollout’u.
- Odtwórz ten sam zestaw ewaluacyjny przed przekierowaniem ruchu produkcyjnego.
Grok 4.7: co obserwować dalej
Cztery zdarzenia zamieniłyby obecne odliczanie w weryfikowalną premierę produktu: oficjalny post xAI o wydaniu; dokumentacja modelu obejmująca kontekst, modalności i kontrolę rozumowania; finalne ceny w API i identyfikatory modeli; oraz odtwarzalne benchmarki lub ewaluacje produkcyjne.
Najbardziej użyteczne pytanie dotyczące premiery nie brzmi, czy 2.1T brzmi imponująco. Brzmi ono: czy Grok 4.7 wykonuje trudne zadania inżynieryjne i agentowe bardziej niezawodnie — i przy lepszym koszcie na udany wynik — niż wydana baza.
FAQ
Kiedy oczekuje się wydania Grok 4.7?
Dziesięciodniowe odliczanie Muska z 2 września wskazuje na około 12 września 2026 r. To wywnioskowany cel, a nie osobno opublikowana data w kalendarzu xAI.
Czy Grok 4.7 został już wydany?
Grok 4.7 został publicznie zapowiedziany/teasowany, ale nie otrzymał jeszcze pełnej oficjalnej dokumentacji API/modelu.
Czy Grok 4.7 to model o 2.1 biliona parametrów?
Musk opisał go jako około 2.1T parametrów. xAI nie opublikowało jeszcze dokumentu architektonicznego potwierdzającego aktywne parametry lub szczegóły routingu.
Czy Grok 4.7 będzie lepszy niż Grok 4.6?
Musk deklarował znaczną poprawę, ale nie istnieje oficjalna tabela benchmarków Grok 4.7. Traktuj to twierdzenie jako niezweryfikowane, dopóki nie pojawią się odtwarzalne wyniki.
Czy Grok 4.7 będzie dostępny przez CometAPI?
Strona śledząca CometAPI już istnieje, ale finalną dostępność, identyfikator, ceny i wspierane formaty należy potwierdzić po oficjalnym wydaniu.
Wnioski
Historia Grok 4.7 przeszła od szerokiego, wczesnowrześniowego szacunku do konkretnego odliczania. Najnowsza wypowiedź Muska wskazuje na około 12 września 2026 r., a wcześniejsze wpisy opisują model około 2.1T i trening uzupełniający z wykorzystaniem znaczących danych firmowych SpaceX.
To wyjątkowo konkretne sygnały przedpremierowe, ale nie są one kartą modelu, zestawem benchmarków ani umową API. Deweloperzy powinni zachować Grok 4.6 jako mierzalny punkt odniesienia, przygotować kontrolowaną ewaluację już teraz i poczekać na potwierdzenie dostępu produkcyjnego przez xAI i CometAPI, zanim podejmą decyzje o migracji lub budżecie.