Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
Jak uruchomić MiniMax M3.1 Flash lokalnie: przewodnik po GPU, vLLM i SGLang
Dowiedz się, jak uruchomić MiniMax M3.1 Flash lokalnie. Poznaj jego architekturę MoE 428B/23B, wymagania GPU, konfigurację vLLM i SGLang, benchmarki oraz alternatywy API.
MiniMax M3.1 Flash udostępnia otwartowagowy model AI do wymagających zadań programistycznych i agentowych, ale uruchomienie lokalne wymaga poważnych zasobów sprzętowych. Architektura MoE o 428 mld parametrów aktywuje tylko 23 mld parametrów na token, ograniczając obliczenia, ale nie eliminując potrzeby przechowywania pełnego modelu. Deweloperzy z obsługiwanymi systemami multi‑GPU mogą wdrożyć go za pomocą vLLM lub SGLang. Dla osób chcących pominąć zarządzanie infrastrukturą, MiniMax M3.1 Flash API w CometAPI oferuje prostszy start.
Kluczowe wnioski
Sprzęt to największa bariera. Opublikowane konfiguracje vLLM wykorzystują cztery obsługiwane GPU Blackwell lub AMD MI355X albo osiem GPU H100/H200.
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
Długi kontekst wiąże się z kosztami pamięciowymi. Model obsługuje do miliona tokenów, ale praktyczne limity serwowania zależą od dostępnej pamięci GPU i współbieżności.
Wdrożenie jest specyficzne dla sprzętu. Użyj kompatybilnego silnika inferencji, formatu kwantyzacji i konfiguracji akceleratora zamiast ogólnego polecenia instalacji.
Benchmarki to tylko punkt wyjścia. Oceń dokładność w kodowaniu, skuteczność zadań agentów, opóźnienia i przepustowość pod własnymi obciążeniami.
Inference lokalne i hostowane służą różnym potrzebom. Samodzielny hosting daje większą kontrolę nad infrastrukturą, a dostęp przez API ogranicza złożoność konfiguracji i koszty utrzymania.
Czym jest MiniMax M3.1 Flash?
MiniMax M3.1 Flash przyjmuje tekst, obrazy i wideo oraz generuje tekst. Został zaprojektowany z myślą o programowaniu, automatyzacji, interakcji z komputerem i bezpieczeństwie. Wagi są udostępnione na licencji MiniMax Community License. Przed uruchomieniem komercyjnej usługi przeczytaj licencję dołączoną do checkpointu i sprawdź warunki obowiązujące dla Twojego zastosowania.
Specyfikacje MiniMax M3.1 Flash
Specyfikacja
MiniMax M3.1 Flash
Deweloper
MiniMax
Rodzina modeli
Natywny multimodalny MoE
Łączna liczba parametrów
Około 428B
Aktywne parametry
Około 23B na token
Maksymalny kontekst
1 048 576 tokenów (możliwości modelu)
Typy wejść
Tekst, obrazy i wideo (zależnie od trasowania)
Wyjście
Tekst
Mechanizm uwagi
MiniMax Sparse Attention w każdej warstwie
Kwantyzacja
MXFP8 dla warstw gęstych / NVFP4 dla ekspertów
Draft decoding
DSpark – zintegrowana głowica szkicu
Reasoning effort
low, medium, high, xhigh, max
Zgłaszana szybkość generowania
200+ tokenów/s w sprzyjających warunkach; P50 170+ tokenów/s
Licencja
MiniMax Community License
Udokumentowane inferencje
vLLM, SGLang
Typowa topologia
4 obsługane GPU Blackwell lub MI355X; 8 GPU H100/H200
Jak MiniMax M3.1 Flash wykorzystuje architekturę 428B/23B?
Model Mixture‑of‑Experts (MoE) kieruje każdy token do wybranych ekspertów. W MiniMax M3.1 Flash około 23B parametrów jest aktywnych dla jednego tokenu, podczas gdy pełna pula parametrów to około 428B. Rzadkie uaktywnianie ogranicza koszty obliczeniowe; nie zamienia to checkpointu w gęsty model 23B.
Co się zmieniło w MiniMax M3.1 Flash?
Rzadka uwaga: Zastosowana w całym modelu, aby zmniejszyć pracę mechanizmu uwagi przy długich wejściach; korzyści zależą od kerneli serwowania i promptu.
Wagi o mieszanej precyzji: Komponenty gęste MXFP8 i eksperci NVFP4 redukują wymagania dot. pamięci i obliczeń, ale nadal wymagają kompatybilnego sprzętu i kerneli.
Dekodowanie DSpark: Zintegrowana głowica szkicu może przyspieszyć generację w obsługiwanych przepisach; wyniki zależą od akceptacji tokenów i charakteru obciążenia.
Serwowanie świadome energii: Harmonogramowanie na poziomie infrastruktury może poprawić wykorzystanie zasobów, ale nie jest funkcją, którą otrzymujesz automatycznie po pobraniu wag.
Jakiego sprzętu potrzeba do MiniMax M3.1 Flash?
Budżet pamięci GPU podziel na cztery części: wagi checkpointu, pamięć podręczną klucz‑wartość (KV) dla poprzednich tokenów, bufory wykonawcze i zapas na obciążenie. Poniższe szacunki obejmują jedynie surowe przechowywanie parametrów. Mieszana precyzja, skale kwantyzacji, komponenty multimodalne i narzut serwowania zmieniają realne wymagania.
Zweryfikowane topologie GPU
Akceleratory
Opisana topologia
Uwagi
NVIDIA GB200/GB300/B200/B300
4 GPU, równoległość tensorowa
Natywna ścieżka NVFP4 dla Blackwell
NVIDIA H100/H200
8 GPU, równoległość tensorowa
Pamięci podręczne FP8 i ścieżka Marlin MoE
AMD MI355X
4 GPU, równoległość tensorowa
Wymaga obsługiwanego ROCm i ustawień AITER
24–32 GB karta konsumencka
Brak przepisu dla pełnego checkpointu
Niewystarczająca do prostego ładowania na jednym GPU
Stacja robocza tylko CPU
Brak zweryfikowanego praktycznego wdrożenia
Eksperymenty z offloadingiem nie są wytycznymi prod.
Szacunek pamięci: Surowe przechowywanie 428B parametrów to około 856 GB przy BF16, 428 GB przy 8‑bit lub 214 GB przy idealizowanym 4‑bit. Oficjalny checkpoint miesza formaty, więc te wartości nie są wymaganiami VRAM w czasie wykonania. Uwzględnij skale kwantyzacji, pamięć KV, bufory wykonawcze i współbieżność; użyj rzeczywistych plików checkpointu oraz przepisu dla Twojego GPU, aby dobrać rozmiar systemu.
Zarezerwuj miejsce na NVMe dla checkpointu, tymczasowych pobrań i kopii na potrzeby rollbacku.
Którą metodę wdrożenia wybrać?
Dla obsługiwanego klastra lokalnego vLLM jest praktycznym punktem startu z referencyjnymi konfiguracjami i znajomą integracją API; SGLang odpowiada zespołom eksplorującym dostosowania serwowania po sprawdzeniu kompatybilności, podczas gdy CometAPI oferuje trasę hostowaną do prototypowania i przełączania modeli.
Wymaganie
Lokalnie: vLLM
Lokalnie: SGLang
CometAPI
Wagi i GPU
Pobierz wagi; obsługuj wspierane GPU
Pobierz wagi; obsługuj wspierane GPU
Inferencja zarządzana przez dostawcę; bez lokalnych wag
Blackwell / AMD MI355X
Przepisy specyficzne dla sprzętu
Przepisy specyficzne dla sprzętu
Sprzęt zarządzany przez dostawcę
H100/H200
Udokumentowany przepis na osiem GPU
Sprawdź aktualną macierz wsparcia
Sprzęt zarządzany przez dostawcę
Dekodowanie i równoległość
DSpark na wspieranych ścieżkach; równoległość tensorowa i serwowanie rozproszone
Dekodowanie specyficzne dla sprzętu; równoległość tensorowa i ekspertów
Wybierz framework z zweryfikowanym przepisem dla Twojego sprzętu, a następnie porównaj opóźnienia i przepustowość, używając tych samych promptów, precyzji i współbieżności.
Jak uruchomić MiniMax M3.1 Flash lokalnie z vLLM?
Poniższe kroki zakładają hosta Linux wyposażonego w cztery kompatybilne GPU NVIDIA Blackwell, obsługiwany sterownik/środowisko CUDA oraz dostęp do oficjalnego checkpointu. Użyj zweryfikowanej kompilacji vLLM; zwykła instalacja na niewspieranym GPU może się nie powieść, nawet jeśli instalacja pakietów zakończy się sukcesem.
Upewnij się, że zainstalowane koło i runtime CUDA odpowiadają Twojej rodzinie GPU. Jeśli potrzebna jest specyficzna dla projektu kompilacja deweloperska, postępuj zgodnie z referencyjnymi uwagami instalacyjnymi przed użyciem parametrów uruchomieniowych.
Użyj odpowiedniego tokena dostępu Hugging Face, jeśli jest wymagany, zachowaj strukturę katalogów i zweryfikuj kompletny pobór shardów przed uruchomieniem serwera.
Poczekaj, aż serwer zakończy ładowanie i zgłosi gotowość, zanim wyślesz żądanie. Powyższe polecenie ogranicza kontekst do 32 768 tokenów i współbieżność do czterech sekwencji w celu wstępnego testu. Te ograniczone ustawienia nie są parametrami do benchmarków; dostosuj je po pomiarze użycia pamięci i zachowania żądań na Twoim sprzęcie.
Jeśli identyfikator serwowanego modelu różni się od nazwy katalogu, wywołaj /v1/models i użyj dokładnie zwróconego ID. Pomyślna odpowiedź tekstowa weryfikuje tylko podstawową inferencję; przetestuj osobno wizję, wywoływanie narzędzi, współbieżność i długi kontekst.
Krok 5: Integracja z klientem Python kompatybilnym z OpenAI
Przykład nasłuchuje na 127.0.0.1 do testów lokalnych. Przed podłączeniem zdalnych klientów ustaw kontrolę dostępu przed punktem końcowym oraz skonfiguruj limity czasowe klientów, ograniczone ponowienia i monitoring.
Wariant H100/H200: użyj przepisu Hopper na osiem GPU
Na ośmiu GPU H100/H200 użyj specyficznej dla Hopper ścieżki pamięci podręcznej FP8 i Marlin MoE zamiast konfiguracji NVFP4 dla Blackwell. Poniższe polecenie podąża za oficjalnym przepisem vLLM dla Hopper z kontekstem i współbieżnością zredukowanymi do 32K i czterech sekwencji na wstępny test. Wyłącza wejście wideo zgodnie z tym przepisem. Trzymaj ten endpoint za istniejącymi mechanizmami kontroli dostępu.
SGLang oferuje przepisy wdrożeniowe M3.1 specyficzne dla sprzętu oraz serwowanie zgodne z OpenAI. W migawce z 23 października dokumentacja obejmuje dedykowane obrazy kontenerów deweloperskich, zatem nie należy zakładać, że ogólna instalacja SGLang zawiera pełne wsparcie specyficzne dla modelu.
Pobierz dedykowany obraz kontenera
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Następnie postępuj zgodnie z cookbookiem SGLang dla MiniMax M3.1 dotyczącym Twojego akceleratora. Pobranie obrazu sprowadza jedynie runtime; nadal musisz uruchomić kontener z dostępem do GPU i wystartować pasujące serwowanie wewnątrz niego. Użyj kompletnego polecenia specyficznego dla sprzętu z cookbooka, poczekaj na gotowość, a potem odpytać listę modeli endpointu przed wysłaniem testowego żądania. Udokumentowane ścieżki dla NVIDIA i AMD używają różnych zależności i należy je konfigurować oddzielnie.
Jak MiniMax M3.1 Flash wypada w benchmarkach?
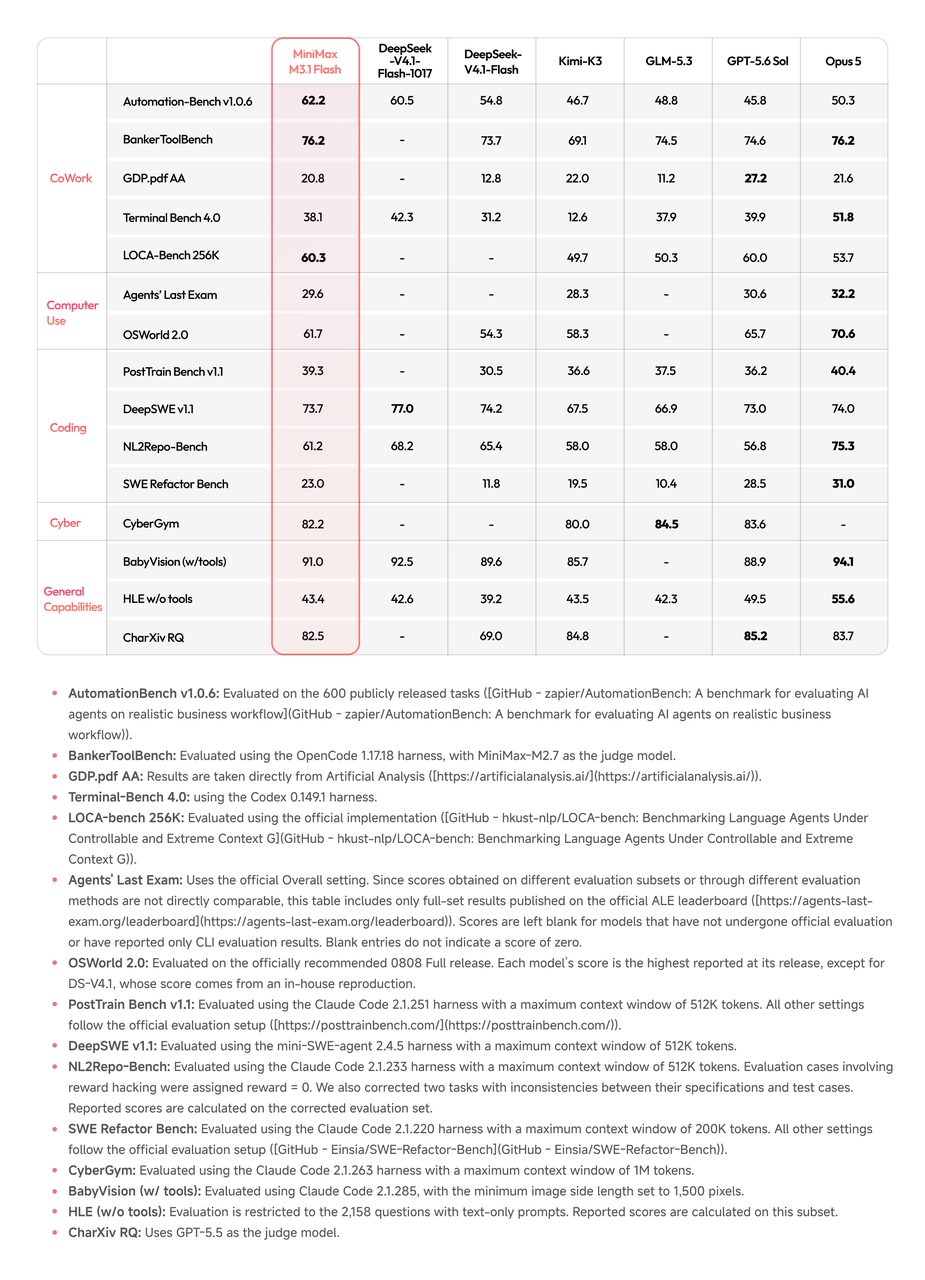
Gdy Twój endpoint przejdzie podstawowe testy, użyj opublikowanych benchmarków, by wybrać kolejne obciążenia do sprawdzenia. Poniższe liczby to oceny opublikowane przez dostawcę, a nie pomiary Twojego lokalnego wdrożenia.
Benchmark
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N/A
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
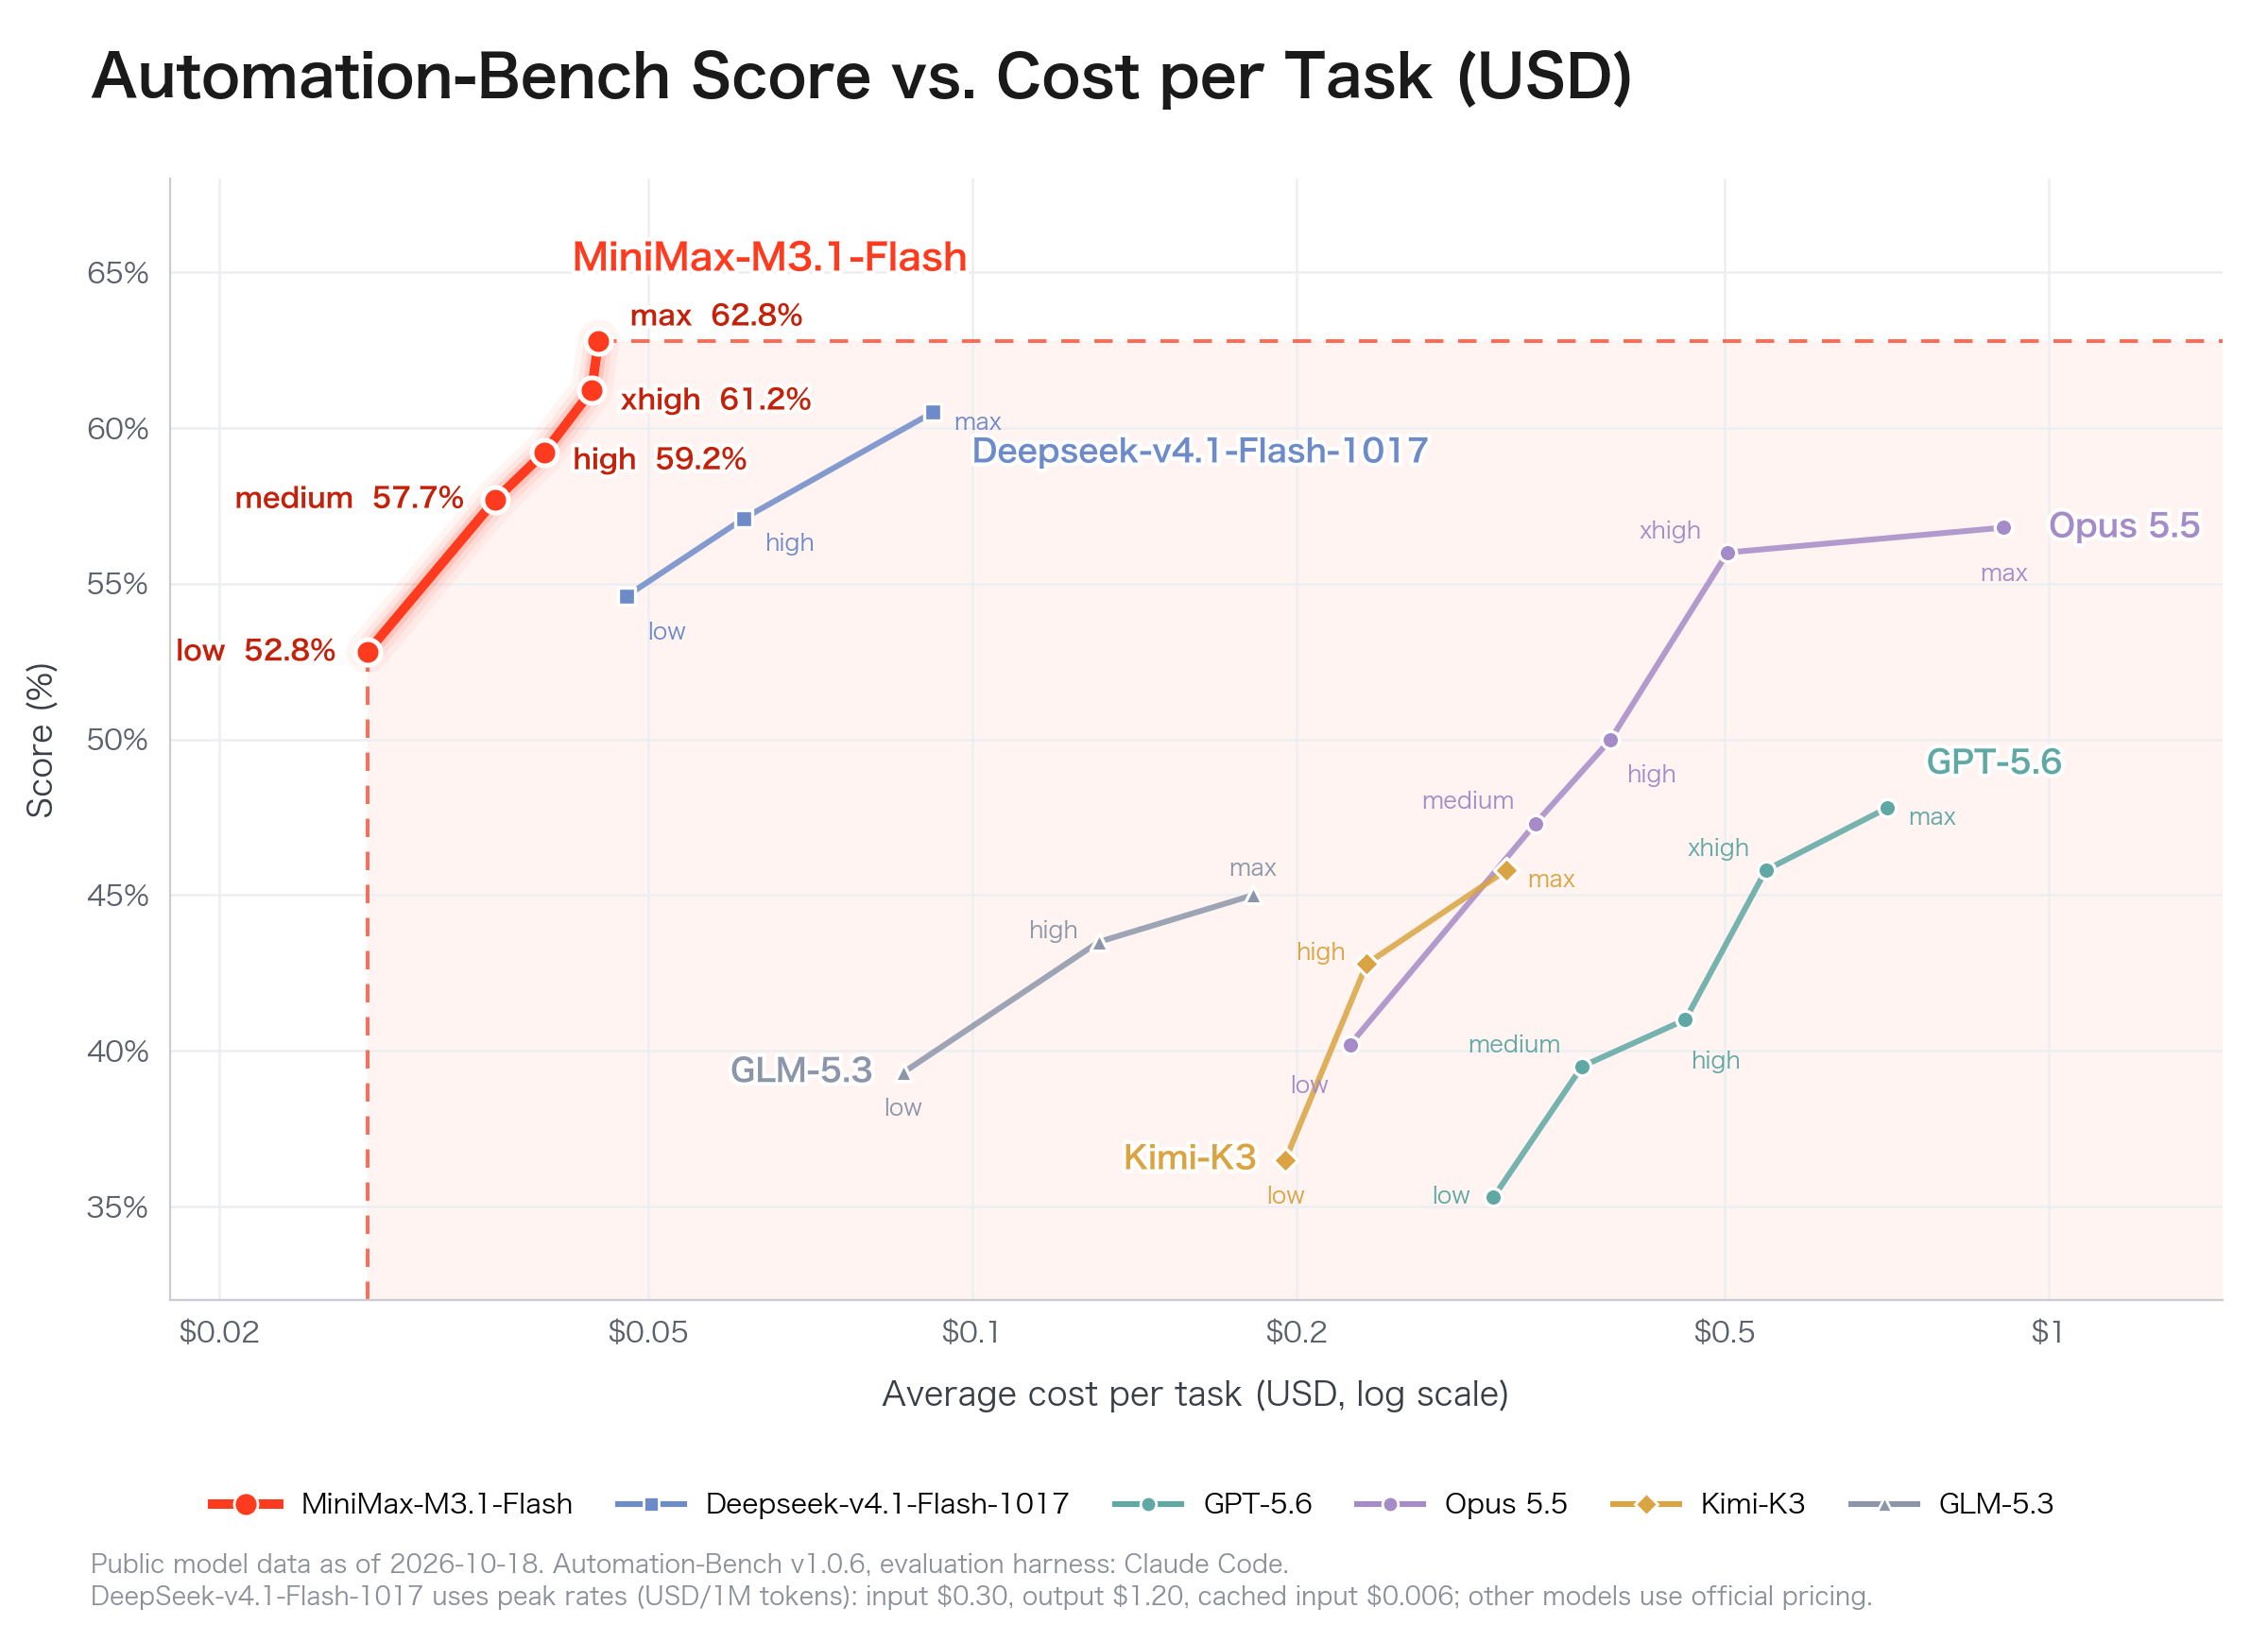
W tym porównaniu MiniMax prowadzi na Automation‑Bench spośród wymienionych modeli, podczas gdy DeepSeek przewodzi w kilku benchmarkach kodowania. Przeczytaj kartę modelu i ustawienia ewaluacji przed wyciąganiem wniosków i testuj prompty oraz narzędzia, których faktycznie używa Twoja aplikacja. Wyniki z różnych wersji benchmarków lub konfiguracji nie są bezpośrednio porównywalne.
Jak zoptymalizować wydajność MiniMax M3.1 Flash?
Kontroluj kontekst i współbieżność
Po pierwszym udanym żądaniu zwiększaj jedną zmienną obciążenia naraz: długość wejścia, długość wyjścia lub liczbę równoległych żądań. Zapisuj szczytowe użycie pamięci i opóźnienie odpowiedzi dla każdego uruchomienia. Zachowaj ostatnie stabilne ustawienia jako punkt wycofania, aby nieudany eksperyment nie stał się Twoją nową bazą.
Świadomie dobieraj poziom rozumowania
M3.1 Flash obsługuje low, medium, high, xhigh i max. Wyższe ustawienia mogą poprawić wyniki w wymagających zadaniach, ale często wymagają większej liczby tokenów rozumowania i dłuższego opóźnienia. Bierz pod uwagę łącznie jakość ukończenia zadań i koszt obliczeniowy w czasie.
Dla lokalnych żądań vLLM przepis pokazuje ustawienia reasoning‑effort w sekcji chat_template_kwargs. Sprawdź zarówno odpowiedź końcową, jak i ewentualne oddzielnie zwracane pole reasoning podczas walidacji klienta, ponieważ endpointy hostowane i lokalne mogą eksponować te pola w różny sposób.
Śledź koszt ukończonego zadania
Dla agentów same tokeny na sekundę nie wystarczą. Rejestruj czas do pierwszego tokenu, tempo generacji, współczynnik akceptacji dla dekodowania spekulacyjnego, przepustowość przy współbieżności, błędy wywołań narzędzi, wykorzystanie pamięci i koszt ukończonego zadania. Wolniejsza odpowiedź z mniejszą liczbą błędnych narzędzi może zapewnić lepszą ekonomię całościową.
Jak korzystać z MiniMax M3.1 Flash API w CometAPI?
Zespoły, które nie potrzebują dedykowanej infrastruktury akceleratorów, mogą użyć hostowanego endpointu zgodnego z OpenAI. Eliminuje to pobieranie checkpointu i obsługę GPU, ale przenosi przetwarzanie żądań poza środowisko samohostowane.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Potwierdź identyfikator modelu w konsoli CometAPI przed uruchomieniem przykładu. Użyj bramki, gdy wspólne API dla dostawców ułatwia Twojej aplikacji działanie; porównaj jej bieżącą stawkę z dostępem bezpośrednim dla oczekiwanego użycia.
Cennik MiniMax M3.1 Flash API
Cena za milion tokenów
Oficjalne API MiniMax
CometAPI
Wejście
$0.15
$0.80
Wyjście
$0.60
$3.20
Buforowane wejście
$0.015
Potwierdź bieżącą stawkę trasy
Bezpośrednie stawki API MiniMax w ogłoszeniu premierowym z 19 października 2026 to $0.15 za wejście, $0.60 za wyjście i $0.015 za buforowane wejście na milion tokenów. Dla CometAPI sprawdź aktywną trasę modelu, stawki wejścia/wyjścia, zasady cache’owania oraz ewentualny rabat konta przed oszacowaniem kosztów. Porównaj łączny koszt dla oczekiwanej mieszanki tokenów i ponowień.
Jakie problemy mogą wystąpić przy uruchamianiu MiniMax M3.1 Flash?
Brak pamięci podczas ładowania lub obsługi żądań
Jeśli wagi nie ładują się: Sprawdź etap awarii w logu startu, potwierdź kompletność checkpointu i zweryfikuj, że topologia GPU oraz backend kwantyzacji odpowiadają przepisowi. Jeśli wagi przekraczają dostępną pamięć, użyj konfiguracji o wystarczającej pojemności; skrócenie żądania nie naprawi błędu ładowania wag.
Jeśli wagi ładują się, ale alokacja cache nie udaje się przy starcie: Sprawdź ustawienia cache i dostępną pamięć, następnie zmniejsz skonfigurowany kontekst lub współbieżność zgodnie z przepisem.
Jeśli serwer startuje, lecz żądanie kończy się brakiem pamięci: Ponów próbę z krótkim promptem i jednym żądaniem naraz, a następnie osobno zwiększaj długość wejścia, długość wyjścia i współbieżność, monitorując pamięć.
Niezgodne kwantyzacje lub kernele uwagi
Wykonanie NVFP4 różni się między sprzętem Blackwell, Hopper i AMD. Dopasuj wersje silnika inferencji, backendy kwantyzacji, wersje CUDA/ROCm i rodziny akceleratorów zamiast bezrefleksyjnego kopiowania flag.
Konfiguracja cache dla rzadkiej uwagi
Jeśli przy starcie zgłaszany jest nieobsługiwany układ cache, porównaj pełną konfigurację cache z przepisem specyficznym dla sprzętu. Obecny przepis vLLM wymaga --block-size 128 dla indeksowanego/sparse cache MSA. Jeśli start zgłasza błąd układu cache lub rozmiaru bloku, porównaj pełną konfigurację z przepisem dla Twojego sprzętu.
Nieoczekiwane identyfikatory modelu
Lokalna ścieżka i nazwa modelu w bramce zdalnej nie muszą być identyczne. Odpytać lokalne /v1/models i unikaj twardego kodowania założeń z innego endpointu.
Słabo obserwowana przepustowość
Oddziel wolne przetwarzanie promptu od wolnej generacji tokenów. Porównuj uruchomienia z tą samą długością wejścia i limitem wyjścia, następnie sprawdź wykorzystanie GPU i zachowanie interkonektu zanim zwiększysz rozmiar wsadu. Liczby szybkości podawane przez dostawcę nie są punktem odniesienia dla Twojego klastra lokalnego.
Podsumowanie
Wybierz pierwszą ścieżkę wdrożenia w oparciu o sprzęt, którym możesz zarządzać dziś. Skorzystaj z przewodnika vLLM dla obsługiwanego klastra lokalnego, hardware‑specyficznego cookbooka SGLang dla alternatywnego stosu serwowania lub z hostowanego API, gdy chcesz skupić się na integracji aplikacji. Zachowaj konfigurację, która spełnia Twoje cele jakości zadań i opóźnień przy zrównoważonym koszcie operacyjnym.
Najbardziej niezawodny sposób wyboru metody serwowania to optymalizacja pod kątem poprawnie ukończonej pracy na dolar i minutę, a nie tylko szczytowych tokenów na sekundę.
FAQ
Jak zapewnić powtarzalność wdrożenia po aktualizacji runtime?
Przypnij rewizję checkpointu, wersje obrazu runtime lub pakietów, stos sterowników i ustawienia uruchomieniowe. Uruchamiaj ten sam mały zestaw akceptacyjny przed każdą aktualizacją i utrzymuj poprzednią działającą konfigurację do szybkiego rollbacku.
Jak obsługiwać ponowienia, gdy agent wywołuje narzędzia?
Oddziel ponowienie wywołania modelu od powtórzenia działania narzędzia. Używaj kluczy idempotencji dla akcji zmieniających dane, sprawdzaj, czy pierwsza próba się powiodła, i waliduj kompletność argumentów narzędzia przed wykonaniem.
Czy mogę przełączać się między lokalnym endpointem a CometAPI bez zmiany zachowania aplikacji?
Utrzymuj konfigurowalne endpoint, poświadczenia i ID modelu. Przetestuj strumieniowanie, wywołania narzędzi, pola rozumowania i wejścia multimodalne na obu trasach i potwierdź wymagania dotyczące kierowania danymi przed włączeniem mechanizmu awaryjnego.
Co powinienem przetestować przed akceptacją wejść multimodalnych?
Przetestuj reprezentatywne obrazy i wideo, w tym niską jakość i nieobsługiwane pliki. Osobno sprawdź wstępne przetwarzanie, limity rozmiaru, jakość odpowiedzi i limity czasowe; udane żądanie tekstowe nie waliduje ścieżki multimodalnej.
Skąd wiem, że wdrożenie jest gotowe dla realnych użytkowników?
Ustal cele dla sukcesu zadań, poprawnych wywołań narzędzi, opóźnień, błędów i kosztów. Przetestuj realistyczny ruch, zweryfikuj monitoring i zachowanie awaryjne, a następnie rozszerzaj wdrożenie z małego rollout’u tylko wtedy, gdy te cele są spełnione.