Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
Keszowanie promptów pozwala modelom językowym ponownie wykorzystać wcześniej przetworzony prefiks promptu zamiast powtarzać te same obliczenia wejścia. Może to obniżyć koszty tokenów wejściowych i poprawić opóźnienie, zwłaszcza w przepływach pracy agentów, obsłudze klienta, RAG oraz analizie dużych dokumentów. W 2026 roku OpenAI oferuje automatyczne keszowanie i nowsze jawne sterowanie cache’em, Claude obsługuje automatyczne i blokowe breakpointy cache, a Gemini stawia na keszowanie implicytne w najnowszych modelach. Dostawcy różnie rozliczają zapisy, odczyty i — tam, gdzie to dotyczy — przechowywanie cache. Wygaśnięcie może spowodować ponowny zapis albo pełne naliczenie wejścia, więc realne oszczędności zależą od częstotliwości ponownego użycia i zaobserwowanych trafień cache.
Ten przewodnik porównuje keszowanie promptów w GPT-6.1 Sol, Claude Opus 5.5 i Gemini 4 Argon dla deweloperów budujących aplikacje z powtarzalnym wejściem. Koncentruje się na sterowaniu cache, cenach i sposobach weryfikacji ponownego użycia.
Najważniejsze wnioski
Keszowanie promptów ponownie wykorzystuje przetworzone wejście — nie poprzednią odpowiedź modelu.
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
Keszowanie OpenAI zależy od stabilnego prefiksu, obsługiwanych funkcji modelu oraz minimalnych długości i ustawień retencji specyficznych dla modelu.
Keszowanie Claude oferuje TTL 5 minut i opcjonalnie 1 godzinę, z automatycznym i jawnym sterowaniem cache.
Keszowanie kontekstu w Gemini jest implicytne w nowoczesnych modelach; jawne zasoby cache zależą od modelu.
Oszczędności zależą od kosztów zapisów, odczytów, przechowywania (jeśli dotyczy) i realnych trafień; weryfikuj wsparcie endpointu i rozliczanie tokenów cache przy użyciu CometAPI.
Czym jest keszowanie promptów w LLM-ach?
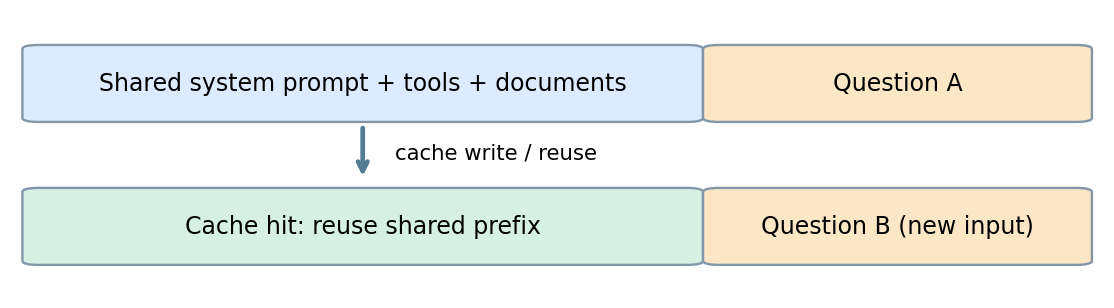
Keszowanie promptów to optymalizacja inferencji umożliwiająca ponowne wykorzystanie stanu obliczeniowego wyprowadzonego z wcześniej przetworzonego prefiksu. Prompt często zawiera stabilne instrukcje, definicje narzędzi lub dokumenty, po których następuje zmienne pytanie użytkownika. Jeśli późniejsze żądanie powtórzy kwalifikujący się prefiks, dostawca może ponownie użyć zbuforowanych stanów KV i przetworzyć tylko niekeszowaną resztę. W odróżnieniu od keszowania odpowiedzi nie odtwarza to poprzedniej odpowiedzi: model generuje nową odpowiedź dla bieżącego żądania.
Przepływ pracy keszowania promptów:
Pierwsze żądanie: prześlij duży, powtarzalny prefiks i konkretne pytanie.
Utworzenie cache: dostawca zapisuje kwalifikujący się pośredni stan obliczeniowy.
Kolejne żądanie: użyj identycznego prefiksu i podmień pytanie.
Odczyt cache: wcześniej przetworzone tokeny są ponownie użyte, a nowe tokeny przetwarzane normalnie.
Koncepcyjna ilustracja dołączona do oryginalnego szkicu: powtarzalny materiał promptu poprzedza zmieniające się pytanie. To nie jest oficjalny diagram architektury dostawcy.
Wspólną zasadą projektową jest stabilność prefiksu. Kontrakty API, kwalifikujące się rodziny modeli, czas życia cache i opłaty nie są zamienne.
Keszowanie w OpenAI, Claude i Gemini w skrócie
Ta sama zasada stabilnego prefiksu obowiązuje u wszystkich dostawców, ale poniższe sterowanie jest specyficzne dla modeli użytych w tym przewodniku. Sprawdź model i endpoint razem, zanim skopiujesz ustawienie.
Parameter
OpenAI: GPT-6.1 Sol
Claude: Opus 5.5
Google: Gemini 4 Argon
Cache activation
Implicit matching; explicit breakpoints supported
Opt in with request-level or content-block cache_control
Implicit caching enabled by default
Minimum prefix
1,024 visible input tokens
512 tokens before the cache boundary
4,096 input tokens
Lifetime controls
Responses API: prompt_cache_options.ttl; 30m default or 12h
5-minute default; optional 1-hour TTL
Provider-managed implicit lifetime
Where to place stable content
Leading instructions, tools, and reference material
Stable tool definitions, system content, or message blocks before the breakpoint
Large shared content at the start of the prompt
Usage to inspect
input_tokens_details.cached_tokens and reported cache-write usage
cache_creation_input_tokens and cache_read_input_tokens
cached_content_token_count in usage_metadata, when present
Important distinction
prompt_cache_key can separate accounting; it is not required for Sol's automatic routing
The breakpoint must end on content that stays unchanged
No explicit cache resource for Argon; older supported models expose a separate interface
Sterowanie keszowaniem promptów i przykłady w Pythonie
Każdy przykład wysyła te same materiały referencyjne z dwoma różnymi pytaniami. Utrzymaj niezmienioną część wspólną, uruchom żądania sekwencyjnie i sprawdź usage, aby zobaczyć, czy drugie żądanie faktycznie ponownie użyło keszowanego wejścia.
OpenAI: sterowanie cache i przykład w Pythonie
OpenAI automatycznie dopasowuje prefiksy promptów kwalifikujące się do cache i — w obsługiwanych nowszych modelach — pozwala na jawne ustawienie breakpointów i retencji. Ponowne użycie cache jest szczególnie przydatne, gdy długie instrukcje systemowe, schematy narzędzi lub kontekst repozytorium powtarzają się w wielu żądaniach. Wymagana długość prefiksu i mnożniki cen tokenów zależą od generacji modelu i wybranego poziomu retencji.
Przykład używa Responses API z prompt_cache_options ustawionym na tryb implicytny i czas życia 30 minut. Wcześniejsze generacje modeli używają innych parametrów retencji; postępuj zgodnie z ustawieniami dla konkretnego modelu.
Zainstaluj SDK openai i ustaw OPENAI_API_KEY. Użyj co najmniej 1,024 widocznych tokenów we wspólnym prefiksie. Uruchom oba żądania sekwencyjnie i sprawdź input_tokens_details.cached_tokens oraz cache_write_tokens w usage. Dodatnia liczba tokenów cache potwierdza rozliczony odczyt z cache; nie gwarantuje to niższego opóźnienia w każdym żądaniu.
Aby uruchomić przykłady, zainstaluj odpowiednie SDK Pythona, ustaw klucz API dostawcy i utwórz plik UTF-8 reference.txt zawierający wystarczającą ilość stabilnej treści, aby spełnić minimum keszowania danego modelu.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Odczytuje OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Streść architekturę.", "Zidentyfikuj główne ryzyka techniczne."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Użyj poniższych materiałów referencyjnych.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: sterowanie cache i przykład w Pythonie
W Claude Messages API keszowanie jest trybem opt-in. Dodaj cache_control na poziomie żądania, aby włączyć automatyczne ustawienie breakpointu, albo dołącz je do bloku treści, aby zaznaczyć jawny breakpoint. Deweloperzy mogą oznaczać stabilne instrukcje, dokumenty i wybrane bloki promptu, zmieniając późniejsze dane użytkownika. Standardowy krótki czas życia cache to pięć minut, z opcją jednej godziny dla odpowiednich obciążeń.
Zainstaluj SDK anthropic i ustaw ANTHROPIC_API_KEY. Dla Claude Opus 5.5 zapewnij co najmniej 512 tokenów przed granicą cache. Utrzymaj blok systemowy identyczny w kolejnych żądaniach. Wpis w cache staje się dostępny, gdy zaczyna się pierwsza odpowiedź; ten przykład czeka na pełną odpowiedź dla prostoty. Sprawdź liczniki utworzenia i odczytu z cache; krótki prefiks może zwrócić zero dla obu bez błędu.
Gemini: keszowanie implicytne i przykład w Pythonie
Google określa swoją implementację jako context caching. Gemini 4 Argon używa keszowania implicytnego i nie obsługuje jawnych zasobów cache. Niektóre wcześniejsze rodziny modeli obsługują jawne cache z konfigurowalnym TTL. Wybierz interfejs keszowania na podstawie kontraktu konkretnego modelu, zamiast zakładać, że wszystkie modele Gemini udostępniają te same sterowanie.
Zainstaluj google-genai i ustaw GEMINI_API_KEY. Użyj co najmniej 4,096 tokenów współdzielonej treści na początku dla Gemini 4 Argon i wyślij drugie żądanie wkrótce po pierwszym. Sprawdź cached_content_token_count w usage_metadata, gdy jest dostępne. Keszowanie implicytne może nie zadziałać nawet wtedy, gdy prefiks jest kwalifikowalny.
from pathlib import Path
from google import genai

client = genai.Client()  # Odczytuje GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Streść architekturę.", "Zidentyfikuj główne ryzyka techniczne."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nPytanie: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
Ile kosztuje keszowanie promptów w OpenAI, Claude i Gemini?
Koszty keszowania należy oceniać jako kombinację zapisów, odczytów i — w niektórych systemach z jawnym cache — retencji lub przechowywania. Poniższe mnożniki ilustrują typowe rozwiązania i nie są uniwersalną obietnicą cen w różnych wersjach modeli.
Cost category
OpenAI
Claude
Gemini
Uncached input
Normal input token rate
Normal input token rate
Normal input token rate
Cache write
Newer-model write premiums possible
5m/1h premiums
Implicit or explicit model-specific
Cache read
Reduced model-specific rate
Reduced model-specific rate
Reduced model-specific rate
Cache lifetime
Model-specific
5m / 1h
Implicit managed / explicit configurable
Additional storage
Depends on model
Usually reflected in write tier
Explicit storage charges can apply
Przykład ilustracyjny: prefiks 10,000 tokenów jest ponownie używany w N żądaniach, jego początkowy zapis do cache kosztuje 1.25 razy stawkę zwykłego wejścia, a kolejne odczyty z cache kosztują 0.1 razy zwykłe wejście. Załóż bazową cenę wejścia $2 za milion tokenów i idealne trafienia cache po pierwszym żądaniu.
Number of requests
Without caching
With caching
Savings on reused prefix
10
$0.200
$0.043
78.50%
100
$2.000
$0.223
88.85%
Wzór: koszt keszowanego prefiksu = 1.25P + (N − 1) × 0.1P, gdzie P to zwykły koszt jednokrotnego przetworzenia współdzielonego prefiksu. Ten przykład nie obejmuje dynamicznego wejścia, wyjścia, wygaśnięć, chybionych trafień, przechowywania i innych usług.
Powyższy przykład używa ilustracyjnej stawki odczytu 10%, a nie bieżącej stawki GPT-6.1 Sol. Standardowe ceny krótkiego kontekstu Sol to $2 za milion niekeszowanych tokenów wejściowych, $0.10 za milion keszowanych tokenów wejściowych oraz $2.50 za milion tokenów zapisanych przy domyślnym czasie życia. Przelicz przykład według rzeczywistego modelu, poziomu i rozliczania endpointu.
Dłuższy czas życia jest opłacalny tylko wtedy, gdy zapobiega wystarczającej liczbie powtórnych zapisów lub niekeszowanych żądań, by zrównoważyć jego cenę. Zapisy 5-minutowe i 1-godzinne w Claude są rozliczane odpowiednio jako 1.25× i 2× bazowej ceny wejścia. Jawne cache w obsługiwanych starszych modelach Gemini mogą również generować opłaty za przechowywanie. Mierz ponowne użycie w realnych przerwach bezczynności, nie tylko w serii tuż po sobie.
Traktuj chybienia, wygaśnięcia i generowanie wyjścia jako część rachunku. Jeśli prefiks wygaśnie przed ponownym użyciem, kolejne żądanie może wymagać kolejnego zapisu lub pełnego przetworzenia wejścia. Krótkie prompty mogą się w ogóle nie kwalifikować, a długie odpowiedzi mogą sprawić, że tokeny wyjściowe staną się największym kosztem nawet przy wysokim ponownym użyciu cache. Porównuj całkowity koszt na ukończone zadanie zanim dodasz więcej złożoności związanej z cache.
Które API keszowania sprawdza się najlepiej w różnych obciążeniach?
Dla agentów programistycznych i obsługi klienta umieść stabilne definicje narzędzi, kontekst repozytorium, polityki i wiedzę przed zmiennym zadaniem. OpenAI i Claude oferują sterowanie breakpointami, które pomaga definiować granice do ponownego użycia; oceniaj faktyczne odczyty cacheu w endpointzie, zamiast zakładać, że powtórzony tekst został skeszowany.
Dla analizy dokumentów i pracy multimodalnej umieść dokument źródłowy lub wspierane media przed pytaniem. Implicytne podejście Gemini zmniejsza nakład pracy związany z zarządzaniem cache, podczas gdy Claude pozwala bezpośrednio oznaczyć stabilny blok. Sprawdź obsługę konkretnego typu mediów i modelu, zanim zaczniesz polegać na ponownym użyciu.
Dla długich rozmów dołączaj nowe tury zamiast wielokrotnego przepisywania początku i wybierz dostępny czas życia, który pasuje do przerw między turami. Jeśli Twoja aplikacja potrzebuje nazwanego zasobu cache, który można utworzyć i jawnie referencjonować, rozważ model Gemini obsługujący taki interfejs; Argon go nie posiada.
Nie ma uniwersalnego zwycięzcy: porównuj trafienia cache, koszt na ukończone zadanie i opóźnienie w realnym wzorcu ruchu.
Jak keszowanie promptów wpływa na opóźnienia i wydajność?
Trafienie w cache ogranicza powtarzane przetwarzanie wejścia i może skrócić czas do pierwszego tokena. Nie poprawia samo z siebie jakości odpowiedzi ani nie przyspiesza generowania wyjścia, a skeszowane wejście nadal zajmuje okno kontekstu. Mierz zarówno opóźnienie do pierwszego tokena, jak i całkowity czas odpowiedzi na porównywalnych żądaniach; samo trafienie w cache nie dowodzi, że użytkownik szybciej otrzymał finalną odpowiedź.
Jak optymalizować keszowanie promptów i diagnozować chybienia
Zacznij od stabilnego, użytecznego prefiksu
Umieść najpierw ponownie używalne instrukcje, definicje narzędzi, polityki i dokumenty; zmienne znaczniki czasu, identyfikatory żądań, zmieniający się kontekst i pytanie użytkownika umieść później. Utrzymuj stabilną kolejność narzędzi i schematów. Przy jawnym keszowaniu zakończ breakpoint na ostatnim niezmiennym bloku. Dodawaj materiały referencyjne, gdy pomagają w zadaniu; nie rozbudowuj każdego żądania tylko po to, by „gonić” metrykę cache.
Jeśli liczba keszowanych tokenów pozostaje równa zero
Sprawdź kwalifikowalność zanim zmienisz prompt: potwierdź dokładny model, endpoint, minimalną długość tokenów i wymagane ustawienia sterowania cache. Następnie wyślij dwa sekwencyjne żądania z identyczną treścią współdzieloną. Osobno sprawdź utworzenie cache i odczyty; pierwsze żądanie może utworzyć wpis, który później może zostać użyty ponownie. Cache implicytny może się kwalifikować do trafienia, ale nie jest ono gwarantowane.
W Claude żądanie poniżej minimum może zwrócić zero tokenów utworzenia i odczytu cache bez błędu. Wpis cache staje się dostępny, gdy zaczyna się pierwsza odpowiedź. Przewodnik po keszowaniu w Claude wyjaśnia również, jak umiejscowienie breakpointu i zmiana ustawień żądania wpływają na ponowne użycie.
Jeśli trafienia znikają między żądaniami
Porównaj rzeczywiste payloady, nie tylko szablon promptu. Szukaj zmienionego tekstu dokumentu, zmienionej kolejności narzędzi, zmodyfikowanych schematów, przepisanych wczesnych tur rozmowy lub dynamicznych pól wstawionych przed granicą ponownego użycia. Sprawdź czas, jaki upłynął od wcześniejszego żądania, i czy wybrany czas życia go obejmuje. Zmieniaj jedną zmienną naraz i zapisuj wynik usage.
Jeśli trafienia nie przynoszą oszczędności
Rozdziel składowe: keszowane wejście, zapisy, niekeszowane wejście, wyjście oraz ewentualne opłaty za przechowywanie. Powtarzające się zapisy po przerwach, niskie ponowne użycie lub długie generowane odpowiedzi mogą przeważyć zniżki na wejściu. Użyj powyższego wzoru kosztów z rzeczywistym usage i faktycznymi stawkami rozliczeń endpointu. Zachowaj optymalizację tylko wtedy, gdy poprawia całkowity koszt zadania lub widoczne dla użytkownika opóźnienie.
Sprawdź wsparcie endpointu i granice danych
Endpoint zgodności może przyjąć żądanie bez udostępniania tych samych sterowań cache lub pól usage co natywne API. Potwierdź obsługę parametrów i porównaj zwrócone usage z rozliczeniami konta, zanim potraktujesz ponowne użycie jako oszczędność. Utrzymuj izolację tenantów i kontrolę dostępu oraz stosuj polityki retencji i przetwarzania danych dostawcy. Keszowanie nie zastępuje tych mechanizmów.
Jak używać keszowania promptów z CometAPI?
CometAPI oferuje jeden punkt integracji do testowania żądań w różnych rodzinach modeli. W kontekście keszowania zweryfikuj, które sterowania specyficzne dla dostawcy obsługuje wybrany endpoint i jak skeszowane wejście pojawia się w usage i rozliczeniach. Deweloperzy mogą scentralizować testy modeli, zachowując osobną walidację zachowania cache i rozliczeń, ponieważ natywne opcje dostawców nie są gwarantowanie identyczne w proxy lub endpointach zgodności.
W przypadku konfiguracji specyficznych dla modeli zobacz strony CometAPI dla GPT-6.1 Sol, Claude Opus 5.5 i Gemini 4 Argon. Potwierdź, że wybrany endpoint obsługuje potrzebne zachowanie cache.
Zainstaluj SDK openai i ustaw COMETAPI_KEY. Ten przykład wysyła żądania z powtarzalnym prefiksem przez interfejs Chat Completions kompatybilny z OpenAI w CometAPI. Potwierdź dostępność modelu, a następnie sprawdź zwrócone usage i rozliczenia konta w poszukiwaniu dowodów na ponowne użycie cache. Nie kopiuj parametrów cache Responses API do tego endpointu bez weryfikacji wsparcia.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Streść architekturę.", "Zidentyfikuj główne ryzyka techniczne."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Zakończenie
W aplikacjach z dużą powtarzalnością keszowanie promptów może znacząco zmienić ekonomię inferencji. OpenAI daje deweloperom coraz bardziej szczegółową kontrolę nad promptem i retencją; Claude zapewnia wygodne sterowanie automatyczne i na poziomie bloków; Gemini upraszcza implicytne ponowne użycie w nowoczesnych modelach. Właściwa implementacja zależy od wolumenu stabilnego promptu, współczynnika trafień, wygaśnięć i łącznego kosztu. Zacznij od klarownego współdzielonego prefiksu, zweryfikuj telemetrię usage, a następnie optymalizuj retencję i wybór dostawcy na podstawie pomiarów zbliżonych do produkcyjnych.
FAQ
Jak uczciwie porównać dostawców keszowania?
Odtwarzaj te same użyteczne dokumenty źródłowe i równoważne pytania, ale używaj własnych liczników tokenów każdego dostawcy i faktycznych stawek rozliczeń. Utrzymaj porównywalne wymagania dotyczące wyjścia i raportuj nieudane żądania tak samo jak udane. Stała liczba znaków nie oznacza tej samej liczby tokenów, więc porównuj koszt na ukończone zadanie równolegle z pomiarem trafień cache.
Czy powinienem keszować każdy dokument w zmieniającej się bazie wiedzy?
Grupuj dokumenty według tego, jak często się zmieniają i jak często są ponownie używane. Często aktualizowany dokument może wielokrotnie unieważniać duży współdzielony prefiks; umieszczenie najpierw stabilnych materiałów polityk, a później zmieniających się treści może ograniczyć to ryzyko. Wersjonuj materiały źródłowe świadomie i odświeżaj je, gdy wymaga tego poprawność, nawet jeśli zmniejsza to ponowne użycie cache.