Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
Tencent Hunyuan wprowadziło Hyra 2.0 2 listopada 2026 jako badawcze Harness do rozwijania modeli naukowych, narzędzi programistycznych i wielokrotnego użytku przepływów pracy. Jego cechą wyróżniającą jest trwała koordynacja w ramach wielodniowych lub wielotygodniowych eksperymentów.
Obecne publiczne wydanie obejmuje wybrane artefakty badawcze — modele, kod, wagi i raporty — zamiast powszechnie dostępnej, hostowanej usługi Hyra 2.0. Na dzień 4 listopada 2026 publiczne materiały Tencent nie dokumentują ogólnego API orkiestracji ani planu subskrypcyjnego.
Najważniejsze wnioski
Cel badawczy: Hyra 2.0 rozwija wielokrotnego użytku modele i narzędzia naukowe, które mogą wspierać więcej niż jeden projekt badawczy.
Trwała koordynacja: Agenci Overall, Mission i Worker dzielą odpowiedzialności, a kolejki oraz zapisy badawcze zachowują postęp w długich eksperymentach.
Wielokrotnego użytku wiedza: Pamięć agentów, Books i umiejętności badawcze przechowują ustalenia wraz z ich dowodami i warunkami użycia.
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
Wyniki specyficzne dla zadań: Udostępnione modele białkowe, siłowe i komórkowe obsługują różne obciążenia naukowe; szybkość i jakość należy oceniać łącznie.
Praktyczny dostęp: Zacznij od dostępnych artefaktów badawczych. Kompletny Hyra Harness i hostowane API modeli Hunyuan to odrębne oferty.
Czym jest Tencent Hunyuan Hyra 2.0?
Hyra 2.0 oznacza Hunyuan Research Agent 2.0, wieloagentowy system zaprojektowany do automatyzacji złożonych naukowych i inżynieryjnych przepływów pracy.
Tencent przedstawia Hyra 2.0 jako przejście od rozwiązywania odosobnionych problemów do rozwijania modeli, metod i infrastruktury używanej do badania szerszej klasy pytań.
Hyra 2.0 nie jest samodzielnym modelem bazowym o stałej liczbie parametrów czy oknie kontekstowym. To system orkiestracji, który może używać różnych modeli AI, wykonywać kod, zarządzać eksperymentami naukowymi i koordynować wyspecjalizowanych agentów badawczych.
Badania naukowe obejmują więcej niż rozumowanie. Kompletny projekt może wymagać projektowania eksperymentów, implementacji, trenowania, debugowania, ewaluacji i wielokrotnych poprawek. Te działania mogą trwać kilka dni lub tygodni, często obejmując równoległe eksperymenty i współdzielone zasoby obliczeniowe.
Hyra 2.0 rozwiązuje to wyzwanie operacyjne poprzez połączenie inteligencji modeli z trwałym wykonaniem, ustrukturyzowaną współpracą i weryfikacją opartą na dowodach.
Specyfikacje techniczne Hyra 2.0
Specyfikacja
Hyra 2.0
Twórca
Tencent Hunyuan
Publiczne ogłoszenie
2 listopada 2026
Kategoria systemu
Autonomiczny agent badań naukowych
Główna architektura
Hierarchiczne, wieloagentowe Harness
Role agentów
Overall, Mission, Worker
Wykonywanie badań
Długotrwałe, równoległe przepływy pracy
Zarządzanie zadaniami
Trwała kolejka zadań
Współpraca
Research Board i komunikacja między agentami
Weryfikacja
Wyniki poparte dowodami i niezależni Review Workers
Pamięć
Stan projektu, warstwowa pamięć agentów, współdzielone Books
Ponowne wykorzystanie wiedzy
Zweryfikowane ustalenia i umiejętności wielokrotnego użytku
Elastyczność modeli
Różni Workers mogą używać różnych modeli bazowych
Środowiska badawcze
WeCom, platformy obliczeniowe, repozytoria kodu
Nadzór człowieka
Punkty kontrolne zatwierdzania dla operacji o istotnych skutkach
Publicznie dostępne artefakty
Wybrane modele, kod źródłowy, wytrenowane wagi, raporty techniczne
Specyfikacje systemu opisują jego możliwości orkiestracji i prowadzenia badań. Poszczególne modele naukowe stworzone przez Hyra 2.0 mają odrębne architektury, liczby parametrów i benchmarki wydajności.
Dlaczego Hyra 2.0 buduje narzędzia
Przejście z Hyra 1.0 do Hyra 2.0 odpowiada na podstawowe ograniczenie zautomatyzowanych badań: pomyślne rozwiązanie jednego problemu niekoniecznie poprawia zdolność systemu do rozwiązania następnego.
Hyra 1.0 używała relatywnie prostego cyklu agenta do generowania rozwiązań, uruchamiania ewaluacji i poprawy wyników poprzez powtarzane próby. Zasilana przez otwartoźródłowy model Hy3 Tencent, Hyra 1.0 pomogła rozstrzygnąć optymalny wykładnik łączący sumzbiory i zbiory różnicowe, a wraz z wynikiem opublikowano maszynowo sprawdzony dowód. Różnica ma znaczenie: oceniony wynik matematyczny jest konkretnym wyjściem, podczas gdy ulepszenie procesu badawczego może być używane ponownie w późniejszych problemach.
Następnym wyzwaniem jest sprawienie, by postęp badań się akumulował.
Od odpowiedzi do umiejętności wielokrotnego użytku
Rozważ trzy poziomy automatyzacji matematycznej:
Agent rozwiązuje pojedynczy problem matematyczny.
Agent opracowuje przepływ pracy dowodowy, który może rozwiązywać podobne problemy.
Agent ulepsza modele rozumowania i narzędzia weryfikacyjne używane przez przyszłe systemy badawcze.
Pierwszy wytwarza odpowiedź. Drugi wytwarza metodę wielokrotnego użytku. Trzeci może poprawić samą bazową zdolność badawczą.
Hyra 2.0 celuje w drugi i trzeci poziom.
Tencent opisuje dwie szerokie kategorie narzędzi wielokrotnego użytku. Symbolic tools wyrażają możliwości poprzez kod, algorytmy, reguły i przepływy pracy. Przykłady obejmują zautomatyzowane systemy weryfikacji, algorytmy wyszukiwania naukowego i potoki zarządzania eksperymentami. Parametric tools przechowują wyuczone możliwości w wagach modeli, w tym modele projektowania białek i naukowe modele bazowe.
Ulepszenie którejkolwiek kategorii może przynieść korzyści wielu zadaniom w dół strumienia bez konieczności rozpoczynania każdego projektu badawczego od tego samego punktu wyjścia.
Kierunek ku rekurencyjnemu samodoskonaleniu
Hyra 2.0 tworzy też ścieżkę ku rekurencyjnemu samodoskonaleniu. Badania nad modelami bazowymi zależą od infrastruktury treningowej, potoków danych syntetycznych, algorytmów optymalizacji i systemów inferencji.
Jeśli agenci AI ulepszają te narzędzia, mogą pomóc rozwijać silniejsze modele. Te silniejsze modele mogą następnie uczestniczyć w kolejnych rundach rozwoju narzędzi.
Lepsze narzędzia badawcze → silniejsze modele AI → bardziej kompetentni agenci badawczy → lepsze narzędzia badawcze.
Tencent opisuje zastosowanie Hyra do infrastruktury pretrenowania, generowania danych post-treningowych i optymalizacji inferencji. Tworzy to wiarygodną pętlę sprzężenia zwrotnego między rozwojem narzędzi a rozwojem modeli. Nie ustanawia to samo w sobie nieograniczonego ani w pełni autonomicznego, rekurencyjnego doskonalenia; każdy proponowany zysk nadal wymaga eksperymentu izolującego jego efekt.
Jak działa architektura Harness Hyra 2.0?
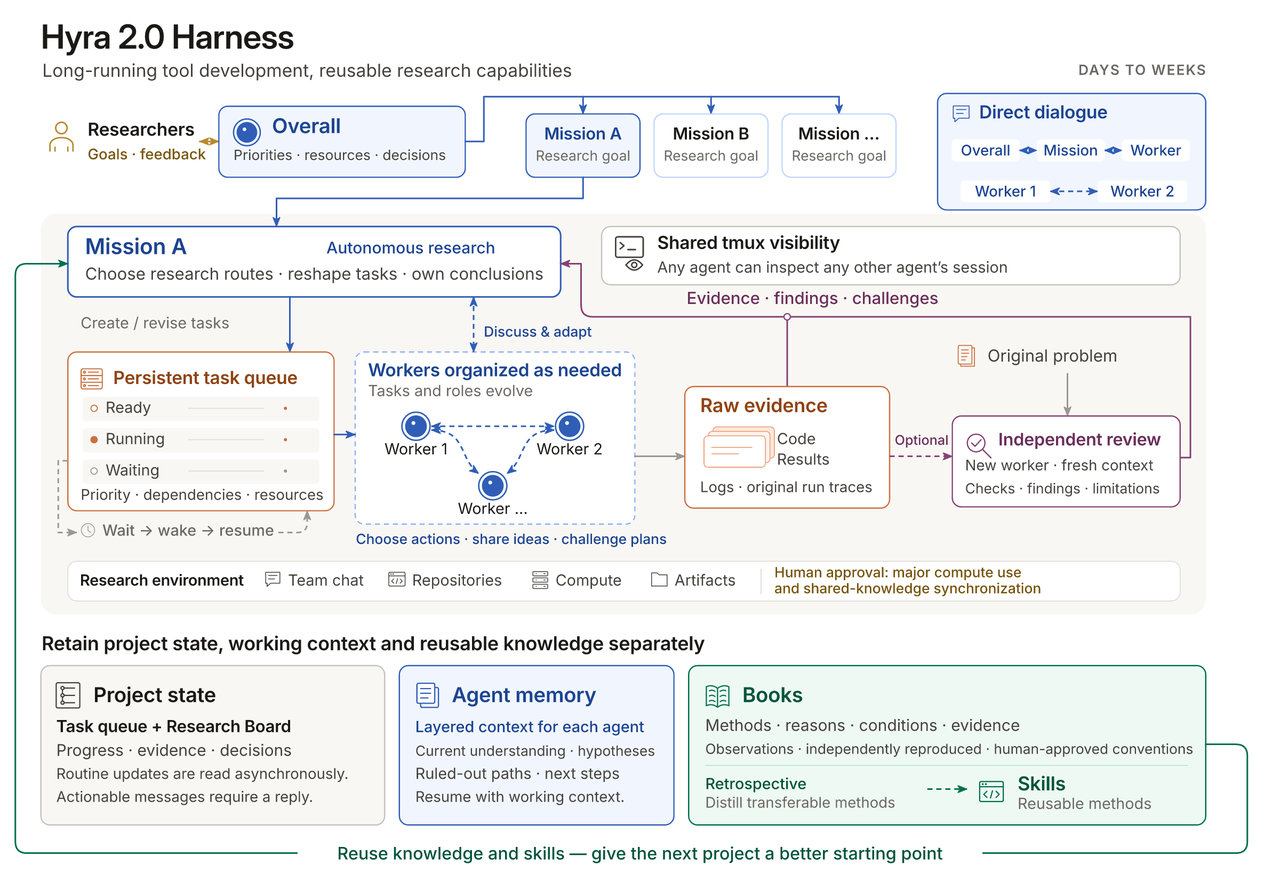
Harness jest centralną innowacją inżynieryjną Hyra 2.0. Konwencjonalny cykl agenta może wykonywać narzędzia, analizować wyniki i kontynuować rozumowanie w ramach sesji. Rozwój modeli naukowych wymaga bardziej zaawansowanego środowiska wykonawczego.
Eksperymenty mogą trwać godziny, zadania treningowe — dni, a odrębne kierunki badań mogą wymagać różnych zasobów obliczeniowych i metod walidacji. Hyra 2.0 odpowiada na te potrzeby dzięki trzem warstwom agentów, trwałemu planowaniu zadań, ustrukturyzowanym zapisom badawczym oraz niezależnej weryfikacji.
Overall to najwyższa warstwa koordynacji. Komunikuje się z badaczami, utrzymuje zgodność z celami badawczymi, zarządza priorytetami i koordynuje zasoby obliczeniowe.
Do jego obowiązków należy określanie, które projekty powinny otrzymać dodatkowe zasoby oraz identyfikowanie decyzji wymagających aprobaty człowieka. Overall pełni zatem rolę warstwy koordynacji między autonomiczną działalnością badawczą a zarządzaniem badaniami przez ludzi.
Mission: długoterminowe planowanie badań
Każda Mission odpowiada za konkretny problem badawczy. Mission utrzymuje kierunek badań przez wiele eksperymentów, organizuje Workers, interpretuje wyniki i decyduje, czy hipoteza zasługuje na dalsze badanie.
Decyduje też, kiedy podejście badawcze należy zmodyfikować lub porzucić. Tworzy to ciągłość w długotrwałym projekcie bez wymagania, by jedna sesja agenta zachowywała każdy pośredni krok.
Worker: wykonanie eksperymentów i niezależna eksploracja
Workers realizują wyspecjalizowane zadania badawcze. Do ich obowiązków należą czytanie kodu, implementacja algorytmów, uruchamianie eksperymentów, diagnozowanie błędów i proponowanie alternatywnych podejść.
Workers mogą kwestionować decyzje Mission, a różni Workers mogą korzystać z różnych modeli bazowych. Ta struktura wspiera równoległą eksplorację i zmniejsza zależność od jednego szlaku rozumowania agenta.
Trwałe planowanie i Research Board
Hyra 2.0 umieszcza zadania badawcze w trwałej kolejce. Planista uwzględnia priorytet zadań, zależności i dostępne zasoby przy uruchamianiu Workers.
Gdy jeden eksperyment czeka na wyniki treningu lub aprobatę człowieka, inne zadania mogą być kontynuowane. Agenci mogą też zaplanować swoje kolejne uruchomienie po zakończeniu eksperymentu.
Research Board zapisuje hipotezy, ustalenia, dowody i kluczowe decyzje. Oddziela to trwały stan projektu badawczego od pojedynczych konwersacji agentów.
Niezależna weryfikacja i aprobata człowieka
Wnioski Workers muszą być poparte dowodami eksperymentalnymi, takimi jak wersje kodu, logi wykonania, wyniki ewaluacji czy oryginalne ślady.
Gdy wynik wymaga dodatkowego zbadania, oddzielny Review Worker może niezależnie sprawdzić pierwotny problem i dowody. Pomaga to wykrywać niepoparte wnioski i błędy implementacyjne zanim wpłyną na dalsze badania.
Operacje o wysokich kosztach obliczeń i zmiany we współdzielonej wiedzy zespołu pozostają zależne od aprobaty człowieka. Architektura łączy więc autonomiczne wykonanie z wyraźnymi punktami kontrolnymi dla decyzji o dużych konsekwencjach.
Books: przekształcanie doświadczeń badawczych w umiejętności
Hyra 2.0 dzieli informacje na trzy kategorie magazynów:
Stan projektu: Kolejki zadań, zapisy współpracy i postęp badań.
Pamięć agentów: Bieżące zrozumienie, hipotezy, odrzucone podejścia i plany na przyszłość.
Books: Wielokrotnego użytku wiedza współdzielona między projektami badawczymi.
Books kategoryzuje informacje jako obserwacje, zweryfikowane ustalenia i konwencje. Pojedynczy eksperyment może dać obserwację. Niezależnie odtworzone ustalenia mogą stać się zweryfikowaną wiedzą. Konwencje wpływające na zachowanie zespołu wymagają potwierdzenia przez ludzi.
Podczas przeglądów projektów metody wielokrotnego użytku można przekształcić w umiejętności. Udana procedura weryfikacji numerycznej lub metoda diagnozowania niestabilności treningu może stać się wielokrotnego użytku komponentem przyszłych przepływów pracy badawczej.
Ten mechanizm pozwala systemowi zachowywać usprawnienia operacyjne poza pojedynczymi sesjami.
Jakie wyniki badawcze osiągnęła Hyra 2.0?
Początkowe wyniki Hyra 2.0 obejmują modele naukowe, badania matematyczne, obliczenia kwantowe, robotykę, analizę pojedynczych komórek i inżynierię sprzętu.
Oficjalne repozytorium badań zawiera wybrane implementacje, wagi, raporty i artefakty weryfikacyjne. Poniższy przegląd podsumowuje zgłoszone przez Tencent wyniki; kolejne podsekcje wyjaśniają ich warunki testowe i dostępność. Są to różne zadania naukowe, a nie pojedyncze zestawienie ogólnej zdolności agentów.
Wynik badawczy
Skala techniczna lub metryka
Zgłaszane osiągnięcie
HyInv
1.96M parametrów
57× szybsze generowanie sekwencji białkowych niż ProteinMPNN
HyPLM-Flash
650M parametrów; 726B tokenów treningowych
130 000 resydów/s na jednym H20; konkurencyjna jakość w 32 zadaniach
HyFF
Pięć modeli; 2.3M–1.2B parametrów
Granica Pareto dokładność–szybkość względem 16 publicznych modeli
HyCell
16.1M parametrów; osadzenia 512D
Łączny wynik 0.735 w siedmiu wydzielonych atlasach komórkowych
HyProver
Przepływ pracy dowodów matematycznych
Wyniki dotyczące hipotezy Petty’ego i hipotezy Yau o działaniu koła
HyQEC
Kod kwantowy [[488,123,22]]
Metryka efektywności 122.0; ok. 48% powyżej poprzedniego lidera wyzwania
Spiral Hand
Projekt dłoni z pięcioma palcami
28.6% szybsza rotacja obiektu w symulacji DR5
XiangShan RISC-V
Wydajność SPEC CPU2006
5.79% wyższy wynik na GHz przy wzroście powierzchni o 0.3%
Te wyniki pokazują wiele typów wyjść badawczych, a nie jeden wynik ogólnej zdolności agenta.
HyInv: 57× szybsze odwrotne składanie białek
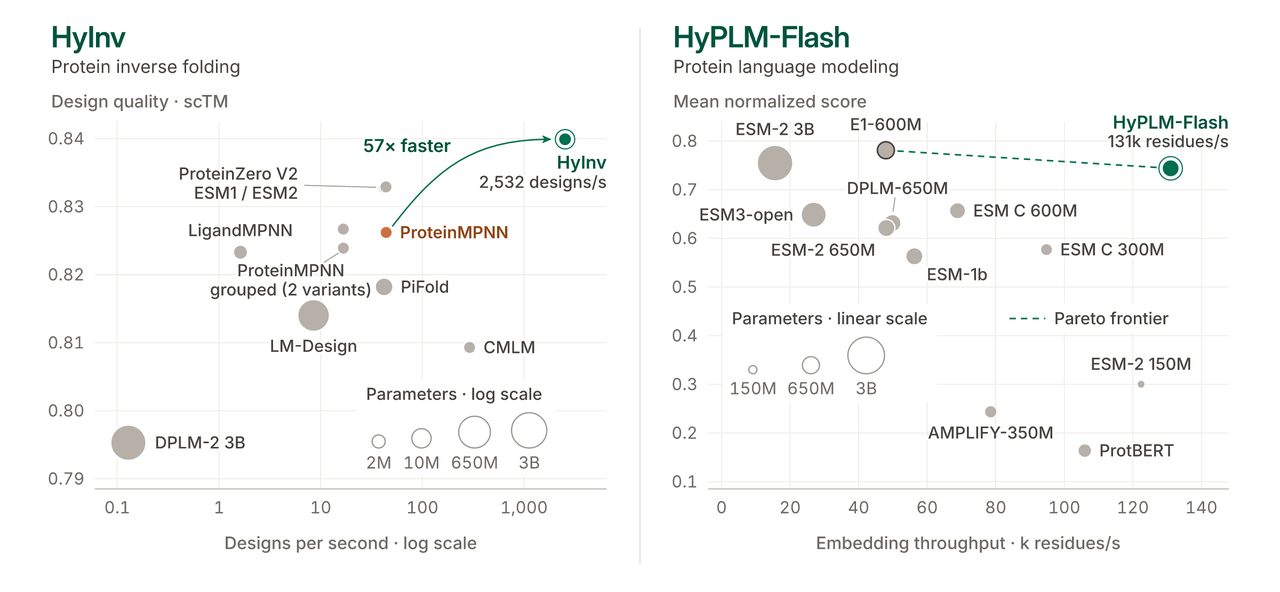
HyInv generuje sekwencje białkowe dla docelowego szkieletu. Jego model o 1.96M parametrach ma działać 57× szybciej niż ProteinMPNN. Zgłaszane 50.6 ms dla 128 projektów używa szkieletu 402-resydowego, jednego H20 i BF16, z wyłączeniem kompilacji i przechwytywania grafu CUDA. Traktuj to jako prędkość generowania po rozgrzaniu; odsiew strukturalny nadal wnosi istotny wkład do pełnego cyklu projektowego.
HyPLM-Flash: wysokoprzepustowe modelowanie języka białek
HyPLM-Flash to 650M-parametrowy językowy model białek wytrenowany na 726B tokenach. W udostępnionej ewaluacji 28 punktów kontrolnych i 32 zadań jego wynik ProteinGym był statystycznie porównywalny z podobnymi enkoderami. Inferencja INT8 osiąga ok. 130 000 resydów/s na jednym H20; BF16 jest preferowane, gdy niewielkie różnice reprezentacji wpływają na dalszą analizę. Poniższa grafika z premiery używa innego zakresu ewaluacji.
HyFF: szybsza symulacja molekularna w pięciu rozmiarach modeli
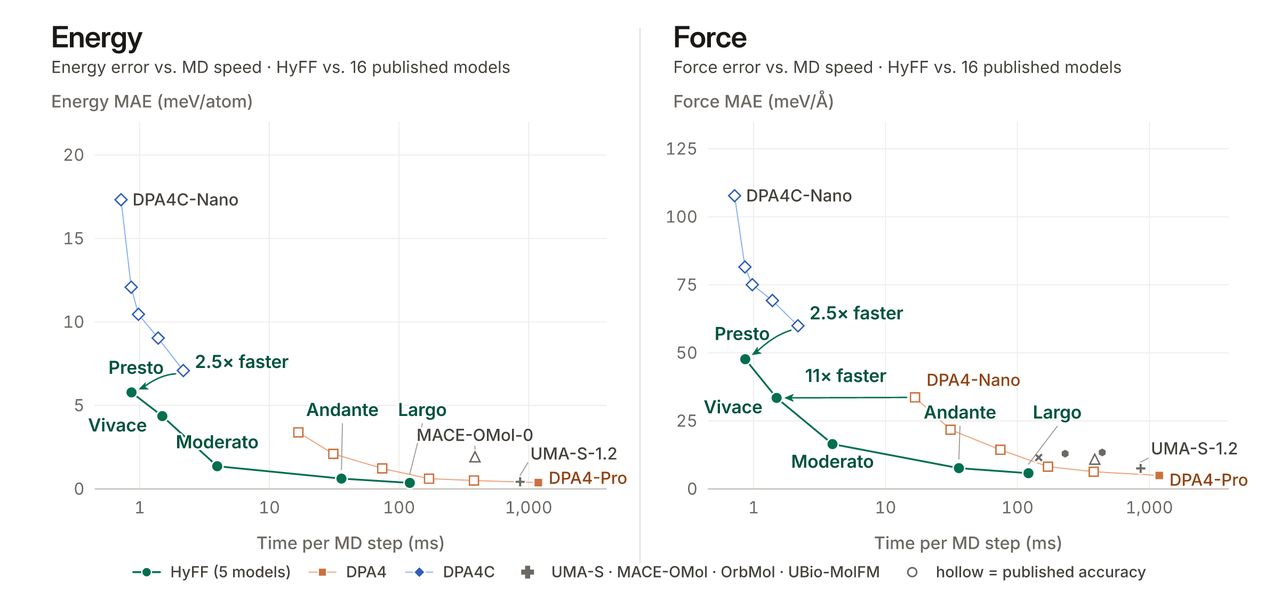
HyFF przewiduje energie molekularne i siły atomowe, z pięcioma rozmiarami modeli od 2.3M do 1.2B parametrów. W zgłoszonym porównaniu OMol25, Andante łączy podobny błąd siły co UMA-S-1.2 (7.65 vs 7.55 meV/Å) z 29× szybszą dynamiką molekularną. Largo zgłasza niższy błąd energii niż DPA4-Pro (0.364 vs 0.380 meV/atom) i 9.7× wyższą szybkość. Wybierz rozmiar, testując zarówno dokładność, jak i czas działania na cząsteczkach, które zamierzasz symulować.
HyCell: model osadzeń dla pojedynczych komórek
HyCell odwzorowuje zliczenia ekspresji genów komórek ludzkich do osadzeń 512-wymiarowych za pomocą modelu o 16.1M parametrach. W siedmiu wydzielonych atlasach komórkowych jego wynik łączny wynosi 0.735, blisko wartości Stack 0.736. Ten wynik łączy konserwację biologiczną, korekcję serii i transfer adnotacji; nie jest to dokładność klasyfikacji. Sprawdź metryki składowe istotne dla Twojego badania.
HyProver: przepływy pracy wielokrotnego użytku do badań matematycznych
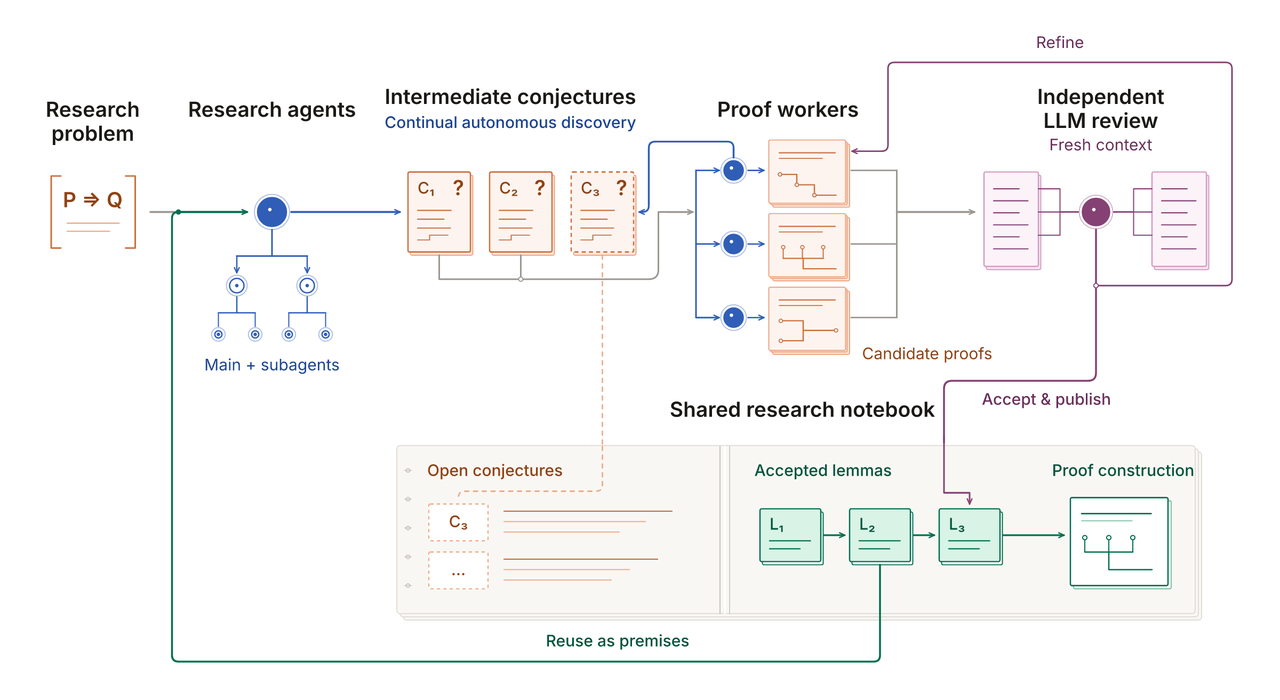
HyProver organizuje pracę matematyczną na eksplorację, rozwój dowodu i przegląd. Zgłoszone wyniki ustanawiają pięciowymiarowy przypadek hipotezy Petty’ego o zbiorach równobocznych i podają przeciwprzykład dla nieograniczonej formy hipotezy Yau dotyczącej działania koła. Wyniki te mają określone granice: hipoteza Petty’ego nie jest rozstrzygnięta we wszystkich wymiarach, a sformułowanie Yau o po prostu spójnej postaci pozostaje otwarte.
HyQEC: 48% poprawa efektywności kodu kwantowego
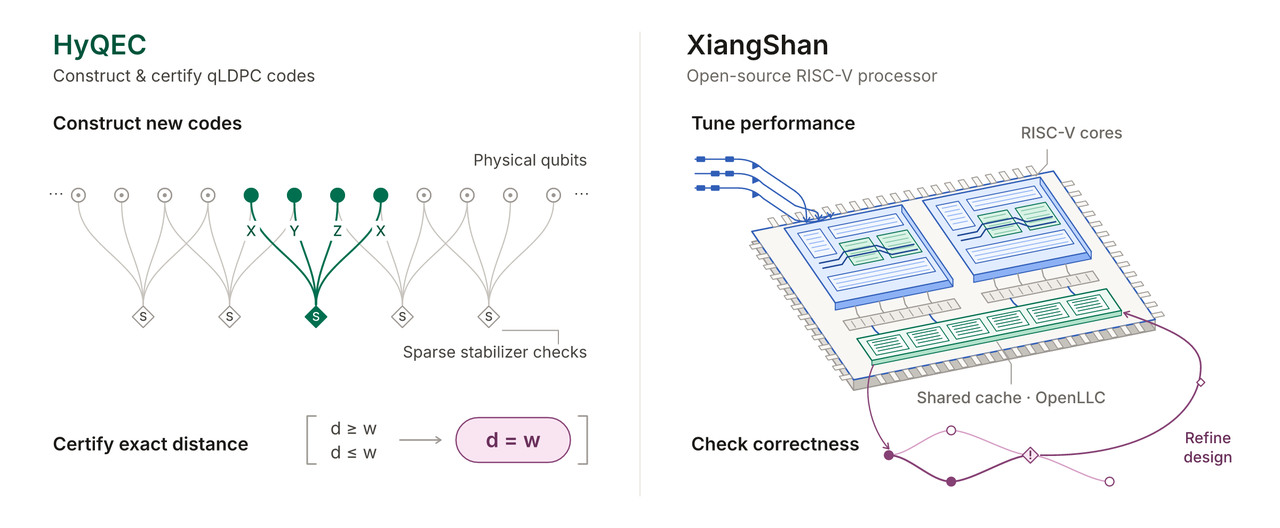
HyQEC poszukuje kwantowych kodów korekcji błędów i sprawdza ich odległości. Tencent zgłasza konstrukcję [[488,123,22]] z metryką efektywności kd²/n równą 122.0, ok. 48% powyżej poprzedniego lidera wyzwania w zadanych ograniczeniach. Mierzy to efektywność kodu, a nie wydajność sprzętu kwantowego. Według stanu na 5 listopada 2026, oficjalne wydanie zawiera narzędzia hyqec-verify i hyqec-check, ale nadal wymienia plik kodu i certyfikat dla tej konkretnej konstrukcji jako dowody do opublikowania. Publiczne narzędzia i publicznie odtwarzalne dowody dla konkretnego wyniku to odrębne kamienie milowe.
Spiral Hand: morfologia robotyczna zaprojektowana przez AI
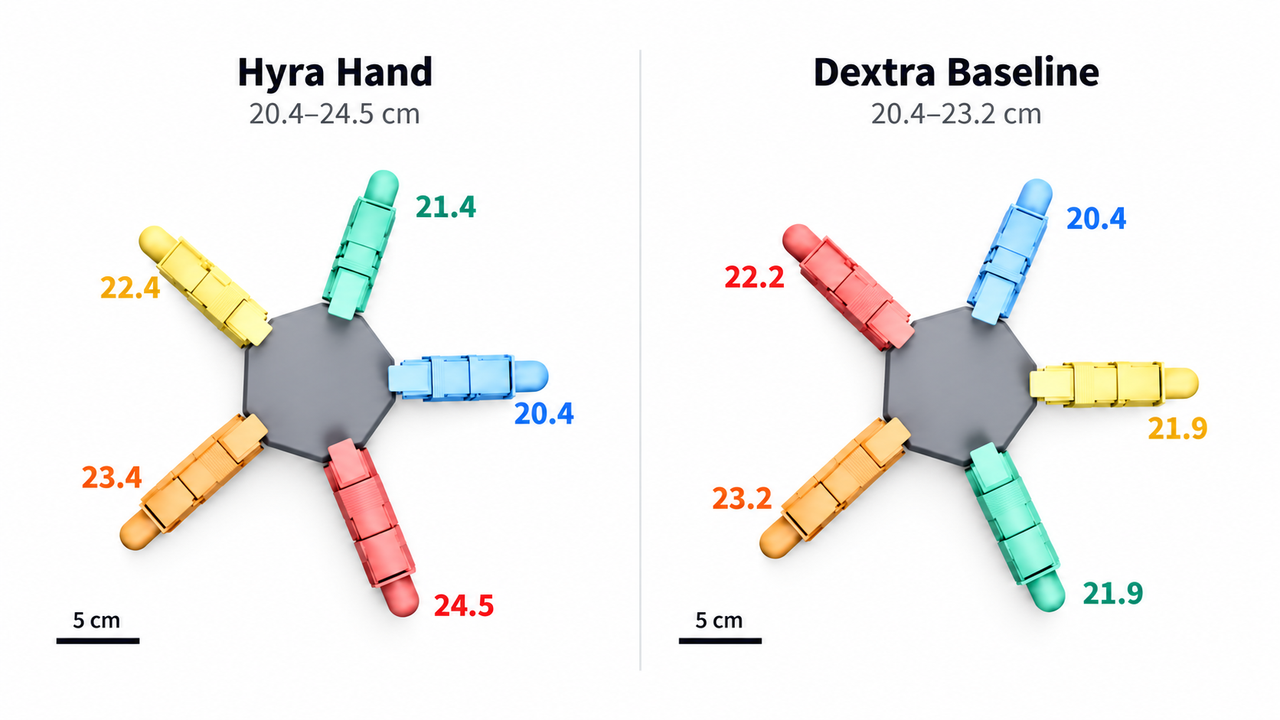
Spiral Staircase Hand Hyra używa stopniowo dłuższych palców wokół dłoni. Tencent zgłasza 28.6% szybszą rotację obiektu i 21% więcej ukończonych celów niż baza Dextra w symulacji DR5 po równych budżetach strojenia polityk. Walidacja na fizycznym sprzęcie pozostaje do wykonania.
XiangShan: optymalizacja procesora i weryfikacja formalna
Dla procesora XiangShan RISC-V Tencent zgłasza 5.79% poprawę wyniku SPEC CPU2006 na GHz, niezmienioną częstotliwość rdzenia i wzrost powierzchni o 0.3%. Praca wykryła też dziesięć wcześniej niezgłoszonych błędów i przeciwprzykład spójności cache. Te rezultaty dotyczą ocenianego projektu i obciążeń, a nie wszystkich systemów RISC-V.
Jak badacze powinni interpretować benchmarki Hyra 2.0?
Odczytuj każdy benchmark w kontekście jego własnego obciążenia. Porównuj te same wejścia, sprzęt, precyzję i granice pomiaru czasu, a następnie oceniaj jakość wyjścia razem z czasem działania. Dla twierdzeń naukowych sprawdź wspierający kod, dane, dowód lub certyfikat: zgłoszony wynik i niezależnie odtworzony wynik zapewniają różne poziomy dowodów.
Czy deweloperzy mogą używać Hyra 2.0 przez API?
Na dzień 4 listopada 2026 publiczne materiały Hyra opisują wyniki badań i wybrane wydania. Nie dokumentują ogólnie dostępnego API orkiestracji Hyra 2.0, ceny subskrypcji ani kompletnego pakietu wdrożeniowego. Ogłoszenie naukowe i artefakty do pobrania należy zatem odróżniać od hostowanego dostępu do pełnego systemu.
Publicznie dostępne materiały koncentrują się na wynikach badań i wybranych artefaktach. Deweloperzy mogą uzyskać dostęp do niektórych modeli stworzonych przez Hyra, w tym HyInv, HyPLM-Flash, HyFF i HyCell, poprzez powiązane repozytoria badawcze.
Kompletny Hyra 2.0 Harness należy odróżniać od tych artefaktów do pobrania.
Hyra 2.0 i hostowane API Hunyuan
Deweloperzy mogą uzyskać dostęp do Tencent Hy4 przez CometAPI używając identyfikatora modelu hy4. Zapewnia to hostowaną inferencję modelu dla zastosowań takich jak kodowanie, analiza i przepływy pracy agentów. Nie zapewnia kompletnego badawczego Hyra 2.0 Harness; modele naukowe rozwijane przez Hyra są dostępne oddzielnie poprzez repozytoria badawcze Tencent.
Co uczyniłoby Hyra 2.0 użytecznym w zespole badawczym?
Zacznij od jednego udostępnionego artefaktu i małego referencyjnego obciążenia. Gdy to działa, przetestuj reprezentatywne lokalne dane przy ustalonym progu jakości i budżecie obliczeniowym. Zachowaj razem rewizję repozytorium, wagi, środowisko, wejścia i wyjścia, aby współpracownicy mogli odtworzyć wynik. Dodaj trwałą wieloagentową koordynację, gdy długie oczekiwania, zależne eksperymenty lub konkurujące hipotezy czynią ją użyteczną.
Wnioski
Hyra 2.0 łączy planowanie badań, wykonanie eksperymentów i wiedzę wielokrotnego użytku w jednym trwałym przepływie pracy. Jej wyniki naukowe są obiecującym punktem wyjścia do dalszych prac. Dla zespołu badawczego praktycznym testem jest to, czy udostępniony artefakt usprawnia rzeczywisty eksperyment i wytwarza dowody, które inni mogą sprawdzić i odtworzyć.
FAQ
Jak laboratorium powinno zaplanować budżet na pierwsze testy artefaktu Hyra?
Zaplanuj budżet na trzy etapy: przygotowanie odtwarzalnego środowiska, uruchomienie małego przypadku referencyjnego oraz ewaluację reprezentatywnego lokalnego obciążenia. Uwzględnij czas przygotowania i przeglądu oraz użycie akceleratorów. Wybierz kryterium akceptacji przed rozpoczęciem, np. utrzymanie wymaganego poziomu jakości przy skróceniu czasu realizacji. Początkowy test powinien być na tyle mały, aby diagnozować awarie bez angażowania zasobów potrzebnych na pełną kampanię badawczą.
Co powinien zawierać pakiet reprodukowalności?
Zachowaj razem rewizję repozytorium, identyfikatory wag modelu, wersje środowiska, pochodzenie danych wejściowych, konfigurację, ziarna losowe tam, gdzie istotne, oraz wyniki ewaluacji. Zanotuj wszelkie zmiany względem opublikowanego przykładu. Gdy wynik opiera się na dowodzie lub certyfikacie, zachowaj wersję sprawdzacza i jego wyjście. Pakiet powinien pozwalać innemu badaczowi odróżnić problem programistyczny, zmienione wejście i rzeczywistą różnicę w wyniku naukowym.
Jak badacze mogą uniknąć zanieczyszczenia benchmarków?
Oddziel dane użyte do wyboru modeli lub strojenia ustawień od danych użytych do końcowej ewaluacji. Zamroź finalny protokół przed porównaniem kandydatów i udokumentuj wszelkie nakładanie się z danymi pretreningowymi lub rozwojowymi, które można ustalić. Dla nowych naukowych zbiorów danych używaj podziałów odzwierciedlających zamierzone środowisko wdrożenia, np. wydzielonego badania lub warunku eksperymentalnego. Silny wynik ma mniejszą wartość informacyjną, jeśli przykłady ewaluacyjne wielokrotnie kształtowały testowany system.
Jak zespoły powinny postępować ze sprzecznymi wnioskami agentów?
Porównuj leżące u podstaw eksperymenty zamiast łączyć wnioski przez głosowanie większościowe. Sprawdź, czy agenci użyli tej samej wersji zbioru danych, założeń, metryki i konfiguracji oprogramowania. Zachowaj oba ustalenia, dopóki różnica nie zostanie wyjaśniona, a potem uruchom ukierunkowany eksperyment rozstrzygający między konkurującymi wyjaśnieniami. Zgodność między agentami jest użyteczna, ale nie zastępuje zewnętrznych pomiarów ani sprawdzalnego argumentu.
Kiedy prostszy przepływ pracy badawczej jest korzystniejszy?
Krótki, deterministyczny task z dojrzałym skryptem i jasną ewaluacją może nie skorzystać na trwałej wieloagentowej koordynacji. Dodatkowe planowanie, prowadzenie zapisów i przegląd mogą kosztować więcej, niż przynoszą oszczędności. Wprowadź orkiestrację, gdy eksperymenty mają istotne zależności, długie oczekiwania, kilka konkurujących hipotez lub wyjścia wielokrotnego użytku wymagające stałego utrzymania. Decyzja powinna wynikać ze struktury obciążenia i obserwowanego kosztu koordynacji.