
Responda primeiro
GPT-6 Astra é o novo modelo carro-chefe da OpenAI para trabalhos difíceis ponta a ponta. A OpenAI lançou o GPT-6 Astra em 3 de setembro de 2026, posicionando-o para raciocínio complexo, uso de computador, codificação, pesquisa, trabalho científico e criação de artefatos profissionais. O modelo da API tem uma janela de contexto de 1,05M tokens e saída máxima de 128K, aceita entrada de texto e imagem e suporta esforço de raciocínio de baixo até máximo. A precificação padrão da API começa em $10 entrada / $50 saída por milhão de tokens. A mudança prática mais importante não é um salto uniforme em todos os benchmarks de inteligência geral: os maiores ganhos do Astra aparecem em execução agentiva, uso de computador, recuperação de longo contexto, fluxos de trabalho de codificação, ciência e cibersegurança.
Isso importa porque o artigo mais antigo da CometAPI GPT-6 Is Coming Soon — What Will It Look Like? era necessariamente especulativo. Agora que o Astra é público, este guia foca no comportamento confirmado do modelo, nas compensações em benchmarks, na economia da API e em onde o modelo é realmente uma escolha melhor do que alternativas de fronteira mais baratas.
O que é o GPT-6 Astra?
GPT-6 Astra é o sucessor do carro-chefe GPT-5.6 Sol da OpenAI. A OpenAI descreve o Astra como seu modelo mais capaz para os trabalhos ponta a ponta mais difíceis, com ênfase em fluxos de trabalho que exigem que o modelo raciocine, use ferramentas, interaja com software, revise trabalho intermediário e leve uma tarefa de um pedido inicial até um resultado finalizado. Esse posicionamento é importante: o Astra não é simplesmente um modelo de chat maior. Ele foi projetado para atuar como o motor de raciocínio dentro de agentes que trabalham em navegadores, terminais, documentos, planilhas, ambientes de desenvolvimento e software corporativo.
O post de lançamento destaca resultados de última geração em uso de computador, navegação, engenharia de software, cibersegurança, ciência e trabalho profissional. Ele relata 97,6% / 99,9% / 100% no FrontierMath Tier 4, ARC-AGI-3 e ExploitBench, respectivamente. Esses números de destaque são impressionantes, mas não devem ser interpretados como “Astra vence todos os benchmarks.” No Artificial Analysis Intelligence Index usado na própria tabela de comparação da OpenAI, o Astra marca 61,2 enquanto o Claude Fable 5.1 marca 65,7. Portanto, o lançamento deve ser entendido como uma mudança de patamar em execução e trabalho agentivo, e não como uma varredura limpa de todas as medidas de inteligência.
O que mudou em relação ao GPT-5.6 Sol?
O uso de computador tornou-se uma capacidade de primeira linha
O ganho geracional mais claro do Astra é o uso de computador. No OSWorld 2.0, a OpenAI relata 72,6% para o Astra versus 65,7% para o GPT-5.6 Sol. Na mesma simulação de latência, o Astra concluiu tarefas em cerca de 40 minutos em comparação com aproximadamente 75 minutos para o Sol, uma redução de cerca de 47%. Combinado com um ambiente do Codex atualizado, a OpenAI relata conclusão 1,9× mais rápida no Mind2Web. O ponto prático não é apenas que o Astra consegue ver uma tela; ele consegue manter uma tarefa de software multietapas coerente por mais tempo, cometendo menos desvios custosos.
A criação de artefatos profissionais é mais deliberada
A OpenAI treinou explicitamente o Astra para fluxos de trabalho profissionais que terminam em artefatos utilizáveis em vez de prosa bruta. Os materiais de lançamento descrevem desempenho mais forte em documentos, planilhas, apresentações, análise de dados, trabalho de design e aderência a templates. O Astra também é melhor em manter a orientação à medida que os requisitos mudam no meio da tarefa, de modo que uma mensagem de direcionamento tem menos probabilidade de sobrescrever o objetivo original. Isso é particularmente útil em agentes corporativos de longa duração, onde novas instruções costumam chegar depois que o fluxo de trabalho já começou.
Sessões longas retêm mais contexto de trabalho útil
Para sessões longas de codificação, o Astra introduz uma nova forma de o Codex preservar e recuperar anotações depois que o contexto ativo enche. Abordagens anteriores dependiam fortemente de compactação, o que pode omitir por que uma correção tentada falhou ou quais restrições já foram testadas. A OpenAI diz que o Astra pode manter anotações através de janelas de contexto, melhorando a continuidade durante grandes refatorações e sessões de depuração.
O esforço de raciocínio agora vai até o máximo
Desenvolvedores podem escolher esforço de raciocínio baixo, médio, alto, muito alto ou máximo. Isso cria uma curva de qualidade-custo mais ampla do que tratar o Astra como um único ponto operacional fixo. A orientação oficial do modelo recomenda selecionar o menor esforço que atenda à sua meta de avaliação, porque a melhor economia do modelo muitas vezes vem da eficiência de tokens em vez de sempre rodar no raciocínio máximo.
Desempenho do GPT-6 Astra em benchmarks
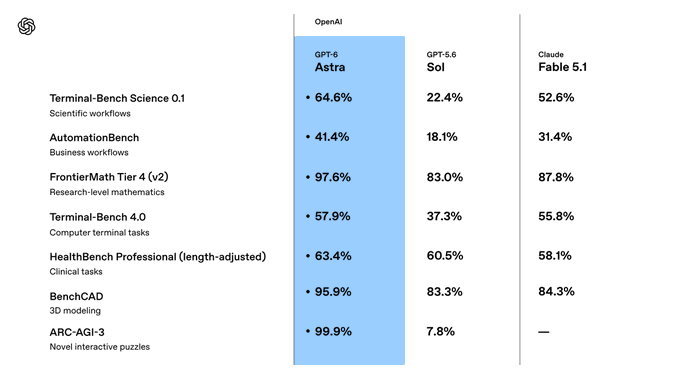
A OpenAI publicou uma comparação ampla abrangendo uso de computador, trabalho profissional, codificação, raciocínio acadêmico, saúde, cibersegurança, longo contexto e alinhamento. A maneira mais útil de ler a tabela é separar “inteligência geral” de “capacidade de completar trabalho usando ferramentas”. O Astra está apenas marginalmente acima do Sol no Artificial Analysis Intelligence Index na tabela da própria OpenAI, mas está muito à frente em vários benchmarks agentivos e operacionais.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | O que o delta sugere |
|---|---|---|---|
| AutomationBench | 41,4% | 18,1% | Grande ganho em fluxos de trabalho de negócios E2E |
| OSWorld 2.0 | 72,6% | 65,7% | Melhor interação com computador e conclusão de tarefas |
| Terminal-Bench 4.0 | 57,9% | 37,3% | Grande ganho em codificação agentiva via terminal |
| Terminal-Bench Science 0.1 | 64,6% | 22,4% | Grande ganho em fluxos científicos com código/ferramentas |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | Raciocínio matemático de fronteira mais forte |
| ExploitBench | 100,0% | 78,5% | Capacidade crítica de cibersegurança |
| SRE-Bench, uma tentativa | 88,0% | 55,9% | Engenharia reversa / SRE muito mais forte |
| MRCR v2, 512K-1M | 96,3% | 73,8% | Recuperação de contexto muito longo aprimorada |
| AA Intelligence Index v4.1.1 | 61,2 | 60,9 | Inteligência geral essencialmente estável vs Sol |
O padrão é incomumente claro. A vantagem do Astra é maior quando um benchmark exige interação sustentada com uma ferramenta ou ambiente. AutomationBench sobe de 18,1% para 41,4%; o Terminal-Bench Science aumenta de 22,4% para 64,6%; e o MRCR de longo contexto melhora de 73,8% para 96,3% na faixa de 512K–1M. Em contraste, o Artificial Analysis Intelligence Index vai de 60,9 para 61,2. É por isso que descrever o Astra como “2,5× mais caro, porém um pouco mais inteligente” perde a proposta de valor real do produto.
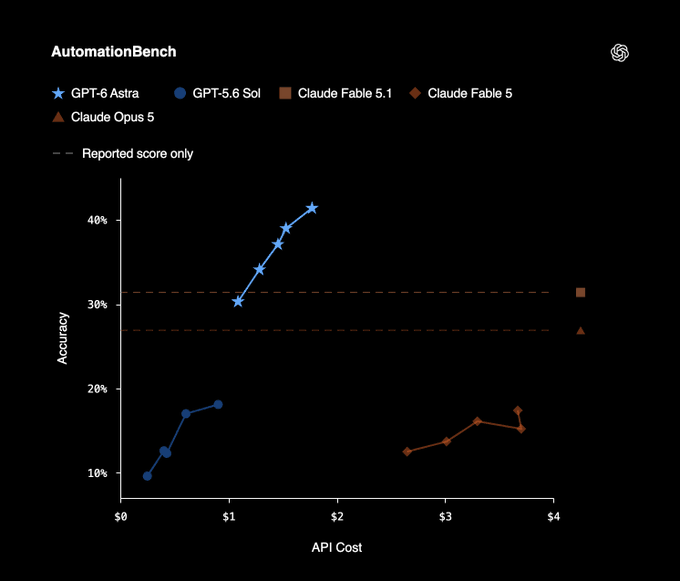
Fonte: Gráfico do OpenAI AutomationBench (imagem original, não redesenhada)
Benchmarks independentes: o GPT-6 Astra é um salto geracional?
Testes independentes acrescentam um controle de realidade importante. A Artificial Analysis relata um Intelligence Index de 61, igual ao GPT-5.6 Sol em esforço máximo. Ao mesmo tempo, o Astra melhora bastante no Coding Agent Index e usa substancialmente menos tokens em codificação agentiva. A Artificial Analysis mediu cerca de uma redução de três vezes no uso de tokens versus o GPT-5.6 Sol em esforço máximo em seu ambiente do Codex, permitindo ao Astra pontuar mais alto a aproximadamente o mesmo custo por tarefa de agente de codificação.
A economia parece menos favorável em inteligência geral. O Astra usa cerca de 10% menos tokens de saída do que o Sol no Intelligence Index em esforço máximo, mas o aumento de 2,5× no preço por token domina esse ganho de eficiência; a Artificial Analysis estima que o Astra seja cerca de 75% mais caro por tarefa em esforço máximo. Ela também relata uma redução de taxa de alucinações de 92% para 51% no AA-Omniscience enquanto a precisão aumentou em quatro pontos.
A conclusão útil é específica ao tipo de carga: o GPT-6 Astra parece mais geracional onde um agente precisa agir, iterar, usar ferramentas e terminar um trabalho complicado. Para raciocínio comum ou geração de texto em alto volume, o prêmio de preço pode ser muito mais difícil de recuperar.
GPT-6 Astra vs GPT-5.6 Sol vs Claude Fable 5.1 vs Gemini 3.8 Flash
Uma comparação prática de seleção de modelo deve incluir capacidade, multimodalidade, contexto, execução agentiva e preço. Os modelos abaixo não são intercambiáveis: o Astra otimiza para execução difícil ponta a ponta, o Claude Fable 5.1 lidera algumas medidas de inteligência geral e o Gemini 3.8 Flash oferece preços de token muito mais baixos com modalidades de entrada nativas mais amplas.
| Métrica | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Gemini 3.8 Flash |
|---|---|---|---|---|
| Janela de contexto | 1,05M | 1,05M | 1M | 1,048M |
| Saída máxima | 128K | 128K | 128K | 65,5K |
| Modalidades de entrada | Texto, imagem | Texto, imagem | Texto, imagem/PDF | Texto, imagem, áudio, vídeo, PDF |
| Artificial Analysis Intelligence Index | 61,2 | 60,9 | 65,7 | 58,7 |
| AutomationBench | 41,4% | 18,1% | 31,4% | — |
| Terminal-Bench 4.0 | 57,9% | 37,3% | 55,8% | 19,1% |
| DeepSWE 1.1 | 74,1% | 72,7% | 67,4% | 73,8% |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | 87,8% | — |
| HLE com ferramentas | 57,2% | — | 65,0% | — |
| HealthBench Professional | 63,4% | 60,5% | 58,1% | 52,1% |
| Preço oficial padrão de entrada | $10/M | $4/M | $10/M | $0,75/M |
| Preço oficial padrão de saída | $50/M | $20/M | $50/M | $3,75/M |
Quando o GPT-6 Astra é a melhor escolha
Escolha o Astra quando a tarefa é cara porque humanos precisam resgatar execuções de agentes que falham: grandes mudanças em código, automação de navegador/desktop, pesquisa profunda que abrange ferramentas, criação de artefatos técnicos ou fluxos de trabalho científicos e operacionais complexos. Seu prêmio é mais fácil de justificar quando menos tentativas, menos correções manuais e menor uso de tokens de saída importam mais do que o preço por token bruto.
Quando o Claude Fable 5.1 é a melhor escolha
O Claude Fable 5.1 continua sendo um concorrente de fronteira sério. Na própria tabela de lançamento da OpenAI, ele marca 65,7 no Artificial Analysis Intelligence Index versus 61,2 do Astra, e 65,0 no Humanity’s Last Exam com ferramentas versus 57,2 do Astra. Isso significa que o Astra não deve ser comercializado como um vencedor universal de inteligência. Se o seu conjunto de avaliação se assemelha mais a raciocínio de longa forma do que a execução de uso de computador, Claude Fable 5.1 pode ainda ser o ajuste mais forte.
Quando o Gemini 3.8 Flash é a melhor escolha
O Gemini 3.8 Flash mira um ponto diferente na fronteira. Ele suporta entrada de texto, imagem, áudio, vídeo e PDF com uma janela de contexto de cerca de 1M tokens, enquanto o preço introdutório oficial é muito inferior ao do Astra. Para extração multimodal em alto volume, entendimento de vídeo/áudio, agentes de rotina ou cargas de trabalho onde a economia de tokens de $10/$50 é difícil de justificar, o Gemini 3.8 Flash é frequentemente a escolha de produção mais econômica.
Por que a classificação de cibersegurança do GPT-6 Astra importa
O Astra é o primeiro modelo amplamente implantado da OpenAI a atingir o limiar de capacidade crítica de cibersegurança sob o Preparedness Framework da empresa. A OpenAI diz que o modelo pode identificar falhas de segurança previamente desconhecidas e desenvolver estratégias de exploração em sistemas reforçados quando recebe as ferramentas e o acesso corretos. Nas avaliações de lançamento, o Astra marcou 100% no ExploitBench, 42,4% no ExploitGym e 88,0% no SRE-Bench em uma tentativa.
Essa capacidade vem com controles de implantação mais rígidos. A OpenAI diz que salvaguardas de produção podem retardar, pausar ou interromper trabalho legítimo, particularmente em contextos cibernéticos de maior risco. O ChatGPT ou o Codex podem pedir a um usuário para revisar uma ação antes de continuar, enquanto uma tarefa de API pode parar. A implantação padrão do Astra também recusa solicitações de criação de exploits mais avançadas; o programa Daybreak fornece acesso separado e verificado para alguns fluxos de trabalho defensivos.
O system card documenta uma compensação de monitorabilidade: o Astra é mais alinhado no geral do que o Sol, mas seu raciocínio escrito pode ser mais difícil de monitorar sob condições de avaliação adversárias. Portanto, a OpenAI implanta monitoramento de desalinhamento mais amplo em torno da inferência do Astra usando ferramentas. Equipes corporativas devem tratar permissões de agentes, limites de aprovação, logs de auditoria e acesso a ferramentas com privilégios mínimos como parte da arquitetura do modelo, e não como complementos opcionais.
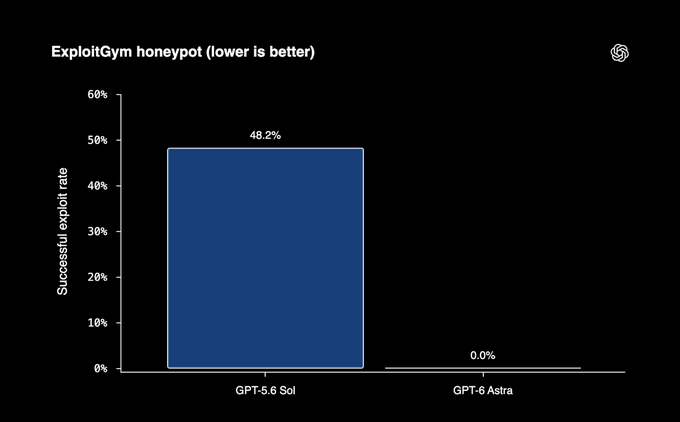
Fonte: Gráfico oficial de segurança do honeypot ExploitGym da OpenAI (imagem original, não redesenhada)
Preços do GPT-6 Astra
A página atual de preços da API da OpenAI separa solicitações de curto e longo contexto. Para Processamento Padrão, as tarifas de contexto curto são $10 de entrada, $1 de entrada em cache, $12,50 para gravações de cache e $50 de saída por milhão de tokens. Solicitações acima de 272K tokens de entrada usam a tabela de longo contexto: $20 de entrada, $2 de entrada em cache, $25 para gravações de cache e $75 de saída por milhão de tokens.
| Processamento / contexto | Entrada | Entrada em cache / gravação no cache | Saída |
|---|---|---|---|
| Padrão, contexto curto | $10/M | $1/M / $12,50/M | $50/M |
| Padrão, longo contexto (>272K entrada) | $20/M | $2/M / $25/M | $75/M |
| Batch / Flex, contexto curto | $5/M | $0,50/M / $6,25/M | $25/M |
| Batch / Flex, longo contexto | $10/M | $1/M / $12,50/M | $37,50/M |
| Modo rápido, contexto curto | $20/M | $2/M / $25/M | $100/M |
| Modo rápido, longo contexto | $40/M | $4/M / $50/M | $150/M |
Comparado ao GPT-5.6 Sol, os preços de token Padrão de contexto curto do Astra são 2,5× mais altos ($10/$50 versus $4/$20). Esse prêmio não significa automaticamente um custo de tarefa concluída 2,5× maior. Em codificação agentiva, a OpenAI e a Artificial Analysis relatam menor uso de tokens de saída para o Astra em algumas configurações. A unidade correta para avaliação é, portanto, custo por tarefa bem-sucedida, não apenas custo por token.
Como acessar o GPT-6 Astra
A OpenAI iniciou um lançamento escalonado em 3 de setembro de 2026. O Astra está programado para chegar aos usuários do ChatGPT Plus, Pro, Business e Enterprise, à OpenAI API e à AWS nos dias seguintes. Administradores corporativos podem habilitar o Astra por workspace, e o acesso está desativado por padrão no lançamento.
Chame o GPT-6 Astra com a OpenAI Responses API
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "Analise a arquitetura deste repositório. Identifique o problema "
        "de design de maior risco, explique as evidências e proponha um "
        "plano de migração."
    ),
)

print(response.output_text)
O ID do modelo é gpt-6-astra. Para fluxos de trabalho pesados em ferramentas, a Responses API é o ponto de partida natural porque o Astra suporta chamada de função, saídas estruturadas, pesquisa na web, pesquisa em arquivos, interpretador de código, shell hospedado, aplicar patch, uso de computador, MCP e busca de ferramentas. O ajuste fino (fine-tuning) não é suportado no momento.
Casos de uso reais do GPT-6 Astra
Desenvolvimento de jogos e fluxos de trabalho de software visual
A Playco testou o Astra dentro do Playbot, um IDE com IA que funciona diretamente no Unity e no Godot. A OpenAI relata 50% menos correções manuais do que com o modelo anterior, e três protótipos temáticos construídos a partir de uma única base cinza. Este exemplo importa porque a tarefa exige mais do que geração de código-fonte: o modelo precisa raciocinar sobre layout espacial, jogar o jogo, testar mudanças, identificar bugs e iterar dentro de um ambiente visual.
Revisão de documentos jurídicos e financeiros
A OpenAI posiciona o Astra para fluxos de trabalho profissionais multietapas que produzem documentos, planilhas e análises polidas. Em revisão jurídica e financeira, seu valor prático é manter o estado da tarefa em muitos arquivos, conferir evidências cruzadas e retornar um artefato finalizado em vez de responder a uma pergunta isolada. Validação por especialista, controles de aprovação e acesso a dados com privilégios mínimos continuam necessários.
Agentes de engenharia de longo horizonte
A combinação de resultados no Terminal-Bench, DeepSWE, migração de bancos de dados, uso de computador e longo contexto torna o Astra especialmente relevante para engenharia em escala de repositório. Um padrão de implantação útil é dar ao Astra um ambiente de desenvolvimento restrito, um objetivo de issue ou migração, testes e acesso a ferramentas; depois avaliar o sucesso na qualidade da tarefa mesclada, número de iterações falhas, tempo de revisão humana e custo total. Esta é uma métrica de produção melhor do que um único score de benchmark de codificação.
Limitações do GPT-6 Astra
- Preço de token premium. O Astra custa 2,5× o GPT-5.6 Sol por token no preço Padrão de contexto curto, portanto chat de rotina, classificação, extração e redação simples muitas vezes são antieconômicos.
- Longo contexto tem sobretaxa. Solicitações com mais de 272K tokens de entrada passam para tarifas mais altas para a solicitação inteira, então “contexto de 1,05M” não deve ser interpretado como memória de preço plano.
- Sem entrada nativa de áudio ou vídeo no modelo. O Astra aceita texto e imagens e produz texto; o Gemini 3.8 Flash é mais flexível quando o entendimento nativo de áudio/vídeo é central à carga de trabalho.
- Sem ajuste fino. A página oficial do modelo atualmente lista o ajuste fino como não suportado, então a personalização depende de prompt, ferramentas, recuperação e design de fluxo de trabalho.
- Salvaguardas cibernéticas podem interromper fluxos de trabalho. A OpenAI alerta explicitamente que verificações de segurança adicionais podem pausar ou interromper trabalho legítimo em contextos de maior risco.
- Não é um vencedor universal de benchmarks. O Claude Fable 5.1 lidera o Astra no Artificial Analysis Intelligence Index e em HLE-com-ferramentas incluídos na comparação de lançamento publicada pela OpenAI.
Perguntas frequentes
O GPT-6 Astra foi lançado oficialmente?
Sim. A OpenAI iniciou o lançamento em 3 de setembro de 2026. A disponibilidade é escalonada entre organizações, planos pagos do ChatGPT, acesso à API e AWS, em vez de aparecer para todas as contas ao mesmo tempo.
Qual é a janela de contexto do GPT-6 Astra?
A página oficial do modelo lista uma janela de contexto de 1,05M tokens e saída máxima de 128K tokens. Solicitações acima de 272K tokens de entrada usam a tabela de preços de longo contexto.
Quanto custa o GPT-6 Astra?
A precificação padrão de contexto curto é de $10 entrada / $50 saída por milhão de tokens, com $1 de entrada em cache e $12,50 para gravações de cache. Longo contexto, Batch/Flex e Modo rápido têm tarifas diferentes, então estimativas de produção devem usar a faixa correspondente à solicitação real.
O GPT-6 Astra é melhor do que o Claude Fable 5.1?
Depende da carga de trabalho. O Astra lidera em várias avaliações de uso de computador, agentes de código, ciência, ciber e trabalho profissional, enquanto o Claude Fable 5.1 lidera o Astra no Artificial Analysis Intelligence Index e no HLE com ferramentas na comparação publicada pela OpenAI. Use suas próprias avaliações de agente/tarefa em vez de supor que um modelo domina todas as categorias.
O GPT-6 Astra é AGI?
As páginas oficiais de produto da OpenAI descrevem o Astra como uma nova geração de inteligência e seu modelo mais capaz amplamente implantado, mas não definem o produto em si como “AGI”. Saturação de benchmarks em algumas tarefas não equivale a uma definição universal e pacífica de AGI.
Conclusão
O GPT-6 Astra deve ser entendido como um modelo de fronteira focado em execução. Sua evidência mais forte de progresso não é o pequeno movimento de 60,9 para 61,2 versus o GPT-5.6 Sol no Artificial Analysis Intelligence Index; é a melhoria muito maior em uso de computador, codificação agentiva, fluxos científicos, recuperação de longo contexto, conclusão de tarefas profissionais e cibersegurança. A janela de contexto de 1,05M e o stack profundo de ferramentas dão aos desenvolvedores mais espaço para construir agentes que permaneçam úteis além de uma única resposta.
A compensação é o preço. O preço Padrão de $10/$50 é premium, solicitações de longo contexto custam mais, e testes independentes mostram que o Astra pode ser significativamente mais caro do que o Sol em cargas de trabalho de inteligência geral. O modelo ganha esse prêmio quando melhores taxas de conclusão e menor correção humana superam o custo de tokens. Para cargas mais simples ou de alto volume, GPT-5.6, Claude Fable 5.1 e especialmente Gemini 3.8 Flash continuam sendo alternativas relevantes, e não predecessores obsoletos.