Краткое резюме
GPT-6.1 Sol — это не модель с большим контекстом и не более дорогая замена GPT-6 Sol. Она сохраняет то же окно контекста на 1.05 млн токенов, максимум вывода 128K и стандартные цены API $2/$10, при этом улучшая кодирование, работу за компьютером, профессиональные рабочие процессы, фактическую надежность и поведение агентов. Самое очевидное изменение в ценообразовании — кэширование промптов: кэшированный ввод снижен с $0.20 до $0.10 за миллион токенов.
Практический результат в том, что GPT-6.1 Sol меньше меняет форму API и больше — дает существенно больше полезной работы при примерно том же бюджетe токенов.
Ключевые выводы
- GPT-6.1 Sol — это обновление возможностей GPT-6 Sol, с тем же окном контекста на 1,050,000 токенов и потолком вывода 128,000 токенов.
- Стандартные цены на ввод и вывод остаются $2/M и $10/M; кэшированный ввод снижается с $0.20/M до $0.10/M.
- Официальные оценки показывают усиление в кодинге, работе за компьютером, бизнес-автоматизации и научных рабочих процессах; результаты зависят от бенчмарка и режима reasoning.
- Для миграции требуется проверить и усилие рассуждения, и совместимость конечной точки API: GPT-6.1 Sol ничего не удаляет, но требует Responses API для вызова инструментов.
- Перед заменой стабильной GPT-6 Sol-постановки валидируйте успешность задач, задержку, фактические попадания в кэш и сквозную стоимость.
Что такое GPT-6.1 Sol и почему она вышла так скоро после GPT-6 Sol?
OpenAI представила GPT-6 Sol 22 сентября 2026 года. Неделей позже, 29 сентября, ее добавление к системной карте объявило GPT-6.1 Sol. OpenAI позиционирует новый релиз как обновление GPT-6 Sol, а не как отдельный тариф.
Короткий интервал релиза важен, потому что GPT-6.1 Sol не позиционируется как новый продуктовый уровень. OpenAI сохранила уровень Sol и сосредоточила обновление на сложных задачах, эффективности затрат и надежности агентов.
OpenAI позиционирует GPT-6.1 Sol вокруг агентного кодирования, компьютерной работы и профессиональных задач. Важное сравнение — успех задачи при заданной стоимости, а не только название модели. Официальный сводный бенчмарк ниже отделяет приросты возможностей от неизмененных спецификаций API.
Таким образом, сравнение необычно прямолинейно: GPT-6.1 Sol — это прежде всего обновление возможностей и эффективности, а не окна контекста или базовой цены.
GPT-6.1 Sol vs. GPT-6 Sol: что остается неизменным?
Обе модели сохраняют одинаковую емкость по заголовкам, поддерживаемые режимы ввода/вывода и цены Standard на ввод/вывод. Таблица также фиксирует различия в датах отсечки, опциях reasoning, вызове инструментов и ставках кэшированного ввода; эти различия не следует путать с общими спецификациями.
Общие спецификации и различия совместимости
| Спецификация | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Идентификатор модели | gpt-6.1-sol | gpt-6-sol |
| Дата релиза | 29 сент. 2026 | 22 сент. 2026 |
| Окно контекста | 1,050,000 tokens | 1,050,000 tokens |
| Максимальный вывод | 128,000 tokens | 128,000 tokens |
| Отсечка знаний | 30 апр. 2026 | 20 апр. 2026 |
| Текст: ввод/вывод | Да / Да | Да / Да |
| Ввод изображений | Да | Да |
| Цена ввода Standard | $2.00 / 1M | $2.00 / 1M |
| Кэшированный ввод | $0.10 / 1M | $0.20 / 1M |
| Запись в кэш | $2.50 / 1M | $2.50 / 1M |
| Цена вывода | $10.00 / 1M | $10.00 / 1M |
| Усилие рассуждения | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Структурированные выводы | Да | Да |
| Вызов функций | Да через Responses API; недоступен через Chat Completions | Да через Responses API; Chat Completions только при reasoning_effort=none |
| Тонкая настройка | Нет | Нет |
| Аудио/видео ввод | Не поддерживается | Не поддерживается |
| Родной вывод изображений | Не поддерживается; генерация изображений — отдельный инструмент | Не поддерживается; генерация изображений — отдельный инструмент |
Две официальные колонки моделей выше фиксируют одинаковые лимиты контекста и вывода. Эти числа описывают емкость; они не гарантируют равную точность извлечения или задержку для каждой задачи с длинным контекстом.
Отсечка знаний немного сдвигается вперед — с 20 апреля до 30 апреля 2026 года. Более важно, что GPT-6.1 Sol больше не поддерживает reasoning.effort="none"; доступные настройки reasoning начинаются с low.
Для разработчиков, зависящих от минимальной задержки, это различие совместимости заслуживает тестирования, поскольку GPT-6 Sol по-прежнему поддерживает усилие reasoning none.
Архитектура: что остается нераскрытым
Ни на одной из страниц моделей, использованных для сравнения, нет числа параметров или подробного описания архитектуры. Официальное дополнение к системной карте говорит, что GPT-6.1 Sol использует те же типы данных и обучение, что Astra; это не доказывает, что Sol и Astra имеют идентичные архитектуры. Различия архитектуры и масштабов параметров остаются нераскрытыми в цитируемых материалах.
Базовое ценообразование без изменений; кэшированные чтения дешевле
Для обычных некэшированных токенов — нет. Стандартные ставки ввода и вывода не изменились. Основное улучшение — кэшированный ввод.
| Официальные цены API — USD за 1M токенов | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Ввод / 1M токенов | $2.00 | $2.00 |
| Кэшированный ввод / 1M | $0.10 | $0.20 |
| Запись в кэш / 1M | $2.50 | $2.50 |
| Вывод / 1M токенов | $10.00 | $10.00 |
GPT-6.1 Sol снижает кэшированный ввод до $0.10 за миллион токенов, или 5% от ставки некэшированного ввода.
Например, повторное использование 100 миллионов кэшированных токенов ввода стоит около $10 на GPT-6.1 Sol против $20 на GPT-6 Sol. Это различие невелико для разовых промптов, но заметнее для высокообъемных агентов со стабильными префиксами.
Также применяются официальные условия ценообразования, показанные в документации модели: запросы свыше 272K токенов на ввод используют 2x ставки ввода и кэша и 1.5x ставки вывода на весь запрос. Режим Fast — 2x Standard; Batch и Flex — на 50% ниже Standard. Региональная обработка добавляет 10% премию, где доступно, а режим Fast недоступен с локализацией данных в ЕС. Возможны отдельные сборы за инструменты. Планируйте бюджет с учетом выбранного режима обработки, региона и фактических попаданий в кэш.
Что улучшено в GPT-6.1 Sol?
Лучше всего оценивать обновление в разрезе кодинга, агентных рабочих процессов, профессиональных документов, науки, фактичности и восстановления после сбоев. Ниже улучшения сгруппированы с сохранением исходных условий бенчмарков и ограничений.
Обзор бенчмарков: заявленные приросты и условия оценивания
Сильнейший аргумент в пользу GPT-6.1 Sol — результаты на уровне задач, а не «сырьевая» специфика. OpenAI сообщает об улучшениях в программной инженерии, бизнес-автоматизации, компьютерном взаимодействии, научных рабочих процессах, фактической точности и выравнивании агентов.
| Официальные результаты бенчмарков/оценок | GPT-6.1 Sol vs. GPT-6 Sol | Что это означает |
|---|---|---|
| DeepSWE v1.1 | +6.4 п.п. по сравнению с лучшим результатом GPT-6 Sol при меньшем усилии reasoning и меньшей стоимости задачи; это не сравнение с равным усилием | Более сильная долгогоризонтная разработка ПО |
| AutomationBench 1.0.6 | +4.8 п.п. при уровне medium для обеих Sol; +2.2 п.п. по сравнению с Opus 5.5 при medium | Лучшая многошаговая работа бизнес-агентов |
| OSWorld 2.0 offline | +7 п.п. при максимальном усилии; частичная награда на offline-наборе, релиз v2026.08.08; менее чем половина стоимости задачи | Лучшая работа за компьютером |
| Terminal-Bench Science 0.1 | Более чем в 2 раза выше результата GPT-6 Sol при максимальном усилии и менее чем половине стоимости задачи | Большой прирост в научных рабочих процессах |
| Сложная оценка фактичности | При low доля ответов с ошибками снижается с 11.4% до 7.7%; это выбранная оценка на сложных промптах | Меньше фактических ошибок на сложных промптах |
| Тест выравнивания при сломанном поиске | При максимальном усилии непредоставление информации о сломанном поиске падает с 4.9% до 2.1%; намеренно «враждебные» задачи | Лучшое распознавание отказов инструментов |
Это результаты, заявленные OpenAI, а не независимые измерения CometAPI. OpenAI оценивала свои модели в исследовательской среде или через свой API; поведение в продакшене может отличаться из-за системных промптов и доступных инструментов. Показатели конкурентов взяты из публичных отчетов. Стоимость задачи отражает протестированную конфигурацию и не равна цене токенов. Не следует делать выводы о нераскрытых деталях, таких как бюджеты на запуск или scaffolds.
Официальный результат в таблице сравнивает GPT-6.1 Sol при меньшем усилии reasoning с лучшим результатом GPT-6 Sol. Это не следует описывать как контролируемое сравнение скорости при равном усилии. DeepSWE v1.1 оценивает оригинальные долгогоризонтные задачи по разработке в реальных кодовых базах.
Для контекста: исходный релиз GPT-6 Sol сообщал 68.8% при максимальном усилии на DeepSWE v1.1.
Кодинг: более сильная долгогоризонтная программная инженерия
Кодинг — пожалуй, самый очевидный апгрейд. DeepSWE v1.1 проверяет агентов на оригинальных задачах в реальных кодовых базах, требующих устойчивой, многошаговой работы.
Улучшение DeepSWE, резюмированное выше, важно, когда агент должен инспектировать репозиторий, планировать изменения, использовать инструменты и исправлять сбои на многих шагах. Разработчики могут сопоставить это обновление с GPT-6 Astra API в CometAPI, чтобы решить, оправдывают ли самые сложные задачи более дорогую модель.
Это важнее коротких бенчмарков по коду, потому что длительные кодовые агенты накапливают стоимость за счет повторного reasoning, вызовов инструментов, чтения файлов, патчей и повторного использования контекста. GPT-6.1 Sol улучшает как завершение задач, так и экономику повторного контекста без повышения стандартной ставки $2/$10.
API GPT-6 Sol в CometAPI по-прежнему полезен для существующих внедрений и предоставляет совместимый с OpenAI путь для кодинговых и агентных рабочих нагрузок.
AI-агенты и бизнес-процессы: автоматизация и работа за компьютером
Да, и улучшение выходит за пределы кодинга. AutomationBench оценивает, может ли агент завершать сквозные рабочие процессы с множеством инструментов в продажах, маркетинге, операциях, поддержке, финансах и HR.
Сопоставимый результат AutomationBench на уровне medium релевантен для насыщенных инструментами бизнес-процессов. Это все еще результат бенчмарка, а не гарантия успеха в собственном стекe инструментов компании. Сравнение также включает Claude Opus 5.5 API в CometAPI; оценивайте всех кандидатов с одинаковыми инструментами и критериями успеха перед выбором.
Для компьютерной работы результат OSWorld выше использует offline-набор и частичную награду. Более высокий балл с частичной наградой не обязательно означает, что каждая задача завершена end-to-end. Состояние браузера, разрешения, поведение восстановления и качество интеграции инструментов по-прежнему влияют на результаты внедрения.
Профессиональные документы и наука: более широкие способности к сложным задачам
GPT-6.1 Sol также продвигает уровень Sol глубже в профессиональную интеллектуальную работу. OpenAI оценивает понимание сложных документов на GDP.pdf, где модели отвечают на реалистичные вопросы по PDF с таблицами, диаграммами, схемами, плотным форматированием и мелким шрифтом в областях, включая финансы, здравоохранение и право.
GDP.pdf добавляет доказательства профессионального анализа PDF сверх обычного ответа на вопросы по тексту. Рассматривайте результат в объявлении запуска как оценку понимания документов, а не гарантию, что каждая диаграмма, сноска или скан будет интерпретирована правильно.
Результат Terminal-Bench Science в официальном сводном бенчмарке охватывает такие рабочие процессы, как анализ данных, моделирование и доказательство теорем. Полезная локальная оценка должна измерять корректность и воспроизводимость финального результата, а также общую стоимость инструментов и модели.
Это не означает, что GPT-6.1 Sol повсеместно заменяет Astra. OpenAI продолжает позиционировать Astra как свою модель с наивысшими возможностями для самых сложных end-to-end задач. Важное изменение — разрыв в производительности между Sol и Astra сокращается, тогда как разрыв в ценах на токены остается большим.
Фактичность и надежность агентов: меньше ошибок и лучшее обработка сбоев
Данные OpenAI по фактичности указывают в этом направлении, хотя оценку не следует трактовать как универсальную частоту «галлюцинаций».
Официальный анонс напрямую сообщает о улучшении фактичности при low: ответы с ошибками снижаются с 11.4% на GPT-6 Sol до 7.7% на GPT-6.1 Sol — снижение на 3.7 п.п., или около 32% относительного уменьшения. Эти выбранные диалоги ранее провоцировали ошибки; эти цифры — не универсальная частота «галлюцинаций».
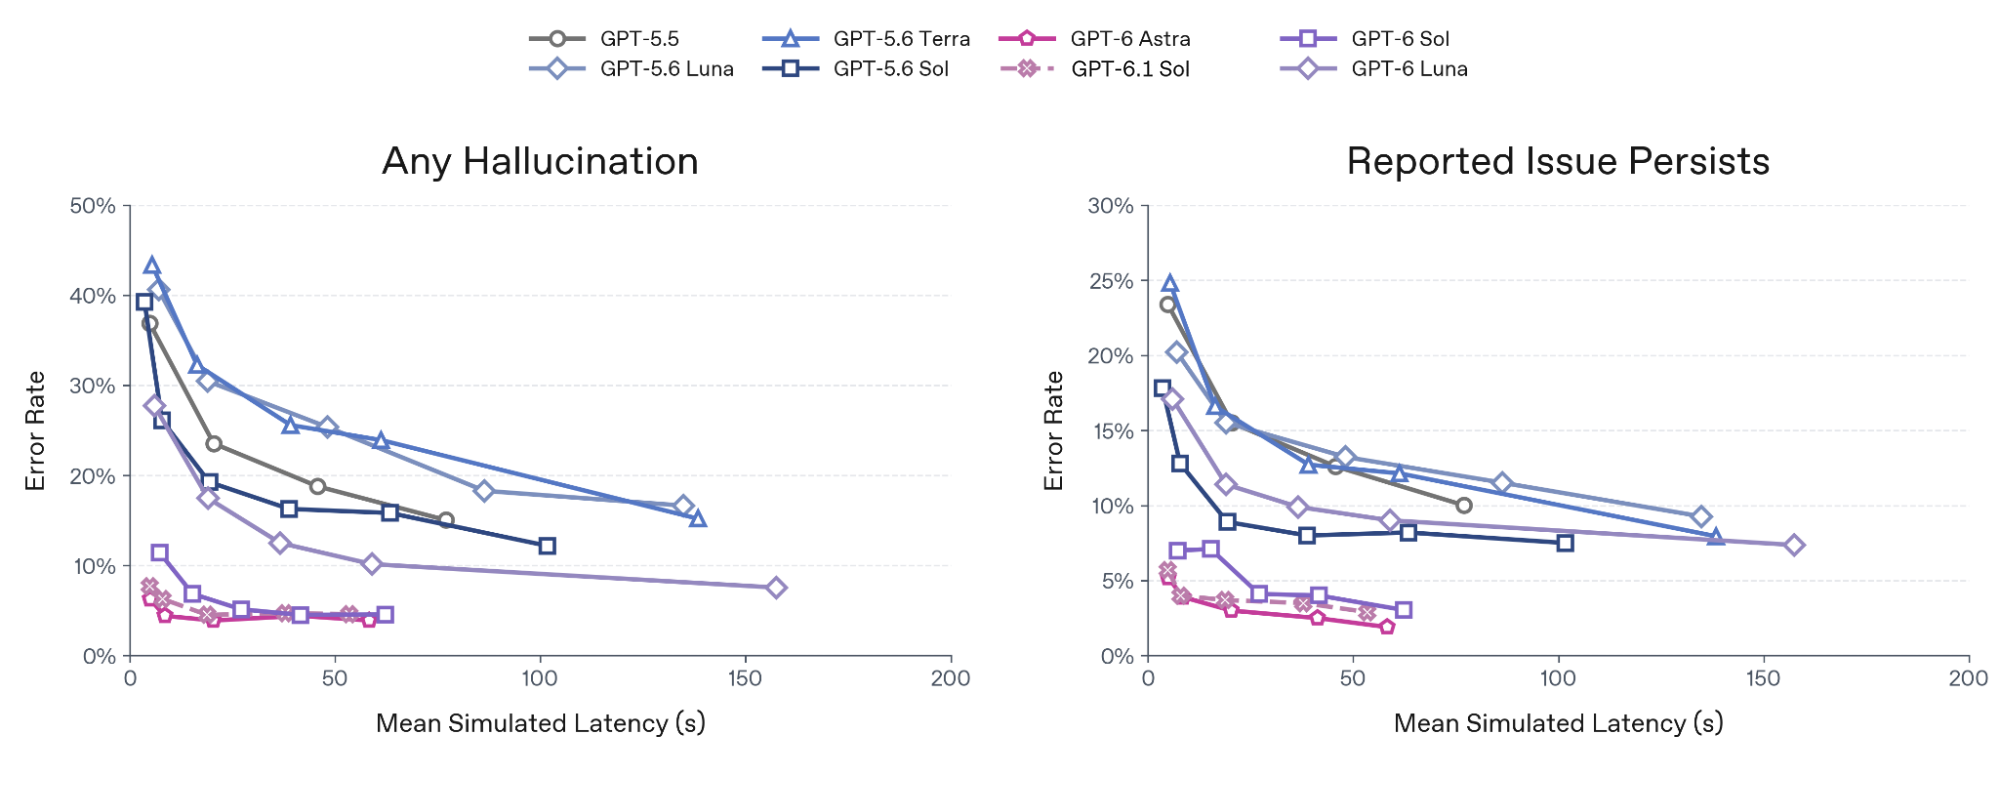
Исходная диаграмма выше извлечена напрямую из PDF системной карты OpenAI без перерисовки. Она отражает выбранные оценки сложных диалогов против симулированной задержки; две панели измеряют любые «галлюцинации» и устойчивость заявленной проблемы. Это не следует читать как оценку частоты ошибок в продакшене.
| Модель | Доля отказов при сломанном поиске — максимальное усилие |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
API GPT-6 Luna в CometAPI — еще один ориентированный на стоимость вариант, но его результат по сломанному поиску здесь иллюстрирует, почему агента нужно тестировать на обработку сбоев инструментов, а не только на успешное выполнение.
Это намеренно «враждебные» оценки, а не репрезентативные частоты отказов в продакшене. Они полезны как свидетельство того, что GPT-6.1 Sol лучше распознает недоступность или отказ инструментов, вместо того чтобы уверенно продолжать с неподдерживаемыми утверждениями.
GPT-6.1 Sol vs. GPT-6 Sol: стоит ли обновляться?
Для нового сложного рабочего процесса GPT-6.1 Sol — сильный кандидат на оценку. Для стабильного развертывания GPT-6 Sol обновляйтесь только тогда, когда измеряемые выгоды оправдывают миграцию. Общие лимиты контекста и базовые цены на токены делают сравнение честным, но публичные бенчмарки не решат, станет ли ваше приложение быстрее, надежнее или дешевле.
Когда стоит тестировать апгрейд
Отдайте приоритет пробному запуску, если существенную долю вашей нагрузки составляют кодирование на уровне репозитория, многошаговая бизнес-автоматизация, компьютерная работа или сложный анализ документов. Заявленные улучшения из предыдущего раздела релевантны этим кейсам. Рассматривайте их как причины для тестирования, а не гарантию, что ваша продакшн-успешность вырастет на столь же величину.
Приложения с повторяющимся контекстом — еще один полезный кейс. Более низкая ставка кэшированных чтений может снизить долю счета за ввод, когда запросы действительно переиспользуют стабильный префикс. Если основные затраты приходятся на сгенерированные токены, инструменты или неудачные попытки, скидка на кэш может мало повлиять. Сравнивайте полную стоимость на принятое решение, включая повторы и время ревью.
Когда разумно остаться на GPT-6 Sol
Оставайтесь на GPT-6 Sol, если он уже соответствует вашим целям по качеству, задержке и бюджету, а новая модель не дает существенной выгоды в репрезентативной оценке. Работающая интеграция также имеет ценность: избегайте замены стабильного маршрута только потому, что название модели новее.
Совместимость может стать решающей. GPT-6 Sol поддерживает усилие reasoning none; GPT-6.1 Sol начинается с low. Приложение, использующее в Chat Completions вызовы функций на none, должно перенести цикл инструментов в Responses, чтобы использовать 6.1 Sol. Также проверьте параметры сэмплинга и разбор ответов. Это изменения миграции, а не только подмена идентификатора модели. См. рекомендации по миграции OpenAI.
Как принять решение об обновлении
Создайте фиксированный набор оценок с рутинными задачами, сложными кейсами и отказами инструментов из вашего целевого рабочего процесса. Сохраните неизменными определения задач, разрешения инструментов и критерии приемки. Сравните валидированную базовую версию Sol с валидной конфигурацией 6.1 Sol; явно фиксируйте настройки reasoning, вместо того чтобы притворяться, что none и low эквивалентны.
- Качество: измеряйте принятые завершения, исправления фактов, некорректные вызовы инструментов и усилия человеческого ревью.
- Скорость: сравнивайте p50/p95 сквозной задержки, включая повторы и ожидание инструментов.
- Стоимость: учитывайте некэшированный ввод, кэшированные чтения, записи в кэш, токены вывода/рассуждений, сборы за инструменты и инженерные усилия.
- Раскатка: начните с небольшого трафика, сохраните откат на Sol и расширяйтесь только при выполнении заранее заданных порогов.
Практическая рекомендация: выбирайте GPT-6.1 Sol, когда пробный запуск дает лучшие «экономику принятой задачи» или необходимый прирост возможностей без неприемлемых регрессий. Оставляйте GPT-6 Sol для маршрутов, где совместимость и проверенные результаты перевешивают измеренную пользу. Смешанное развертывание разумно, когда улучшаются только некоторые классы задач. Это рекомендации, основанные на нагрузке, а не утверждение, что какая-либо модель выигрывает универсально.
Как перейти с GPT-6 Sol на GPT-6.1 Sol?
В простейшем случае меняется идентификатор модели с gpt-6-sol на gpt-6.1-sol.
Пример запроса к Responses API может выглядеть так:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Проанализируйте этот репозиторий и определите причину сбоя тестов."
)

print(response.output_text)
Смена идентификатора модели — лишь первый шаг. GPT-6.1 Sol поддерживает low, medium, high, xhigh и max, в то время как GPT-6 Sol дополнительно поддерживает none. Уберите явную установку none и выберите допустимое усилие. Приложения с инструментами также требуют Responses API: GPT-6.1 Sol в Chat Completions не поддерживает вызов инструментов, тогда как GPT-6 Sol в Chat Completions поддерживает вызов функций только при none. Официальные колонки в таблице спецификаций фиксируют эти ограничения по endpoint’ам.
Команды должны повторно протестировать чувствительные к задержке рабочие процессы, вызов инструментов, кэширование промптов, поведение с длинным контекстом и любую логику, которая явно отправляет reasoning.effort="none".
Этот пример нацелен прямо на OpenAI с использованием OPENAI_API_KEY; это не проверенный пример конечной точки CometAPI. Сохраните маршрут GPT-6 Sol во время поэтапного rollout’а, регистрируйте успешность задач и p95-задержку и откатывайте, если критерии приемки вашего приложения не соблюдены.
Какие рабочие нагрузки GPT-6.1 Sol выигрывают больше всего?
| Нагрузка | Преимущество GPT-6.1 Sol |
|---|---|
| Кодовые агенты | Более высокий результат на DeepSWE |
| Отладка уровня репозитория | Лучшая долгогоризонтная разработка ПО |
| Браузер/компьютерные агенты | +7 п.п. на OSWorld 2.0 |
| Корпоративная автоматизация | Более высокий результат на AutomationBench |
| Агенты с повторным контекстом | Кэшированный ввод дешевле на 50% |
| Сложный анализ PDF | Профессиональная работа с документами близка к Astra |
| Научные рабочие процессы | Более чем в 2 раза выше результата GPT-6 Sol по Terminal-Bench Science |
| Факт-чувствительные задачи | Ниже доля фактических ошибок на сложных промптах |
| Агенты с множеством инструментов | Лучшее поведение при отказах инструментов |
GPT-6 Sol остается полезным там, где существующие интеграции уже стабильны или где разработчикам специально требуется настройка none для reasoning. Для новых внедрений, сосредоточенных на агентах, кодинге, компьютерной работе или повторном контексте, GPT-6.1 Sol меняет соотношение цена/производительность без изменения обычной цены за токены ввода/вывода.
Чем CometAPI может помочь в апгрейде с GPT-6 Sol на GPT-6.1 Sol?
Для разработчиков, уже использующих API GPT-6 Sol в CometAPI, переход на GPT-6.1 Sol может рассматриваться как относительно небольшая миграция, а не полная переработка интеграции.
GPT-6.1 Sol уже доступна через CometAPI с идентификатором модели gpt-6.1-sol. В CometAPI сейчас указана стартовая цена за ввод короткого контекста в $1.60 за миллион токенов, по сравнению с официальной ставкой OpenAI $2.00, а цена вывода начинается с $8.00 за миллион токенов. Это удерживает новую модель Sol в той же структуре скидок, что и GPT-6 Sol, предоставляя разработчикам доступ к ее более сильной работе в кодинге, агентах и компьютерном использовании.
Поскольку CometAPI предоставляет совместимый с OpenAI интерфейс, существующие приложения GPT-6 Sol обычно могут оставить ту же структуру SDK и поток запросов, переключившись на идентификатор модели gpt-6.1-sol. CometAPI также предоставляет инструменты для сравнения моделей, тестирования промптов, оценки стоимости рабочих нагрузок и инспекции поведения миграции перед продакшн-раскаткой.
Более безопасный процесс апгрейда — прогонять одни и те же репрезентативные промпты против GPT-6 Sol и GPT-6.1 Sol, затем сравнивать качество вывода, задержку, поведение инструментов и полную стоимость. Это особенно важно для приложений, зависящих от настроек reasoning, структурированных выводов, вызовов инструментов или длительных агентных циклов, поскольку совместимость модели не гарантирует идентичное поведение на каждой нагрузке.
Для команд с повторяющимся контекстом или агентно-тяжелыми нагрузками новый маршрут также может улучшить экономику. CometAPI в настоящее время оценивает кэшированные чтения короткого контекста GPT-6.1 Sol в $0.08 за миллион токенов, против официальных $0.10 OpenAI, при этом ставки ввода и вывода короткого контекста указаны на 20% ниже официальных.
На практике переход GPT-6 Sol → GPT-6.1 Sol в CometAPI можно сделать в три шага:
- Замените
gpt-6-solнаgpt-6.1-sol. - Сравните те же продакшн-подобные промпты и агентные процессы до переключения трафика.
- Переносите нагрузки постепенно, когда качество вывода, поведение инструментов, задержка и стоимость удовлетворяют вашим требованиям.
Этот подход позволяет принять GPT-6.1 Sol без перестройки приложения под новый стек API, одновременно валидируя поведенческие различия, вносимые новой моделью.
Заключение
GPT-6 Sol не стал технически устаревшим. Он сохраняет то же окно контекста 1.05M, потолок вывода 128K, структурированные выводы, ввод изображений и цены Standard $2/$10. Его опция reasoning none также может быть важна для существующих интеграций. Решение об обновлении должно исходить из измеренных результатов задач и совместимости, а не только из номера версии.
Однако документация GPT-6 Sol от OpenAI теперь направляет разработчиков на GPT-6.1 Sol как новую модель уровня Sol.
Для большинства сложных нагрузок ключевой вопрос — не в том, имеет ли GPT-6.1 Sol большее окно контекста или более высокую цену токена — нет. Вопрос в том, оправдывают ли более высокий успех задач, более дешевые кэшированные чтения, улучшенная фактичность и более сильное поведение агентa смену идентификатора модели и повторное тестирование нагрузки.
FAQ
Как мигрировать с GPT-6 Sol на GPT-6.1 Sol с вызовом инструментов?
Нет. Сначала проверьте endpoint и поля запроса, затем перенесите цикл инструментов в Responses API и протестируйте парсинг вызовов инструментов, валидацию аргументов, повторы и обработку ошибок. Запустите «канарейку» на репрезентативных задачах перед увеличением трафика; успешный текстовый запрос не подтверждает рабочий цикл инструментов.
Дешевле ли GPT-6.1 Sol в реальных нагрузках?
Логируйте кэшированный и некэшированный ввод, записи в кэш, токены reasoning и вывода, режим обработки и сборы за инструменты. Сравнивайте стоимость на принятую задачу, а не только цену кэшированных токенов. Стабильные префиксы помогают только тогда, когда запросы действительно попадают в кэш, а более длинные циклы инструментов или неудачные попытки могут нивелировать экономию на кэше.
Как тестировать GPT-6.1 Sol перед переключением с GPT-6 Sol?
Используйте фиксированный набор задач, приближенных к продакшену, и записывайте успешные завершения, исправления фактов, некорректные вызовы инструментов, p50/p95 задержки и общую стоимость. Заранее определите допустимые пороги. Сохраните маршрут отката модели и расширяйте трафик только после того, как новая конфигурация достигнет этих порогов.
Как тестировать GPT-6.1 Sol с PDF?
Соберите небольшой корпус с плотными таблицами, сносками, диаграммами и сканами, репрезентативный для целевого процесса. Задавайте вопросы с проверяемыми ответами и требуйте доказательства в виде страницы или таблицы. Отдельно оценивайте корректность расчетов, пропущенные оговорки и неподдержанные ответы; сохраняйте человеческое ревью для выводов, ошибки в которых могут иметь существенные последствия.