Технические характеристики MiniMax M3.1-Flash-Preview
| Пункт | MiniMax M3.1-Flash-Preview |
|---|---|
| Идентификатор модели | MiniMax-M3.1-Flash-Preview |
| Семейство моделей | Серия MiniMax M3.1, модель для кодирования (Preview) |
| Статус релиза | Preview; объявлен 27 сентября 2026 года |
| Основной фокус | Повседневная разработка ПО — от исправления ошибок до реализации полнофункциональных задач |
| Окно контекста | 1,000,000 токенов |
| Модальности ввода | Текст, изображение и видео |
| Модальность вывода | Текст |
| Контроль рассуждений | reasoning_effort: low, medium, high, xhigh, max |
| Поведение рассуждений | Требуется адаптивное мышление; изученная публичная документация не предполагает отключение мышления |
| Максимальный вывод | Отдельно не публиковался в изученных публичных материалах |
| Количество параметров | Не раскрывается публично |
| Открытые веса | Публичного чекпойнта/репозитория модели не выявлено |
MiniMax объявила M3.1-Flash-Preview для MiniMax Code 27 сентября 2026 года, позиционируя модель для повседневных задач разработки, таких как исправление ошибок и полная реализация функций. Текущие публичные материалы последовательно указывают на окно контекста в 1M токенов и настраиваемое усилие рассуждений, при этом отмечая, что отдельная таблица бенчмарков и стоимость за токен не были опубликованы.
Что такое MiniMax M3.1-Flash?
MiniMax M3.1-Flash-Preview — это ориентированная на кодирование текстовая модель в статусе Preview, предназначенная для итеративных процессов разработки ПО, а не только генерации кода. MiniMax описывает рабочий процесс как охватывающий понимание требований, локализацию проблем, реализацию, регрессионное тестирование и проверку изменений на совместимость с существующей функциональностью.
Ее отличительными задокументированными элементами управления являются длинный контекст и пятиуровневая шкала усилий рассуждения. Доступные уровни: low, medium, high, xhigh и max, что позволяет разработчикам балансировать глубину рассуждений и задержку в зависимости от сложности задачи.
Основные особенности MiniMax M3.1-Flash-Preview
- 1M-токенный контекст: опубликованное описание модели присваивает версии Preview окно контекста в один миллион токенов, что делает ее подходящей для больших репозиториев, длинных спецификаций и продолжительных сессий кодирующих агентов.
- Нативный мультимодальный ввод: публичные описания модели перечисляют текст, изображения и видео в качестве входов, при этом модель возвращает текст.
- Пять уровней усилий рассуждения:
low,medium,high,xhighиmaxобеспечивают более тонкий контроль глубины рассуждений по сравнению с простым переключателем включено/выключено. - Сквозной рабочий процесс кодирования: MiniMax специально позиционирует модель для локализации ошибок, реализации, обработки крайних случаев, завершения регрессионных тестов и валидации изменений.
- Развертывание, ориентированное на Preview: начальный публичный релиз осуществляется через MiniMax Code и Token Plan, а не как полностью документированное самостоятельное предложение pay-as-you-go.
- Подходит для кодирующих агентов: модель предназначена для повторяющихся взаимодействий в разработке, где контекст репозитория, вывод инструментов, тесты и итеративные исправления важнее, чем одноразовая генерация кода.
MiniMax M3.1-Flash-Preview vs другие модели MiniMax для кодирования
| Модель | Фокус | Контекст | Публичные бенчмарки | Доступ/статус |
|---|---|---|---|---|
| M3.1-Flash-Preview | Повседневное кодирование, итеративная разработка | 1M | Пока не опубликованы | Preview; MiniMax Code / Token Plan |
| M3 | Передовое кодирование + агентная работа, нативная мультимодальность | До 1M | Опубликованы MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Инжиниринг ПО + широкий спектр агентной/продуктивной работы | Здесь не используется как скопированная спецификация M3.1 | Опубликованы MiniMax | API, Token Plan, Agent |
M3 — более подробно задокументированная референсная точка: MiniMax публикует ее архитектуру, методологию оценки для кодирования/агентов и доступность API. У M2.7 также есть публичные бенчмарки и интеграция с API. M3.1-Flash-Preview новее и в настоящее время имеет более узкую публичную документацию, поэтому сравнения следует строить на основании задокументированного позиционирования, а не заявлять победителя по бенчмаркам. 4
Представительные сценарии использования
- Исправление ошибок на уровне репозитория: предоставьте модели большой кодбейс, описание проблемы, логи и тесты, используя длинный контекст для сохранения релевантного контекста проекта.
- Реализация функций: используйте модель для перехода от требований на естественном языке к изменениям в коде и регрессионному тестированию.
- Ревью кода и ремедиация: попросите выявить граничные случаи, предложить патчи и проверить, что изменения не ломают существующее поведение.
- Мультимодальная отладка: предоставляйте скриншоты, диаграммы или видео вместе с текстовыми требованиями, когда визуальный контекст является частью инженерной задачи.
- Длительные сессии кодирующих агентов: используйте большое окно контекста для спецификаций, файлов репозитория, вывода терминала и итеративных результатов тестов.
- Разработка с акцентом на скорость: выбирайте более низкий уровень усилий рассуждения для рутинных правок и повышайте усилия для более сложных многошаговых изменений.
Как получить доступ к API MiniMax M3.1-Flash-Preview
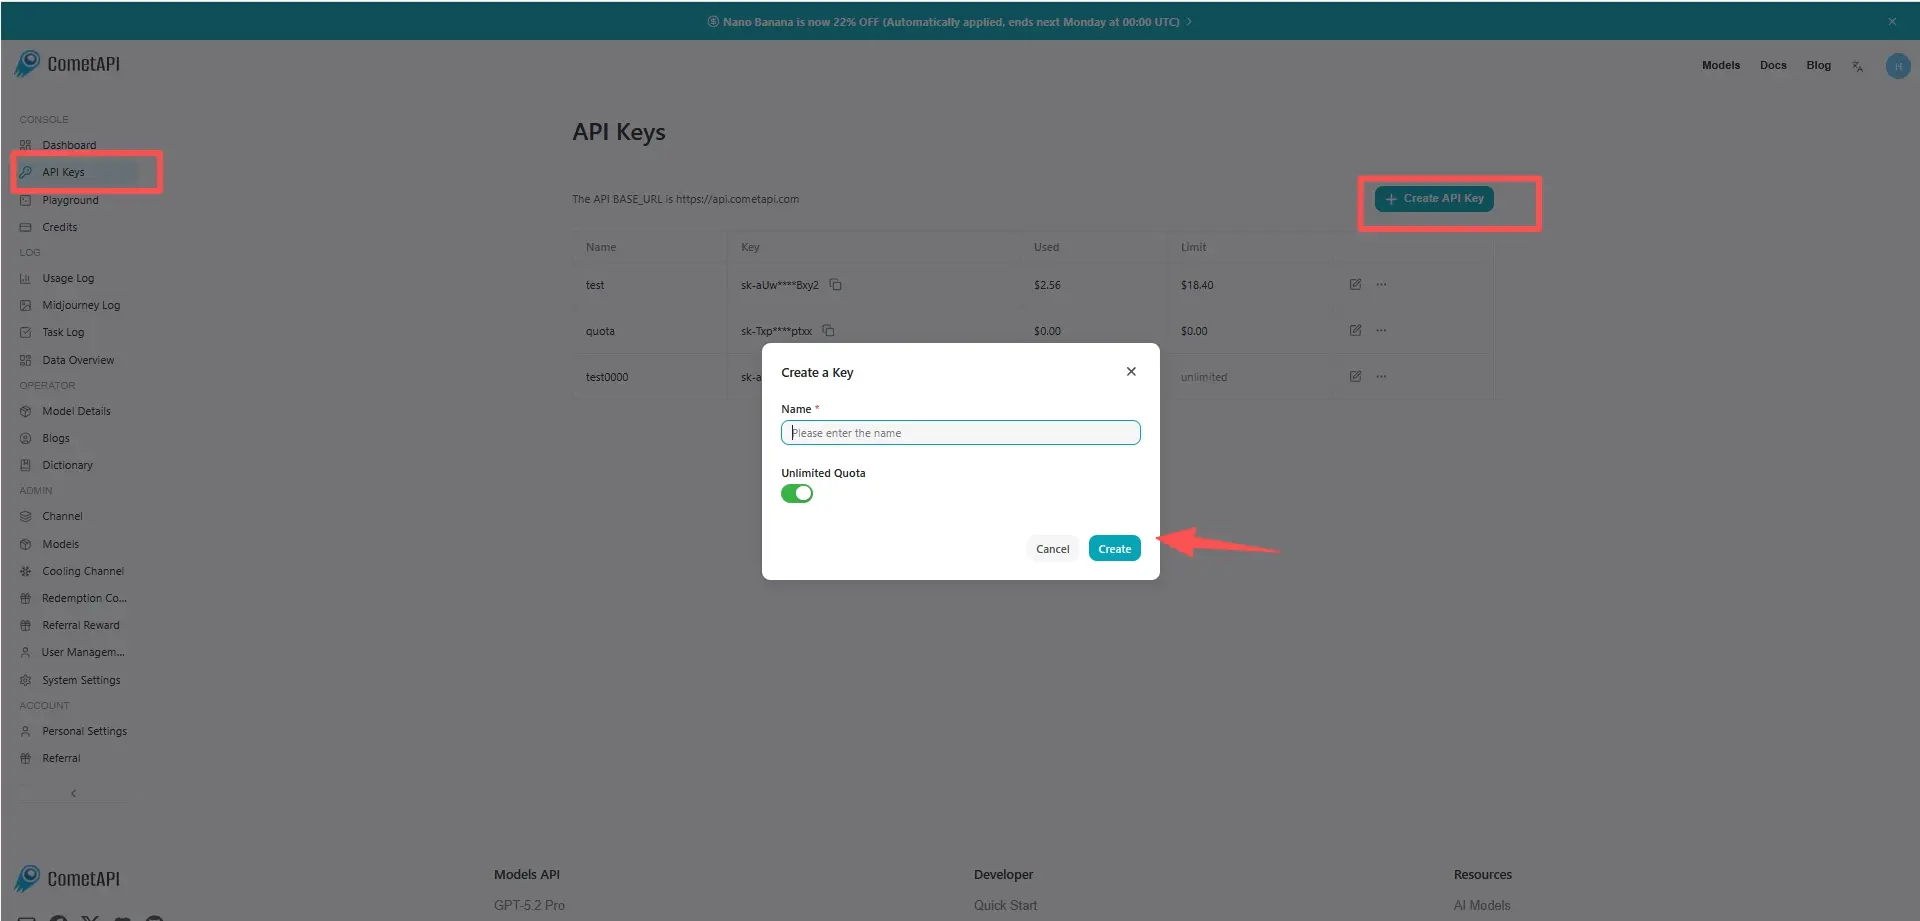
Шаг 1: Зарегистрируйтесь для получения API-ключа
Войдите на cometapi.com. Если вы еще не являетесь пользователем, зарегистрируйтесь. Войдите в консоль CometAPI. Получите учетный API-ключ для интерфейса. Нажмите “Add Token” в разделе API token в личном кабинете, получите токен-ключ: sk-xxxxx и отправьте.
Шаг 2: Отправьте запросы к API MiniMax M3.1-Flash-Preview
Выберите endpoint “minimax-m3.1-flash-preview” для отправки API-запроса и задайте тело запроса. Метод запроса и тело запроса берутся из документации API на нашем сайте. Наш сайт также предоставляет тестирование в Apifox для вашего удобства. Замените <YOUR_API_KEY> на ваш фактический ключ CometAPI из вашей учетной записи. base url — Chat Completions.
Вставьте ваш вопрос или запрос в поле content — именно на это ответит модель. Обработайте ответ API, чтобы получить сгенерированный ответ.
Шаг 3: Получите и проверьте результаты
Обработайте ответ API, чтобы получить сгенерированные данные. После обработки API отвечает статусом задачи и выходными данными.