
Самый быстрый способ использовать GLM-5.3 Flash API — вызывать модель через совместимый с OpenAI endpoint chat-completions в CometAPI. Сведения о подключении сведены в таблице спецификаций API ниже; храните ключ API на сервере.
Ответ сначала: создайте ключ CometAPI, установите совместимый с OpenAI SDK, отправьте POST-запрос на /v1/chat/completions, затем добавляйте стриминг, зрение, JSON-вывод или инструменты только после успешного базового запроса.
Что такое GLM-5.3 Flash API?
GLM-5.3 Flash — ориентированная на эффективность нативная мультимодальная модель Z.ai из семейства GLM-5. Она предоставляет рассуждение, длинный контекст, визуальное понимание и агентные возможности через chat API. Модель содержит 320B общих параметров, но активирует 18B на токен (https://docs.z.ai/guides/vlm/glm-5.3-flash); эта архитектура важна для стоимости, но разработчики в основном видят результат как модель, которая может оставаться «в контексте» на длинных промптах и при повторных вызовах инструментов.
В этом руководстве архитектуре и бенчмаркам уделено мало внимания. В сопроводительном обзоре модели (https://www.cometapi.com/what-is-glm-5-3-flash/) уже объяснены гибридное внимание, открытые веса, полный набор стартовых бенчмарков, ценообразование и сравнение внутри семейства моделей. Здесь фокус — интеграционное поведение и продакшен-решения.
Спецификации API, влияющие на интеграцию
| Спецификация API | Значение | Практический смысл |
|---|---|---|
| Базовый URL | https://api.cometapi.com/v1 | Укажите один раз в серверном клиенте. |
| Endpoint | POST /v1/chat/completions | Используйте совместимый с OpenAI маршрут chat-completions. |
| Совместимые SDK | Совместимые с OpenAI клиенты Python и JavaScript | Повторно используйте знакомые паттерны клиентов с базовым URL CometAPI. |
| Аутентификация | Bearer API key | Держите ключ в переменной окружения на сервере или в менеджере секретов. |
| Код модели | glm-5.3-flash | Используйте это точное значение в теле запроса. |
| Контекстное окно | 1,048,576 токенов | Подходит для больших репозиториев, наборов документов и длинной истории агента. |
| Максимальный вывод | До 131,072 токенов | Задайте меньший прикладной лимит для контроля стоимости и задержки. |
| Нативные входы | Text, image, video, file | Поддержка на хостинге может отличаться; проверьте точный маршрут CometAPI перед зависимостью. |
| Вывод | Text | Модель интерпретирует медиа, но не возвращает сгенерированные изображения или видео. |
| Reasoning | low, high, max | Используйте уровни усилия, чтобы обменять задержку и токены на глубину. |
| Thinking | Всегда включено | Не отправляйте параметр, пытающийся отключить thinking. |
| Функции для разработчиков | Streaming, function calling, caching, structured output | Полезно для интерактивных приложений, агентов и машинных конвейеров. |
Возможности модели и шлюза не идентичны. Считайте живую страницу модели на CometAPI и схему API контрактом для вызываемого вами маршрута, особенно для видео, файлов, строгого JSON Schema и провайдер-специфичных полей thinking.
Краткий контекст производительности
Z.ai сообщает о сильных результатах запуска (https://z.ai/blog/glm-5.3-flash) по задачам, важным для API-разработчиков: работа в терминале, разработка ПО, использование инструментов и автоматизация. Это оценки от вендора, полученные со специфическими стендами и политиками инструментов; они помогают определить вероятные сильные стороны, а не установить универсальный рейтинг.
| Бенчмарк | GLM-5.3 Flash | Что это предполагает для API-нагрузок |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Отлично подходит для кодовых агентов в терминале. |
| DeepSWE v1.1 | 63.4 | Перспективно для инженерии ПО на масштабе репо. |
| Toolathlon Verified | 78.4 | Сильный сигнал по выбору и использованию инструментов. |
| AutomationBench | 48.8 | Улучшенная многошаговая автоматизация vs предшественник. |
Практический вывод уже: GLM-5.3 Flash — сильный кандидат, когда рабочий процесс объединяет длинный контекст с инструментами или визуальной обратной связью. Для полного сравнения моделей используйте существующий обзор модели (https://www.cometapi.com/what-is-glm-5-3-flash/), а не дублируйте его здесь.
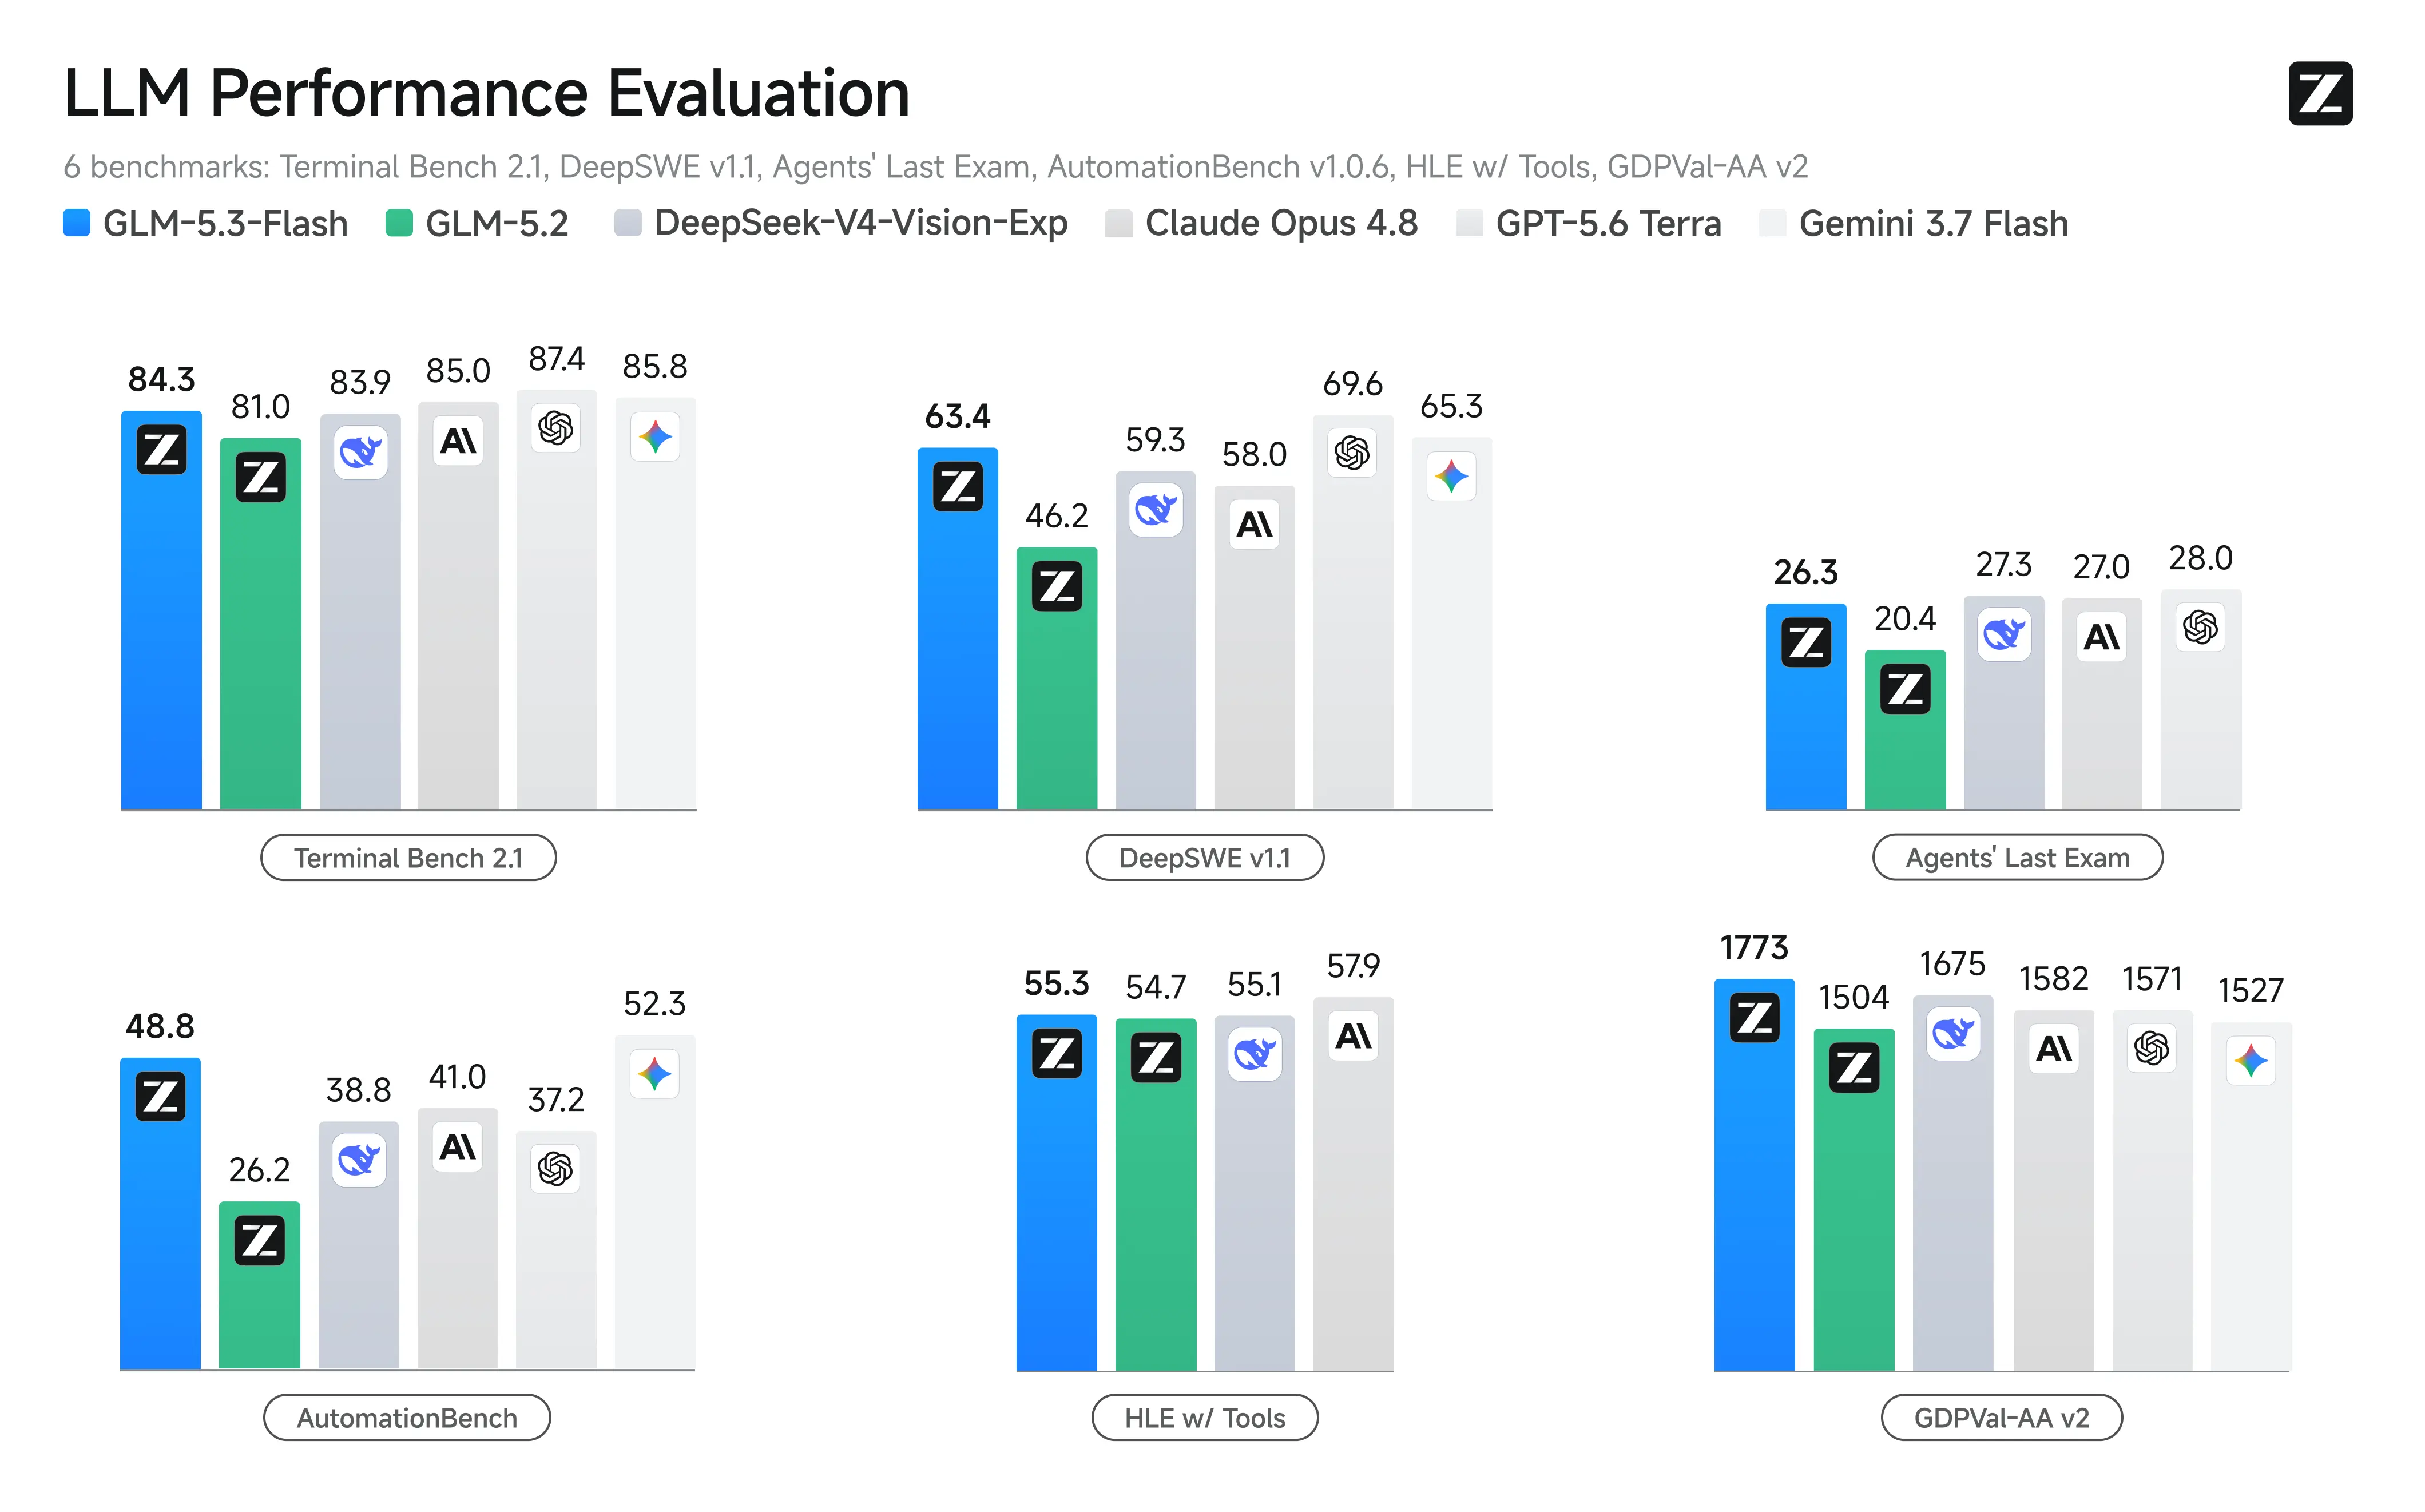
Источник: Z.ai official benchmark graphic (https://docs.z.ai/guides/vlm/glm-5.3-flash)
Официальная графика бенчмарков сравнивает производительность GLM-5.3 Flash по моделям и настройкам усилия. В этом руководстве она дает краткий контекст производительности, а не повтор полных матриц запуска. Приложения всё равно должны измерять успех задач, сквозную задержку и общий расход токенов на собственных промптах.
Почему использовать GLM-5.3 Flash через CometAPI?
CometAPI (https://www.cometapi.com/) предоставляет GLM-5.3 Flash через интерфейс, совместимый с OpenAI. Это позволяет команде повторно использовать знакомые паттерны SDK, централизовать учетные данные и биллинг и менять модели без перестройки всего слоя запросов.
• Один шаблон интеграции. Тот же базовый клиент может вызывать разные поддерживаемые модели, меняя ID модели.
• Централизованная видимость использования. Команды могут просматривать использование и стоимость без отдельных панелей для каждого провайдера.
• Быстрая оценка. Один стенд запросов может сравнивать качество ответов, задержку и ошибки разных моделей-кандидатов.
• Проще fallback-дизайн. Приложения могут держать логику ретраев и роутинга в одном шлюзовом слое.
• Более низкая заявленная цена маршрута. На текущей странице модели указано $0.06 за миллион входных токенов (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) и $0.20 за миллион выходных токенов (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/); перед бюджетированием проверяйте живую страницу.
Прежде чем начать
Вам нужны аккаунт CometAPI, ключ API и одна из локальных сред:
• Python 3.9+ с pip
• Node.js 18+ с npm
• cURL для минимального теста в командной строке
Никогда не размещайте продакшен-ключ CometAPI в браузерном JavaScript, мобильном приложении, публичном репозитории, скриншоте или клиентских логах. Вызывайте CometAPI с доверенного сервера и храните ключ в переменной окружения или менеджере секретов.
Как использовать GLM-5.3 Flash API с CometAPI
Шаг 1: Создайте ключ API CometAPI
Войдите в CometAPI, откройте консоль ключей API (https://www.cometapi.com/console/token), создайте ключ и один раз перенесите его в ваш процесс управления секретами. Используйте отдельные ключи для dev и prod, чтобы можно было ротировать или отзывать ключ в одной среде без простоя другой.
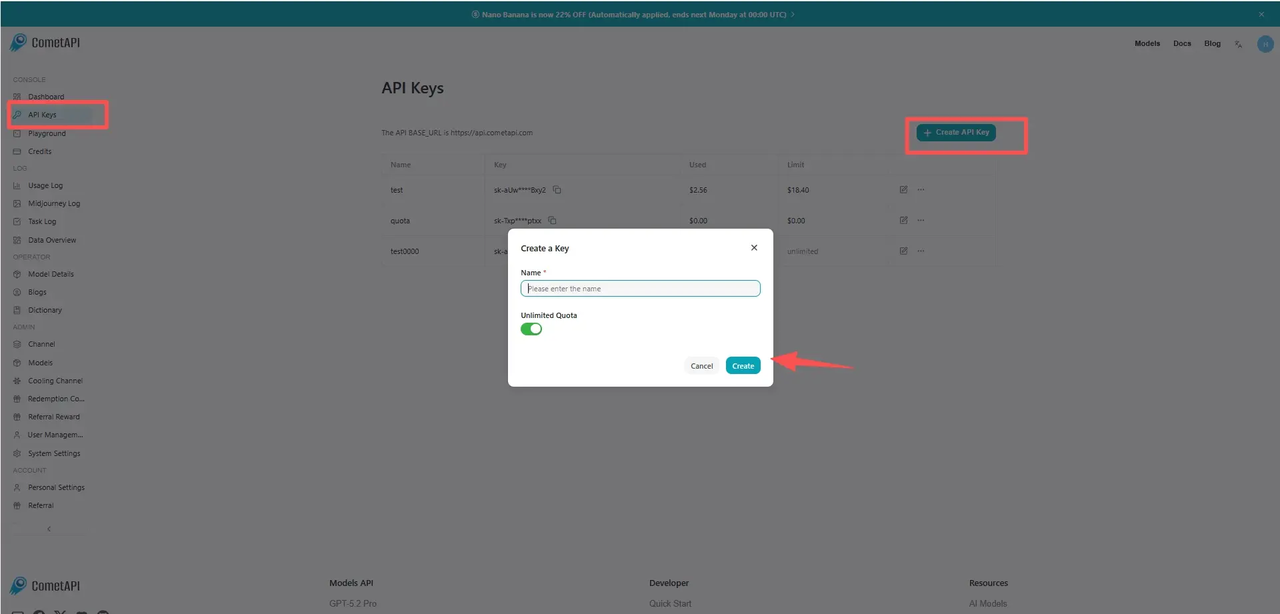
Источник: CometAPI official API key guide image (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)
Шаг 2: Сохраните ключ в переменной окружения
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
В продакшене замените историю shell на деплой-секрет, секрет контейнера или управляемый vault.

### Шаг 3: Установите совместимый с OpenAI SDK
python -m pip install --upgrade openai
npm install openai
```

### Шаг 4: Выполните первый запрос с cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "Вы — точный технический помощник."
      },
      {
        "role": "user",
        "content": "Объясните три практических применения контекстного окна на один миллион токенов."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Успешный ответ содержит сообщение ассистента в choices[0].message.content плюс метаданные об использовании, когда маршрут их возвращает. Начните с этого небольшого запроса, прежде чем добавлять необязательные параметры.

### Шаг 5: Вызов API из Python

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Вы — точный технический помощник.",
        },
        {
            "role": "user",
            "content": "Проверьте этот план миграции и перечислите пять главных рисков.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Шаг 6: Вызов API из JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "Вы — точный технический помощник." },
    { role: "user", content: "Составьте безопасный чек-лист по развертыванию этого API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## Как управлять усилием на рассуждение

Официальная документация модели (https://docs.z.ai/guides/vlm/glm-5.3-flash) поддерживает уровни усилия рассуждений low, high и max (https://docs.z.ai/guides/vlm/glm-5.3-flash). Thinking остается включенным (https://docs.z.ai/guides/vlm/glm-5.3-flash); настройка усилия меняет доступный «бюджет» рассуждений.

| Уровень | Хорошие начальные нагрузки                         | Компромисс                                          |
| ------- | -------------------------------------------------- | --------------------------------------------------- |
| low     | Классификация, перефразирование, короткая экстракция | Ниже задержка и расход выходных токенов; меньше глубины. |
| high    | Code review, планирование, анализ документов       | Сбалансированный дефолт для многих продакшен-задач. |
| max     | Сложный дебаг, агент с инструментами, трудные задачи | Максимальная глубина; потенциально выше задержка и стоимость. |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Найдите скрытые режимы отказа в этом плане распределенного развертывания.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

Если установленный SDK предоставляет reasoning_effort как отдельный аргумент, можете передать его напрямую. Если маршрут CometAPI отклоняет провайдер-специфичное поле, удалите его и используйте дефолт маршрута. Не пытайтесь отключать thinking.

## Как стримить ответы

Стриминг полезен для чатов, помощников по коду и длительного анализа, потому что позволяет интерфейсу отображать вывод по мере поступления. Он не уменьшает общее число сгенерированных токенов, поэтому сохраняйте те же лимиты вывода и контроль стоимости.

### Python Streaming

Python

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Создайте поэтапный план миграции базы данных."}
    ],
    max_completion_tokens=1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### JavaScript Streaming

JavaScript

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Создайте поэтапный план миграции базы данных." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• Обрабатывайте отмену. Прекращайте чтение стрима при отключении клиента и отменяйте работу upstream, когда поддерживается.

• Буферизуйте безопасно. Не предполагайте, что каждый чанк содержит целое слово, JSON-токен или объект tool-call.

• Записывайте финальное использование. Usage может появиться только в финальном событии или маршруто-специфичных метаданных.

## Как отправлять изображения

GLM-5.3 Flash (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) принимает визуальный контент через блоки image_url в messages[].content[]. Официальная документация рекомендует доступный по сети URL изображения или Base64 Data URL. Страница модели CometAPI указывает способность image-to-text, но приложениям следует тестировать форматы, размер файла и поведение маршрута до продакшена.

### Анализ URL изображения

Python

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Проверьте этот дашборд. Укажите проблемы удобства, "
                        "двусмысленные метрики и возможные риски качества данных."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Отправка локального изображения в Base64

Python

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Извлеките заголовок графика, оси и основную тенденцию.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Перед кодированием обрежьте несущественные поля вокруг изображения.

• Уменьшайте изображения, если их размер сильно превышает объем полезной информации.

• Задавайте конкретный визуальный вопрос, а не просите общий пересказ.

• Не предполагайте, что URL веб-страницы — это прямой URL изображения.

• Тестируйте порядок нескольких изображений, так как каждое должно быть явно упомянуто в запросе.

## Как запрашивать структурированный JSON

Структурированный вывод полезен, когда следующий компонент — это код, а не человек. Используйте узкую схему, валидируйте результат и держите fallback для маршрутов, которые не поддерживают строгий JSON Schema в той же форме.

Python

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Возвращайте только корректный JSON.",
        },
        {
            "role": "user",
            "content": (
                "Извлеките оборудование, серьезность, наблюдаемый симптом и следующее действие "
                "из этого отчета: Фидер 12 показал повторяющиеся всплески нулевой последовательности тока "
                "после дождя; проверьте изоляцию и сравните соседние секции."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

Режим JSON не отменяет необходимость валидации. Проверьте обязательные поля, типы, допустимые значения и максимальные длины, прежде чем сохранять результат или запускать другую систему.

## Как использовать Function Calling

Function calling позволяет модели решать, когда ей нужны внешние данные, при этом код приложения отвечает за авторизацию и выполнение. Безопасный паттерн: модель предлагает вызов инструмента, сервер валидирует, сервер выполняет инструмент и модель получает результат.

Python

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Возвращайте только корректный JSON.",
        },
        {
            "role": "user",
            "content": (
                "Извлеките оборудование, серьезность, наблюдаемый симптом и следующее действие "
                "из этого отчета: Фидер 12 показал повторяющиеся всплески нулевой последовательности тока "
                "после дождя; проверьте изоляцию и сравните соседние секции."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Валидируйте аргументы. Рассматривайте JSON вызова инструмента как недоверенный ввод.

• Принуждайте авторизацию. Модель не решает, что текущему пользователю разрешено.

• Разделяйте инструменты чтения и записи. Требуйте подтверждение для разрушающих или внешне видимых действий.

• Ограничивайте инвентарь инструментов. Экспонируйте только релевантные текущему процессу инструменты.

• Ограничьте цикл. Установите максимум раундов инструментов, общее число токенов, затраченное время и стоимость.

## Параметры API GLM-5.3 Flash (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)

| Параметр               | Назначение                       | Практические рекомендации                              |
| ---------------------- | -------------------------------- | ------------------------------------------------------- |
| model                  | Выбор маршрута модели            | Используйте glm-5.3-flash.                              |
| messages               | Диалог и мультимодальный ввод    | Сохраняйте корректный порядок ролей; не теряйте tool-сообщения. |
| max_completion_tokens  | Лимит генерируемого вывода       | Задавайте по воркфлоу, а не полагайтесь на максимум модели. |
| temperature            | Поведение семплирования          | Официальная рекомендация — 1.                           |
| top_p                  | Nucleus sampling                 | Официальная рекомендация — 0.95.                        |
| reasoning_effort       | Бюджет рассуждений               | Используйте low, high или max; поддержку маршрута надо тестировать. |
| stream                 | Инкрементальный вывод            | Используйте true для интерактивных ответов.             |
| tools                  | Определения функций              | Держите схемы узкими и валидируйте каждый вызов.        |
| tool_choice            | Контроль выбора инструмента      | Начните с auto, если воркфлоу не требует конкретный инструмент. |
| response_format        | Машиночитаемый вывод             | Валидируйте поддержку и возвращаемый JSON.              |

## Прямой API Z.ai vs CometAPI

Оба маршрута могут подойти. Решение в основном о владении интеграцией, широте моделей, биллинге и скорости доступа к нативным функциям провайдера.

| Измерение        | Z.ai Direct API                               | CometAPI                                           | Практический результат                                        |
| ---------------- | --------------------------------------------- | -------------------------------------------------- | -------------------------------------------------------------- |
| Аккаунт и ключ   | Аккаунт и ключ Z.ai                            | Аккаунт и ключ CometAPI                            | Ключи взаимозаменяемыми не являются.                           |
| Паттерн SDK      | Совместимый с OpenAI                          | Совместимый с OpenAI                               | Большую часть клиентского кода можно переиспользовать.         |
| Набор моделей    | Семейство моделей Z.ai                        | Несколько провайдеров и семейств моделей           | CometAPI полезен для роутинга и сравнения.                     |
| Нативные функции | Ранний доступ к специфике провайдера          | Зависит от экспозиции и пасс-тру в шлюзе           | Тестируйте продвинутые поля на выбранном маршруте.             |
| Биллинг          | Специфичен провайдеру                         | Централизован по поддерживаемым моделям            | Единый биллинг упрощает мульти-модельные операции.             |
| Fallback-дизайн  | Требует интеграцию с другим провайдером       | Может остаться в одном шлюзовом слое               | CometAPI снижает трение при переключении.                      |
| Лучшее применение| Глубокая ставка на нативные возможности Z.ai  | Единый доступ, оценка и продакшен-роутинг          | Выбирайте по архитектуре системы, не по «универсальному победителю». |

Используйте прямой API, когда жизненно важны новейшие провайдер-нативные параметры или фичи. Используйте CometAPI, когда важнее единый клиент, централизованный биллинг и возможность сравнивать/заменять модели. Для продакшена прогоняйте один и тот же представительский тестовый набор через точный маршрут, который собираетесь деплоить.

## Оценка стоимости и бюджет токенов

Текущая страница модели CometAPI (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) указывает $0.06 за миллион входных токенов (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) и $0.20 за миллион выходных токенов (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/). При этих тарифах оценочная стоимость запроса равна:

стоимость = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Нагрузка                 | Входные токены | Выходные токены | Оценочная стоимость |
| ------------------------ | -------------- | ----------------| ------------------- |
| Короткий вопрос          | 2,000          | 400             | $0.00020            |
| Code review              | 50,000         | 4,000           | $0.00380            |
| Анализ большого документа| 250,000        | 10,000          | $0.01700            |
| Длинный прогон агента    | 800,000        | 30,000          | $0.05400            |

Цены со временем меняются. Подтвердите актуальные ставки для input, cached-input и output перед публикацией или бюджетированием. Reasoning и циклы инструментов могут увеличить тарифицируемый вывод и повторяемый ввод, поэтому оценивайте полный воркфлоу, а не один видимый ответ.

## Лучшие практики продакшен-использования GLM-5.3 Flash API

### Контроль стоимости и задержки

#### Лимиты вывода

Настройки генерации в бенчмарках и продакшене — разные. В упомянутой оценке HLE использовалась максимальная длинна генерации 163,840 токенов, а в некоторых — 64K; ни то, ни другое не доказывает, что каждый хостed-маршрут может вернуть более 100,000 токенов. Устанавливайте лимит по живой схеме маршрута и бюджету воркфлоу. Используйте малые лимиты для классификации и экстракции, средние — для анализа, и большие — только для явных long-form или агентных задач.

Контроль контекста

Окно в миллион токенов — это ёмкость, а не цель. Извлекайте релевантные файлы, убирайте дубликаты логов, размещайте стабильные инструкции ближе к началу и измеряйте, улучшает ли дополнительный контекст успех задачи.

### Состояние и надежность

#### Сохраняйте состояние

Храните полные сообщения ассистента, нужные для следующего хода, включая вызовы инструментов и проверенные вашим приложением маршрут-специфичные поля. Потеря структурной истории может сломать многошаговый цикл инструментов, даже если видимый текст кажется полным.

#### Выборочные ретраи

• Повторяйте транзиентные 429, 500, 502, 503 и сетевые таймауты с экспоненциальным бэкоффом и джиттером.

• Не ретрайте вслепую ошибки аутентификации, неверные параметры или слишком большие запросы.

• Прикрепляйте ID запроса приложения, чтобы распознавать дублированную работу.

• Используйте идемпотентность вокруг внешних операций записи, даже если сам запрос к модели ретраится.

### Безопасность и валидация

#### Валидируйте машиночитаемый вывод

Проверка схемы, допустимых значений, лимитов длин и доменных правил должна стоять между моделью и каждой БД, очередью или внешним API. Синтаксически корректный JSON может быть неполным или небезопасным.

#### Авторизуйте вызовы инструментов

Рассматривайте предложенные моделью вызовы инструментов как недоверенные запросы: валидируйте аргументы, обеспечивайте авторизацию пользователя, разделяйте операции чтения и записи и требуйте подтверждение для разрушительных действий.

### Наблюдаемость и fallback

#### Измеряйте воркфлоу

• Успех задачи или доля принятия человеком

• Время до первого токена и общая задержка

• Входные, кэшированные входные, рассуждательные и выходные токены

• Число вызовов инструментов и доля ошибок инструментов

• Ретраи, rate limit и ошибки провайдера

• Стоимость за завершенную задачу, а не за изолированный вызов API

#### Проектируйте fallback

Выбирайте fallback по типу нагрузки, а не по репутации. Текстовый fallback может быть приемлем для извлечения из документов, но провалить задачу по скриншотам. Определите, какие входы и схемы инструментов переносимы, какие параметры надо убрать, и когда пользователю следует показать восстановимую ошибку вместо автоматического переключения модели.

## Частые ошибки и устранение неполадок

| Симптом                 | Вероятная причина                                                   | Что проверить                                                                   |
| ----------------------- | ------------------------------------------------------------------- | -------------------------------------------------------------------------------- |
| 401 Unauthorized        | Отсутствующий, неверный или отозванный ключ                         | Подтвердите заголовок Authorization и переменную окружения на сервере.          |
| 404 или model not found | Неверный ID модели или недоступный маршрут                          | Используйте glm-5.3-flash и подтвердите доступность на живой странице модели.   |
| 429 Rate Limit          | Превышен лимит запросов или токенов                                 | Замедлите, уменьшите конкуренцию, проверьте лимиты аккаунта и ретрайте с джиттером. |
| Unsupported parameter   | Провайдер-специфичное поле не экспонируется через шлюз              | Уберите опциональные поля и добавляйте обратно по одному.                       |
| Context length exceeded | Промпт плюс запрошенный вывод превышают лимит маршрута              | Обрежьте, извлеките, суммируйте или снизьте max_completion_tokens.              |
| Invalid image           | URL недоступен, формат не поддерживается или поврежден Base64       | Протестируйте прямой HTTPS URL изображения и корректный MIME-префикс.          |
| Broken streamed JSON    | Чанки парсились как полные объекты                                  | Буферизуйте поток и парсьте только по завершении полного JSON-пейлоада.         |
| Tool loop never ends    | Нет лимита шагов или двусмысленные результаты инструментов          | Ограничьте раунды, улучшите описания инструментов, возвращайте явные ошибки.    |

## Когда стоит использовать GLM-5.3 Flash API?

### Подходящие случаи

• Понимание кода на уровне репозитория и ревью нескольких файлов

• Визуальное кодирование, анализ скриншотов и QA интерфейса

• Пакеты длинных документов и синтез с подтверждениями

• Агенты с инструментами с повторным планированием и проверками

• Высокие объемы, где стоимость токенов существенно влияет на unit-экономику

• Приложения, выигрывающие от переключения или сравнения моделей через один шлюз

### Когда выбрать другой маршрут или модель

• Продукту нужен вывод изображения или видео, а не текстовый вывод.

• Задача — маленькая и низкорисковая классификация, с которой справится меньшая модель.

• Нужна провайдер-нативная функция, не экспонируемая на шлюзе.

• Воркфлоу не может терпеть всегда включенное рассуждение и его профиль задержки.

• Приложение еще не протестировало модель на своих инструментах, данных и кейсах отказов.

## FAQ

###

### Что следует проверить на конкретном маршруте CometAPI перед запуском?

Проверьте доступность модели, поддерживаемые мультимодальные форматы, максимальный вывод, поля рассуждений, поведение структурированного вывода, лимиты и текущие цены на представительских запросах.

### Какие метрики отслеживать в продакшен-оценке?

Отслеживайте успех задачи, время до первого токена, общую задержку, входные и выходные токены, ошибки вызова инструментов, долю ретраев и стоимость за завершенный воркфлоу, а не только стоимость одного вызова API.

### Как выбрать между прямым Z.ai и CometAPI?

Используйте прямой Z.ai, когда критичен немедленный доступ к провайдер-нативному поведению. Используйте CometAPI, когда важнее единая аутентификация, биллинг, сравнение моделей и fallback на уровне шлюза.

### Что делает fallback безопасным?

Безопасный fallback принимает ту же модальность входа, сохраняет необходимые схемы инструментов, убирает неподдерживаемые параметры, остается в пределах границ авторизации задачи и прозрачно падает, когда поведение невозможно сохранить.

## Заключение

GLM-5.3 Flash (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) наиболее полезна через API, когда длинный контекст, визуальный ввод, рассуждения и использование инструментов объединены в один воркфлоу. Базовая интеграция с CometAPI минимальна: один серверный ключ, один совместимый с OpenAI клиент, ID модели glm-5-3-flash и endpoint chat-completions. Продакшен-качество обеспечивают все вокруг запроса: сфокусированные промпты, лимиты вывода, валидация схем, авторизация инструментов, ретраи, наблюдаемость и оценка, специфичная для нагрузки.

Начните с короткого текстового вызова, добавляйте возможности по одной и тестируйте полный пользовательский путь перед масштабированием. Подтвердите на живой странице модели GLM-5.3 Flash (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) текущую доступность, поддерживаемое поведение маршрута и цены.

## SEO Метаданные

Метатайтл: How to Use GLM-5.3 Flash API: Developer Guide

Мета-описание: Узнайте, как использовать GLM-5.3 Flash API с CometAPI, включая примеры на Python и JavaScript, работу с изображениями, стриминг, инструменты, JSON-вывод и лучшие практики.

Ключевые слова: GLM-5.3 Flash API, how to use GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, GLM API tutorial, мультимодальный API, reasoning API, function calling

URL slug: how-to-use-glm-5-3-flash-api