

Кратко
MiMo-V2.5 — более сильный вариант по умолчанию для мультимодальной работы, рутинных агентов и чувствительных к стоимости продакшн-сценариев. MiMo-V2.5-Pro — специализированный выбор для сложного рассуждения, кодирования на уровне репозиториев и долгих траекторий с инструментами. Обе модели предоставляют окно контекста на 1M токенов и до 128K токенов вывода, но Pro использует гораздо более крупный языковой бэкенд и стоит примерно в 3,1× дороже для обычных входных и выходных токенов.
MiMo-V2.5 vs. Pro: Быстрый выбор
| Спецификация — официальный релиз | MiMo-V2.5 | MiMo-V2.5-Pro | Рекомендуемая модель | Причина |
|---|---|---|---|---|
| Основное позиционирование | Омнимодальная модель и эффективные агенты | Флагманский агент и сложное кодирование | Выбор по типу задач | Омнимодальные входы — за V2.5; длительные сложные текстовые задачи — за Pro. |
| Архитектура | Разрежённая MoE | Разрежённая MoE | Выбор по типу задач | Один лишь размер модели не делает её лучшим выбором для любой задачи. |
| Общие параметры | 310B | 1.02T | Выбор по типу задач | Большая модель нацелена на сложное рассуждение, но сам размер — не результат задачи. |
| Активные параметры | 15B | 42B | Выбор по типу задач | Ориентируйтесь на завершение задач и стоимость. |
| Слои LLM | 48 | 70 | Выбор по типу задач | Число слоёв описывает архитектуру, а не универсальное превосходство. |
| Эксперты с маршрутизацией | 256 | 384 | Выбор по типу задач | Разница важна лишь если улучшает целевую нагрузку. |
| Экспертов на токен | 8 | 8 | Любая | Обе активируют восемь экспертов на токен. |
| Окно контекста | 1M токенов | 1M токенов | Любая | Обе заявляют окно в 1M токенов; тестируйте реальное извлечение. |
| Максимальный вывод | 128K токенов | 128K токенов | Любая | Обе заявляют до 128K токенов вывода. |
| Входные модальности | Текст, изображение, видео и аудио | Текст | MiMo-V2.5 | V2.5 принимает изображения, видео и аудио; Pro ориентирован на текстовый ввод. |
| Вызов инструментов | Да | Да | Выбор по типу задач | Обе вызывают инструменты; тестируйте успех на реальной траектории. |
| Открытые веса и лицензия | Да; MIT | Да; MIT | Любая | Обе модели с открытыми весами (MIT); стоимость сервинга различается. |
Решающее отличие: мультимодальность против агент-ориентированного подхода
V2.5 нативно принимает текст, изображения, видео и аудио. Xiaomi сочетает языковой бэкенд с визуальным энкодером на 729M параметров и аудиоэнкодером на 261M параметров, позволяя мультимодальной информации напрямую участвовать в одном и том же процессе рассуждения.
- Анализировать скриншоты до вызова инструментов.
- Понимать видео и его аудиодорожку вместе.
- Извлекать информацию из диаграмм и изображений документов.
- Работать с агентами для визуальных интерфейсов и мультимодальной поддержки.
- Рассуждать по длинным видеопоследовательностям.
V2.5-Pro следует другому дизайну. На текущий момент Xiaomi указывает текст как входную модальность и делает упор на глубокое рассуждение, разработку кода и длительную оркестрацию инструментов.
Если в самом рабочем процессе есть входы в виде изображений, видео или аудио, начинайте с V2.5. Тестируйте Pro, когда сложность заключается в рассуждении по тексту, исходному коду, инструментам или длинной агентной траектории.

Официальное сравнение мультимодальных бенчмарков Xiaomi.
Почему V2.5-Pro может быть лучше на сложных задачах
Масштаб модели: 310B/15B vs 1.02T/42B
Обе модели используют разрежённые бэкенды Mixture-of-Experts, гибрид внимания со скользящим окном и глобальными головами, а также три модуля Multi-Token Prediction. Карточка модели V2.5 фиксирует общий размер 310B и 15B активных параметров; карточка Pro масштабирует это до 1.02T общих параметров и 42B активных на токен.
| Архитектура — официальная карточка модели | V2.5 | Pro | Разница |
|---|---|---|---|
| Общие параметры | 310B | 1.02T | ≈3,3× |
| Активные параметры | 15B | 42B | 2,8× |
| Скрытая размерность | 4,096 | 6,144 | 1,5× |
| Слои LLM | 48 | 70 | +22 |
| Голов внимания | 64 | 128 | 2× |
| Эксперты с маршрутизацией | 256 | 384 | 1,5× |
| Экспертов на токен | 8 | 8 | То же |
| Слои MTP | 3 | 3 | То же |
V2.5 использует шаблон внимания 5:1, а Pro переходит к локально-глобальному шаблону 6:1. По словам Xiaomi, эти конструкции уменьшают требования к KV-кэшу почти в 6× и 7× соответственно по сравнению с полным вниманием на всех уровнях.
Общее число параметров не переводится линейно в качество ответа. Больший бэкенд Pro важнее всего, когда сложность рассуждения или длина траектории заставляет небольшие приросты надёжности на шаг увеличиваться в совокупности.
Почему небольшие приросты надёжности складываются
Длинная задача агента состоит из множества зависимых шагов. Ошибка на раннем вызове инструмента может привести к повторам или обесценить последующие шаги, поэтому умеренный прирост надёжности на шаге может существенно повлиять на завершение от конца до конца. Оценивайте этот эффект на репрезентативных задачах, а не предполагая, что размер модели сам по себе всё гарантирует.
Где V2.5-Pro реально улучшает результаты?
Самое чистое численное сравнение — базовая оценка от Xiaomi, где обе модели тестируются в одинаковых условиях. Это позволяет избежать смешения результатов, полученных разными хранилищами или конфигурациями постобучения.
Общие знания: небольшой–умеренный прирост
В базовом сравнении от Xiaomi Pro выигрывает 1,2 пункта на BBH, 3,1 на MMLU и 2,7 на MMLU-Pro. Это измеримо, но меньше, чем приросты на более сложных задачах рассуждения.
Математика и наука: больший прирост
В той же базовой оценке Pro добавляет 8,6 пункта на GPQA-Diamond, 16,3 на GSM8K и 18,5 на MATH. Это наиболее явное основание выбирать Pro, когда успех задачи определяется сложным рассуждением.
Программирование: лучше, но не всегда равномерно
Отмеченные приросты составляют 4,3 пункта на HumanEval+, 3,2 на MBPP+, 4,1 на LiveCodeBench v6 и 4,9 на SWE-Bench AgentLess. Тестируйте задачи уровня репозитория и использование инструментов отдельно: эти базовые показатели не покрывают все производственные агентные сценарии.
Результат бенчмарка: Pro не втрое лучше лишь потому, что стоит примерно втрое дороже. Его ценность прогрессивно растёт по мере увеличения сложности рассуждения и длительности задачи.
Эти строки — базовые оценки моделей, а не обещание, что продакшн API воспроизведёт те же баллы. Результаты агентов зависят от инструментов, подсказок, повторов, окружения исполнения и бюджетов токенов.
Постобучение и агенты с длинным горизонтом
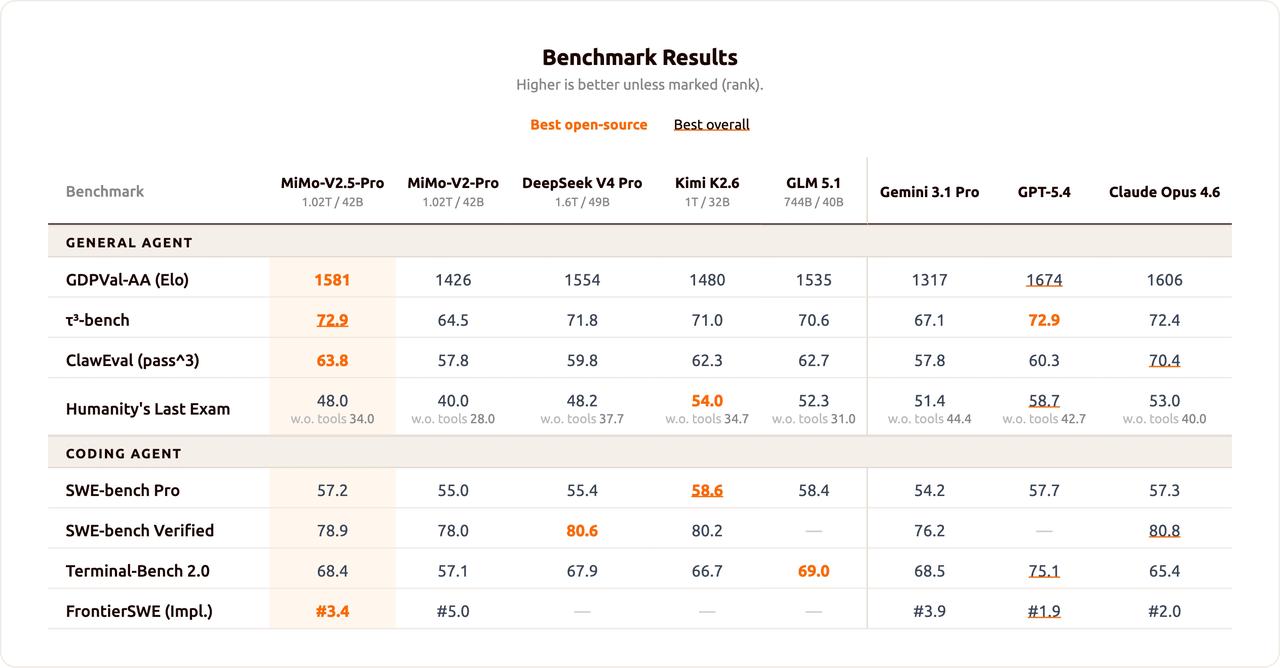
Продакшн-модели добавляют supervised fine-tuning, агентное reinforcement learning и Multi-Teacher On-Policy Distillation. Xiaomi сообщает постобученные результаты: 56,1 на SWE-bench Pro, 65,8 на Terminal-Bench 2.0 и 62,1 Pass³ на общей части Claw-Eval для V2.5.
Pro ещё явнее оптимизирована для длинного горизонта в разработке ПО. Xiaomi описывает сотни вызовов инструментов в устойчивых траекториях и публикует результат 78,9% на SWE-bench Verified.
Один официальный кейс показывает, что Pro завершил компилятор SysY за 4,3 часа с 672 вызовами инструментов и прохождением всех 233 тестов. Урок не в том, что каждому запросу кодирования нужна Pro; а в том, что небольшие различия в надёжности могут определить, завершится ли рабочий процесс с сотнями зависимых действий.

Официальная диаграмма бенчмарков по кодированию и агентам Xiaomi.
Длинный контекст: одинаковая ёмкость, разные рабочие нагрузки
Обе модели предоставляют окно контекста на 1M токенов и до 128K токенов вывода через текущий API Xiaomi. Следовательно, чистый размер контекста их не различает.
V2.5 привлекателен, когда длинный контекст включает мультимодальные материалы, такие как видео, изображения документов или визуальные следы агентов. Pro — модель для тестирования, когда сам контекст становится задачей рассуждения: крупный репозиторий, длинный контракт, исследовательский корпус или агентная траектория с множеством последовательных действий.
Большое окно контекста описывает ёмкость, но не гарантированную точность рассуждения. Оценивайте извлечение, удержание инструкций и использование доказательств на длинах, важных для приложения.
Цена и эффективность по стоимости
Поминутные цены Xiaomi за рубежом делают компромисс очевидным.
| Цены — официальный прайс-лист | V2.5 | Pro | Соотношение |
|---|---|---|---|
| Некэшированный ввод за 1M токенов | $0.14 | $0.435 | 3,11× |
| Кэшированный ввод за 1M токенов | $0.0028 | $0.0036 | 1,29× |
| Вывод за 1M токенов | $0.28 | $0.87 | 3,11× |
| Окно контекста | 1M | 1M | То же |
| Максимальный вывод | 128K | 128K | То же |
Запрос с 1M некэшированных входных токенов и 200K выходных токенов обойдётся примерно в $0.196 на V2.5 и $0.609 на Pro до учёта кэш-хитов, платных веб-поисков или особенностей биллинга провайдера.
Разница цен при кэше меньше: для кэшированных входов Pro примерно на 29% дороже, а не на 211%. Поэтому долгоживущие агенты со стабильными системными подсказками, определениями инструментов или префиксами репозиториев должны измерять реальную долю кэш-хитов.
Оценивайте стоимость на успешную задачу. Агент на Pro, единожды завершающий сложный рабочий процесс, может стоить дешевле, чем повторные неудачные попытки на более дешёвой модели.
Какую модель использовать?
| Нагрузка — официальные рекомендации | Лучший выбор | Почему |
|---|---|---|
| Рутинный текстовый чат | V2.5 | Ниже стоимость; Pro часто избыточна |
| Массовая генерация | V2.5 | Примерно в 3,1× ниже стоимость стандартных токенов |
| Понимание изображений, видео или аудио | V2.5 | Нативный мультимодальный ввод |
| Рутинные вызовы инструментов | V2.5 | Сильные агентные навыки при меньшей цене |
| Сложная математика и наука | Pro | Большие выигрыши в бенчмарках |
| Кодирование на уровне репозитория | Pro | Спроектирована для сложной разработки ПО |
| Сотни зависимых вызовов инструментов | Pro | Лучше подходит для устойчивого исполнения |
| 1M-контекст при жёстком бюджете | V2.5 | То же окно контекста за гораздо меньшую цену |
Итог выбора: V2.5 — модель по умолчанию для мультимодальных приложений, рутинных агентов и задач с чувствительностью к стоимости. Pro — апгрейд для сложного рассуждения, комплексной разработки ПО и длинных автономных траекторий.
Лучшая продакшн-стратегия: маршрутизация между обеими
Часто нет нужды в едином глобальном выборе модели. Маршрутизируйте мультимодальные и рутинные запросы на V2.5, а эскалируйте только сложное текстовое рассуждение, непростое кодирование или длинное выполнение инструментов на Pro.
| Измерение оценки | Метрика | Почему важно | Сигнал для маршрутизации |
|---|---|---|---|
| Завершение | Успешные задачи / попытки | Отражает надёжность end-to-end | Эскалировать классы с низким завершением |
| Качество | Оценка человеком или по рубрике | Не даёт стоимости токенов доминировать | Эскалировать высокозначимые задачи |
| Надёжность инструментов | Ошибки и повторы | Небольшие ошибки накапливаются у агентов | Эскалировать длинные траектории |
| Задержка | Время до принятого результата | Включает накладные на повторы | Держать интерактивные задачи лёгкими |
| Стоимость | Расход на успешную задачу | Учитывает сбои и перезапуски | Использовать самую дешёвую модель, которая справляется |
Тестируйте обе API в CometAPI
MiMo-V2.5 API в CometAPI и MiMo-V2.5-Pro API в CometAPI поддерживают параллельную оценку через единый агрегирующий слой. Отправляйте одинаковые подсказки, системные инструкции, инструменты и лимиты вывода обеим моделям, затем сравнивайте успех задач и стоимость.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Запустите репрезентативную выборку, содержащую простые запросы, сложное рассуждение, правки кода, задачи с длинным контекстом и вызовы инструментов агентом. Записывайте долю завершения, токены, задержку, ошибки инструментов, повторы, качество ответов и стоимость на успешную задачу.
Ограничения
Ограничения V2.5
Меньший языковой бэкенд оставляет часть производительности на столе по мере роста сложности рассуждения. Разрыв умеренный на BBH, но становится намного больше на GPQA-Diamond и MATH. Окно контекста на 1M токенов также не следует путать с гарантией рассуждения на всех 1M токенов.
Ограничения Pro
Обычные цены на вход и выход примерно в 3,1× выше, чем у V2.5, а текстовый-only ввод делает её неподходящей как drop-in замена для мультимодальных приложений. Модель с открытыми весами на 1.02T параметров также требует много ресурсов при самохостинге, даже несмотря на 42B активных параметров на токен.
Итоговый вердикт
Выбирайте V2.5 для мультимодальных приложений, рутинных агентов и чувствительных к стоимости сценариев. Выбирайте Pro для сложного рассуждения, комплексной разработки ПО и длительных автономных агентов. Для смешанных нагрузок маршрутизируйте основную массу трафика на V2.5 и эскалируйте только те запросы, чья сложность или длина траектории оправдывают дополнительные расходы.
Частые вопросы
Всегда ли Pro лучше, чем V2.5?
Нет. Pro сильнее на сложном текстовом рассуждении и кодировании, но V2.5 поддерживает входы изображения/видео/аудио и значительно дешевле.
Поддерживают ли обе модели окно контекста на 1M токенов?
Да. Обе заявляют 1M токенов контекста и до 128K токенов вывода. Приложения всё равно должны тестировать извлечение и рассуждение на фактических рабочих длинах.
Какую модель должен использовать мультимодальный агент?
Начинайте с V2.5, поскольку он нативно принимает визуальные и аудио входы. Pro в настоящий момент ориентирован на рабочие процессы с текстовым вводом.
Когда Pro оправдывает свою более высокую цену?
Чаще всего — когда лучшая надёжность рассуждения влияет на завершение сложной математики, кодирования на уровне репозитория или длинных траекторий с множеством зависимых вызовов инструментов.
Должны ли продакшн-системы использовать только одну модель?
Не обязательно. Маршрутизатор может держать рутинные и мультимодальные задачи на V2.5, а эскалировать сложное текстовое и агентное выполнение на Pro.