
TL;DR
Claude Opus 5.5 และ Claude Sonnet 5.5 มีบริบท 1M และเอาต์พุตมาตรฐานสูงสุด 128K รองรับอินพุตข้อความและภาพ พร้อมขอบเขตความรู้ถึงมิถุนายน 2026 Opus มุ่งไปที่งานซับซ้อน เปิดกว้าง ส่วน Sonnet มุ่งไปที่งานประจำที่กำหนดขอบเขตชัดเจนและต้องการความเร็ว
ตามอัตรามาตรฐานของ API จาก Anthropic, Sonnet 5.5 มีค่าใช้จ่ายอินพุต $2/M และเอาต์พุต $10/M ซึ่งเท่ากับครึ่งหนึ่งของ Opus 5.5 ที่ $4/M สำหรับอินพุต และ $20/M สำหรับเอาต์พุต คะแนนที่เผยแพร่หลายรายการใกล้เคียงกัน แต่การจัดอันดับแตกต่างกันตามเบนช์มาร์ก Opus ได้คะแนนสูงกว่าบน CursorBench ขณะที่ Sonnet ได้คะแนนสูงกว่าบน Terminal-Bench ผลลัพธ์เหล่านี้ใช้การตั้งค่า effort ต่างกันและไม่ควรถือเป็นการทดสอบแบบ head-to-head ภายใต้การควบคุม
เลือกโมเดลที่ตรงกับความต้องการด้านคุณภาพและเวลาแฝงที่ต้นทุนรวมของงานต่ำที่สุด ทีมควรเปรียบเทียบต้นทุนต่อภารกิจที่ยอมรับได้ เวลาแฝง พฤติกรรมการเรียกใช้เครื่องมือ การลองใหม่ และปริมาณการใช้ดุลยพินิจก่อนตัดสินใจว่า Opus คุ้มค่าพรีเมียมเมื่อใด
Key Takeaways
- ราคา: Sonnet 5.5 มีราคาครึ่งหนึ่งของ Opus 5.5 สำหรับอินพุต/เอาต์พุตมาตรฐาน
- สเปก: ทั้งคู่รองรับหน้าต่างบริบท 1M โทเค็น และเอาต์พุตมาตรฐานสูงสุด 128K
- การเขียนโค้ด: Opus นำบน FrontierCode และ CursorBench ขณะที่ Sonnet มีผล Terminal-Bench 4.0 ที่สูงกว่าที่เผยแพร่
- งานความรู้: Opus ยังคงได้เปรียบเล็กน้อยบน GDPval-AA และ AA-Briefcase
- การนำไปใช้งาน: ทดสอบ Sonnet ที่เร็วกว่าเพื่อการดำเนินการแบบกำหนดขอบเขต และ Opus สำหรับการยกระดับงานซับซ้อน; ตรวจสอบทั้งสองเทียบกับเป้าหมายคุณภาพ เวลาแฝง และต้นทุน
Claude Opus 5.5 vs Sonnet 5.5 at a Glance
| ปัจจัยการตัดสินใจ | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| บริบท / เอาต์พุตมาตรฐานสูงสุด | 1M / 128K | 1M / 128K |
| โมดาลิตีอินพุต/เอาต์พุต | ข้อความ + รูปภาพ -> ข้อความ | ข้อความ + รูปภาพ -> ข้อความ |
| การให้เหตุผล | Adaptive thinking เปิดตลอดเวลา | Adaptive thinking |
| ค่าเริ่มต้น effort บน Claude Platform | Medium | High |
| ราคาทางการ อินพุต/เอาต์พุต | $4 / $20 ต่อ 1M | $2 / $10 ต่อ 1M |
| การอ่านแคช | $0.20 / 1M | $0.10 / 1M |
| เวลาแฝงเปรียบเทียบ | ปานกลาง | เร็ว |
| ไฮไลต์ด้านโค้ด | FrontierCode 54.4%; CursorBench 57.8% | Terminal-Bench 70.6%; CursorBench 55.5% |
| ไฮไลต์งานความรู้ | GDPval-AA 1846 | GDPval-AA 1844 |
| ความเหมาะสมหลัก | งานซับซ้อน คลุมเครือ ระยะยาว | การผลิตงานที่เร็ว กำหนดขอบเขตได้ ทำซ้ำได้ |
Claude Opus 5.5
Claude Opus 5.5 เปิดตัวเมื่อ 22 กันยายน 2026 ในฐานะโมเดลแรกในตระกูล Claude 5.5 Anthropic วางตำแหน่งสำหรับการเขียนโค้ดขั้นสูง เอเจนต์ซับซ้อน งานความรู้ระดับมืออาชีพ และเวิร์กโฟลว์ระยะยาวที่การคงเจตนาให้สอดคล้องตลอดหลายขั้นตอนมีความสำคัญมากกว่าเวลาแฝงต่ำสุด
พฤติกรรมการทำงานที่โดดเด่นที่สุดคือ adaptive thinking ที่เปิดตลอดเวลา นักพัฒนาสามารถควบคุมระดับ effort ในการให้เหตุผลได้ แต่ adaptive thinking เองไม่สามารถปิดได้ สิ่งนี้ทำให้การทดสอบการย้ายสำคัญสำหรับเอเจนต์รุ่นเก่าที่เคยพึ่งพาเส้นทางที่ปิดการคิดหรือค่าเริ่มต้น effort ที่ต่างกัน
API ของ Claude Opus 5.5 บน CometAPI ให้เส้นทางแบบรวมสำหรับโมเดลเดียวกันด้วย model ID claude-opus-5-5 ควบคู่ไปกับโมเดลอื่นเพื่อการจัดเส้นทางงาน
Claude Sonnet 5.5
Claude Sonnet 5.5 เปิดตัวเมื่อ 28 กันยายน 2026 เป็นโมเดลที่สองในตระกูล Claude 5.5 Anthropic อธิบายว่าเป็นคู่เสริมที่เร็วกว่าและต้นทุนต่ำกว่า Opus 5.5 สำหรับงานประจำที่กำหนดขอบเขตดี เช่น การแก้บั๊ก การสร้างเอกสาร การเขียนโค้ด เอเจนต์ และงานด้านการออกแบบ
Anthropic รายงานว่า Sonnet 5.5 สร้างเอาต์พุตได้เร็วกว่า Sonnet 5 มากกว่า 30% และอาจมีต้นทุนต่อภารกิจต่ำกว่าสูงสุด 30% นี่เป็นการเปรียบเทียบที่ผู้ให้บริการรายงานกับ Sonnet 5 ไม่ใช่อัตราความเร็วหรือค่าใช้จ่ายงานเมื่อเทียบกับ Opus 5.5
API ของ Claude Sonnet 5.5 บน CometAPI ใช้ model ID claude-sonnet-5-5 และเหมาะสำหรับทดสอบ Sonnet เป็นชั้นดำเนินการที่ต้นทุนต่ำกว่าในแอปพลิเคชันผสมหลายโมเดล
Claude Opus 5.5 vs Sonnet 5.5: Performance
ผลที่เผยแพร่ของ Anthropic แสดงความแตกต่างของคะแนนเล็กน้อยในการประเมินหลายรายการด้านงานความรู้และการใช้งานคอมพิวเตอร์ Opus รายงานคะแนนสูงกว่าบน FrontierCode, CursorBench และ Humanity’s Last Exam ขณะที่ Sonnet รายงานคะแนนสูงกว่าบน Terminal-Bench การเปรียบเทียบขึ้นกับการตั้งค่า effort และเงื่อนไขการประเมิน
| เบนช์มาร์ก | Claude Opus 5.5 | Claude Sonnet 5.5 | วัดอะไร |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 70.6% | งานเอเจนต์ในสภาพแวดล้อมบรรทัดคำสั่ง |
| FrontierCode 1.1 Main | 54.4% | 46.2% (Max) | วิศวกรรมซอฟต์แวร์ในโลกจริง |
| CursorBench 4.0 | 57.8% | 55.5% | งานโค้ดหลายไฟล์ที่คลุมเครือ |
| GDPval-AA v2.1 | 1846 | 1844 | งานความรู้ระดับมืออาชีพ |
| AA-Briefcase v1.1 | 1822 | 1811 | งานความรู้ระยะยาว |
| Humanity's Last Exam, tools | 67.7% | 64.5% | การให้เหตุผลสหวิทยาการ |
| OSWorld 2.1 | 81.8% | 80.1% | การใช้งานคอมพิวเตอร์ |
| Chartography | 64.4% | 61.6% | การจดจำแผนภูมิแบบภาพ |
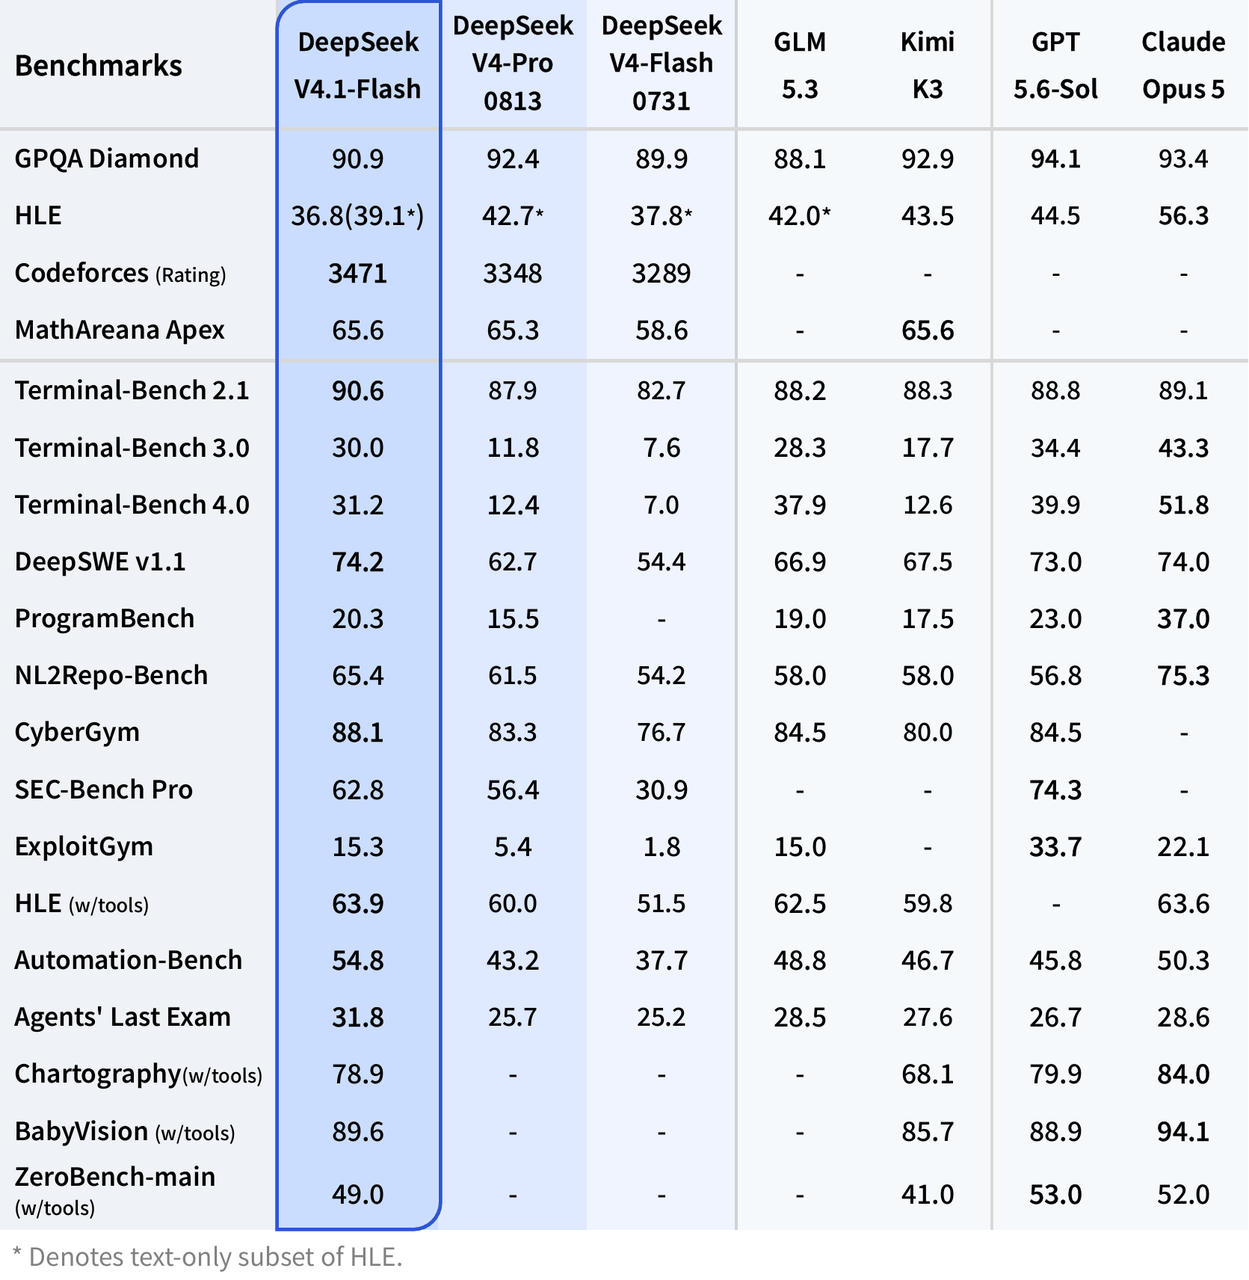
นี่คือผลที่เผยแพร่ ไม่ใช่การเปรียบเทียบภายใต้การควบคุมที่ทำขึ้นสำหรับบทความนี้
- Effort: ผล Terminal-Bench ของ Opus ใช้ Xhigh ส่วนคะแนน FrontierCode ของ Sonnet สูงกว่าที่ Xhigh มากกว่าที่ Max
- การให้คะแนนและเครื่องมือ: OSWorld ใช้การให้คะแนนแบบบางส่วน; ผล Chartography ที่นี่ไม่ใช้เครื่องมือ
- การนำไปใช้งาน: ผล GDPval-AA และ AA-Briefcase ของ Sonnet วัดบนการปรับใช้ก่อนปล่อยที่มีบั๊กเอาต์พุตแบบมีโครงสร้างซึ่งแก้ไขแล้ว
Agentic Coding
ผล 70.6% ของ Sonnet 5.5 บน Terminal-Bench 4.0 สูงกว่าคะแนนที่รายงานของ Opus 5.5 ที่ 66.4% แต่เชิงอรรถอย่างเป็นทางการระบุว่าผลของ Opus อยู่ที่ effort ระดับ Xhigh บน FrontierCode 1.1 Main, Opus นำ 54.4% ต่อ 46.2% Max ของ Sonnet; บน CursorBench 4.0, Opus นำ 57.8% ต่อ 55.5%
ความแตกแยกนี้สำคัญเพราะเบนช์มาร์กเอเจนต์โค้ดให้รางวัลพฤติกรรมต่างกัน Terminal-Bench เน้นการดำเนินการหลายขั้นตอนที่สำเร็จในสภาพแวดล้อมบรรทัดคำสั่ง ขณะที่ CursorBench ใช้งานหลายไฟล์ที่คลุมเครือจากเซสชันโค้ดจริง สำหรับการเขียนโค้ดที่มีขอบเขตและการดำเนินการแบบวนซ้ำ Sonnet สามารถแข่งขันได้สูง; สำหรับงานระดับ repository ที่กว้าง Opus ยังมีหลักฐานที่เข้มแข็งกว่าตามการประเมินที่เผยแพร่ของ Anthropic
งานความรู้และการให้เหตุผล
บน GDPval-AA v2.1, Sonnet 5.5 ได้ 1844 เทียบกับ Opus 5.5 ที่ 1846 บน AA-Briefcase v1.1 ช่องว่างคือ 1811 เทียบกับ 1822 ผลเหล่านี้โดดเด่นเพราะช่องว่างด้านราคามีขนาดใหญ่กว่าช่องว่างของเบนช์มาร์กมาก
Anthropic ระบุว่า Opus 5.5 แข็งแกร่งกว่าสำหรับงานเปิดกว้างซับซ้อนที่ต้องการดุลยพินิจอย่างต่อเนื่อง สำหรับการวิจัย สถาปัตยกรรม และการตรวจสอบ ทดสอบว่าพฤติกรรมนั้นลดการตัดสินใจที่ผิดหรือการแก้ไขโดยมนุษย์ในงานของคุณเองหรือไม่ แทนที่จะสรุปข้อได้เปรียบทางเศรษฐศาสตร์จากส่วนต่างคะแนนเล็กน้อย
การใช้งานคอมพิวเตอร์และงานภาพ
บน OSWorld 2.1 ที่ใช้การให้คะแนนแบบบางส่วน Opus ได้ 81.8% และ Sonnet 80.1% บน Chartography แบบไม่ใช้เครื่องมือ คะแนนคือ 64.4% และ 61.6% ตามลำดับ สำหรับเอเจนต์ที่ใช้งานเบราว์เซอร์หรือ GUI สิ่งนี้ชี้ว่าเวลาแฝง ประสิทธิภาพการเรียกใช้เครื่องมือ และต้นทุนระดับภารกิจอาจมีความสำคัญพอๆ กับช่องว่างคะแนนหลัก
การตีความเบนช์มาร์ก
เรื่องราวของเบนช์มาร์กไม่ใช่ว่า Sonnet แทนที่ Opus แต่คือ Anthropic ลดช่องว่างความสามารถลงจนรูปร่างงานมีความสำคัญมากกว่าชั้นของโมเดลเพียงอย่างเดียว งานที่กำหนดขอบเขตดีและไวต่อเวลาแฝงเริ่มเอียงเข้าหาเศรษฐศาสตร์ของ Sonnet ขณะที่ความคลุมเครือ ขอบเขตยาว และต้นทุนความล้มเหลวที่สูงยังเป็นเหตุผลหลักในการทดสอบ Opus
Claude Opus 5.5 vs Sonnet 5.5: Pricing
ราคาทางการของ Claude API
Opus pricing specification และ Sonnet pricing specification แยกอัตราโทเค็นมาตรฐาน หน้าต่างการเก็บแคช และส่วนลด Batch ราคาด้านล่างเป็น USD ต่อหนึ่งล้านโทเค็น; โปรดยืนยันตัวปรับแต่งบริการเสริมแยกต่างหาก
| เมตริกราคา | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| อินพุต / 1M โทเค็น | $4.00 | $2.00 |
| เอาต์พุต / 1M โทเค็น | $20.00 | $10.00 |
| การอ่านแคช / 1M โทเค็น | $0.10 | $0.20 |
| การเขียนแคช 5 นาที / 1M โทเค็น | $5.00 | $2.50 |
| การเขียนแคช 1 ชั่วโมง / 1M โทเค็น | $8.00 | $4.00 |
| Batch อินพุต / 1M โทเค็น | $2.00 | $1.00 |
| Batch เอาต์พุต / 1M โทเค็น | $10.00 | $5.00 |
Sonnet มีอัตราอินพุต เอาต์พุต และการเขียนแคชมาตรฐานครึ่งหนึ่ง
การอ่านแคชช่วยตามอัตราส่วนราคา 2:1 เดียวกัน: Sonnet 5.5 มีค่า $0.10/M สำหรับอินพุตที่แคชไว้ ขณะที่ Opus 5.5 มีค่า $0.20/M การใช้คำนำหน้าที่แคชซ้ำช่วยลดต้นทุนอินพุตสำหรับทั้งสองโมเดล โดยยังคงอัตราต่อโทเค็นที่ต่ำกว่าของ Sonnet การประหยัดต้นทุนรวมของภารกิจยังขึ้นกับความยาวเอาต์พุต การเขียนแคช การลองใหม่ และอัตราการยอมรับ
ต้นทุนต่อภารกิจที่ยอมรับ
ตัวอย่างง่ายๆ การร้องขอที่มีอินพุต 100K โทเค็นที่ไม่แคชและเอาต์พุต 10K โทเค็น มีค่าใช้จ่ายประมาณ $0.60 บน Opus 5.5 และ $0.30 บน Sonnet 5.5 ตามอัตรามาตรฐาน แต่ความแตกต่างของอัตราโทเค็น 2 เท่า ไม่ได้การันตีความแตกต่างของต้นทุนต่อความสำเร็จ 2 เท่า การลองใหม่ การเรียกเครื่องมือ ความยาวเอาต์พุต ฮิตของแคช ความพยายามที่ล้มเหลว และการแก้ไขโดยมนุษย์สามารถเปลี่ยนผลลัพธ์ได้
ดังนั้นการประเมินในระบบจริงควรบันทึกต้นทุนต่อภารกิจที่ยอมรับควบคู่ไปกับอัตราการทำสำเร็จ เวลาแฝง p50/p95 การลองใหม่ การเรียกเครื่องมือ และการแทรกแซงของมนุษย์
ราคาของ CometAPI
แคตาล็อกโมเดลของ CometAPI โปรโมตส่วนลด 20% สำหรับหลายเส้นทางของ Anthropic ที่รองรับ สำหรับ Claude Opus 5.5 API ใน CometAPI ราคาที่อ้างอิงในแคตาล็อกคือ $3.20/M อินพุต และ $16/M เอาต์พุต สำหรับ Claude Sonnet 5.5 API ใน CometAPI ข้อมูลแคตาล็อกแบบโลคัลไลซ์แสดง $1.60/M อินพุต และ $8/M เอาต์พุต เนื่องจากราคาเกตเวย์อาจเปลี่ยน โปรดยืนยันเส้นทางโมเดลสดก่อนวางงบประมาณทราฟฟิกผลิตจริง
| อัตรา CometAPI | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| อินพุต / 1M | $3.20 | $1.60 |
| เอาต์พุต / 1M | $16.00 | $8.00 |
| ส่วนลดสัมพัทธ์เทียบทางการ | 20% | 20% |
Claude Opus 5.5 vs Sonnet 5.5: Technical Specifications
ทั้งสองโมเดลแชร์ขีดจำกัดบริบทและเอาต์พุตหลักตามที่แสดงในตาราง At a Glance ขีดจำกัดเอาต์พุต 300K เพิ่มเติมเป็นความสามารถแบบเบตาของ Batch API ไม่ใช่ขีดจำกัดเอาต์พุตแบบโต้ตอบมาตรฐาน
ความยาวบริบทไม่ใช่ตัวแยกความแตกต่างระหว่างสองโมเดลนี้ ทั้งสองรองรับหน้าต่าง 1M โทเค็นและเพดานเอาต์พุตมาตรฐาน 128K ความแตกต่างที่มีความหมายมากกว่าคือพฤติกรรมการให้เหตุผล ความเร็ว และปริมาณดุลยพินิจที่งานต้องการ
การปรับปรุงความเร็วเอาต์พุตของ Sonnet ที่รายงานเป็นการเทียบกับ Sonnet 5 Opus ยังมี Fast mode ที่ให้อัตราการส่งผ่านโทเค็นเอาต์พุตสูงสุด 2.5 เท่า โดยมีราคา $8/M อินพุต และ $40/M เอาต์พุต เป็นการแสดงตัวอย่างเชิงวิจัยบน Claude API; นี่ไม่ใช่การรับประกันความเร็วภารกิจแบบ end-to-end หรือเวลาโทเค็นแรกที่เร็วขึ้น 2.5 เท่า
การเปิดเผยสถาปัตยกรรมและพฤติกรรมการผสาน
เอกสารที่อ้างถึงไม่ได้เปิดเผยจำนวนพารามิเตอร์หรือรายละเอียดสถาปัตยกรรมภายในเพียงพอสำหรับการเปรียบเทียบแบบ dense-versus-MoE ที่น่าเชื่อถือ เปรียบเทียบอินเทอร์เฟซและพฤติกรรมที่บันทึกแทน ทั้งสองการย้ายต้องทดสอบข้อจำกัดการเลือกเครื่องมือและการคงไว้ซึ่งการคิด; adaptive thinking ของ Opus ไม่สามารถปิดได้ ตรวจสอบสถานะการสนทนาเมื่อจัดเส้นทางระหว่างโมเดล แทนที่จะส่งต่อบล็อกการคิดที่ไม่โปร่งใสโดยไม่ตรวจสอบความเข้ากันได้
Claude Opus 5.5 vs Sonnet 5.5: Use Cases
กลยุทธ์การปรับใช้ที่มีประโยชน์คือพิจารณา Sonnet 5.5 เป็นโมเดลดำเนินการเริ่มต้น และ Opus 5.5 เป็นโมเดลยกระดับ สิ่งนี้สามารถลดค่าใช้จ่ายสำหรับงานที่ระบุชัดเจน ทำซ้ำได้ ขณะสงวน Opus สำหรับงานที่ได้รับประโยชน์จากดุลยพินิจที่ยาวนาน การประหยัดขึ้นอยู่กับอัตราการยอมรับของ Sonnet และความถี่ที่งานต้องยกระดับ
การเลือกตามลักษณะงาน
| ลักษณะงาน | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| การเขียนโค้ดประจำ | ทำได้ดี ต้นทุนสูงกว่า | เหมาะมาก |
| การแก้บั๊ก | มีประโยชน์สำหรับเคสยาก | เหมาะมาก |
| ทราฟฟิก API ปริมาณสูง | ต้นทุนต่อหน่วยสูงกว่า | เหมาะมาก |
| สร้างเอกสาร/สไลด์ | แข็งแรง | ประหยัดกว่า |
| ซับเอเจนต์ด้านโค้ด | ใช้แบบคัดเลือก | เหมาะมาก |
| การย้ายระดับ repository | เหมาะมาก | ทดสอบสำหรับงานมีขอบเขต |
| สถาปัตยกรรมที่คลุมเครือ | เหมาะมาก | ขึ้นกับความซับซ้อน |
| เอเจนต์อัตโนมัติระยะยาว | เหมาะมาก | ชั้นดำเนินการที่ดี |
| วิจัย/วิเคราะห์ยาก | เหมาะมาก | ดีสำหรับงานมีขอบเขต |
| UX ที่ไวต่อเวลาแฝง | ปานกลาง | เหมาะมาก |
| งานผลิตผสม | โมเดลยกระดับ | โมเดลดำเนินการเริ่มต้น |
ตัวกำหนดเส้นทางที่ใช้ได้จริงสามารถเริ่มด้วย Sonnet และยกระดับเมื่อภารกิจข้ามเกณฑ์ความคลุมเครือ ความยาวลูปเครื่องมือ ความล้มเหลวซ้ำ หรือผลกระทบต่อธุรกิจ กฎการจัดเส้นทางควรได้รับการตรวจสอบกับงานที่เหมือนการผลิต แทนที่จะสรุปจากคะแนนเบนช์มาร์ก
How to Call Opus 5.5 and Sonnet 5.5 Through CometAPI
สร้างคีย์ API ของ CometAPI และกำหนดค่าไคลเอนต์ที่เข้ากันกับ Anthropic ให้ใช้เอ็นด์พอยต์ของ CometAPI เลือก model ID สำหรับงาน ส่งพรอมป์ตผ่าน Messages API และอ่านการตอบกลับข้อความ เมื่อเปรียบเทียบโมเดล ให้คงพรอมป์ต เพดานเอาต์พุต เครื่องมือ และเกณฑ์การยอมรับให้สอดคล้องกัน และบันทึกระดับ effort ที่ใช้งานจริง
ตัวอย่าง Opus 5.5
สำหรับการรีวิวแผนการย้าย ให้เลือก claude-opus-5-5 และขอให้โมเดลระบุขั้นตอนที่มีความเสี่ยงสูงสุด อธิบายผลกระทบ และแนะนำวิธีป้องกัน ส่งคำขอผ่าน Messages API ของ CometAPI และตรวจทานข้อความที่ส่งกลับ
ตัวอย่าง Sonnet 5.5
สำหรับการรีวิวแผนการย้ายเดียวกัน ให้เลือก claude-sonnet-5-5 และส่งพรอมป์ตและเพดานเอาต์พุตเดียวกันผ่าน CometAPI เปรียบเทียบคำตอบกับเกณฑ์การยอมรับเดียวกัน แล้วบันทึกเวลาแฝง การลองใหม่ และต้นทุนจริงก่อนตัดสินใจว่าโมเดลใดเหมาะกับงาน
สำหรับการจัดเส้นทางในระบบผลิต ให้เก็บทั้งสอง model ID ไว้หลังอินเทอร์เฟซแอปเดียวกัน และล็อกคุณภาพการทำสำเร็จ เวลาแฝง การลองใหม่ และต้นทุนที่คิดจริง หลีกเลี่ยงการยกระดับเพียงเพราะพรอมป์ตยาว; ความคลุมเครือและต้นทุนความล้มเหลวมักเป็นสัญญาณที่ดีกว่า
Conclusion
Claude Opus 5.5 และ Sonnet 5.5 มีขอบเขตทางเทคนิคเกือบเหมือนกัน ดังนั้นการเลือกโมเดลจึงเกี่ยวข้องกับเศรษฐศาสตร์และพฤติกรรมงานมากกว่าขนาดบริบท Sonnet ผสานความเร็วในการดำเนินการที่สูงกว่าและโทเค็นมาตรฐานที่มีราคาเพียงครึ่งหนึ่งเข้ากับประสิทธิภาพเบนช์มาร์กที่มักใกล้เคียงกับ Opus
Opus มีคุณค่ามากขึ้นเมื่อความคลุมเครือ ระยะเวลาภารกิจ และต้นทุนการตัดสินใจผิดเพิ่มขึ้น คุณค่าของมันน้อยเกี่ยวกับการมีบริบทที่ใหญ่กว่า และมากกว่าคือความสามารถในการคงดุลยพินิจผ่านเวิร์กโฟลว์ที่ยากและเปิดกว้าง
สำหรับหลายทีมการผลิต สถาปัตยกรรมที่มีประสิทธิภาพที่สุดจะใช้ทั้งสอง: Sonnet สำหรับงานส่วนใหญ่ที่ทำซ้ำได้ และ Opus สำหรับชุดงานที่การให้เหตุผลที่แข็งแกร่งช่วยลดความล้มเหลว การลองใหม่ หรือการแทรกแซงของมนุษย์อย่างมีนัยสำคัญ
FAQ
ตัวจัดเส้นทาง Claude 5.5 ควรป้องกันลูปการยกระดับที่มีราคาแพงอย่างไร?
กำหนดจำนวนความพยายามสูงสุดและงบประมาณก่อนการดำเนินการ ยกระดับหลังจากความล้มเหลวที่ทำซ้ำได้ หลักฐานที่หายไป หรือเกณฑ์คุณภาพเฉพาะภารกิจ แทนที่จะหลังจากคำตอบที่ไม่แน่ใจทุกครั้ง บันทึกว่าความล้มเหลวใดทริกเกอร์ Opus และมันปรับปรุงผลลัพธ์ที่ยอมรับได้หรือไม่ หากไม่มีโมเดลใดผ่าน ให้ส่งคืนประเด็นที่ยังไม่แก้เพื่อการตรวจทานแทนการลองไม่สิ้นสุด
จะเปรียบเทียบ Opus และ Sonnet อย่างยุติธรรมบนงานหนึ่งได้อย่างไร?
ใช้ชุดภารกิจเดียวกัน เครื่องมือที่มีอยู่ หลักฐานอินพุต เพดานเอาต์พุต และรูบริกการให้คะแนนเดียวกัน บันทึก effort ที่ใช้จริงและทดสอบแบบแคชเย็นและแคชอุ่นแยกกัน ตรวจทานผลโดยไม่เปิดเผยโมเดลเมื่อทำได้ รายงานอัตราการยอมรับและต้นทุนรวมรวมถึงความพยายามที่ไม่สำเร็จ; ราคาต่อโทเค็นเท่ากันหรือเบนช์มาร์กเดียวไม่ยืนยันคุณค่าเท่ากัน
ควรรักษาอะไรไว้เมื่อสลับโมเดล Claude 5.5 กลางภารกิจ?
รักษาคำสั่งผู้ใช้ หลักฐานที่เกี่ยวข้อง ผลเครื่องมือ และสรุปความคืบหน้าอย่างชัดเจน ปฏิบัติต่อสถานะการคิดที่ไม่โปร่งใสว่าเฉพาะโมเดลและการสนทนา; อย่าคิดว่าสามารถเล่นซ้ำข้ามเส้นทางได้ ทดสอบพฤติกรรมการส่งต่อที่ผู้ให้บริการรองรับก่อนใช้งานจริง โดยเฉพาะหากเวิร์กโฟลว์ผสมบัญชี เกตเวย์ หรือ SDK
ควรประเมินการเลือกโมเดล Claude 5.5 ใหม่เมื่อใด?
รันการทดสอบการยอมรับที่ได้รับผลกระทบอีกครั้งหลังจากแก้ไขการปรับใช้ เปลี่ยนกฎการจัดเส้นทาง เปลี่ยนราคา เปลี่ยนเครื่องมือ หรืออัปเดตพรอมป์ตอย่างมีนัยสำคัญ เก็บรันก่อนหน้าเป็นฐาน และบันทึกวันที่ model ID เอ็นด์พอยต์ การกำหนดค่า และเวอร์ชันฮาร์เนส เพื่อแยกแยะการเปลี่ยนโมเดลออกจากการเปลี่ยนในแอปพลิเคชันรอบๆ