
TLDR: DeepSeek-V4.1-Flash-1017 เป็นอัปเดตเล็กแต่ทรงพลังของรุ่น V4.1-Flash เมื่อวันที่ 17 ตุลาคม 2026 ส่งมอบผลลัพธ์ที่แข็งแกร่งขึ้นในบรรดามาตรฐานด้านการให้เหตุผล การเขียนโค้ด งานเชิงเอเจนต์ และภาพ พร้อมทั้งให้เอาต์พุตสั้นลงและทำงานเสร็จเร็วขึ้น—ผลักดันเส้นพาเรโตด้านสมรรถนะ-ต้นทุนให้ก้าวหน้า
ประเด็นสำคัญ
- DeepSeek-V4.1-Flash-1017 เปิดตัววันที่ 17 ตุลาคม 2026 เป็นการอัปเกรดฟรีสำหรับ
deepseek-flashบน API เดิม—ผู้ใช้เดิมไม่ต้องเปลี่ยนโค้ด - ผู้ให้บริการรายงานว่าได้คะแนนสูงขึ้นบน 11 มาตรฐานที่ระบุ เทียบกับ V4.1-Flas เดือนกันยายนh โดยเพิ่มขึ้นมากที่สุดในงานเชิงเอเจนต์และการเขียนโค้ด
- สถาปัตยกรรม: Mixture-of-Experts 552B พารามิเตอร์ ด้วยดีไซน์ Causal Encoder-Decoder (ใช้งานพารามิเตอร์ ≈8B ในอินพุต/Prefill และ 16B ในการถอดรหัส/สร้างเอาต์พุต); หน้าต่างบริบท 1M โทเค็น; เอาต์พุตสูงสุด 384K โทเค็น; รองรับภาพแบบเนทีฟ
- ราคาไม่เปลี่ยน: นอกช่วงพีค $0.15 / $0.60 ต่อ 1M โทเค็นอินพุต (ไม่มีแคช) / เอาต์พุต (ช่วงพีคคิดสองเท่า); โทเค็นแคชฮิตราคาราว $0.003 โดย CometAPI ตั้งราคาต่ำกว่าเรตทางการ 20%
- เปิดใช้ Search & Fetch APIs สำหรับนักพัฒนาทุกคน ($0.75 ต่อ 1,000 คอลล์; ฟรีผ่านบางเครื่องมือฝั่งเซิร์ฟเวอร์จนถึง 31 ต.ค. 2026)
- ความสามารถ “wish-driven programming” ที่แข็งแกร่งสำหรับการสร้างโปรเจ็กต์แบบครบวงจร (เกม ฉาก 3D รีโพเต็ม) แข่งกับรุ่นปิดขนาดใหญ่บนเบนช์มาร์กเอเจนต์/โค้ดได้ ในขณะที่ยังถูกและเร็วสำหรับงานโปรดักชันจำนวนมาก
- น้ำหนักโอเพนซอร์สภายใต้ MIT บน Hugging Face และ ModelScope รองรับการโฮสต์เองและปรับจูน
- สำหรับการใช้งานโปรดักชัน แพลตฟอร์มอย่าง CometAPI ให้การเข้าถึงแบบเข้ากันได้กับ OpenAI สำหรับโมเดล DeepSeek และอีกกว่า 500 รุ่น มักมีราคาที่แข่งขันได้และสลับใช้งานได้ง่าย
DeepSeek ยังคงผลักดันขอบเขตของโมเดล AI ที่มีประสิทธิภาพและมีสมรรถนะสูง ในวันที่ 17 ตุลาคม 2026 บริษัทได้ปล่อย DeepSeek-V4.1-Flash-1017 ซึ่งเป็นอัปเดตเจาะจงสำหรับรุ่น V4.1-Flash (เปิดตัวครั้งแรก 10 กันยายน 2026) โฆษณาว่าปรับปรุงอย่างมีนัยสำคัญด้านการให้เหตุผล การเขียนโค้ด ความสามารถเชิงเอเจนต์ และความเข้าใจเชิงภาพ—พร้อมลดเวลาทำงานและความยาวเอาต์พุต—เช็คพอยต์นี้ถูกวางตำแหน่งให้เป็นโมเดลประสิทธิภาพสูงสุดที่คุ้มค่าที่สุดของ DeepSeek สำหรับงานเอเจนต์และการเขียนโค้ดในโลกจริง
โมเดลเปิดให้ใช้บนเว็บไซต์ แอปมือถือ และ API ของ DeepSeek (ยังใช้ชื่อ deepseek-flash) น้ำหนักโมเดลปล่อยแบบเปิดภายใต้สัญญาอนุญาต MIT ทำให้เป็นตัวเลือกโอเพนเวตที่แข็งแกร่งสำหรับนักพัฒนาที่ต้องการสมรรถนะระดับแนวหน้าโดยไม่ต้องจ่ายต้นทุนระดับแนวหน้า
DeepSeek V4.1-Flash-1017 คืออะไรแน่?
DeepSeek-V4.1-Flash-1017 เป็นเช็คพอยต์ลงวันที่ (“1017” หมายถึงปล่อยวันที่ 17 ตุลาคม) ของตระกูล V4.1-Flash DeepSeek อธิบายว่าเป็น “อัปเดตเล็ก” แต่การปรับปรุงกว้างและมีความหมาย: คะแนนสูงขึ้นในทุกหมวดเบนช์มาร์กรายงาน งานเสร็จเร็วขึ้น และเอาต์พุตสั้นลง บริษัทจัดกรอบว่าเป็นการปรับปรุงแบบพาเรโตแท้จริง—สมรรถนะดีขึ้นและความคุ้มค่าดีขึ้นพร้อมกัน
โมเดลนี้สืบทอดสถาปัตยกรรมเชิงนวัตกรรมที่เปิดตัวพร้อม V4.1-Flash:
- ดีไซน์ Mixture-of-Experts (MoE) ด้วยพารามิเตอร์รวมประมาณ 552B (พร้อมพารามิเตอร์ Engram เพิ่มเติมในบางรายงาน) สถาปัตยกรรม Causal Encoder-Decoder ที่เปิดใช้งานเพียง ~8B พารามิเตอร์ต่อโทเค็นระหว่างการพรีฟิลล์/ประมวลผลอินพุต และ ~16B ระหว่างการถอดรหัส/สร้างเอาต์พุต
- KV cache ที่บีบอัดอย่างมาก (อ้างว่าลดการใช้ HBM เหลือ 1/4 และ SSD เหลือ 1/8 เทียบกับรุ่นก่อน) ลดต้นทุนของบริบทยาวและการโต้ตอบหลายรอบของเอเจนต์อย่างมาก
- รองรับมัลติโหมดแบบเนทีฟ (อินพุตข้อความ + รูปภาพ → เอาต์พุตข้อความ) หน้าต่างบริบท 1 ล้านโทเค็น และความยาวเอาต์พุตสูงสุด 384K โทเค็น (การสุ่มตัวอย่างที่แนะนำมักตั้งค่า ≥256K โทเค็นสูงสุด)
- รองรับโหมดคิด/ไม่คิด การเรียกเครื่องมือ เอาต์พุต JSON และการปรับระดับความพยายามด้านการให้เหตุผล
โมเดลถูกฝึกด้วยเทคนิคการเรียนรู้เสริมแรงที่เพิ่มพูน รวมถึงลูปการป้อนกลับด้วยตนเอง โดยมุ่งปรับปรุงการพัฒนาโปรเจ็กต์แบบครบวงจร ทำให้ “wish-driven programming” เชื่อถือได้มากขึ้น—เปลี่ยนเป้าหมายภาษาธรรมชาติระดับสูงให้เป็นโปรเจ็กต์ที่สมบูรณ์และใช้งานได้จริง เช่น เกมเว็บ ฉาก 3D หรือรีโพโค้ดเต็มรูปแบบ
สำหรับนักพัฒนาแอปพลิเคชัน สิ่งนี้เปลี่ยนคำถามในการประเมิน จากเดิมตรวจว่ามันเขียนฟังก์ชันที่ดูสมเหตุผลได้หรือไม่ มาเป็นตรวจว่ามันเข้าใจโค้ดเบสที่มีอยู่ ทำการแก้ไขอย่างสอดประสาน รันเช็ค และซ่อมข้อผิดพลาดได้หรือไม่ การสาธิตที่น่าเชื่อถือแสดงศักยภาพที่ควรทดสอบ; แต่มิได้รับประกันความเชื่อถือได้ในทุกรีโพที่เป็นไปได้
อัปเดตนี้ยังทำให้ “ประสิทธิภาพเอาต์พุต” ควรแยกวัดจากคุณภาพคำตอบ เอาต์พุตที่สั้นลงช่วยลดต้นทุนการสร้าง แต่เฉพาะเมื่อยังคงรักษาการนำไปใช้ คำอธิบาย หรือหลักฐานที่งานต้องการไว้ การตัดทอนการยืนยันที่เป็นประโยชน์จะถือว่าเป็นการถอยหลัง แม้บิลโทเค็นจะลดลง
ข้อกำหนด API ของ DeepSeek V4.1-Flash-1017
| Specification | DeepSeek V4.1-Flash-1017 |
|---|---|
| Native API identifier | deepseek-flash |
| Context window | 1M tokens |
| Maximum output | 384K tokens |
| Input support | Text and images |
| Reasoning modes | Thinking and non-thinking |
| Developer features | Tool calls, JSON output, Responses API |
| Architecture | Causal Encoder–Decoder MoE |
| Announced family parameter count | 552B |
| Active parameters | 8B for input; 16B for output |
DeepSeek V4.1-Flash-1017 ทำผลงานบนเบนช์มาร์กอย่างไร?
การทดสอบอิสระระยะต้น (เช่น เทียบข้างกับ DeepSeek V4 Pro) พบว่า 1017 ให้คุณภาพเทียบเคียงในงานปฏิบัติจริง ในขณะที่เร็วและถูกกว่ามาก พร้อมเพิ่มการรองรับวิชั่นซึ่ง Pro ขาดในบางคอนฟิก
ผลลัพธ์ที่ผู้ขายเลือกนำเสนอ เปรียบเทียบรุ่นเดือนกันยายนกับอัปเดตวันที่ 17 ตุลาคม
| Official benchmark results | September release | October 17 update | Absolute score change (points) |
|---|---|---|---|
| HLE without tools | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
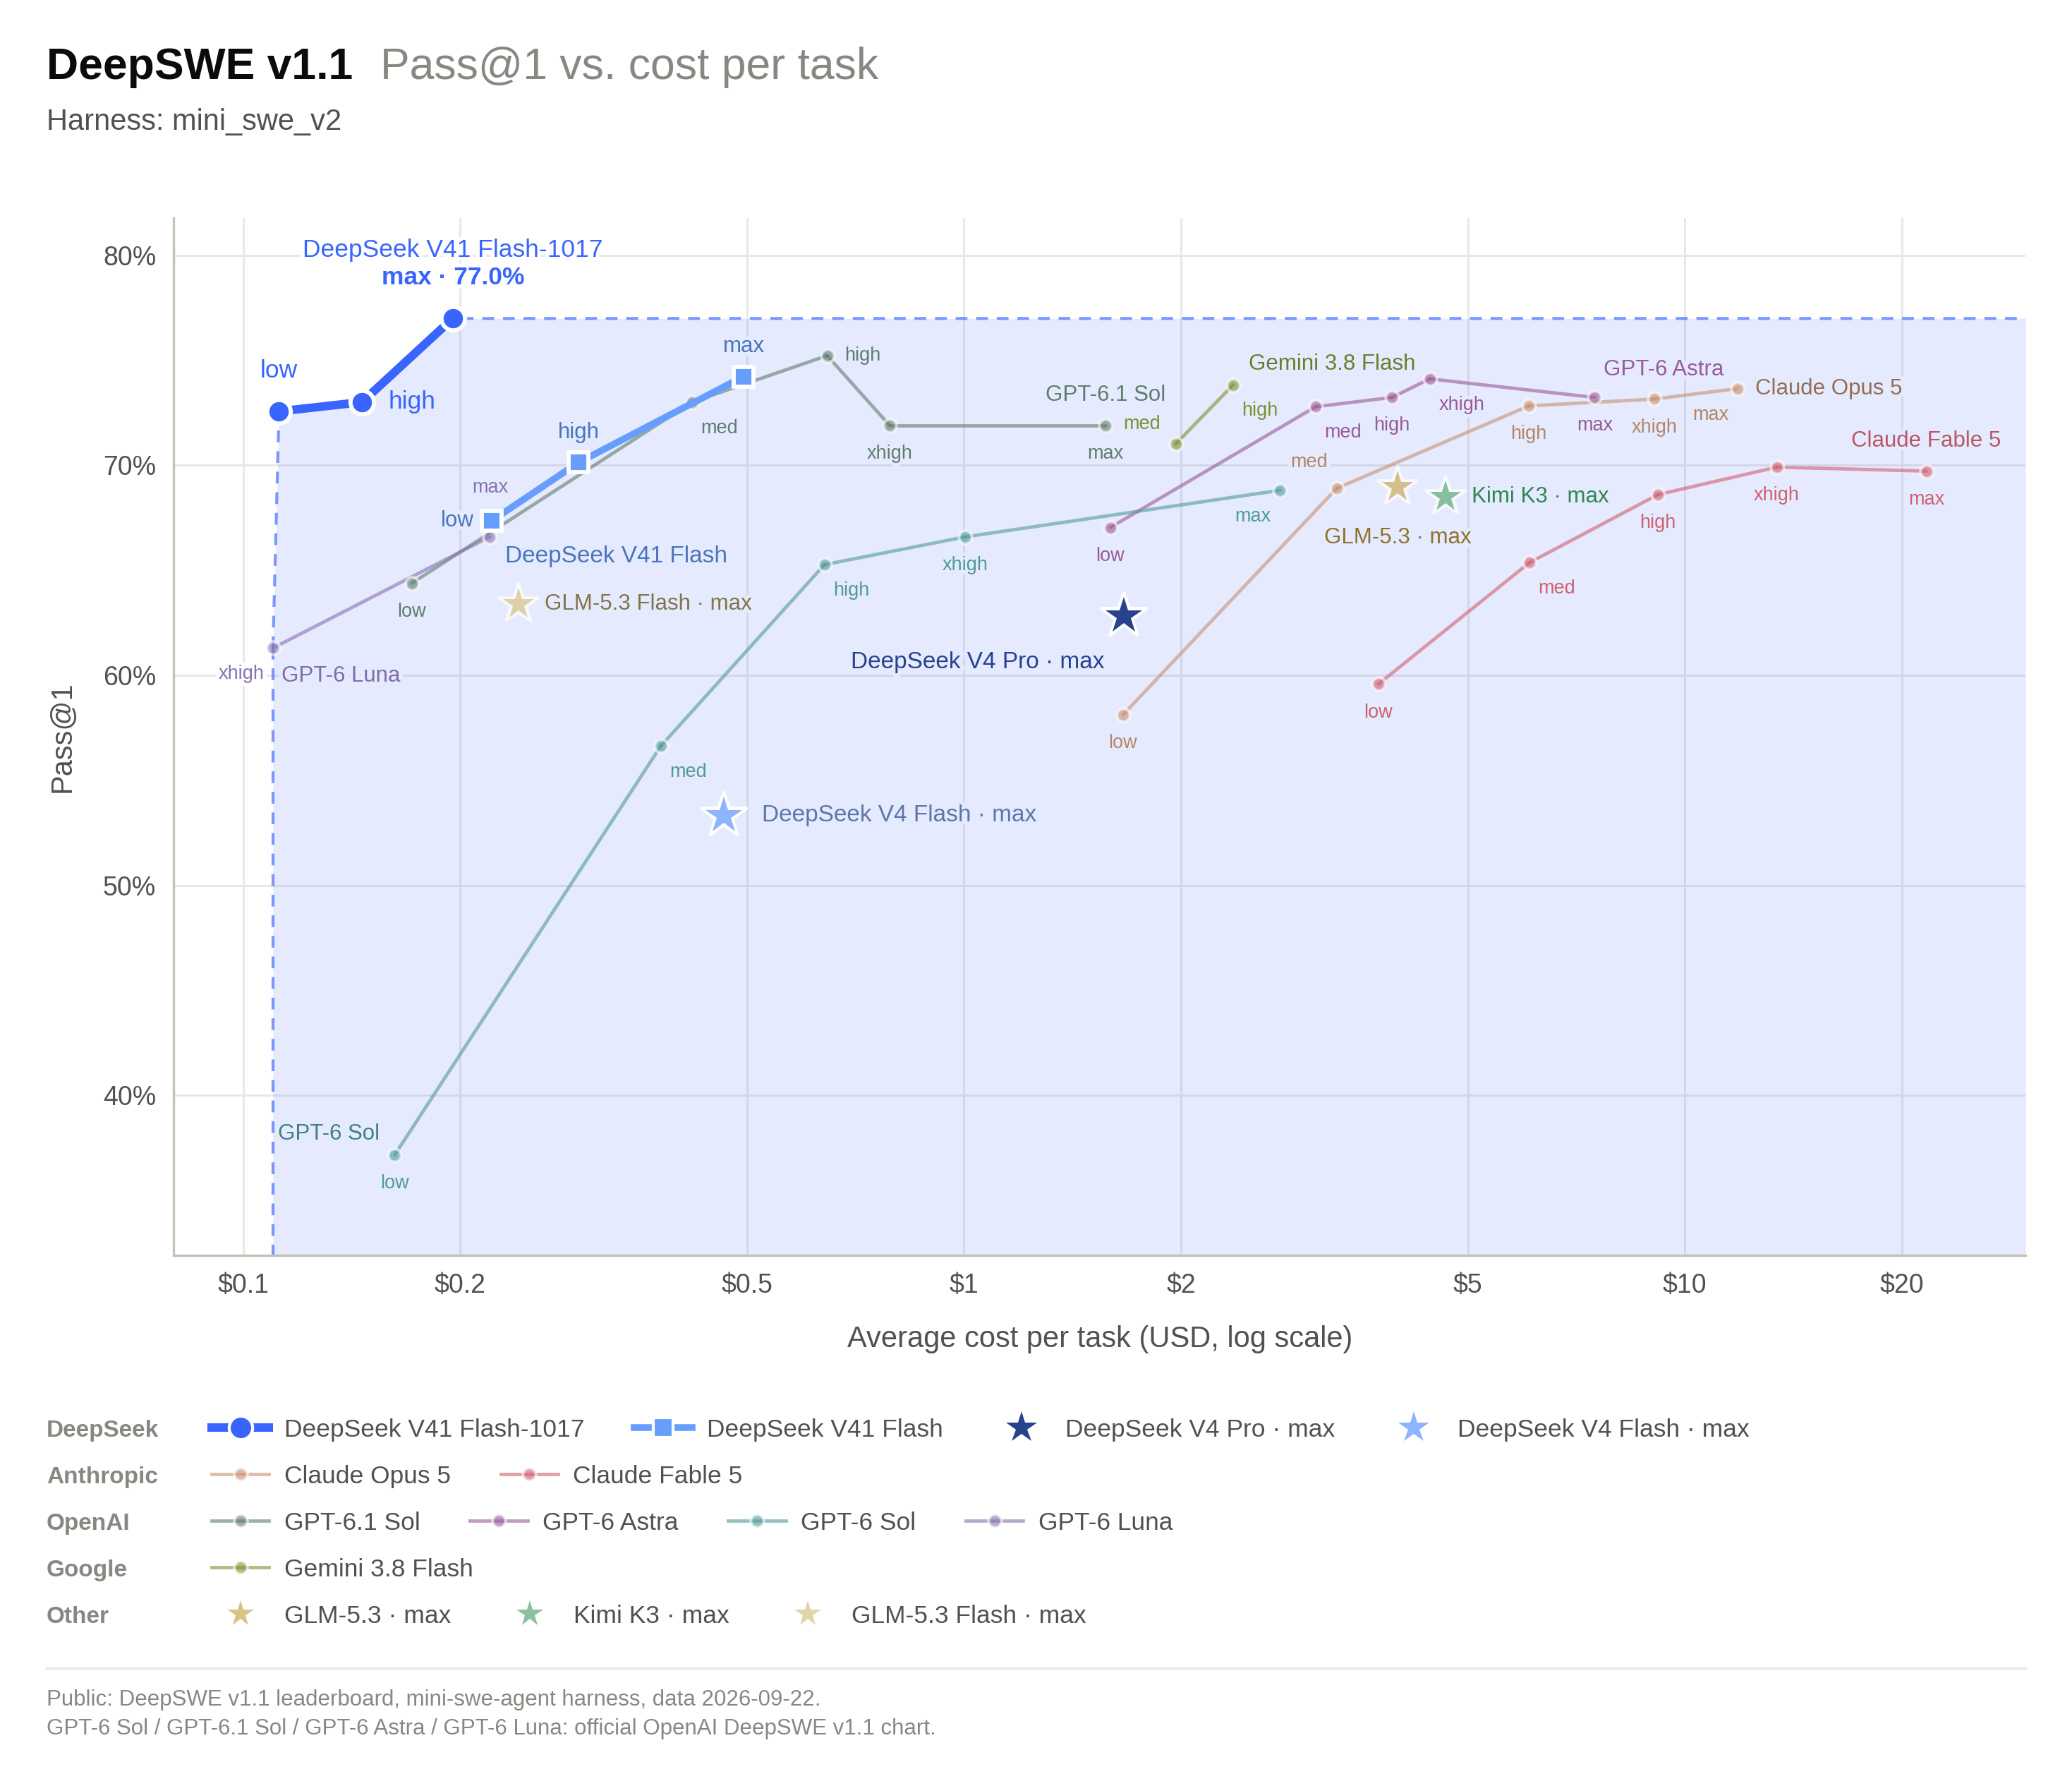
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Chartography with tools | 78.9 | 83.0 | +4.1 |
นี่เป็นผลลัพธ์ที่ผู้ขายรายงาน ไม่ใช่การทำซ้ำแบบอิสระ DeepSeek ใช้ Claude Code สำหรับ Terminal-Bench 4.0 และ Mini-SWE-V2 สำหรับ DeepSWE v1.1 HLE รายงานแบบไม่ใช้เครื่องมือและใช้คะแนนหลักแทนชุดข้อความล้วนที่ทำเครื่องหมายแยก; Chartography ใช้เครื่องมือ ตารางที่อ้างถึงไม่ได้ให้รายละเอียดคอนฟิกต่อแถวครบถ้วนสำหรับเบนช์มาร์กอื่นๆ จึงไม่สามารถสมมติงบเหตุผล ฮาร์ดแวร์ และเงื่อนไขการหยุดที่เทียบเท่าได้ การเปลี่ยนแปลงข้างต้นเป็นความต่างคะแนนแบบสัมบูรณ์ ไม่ใช่การปรับปรุงแบบร้อยละ
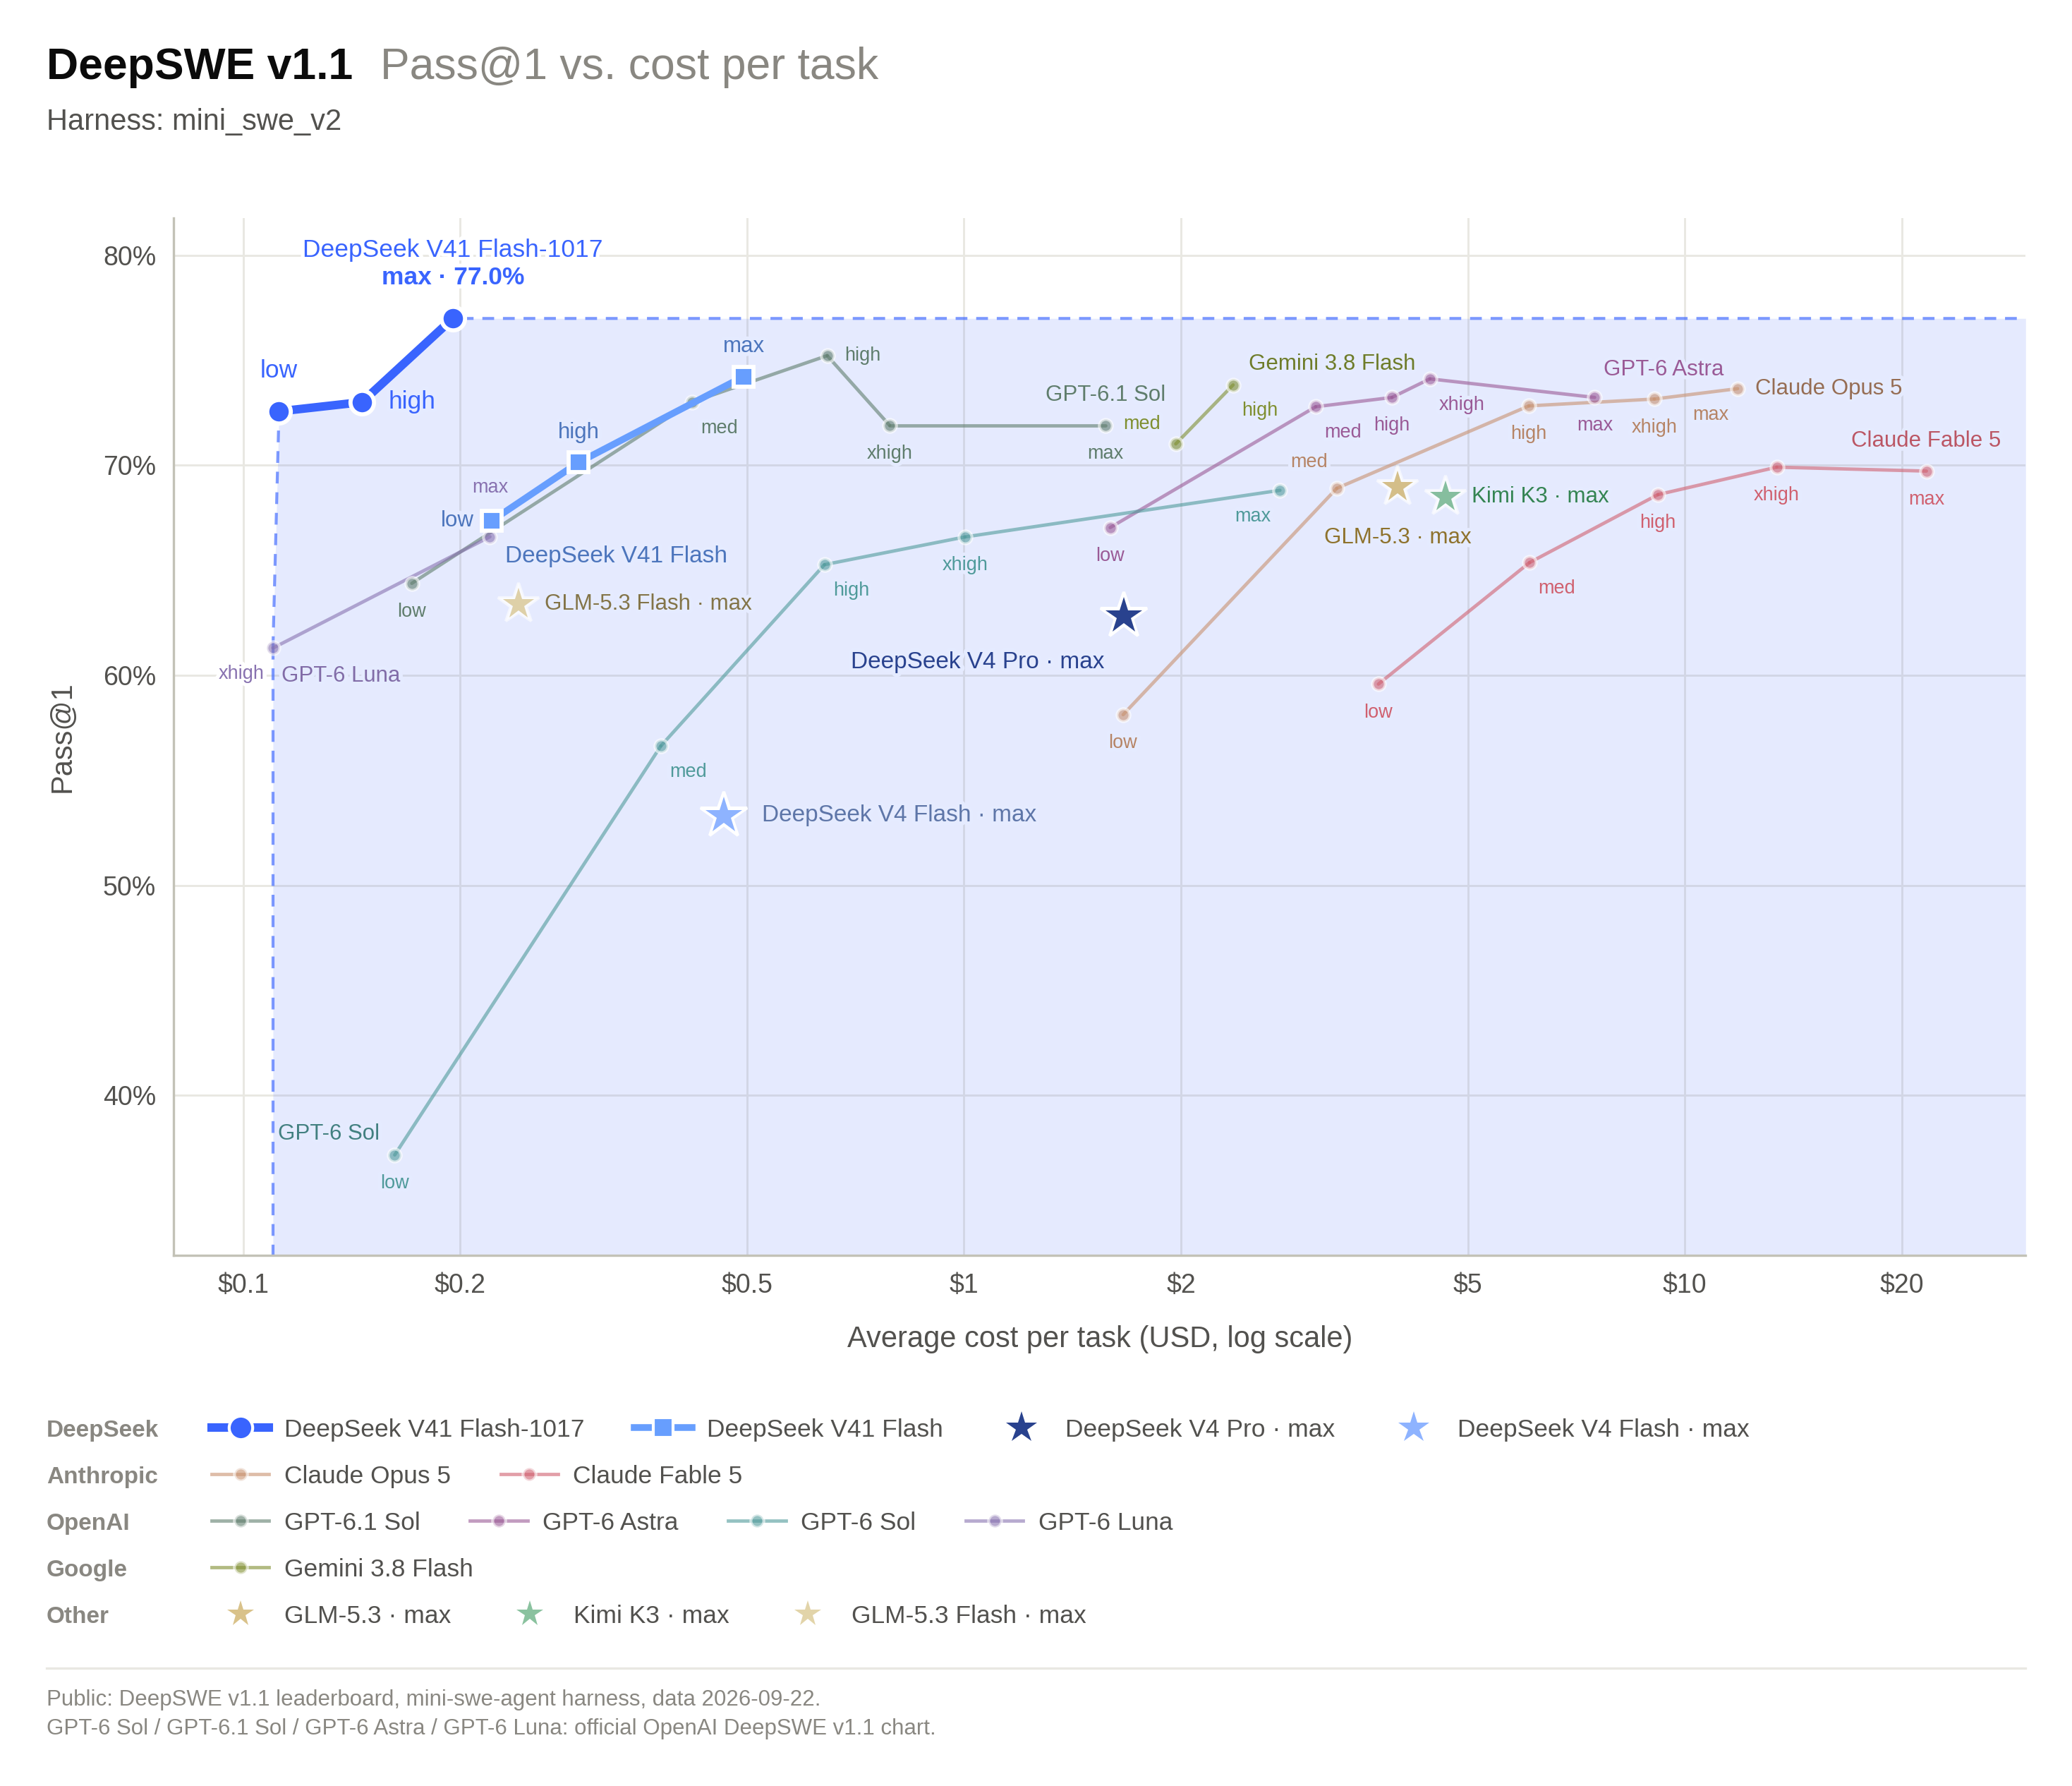
แผนภูมิ ประสิทธิภาพต่อค่าใช้จ่ายของ DeepSWE v1.1 ของ DeepSeek พล็อต Pass@1 กับค่าใช้จ่ายเฉลี่ยต่อภารกิจเป็น USD บนแกนลอการิทึม โดยใช้ฮาร์เนส Mini-SWE-V2 การตั้งค่าการให้เหตุผลที่ต่างกันปรากฏเป็นจุดแยกต่างหาก; ควรเปรียบเทียบอัตราความสำเร็จและคอนฟิกที่เหมาะสมก่อนสรุปเรื่องต้นทุน
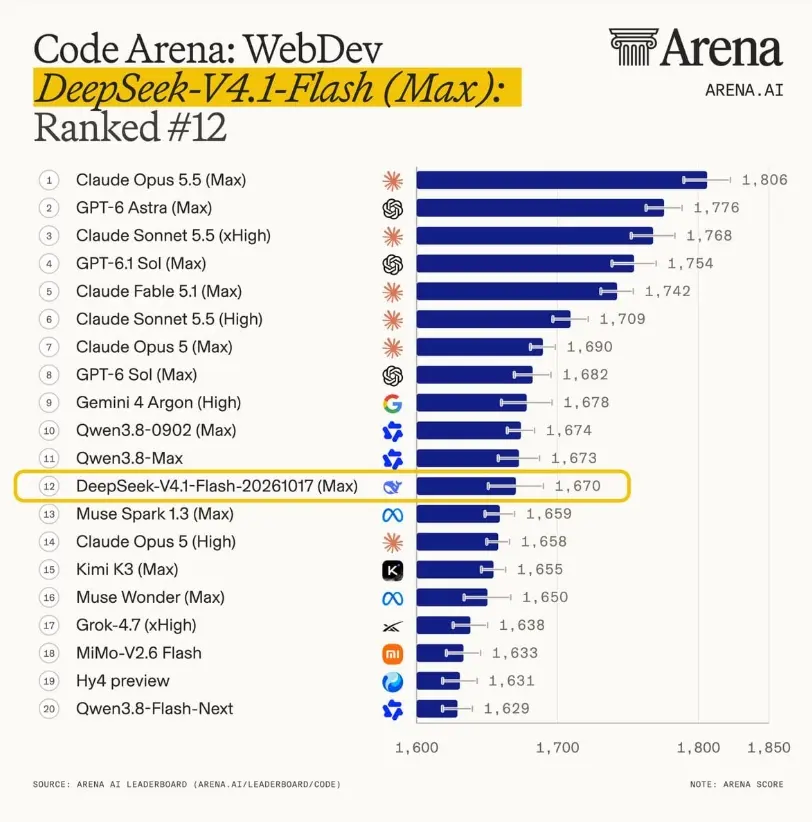
Code Arena: WebDev Leaderboard – โมเดลโอเพนซอร์สอันดับสูงสุด
ในการประเมินเบนช์มาร์กแนวหน้าด้านการเขียนโค้ดเว็บและพัฒนาเว็บล่าสุด DeepSeek-V4.1-Flash-1017 ไม่เพียงแซง Kimi K3 (Max) ที่ได้รับการยกย่องสูง แต่ยังบรรลุการปรับปรุงประสิทธิภาพต้นทุนการอนุมานในระดับลำดับขนาด—ด้วยค่าใช้จ่ายการดำเนินงานประมาณหนึ่งในสิบของคู่แข่ง DeepSeek-V4.1-Flash-20261017 (Max) ครองอันดับหนึ่งบน Code Arena: WebDev leaderboard อย่างเป็นทางการ ได้รับตำแหน่ง “โมเดลโอเพนซอร์สอันดับหนึ่ง”
บนกระดานรวม โมเดลได้อันดับที่ 12 ด้วยคะแนน 1670 ในระดับอันดับสูงนี้ มันทำผลงานเหนือโมเดลปิดชั้นนำ Claude Opus5 (High) และไล่ช่องว่างกับโมเดลระดับท็อป GPT-6Sol (Max) ให้เหลือภายใน 10 คะแนน
อัปเดตเดือนตุลาคมเทียบกับรุ่นเดือนกันยายนอย่างไร?
เมื่อเทียบกับรุ่นเดือนกันยายน อัปเดตวันที่ 17 ตุลาคมแสดงการเพิ่มขึ้นเด่นชัดในเบนช์มาร์กการเขียนโค้ดที่เลือก: Terminal-Bench 4.0 เพิ่มจาก 31.2 เป็น 42.3 (+11.1 คะแนน) ขณะที่ ProgramBench เพิ่มจาก 20.3 เป็น 29.1 (+8.8 คะแนน) DeepSWE v1.1 ดีขึ้นจาก 74.2 เป็น 77.0 (+2.8 คะแนน) ผลลัพธ์ที่ผู้ขายรายงานสนับสนุนให้ประเมินอัปเดตสำหรับเวิร์กโฟลว์บนเทอร์มินัลและงานเขียนโปรแกรมที่กว้างขึ้น; แต่ไม่ได้หมายความว่าผลผลิตเทียบเท่าจะเกิดขึ้นในทุกโค้ดเบส
รุ่นปล่อยนี้ยังให้ความสำคัญมากขึ้นกับการพัฒนาโปรเจ็กต์ครบวงจรผ่านการเรียนรู้เสริมแรงแบบป้อนกลับตนเอง ความเร็วและการประหยัดโทเค็นยังขึ้นกับงาน ดังที่สองตัวอย่างในส่วนถัดไปแสดง สำหรับการอินทิเกรต API เนทีฟที่มีอยู่ ตัวบ่งชี้โมเดลยังคงเป็น deepseek-flash ดังนั้นการตัดสินใจอัปเกรดเชิงปฏิบัติควรตั้งอยู่บนการทำงานสำเร็จที่ยอมรับได้ ต้นทุนรวม และเวลาตั้งแต่ต้นจนจบที่วัดบนงานตัวแทน
DeepSeek V4.1-Flash-1017 ราคาเท่าไร?
ข้อได้เปรียบด้านราคานั้นมหาศาล: โดยทั่วไป Flash ถูกกว่ารุ่นปิดระดับท็อป 10–40× ต่อโทเค็น และเอาต์พุตที่สั้นลงยิ่งขยายการประหยัดบนเอเจนต์หลายขั้น ตอนเทียบกับรุ่นก่อน 1017 ดีขึ้นแบบเข้มงวดบนเมตริกรายงานโดยคงราคาเดิม—เป็นการอัปเกรดบริสุทธิ์
ราคาต่อหนึ่งล้านโทเค็นเป็น USD ตามบทความต้นทาง ณ วันที่ 19 ตุลาคม 2026 CometAPI ใช้ตัวคูณช่วงพีค 2×
| Token category | DeepSeek native: off-peak | DeepSeek native: peak | DeepSeek V4.1 Flash API in CometAPI: base | CometAPI: 2× window |
|---|---|---|---|---|
| Input, cache hit | $0.003 | $0.006 | $0.0024 | $0.0048 |
| Input, cache miss | $0.15 | $0.30 | $0.12 | $0.24 |
| Output | $0.60 | $1.20 | $0.48 | $0.96 |
ทั้งสองผู้ให้บริการแสดงช่วงพีควันธรรมดาเวลา 01:00–04:00 และ 06:00–10:00 UTC DeepSeek ยกเว้นวันหยุดราชการจีน; เงื่อนไขที่แสดงของ CometAPI ไม่ได้ระบุข้อยกเว้นนั้น ชั่วโมงอื่นใช้เรตราคา off-peak/base คอลัมน์ 2× ของ CometAPI คำนวณจากราคาพื้นฐานที่เผยแพร่
สำหรับ API เนทีฟของ DeepSeek การใช้ อินพุตไม่แคช 10 ล้านโทเค็น บวกเอาต์พุต 2 ล้านโทเค็น มีค่าใช้จ่าย:
- นอกช่วงพีค: (10 × $0.15) + (2 × $0.60) = $2.70.
- ช่วงพีค: (10 × $0.30) + (2 × $1.20) = $5.40.
สำหรับงบทดลองใช้งาน ควรเฉลี่ยโทเค็นและค่าเครื่องมือทั้งหมดต่อจำนวนความพยายามโดยภารกิจที่ยอมรับได้ รวมการใช้แคชซ้ำและช่วงพีค; รายงานต้นทุนโครงสร้างพื้นฐานและการรีวิวโดยมนุษย์แยกต่างหาก ตัวอย่างข้างต้นครอบคลุมเฉพาะโทเค็นของโมเดล
ค่าบริการ Search และ Fetch
Search และ Fetch APIs ของ DeepSeek มีค่าใช้จ่าย $0.75 ต่อ 1,000 คำขอที่สำเร็จ การคิดเงินแยกจากการใช้โทเค็นของโมเดล; คำขอล้มเหลว ผลการค้นหาว่างเปล่า และการหมดเวลา ไม่ถูกคิดค่าใช้จ่ายตามกฎที่บันทึกไว้
สำหรับผู้ใช้ API ของ DeepSeek การเรียก Search และ Fetch ฝั่งเซิร์ฟเวอร์ผ่าน DeepSeek Harness, Claude Code และ Codex ชั่วคราวฟรีตามนโยบายเรียกเก็บเงินทางการ การคิดค่าบริการสำหรับการเรียกเหล่านั้นเริ่ม 31 ตุลาคม 2026 เวลา 16:00 UTC ซึ่งเทียบเท่ากับวันที่ 1 พฤศจิกายน เที่ยงคืนที่ปักกิ่ง การยกเว้นจำกัดนี้ไม่ได้ทำให้คำขอ API Search และ Fetch แบบสแตนด์อโลนทั้งหมดฟรี
DeepSeek V4.1-Flash-1017 เร็วและถูกกว่าเสมอหรือไม่?
ไม่ใช่ การทดสอบสองงานของ EmpirioLabs พบว่าเวลาและการใช้โทเค็นเอาต์พุตต่ำลงสำหรับแอนิเมชันตู้ปลา แต่ค่าสูงขึ้นสำหรับแอนิเมชันสกายไลน์:
| EmpirioLabs’ first-hand coding tests | September release | October 17 update | Observed result |
|---|---|---|---|
| Aquarium completion time | 162 seconds | 124 seconds | October update faster |
| Aquarium output tokens | 41,833 | 33,149 | October update used fewer |
| Skyline completion time | 163 seconds | 177 seconds | October update slower |
| Skyline output tokens | 37,928 | 42,907 | October update used more |
ทั้งสองรุ่นสร้างแอนิเมชันที่ทำงานได้ในการทดสอบนี้บนแพลตฟอร์ม API ของ EmpirioLabs วันที่ 18 ตุลาคม 2026 แต่ละงานใช้พรอมต์เดียวกันและขอไฟล์ HTML แบบ self-contained หนึ่งไฟล์ พร้อม CSS และ JavaScript แบบอินไลน์ โดยไม่ใช้ไลบรารีหรือแอสเซ็ตภายนอก ทั้งสองโมเดลรันด้วยการตั้งค่าเริ่มต้น เปิดโหมดคิดที่งบประมาณเริ่มต้น และจำกัดเอาต์พุต 65,536 โทเค็น รันพร้อมกันสำหรับแต่ละงาน หนึ่งครั้งต่อโมเดล เวลาเป็นทั้งคำขอ; จำนวนโทเค็นเอาต์พุตรวมโทเค็นการให้เหตุผล มาจากรายงานการใช้ API ภาพหน้าจอเรนเดอร์ในเบราว์เซอร์แบบไม่มีหัวหลัง 6 วินาที ตัวอย่างสองนี้แสดงความแปรผันของเวิร์กโหลด มากกว่าจะสถาปนาการจัดอันดับทั่วไป
เข้าถึง DeepSeek V4.1-Flash-1017 ได้อย่างไร?
- DeepSeek API อย่างเป็นทางการ — ใช้ชื่อโมเดล
deepseek-flashที่ https://api.deepseek.com. - น้ำหนักแบบเปิด — ดาวน์โหลดจาก Hugging Face หรือ ModelScope เพื่อโฮสต์เอง
- CometAPI — CometAPI เพิ่ม DeepSeek-V4.1-Flash-1017 ดูรายละเอียดโมเดล รหัสโมเดล: deepseek-v4.1-flash-1017
ใช้ DeepSeek API เนทีฟ
API quick start ของ DeepSeek และ CometAPI ยืนยันว่า deepseek-flash ให้บริการเวอร์ชันวันที่ 17 ตุลาคมแล้ว โดยวิธีการเรียกไม่เปลี่ยน
ส่งคำขอวางแผนโปรเจ็กต์ผ่าน API ด้วย Python ติดตั้งแพ็กเกจ OpenAI สำหรับ Python และตั้งค่า API_KEY ในสภาพแวดล้อมก่อนรันตัวอย่าง
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.deepseek.com",# https://api.cometapi.com/v1
)
response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {
            "role": "user",
            "content": (
                "Design a small issue-tracking application. "
                "Give the data model, implementation plan, "
                "and acceptance tests."
            ),
        }
    ],
)
print(response.choices[0].message.content)
สิ่งนี้จะสร้างการตอบกลับจากโมเดล เพื่อสร้างและตรวจสอบโปรเจ็กต์โดยอัตโนมัติ สภาพแวดล้อมเอเจนต์ยังต้องจัดให้มีการเข้าถึงไฟล์ การรันคำสั่ง ฟีดแบ็กการทดสอบ และสิทธิ์ที่เหมาะสม
CometAPI คำแนะนำ: CometAPI มีรายการโมเดล DeepSeek หลากหลายอยู่แล้ว และเป็นวิธีที่ยอดเยี่ยมในการลอง V4.1-Flash-1017 ควบคู่ไปกับ Claude, GPT, Gemini, Grok และโมเดลเฉพาะทางด้านโค้ด/วิชั่นโดยไม่ติดผู้ขาย สมัครและรับ API key จากนั้นชี้ SDK ของ OpenAI ที่คุณมีอยู่ไปยัง base URL ของ CometAPI วิธีนี้ทรงพลังเป็นพิเศษสำหรับเฟรมเวิร์กเอเจนต์ที่ได้ประโยชน์จากการจัดเส้นทางงานย่อยไปยังโมเดลที่คุ้มค่าที่สุดหรือมีสมรรถนะสูงสุดที่มีอยู่
บทสรุป
DeepSeek-V4.1-Flash-1017 เป็นการก้าวกระโดดที่ฉลาดและมีประสิทธิภาพในความสามารถของ AI แบบเปิด ด้วยการปรับปรุงสมรรถนะบนเบนช์มาร์กสำคัญด้านเอเจนต์และการเขียนโค้ด พร้อมลดความยาวเอาต์พุตและเวลาในการทำงาน—ทั้งหมดนี้ที่ราคาต่ำเท่าเดิม—มันเสริมความแข็งแกร่งให้ตำแหน่งของ DeepSeek ในการแข่งขันสมรรถนะต่อดอลลาร์ ไม่ว่าคุณจะสร้างเอเจนต์ซอฟต์แวร์อัตโนมัติ แอปพลิเคชันมัลติโหมด หรือระบบโปรดักชันที่ปรับต้นทุนให้เหมาะสม โมเดลนี้ควรค่าแก่การประเมินอย่างจริงจัง
เมื่อรวมกับชั้นการเข้าถึงที่สะดวกอย่าง CometAPI นักพัฒนาสามารถผสานโมเดลล้ำหน้าอย่าง V4.1-Flash-1017 เข้ากับเวิร์กโฟลว์แบบหลายผู้ให้บริการที่แข็งแรงได้ด้วยแรงเสียดทานต่ำ ขณะที่การประเมินอิสระทยอยออกมาและระบบนิเวศเครื่องมือ (Harness, CodeBuddy ฯลฯ) เติบโต คาดว่าเช็คพอยต์นี้จะกลายเป็นตัวเลือกเริ่มต้นสำหรับงานโหลดสูงที่ต้องการสติปัญญาสูงในช่วงปลายปี 2026 และต่อไปในอนาคต