Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Gemini 4 Carbon vs Gemini 4 Argon: ผลทดสอบ ราคา และควรเลือกตัวไหน
ai-comparisons / งานวิจัย CometAPI
Gemini 4 Carbon vs Gemini 4 Argon: ผลทดสอบ ราคา และควรเลือกตัวไหน เปรียบเทียบ Gemini 4 Carbon กับ Gemini 4 Argon ในด้านผลการทดสอบ (benchmarks), การเขียนโค้ด, ความปลอดภัยทางไซเบอร์, ขนาดหน้าต่างบริบท (context windows), ราคา API, ความเร็ว และความพร้อมให้ใช้งาน.
Deon Goodwin ทีมวิจัยโมเดล AI และ API เปรียบเทียบ Gemini 4 Carbon กับ Gemini 4 Argon ในด้านผลการทดสอบ (benchmarks), การเขียนโค้ด, ความปลอดภัยทางไซเบอร์, ขนาดหน้าต่างบริบท (context windows), ราคา API, ความเร็ว และความพร้อมให้ใช้งาน.
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
Google ประกาศ Gemini 4 Carbon เมื่อวันที่ 28 ตุลาคม 2026 โดยมีผลการเผยแพร่ที่แข็งแกร่งกว่า Gemini 4 Argon ทั้งด้านการเขียนโค้ด การให้เหตุผลบริบทยาว และความมั่นคงปลอดภัยไซเบอร์ สำหรับนักพัฒนา ทางเลือกทันทีขึ้นอยู่กับการเข้าถึง: Argon ใช้งานได้ผ่าน Gemini API แบบชำระเงิน ส่วน Carbon ยังจำกัดการเปิดตัว บทความนี้เปรียบเทียบเบนช์มาร์ก สเปก API ความเร็ว และราคา เพื่อช่วยตัดสินใจว่าอะไรควรดีพลอยตอนนี้ และควรประเมิน Carbon เมื่อใด
Key Takeaways
ประสิทธิภาพ: Carbon ได้คะแนน 59 เทียบกับ 50 ของ Argon บน Artificial Analysis Intelligence Index v5.0 ช่องว่างต่างกันตามเบนช์มาร์ก: SWE-sweep เพิ่มขึ้น 5.3 จุดเปอร์เซ็นต์ ขณะที่ GraphWalks BFS F1 เพิ่มขึ้น 12.0 จุด
สเปก API: Argon มีเอกสารหน้าต่างคอนเท็กซ์แบบรวม 1,048,576 โทเค็นที่ใช้ร่วมกันระหว่างอินพุต การคิด และเอาต์พุต ส่วนข้อจำกัด API สาธารณะและการรองรับเครื่องมือของ Carbon ยังไม่ประกาศ
ราคา: ทั้งสองโมเดลประกาศอัตราเริ่มต้นอินพุต $2 ต่อโทเค็น 1 ล้าน และเอาต์พุต $10 ต่อโทเค็น 1 ล้าน Argon มีโปรโมชันถึงวันที่ 30 พฤศจิกายน 2026; Carbon ยังไม่ประกาศวันสิ้นสุดอัตราเริ่มต้น
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ เผยแพร่เมื่อ Oct 29, 2026 อัปเดตล่าสุด Oct 29, 2026 ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
การตัดสินใจอัปเกรด: เปรียบเทียบอัตราการยอมรับงาน เวลาหน่วงแบบ end-to-end และต้นทุนต่อผลลัพธ์ที่ยอมรับเมื่อประเมิน Carbon คะแนนเบนช์มาร์กที่สูงกว่าเพียงอย่างเดียวไม่ยืนยันว่าการสลับจะปรับปรุงแอปของคุณ
Gemini 4 Carbon vs Gemini 4 Argon: ภาพรวมและสเปก เริ่มจากการตัดสินใจดีพลอย: Argon มี API ที่มีเอกสารพร้อมใช้งานทันที ส่วน Carbon เผยผลลัพธ์ที่แข็งแกร่งกว่าแต่จำกัดการเข้าถึงช่วงแรก
Gemini 4 Carbon มุ่งเน้นเวิร์กโฟลววิศวกรรมที่หนักและการป้องกันความมั่นคงปลอดภัยไซเบอร์ โดยการเข้าถึงเบื้องต้นจำกัดแก่พาร์ทเนอร์ที่คัดเลือก Gemini 4 Argon พร้อมใช้งานผ่าน Gemini API แบบชำระเงินสำหรับงานให้เหตุผล การเขียนโค้ด การแก้ปัญหาทางวิทยาศาสตร์ และเวิร์กโฟลวเอเจนต์ ตารางด้านล่างเปรียบเทียบสเปก API และความสามารถที่ประกาศ
บริบท การให้เหตุผล และสเปก API Argon มีสเปกสำหรับนักพัฒนาที่เผยแพร่แล้ว Carbon เผยผลการประเมิน แต่ผลเหล่านั้นไม่ยืนยันขีดจำกัดหรือการรองรับเครื่องมือของ API สาธารณะในอนาคต การใช้แบรนด์ครอบครัวเดียวกันหรือคะแนนสูงกว่าไม่ได้ยืนยันว่าโมเดลใช้สถาปัตยกรรมเหมือนกัน
การวางตำแหน่งโมเดล การให้เหตุผลระดับแนวหน้า, ความมั่นคงปลอดภัยไซเบอร์, เอเจนต์ระยะยาว การให้เหตุผลระดับแนวหน้า, การเขียนโค้ด, วิทยาศาสตร์, เอเจนต์ รหัสโมเดลใน API สาธารณะ ยังไม่ประกาศ gemini-4-argon หน้าต่างคอนเท็กซ์ 1M โทเค็นที่รายงานโดย Artificial Analysis; ขีดจำกัด API อย่างเป็นทางการยังไม่มีเอกสาร 1,048,576 โทเค็น ใช้ร่วมกันระหว่างอินพุต การคิด และเอาต์พุต เอาต์พุตสูงสุด ยังไม่มีเอกสารอย่างเป็นทางการ ขีดจำกัดซิงก์เริ่มต้น 65,536; long decode ได้สูงสุดเท่าหน้าต่างแบบรวมที่เหลือ อินพุตมัลติโหมด แสดงความสามารถมัลติโหมดแล้ว; สเปก API ฉบับสมบูรณ์รอประกาศ ข้อความ รูปภาพ เสียง วิดีโอ PDF เอาต์พุตมัลติโหมด สเปก API สาธารณะรอประกาศ ข้อความ ระดับการให้เหตุผล ยังไม่มีเอกสารอย่างเป็นทางการ ต่ำ ปานกลาง สูง Function calling และรันโค้ด ยังไม่ยืนยันการรองรับใน API สาธารณะ รองรับ การใช้คอมพิวเตอร์ ยังไม่ยืนยันการรองรับใน API สาธารณะ รุ่นพรีวิว การแคชคอนเท็กซ์ ประกาศส่วนลดราคา; รายละเอียดการทำงานรอประกาศ แคชโดยนัย การเข้าถึงของนักพัฒนาสาธารณะ ยังไม่เปิดกว้าง พร้อมให้ใช้งาน
หน้าต่าง 1,048,576 โทเค็นของ Argon ใช้ร่วมกันระหว่างอินพุต การคิด และเอาต์พุตที่สร้าง ดังนั้นอินพุตที่ใหญ่ขึ้นจะเหลือพื้นที่สำหรับการสร้างน้อยลง งบประมาณการสร้างเริ่มต้นคือ 65,536 โทเค็น รวมทั้งการคิดและเอาต์พุต รุ่นที่ยาวขึ้นใช้ long decode ซึ่งประมวลผลคอนเท็กซ์เดิมซ้ำผ่านสเต็ปต่อเนื่องและเพิ่มค่าบริการโทเค็นอินพุต; คอนเท็กซ์ที่ซ้ำอาจเข้าเกณฑ์ส่วนลดแคชโดยนัย
กับ Interactions API การสร้างที่ยาวขึ้นต้องใช้โหมด background และตั้งค่า max_output_tokens ที่สูงขึ้น กับ GenerateContent ไคลเอนต์ต้องจัดการคำขอต่อเนื่องเอง
Gemini 4 Carbon vs Gemini 4 Argon: ประสิทธิภาพ Carbon นำหน้า Argon ตามรายงานการเปรียบเทียบ แต่ขนาดและความหมายของช่องว่างต่างกันไปตามงาน
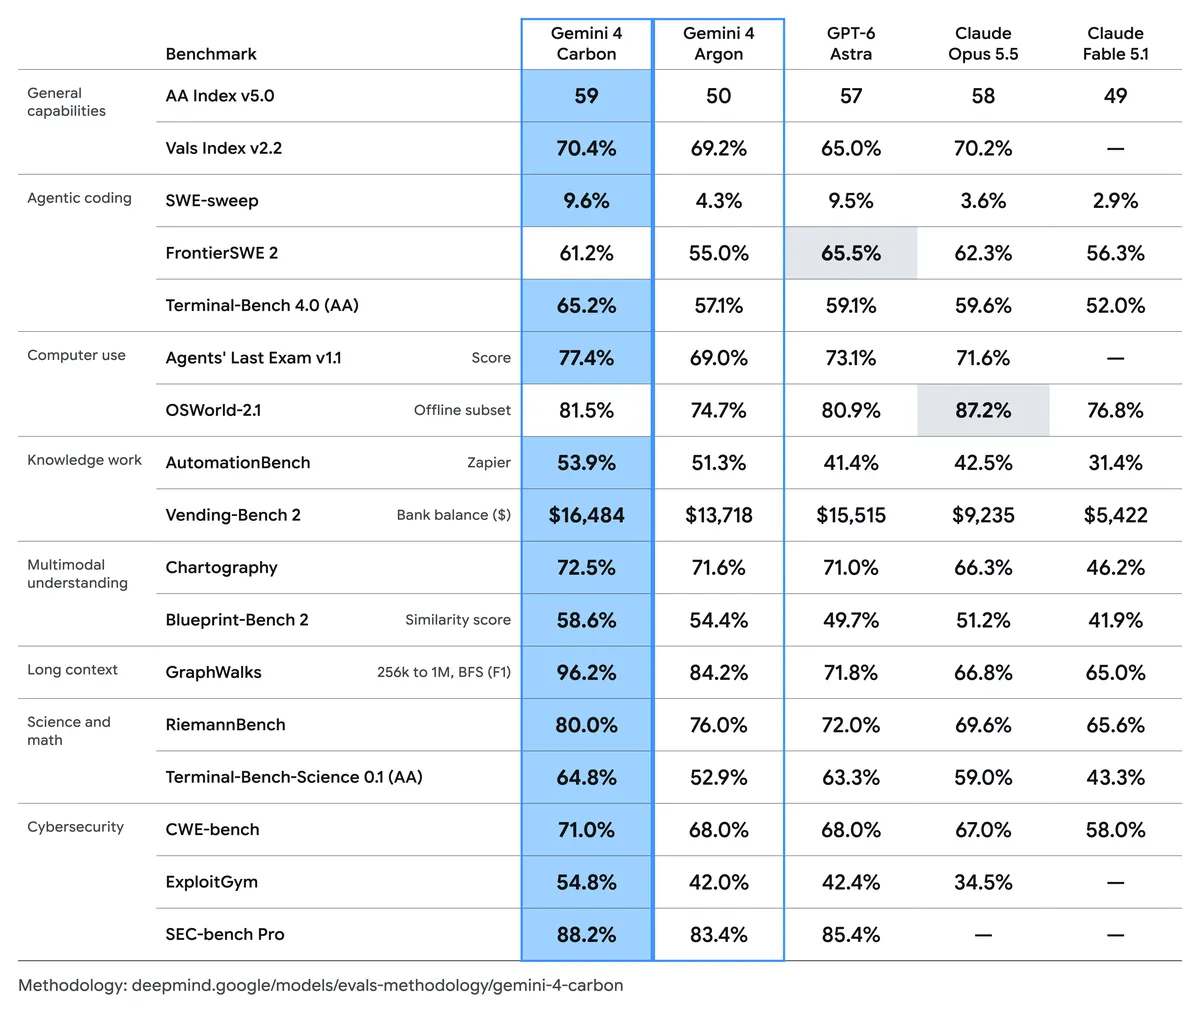
ผลเบนช์มาร์กทางการและเงื่อนไขการทดสอบ การเปรียบเทียบที่เผยแพร่ของ Google แสดง Carbon นำหน้าทุก 17 แถวด้านล่าง โดยผสมการประเมินที่ Google รันเองกับคะแนนจากผู้ประเมินภายนอกและลีดเดอร์บอร์ดของเบนช์มาร์ก; ไม่ได้อ้างว่า Google รันการทดสอบทั้งหมดโดยอิสระ
ระเบียบวิธีการประเมิน โดยทั่วไปใช้การตั้งค่าการคิดระดับสูงสุดและ pass@1 เว้นแต่เบนช์มาร์กกำหนดต่างออกไป โครงร่างเอเจนต์ ชุดงานย่อย และนิยามคะแนนแตกต่างกัน ดังนั้นเปอร์เซ็นต์ระหว่างเบนช์มาร์กต่างประเภทจึงไม่เทียบกันได้โดยตรง
Artificial Analysis Intelligence Index v5.0 59 50 +9 points Vals Index v2.2 70.4% 69.2% +1.2 pp SWE-sweep 9.6% 4.3% +5.3 pp FrontierSWE 2 61.2% 55.0% +6.2 pp Terminal-Bench 4.0 (AA) 65.2% 57.1% +8.1 pp Agents' Last Exam v1.1 77.4% 69.0% +8.4 pp OSWorld-2.1 (offline subset) 81.5% 74.7% +6.8 pp AutomationBench (Zapier) 53.9% 51.3% +2.6 pp Vending-Bench 2 (bank balance) $16,484 $13,718 +$2,766 Chartography 72.5% 71.6% +0.9 pp Blueprint-Bench 2 58.6% 54.4%
pp = จุดเปอร์เซ็นต์ Vending-Bench 2 รายงานยอดเงินจำลองในบัญชี ไม่ใช่ความแม่นยำ
GraphWalks: ชุด 256K–1M มี 200 ปัญหาและรายงาน BFS F1 ไม่ใช่อัตราความแม่นยำทั่วไป
Agents' Last Exam: Google ใช้ชุดงาน v1.1 จำนวน 122 งาน, ฮาร์เนส ALE-Claw, หน้าต่างเวลา 5 ชั่วโมง และเปิดฟิลเตอร์ด้านความปลอดภัย
OSWorld: ตัวเลขที่รายงานใช้ชุดออฟไลน์ 82 งาน, สกรีนช็อต 1080p, ขีดจำกัด 500 ขั้นตอน และใช้ค่าสูงสุดจากการรันเดี่ยว 3 ครั้ง ไม่ได้แทนที่เบนช์มาร์กออนไลน์เต็มรูปแบบ
ประสิทธิภาพการเขียนโค้ดและงานระดับคลังซอร์ส บน Terminal-Bench 4.0 Carbon ได้ 65.2% เทียบกับ 57.1% ของ Argon นำอยู่ 8.1 จุดเปอร์เซ็นต์ เบนช์มาร์กนี้ทดสอบการทำงานบรรทัดคำสั่งและการแก้ปัญหาทางเทคนิคหลายขั้นตอน
บน SWE-sweep Carbon ได้ 9.6% เทียบกับ 4.3% ของ Argon นำอยู่ 5.3 จุดเปอร์เซ็นต์และมากกว่าสองเท่า
แม้การปรับปรุงสัมพัทธ์จะสะดุดตา แต่ผลสัมบูรณ์ยังต่ำกว่า 10% Carbon แข็งแกร่งกว่า แต่ไม่ได้เชื่อถือได้สากลในทุกงานวิศวกรรมซอฟต์แวร์ที่ยาก
ตัวเลือกที่เหมาะสมในการประเมิน ได้แก่ การดีบักทั้งคลังซอร์ส การย้ายโค้ด และงานที่ต้องใช้เครื่องมือซ้ำพร้อมการตรวจสอบ สำหรับโค้ดฐานในโปรดักชัน การผ่านชุดทดสอบของคุณเองมีประโยชน์มากกว่าการคาดคะเนอัตราสำเร็จจากเบนช์มาร์กอื่น
มัลติโหมดและประสิทธิภาพบริบทยาว บน GraphWalks 256K–1M BFS F1 Carbon ได้ 96.2% เทียบกับ 84.2% ของ Argon นำอยู่ 12 จุดเปอร์เซ็นต์ สิ่งนี้ทำให้การสังเคราะห์เอกสารยาวและการวิเคราะห์คลังซอร์สเป็นผู้สมัครที่ควรประเมิน คุณภาพการเรียกคืน โครงสร้างเอกสาร และขีดจำกัดจริงของแต่ละเอนด์พอยต์ยังส่งผลต่อผลลัพธ์
บน Chartography Carbon ได้ 72.5% เทียบกับ 71.6% ของ Argon นำอยู่ 0.9 จุดเปอร์เซ็นต์ บน Blueprint-Bench 2 Carbon ได้ 58.6% เทียบกับ 54.4% ของ Argon นำอยู่ 4.2 จุดเปอร์เซ็นต์ ผลความเข้าใจภาพเหล่านี้สนับสนุนการทดสอบเวิร์กโฟลวเอกสารและชาร์ต ขณะที่รูปแบบอินพุตที่รองรับของ API สาธารณะของ Carbon ในอนาคตยังต้องยืนยัน
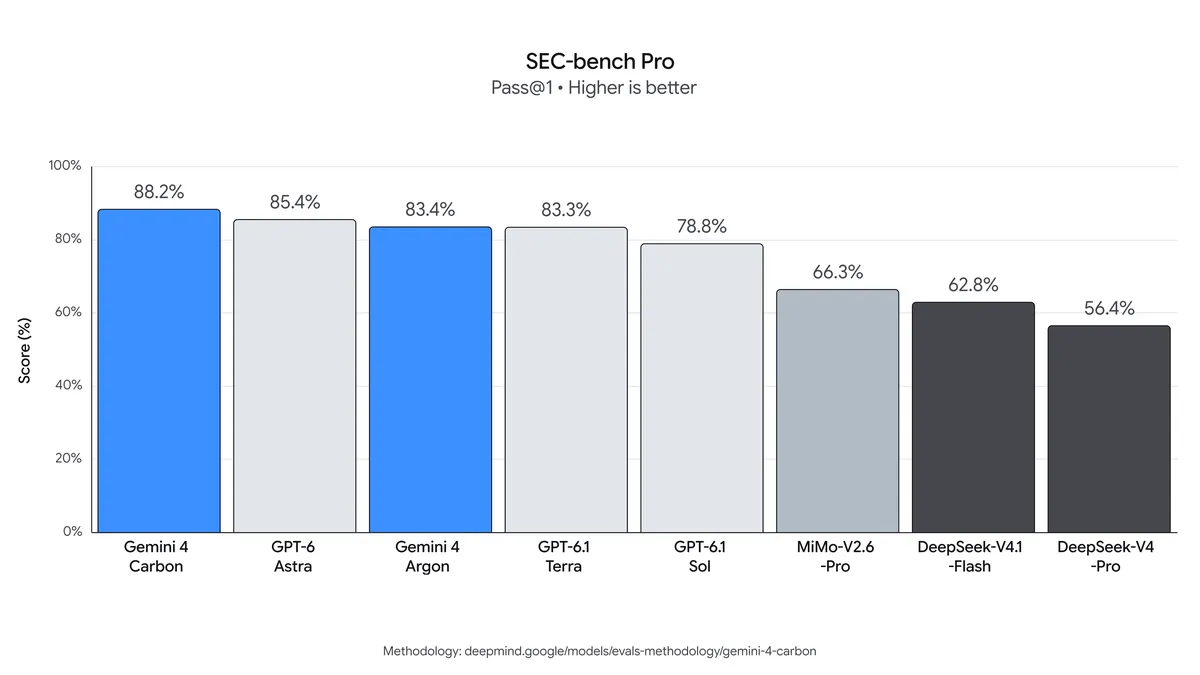
ความมั่นคงปลอดภัยไซเบอร์และความน่าเชื่อถือของเอเจนต์ ผลด้านความปลอดภัยครอบคลุมการค้นหา การยืนยันช่องโหว่ และการแก้ไข: Carbon ได้ 88.2% บน SEC-bench Pro, 54.8% บน ExploitGym และ 71.0% บน CWE-bench ความได้เปรียบที่ใหญ่ที่สุดเหนือ Argon อยู่บน ExploitGym ที่ 12.8 จุดเปอร์เซ็นต์
เงื่อนไขการประเมินด้านความปลอดภัย สำคัญ: SEC-bench Pro ใช้ชุดงานเครื่องยนต์ JavaScript เดือนพฤษภาคม 2026 จำนวน 183 งาน ขณะที่ ExploitGym ใช้การตั้งค่าเอเจนต์แบบออฟไลน์ การพยายามเดียว และปิดมาตรการบรรเทา Google รายงานการประเมินภายนอกโดยไม่มีหลักปฏิบัติในการดีพลอย; คะแนนเหล่านี้ไม่ยืนยันพฤติกรรม API แบบไร้ข้อจำกัด
สำหรับเอเจนต์ที่รันนาน โมเดลที่มีประโยชน์ต้องรายงานความล้มเหลวอย่างซื่อสัตย์และอยู่ภายในงานที่ได้รับอนุญาต Google รายงานอัตราโกงสำเร็จที่สังเกตได้ 0.0% บน Terminal-Bench 4.0 ขณะที่ความพยายามโกงอยู่ที่ 0.4% การประเมินภายในยังพบการอ้างที่ไม่รองรับน้อยลงและอัตราการล้ำขอบเขตกับให้บริการต่ำกว่าที่อนุญาตน้อยลงกว่า Argon สิ่งเหล่านี้เป็นข้อสังเกตเฉพาะการประเมิน ไม่ใช่การรับประกันสำหรับทุกแอปพลิเคชัน
ในทางปฏิบัติ ควรรักษาการตรวจสิทธิ์ การรันในสภาพแวดล้อมแยก การตรวจแพตช์ และการยืนยันอิสระเมื่อประเมินโมเดลใด ๆ บนงานป้องกันความปลอดภัย
ความเร็วและความหน่วง อัตราการปล่อยเอาต์พุต ประมาณ 102 โทเค็น/วินาที ประมาณ 82 โทเค็น/วินาที เวลาก่อนโทเค็นแรก ประมาณ 100 วินาที ประมาณ 47 วินาที โทเค็นเอาต์พุตต่อหนึ่งงานที่ประเมิน ประมาณ 123K ประมาณ 116K โทเค็นการให้เหตุผลต่อหนึ่งงานที่ประเมิน ประมาณ 72K ประมาณ 68K
การวัดจากบุคคลที่สามเหล่านี้อธิบายการตั้งค่าการทดสอบของผู้ประเมินและไม่ใช่การรับประกันความหน่วงหรืออัตราการปล่อยสำหรับดีพลอย API ของคุณ การเปรียบเทียบอาจเปลี่ยนไปเมื่อผู้ประเมินอัปเดตผลและ Google ขยายการเข้าถึง Carbon
อัตราการสร้างโทเค็นที่สูงขึ้นและความหน่วงก่อนโทเค็นแรกที่ยาวกว่าของ Carbon อธิบายส่วนต่าง ๆ ของคำขอ สำหรับอินเทอร์เฟซแชต การรอคอยก่อนเริ่มเอาต์พุตอาจครองประสบการณ์; สำหรับงานอัตโนมัติ ควรประเมินเวลาสำเร็จ end-to-end ร่วมกับอัตราสำเร็จ เพียงดู throughput ไม่สามารถกำหนดได้ว่าโมเดลใดจะเสร็จงานที่มีประโยชน์เร็วกว่า
Gemini 4 Carbon vs Gemini 4 Argon: ค่าใช้จ่าย เปรียบเทียบอัตราโทเค็นอย่างเป็นทางการและการเรียกเก็บเงินของผู้ให้บริการแยกกัน จากนั้นคำนวณต้นทุนต่อผลลัพธ์ที่ยอมรับ ราคาที่ประกาศเหมือนกันยังอาจสร้างบิลที่ต่างกันเมื่อการให้เหตุผล ความพยายามที่ล้มเหลว และการใช้เครื่องมือแตกต่าง
ราคา API ตามผู้ให้บริการ ทั้งสองโมเดลมีอัตราโทเค็นเริ่มต้นของ Google ที่เหมือนกัน CometAPI แสดงอัตรา Argon แยกต่างหาก; ไม่มีราคาที่ยืนยันของ Carbon ในการเปรียบเทียบนี้ ราคาผู้ให้บริการทั้งหมดด้านล่างสะท้อนสแนปช็อตวันที่ 29 ตุลาคม 2026 ของบทความ
Google อินพุตแบบเริ่มต้น / โทเค็น 1M $2.00 $2.00 Google เอาต์พุตแบบเริ่มต้น รวมการคิด / โทเค็น 1M $10.00 $10.00 Google อินพุตแบบแคชเริ่มต้น / โทเค็น 1M $0.10 $0.10 Google อินพุตภายหลัง / โทเค็น 1M $4.00 $4.00 Google เอาต์พุตภายหลัง รวมการคิด / โทเค็น 1M $20.00 $20.00 Google อินพุตแบบแคชภายหลัง / โทเค็น 1M $0.20 $0.20 Google ระยะเวลาอัตราเริ่มต้น ยังไม่ประกาศวันสิ้นสุด ถึงวันที่ 30 พฤศจิกายน 2026 Google การเข้าถึงโปรดักชันสาธารณะ Restricted rollout Available CometAPI อินพุตปกติ / โทเค็น 1M Not confirmed $1.60 CometAPI เอาต์พุตปกติ / โทเค็น 1M Not confirmed $8.00
อัตราเริ่มต้นของ Argon บน Google สิ้นสุดวันที่ 30 พฤศจิกายน 2026 โดยอัตราภายหลังเริ่มวันที่ 1 ธันวาคม Carbon ยังไม่มีวันสิ้นสุดอัตราเริ่มต้นที่ประกาศ ตัวเลขอินพุตแบบแคชของ Carbon คำนวณจากส่วนลด 95% ที่ประกาศ; รายละเอียดการทำงานและคุณสมบัติเข้าเกณฑ์ยังรอประกาศ
ก่อนประมาณบิล ควรยืนยันอัตรา กฎการแคช ค่าบริการบริบทยาว และการรองรับเครื่องมือสำหรับผู้ให้บริการและบัญชีที่เลือก อัตราที่ประกาศของ Carbon โดย Google ไม่ได้ยืนยันราคาของ Carbon บน CometAPI
ตัวอย่างต้นทุน: 1,000 คำขอ สำหรับคำขอที่มีอินพุต 100,000 โทเค็น และเอาต์พุตที่เรียกเก็บเงินรวมการคิด 25,000 โทเค็น ภายใต้อัตราเริ่มต้นมาตรฐาน:
อินพุต: 100,000 × $2 / 1,000,000 = $0.20.
เอาต์พุต รวมการคิด: 25,000 × $10 / 1,000,000 = $0.25.
รวม: $0.45 ต่อคำขอ หรือ $450 สำหรับ 1,000 คำขอที่เหมือนกัน
ที่อัตราภายหลัง งานเดียวกันมีต้นทุน $0.90 หาก 25,000 อธิบายเฉพาะคำตอบสุดท้ายที่มองเห็น ให้บวกโทเค็นการคิดที่นับแยกก่อนประมาณบิล ตัวอย่างนี้ไม่รวม grounding เครื่องมือภายนอก และค่าบริการอื่น ๆ
ที่อัตรา Argon บน CometAPI ที่แสดง คำขออินพุต 100,000 และเอาต์พุตที่เรียกเก็บเงิน 25,000 โทเค็นมีต้นทุน $0.16 + $0.20 = $0.36 หรือ $360 สำหรับ 1,000 คำขอที่เหมือนกัน การประมาณนี้ไม่รวมผลแคช การลองใหม่ และค่าบริการแยกต่างหาก; และไม่ประมาณการดีพลอย Carbon ผ่าน CometAPI
ต้นทุนต่อภารกิจที่ยอมรับ = ยอดใช้จ่ายโมเดลและเครื่องมือทั้งหมด ÷ จำนวนภารกิจที่เสร็จสิ้นและยอมรับ กำหนดเกณฑ์การยอมรับก่อนทดสอบ รวมความพยายามที่ล้มเหลวและการลองใหม่ในยอดใช้จ่าย และบันทึกเวลาตรวจทานของมนุษย์แยกต่างหาก
เข้าถึง Gemini 4 Carbon และ Gemini 4 Argon ได้ที่ไหน
การเข้าถึงจากผู้ให้บริการทางการ ณ วันที่ 29 ตุลาคม 2026 Argon ใช้งานได้ผ่าน Gemini API และ Google AI Studio ส่วน Carbon เบื้องต้นจำกัดแก่ผู้ป้องกันความมั่นคงปลอดภัยไซเบอร์ที่ได้รับการคัดเลือกและพาร์ทเนอร์ที่ไว้ใจได้; ยังไม่มีการยืนยันเอนด์พอยต์สำหรับนักพัฒนาทั่วไปและวันเปิดให้ใช้งานที่กว้างขึ้น เริ่มจากเส้นทางที่เปิดให้บัญชีของคุณ และตรวจสอบรหัสโมเดลและฟีเจอร์ที่รองรับ
เริ่มต้นโดยสร้างคีย์ API ของ CometAPI เลือกโมเดล gemini-4-argon และตั้งค่าแอปให้ใช้เอนด์พอยต์แชตตามเอกสารของผู้ให้บริการ เริ่มด้วยคำขอข้อความที่เป็นตัวแทน ตรวจทานการตอบกลับ และตรวจสอบการใช้งานและค่าใช้จ่ายก่อนขยายงาน
CometAPI ใช้อัตราเรียกเก็บเงินของตนเอง ยืนยันการรองรับเครื่องมือ การควบคุมการคิด และคำตอบยาวบนเส้นทางที่คุณวางแผนใช้ ส่วนติดต่อแชตที่เข้ากันได้ไม่ได้ยืนยันการรองรับฟีเจอร์ Gemini ดั้งเดิมทั้งหมด
ความพร้อมใช้งานของ Carbon บน CometAPI และรหัสโมเดลโปรดักชันยังไม่ยืนยัน ณ วันที่ 29 ตุลาคม 2026 รักษาเวิร์กโฟลว Argon ให้ทำงาน และสลับเฉพาะหลังผู้ให้บริการเอกสารการเข้าถึง Carbon และอินทิเกรตของคุณผ่านการตรวจที่เกี่ยวข้องแล้ว
ควรเลือก Gemini 4 Carbon หรือ Argon? แอปพลิเคชันที่ต้องส่งตอนนี้ Argon อัตราการยอมรับงาน พฤติกรรมเอนด์พอยต์ และต้นทุนปฏิบัติการ การดีบักซับซ้อนหรือย้ายโค้ด ประเมิน Carbon เมื่อเข้าถึงได้ การทดสอบคลังซอร์ส คุณภาพการรีวิว และการลองใหม่ งานวิจัยช่องโหว่ที่ได้รับอนุญาต ประเมิน Carbon ภายในโปรแกรมที่อนุญาต การควบคุมด้านความปลอดภัย ความถูกต้องของการค้นพบ และความถูกต้องของแพตช์ การวิเคราะห์เอกสารหรือโค้ดฐานขนาดใหญ่ Argon เป็นฐาน; Carbon เป็นผู้สมัคร ความถูกต้องของหลักฐานและการตกหล่นจากอินพุตแหล่งเดียวกัน อินเทอร์เฟซผู้ใช้แบบโต้ตอบ เบนช์มาร์กเอนด์พอยต์ Argon ที่ใช้งานได้ก่อน เวลาก่อนโทเค็นแรกและเวลารวมภายใต้ทราฟฟิกจริง
เลือกจุดเริ่มต้นและผู้สมัครอัปเกรด เลือก Argon เมื่อคุณต้องดีพลอยตอนนี้ API ที่เข้าถึงได้และคอนเท็กซ์ มัลติโหมด และเครื่องมือที่มีเอกสารช่วยให้คุณทดสอบแอปทั้งระบบ รวมถึงความหน่วงและต้นทุน
ประเมิน Carbon เมื่อเข้าถึงได้และงานมีเหตุผลเพียงพอ ให้ความสำคัญกับการเปลี่ยนแปลงคลังซอร์สที่ยาก การสังเคราะห์บริบทยาว หรือภารกิจป้องกันความปลอดภัยไซเบอร์ที่ได้รับอนุญาต อัปเกรดเมื่อมันให้แพตช์หรือการค้นพบที่ยอมรับได้มากขึ้น ลองใหม่น้อยลง หรือใช้แรงตรวจทานน้อยลง ภายในข้อจำกัดความหน่วงและงบประมาณของคุณ
ฐาน Argon และเส้นทางอัปเกรดสู่ Carbon รักษาเวิร์กโฟลว Argon ให้ทำงาน พร้อมสร้างชุดงานตัวแทนที่ตายตัว เมื่อ Carbon เข้าถึงได้ผ่านเส้นทางที่รองรับ ให้รันงานเดียวกันด้วยสิทธิ์เครื่องมือที่เทียบเคียงและเกณฑ์การยอมรับที่เหมือนกัน อย่าสร้างการสลับอัตโนมัติไปยังเอนด์พอยต์ที่จำกัดหรือไม่มีเอกสาร; ตัดสินใจการรูตหลังยืนยันความเข้ากันได้และผลเวิร์กโหลดแล้วเท่านั้น
การประเมินในโปรดักชัน รักษาชุดประเมินให้ตายตัวเมื่อเปรียบเทียบโมเดล บันทึกเวอร์ชันโมเดล การตั้งค่าการให้เหตุผล พรอมต์ สิทธิ์เครื่องมือ การใช้โทเค็น เวลาก่อนโทเค็นแรก ระยะเวลารวม และผลลัพธ์ผ่านการตรวจหรือไม่ คะแนนเบนช์มาร์กที่สูงขึ้นเป็นหลักฐานที่มีประโยชน์สำหรับการเลือกสิ่งที่ควรทดสอบ; การตัดสินใจส่งโปรดักชันควรตามผลบนเวิร์กโหลดของคุณ
รวมคำขอประจำและกรณียากที่ความล้มเหลวจะแพง
ทำซ้ำงานและสลับลำดับโมเดลเพื่อลดอิทธิพลจากผลลัพธ์ครั้งเดียว
วัดความหน่วงระดับมัธยฐานและหาง การใช้โทเค็น การลองใหม่ และผลลัพธ์ที่ยอมรับตลอดเวิร์กโฟลวเต็ม
ตั้งขีดจำกัดการลองใหม่และเงื่อนไขการส่งต่อโดยอิงผลการตรวจสอบที่สังเกตได้
บทสรุป การอัปเกรดที่มีประโยชน์คือสิ่งที่ปรับปรุงงานที่เสร็จของคุณ เลือกชุดงานตัวแทนเล็ก ๆ กำหนดสิ่งที่นับเป็นผลลัพธ์ที่ยอมรับได้ และวัดต้นทุนโมเดลพร้อมเวลาตรวจทานร่วมกัน เมื่อ Carbon พร้อมใช้งานในบัญชีของคุณ งานชุดเดียวกันนั้นจะบอกว่าคะแนนเบนช์มาร์กที่สูงขึ้นแปลเป็นมูลค่ามากพอที่จะสมควรสลับหรือไม่
FAQ
ใช้พรอมต์ของ Argon ซ้ำโดยไม่เปลี่ยนกับ Carbon ได้หรือไม่? ใช้เป็นจุดเริ่มต้นในการประเมินได้ แต่ไม่ใช่หลักฐานของพฤติกรรม API ที่เข้ากัน ตรวจรักษางานและเกณฑ์การยอมรับให้คงที่ แล้วตรวจยืนยันรหัสโมเดล สคีมาคำขอ รูปแบบเครื่องมือ และขีดจำกัดของ Carbon ที่มีเอกสารเมื่อเข้าถึงได้ การใช้พรอมต์ซ้ำและความเข้ากันในการอินทิเกรตเป็นคำถามแยกกัน
ควรจับคู่การตั้งค่าการคิดเมื่อเปรียบเทียบโมเดลหรือไม่? ควรจับคู่เมื่อเอนด์พอยต์มีคอนโทรลที่เทียบเคียงกัน และบันทึกความต่างไว้ ผลเบนช์มาร์กของ Google ที่ใช้การคิดระดับสูงสุดอธิบายการตั้งค่าการประเมินเฉพาะ; ไม่ได้ทำนายคุณภาพหรือความหน่วงของดีพลอย Argon ที่รันด้วยการตั้งค่าปานกลางโดยค่าเริ่มต้น การตั้งค่าการคิดของ Argon มีระดับต่ำ ปานกลาง และสูง ดังนั้นควรเปรียบเทียบทั้งการตั้งค่าต่ำสุดที่ผ่านเกณฑ์การยอมรับของแอปคุณและการตั้งค่าคุณภาพสูงสุด
ช่องว่างบนเบนช์มาร์กสามารถยืนยันการรับประกันบริการโปรดักชันได้หรือไม่? ไม่ได้ ประสิทธิภาพบนเบนช์มาร์กไม่ยืนยันข้อผูกพัน uptime ของเอนด์พอยต์ การให้บริการตามภูมิภาค เงื่อนไขการจัดการข้อมูล หรือการจัดการซัพพอร์ต ตรวจทานเงื่อนไขเหล่านั้นกับผู้ให้บริการที่คุณเลือกแยกกัน และทดสอบขนาดคำขอและรูปแบบทราฟฟิกที่คาดหวัง ก่อนพึ่งโมเดลใด ๆ สำหรับเวิร์กโฟลวที่สำคัญ
GraphWalks, 256K–1M (BFS F1) 96.2% 84.2% +12.0 pp
RiemannBench 80.0% 76.0% +4.0 pp
Terminal-Bench-Science 0.1 64.8% 52.9% +11.9 pp
CWE-bench 71.0% 68.0% +3.0 pp
ExploitGym 54.8% 42.0% +12.8 pp
SEC-bench Pro 88.2% 83.4% +4.8 pp