Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog GPT-5.6 Sol vs Fable 5.1: โมเดลระดับแนวหน้าใดดีกว่ากัน? ai-comparisons / งานวิจัย CometAPI
GPT-5.6 Sol vs Fable 5.1: โมเดลระดับแนวหน้าใดดีกว่ากัน? เปรียบเทียบ GPT-5.6 Sol กับ Claude Fable 5.1 ในด้านเบนช์มาร์ก เอเจนต์สำหรับการเขียนโค้ด ราคา API การแคช ความเร็ว และการเข้าถึง CometAPI
Deon Goodwin ทีมวิจัยโมเดล AI และ API เปรียบเทียบ GPT-5.6 Sol กับ Claude Fable 5.1 ในด้านเบนช์มาร์ก เอเจนต์สำหรับการเขียนโค้ด ราคา API การแคช ความเร็ว และการเข้าถึง CometAPI
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
Claude Fable 5.1 มีคะแนนทดสอบที่แข็งแรงกว่าในงานโค้ดอัตโนมัติที่ยากและงานระยะยาวหลายขั้นตอน ส่วน GPT-5.6 Sol มีต้นทุนโทเคนทั่วไปต่ำกว่า เครื่องมือเนทีฟกว้าง และเวลาถึงโทเคนแรกต่ำกว่าในการเปรียบเทียบแบบอิสระที่ตั้งค่าความพยายามสูงสุด การเลือกดีฟอลต์ที่เหมาะสมขึ้นกับ “ต้นทุนของงานที่ล้มเหลว” ไม่ใช่แค่คะแนนเบนช์มาร์กที่สูงสุด
ในสแนปช็อต Intelligence Index วันที่ 8 กันยายน 2026 Fable 5.1 ได้ 53 เทียบกับ 47 ของ GPT-5.6 Sol อัตราการส่งออกเอาต์พุตใกล้เคียงกันที่ 69.9 เทียบกับ 69.8 tok/s ผลลัพธ์เหล่านี้สนับสนุนการตัดสินใจแบบคุณภาพเทียบต้นทุน ไม่ได้ชี้ว่ามีผู้ชนะด้านความเร็วแบบสากล
ประเด็นสำคัญ
เลือก Fable 5.1 สำหรับงานอัตโนมัติที่ยากที่สุดเมื่อการประเมินของคุณยืนยันว่าคุ้มกับราคาที่สูงกว่า
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ เผยแพร่เมื่อ Sep 21, 2026 อัปเดตล่าสุด Sep 28, 2026 ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
เริ่มด้วย GPT-5.6 Sol สำหรับอินเฟอเรนซ์เชิงปริมาณที่คุ้มค่าและแอปที่ได้ประโยชน์จากเครื่องมือแบบบูรณาการ
เปรียบเทียบดีเลย์เริ่มต้นแยกจากความเร็วเอาต์พุต: GPT-5.6 Sol มีเวลาเริ่มแสดงโทเคนแรกต่ำกว่า ขณะที่อัตราการส่งออกแทบเสมอกัน
แยกบิลค่าเขียน/อ่านแคช การคงอยู่ของแคช และอัตราบริบทยาวออกจากกัน ราคาอินพุต/เอาต์พุตแบบพาดหัวไม่ครอบคลุมทุกเวิร์กโหลดของเอเจนต์
ตรวจสอบข้อมูลวันที่ 8 กันยายน 2026 ผลลัพธ์แบบอิสระใช้ GPT-5.6 Sol ที่ Max Effort และ Fable 5.1 ที่ Adaptive Reasoning, Max Effort, Default Fallback เบนช์มาร์กของผู้ขายและของอิสระใช้การตั้งค่าการประเมินต่างกัน ราคาเป็น USD ต่อหนึ่งล้านโทเคน (MTok) เว้นแต่ระบุไว้ต่างหาก
GPT-5.6 Sol vs Fable 5.1: ข้อสรุปแบบย่อ Independent Intelligence Index v4.3 (Sep 8) 47 53 Fable 5.1 Independent Terminal-Bench 4.0 (Sep 7) 39.9% 52.0% Fable 5.1 Anthropic-run Terminal-Bench 4.0 37.3% 55.8% Fable 5.1 Context window 1.05M 1M ถือว่าเสมอกัน Maximum output 128K 128K เสมอกัน Text/image input Yes Yes เสมอกัน Official input price / MTok $4 $10 Sol Official output price / MTok $20 $50 Sol Official cache read / MTok $0.40 $0.25 Fable 5.1 Independent output speed (Sep 8) 69.8 tok/s 69.9 tok/s ถือว่าเสมอกัน API tool breadth Very broad
นโยบายตั้งต้นที่เป็นประโยชน์คือใช้ Sol สำหรับงานแนวหน้าทั่วไป แล้วมี Fable 5.1 เป็นทางยกระดับเมื่อภารกิจไม่ผ่านเกณฑ์คุณภาพหรือความอัตโนมัติของคุณ ตรวจสอบนโยบายนี้เทียบกับ “ต้นทุนต่อภารกิจที่สำเร็จ”
ส่วนต่างบริบทเพิ่มอีก 50,000 โทเคนของ GPT-5.6 Sol มักไม่ใช่ตัวชี้ขาดสถาปัตยกรรมส่วนใหญ่ การคิดค่าบริการและการใช้แคชซ้ำมีผลมากขึ้นเมื่อคำขอเข้าใกล้หนึ่งล้านโทเคน; ส่วนบริบทยาวด้านล่างอธิบายเหตุผล
GPT-5.6 Sol คืออะไร? GPT-5.6 Sol เป็นระดับความสามารถสูงในตระกูล GPT-5.6 ของ OpenAI สำหรับงานโค้ดดิ้ง การวิจัย การวางแผน และเวิร์กโฟลว์เอเจนต์ที่ต้องการความสามารถสูง จุดเด่นในการเปรียบเทียบนี้คือการผสาน “ตัวควบคุมเหตุผล” เข้ากับสภาพแวดล้อมการปฏิบัติการที่รายล้อม
ผ่าน Responses API, GPT-5.6 Sol รองรับ พอร์ตโฟลิโอเครื่องมือเนทีฟที่กว้าง : web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills และ tool search ซึ่งช่วยลดจำนวนองค์ประกอบรันไทม์ที่แอปจำเป็นต้องผสานเอง
OpenAI ยังระบุ programmatic tool calling และการทำงานแบบหลายเอเจนต์สำหรับตระกูลนี้ ฟีเจอร์แพลตฟอร์มเหล่านี้มีความสำคัญเมื่อโมเดลต้องประสานงานข้ามเครื่องมือ ไม่ใช่เพียงตอบคำถามเดี่ยว
Claude Fable 5.1 คืออะไร? Claude Fable 5.1 มุ่งเป้าไปที่งานโค้ดดิ้งที่ต้องการ ความรู้เชิงวิชาชีพ การวิจัย และเอเจนต์ที่ทำงานยาว ผลลัพธ์เบนช์มาร์กโดยตรงทำให้เป็นตัวเลือกที่แข็งแกร่งสำหรับงานที่ “การกู้คืน การยืนหยัด และการทำงานจนสำเร็จ” สำคัญกว่าคำตอบที่สั้น
Fable 5.1 ยังต่างจาก GPT-5.6 Sol ในพฤติกรรม API: ข้อจำกัดการบังคับเลือกเครื่องมือ ส่งผลต่อเวิร์กโฟลว์ที่ต้องให้โมเดลเรียกเครื่องมือเฉพาะ ตรวจสอบโหมด tool_choice ที่รองรับเมื่อย้ายลูปเอเจนต์แบบกำหนดขั้นตอนแน่นอน
คำถามการผสานจึงเป็นเชิงปฏิบัติ: แอปของคุณยอมรับลูปเหตุผลที่อัตโนมัติมากขึ้นได้หรือไม่ หรือจำเป็นต้องควบคุมแต่ละขั้นให้ละเอียด? ทดสอบพฤติกรรมเครื่องมือที่แน่ชัดก่อนเลือกทาง
การเปรียบเทียบเบนช์มาร์ก: Fable 5.1 มีหลักฐานตรงที่แข็งแรงกว่า การเปรียบเทียบเบนช์มาร์กระหว่างผู้ขายแข่งขันกันใช้งานผิดได้ง่าย การประเมินเปิดตัว GPT-5.6 ของ OpenAI มาก่อน Fable 5.1 ขณะที่การเปิดตัว Fable 5.1 ของ Anthropic มีการเปรียบเทียบตรงกับ GPT-5.6 Sol ที่ใหม่กว่า
วิธีอ่านหลักฐานที่สะอาดที่สุดจึงเป็นสามชั้น: การเปรียบเทียบตรงของ Anthropic, การทดสอบอิสระปัจจุบัน และโปรไฟล์ความสามารถของ GPT-5.6 Sol จาก OpenAI เอง
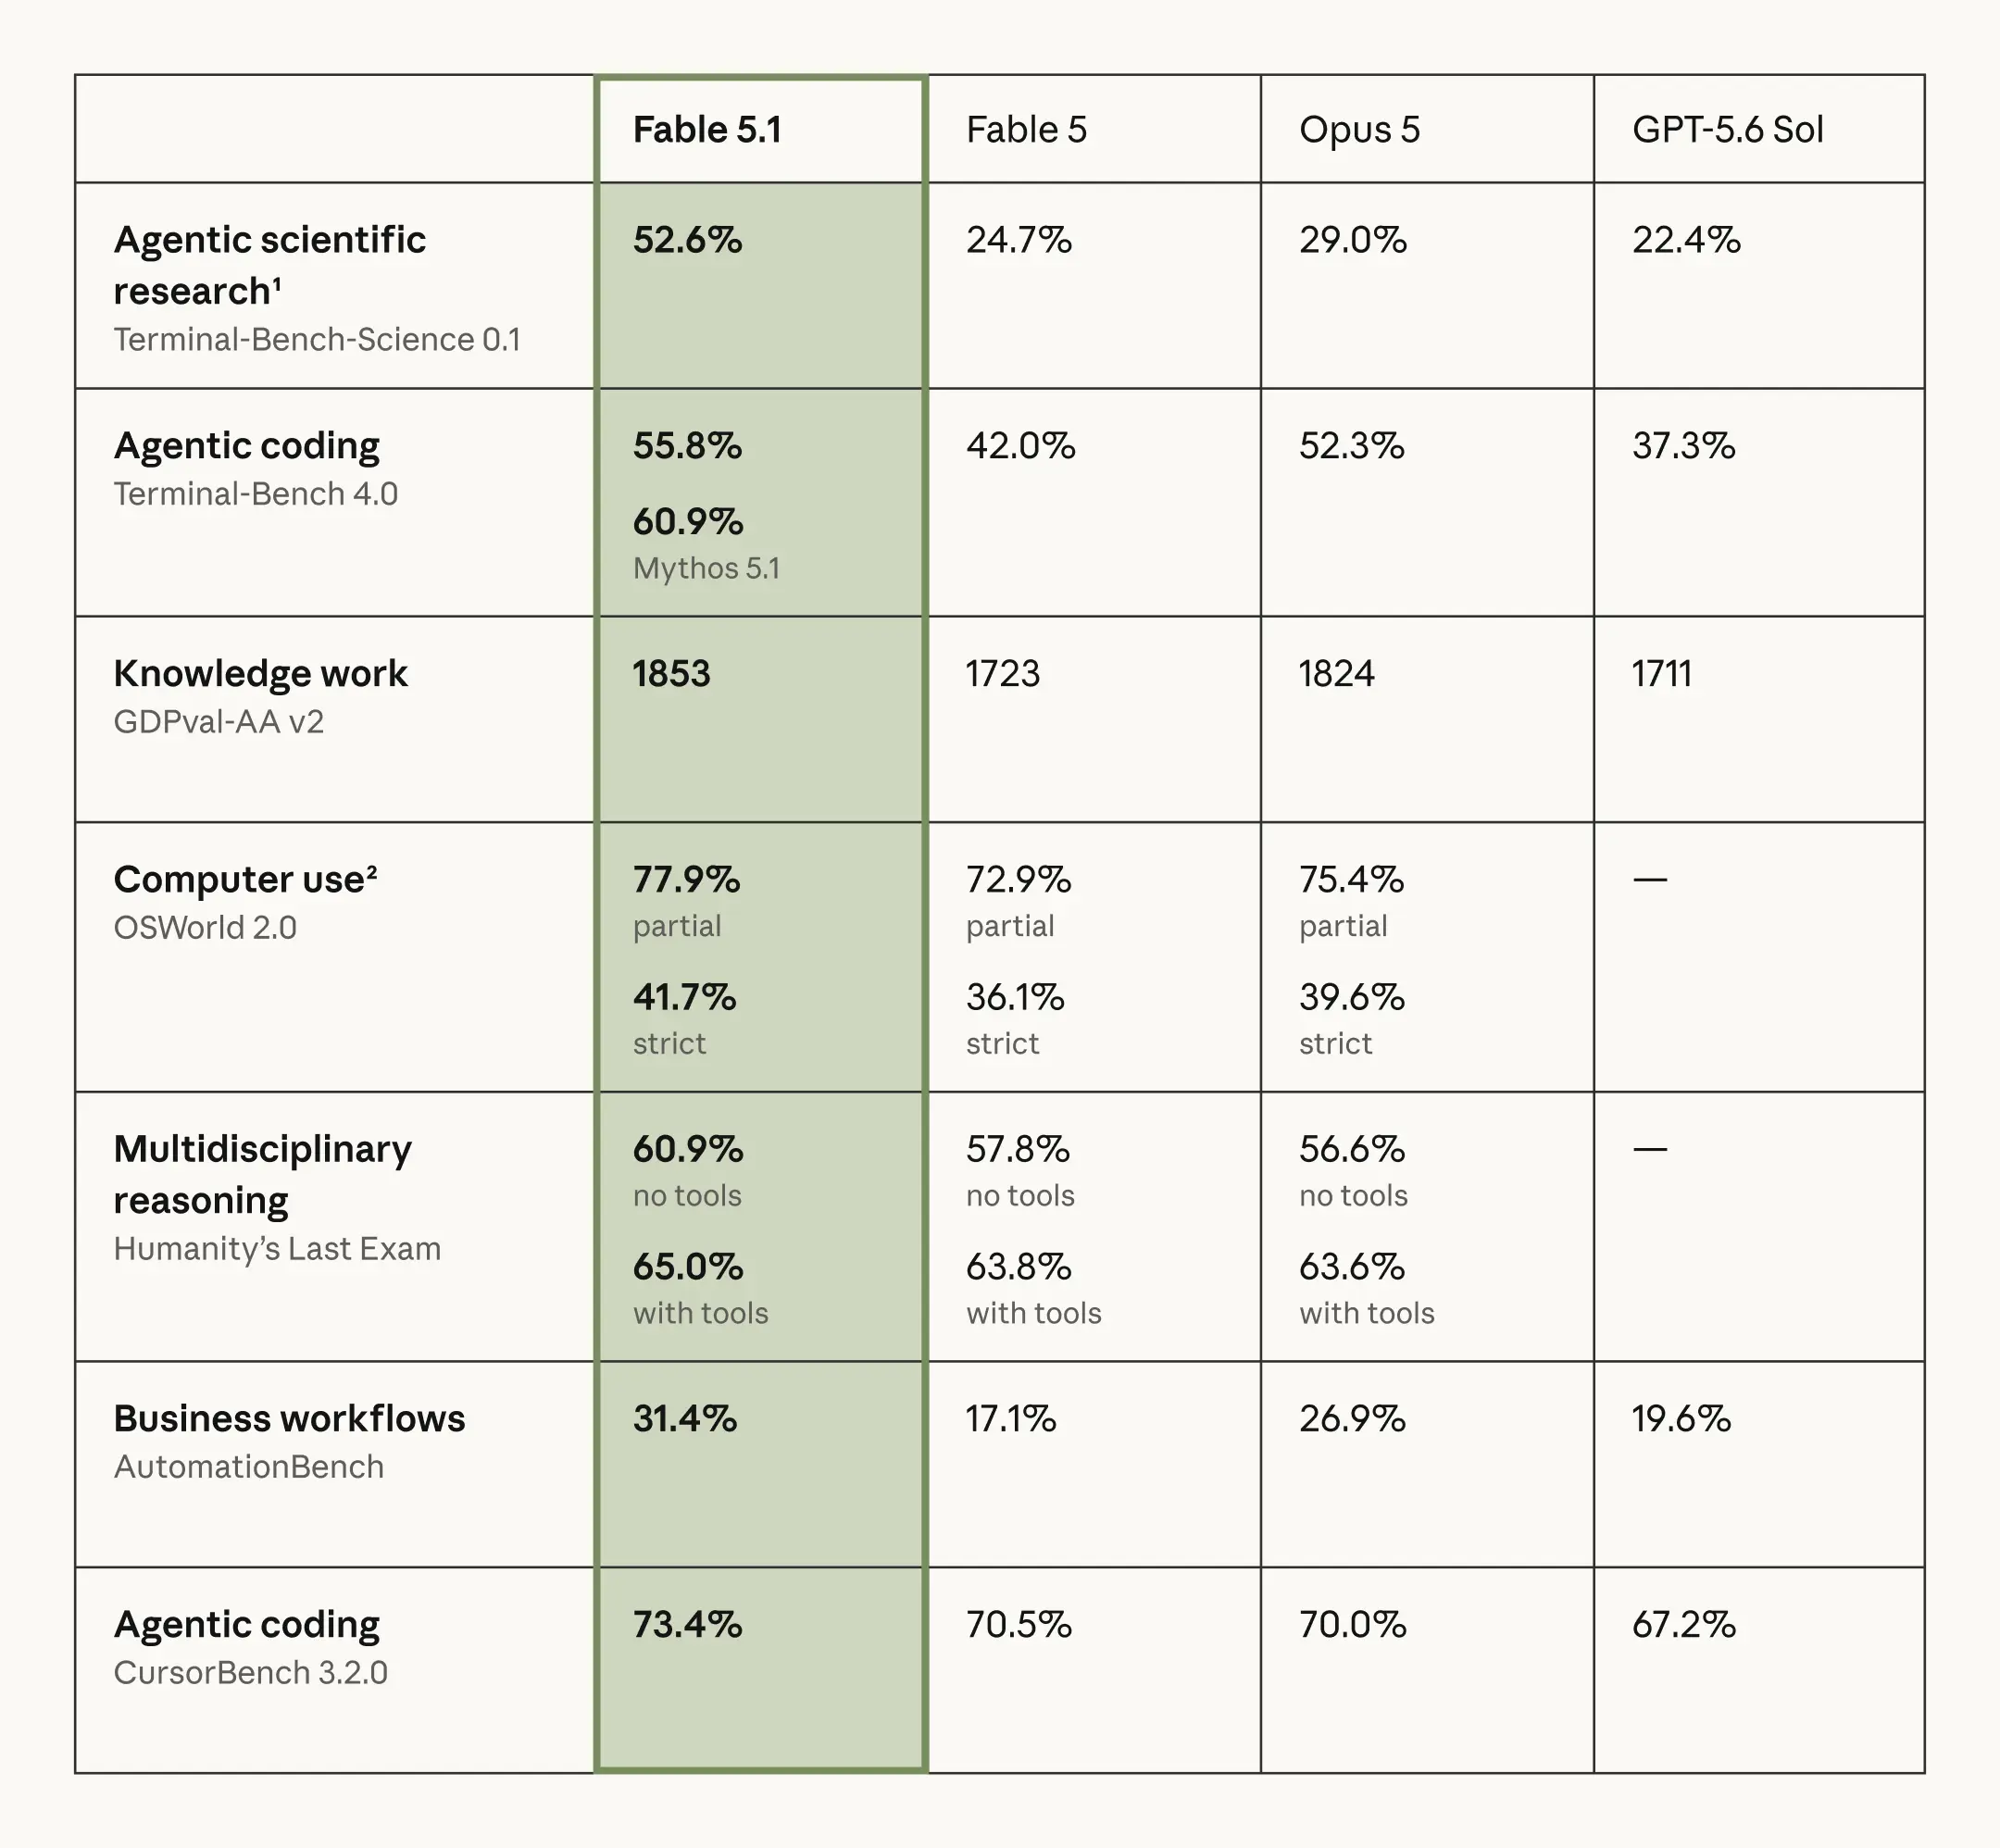
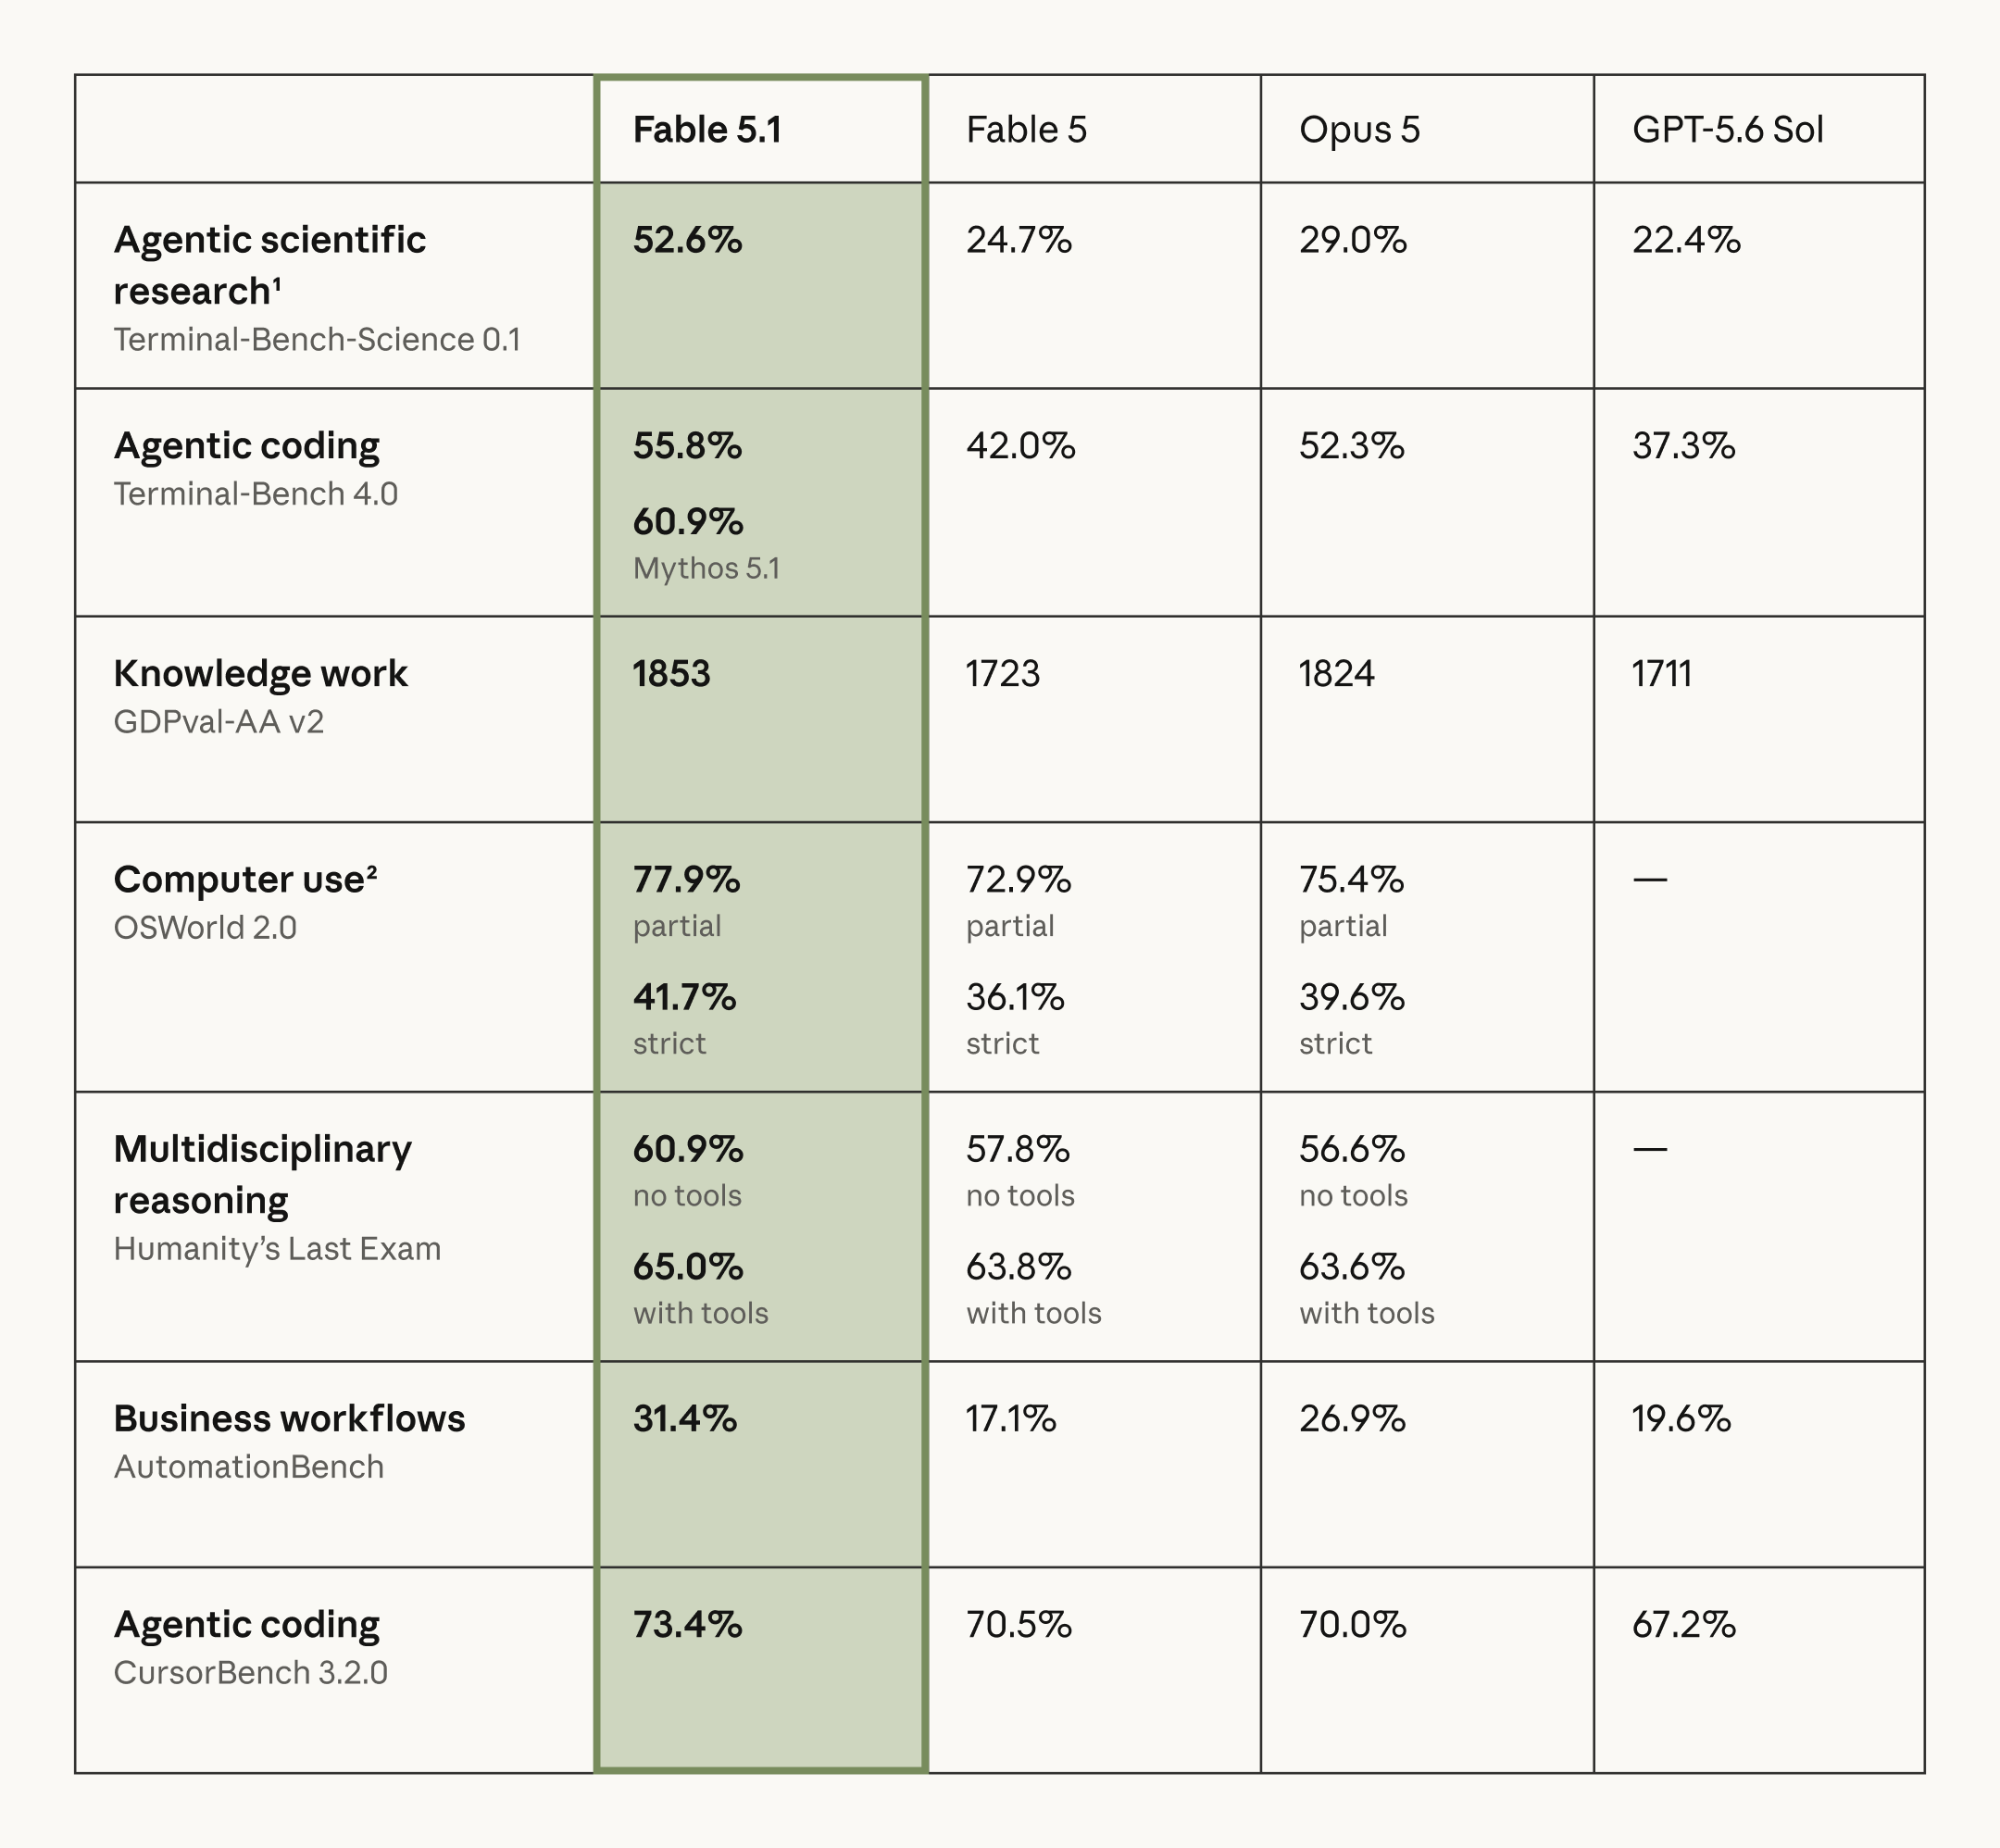
ผลลัพธ์ตรง Fable 5.1 เทียบ GPT-5.6 Sol ของ Anthropic ผลลัพธ์เบนช์มาร์กทางการ มี 5 งานที่รายงานคะแนนของทั้งสองโมเดล ความต่างเป็นเปอร์เซ็นต์และ Elo ด้านล่างคำนวณจากค่าที่เผยแพร่
Terminal-Bench-Science 0.1 22.4% 52.6% +30.2 pts Terminal-Bench 4.0 37.3% 55.8% +18.5 pts GDPval-AA v2 1711 Elo 1853 Elo +142 Elo AutomationBench 19.6% 31.4% +11.8 pts CursorBench 3.2.0 67.2% 73.4% +6.2 pts
ผลลัพธ์สอดคล้องผิดปกติ: Fable 5.1 นำ GPT-5.6 Sol ในทุกแถวที่ Anthropic เผยแพร่ ความต่างที่ใหญ่สุดปรากฏในงานวิจัยวิทยาศาสตร์เชิงเอเจนต์และโค้ดดิ้งบนเทอร์มินัล มากกว่าการให้เหตุผลแบบสั้นทั่วไป
นี่คือการประเมินโดยผู้ขาย: Anthropic ทดสอบทั้งโมเดลของตนและของคู่แข่ง ให้หลักฐานเปรียบเทียบโดยตรง แต่ไม่ใช่การทดสอบอิสระ Anthropic รายงานค่าเบี่ยงเบนมาตรฐาน ±3.5–4.5 จุดเปอร์เซ็นต์ต่อโมเดลบน Terminal-Bench-Science; ตารางข้างบนแสดงค่าคาดประมาณ ไม่ใช่ช่วงความเชื่อมั่น
ผลจากผู้ขายเข้าข้าง Fable 5.1 แต่หลักฐานอิสระต้องดูวันที่และการตั้งค่าของมันเอง
เบนช์มาร์กอิสระ: แยกผลที่ลงวันที่ออกจากการวัดสด Artificial Analysis เปิดตัว Intelligence Index v4.3 เมื่อ 7 กันยายน โดยแทนที่ Terminal-Bench 2.1 ด้วย Terminal-Bench 4.0 และเพิ่ม AutomationBench-AA รุ่นนี้รายงาน 53 สำหรับ Fable 5.1 และ 47 สำหรับ GPT-5.6 Sol ตรงกับคะแนนปัดเศษในเปรียบเทียบวันที่ 8 กันยายน ตารางแยกผลเทอร์มินัลของรุ่นเปิดตัวออกจากสแนปช็อตสมรรถนะที่ตามมา
Intelligence Index v4.3 (Sep 8) 47 53 Fable Terminal-Bench 4.0 (Sep 7 release) 39.9% 52.0% Fable OSWorld 2.0 62.6% 41.7% Output speed (Sep 8) 69.8 tok/s 69.9 tok/s ถือว่าเสมอกัน Time to first token (Sep 8) 132.10 s 277.47 s Sol AA normalized token-mix price / MTok $3.08 $7.175 Sol
สแนปช็อต: 8 กันยายน 2026 เว้นแถว Terminal-Bench วันที่ 7 กันยายน Fable 5.1 ใช้ Adaptive Reasoning, Max Effort, Default Fallback; Sol ใช้ max การวัดสดอาจเปลี่ยนได้ ราคา token-mix ที่ปรับมาตรฐานของ AA ใช้อัตราส่วน 7:2:1 สำหรับ cache-hit/input/output; ไม่ใช่ต้นทุนของทุกคำขอ API
OSWorld 2.0 เป็นข้อได้เปรียบที่รายงานใหญ่สุดของ Sol ในการเปรียบเทียบนั้น: 62.6% เทียบ 41.7% สำหรับ Fable 5.1 นำ 20.9 จุด ซึ่งถ่วงดุลผลที่ Fable เด่นกว่าใน Intelligence Index และ Terminal-Bench
หลักฐานสนับสนุนการแลกเปลี่ยนเฉพาะ: Fable 5.1 มีคะแนน Intelligence Index สูงกว่า ขณะที่ Sol มีเวลาเริ่มโทเคนแรกต่ำกว่าและราคาที่ปรับมาตรฐานต่ำกว่า อัตราการส่งออกเอาต์พุตแทบเสมอกัน การวัดเหล่านี้สนับสนุนตัวเลือกที่ต่างกันระหว่างงานแบตช์ที่เน้นคุณภาพกับแอปเชิงโต้ตอบ
การเปรียบเทียบ Terminal-Bench อิสระที่ลงวันที่ชี้ทิศทางเดียวกับการทดสอบของ Anthropic: 52.0% เทียบ 39.9% เทียบกับ 55.8% เทียบ 37.3% ของผู้ขาย ช่องว่างสองกรณีใช้แทนกันไม่ได้เพราะการตั้งค่าการประเมินต่างกัน
สิ่งที่เบนช์มาร์กของ OpenAI ยังบอกเราเกี่ยวกับ GPT-5.6 Sol การประเมินเปิดตัวของ OpenAI ให้บริบทเพิ่มเติมเกี่ยวกับความสามารถของ GPT-5.6 Sol แม้มันมาก่อนผลชนกันรุ่นใหม่ด้านบน จึงไม่ควรใช้เปรียบเทียบโดยตรงกับ Fable 5.1
OpenAI รายงาน 88.8% บน Terminal-Bench 2.1 สำหรับ GPT-5.6 Sol ซึ่งเป็นหลักฐานความสามารถโค้ดดิ้งเชิงเอเจนต์ที่แข็งแรงภายใต้การตั้งค่าเปิดตัว; เวอร์ชันเบนช์มาร์กเก่ากว่าไม่ควรนำไปเทียบเชิงตัวเลขกับคะแนนของ Terminal-Bench 4.0
GPT-5.6 Sol vs Fable 5.1 สำหรับงานโค้ดดิ้ง สำหรับการสร้างโค้ดตรงไปตรงมา โมเดลทั้งสองเกินความต้องการของงานโปรดักชันจำนวนมาก ความแตกต่างชัดขึ้นเมื่อโค้ดดิ้งกลายเป็น “วิศวกรรมซอฟต์แวร์แบบเอเจนต์”: ตรวจสอบรีโพขนาดใหญ่ แก้หลายไฟล์ รันคำสั่ง วินิจฉัยความล้มเหลว เขียนเทสต์ และวนซ้ำจนงานผ่าน
ที่นี่ Claude Fable 5.1 มีกรณีเบนช์มาร์กปัจจุบันที่แข็งแรงกว่า นำทั้งการเปรียบเทียบ Terminal-Bench 4.0 ของผู้ขายและของอิสระ และผล CursorBench ของ Anthropic ก็โน้มไปทางมันที่ 73.4% ต่อ 67.2%
สำหรับการประเมินเชิงปฏิบัติ ควรรวมการเปลี่ยนแปลงทั้งรีโพ เทสต์ รีวิว และงานสมรรถนะ โค้ดสั้นที่สำเร็จไม่ใช่ตัวแทนที่ดีของงานที่ครอบคลุมหลายไฟล์และหลายครั้งที่ล้มเหลว
GPT-5.6 Sol ยังคงน่าดึงดูดเมื่อสภาพแวดล้อมการปฏิบัติการรอบข้างสำคัญพอๆ กับคุณภาพโมเดล รองรับเครื่องมือเนทีฟอย่าง shell, apply-patch, code interpreter, file search, computer use และ MCP ช่วยลดโครงสร้าง orchestrator ที่คุณต้องสร้างเอง
ข้อสรุปงานโค้ด: เลือก Fable 5.1 เมื่อการประเมินเน้นงานอัตโนมัติบนรีโพที่ยากที่สุด เลือก GPT-5.6 Sol เมื่อยอมรับความสามารถเบนช์มาร์กที่ต่ำลงเล็กน้อยเพื่อแลกกับต้นทุนที่ต่ำกว่าและสแตกการปฏิบัติการแบบบูรณาการกว้าง
การควบคุมเหตุผลและประสบการณ์นักพัฒนา API ของทั้งสองแสดง “ความฉลาด” ต่างกัน
ช่วง none-to-max ของ Sol เปิดทางให้ทีมทดสอบทั้งคุณภาพและดีเลย์ในหลายระดับ ลดระดับความพยายามอาจลดงานให้เหตุผล แต่การตั้งค่าที่เหมาะขึ้นกับ “ต้นทุนของความล้มเหลว”
การคิดแบบปรับตัวตลอดเวลาของ Fable ทำให้การจูน effort เป็นอีกแบบ เปรียบเทียบการตั้งค่าที่แอปของคุณจะใช้จริง แทนที่จะถือว่าป้าย effort เหมือนกันคือบัดเจ็ตคอมพิวต์เท่ากัน
จึงไม่มีการเปรียบเทียบที่ “ยุติธรรมสากล” ระหว่าง “ดีฟอลต์ของ Sol” กับ “ดีฟอลต์ของ Fable” เพราะค่าเริ่มเหตุผลต่างกัน การประเมินโปรดักชันควรเปรียบเทียบทั้งงบคอมพิวต์ที่เทียบเท่าหรือการตั้งค่าที่คุณจะใช้งานจริง
GPT-5.6 Sol vs Fable 5.1: โมเดลไหนดีกว่าสำหรับเอเจนต์ AI? ขึ้นอยู่กับว่าคอขวดคือ “การให้เหตุผลที่ยาก” หรือ “รันไทม์รอบๆ” กันแน่
ความนำของ Fable ในเทอร์มินัล ออโตเมชัน และงานวิชาชีพที่อ้างถึงทำให้มันเป็นผู้ท้าชิงที่สมเหตุผลสำหรับงานที่ยากที่สุด วัดอัตราสำเร็จและการกู้คืนจากขั้นที่ล้มเหลวก่อนสรุปผลทั่วไปไปยังเอเจนต์ของคุณ
พอร์ตเครื่องมือ Responses ของ GPT-5.6 Sol ทำให้มันน่าสนใจสำหรับแอปที่สร้างรอบ search, files, shell execution และ patches นั่นเป็นข้อได้เปรียบด้านการผสานที่ควรประเมินคู่กับความแม่นยำงาน ไม่ใช่แทนที่มัน
การให้เหตุผลยากระยะยาว Excellent Best fit ความอัตโนมัติบนเทอร์มินัล/รีโพ Excellent Stronger evidence พอร์ตเครื่องมือเนทีฟแบบบูรณาการ Stronger Strong การบังคับเลือกเครื่องมือเฉพาะ Supported; check chosen API Restricted; check tool_choice modes การผสานแพลตฟอร์มหลายเอเจนต์ Strong advantage Available through agent architecture การสื่อสารความคืบหน้าระหว่างงานยาว Good Core behavior เอเจนต์ปริมาณสูงอ่อนไหวต่อต้นทุน Better Premium บริบทขนาดใหญ่อ่านจากแคชซ้ำๆ Good Potentially very attractive
การใช้ทั้งสองอาจคุ้มเมื่อมีเพียงส่วนน้อยของงานที่ต้องยกระดับ วัดว่าการสำเร็จเพิ่มขึ้นชดเชยราคาและดีเลย์เริ่มต้นที่สูงกว่าของโมเดลที่สองหรือไม่
บริบทยาว: 1.05M vs 1M ไม่ใช่ความต่างที่สำคัญ ตัวเลขพาดหัวดูเกือบเหมือนกัน: GPT-5.6 Sol ให้ 1.05M โทเคน และ Fable ให้ 1M ความต่าง 5% ไม่น่าจะตัดสินได้ว่าคุณวิเคราะห์รีโพขนาดใหญ่ คลังคดีความ ชุดงานวิจัย หรือประวัติเอเจนต์หลายชั่วโมงได้หรือไม่ ทั้งสองอยู่ในชั้นล้านโทเคนแล้ว
สำหรับ GPT-5.6 Sol อินพุตเกิน 272K จะกระตุ้น อัตราบริบทยาวที่สูงขึ้น ต่อคำขอ: $8/MTok อินพุต, $0.80/MTok อินพุตที่แคชแล้ว และ $30/MTok เอาต์พุต ค่าบันทึกแคชก็เพิ่มจาก $5 เป็น $10/MTok
Fable 5.1 คง อัตรามาตรฐานสำหรับบริบท 1M : $10/MTok อินพุต, $50/MTok เอาต์พุต และ $0.25/MTok อ่านแคช ไม่มีเรทราคาเหนือ 272K แยกต่างหากในคอนฟิกที่บันทึกไว้
พิจารณารอบหนึ่งที่มีอินพุตใหม่ไม่แคช 100K โทเคน อ่านแคช 900K โทเคน และเอาต์พุตที่ถูกคิดเงินรวม 20K โทเคน GPT-5.6 Sol มีต้นทุน 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12 ส่วน Fable 5.1 มีต้นทุน 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225
รอบที่พึ่งแคชหนักๆ นี้ทำให้ช่องว่างราคาแคบลงมาก เพราะ Fable อ่านแคชถูกกว่า ผลลัพธ์ขึ้นกับสัดส่วนโทเคนของเวิร์กโหลด; ไม่ได้หมายความว่าโมเดลทั้งสองมีต้นทุนเท่ากันสำหรับเซสชันเอเจนต์เต็มๆ
สมมติฐานต้นทุน: พรีฟิกซ์ 900K โทเคนถูกแคชไว้แล้ว และอินพุตใหม่ 100K ไม่ถูกคิดเป็นการเขียนแคชใหม่ การประมาณไม่รวมการเขียนแคชเริ่มต้นและค่าธรรมเนียมเครื่องมือ เอาต์พุต 20K รวมเอาต์พุตที่ถูกคิดเงินทั้งหมด รวมถึงโทเคนเหตุผลที่ถูกคิดเงินด้วย
ราคา: Sol ชนะเวิร์กโหลดทั่วไป, Fable ชนะหนึ่งเมตริกของแคชที่สำคัญ ที่เรทราคาที่ตรวจสอบ Sol มีค่าใช้จ่าย $4 อินพุต / $20 เอาต์พุต ต่อ MTok โดยอ่านแคช $0.40/MTok ส่วน Fable 5.1 อยู่ที่ $10 อินพุต, $50 เอาต์พุต และอ่านแคช $0.25 ตารางแยกราคาจากผู้ให้บริการโดยตรงออกจากเรท GPT-5.6 Sol API ใน CometAPI และ Claude Fable 5.1 API ใน CometAPI
Official input / MTok $4.00 $10.00 Official output / MTok $20.00 $50.00 Official cache read / MTok $0.40 $0.25 Official cache write / MTok $5.00 (30 minutes) $12.50 (5 minutes) Above 272K input: input / cache read / cache write / output $8 / $0.80 / $10 / $30 Same documented base rates CometAPI input / MTok $3.20 $8.00 CometAPI output / MTok $16.00 $40.00
ที่อัตราผู้ให้บริการโดยตรงที่ตรวจสอบ Fable 5.1 แพงกว่า Sol 2.5× ทั้งอินพุตที่ไม่แคช ($10 vs $4/MTok) และเอาต์พุต ($50 vs $20/MTok) ปฏิบัติต่อเรทราคานี้เป็นการเปรียบเทียบ ณ วันที่หนึ่ง เพราะโปรโมชันผู้ให้บริการและราคาจากเกตเวย์อาจเปลี่ยนได้
คำขอสั้นที่มีอินพุต 100K และเอาต์พุตที่ถูกคิดเงินรวม 10K มีค่าใช้จ่ายประมาณ $0.60 กับ Sol หรือ $1.50 กับ Fable ที่เรทราคาผู้ให้บริการโดยตรง ที่เรท CometAPI ข้างต้น ชุดเดียวกันมีค่า $0.48 หรือ $1.20 ตัวอย่างนี้ไม่รวมการเขียนแคชและค่าธรรมเนียมเครื่องมือ
อัตราอ่านแคกระยะสั้นของ Fable ถูกกว่า 37.5%: ($0.40 − $0.25) ÷ $0.40 ซึ่งสำคัญสำหรับเอเจนต์ที่ใช้พรีฟิกซ์ขนาดใหญ่คงที่ซ้ำๆ แต่การประหยัดรวมยังขึ้นกับอินพุตใหม่ ความถี่ในการเขียน และปริมาณเอาต์พุต
ข้อสรุปราคา: Sol เป็นจุดเริ่มต้นที่ถูกกว่าสำหรับทราฟฟิกที่ไม่มีบริบทแคช Fable แข่งขันได้มากขึ้นเมื่อสัดส่วนอ่านแคชเติบโต; เปรียบเทียบต้นทุนทั้งเซสชัน รวมถึงการสร้างและรีเฟรชแคช
ความเร็วและเวลาแฝง การทดสอบความพยายามสูงสุดอาจใช้เวลาให้เหตุผลก่อนโทเคนแรกปรากฏนาน
การวัด throughput และ latency วันที่ 8 กันยายน แสดง 69.9 โทเคน/วินาทีสำหรับ Fable และ 69.8 สำหรับ Sol เวลาเริ่มโทเคนแรกคือ 277.47 วินาที เทียบ 132.10 วินาที อัตราการส่งออกเอาต์พุตแทบเท่ากัน; Sol เริ่มส่งออกที่มองเห็นได้เร็วกว่าในคอนฟิกนี้
นี่คือการวัดเบนช์มาร์กแบบ Max Effort ไม่ใช่คำสัญญา latency ของทุกคำขอ API ความยาวพรอมป์ การตั้งค่าเหตุผล โหลดผู้ให้บริการ เครื่องมือ และสถานะแคชสามารถเปลี่ยนผลได้ เวลาเริ่มโทเคนแรกและเวลาจบทั้งคำตอบเป็นเมตริกที่ต่างกัน
สำหรับงานเชิงโต้ตอบ ดีเลย์เริ่มต้นต่ำที่สังเกตได้อาจเอียงไปทาง Sol สำหรับการวิจัยแบบอะซิงก์หรือการทำงานกับรีโพข้ามคืน “การจบสำเร็จ” อาจสำคัญกว่าการรอโทเคนแรก ทดสอบทั้งสองโมเดลด้วยการตั้งค่าและความขนานที่คุณตั้งใจใช้
ระบบป้องกันเป็นความต่างในโปรดักชัน ทั้งสองโมเดลมีระบบป้องกันที่เข้มแข็งขึ้น เพราะความสามารถขยายไปยังไซเบอร์ซีเคียวริตี้และโดเมนวิทยาศาสตร์ที่อ่อนไหว แต่การใช้งานต่างกัน
เงื่อนไข rerouting และการเก็บข้อมูล ของ Anthropic อธิบายการส่งคำขอไซเบอร์ซีเคียวริตี้หรือชีววิทยาบางประเภทไปยังโมเดลที่มีความสามารถน้อยกว่า โดยไม่คิดอัตรา Fable สำหรับคำขอที่ถูกเปลี่ยนเส้นทาง ค่าเริ่มต้นการเก็บข้อมูลคือ 30 วัน โดยมีข้อยกเว้นสำหรับข้อตกลงระดับองค์กรที่เข้าเงื่อนไข
สำหรับโค้ดดิ้งและงานความรู้ทั่วไป ความต่างนี้อาจไม่เคยปรากฏ สำหรับผลิตภัณฑ์ด้านความปลอดภัย เวิร์กโหลดที่ถูกกำกับดูแล หรือการปรับใช้ที่อ่อนไหวด้านความเป็นส่วนตัว สิ่งเหล่านี้ควรอยู่ในเช็คลิสต์การประเมินควบคู่ไปกับคุณภาพเบนช์มาร์กและราคา
ควรเลือกโมเดลไหน? โดยรวมการเปรียบเทียบควรลดทอนตามรูปทรงเวิร์กโหลด
โค้ดดิ้งอัตโนมัติที่ยาก Excellent Stronger current benchmarks Fable 5.1 การวิจัยระยะยาวหลายขั้น Excellent Core strength Fable 5.1 API ปริมาณสูงแนวหน้า Much cheaper Expensive Sol ผู้ช่วยโค้ดแบบโต้ตอบ Lower measured max-effort TTFT Higher measured max-effort TTFT ทดสอบการตั้งค่าที่ใช้จริง เอเจนต์ API ที่พึ่งเครื่องมือ Broader native tool stack Strong Sol เอเจนต์บริบทล้านโทเคนแบบแคช Competitive Very low cache-read price ทดสอบทั้งสอง คุณภาพเหตุผลสูงสุด Excellent Independent lead Fable 5.1 ต้นทุนต่อคำขอทั่วไป Clear advantage Premium Sol เหตุผลบนภาพ/เอกสาร Strong Strong ทดสอบบนเวิร์กโหลด สแต็กผู้ให้บริการ OpenAI เดียว Natural fit Requires migration/gateway Sol
นโยบายเราต์ควรคุ้มกับความซับซ้อน เปรียบเทียบฐานที่ใช้โมเดลเดียวกับนโยบาย “เริ่มจาก Sol แล้วยกระดับไป Fable 5.1 เมื่อยาก” และคงการเราต์ไว้ก็ต่อเมื่อช่วยปรับปรุง “ต้นทุนต่อภารกิจที่สำเร็จ” ที่ระดับคุณภาพที่ต้องการ
CometAPI ผสาน GPT-5.6 Sol และ Claude Fable 5.1 แล้ว เข้าถึงทั้งสองโมเดลด้วยฟอร์แมตคำขอเนทีฟของแต่ละราย ส่งชุดประเมินเดียวกัน และเปรียบเทียบผลลัพธ์ภายใต้การตั้งค่าที่แมตช์กัน
ใช้คำขอรูปแบบเนทีฟของแต่ละโมเดล และตรึงพรอมป์ ชุดข้อมูล การตั้งค่าความพยายาม ความขนาน และกฎการให้คะแนนให้คงที่ ทำซ้ำรอบการรัน; การยิงคำขอทีละหนึ่งต่อโมเดลไม่พอจะประเมิน latency หรือคุณภาพที่เชื่อถือได้
สำหรับการประเมินโปรดักชัน ใช้ชุดพรอมป์ตายตัว สลับลำดับการรัน บันทึกการตั้งค่าความพยายาม และให้คะแนนความถูกต้อง อัตราผ่านเทสต์ ความสำเร็จของเครื่องมือ การลองซ้ำ การใช้โทเคน เวลาที่ผ่านไป และต้นทุนรวมต่อภารกิจที่สำเร็จ จูนแต่ละโมเดลแยกกันหลังจากฐานร่วม
ข้อสรุปสุดท้าย: GPT-5.6 Sol หรือ Claude Fable 5.1? Fable 5.1 มีหลักฐานตรงที่แข็งแรงกว่าสำหรับโค้ดดิ้งอัตโนมัติที่ยากที่สุดและงานระยะยาว นำทั้งห้าแถวเบนช์มาร์กของผู้ขายและการเปรียบเทียบเทอร์มินัลของอิสระที่ลงวันที่ จึงเป็นตัวเลือกยกระดับที่แข็งแรง โดยต้องยืนยันกับงานของคุณเอง
Sol มีราคาโทเคนทั่วไปที่ต่ำกว่า การควบคุมเหตุผลที่ละเอียดกว่า และสแตกเครื่องมือเนทีฟกว้าง ในคอนฟิกแบบอิสระที่พยายามสูงสุดที่ตรวจสอบ มันยังมีเวลาเริ่มโทเคนแรกต่ำกว่า; อัตราส่งออกเอาต์พุตแทบเสมอกัน
ให้น้ำหนัก Fable 5.1 เมื่อ “งานอัตโนมัติที่ยากที่สุด” เป็นตัวกำหนดอัตราสำเร็จ เริ่มจาก Sol สำหรับอินเฟอเรนซ์เชิงประหยัดหรือแอปที่พึ่งเครื่องมือหนัก สำหรับเวิร์กโหลดโต้ตอบ ทดสอบการตั้งค่าความพยายามที่คุณจะใช้จริงเพื่อยืนยันว่าได้เปรียบด้านดีเลย์เริ่มต้นคงอยู่หรือไม่
เลือกโมเดลเดียวเมื่อมันตอบโจทย์อย่างเรียบง่าย เพิ่มการเราต์เมื่อผลการประเมินแสดงว่าการสลับระหว่างสองโมเดลช่วยปรับปรุงคุณภาพหรือ “ต้นทุนต่อภารกิจที่สำเร็จ”
คำถามที่พบบ่อย
Claude Fable 5.1 ดีกว่า GPT-5.6 Sol หรือไม่? มันมี Intelligence Index อิสระที่สูงกว่าในสแนปช็อต 8 กันยายน: 53 เทียบกับ 47 ของ Sol และยังนำการทดสอบเทอร์มินัลของอิสระที่ลงวันที่ นั่นสนับสนุนความได้เปรียบด้านคุณภาพบนการประเมินเหล่านี้ ไม่ใช่ข้ออ้างว่าดีกว่าสำหรับทุกเวิร์กโหลด
GPT-5.6 Sol ถูกกว่า Claude Fable 5.1 หรือไม่? สำหรับทราฟฟิก API ที่ไม่ใช้แคชทั่วไป ใช่: อัตราผู้ให้บริการโดยตรงที่ตรวจสอบคือ $4/$20 ต่อ MTok สำหรับ Sol และ $10/$50 สำหรับ Fable 5.1 เวิร์กโหลดที่พึ่งแคชหนักสามารถทำให้ช่องว่างแคบลง เพราะอัตราอ่านแคชของ Fable ต่ำกว่า รวมพฤติกรรมการเขียนและหมดอายุแคชในการประมาณด้วย
โมเดลไหนดีกว่าสำหรับโค้ดดิ้ง? Fable 5.1 มีหลักฐานเบนช์มาร์กโค้ดดิ้งอัตโนมัติที่แข็งแรงกว่าในการเปรียบเทียบนี้ Sol ยังคงน่าสนใจสำหรับเวิร์กโฟลว์ที่ต้องการต้นทุนต่ำกว่าและเครื่องมือปฏิบัติการแบบบูรณาการ ใช้งานบนรีโพที่มีเทสต์รันได้เพื่อดูว่าช่องว่างความสามารถที่วัดได้สำคัญต่อแอปของคุณหรือไม่
โมเดลไหนมีบริบทใหญ่กว่า? Sol นำทางเทคนิคที่ 1.05M เทียบกับ 1M โทเคนของ Fable 5.1 ขณะที่ทั้งคู่อนุญาตเอาต์พุตสูงสุด 128K ในทางปฏิบัติ เกณฑ์ราคาของ Sol ที่ >272K และอัตราอ่านแคชที่ถูกของ Fable มักสำคัญกว่าความต่างความจุ 50K โทเคน
ได้ GPT-5.6 Sol API ใน CometAPI และ Claude Fable 5.1 API ใน CometAPI สนับสนุนจุดเริ่มต้นทั่วไปสำหรับการประเมินข้อความ ตรวจสอบการรองรับเหตุผล การแคช และเครื่องมือเฉพาะเส้นทางก่อนขยายไปเป็นเอเจนต์โปรดักชัน
Long-running autonomous work Excellent Core strength Fable 5.1
Cost-sensitive production Better default Premium escalation Sol
การเราต์แบบไม่ผูกโมเดล Strong Strong ใช้ทั้งสองผ่าน CometAPI