Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog GPT-6.1 Terra เทียบกับ DeepSeek V4.1 Flash: ผลทดสอบเบนช์มาร์ก, คุณสมบัติ, ราคา
ai-comparisons / งานวิจัย CometAPI
GPT-6.1 Terra เทียบกับ DeepSeek V4.1 Flash: ผลทดสอบเบนช์มาร์ก, คุณสมบัติ, ราคา เปรียบเทียบ GPT-6.1 Terra และ DeepSeek V4.1 Flash ในด้านเบนช์มาร์ก การเขียนโค้ด คอมพิวเตอร์วิชัน บริบท ราคา API และการเข้าถึง CometAPI เพื่อหาว่ารุ่นใดดีกว่า
lesile ทีมวิจัยโมเดล AI และ API เปรียบเทียบ GPT-6.1 Terra และ DeepSeek V4.1 Flash ในด้านเบนช์มาร์ก การเขียนโค้ด คอมพิวเตอร์วิชัน บริบท ราคา API และการเข้าถึง CometAPI เพื่อหาว่ารุ่นใดดีกว่า
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR : GPT-6.1 Terra เป็นจุดเริ่มต้นที่แข็งแกร่งกว่าเมื่อคุณภาพการให้เหตุผลและเวิร์กโฟลว์ภาพที่ซับซ้อนมีความสำคัญสูงสุด; DeepSeek V4.1 Flash น่าดึงดูดเมื่อให้ความสำคัญกับต้นทุนต่อโทเคน ความเร็วในการสร้าง หรือการโฮสต์ด้วยตนเอง การเปรียบเทียบนี้ใช้การอัปเดตของ DeepSeek วันที่ 17 ตุลาคม รุ่น Flash-1017
DeepSeek Flash-1017 มีราคาต่อโทเคนต่ำกว่า แต่ต้นทุนของงานที่เสร็จสมบูรณ์ยังขึ้นกับความยาวการให้เหตุผล การลองใหม่ และการเรียกใช้เครื่องมือ
การเปรียบเทียบด้านล่างครอบคลุมสถาปัตยกรรม คอนเท็กซ์ การให้เหตุผล การเขียนโค้ด วิชัน ความเร็ว การตั้งราคา และการปรับใช้ ราคาและหน้าประเมินแบบสดตรวจสอบ ณ วันที่ 28 ตุลาคม 2026
สาระสำคัญ
Terra นำในการเปรียบเทียบ Intelligence Index โดยอิสระที่อ้างอิง ทำให้เป็นผู้สมัครแรกที่มีเหตุผลสำหรับงานให้เหตุผลที่ต้องการ
DeepSeek มีราคาต่อโทเคนที่ต่ำกว่าตามรายการ เปรียบเทียบเวลาแฝงแบบครบวงจรและต้นทุนต่อหนึ่งงานที่สำเร็จ รวมถึงอัตราชั่วโมงพีค การใช้แคช โทเคนการให้เหตุผล และการลองใหม่
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ เผยแพร่เมื่อ Oct 30, 2026 อัปเดตล่าสุด Oct 30, 2026 ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
ประเมินการเขียนโค้ดด้วยแพตช์ที่ถูกยอมรับ และเวิร์กโฟลว์ภาพด้วยงานที่ทำเสร็จ คะแนนเบนช์มาร์กที่เผยแพร่ให้หลักฐานที่มีประโยชน์ แต่การตั้งค่าการทดสอบแตกต่างกัน
Terra เป็นโมเดลที่โฮสต์แบบ proprietary DeepSeek เสนอเวทน้ำหนักที่ดาวน์โหลดได้ภายใต้สัญญาอนุญาต MIT เพื่อการโฮสต์ด้วยตนเอง โดยต้องพิจารณาฮาร์ดแวร์และต้นทุนการดำเนินงาน
CometAPI มีอินเทอร์เฟซข้อความแบบแชร์สำหรับทดสอบทั้งสองโมเดล ตรวจสอบเวอร์ชันโมเดลที่ resolve แล้วและการรองรับเครื่องมือ การควบคุมการให้เหตุผล และเอาต์พุตแบบมีโครงสร้างก่อนนำไปใช้จริง
GPT-6.1 Terra vs DeepSeek V4.1 Flash: ภาพรวมและสเปก ความแตกต่างหลักของสเปกเกี่ยวกับขีดจำกัดเอาต์พุต การควบคุมการให้เหตุผล การเรียกใช้เครื่องมือ และการปรับใช้ ตารางด้านล่างสรุปทั้งสองโมเดล
สถาปัตยกรรมและพารามิเตอร์ สถาปัตยกรรม proprietary; จำนวนพารามิเตอร์ไม่เปิดเผย 552B Causal Encoder–Decoder MoE; ประมาณ 8B พารามิเตอร์ที่ทำงานสำหรับอินพุต และ 16B สำหรับเอาต์พุต หน้าต่างคอนเท็กซ์ 1,050,000 โทเคน 1M โทเคน เอาต์พุตสูงสุด 128,000 โทเคน 384K โทเคน โมดาลิตีอินพุต ข้อความ ภาพ ข้อความ ภาพ โมดาลิตีเอาต์พุต ข้อความ ข้อความ การควบคุมการให้เหตุผล none, low, medium, high, xhigh, max การสลับ thinking; low, high, max ใน Chat Completions การเรียกใช้เครื่องมือ รองรับผ่าน Responses API รองรับ; พฤติกรรมขึ้นกับเอ็นด์พอยต์และโหมด thinking เปิดเผยเวทน้ำหนัก ไม่ ใช่ สัญญาอนุญาต MIT
สถาปัตยกรรมและเวอร์ชันโมเดล Terra ใช้สถาปัตยกรรม proprietary โดยจำนวนพารามิเตอร์ไม่ถูกเปิดเผยสู่สาธารณะ DeepSeek-V4.1-Flash ใช้สถาปัตยกรรม Causal Encoder–Decoder แบบ MoE โดยมีงบประมาณพารามิเตอร์ที่ใช้งานต่างกันสำหรับการประมวลผลอินพุตและการสร้างเอาต์พุต
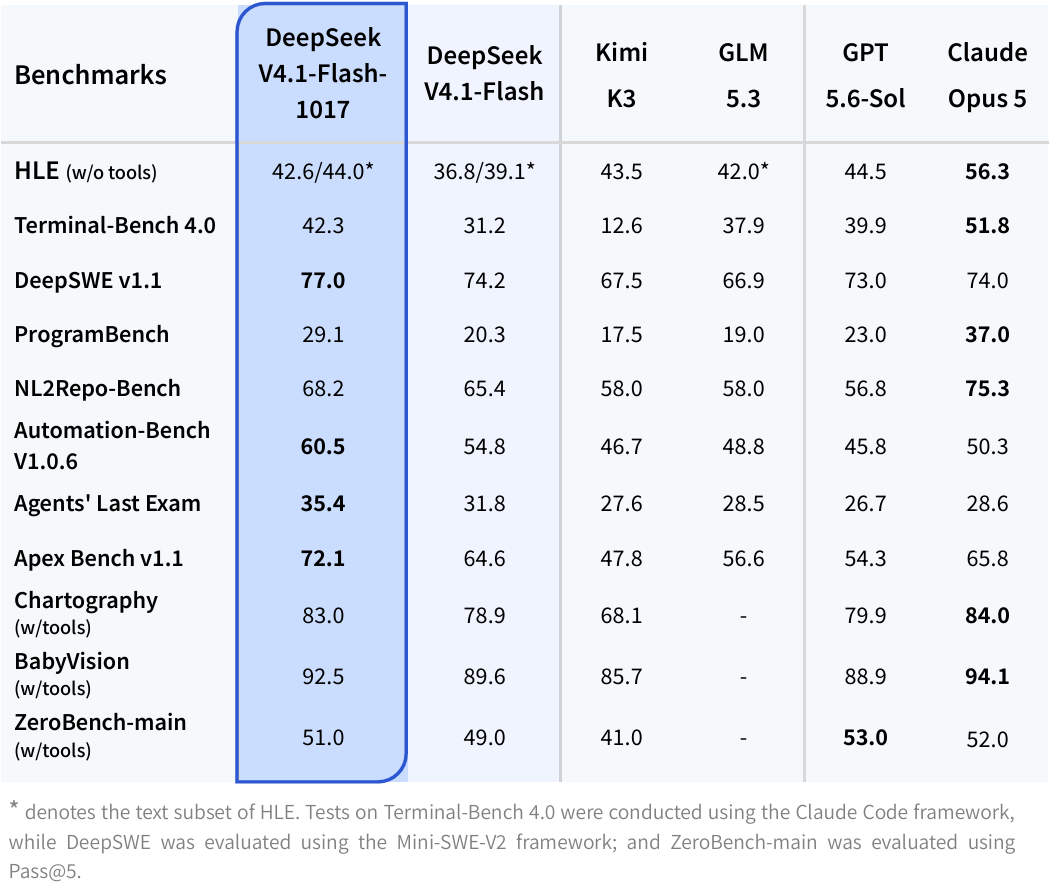
การเปิดตัว V4.1 Flash ของ DeepSeek อธิบายแบ็คโบน mixture-of-experts แบบ Causal Encoder–Decoder ขนาด 552B พารามิเตอร์ โดยมีประมาณ 8B พารามิเตอร์ทำงานระหว่างประมวลผลอินพุต และ 16B ระหว่างสร้างเอาต์พุต การอัปเดตวันที่ 17 ตุลาคมปรับปรุงผลลัพธ์ที่เผยแพร่ด้านการเขียนโค้ด เอเจนต์ และวิชัน
ตลอดบทความนี้ Flash-1017 หมายถึงเช็คพอยต์เดือนตุลาคม อาลิแอสทั่วไปของ API อาจชี้ไปยังเวอร์ชันอื่นในภายหลัง ดังนั้นบันทึกการประเมินควรรวมเวอร์ชันโมเดลที่ให้บริการจริง
ความต้องการ KV Cache และการปรับใช้ DeepSeek รายงานรอยเท้า KV-cache ทั่วโลกประมาณ 890 ไบต์ต่อโทเคน ประมาณหนึ่งในสี่ของ DeepSeek-V4-Flash ซึ่งช่วยปรับปรุงประสิทธิภาพแคช แม้ว่าเมื่อโฮสต์ด้วยตนเองยังต้องใช้ทรัพยากรจำนวนมากสำหรับเวทน้ำหนัก โมเดล Terra มีให้บริการผ่านผู้ให้บริการโฮสต์ ในขณะที่เวทน้ำหนักที่ดาวน์โหลดได้ของ DeepSeek ให้ตัวเลือกการโฮสต์ด้วยตนเองเพิ่มเติม
การควบคุมการให้เหตุผลและการเรียกใช้เครื่องมือ ทั้งสองโมเดลรองรับเวิร์กโฟลว์แบบเอเจนต์ แต่การควบคุมการให้เหตุผลและข้อกำหนดการเรียกใช้เครื่องมือต่างกัน เอกสาร การรองรับการเรียกใช้เครื่องมือของ Terra ใช้ Responses API การ์ดโมเดลของ DeepSeek อธิบายความพยายามในการให้เหตุผลเชิงตัวเลขจาก 1 ถึง 100; ควรตรวจสอบการควบคุม API ที่โฮสต์แยกต่างหาก เมื่อสลับโมเดล ให้ปรับพารามิเตอร์การให้เหตุผลและคำจำกัดความของเครื่องมือให้เหมาะกับเอ็นด์พอยต์ที่เลือก
GPT-6.1 Terra vs DeepSeek V4.1 Flash: ประสิทธิภาพ การเปรียบเทียบด้านล่างครอบคลุมการให้เหตุผล การเขียนโค้ด วิชัน และงานคอนเท็กซ์ยาว การประเมินโดยอิสระและเบนช์มาร์กที่ผู้จำหน่ายรายงานถูกระบุแยกกัน โดยแปลผลร่วมกับการกำหนดค่าโมเดลและกรอบเอเจนต์ของพวกเขา
การให้เหตุผลและความรู้ คะแนนรวมที่สูงกว่าของ Terra สนับสนุนการทดสอบมันก่อนสำหรับงานให้เหตุผลที่ต้องการ สำหรับเวิร์กโหลดที่แคบกว่า DeepSeek อาจยังเป็นตัวเลือกที่ดีกว่าหากทำความแม่นยำที่ต้องการได้ด้วยต้นทุนต่อหนึ่งงานที่สำเร็จต่ำกว่า
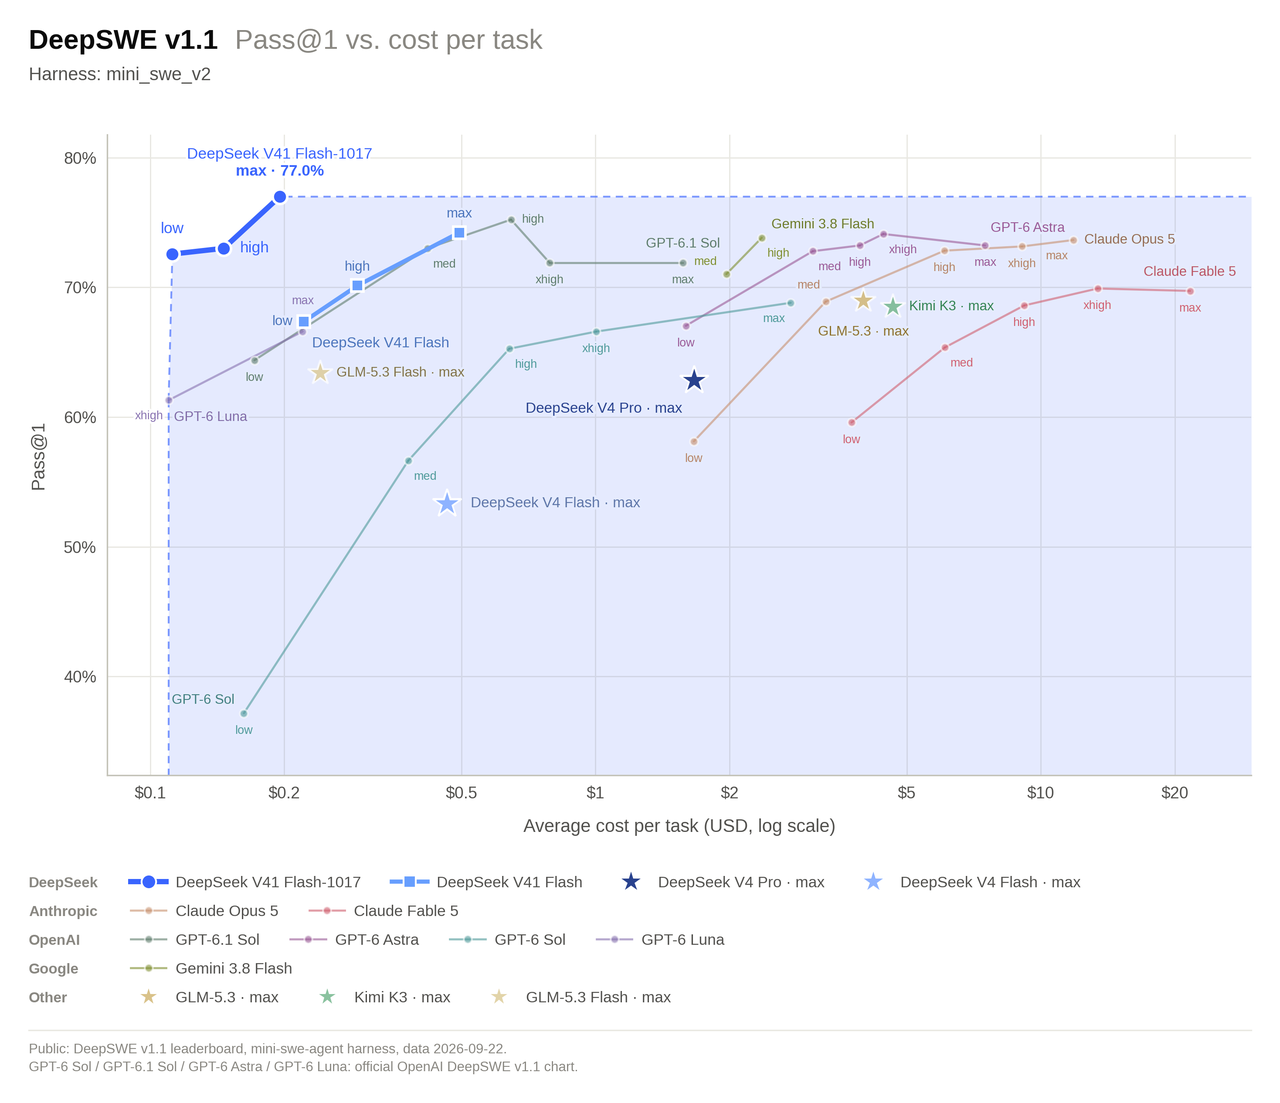
เบนช์มาร์กทางการด้านการเขียนโค้ดและเอเจนต์ Terminal-Bench 4.0 และ DeepSWE v1.1 ให้หลักฐานเกี่ยวกับประสิทธิภาพการเขียนโค้ดและเอเจนต์ เมื่อเปรียบเทียบผลลัพธ์ของผู้จำหน่าย ให้ระบุเวอร์ชันโมเดลที่แน่นอน การตั้งค่าการให้เหตุผล กรอบเอเจนต์ และเมตริกการให้คะแนน; ความแตกต่างในสิ่งเหล่านี้สามารถส่งผลอย่างมีนัยสำคัญต่อคะแนน
สำหรับงานเขียนโค้ดจริง เปรียบเทียบว่าแต่ละโมเดลผลิตแพตช์ที่ผ่านการทดสอบที่มีอยู่ รักษาอินเทอร์เฟซสาธารณะ จัดการกรณีขอบ และหลีกเลี่ยงการเปลี่ยนแปลงที่ไม่เกี่ยวข้องได้หรือไม่ ความน่าเชื่อถือในการเรียกใช้เครื่องมือและการฟื้นตัวจากข้อผิดพลาดระหว่างการรันก็มีผลต่อปริมาณงานที่เอเจนต์ทำได้เช่นกัน
ราคาต่อโทเคนที่ต่ำกว่าของ DeepSeek ทำให้มันเป็นผู้สมัครที่มีประโยชน์สำหรับการบำรุงรักษา repository แบบซ้ำๆ ที่มีเกณฑ์การยอมรับที่ชัดเจน สำหรับการเปลี่ยนแปลงที่ซับซ้อน เปรียบเทียบทั้งสองโมเดลในด้านแพตช์ที่ถูกยอมรับ ต้นทุนงานทั้งหมด และเวลาการแก้ไขโดยมนุษย์
วิชันและการใช้งานคอมพิวเตอร์ ทั้งสองโมเดลรับอินพุตภาพ แต่ความเข้าใจภาพและการโต้ตอบกับเดสก์ท็อปต้องใช้ความสามารถต่างกัน วัสดุการเปิดตัวของ OpenAI สำหรับ Terra พูดถึง MMMU-Pro และ OSWorld 2.1 ในขณะที่การ์ดโมเดลของ DeepSeek รายงานงานวิชันรวมถึง Chartography และ BabyVision พร้อมการตั้งค่าแบบใช้เครื่องมือช่วย
สำหรับการแยกข้อมูลจากเอกสาร ให้เปรียบเทียบความแม่นยำของฟิลด์ ข้อความที่ตกหล่น และโครงสร้างตาราง สำหรับระบบอัตโนมัติบนเดสก์ท็อป ให้เปรียบเทียบเวิร์กโฟลว์ที่ทำเสร็จ การกระทำที่ผิด และการฟื้นตัวหลังการเปลี่ยนแปลงอินเทอร์เฟซ โมเดลที่อธิบายภาพหน้าจอได้อย่างแม่นยำอาจยังคงมีปัญหาในการใช้งานแอปพลิเคชันที่แสดงอยู่
เลือกตามเวิร์กโฟลว์: ความแม่นยำในการแยกข้อมูลมีความสำคัญที่สุดสำหรับการประมวลผลเอกสาร ในขณะที่ความน่าเชื่อถือของการกระทำและการฟื้นตัวสำคัญกว่าสำหรับเอเจนต์ใช้งานคอมพิวเตอร์ เปรียบเทียบต้นทุนเฉพาะหลังจากทั้งสองโมเดลผ่านเกณฑ์คุณภาพที่ต้องการแล้ว
การให้เหตุผลคอนเท็กซ์ยาวและการค้นคืน ทั้งสองโมเดลรองรับเวิร์กโฟลว์เอกสารยาว แต่ความจุคอนเท็กซ์เพียงอย่างเดียวไม่ได้กำหนดคุณภาพการค้นคืน เปรียบเทียบพวกมันบนคอลเล็กชันเอกสารเดียวกัน โดยวางหลักฐานสำคัญไว้ใกล้ต้น กลาง และท้าย
ประเมินความแม่นยำของคำตอบ ตอนสนับสนุน ความสอดคล้องข้ามเอกสาร และความครบถ้วนของการตอบ สำหรับงานวิจัยและการวิเคราะห์เอกสาร ให้เลือกโมเดลที่ค้นคืนและเชื่อมโยงหลักฐานที่เกี่ยวข้องได้อย่างเชื่อถือภายในข้อกำหนดเรื่องเวลาแฝงและต้นทุนของคุณ
GPT-6.1 Terra vs DeepSeek V4.1 Flash: ความเร็ว
อัตราการสร้างเอาต์พุตและเวลาทำงานให้เสร็จ เวลาแฝงควรถูกพิจารณาแยกจากคุณภาพการให้เหตุผล
โมเดลที่สร้างโทเคนได้เร็วกว่าอาจยังใช้เวลานานกว่าจะเสร็จ หากมันผลิตการให้เหตุผลมากกว่า รอเครื่องมือ หรือลองใหม่ วัดเวลาถึงโทเคนแรก เวลาเสร็จสิ้นทั้งหมด และเวลาแฝงของงานที่ถูกยอมรับแยกกัน
เวลาแฝงแบบอินเทอร์แอคทีฟบนเส้นทาง API ของคุณ สำหรับผลิตภัณฑ์เชิงโต้ตอบ ทดสอบพรอมต์สั้นและยาวที่ concurrency สมจริง และบันทึกเวลาแฝงค่าเฉลี่ยและเปอร์เซ็นต์ที่ 95 เก็บภูมิภาค เส้นทาง API การแคชพรอมต์ การตั้งค่าการให้เหตุผล และนโยบายการลองใหม่ไว้ในผลลัพธ์ บันทึกนั้นจะให้ข้อมูลเกี่ยวกับประสบการณ์ผู้ใช้มากกว่าค่าความเร็วโทเคนต่อวินาทีเพียงตัวเลขเดียว
GPT-6.1 Terra vs DeepSeek V4.1 Flash: ต้นทุน การตั้งราคาเป็นหนึ่งในความแตกต่างที่ชัดเจนที่สุดระหว่างโมเดลเหล่านี้
ตารางอัตราของ Terra และนโยบายราคา DeepSeek ให้เรตรายแรกดังต่อไปนี้ ณ วันที่ 28 ตุลาคม 2026 ทั้งหมดเป็นดอลลาร์สหรัฐต่อหนึ่งล้านโทเคน
เรตราคา API ทางการ อินพุต, cache miss $1.00 $0.15 $0.30 อินพุต, cache hit $0.05 $0.003 $0.006 เอาต์พุต $5.00 $0.60 $1.20
ราคา peak ของ DeepSeek ใช้กับวันจันทร์–ศุกร์ เวลา 01:00–04:00 และ 06:00–10:00 UTC ยกเว้นวันหยุดราชการของจีน นั่นคือ 09:00–12:00 และ 14:00–18:00 ตามเวลา China Standard Time (UTC+8) ระยะเวลาอื่นใช้เรต off-peak
สำหรับคำขอ Terra ที่เกิน 272,000 โทเคนอินพุต OpenAI ระบุอัตราสองเท่าสำหรับอินพุตและอินพุตที่ถูกแคช และ 1.5 เท่าสำหรับเอาต์พุตสำหรับทั้งคำขอ เปรียบเทียบเงื่อนไขเหล่านั้นกับขนาดพรอมต์จริงของคุณก่อนที่จะถือว่าราคา base เป็นราคาที่มีผลจริง
อินพุตที่ไม่ถูกแคช $0.80 $0.12 เอาต์พุต $4.00 $0.48 อินพุตที่ถูกแคช ไม่ระบุแยกต่างหาก $0.0024 ตัวคูณตามเวลา ไม่ระบุในราคา base 2× ในช่วงหน้าต่าง peak ที่ระบุ
CometAPI ระบุหน้าต่าง peak ของ DeepSeek เป็นวันจันทร์–ศุกร์ เวลา 01:00–04:00 และ 06:00–10:00 UTC กำหนดการที่ระบุไม่ได้สร้างข้อยกเว้นวันหยุดแบบเดียวกับนโยบายทางการของ DeepSeek ตรวจสอบข้อกำหนดการเรียกเก็บเงินของเส้นทางที่เลือกสำหรับเวลาปฏิบัติการที่คุณตั้งใจใช้
ตัวอย่างต้นทุนแบบโทเคนคงที่ พิจารณาคำขอที่ใช้โทเคนอินพุตที่ไม่ถูกแคช 100,000 และสร้างโทเคนเอาต์พุต 10,000
หากตัวเลขเหล่านั้นคือยอดรวมโทเคนที่ถูกเรียกเก็บทั้งหมด ค่าธรรมเนียมโทเคนคือ $0.150 สำหรับ Terra, $0.021 สำหรับ DeepSeek ช่วง off-peak หรือ $0.042 สำหรับ DeepSeek ช่วง peak การลดลงช่วง off-peak คือ 86% ตัวอย่างนี้ไม่รวมค่าธรรมเนียมเครื่องมือเพิ่มเติม โครงสร้างพื้นฐาน และการลองใหม่; โทเคนการให้เหตุผลที่ถูกนับแยกต้องเข้าคำนวณด้วย
ที่เรตราคา base ที่ระบุของ CometAPI โทเคนอินพุต 100,000 และเอาต์พุต 10,000 เดียวกันมีต้นทุน $0.120 สำหรับ Terra หรือ $0.0168 สำหรับ Flash เมื่อใช้ตัวคูณช่วง peak 2× ตามที่ระบุ ต้นทุนสำหรับ Flash จะเป็น $0.0336 เหล่านี้เป็นการคำนวณเฉพาะโทเคนโดยใช้จำนวนที่ระบุ ไม่ใช่การวัดงานจริง
เมื่อเอาต์พุตส่วนเกินลบข้อได้เปรียบด้านราคาต่อโทเคน ตรึงอินพุตที่ไม่ถูกแคชไว้ที่ 100,000 โทเคน และเอาต์พุตที่ถูกเรียกเก็บของ Terra ที่ 10,000 โทเคน บิลโทเคนมาตรฐานของ Terra จึงเป็น $0.150 Flash จะไปถึงบิลเท่ากันที่เอาต์พุตที่ถูกเรียกเก็บ 225,000 โทเคนในช่วง off-peak หรือ 100,000 ในช่วง peak เลขคณิตนี้แยกปริมาณเอาต์พุต; การแคช อินพุตซ้ำ ค่าธรรมเนียมเครื่องมือ และการลองใหม่จะเปลี่ยนการเปรียบเทียบ
ต้นทุนต่อหนึ่งงานที่สำเร็จ ประเมินงานชุดตายตัวและหารค่าใช้จ่าย API และเครื่องมือทั้งหมดที่ถูกเรียกเก็บด้วยจำนวนงานที่ผ่านการตรวจรับ นับค่าใช้จ่ายในการพยายามที่ล้มเหลวด้วย รายงานอัตราสำเร็จควบคู่กับต้นทุนนี้เพื่อไม่ให้โมเดลได้รางวัลจากการทำให้เสร็จเฉพาะงานที่ง่ายที่สุด
ต้นทุนต่อหนึ่งงานที่สำเร็จ = ค่าใช้จ่าย API และเครื่องมือทั้งหมด / จำนวนงานที่สำเร็จ
คุณควรเลือกอะไร: GPT-6.1 Terra หรือ DeepSeek-V4.1-Flash? เลือกตามข้อกำหนดคุณภาพของงาน เป้าหมายต้นทุน และความต้องการในการปรับใช้ ใช้ผลเบนช์มาร์กด้านบนเพื่อตัดสินใจว่าควรทดสอบโมเดลใดก่อน
งานให้เหตุผลที่ต้องการ GPT-6.1 Terra ความแม่นยำและงานแก้ไขบนงานยากที่เป็นตัวแทน เอเจนต์เขียนโค้ด ทดสอบทั้งสอง แพตช์ที่ถูกยอมรับ การตรวจเช็คถดถอย ความล้มเหลวของเครื่องมือ และต้นทุนรวม เวิร์กโฟลว์ภาพที่ซับซ้อน GPT-6.1 Terra เวิร์กโฟลว์ที่ทำเสร็จและการฟื้นตัวจากข้อผิดพลาดอินเทอร์เฟซ การแยกข้อความหรือภาพปริมาณสูง DeepSeek Flash-1017 ความแม่นยำในการแยกถึงเกณฑ์ที่ต้องการหรือไม่ การค้นคืนเอกสารยาว ทดสอบทั้งสอง การค้นคืนหลักฐานและความแม่นยำคำตอบข้ามตำแหน่งอินพุต การโฮสต์ด้วยตนเอง DeepSeek Flash-1017 ฮาร์ดแวร์ที่มี ต้นทุนการดำเนินงาน และการควบคุมเวทน้ำหนัก แอปพลิเคชันเชิงโต้ตอบ ทดสอบทั้งสอง เวลาแฝงค่าเฉลี่ยและหางบนเส้นทางผู้ให้บริการที่เลือก
เมื่อควรเลือก GPT-6.1 Terra ให้ความสำคัญกับ Terra สำหรับการประเมินเมื่อการให้เหตุผลที่ซับซ้อนเป็นแกนกลางของงาน สำหรับเวิร์กโฟลว์ภาพหรือการใช้งานคอมพิวเตอร์ที่ต้องการ ให้รวมมันในชุดทดสอบและวัดงานที่ทำเสร็จ ข้อผิดพลาด และการฟื้นตัว
คำถามสำคัญคือ Terra ลดความพยายามที่ล้มเหลวและการแก้ไขด้วยมือได้มากพอที่จะคุ้มค่ากับราคาต่อโทเคนที่สูงกว่าหรือไม่
เมื่อควรเลือก DeepSeek-V4.1-Flash เริ่มด้วย DeepSeek-V4.1-Flash สำหรับงานซ้ำๆ ปริมาณสูงที่มีเกณฑ์การยอมรับชัดเจนและเป้าหมายต้นทุนแน่น เลือกมันหากเอาต์พุตตรงตามข้อกำหนดคุณภาพด้วยต้นทุนต่อหนึ่งงานที่สำเร็จต่ำกว่า
เวทน้ำหนักภายใต้สัญญาอนุญาต MIT ของ DeepSeek ยังทำให้มันเป็นตัวเลือกที่เกี่ยวข้องเมื่อการโฮสต์ด้วยตนเองเป็นข้อกำหนด รวมต้นทุนฮาร์ดแวร์และการดำเนินงานในการตัดสินใจนั้นด้วย
เมื่อควรทดสอบทั้งสองโมเดล ทดสอบทั้งสองเมื่อคุณภาพการเขียนโค้ด ความน่าเชื่อถือของเครื่องมือ เวลาแฝง หรือความแม่นยำคอนเท็กซ์ยาวมีความสำคัญ ใช้งานที่เป็นตัวแทนที่มีอินพุตเดียวกัน เครื่องมือเดียวกัน ข้อจำกัดการรันเดียวกัน และเกณฑ์การยอมรับเดียวกัน
เปรียบเทียบอัตราสำเร็จ ต้นทุนรวมต่อหนึ่งงานที่สำเร็จ เวลาแฝงแบบ end-to-end และเวลาการแก้ไขโดยมนุษย์ บันทึกเวอร์ชันโมเดลและการตั้งค่าการให้เหตุผลเพื่อให้ผลลัพธ์ทำซ้ำได้
การตั้งค่าแบบไฮบริดสามารถเริ่มงานประจำด้วย DeepSeek และส่งงานที่ล้มเหลวที่คัดเลือกไปยัง Terra วัดต้นทุนและอัตราการทำเสร็จของเวิร์กโฟลว์ทั้งหมดเพื่อยืนยันว่าการเรียกโมเดลเพิ่มเติมนั้นคุ้มค่าหรือไม่
เข้าถึง GPT-6.1 Terra และ DeepSeek V4.1 Flash ได้ที่ไหน? ใช้ API ที่โฮสต์ของ OpenAI สำหรับ Terra หรือ API ที่โฮสต์ของ DeepSeek สำหรับ Flash ยืนยันตัวระบุโมเดลปัจจุบัน ขีดจำกัดบัญชี และเอ็นด์พอยต์ที่รองรับก่อนการผสานรวม เวทน้ำหนักที่ดาวน์โหลดได้ของ Flash-1017 ให้ตัวเลือกการโฮสต์ด้วยตนเองแยกต่างหาก
CometAPI จัดเตรียมอินเทอร์เฟซแบบเข้ากันได้กับ OpenAI ที่ช่วยทำให้ง่ายต่อการพัฒนาแอปพลิเคชันหลายโมเดล
เพื่อทดลองทั้งสองโมเดลผ่านไคลเอนต์ข้อความเดียว ใช้ OpenAI Python SDK กับคีย์ CometAPI ของคุณและเอ็นด์พอยต์ https://api.cometapi.com/v1 เก็บคีย์ไว้ในตัวแปรสภาพแวดล้อม แล้วส่งพรอมต์เดียวกันไปยังเส้นทาง gpt-6.1-terra และ deepseek-v4.1-flash และเปรียบเทียบคำตอบที่ส่งกลับและการใช้โทเคน
ตัวอย่างเช่น ขอให้แต่ละโมเดลรีวิวเวิร์กโฟลว์การชำระเงินที่ลองใหม่คำขอที่หมดเวลาโดยไม่มี idempotency key และบันทึกร่างคำขอเต็ม เปรียบเทียบว่าคำตอบระบุความเสี่ยงด้านความน่าเชื่อถือและความเป็นส่วนตัวได้ชัดเจนเพียงใด และอธิบายวิธีแก้ปฏิบัติได้ดีเพียงใด พรอมต์ร่วมกันทำให้คำตอบตรวจสอบได้ง่ายขึ้น แต่คำขอข้อความค่าเริ่มต้นไม่ได้ทำให้บัดเจ็ตการให้เหตุผลเท่ากันหรือสร้างอันดับประสิทธิภาพ ยืนยันเช็คพอยต์ที่ให้บริการโดยแต่ละเส้นทางก่อนที่จะถือผลลัพธ์ว่าเป็นหลักฐานเกี่ยวกับ Flash-1017
บทสรุป GPT-6.1 Terra ให้ผลรวมการให้เหตุผลที่แข็งแกร่งกว่าในปัจจุบัน ในขณะที่ DeepSeek Flash-1017 ผสานราคาต่อโทเคนที่ต่ำกว่า ความเร็วการสร้างเอาต์พุตที่วัดได้เร็วกว่า และการปรับใช้แบบเวทน้ำหนักเปิด ทางเลือกที่มีประโยชน์คือโมเดลที่ตรงตามข้อกำหนดคุณภาพและเวลาแฝงของคุณด้วยต้นทุนรวมต่ำสุด
เริ่มด้วยเวิร์กโหลดที่เป็นตัวแทน คงสภาพแวดล้อมเครื่องมือและเกณฑ์การยอมรับไว้ให้คงที่ และเปรียบเทียบต้นทุนของงานที่ทำเสร็จสำเร็จ การผสานรวมข้อความร่วมกันผ่าน CometAPI สามารถทำให้การประเมินนั้นง่ายขึ้น ในขณะที่ฟีเจอร์เฉพาะโมเดลยังต้องการการกำหนดค่าเฉพาะของตนเอง
FAQ
ทำไมงานเดียวกันจึงอาจมีบิลโทเคนต่างกันระหว่าง Terra และ Flash-1017? พรอมต์ข้อความไม่ได้กลายเป็นจำนวนโทเคนเท่ากันเสมอในสองโมเดล คำตอบที่สร้างและความยาวการให้เหตุผลก็อาจแตกต่างกันด้วย เปรียบเทียบการใช้งานที่รายงานโดยแต่ละเส้นทางสำหรับงานที่เหมือนกัน รวมถึงโทเคนการให้เหตุผลที่ถูกแคชและที่ถูกเรียกเก็บเมื่อมีรายงาน แทนที่จะใช้รายการราคาเดียวกันกับจำนวนโทเคนที่ประมาณร่วมกัน
GPT-6.1 Terra และ DeepSeek V4.1 Flash ใช้แคชพรอมต์ร่วมกันได้ไหม? คุณสามารถนำข้อความพรอมต์กลับมาใช้ในแอปพลิเคชันของคุณได้ แต่ไม่ควรถือว่าแคชที่สร้างสำหรับโมเดลหรือผู้ให้บริการหนึ่งรายลดบิลของอีกราย การเข้าเกณฑ์แคชและการบัญชีเป็นเรื่องเฉพาะเส้นทาง ตรวจสอบฟิลด์การใช้งานของแต่ละคำตอบและทดสอบคำขอที่ซ้ำก่อนที่จะรวมการประหยัดไว้ในการคาดการณ์
ควรตรวจสอบเอาต์พุตแบบมีโครงสร้างจาก Terra และ Flash-1017 อย่างไร? กำหนดฟิลด์และชนิดข้อมูลที่ต้องการในแอปพลิเคชันของคุณก่อนเลือกโมเดล หากเส้นทางเสนอเอาต์พุต JSON หรือโหมดที่จำกัดตามสคีมา ให้ตรวจสอบโหมดที่รองรับอย่างแม่นยำ จากนั้นพาร์สคำตอบและตรวจสอบความถูกต้องตามสคีมาของคุณ จัดประเภทฟิลด์ที่หาย ค่าที่ไม่ถูกต้อง เอาต์พุตที่ถูกตัดทอน และการปฏิเสธเป็นผลลัพธ์ที่แยกต่างหาก JSON ที่ถูกต้องเพียงอย่างเดียวไม่ได้ยืนยันว่าข้อเท็จจริงที่แยกออกมาถูกต้อง