Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Grok Voice 3.0 คืออะไร และใช้งานอย่างไร? ai-model / งานวิจัย CometAPI
Grok Voice 3.0 คืออะไร และใช้งานอย่างไร? เชื่อมต่อกับ Grok Voice 3.0 ด้วย Python, สร้างคำตอบแบบเสียงพูด, ส่งข้อมูลเสียง, เพิ่มเครื่องมือ และแก้ไขปัญหาที่พบบ่อยของ Realtime API
Deon Goodwin ทีมวิจัยโมเดล AI และ API เชื่อมต่อกับ Grok Voice 3.0 ด้วย Python, สร้างคำตอบแบบเสียงพูด, ส่งข้อมูลเสียง, เพิ่มเครื่องมือ และแก้ไขปัญหาที่พบบ่อยของ Realtime API
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)สรุปสั้นๆ
Grok Voice 3.0 คือโมเดลแปลงเสียงพูดเป็นเสียงพูดแบบเรียลไทม์ของ xAI เปิดตัวเมื่อวันที่ 14 ตุลาคม 2026 ชื่อโมเดลสำหรับ API คือ grok-voice-3.0; ณ วันที่ 3 พฤศจิกายน 2026, grok-voice-latest points to this version
ประเด็นสำคัญ
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
Grok Voice 3.0 แลกเปลี่ยนเสียงและข้อความแบบเรียลไทม์
การทดสอบแรกอาจเป็นรอบเดียวแบบข้อความเป็นเสียง การเล่นคำตอบได้ยืนยันว่า การยืนยันตัวตนและการสร้างเสียงทำงาน ก่อนคุณจะเพิ่มไมโครโฟน
อินพุตเสียงต้องใช้รูปแบบที่ตรงกันและมีขอบเขตเทิร์นที่ชัดเจน แอปของคุณสามารถส่งเสียง PCM ที่อัดไว้พร้อมการปิดเทิร์นแบบแมนนวล หรือสตรีมเสียงไมโครโฟนพร้อมการตรวจจับเสียงฝั่งเซิร์ฟเวอร์
แอปพลิเคชันของคุณควบคุมการดำเนินการทางธุรกิจ ตรวจสอบอาร์กิวเมนต์ของฟังก์ชันและสิทธิ์ของผู้ใช้ ดำเนินการที่อนุมัติแล้ว และส่งคืนผลลัพธ์เพื่อให้เอเจนต์เสียงสนทนาต่อได้
ไคลเอนต์บนเบราว์เซอร์และมือถือใช้ข้อมูลรับรองแบบอายุสั้น เซิร์ฟเวอร์ของคุณเก็บคีย์ API ถาวร และออกโทเค็นชั่วคราวสำหรับการเชื่อมต่อของไคลเอนต์
Grok Voice 3.0 คืออะไร? Grok Voice 3.0 เป็นโมเดลสนทนาแบบเรียลไทม์ด้วยเสียงที่พัฒนาโดย xAI ภายใต้แบรนด์ SpaceX Super Intelligence รองรับอินพุตแบบเสียงพูดหรือข้อความ และสามารถส่งคืนเสียงและข้อความภายในเซสชันที่ดำเนินอยู่ โมเดลนี้ปรับให้เหมาะกับกรณีใช้งานเอเจนต์เสียง มากกว่าการเป็นตัวแทนแทนที่โดยตรงของโมเดล Grok แบบข้อความทั่วไป
ผู้ช่วยเสียงแบบเดิมมักเชื่อมต่อการรู้จำเสียง โมเดลภาษาธรรมชาติ และการสังเคราะห์เสียงเป็นสายโซ่ ในทางกลับกัน Grok Voice เปิดเผยเซสชันแบบเสียง-ต่อ-เสียงที่บูรณาการพฤติกรรมการสนทนาและรองรับเครื่องมือ สถาปัตยกรรมนี้ช่วยให้เลเยอร์ orchestration ของนักพัฒนาง่ายขึ้น แม้ว่าแอปพลิเคชันยังคงต้องมีการจับเสียง การส่งผ่าน การอนุญาต การผสานระบบธุรกิจ และการมอนิเตอร์
คำจำกัดความโมเดล Grok Voice 3.0 ระบุว่า ข้อความและเสียงเป็นสื่ออินพุตและเอาต์พุต สำหรับบทแนะนำนี้ จุดตรวจที่มีประโยชน์จุดแรกคือคำตอบที่เล่นได้จากสคริปต์ Python ฝั่งเซิร์ฟเวอร์
คุณลักษณะและความสามารถหลักของ Grok Voice 3.0
สนทนาแบบสด: แลกเปลี่ยนเสียงและข้อความผ่าน WebSocket ตลอดทั้งเซสชันรองรับการขัดจังหวะ: ใช้การตรวจจับเสียงฝั่งเซิร์ฟเวอร์และหยุดการเล่นคิวเมื่อผู้โทรเริ่มพูดใช้เครื่องมือทางธุรกิจ: เชื่อมต่อฟังก์ชันของคุณเองสำหรับงานอย่างการค้นหาคำสั่งซื้อและการนัดหมาย
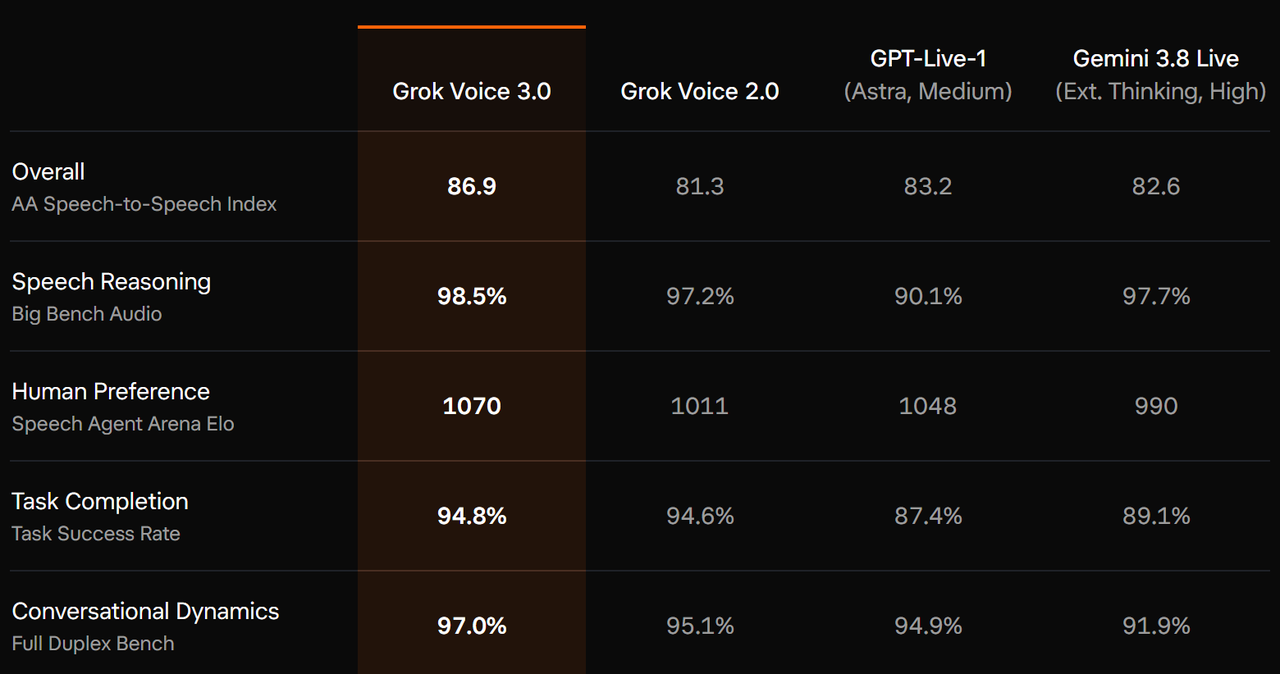
ผลการทดสอบ Benchmark ของ Grok Voice 3.0 ผลลัพธ์เหล่านี้เป็นผลการทดสอบที่เผยแพร่ ไม่ใช่การรับประกันสำหรับการใช้งานจริงของคุณ ทดสอบสำเนียง สภาพเสียงรบกวน เครื่องมือ และเส้นทางการส่งต่อของคุณเองก่อนนำเอเจนต์ไปใช้กับลูกค้า
ต้องเตรียมอะไรบ้างก่อนเรียกใช้ Grok Voice 3.0 API? สร้างหรือเข้าสู่บัญชีใน xAI Console , สร้างคีย์ API และตรวจสอบว่าบัญชีของคุณมีสิทธิ์เข้าถึงและเครดิตการใช้งานเพียงพอ ใช้เทอร์มินัลภายในเครื่องหรือเซิร์ฟเวอร์ที่เชื่อถือได้สำหรับตัวอย่าง Python
Python 3.11 ขึ้นไป และมี pip ในสภาพแวดล้อมเดียวกัน
คีย์ xAI API ที่ถูกต้อง จัดเก็บเป็น XAI_API_KEY
การเชื่อมต่อเครือข่ายที่อนุญาตการเชื่อมต่อ WebSocket แบบปลอดภัยออกสู่ภายนอก
โปรแกรมเล่นสื่อเพื่อเปิดไฟล์ WAV ที่สร้างขึ้น
สร้างคีย์ใน xAI Console จัดเก็บไว้ในตัวแปรสภาพแวดล้อมแทนการเขียนฝังในแอปพลิเคชัน
ตั้งค่า API key สำหรับเทอร์มินัล Bash ปัจจุบัน
export XAI_API_KEY="your_xai_api_key"
ตั้งค่า API key สำหรับเซสชัน PowerShell ปัจจุบัน
$env:XAI_API_KEY="your_xai_api_key"
ติดตั้ง WebSocket client ในสภาพแวดล้อม Python ของคุณ
python -m pip install "websockets>=14,<18"
รันคำสั่งที่เหลือในเซสชันเทอร์มินัลเดียวกัน หากคุณใช้ virtual environment ให้เปิดใช้งานก่อนติดตั้งแพ็กเกจ
วิธีใช้ Grok Voice 3.0 API ด้วย Python Realtime API แบบเนทีฟใช้การเชื่อมต่อผ่าน WebSocket ต่างจากการสนทนาแบบข้อความธรรมดา ตรงที่มันแลกเปลี่ยนอีเวนต์ของเซสชันอย่างต่อเนื่องและสตรีมชิ้นเสียงระหว่างที่การสนทนาดำเนินอยู่
ขั้นตอนที่ 1: เลือกโมเดลแบบกำหนดเวอร์ชันคงที่และกำหนดค่าเซสชัน API ยอมรับชื่อโมเดลแบบกำหนดเวอร์ชันใน WebSocket URL ตัวอย่างใช้ grok-voice-3.0 เพื่อระบุเวอร์ชันอย่างชัดเจน อีเวนต์ session.update จะตั้งค่าเสียง รูปแบบเสียง และการจัดการเทิร์นแบบแมนนวล; รอ session.updated ก่อนส่งพรอมป์
ขั้นตอนที่ 2: ส่งข้อความและรับคำตอบแบบเสียงพูด บันทึกสคริปต์ต่อไปนี้เป็น grok_voice_demo.py สคริปต์จะส่งพรอมต์ข้อความหนึ่งรายการ รวบรวมชิ้นเสียงที่เข้ารหัส base64 และเขียนเป็นไฟล์ WAV โมโน 24 kHz PCM 16 บิต สคริปต์จะหยุดเมื่อเกิดข้อผิดพลาดจาก API การสำเร็จไม่ผ่าน หรือคำตอบไม่สร้างเสียง
สร้างคำตอบเสียงจากพรอมต์ข้อความหนึ่งครั้งและบันทึกเป็นไฟล์ WAV
import asyncio, base64, json, os, wave
import websockets

SAMPLE_RATE = 24000

async def receive_event(ws):
    event = json.loads(await asyncio.wait_for(ws.recv(), 60))
    if event.get("type") == "error":
        raise RuntimeError(event)
    return event

async def main():
    url = "wss://api.x.ai/v1/realtime?model=grok-voice-3.0"
    headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"}
    async with websockets.connect(url, additional_headers=headers) as ws:
        await ws.send(json.dumps({"type": "session.update", "session": {
            "voice": "eve", "turn_detection": {"type": None},
            "audio": {
                "input": {"format": {"type": "audio/pcm", "rate": SAMPLE_RATE}},
                "output": {"format": {"type": "audio/pcm", "rate": SAMPLE_RATE},
                           "transport": "json"}}}}))
        async with asyncio.timeout(30):
            while (await receive_event(ws)).get("type") != "session.updated":
                pass
        await ws.send(json.dumps({"type": "conversation.item.create", "item": {
            "type": "message", "role": "user",
            "content": [{"type": "input_text", "text": "Explain Grok Voice 3.0 briefly."}]}}))
        await ws.send(json.dumps({"type": "response.create"}))
        chunks = []
        async with asyncio.timeout(120):
            while True:
                event = await receive_event(ws)
                if event["type"] in ("response.output_audio.delta", "response.audio.delta"):
                    chunks.append(base64.b64decode(event["delta"]))
                elif event["type"] == "response.done":
                    if event.get("response", {}).get("status") != "completed":
                        raise RuntimeError(event)
                    break
    if not chunks:
        raise RuntimeError("The response contained no audio.")
    with wave.open("grok_response.wav", "wb") as wav:
        wav.setparams((1, 2, SAMPLE_RATE, 0, "NONE", "not compressed"))
        wav.writeframes(b"".join(chunks))
    print("Saved grok_response.wav")

asyncio.run(main())
ขั้นตอนที่ 3: รันสคริปต์และตรวจสอบผลลัพธ์ รันตัวอย่างเสียงด้วย Python
python grok_voice_demo.py
หลังคำตอบสำเร็จ เทอร์มินัลจะแสดงข้อความ Saved grok_response.wav เปิดไฟล์นั้นด้วยโปรแกรมเล่นสื่อและตรวจสอบว่าคุณได้ยินคำตอบที่สมบูรณ์ในความเร็วปกติ หากไฟล์หายไปหรือเล่นไม่ได้ ให้ตรวจสอบอีเวนต์ที่ส่งกลับและการตั้งค่าเสียงก่อนเพิ่มคุณสมบัติอื่น
เอกสารอ้างอิงอีเวนต์แบบเรียลไทม์อธิบายการยืนยันเซสชันและลำดับขั้นการตอบกลับที่ใช้ที่นี่ สคริปต์จะรอครบทั้งเทิร์นก่อนเขียนไฟล์; แอปสนทนาแบบโต้ตอบควรเล่นชิ้นเสียงทันทีที่ได้รับ
จะส่งเสียงเข้า Grok Voice 3.0 ได้อย่างไร?
เสียงที่อัดไว้พร้อมการปิดเทิร์นแบบแมนนวล ตัวอย่างนี้ใช้ไฟล์ WAV โมโน 24 kHz PCM 16 บิต Grok Voice 3.0 ยังรองรับอัตราตัวอย่าง PCM อื่นๆ, μ-law, A-law และ Opus รูปแบบจริงต้องตรงกับการกำหนดค่าใน session.update ให้แทนที่เฉพาะบล็อก conversation.item.create ในสคริปต์ก่อนหน้าด้วยโค้ดด้านล่าง คงคำสั่ง response.create ถัดไปและลูปรับข้อความที่มีอยู่เดิมไว้
แทนที่บล็อกข้อความด้วยการอัปโหลดเสียงที่อัดไว้ภายใน main()
with wave.open("request.wav", "rb") as source:
    if (
        source.getnchannels() != 1
        or source.getsampwidth() != 2
        or source.getframerate() != SAMPLE_RATE
        or source.getcomptype() != "NONE"
    ):
        raise ValueError("Use mono, 24 kHz, 16-bit PCM WAV audio.")
    pcm = source.readframes(source.getnframes())

if len(pcm) < SAMPLE_RATE * 2 // 10:
    raise ValueError("Use a spoken recording longer than 100 ms.")

for offset in range(0, len(pcm), 4800):
    await ws.send(json.dumps({
        "type": "input_audio_buffer.append",
        "audio": base64.b64encode(pcm[offset:offset + 4800]).decode("ascii"),
    }))
await ws.send(json.dumps({"type": "input_audio_buffer.commit"}))
while (await receive_event(ws)).get("type") != "input_audio_buffer.committed":
    pass
จัดย่อหน้าแทนที่นี้ให้อยู่ระดับเดียวกับบล็อกข้อความเดิมภายในบริบท WebSocket โค้ดจะส่งตัวอย่าง PCM ดิบจากไฟล์ WAV ไม่ใช่ส่วนหัวของคอนเทนเนอร์ WAV สคริปต์แรกเลือกการจัดการเทิร์นแบบแมนนวลอย่างชัดเจน ดังนั้นการ commit บัฟเฟอร์และการร้องขอคำตอบจึงเป็นการกระทำแยกกัน
จับเสียงจากไมโครโฟนแบบสดและเล่นกลับทันที สำหรับการสนทนาแบบโต้ตอบ ให้จับเสียงอย่างต่อเนื่อง แปลงสู่รูปแบบอินพุตที่กำหนด และส่งชิ้นเล็กๆ ในขณะที่ลูปรับแยกกันจัดการคำตอบ เลือก server_vad สำหรับการตรวจจับเทิร์นอัตโนมัติแทนโหมดแมนนวลที่ใช้ในตัวอย่างไฟล์ที่อัดไว้ หลีกเลี่ยงการส่ง response.create ตัวที่สองเมื่อเซิร์ฟเวอร์กำลังสร้างคำตอบอยู่แล้ว
เมื่อเกิดการขัดจังหวะ ให้หยุดการเล่นเสียงของผู้ช่วยที่คิวไว้ทันที การยกเลิกผ่านเครือข่ายเพียงอย่างเดียวไม่ลบเสียงที่บัฟเฟอร์ไว้โดยแอปของคุณ รักษาคิวการเล่นให้มีขนาดเล็กและติดตามว่า ผู้ฟังได้ยินเสียงไปแล้วเท่าไร เพื่อให้แอปของคุณคงสถานะการสนทนาให้สอดคล้องกัน
วิธีเพิ่มเครื่องมือให้เอเจนต์ Grok Voice 3.0 แอปพลิเคชันสามารถเปิดเผยเครื่องมือต่างๆ เช่น การค้นหาคำสั่งซื้อ การนัดหมาย หรือการยืนยันบัญชี เอเจนต์สามารถตีความคำขอที่ซับซ้อนแบบพูด เรียกใช้ฟังก์ชันที่ได้รับอนุญาต และใช้ผลลัพธ์เพื่อสนทนาต่อได้ ซึ่งมีประโยชน์อย่างยิ่งเมื่อมีคำขอเปลี่ยนแปลงหลายอย่างในการโทรครั้งเดียว
API รองรับฟังก์ชันแบบกำหนดเองและเครื่องมือที่บริหารโดยเซิร์ฟเวอร์ สำหรับฟังก์ชันแบบกำหนดเอง แอปของคุณเป็นผู้ดำเนินการจริง; การนิยามเครื่องมือไม่ได้เชื่อมโมเดลเข้ากับฐานข้อมูลของคุณโดยอัตโนมัติ
ประกาศชื่อฟังก์ชัน คำอธิบาย และสคีมาของอาร์กิวเมนต์ JSON ใน session.tools
จัดการ response.function_call_arguments.done แยกวิเคราะห์อาร์กิวเมนต์ และตรวจสอบสิทธิ์ของผู้โทรก่อนดำเนินการฟังก์ชัน
ส่งคืนผลลัพธ์เป็นอีเวนต์ conversation.item.create โดยตั้งค่า item.type เป็น function_call_output และระบุ call_id ที่สอดคล้องกัน
ส่ง response.create หลังจากส่งผลลัพธ์ของฟังก์ชันที่ต้องการครบแล้ว หากมีหลายคำขอเรียกมาพร้อมกัน ให้ส่งคืนผลลัพธ์ทั้งหมดก่อนขอให้โมเดลดำเนินการต่อ
เริ่มจากเครื่องมือแบบอ่านอย่างเดียว เช่น การตรวจสอบสถานะการจัดส่งของคำสั่งซื้อ สำหรับการกระทำที่เปลี่ยนการจอง คืนเงิน หรือสั่งซื้อ ให้บังคับใช้การยืนยันตัวตน การยืนยันความตั้งใจ และการป้องกันคำขอซ้ำในแอปพลิเคชัน
การใช้ Grok Voice 3.0 บนเบราว์เซอร์และแอปมือถือ ใช้ข้อมูลรับรองแบบชั่วคราวสำหรับการเชื่อมต่อฝั่งไคลเอนต์ เซิร์ฟเวอร์ของคุณร้องขอโทเค็นอายุสั้นด้วยคีย์ API ถาวร และส่งต่อโทเค็นไปยังไคลเอนต์ ตรวจสอบสิทธิ์คำขอไปยังเอ็นด์พอยต์โทเค็นของคุณเองและกำหนดขีดจำกัดการใช้งานเพื่อไม่ให้กลายเป็นเกตเวย์แบบไม่จำกัด
แสดงความยินยอมการใช้ไมโครโฟน ตัวควบคุมการบันทึก และสถานะการเชื่อมต่ออย่างชัดเจนในอินเทอร์เฟซ จัดการเหตุการณ์การหลุดการเชื่อมต่ออย่างชัดเจน: หยุดการเล่นที่ค้างอยู่ แจ้งผู้ใช้ว่าการเชื่อมต่อกำลังกู้คืน และหลีกเลี่ยงการเล่นซ้ำการกระทำที่อาจดำเนินการเสร็จแล้ว
วิธีแก้ปัญหาข้อผิดพลาดทั่วไปของ Grok Voice 3.0 API
การยืนยันตัวตนล้มเหลว: ยืนยันว่า XAI_API_KEY ถูกตั้งค่าในเทอร์มินัลที่รันสคริปต์และคีย์ดังกล่าวอยู่ในบัญชีที่มีสิทธิ์เข้าถึง ห้ามวางคีย์ลงในบันทึกหรือข้อความสนับสนุนอาร์กิวเมนต์ของไลบรารีไคลเอนต์ไม่คาดคิด: ตรวจสอบว่า pip ติดตั้งเวอร์ชัน websockets ที่ร้องขอไว้ในสภาพแวดล้อม Python ที่ใช้รันสคริปต์ไม่มีเสียงเอาต์พุต: ตรวจสอบอีเวนต์ error และ response.done ยืนยันว่า session.updated ยอมรับการกำหนดค่าแล้ว และตรวจสอบว่ามีการร้องขอคำตอบสำหรับโหมดเทิร์นแบบแมนนวลการเล่นกลับผิดเพี้ยน: เปรียบเทียบไบต์จริงกับโค้ดेक อัตราตัวอย่าง จำนวนแชนเนล และส่วนหัว WAV ที่กำหนดค่าไว้ การเปลี่ยนชื่อไฟล์ MP3 เป็น WAV ไม่ใช่การแปลงไฟล์หมดเวลา (Timeout): ตรวจสอบการเข้าถึงเครือข่ายและสถานะบริการ จากนั้นตรวจสอบอีเวนต์สุดท้ายที่สำเร็จ ลองเชื่อมต่อใหม่แยกจากการดำเนินการทางธุรกิจใดๆ ที่อาจดำเนินไปแล้ว
ควรตั้งงบประมาณเท่าไรสำหรับการเรียกใช้ Grok Voice 3.0 API? การใช้งานเสียงและการผสานรวมแบบกำหนดเองอาจมีค่าบริการแยกกัน สำหรับบทแนะนำนี้ อัตราที่เกี่ยวข้องคือค่าเซสชันแบบเรียลไทม์และอินพุตข้อความ; บริการถอดเสียงและสร้างเสียงแบบเดี่ยวเป็นคนละบริการ
เซสชันเสียง-ต่อ-เสียง: $0.08 ต่อนาที คิดเป็น $4.80 ต่อชั่วโมงอินพุตข้อความระหว่างเซสชันเสียง: $0.004 ต่ออินพุตข้อความ ตัวอย่างเช่น 500 นาทีเซสชันที่คิดค่าบริการ คิดเป็นค่าใช้จ่ายเสียงพื้นฐาน $40 การประเมินนี้ไม่รวมอินพุตข้อความ เครื่องมือเสริม โทรคมนาคม และโครงสร้างพื้นฐานของคุณ เริ่มด้วยเซสชันสั้นๆ และปิดการเชื่อมต่อที่ว่างเมื่อการสนทนาสิ้นสุด
บทสรุป เริ่มจากเทิร์น Grok Voice 3.0 API ที่สมบูรณ์หนึ่งครั้ง: เชื่อมต่อ กำหนดค่าเซสชัน ส่งพรอมต์ รับเสียง และเล่นผลลัพธ์ เมื่อเส้นทางนี้ทำงานแล้ว จึงเพิ่มเสียงที่อัดไว้ จากนั้นสร้างการจับเสียงจากไมโครโฟนและสตรีมการเล่นกลับ ลงมือเพิ่มเครื่องมือทางธุรกิจหลังจากที่เส้นทางการสนทนาและการจัดการข้อผิดพลาดมีความน่าเชื่อถือแล้ว