
TL;DR
DeepSeek-V4.1-Flash เป็นโมเดลแบบ open-weight และสามารถโฮสต์เองได้ แต่ “local” ไม่ได้หมายความว่า “รันบนพีซีสำหรับเล่นเกม” DeepSeek อธิบายว่าเป็นโครงหลัก Mixture-of-Experts ขนาด 552B พารามิเตอร์ โดยใช้สถาปัตยกรรม Causal Encoder-Decoder ซึ่งมีพารามิเตอร์ที่ทำงานจริงเพียง 8B ระหว่างการประมวลผลพรอมต์ และ 16B ระหว่างการสร้างข้อความ ทั้งนี้ตัวโมเดลเต็มยังคงเป็นเป้าหมายการปรับใช้ระดับแนวหน้าที่ต้องใช้ทรัพยากรสูง
สูตรการปรับใช้ vLLM ปัจจุบันระบุว่าขนาดเช็คพอยต์ราวๆ 511 GB บนดิสก์ และต้องใช้งบ VRAM ขั้นต่ำประมาณ 614 GB ทำให้เซิร์ฟเวอร์ระดับ 8×H200 หรือระบบหน่วยความจำสูงที่เทียบเท่ามีความเป็นไปได้มากกว่าสถานีทำงานของผู้ใช้ทั่วไป
สำหรับทีมที่ต้องการเพียงการเข้าถึงโมเดล ไม่จำเป็นต้องควบคุมถึงระดับเวท ชุด API DeepSeek V4.1 Flash บน CometAPI เรียบง่ายกว่าการดูแลเซิร์ฟเวอร์อินเฟอเรนซ์หลายจีพียูมาก
Key Takeaways
- DeepSeek-V4.1-Flash ใช้โครงหลัก MoE 552B โดยมีพารามิเตอร์ที่ทำงานจริง 8B ระหว่าง prefill และ 16B ระหว่าง decode; ตัวเลขพารามิเตอร์ที่ทำงานจริงไม่ใช่ข้อกำหนดหน่วยความจำที่ต้องประจำอยู่ในเครื่อง
- คอนเท็กซ์ 1,048,576 โทเคน และ global KV cache 890 ไบต์ต่อโทเคน ช่วยลดแรงกดดันของแคช แต่เวทของโมเดลยังคงเป็นตัวแปรหลักในการวางแผนความจุ
- เช็คพอยต์อย่างเป็นทางการมีขนาดประมาณ 511 GB บนดิสก์ สูตร vLLM ประมาณการงบ VRAM ใช้งานรวมขั้นต่ำราว 614 GB สำหรับการโหลดโมเดลและโอเวอร์เฮดรันไทม์; ตัวเลขนี้เป็นฐานอ้างอิง ไม่ใช่การรับประกันสำหรับทุกขนาดแบตช์ ความยาวคอนเท็กซ์ หรือโหมดมัลติโหมด
- vLLM เป็นเส้นทางที่ชัดเจนที่สุดสำหรับการให้บริการในโปรดักชัน ขณะที่ SGLang มุ่งเป้าไปที่อินเฟอเรนซ์แบบกระจายขั้นสูง; เส้นทางของ Ollama ตอนนี้เป็นแบบคลาวด์ ไม่ใช่อินเฟอเรนซ์เต็มรูปแบบในเครื่อง
- การโฮสต์เองคุ้มค่าสำหรับความเป็นส่วนตัว การทำงานแบบ air-gapped งานวิจัยระดับเวท หรือการใช้คลัสเตอร์อย่างต่อเนื่อง; นักพัฒนาส่วนใหญ่จะพบว่า API แบบโฮสต์ใช้งานง่ายกว่า
What Is DeepSeek-V4.1-Flash? Architecture, Parameters, and Model Size
DeepSeek เปิดตัว V4.1-Flash อย่างเป็นทางการเมื่อวันที่ 10 กันยายน 2026 ในฐานะโมเดลที่เล็กที่สุดในตระกูลสถาปัตยกรรมใหม่ พร้อมความเข้าใจเชิงภาพแบบเนทีฟ แม้ชื่อว่า “Flash” แต่ไม่ได้เป็นโมเดล dense ขนาดเล็ก
การเปลี่ยนแปลงเชิงสถาปัตยกรรมที่สำคัญคือการออกแบบ Causal Encoder-Decoder (CED) โมเดลแบ่งภาระการคำนวณแบบอสมมาตรระหว่างการรับพรอมต์และการสร้างโทเคน เพื่อลดการคำนวณที่ต้องใช้ในแต่ละโทเคน ขณะยังคงกองผู้เชี่ยวชาญที่มีขนาดใหญ่มาก
| Specification | DeepSeek-V4.1-Flash |
|---|---|
| Architecture | Multimodal MoE with Causal Encoder-Decoder |
| Backbone parameters | 552B |
| Active parameters, input | 8B |
| Active parameters, output | 16B |
| Transformer layers | 40: 20 encoder + 20 decoder |
| Context window | 1,048,576 tokens |
| Global KV cache | 890 bytes/token |
| Modalities | Text + image input, text output |
| Weight license | MIT |
| Recommended sampling | Temperature 1.0; top_p 0.95 or 1.0 |
| Official weights | Hugging Face |
| Primary local serving options | vLLM, SGLang, DeepSeek reference inference |
ความแตกต่างระหว่างพารามิเตอร์ที่ทำงานจริงกับพารามิเตอร์ที่ต้องประจำอยู่ในหน่วยความจำเป็นเรื่องสำคัญ MoE routing ลดปริมาณการคำนวณที่ใช้ต่อโทเคน แต่เซิร์ฟเวอร์ยังคงต้องเข้าถึงเวทของผู้เชี่ยวชาญทั้งหมดที่อาจถูกเลือกใช้ นั่นคือเหตุผลที่โมเดล “8B active” ยังอาจต้องใช้พื้นที่จัดเก็บและหน่วยความจำของตัวเร่งหลายร้อยกิกะไบต์
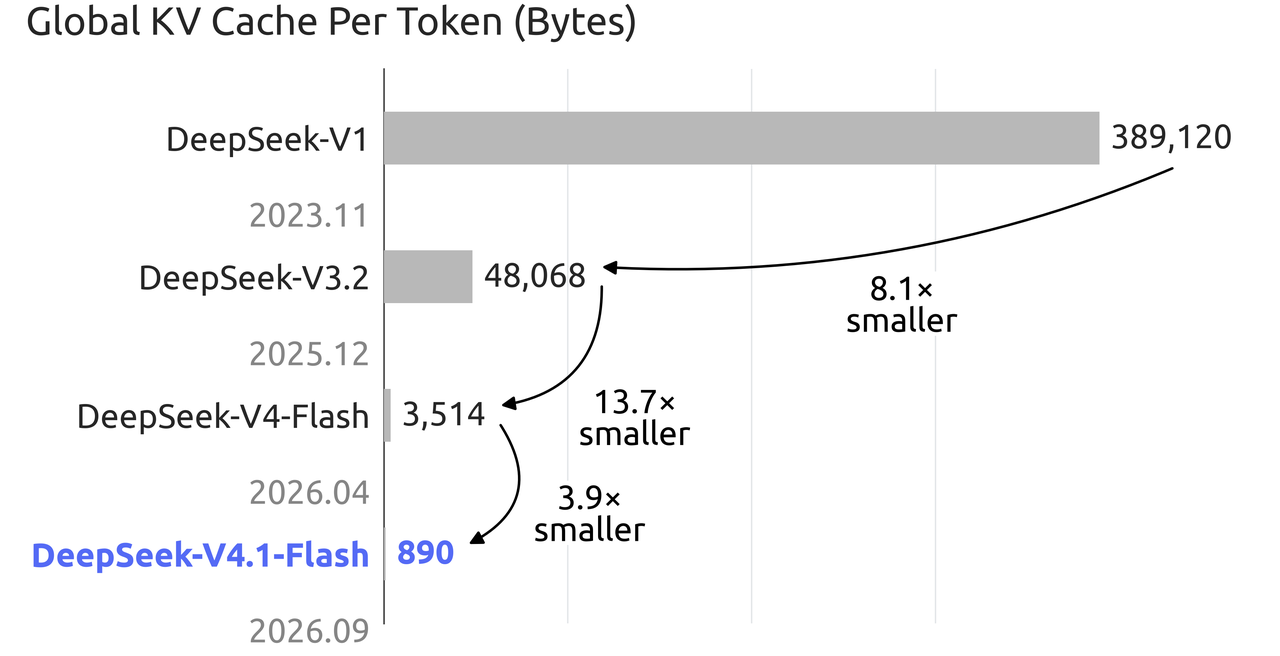
กราฟ KV-cache อย่างเป็นทางการของ DeepSeek แสดงให้เห็นว่า global cache ลดลงจาก 3,514 ไบต์ต่อโทเคนใน V4 Flash เหลือ 890 ไบต์ต่อโทเคนใน V4.1 Flash ลดลงประมาณ 3.9× ประเด็นนี้สำคัญสำหรับอินเฟอเรนซ์ระดับล้านโทเคน แต่ก็ยังไม่สามารถลบล้างความต้องการหน่วยความจำที่ใหญ่กว่ามากซึ่งเกิดจากเวทของโมเดลเอง
How Good Is DeepSeek-V4.1-Flash Before You Deploy It?
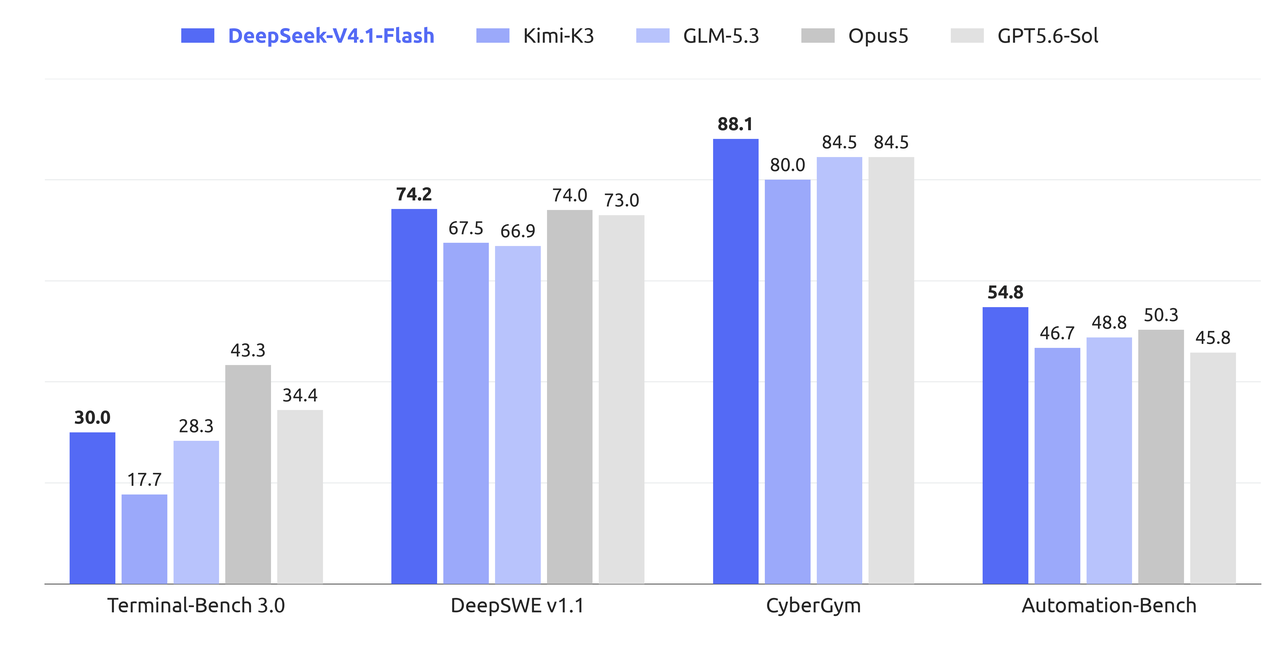
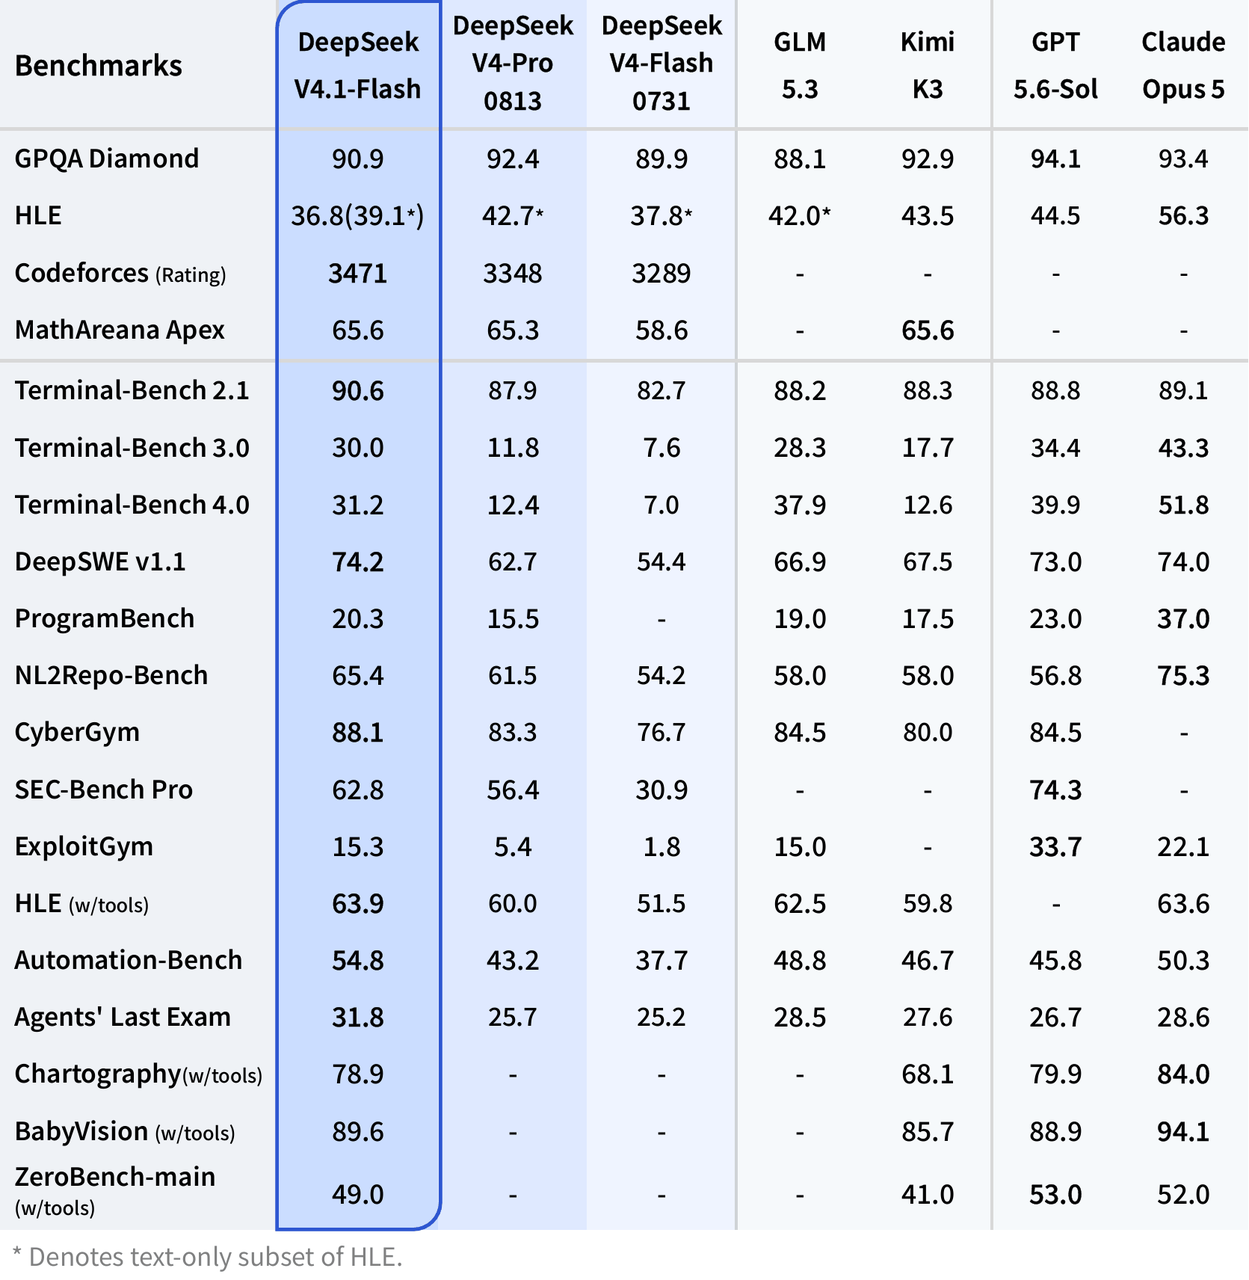
ตารางเกณฑ์วัดผลที่ DeepSeek เผยแพร่จัดวาง V4.1-Flash เป็นการอัปเกรดครั้งใหญ่ด้านงานโค้ดแบบเอเจนต์ การทำงานกับเทอร์มินัล อัตโนมัติ และเวิร์กโหลดวิศวกรรมซอฟต์แวร์ ตัวเลขเหล่านี้เป็น ผลการทดสอบที่ผู้ผลิตรายงาน จึงควรใช้เป็นค่ามาตรฐานอ้างอิง มากกว่าการรับประกันประสิทธิภาพในแอปพลิเคชันจริง
เพื่อความทำซ้ำได้ การ์ดโมเดลอย่างเป็นทางการแนะนำ temperature 1.0 และ top_p 0.95 โดยระดับความพยายามด้าน reasoning และงบโทเคนแตกต่างกันไปตามการประเมิน ตัวเลขด้านล่างเป็นผลอ้างอิงจากผู้ผลิต ไม่ใช่การรับประกันประสิทธิภาพที่เป็นกลางด้านฮาร์ดแวร์; ควรตรวจสอบรายละเอียดฮาร์เนสเฉพาะของแต่ละเกณฑ์ก่อนทำซ้ำ
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
รูปแบบโดยรวมสำคัญกว่าคะแนนใดคะแนนหนึ่ง V4.1-Flash ไม่ได้นำหน้าในทุกเกณฑ์ แต่การกระโดดจาก V4 Flash 0731 นั้นใหญ่เป็นพิเศษบน Terminal-Bench, DeepSWE, งานอัตโนมัติ และความปลอดภัยไซเบอร์ ซึ่งทำให้การปรับใช้ในเครื่องมีความเกี่ยวข้องเป็นพิเศษสำหรับเอเจนต์โค้ดส่วนตัว การวิเคราะห์ระดับรีโพซิทอรี ระบบอัตโนมัติภายใน และโครงสร้างพื้นฐานเอเจนต์แบบ air-gapped
Can You Really Run DeepSeek-V4.1-Flash Locally?
ได้ แต่คำว่า “ในเครื่อง” ต้องตีความให้ชัดเจน สูตร vLLM ล่าสุดสำหรับ DeepSeek-V4.1-Flash แยกเช็คพอยต์ไว้ราวครึ่งเทราไบต์ และแนะนำงบ VRAM ที่ใหญ่กว่ามากเมื่อรวมโอเวอร์เฮดรันไทม์เข้าไปแล้ว
| Component | Approximate stored size |
|---|---|
| Routed + DSpark experts | 259.5 GiB |
| Engram tables | 183.1 GiB |
| Attention, dense projections and routers | 6.9 GiB |
| Embeddings, LM head and norms | 3.9 GiB |
| UE8M0 block scales | 21.9 GiB |
| Full checkpoint | ~476 GiB / ~511 GB |
| vLLM recommended minimum VRAM budget | ~614 GB |
จุดที่น่าประหลาดใจคือ V4.1-Flash ถูกบีบอัดภายในอย่างมากอยู่แล้ว เวทของผู้เชี่ยวชาญแบบ routed ใช้ฟอร์แมตความแม่นยำต่ำ ดังนั้นเช็คพอยต์อย่างเป็นทางการจึงไม่ใช่โมเดล BF16 ขนาดใหญ่ที่รอการแปลงเป็น 4 บิตแบบง่ายๆ
DeepSeek-V4.1-Flash Hardware Requirements
| Hardware configuration | Practical status | Comments |
|---|---|---|
| 1× RTX 4090 / 5090 | No | ต่ำกว่ารอยเท้าหน่วยความจำของโมเดลมาก |
| 2–4 consumer GPUs | No for the official full checkpoint | VRAM รวมยังไม่เพียงพอ |
| 128 GB workstation | No | พารามิเตอร์ที่ทำงานจริงไม่ได้กำหนดหน่วยความจำที่ต้องประจำอยู่ |
| 256 GB workstation | No for official serving path | ยังต่ำกว่ารอยเท้าของเช็คพอยต์ทางการมาก |
| 512 GB system RAM + GPU offload | Experimental | พื้นที่ของชุมชน/offload ยังไม่เทียบเท่าเส้นทางให้บริการโปรดักชันที่ยืนยันแล้ว |
| 4× high-memory datacenter GPUs | Hardware-dependent | เป็นไปได้ถ้าตัวเร่งรุ่นใหม่มีหน่วยความจำมากเพียงพอ; ตรวจสูตรรันไทม์ |
| 8× H200 | Yes, documented class | หน่วยความจำ HBM รวมราว 1,128 GB |
| GB200 NVL4-class system | Yes | vLLM ระบุว่าเทรย์ 768 GB สามารถบรรจุโมเดลนี้ได้ |
สำคัญ: 8B พารามิเตอร์ที่ทำงานจริง ไม่ได้หมายความว่าใช้ VRAM 8 GB “Active” อธิบายสัดส่วนของเครือข่าย MoE ที่เข้าร่วมในการคำนวณของโทเคนหนึ่งๆ ชุดผู้เชี่ยวชาญทั้งหมดยังต้องถูกเก็บไว้และเข้าถึงได้โดยเอนจินอินเฟอเรนซ์
Which Runtime Should You Use for DeepSeek-V4.1-Flash?
| Runtime | Current V4.1-Flash status | Best use |
|---|---|---|
| vLLM | มีสูตรการปรับใช้ปัจจุบัน; ต้องใช้อิมเมจเวอร์ชันใหม่ | ให้บริการแบบ OpenAI-compatible ในโปรดักชัน |
| SGLang | รองรับผ่านบิลด์ปรับใช้ DeepSeek-V4.1 ปัจจุบัน | อินเฟอเรนซ์แบบกระจายประสิทธิภาพสูง |
| DeepSeek reference inference | อิมพลีเมนเตชัน TP8 อ้างอิงอย่างเป็นทางการ | งานวิจัยสถาปัตยกรรมและการตรวจสอบความถูกต้อง |
| Transformers | อินทิเกรตโมเดลบน Hugging Face แล้ว | การพัฒนาและทดลอง; ยังต้องใช้ฮาร์ดแวร์ที่เหมาะสม |
| Ollama | เส้นทางไลบรารีทางการใช้ :cloud | เรียกใช้งานคลาวด์สะดวก ไม่เทียบเท่าการโฮสต์เองเต็มรูปแบบ |
สำหรับการโฮสต์เองในโปรดักชัน vLLM เป็นจุดเริ่มต้นที่ชัดเจนที่สุด คู่มือการปรับใช้ SGLang เป็นอีกเส้นทางหนึ่งที่รองรับสำหรับอินเฟอเรนซ์แบบกระจายขั้นสูง
How to Run DeepSeek-V4.1-Flash Locally with vLLM
นี่คือเส้นทางที่ปฏิบัติได้สำหรับเซิร์ฟเวอร์ Linux แบบหลายจีพียู
ตัวอย่างคำสั่งทั้งหมดด้านล่างได้รับการจัดรูปแบบใหม่เป็นโค้ดบล็อกแยกตามภาษา พร้อมคำอธิบายภาษาอังกฤษแบบย่อ
Step 1: Check Your Environment
- Linux
- Docker
- NVIDIA Container Toolkit
- พื้นที่ SSD ว่างหลายร้อยกิกะไบต์
- การกำหนดค่าจีพียูหลายตัวที่รองรับ
- หน่วยความจำตัวเร่งรวมที่ใช้งานได้ประมาณ 614 GB สำหรับโปรไฟล์ให้บริการเวททางการปัจจุบัน
- เครือข่ายที่รวดเร็ว หากโมเดลยังไม่ถูกแคชในเครื่อง
Step 2: Download the DeepSeek-V4.1-Flash Weights
เวทอย่างเป็นทางการโฮสต์อยู่ในรีโพซิทอรี Hugging Face ของ DeepSeek-V4.1-Flash ภายใต้ไลเซนส์ MIT
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
ตรวจสอบให้แน่ใจว่าระบบไฟล์ที่เก็บ ~/.cache/huggingface มีพื้นที่ว่างมากกว่า 511 GB ไฟล์ชั่วคราวและอาร์ติแฟกต์ของเอนจินเพิ่มเติมอาจทำให้การใช้ดิสก์สูงสุดมากขึ้น
Step 3: Start DeepSeek-V4.1-Flash with vLLM
ตามสูตร vLLM ปัจจุบัน การรองรับ DeepSeek-V4.1 ต้องใช้อิมเมจ vLLM ที่ใหม่เพียงพอ การตั้งค่าเริ่มต้นแบบ text-only บนแปดจีพียูอาจเป็นดังนี้:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
มีสองตัวเลือกที่ตั้งใจไว้ที่นี่ ประการแรก --language-model-only ปิดการใช้งานตัวเข้ารหัสภาพสำหรับงานข้อความล้วน ประการที่สอง การเริ่มที่ 131,072 โทเคนปลอดภัยกว่าการเปิดใช้งานคอนเท็กซ์ล้านโทเคนตั้งแต่แรก เมื่อเซิร์ฟเวอร์เสถียรแล้ว คุณสามารถเพิ่มได้เป็น:
--max-model-len 1048576
การตั้งค่า tensor-parallel ที่เหมาะสมขึ้นอยู่กับ topology ของตัวเร่ง ดังนั้นอย่าคัดลอก --tensor-parallel-size 8 แบบตาบอดไปยังทุกเครื่อง
Step 4: Test the Local DeepSeek-V4.1-Flash Endpoint
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Step 5: Call Your Local DeepSeek-V4.1-Flash Server with Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
How Do You Enable DeepSeek-V4.1-Flash Thinking Mode Locally?
V4.1-Flash รองรับการควบคุม reasoning แบบชัดเจนผ่าน chat template ตัวอย่างหนึ่งคือ:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
หากโมเดลดูเหมือนส่งคืนเนื้อหาสุดท้ายเล็กน้อยหรือไม่มีเลยเมื่อ max_tokens มีค่าน้อย ให้ตรวจสอบว่าโหมดคิดกำลังกินงบการสร้างโทเคนหรือไม่ ก่อนจะสรุปว่าการปรับใช้งานมีปัญหา
How Do You Run DeepSeek-V4.1-Flash with Reference Code?
DeepSeek ยังมี อิมพลีเมนเตชันอินเฟอเรนซ์ TP8 แบบมินิมัล อยู่ในรีโพซิทอรีของโมเดลด้วย มีจุดประสงค์หลักเพื่อเป็นโค้ดอ้างอิงที่อ่านง่าย มากกว่าจะเป็นเซิร์ฟเวอร์โปรดักชันที่มีอัตราส่งผ่านสูง
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
เส้นทางนี้มีประโยชน์สำหรับการสำรวจ CED, MoE routing, หน่วยความจำ Engram, speculative decoding และรายละเอียดการอิมพลีเมนต์ที่เกี่ยวข้อง สำหรับการให้บริการในโปรดักชันตามปกติ vLLM หรือ SGLang ใช้งานง่ายกว่า
Can You Run DeepSeek-V4.1-Flash Locally with Ollama?
ไม่ใช่ในความหมายเดียวกับการรันโมเดล 7B หรือ 32B บน Ollama ตอนนี้ Ollama เปิดเผย V4.1-Flash ผ่าน:
ollama run deepseek-v4.1-flash:cloud
ส่วนสำคัญคือ :cloud รายการไลบรารี Ollama ปัจจุบัน ใช้เส้นทางคลาวด์ ดังนั้นคำสั่งนี้ไม่เทียบเท่ากับการดาวน์โหลดเวททั้งหมดและทำอินเฟอเรนซ์บนเครื่องคุณโดยสมบูรณ์
DeepSeek-V4.1-Flash Local Deployment vs API: Which Makes More Sense?
| Dimension | Local DeepSeek-V4.1-Flash | Hosted API |
|---|---|---|
| Up-front hardware | สูงมาก | ไม่มี |
| Accelerator memory | ~614 GB เป้าหมายเชิงปฏิบัติของทางการ | ผู้ให้บริการเป็นผู้จัดการ |
| Model control | เต็ม | จำกัด |
| Data stays on premises | ใช่ | ไม่ |
| Weight modification | ใช่ | ไม่ |
| Maintenance | คุณต้องรับผิดชอบเอง | ผู้ให้บริการเป็นผู้ดูแล |
| Setup complexity | สูง | ต่ำ |
| Scaling | ต้องใช้อินฟราสตรักเจอร์ | ผ่าน API |
| Best for | Air-gapped, ส่วนตัว, วิจัย, คลัสเตอร์ใช้งานหนัก | นักพัฒนาส่วนใหญ่และแอปโปรดักชัน |
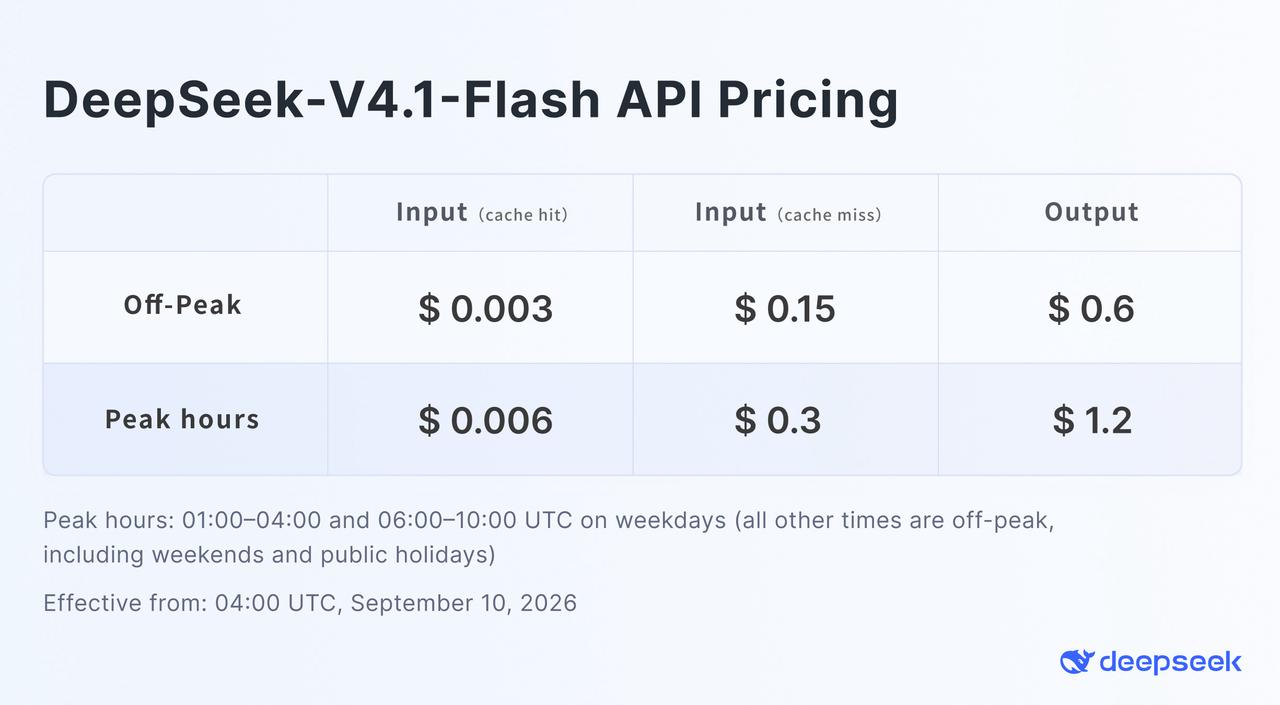
DeepSeek แสดงราคานอกชั่วโมงพีคอย่างเป็นทางการในกราฟราคา V4.1-Flash สำหรับนักพัฒนาที่ไม่จำเป็นต้องครอบครองเวทจริง ชุด API DeepSeek V4.1 Flash บน CometAPI นำเสนอตัวเลือกแบบ OpenAI-compatible ที่สะดวกกว่า
ตัวอย่างต่อไปนี้ใช้ตัวระบุโมเดลของ CometAPI ซึ่งไม่ใช่ตัวระบุเดียวกับ API อย่างเป็นทางการของ DeepSeek
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
การตัดสินใจเชิงปฏิบัติค่อนข้างตรงไปตรงมา: การปรับใช้ในเครื่องมีความคุ้มค่าเมื่อความเป็นส่วนตัว การทำงานแบบ air-gapped การทดลองระดับเวท การใช้งานหนักต่อเนื่อง หรือข้อกำกับดูแลมีน้ำหนักมากกว่าต้นทุนโครงสร้างพื้นฐาน สำหรับการพัฒนาแอปทั่วไป การใช้เอ็นด์พอยต์แบบโฮสต์ช่วยหลีกเลี่ยงการจัดการโมเดลขนาดหลายร้อยกิกะไบต์และการประสานงานหลายจีพียู
What Problems Can You Encounter When Running DeepSeek-V4.1-Flash Locally?
เซิร์ฟเวอร์หมดหน่วยความจำก่อนเริ่มการสร้างข้อความ
เช็คพอยต์เต็ม ไม่ใช่ตัวเลข 8B/16B ของพารามิเตอร์ที่ทำงานจริง เป็นตัวกำหนดความต้องการหน่วยความจำส่วนใหญ่ ตรวจสอบ tensor parallelism, การใช้หน่วยความจำจีพียู, การโหลดวิชัน และ HBM ที่มีอยู่
DeepSeek-V4.1-Flash ใช้เวลาสตาร์ทยาวนาน
เช็คพอยต์ระดับครึ่งเทราไบต์ต้องใช้เวลาในการดาวน์โหลด แมป เริ่มต้น และแบ่งชาร์ด ค่า timeout ของเอนจินที่ยาวเป็นเรื่องปกติสำหรับโมเดลชั้นนี้
คำตอบว่างเปล่าหรือจบด้วย finish_reason=length
โหมดคิดอาจกำลังกินงบการสร้างโทเคน เพิ่ม max_tokens ลดความพยายาม reasoning หรือปิดโหมดคิดสำหรับคำขอที่เรียบง่าย
การเรียกใช้เครื่องมือแยกวิเคราะห์ไม่ถูกต้อง
ตรวจสอบให้แน่ใจว่าเซิร์ฟเวอร์ใช้ tokenizer, tool-call parser, reasoning parser ของ DeepSeek V4.1 และเปิดใช้แฟลก auto-tool-choice แล้ว
อินพุตภาพไม่ทำงาน
หากคุณสตาร์ทด้วย --language-model-only คุณได้ปิดการใช้งานตัวเข้ารหัสภาพโดยตั้งใจ ก่อนทดสอบภาพให้รีสตาร์ทพร้อมเปิดโหมดมัลติโหมด
Should You Run DeepSeek-V4.1-Flash Locally?
DeepSeek-V4.1-Flash มีความน่าสนใจเป็นพิเศษจากมุมมองการโฮสต์เอง เพราะสถาปัตยกรรมช่วยลดการคำนวณต่อโทเคนและต้นทุน KV-cache อย่างมาก แต่ไม่ได้ทำให้โมเดล open-weight ระดับแนวหน้า กลายเป็นโมเดลสำหรับเดสก์ท็อป
สำหรับห้องวิจัย แพลตฟอร์ม AI ระดับองค์กร สแตกเอเจนต์โค้ดส่วนตัว หรือสภาพแวดล้อมแบบ air-gapped vLLM และ SGLang ทำให้การโฮสต์เองเป็นจริงทางเทคนิค สำหรับนักพัฒนาที่มีจีพียูหนึ่งหรือสองตัว ไม่ใช่เป้าหมายการปรับใช้โมเดลเต็มที่ปฏิบัติได้ ในกรณีนั้น การใช้ DeepSeek V4.1 Flash ผ่าน CometAPI ช่วยให้เข้าถึงโมเดลได้โดยไม่ต้องทำให้การให้บริการกลายเป็นโครงการโครงสร้างพื้นฐานขนาดใหญ่
FAQ
DeepSeek-V4.1-Flash เป็นโอเพ่นซอร์สหรือไม่?
เวทและรีโพซิทอรีเผยแพร่ภายใต้ไลเซนส์ MIT ซึ่งอนุญาตให้ใช้งาน ดัดแปลง และแจกจ่ายได้อย่างกว้างขวางตามเงื่อนไขของไลเซนส์
ฉันสามารถรัน DeepSeek-V4.1-Flash บน RTX 4090 หรือ RTX 5090 ได้ไหม?
ไม่ใช่โมเดลเต็มอย่างเป็นทางการ จีพียูผู้บริโภคตัวเดียวมีหน่วยความจำเพียงเศษเสี้ยวของที่เช็คพอยต์ต้องการ
8B พารามิเตอร์ที่ทำงานจริง หมายความว่า DeepSeek-V4.1-Flash ใช้ VRAM แค่ 8 GB ใช่ไหม?
ไม่ ตัวเลข 8B อธิบายพารามิเตอร์ที่เข้าร่วมระหว่างการประมวลผลพรอมต์ ชุดผู้เชี่ยวชาญทั้งหมดและสถานะสนับสนุนยังต้องถูกเก็บและเข้าถึงได้
DeepSeek-V4.1-Flash ต้องใช้ VRAM เท่าไร?
สูตร vLLM ปัจจุบันใช้งบประมาณประมาณ 614 GB เป็นตัวเลขสำหรับการวางแผน รวมเช็คพอยต์ทางการและโอเวอร์เฮดรันไทม์ ความต้องการจริงขึ้นกับฮาร์ดแวร์ ขนาดแบตช์ คอนเท็กซ์ โหมดวิชัน และการตั้งค่าให้บริการ
DeepSeek-V4.1-Flash มีขนาดบนดิสก์เท่าไร?
การแยกส่วนของ vLLM ปัจจุบันระบุว่าเช็คพอยต์ประมาณ 476 GiB หรือราว 511 GB
DeepSeek-V4.1-Flash สามารถรันคอนเท็กซ์ 1M โทเคนในเครื่องได้ไหม?
สถาปัตยกรรมรองรับสูงสุด 1,048,576 โทเคน แต่การใช้หน่วยความจำจริงยังขึ้นกับขนาดแบตช์ บัฟเฟอร์รันไทม์ สถานะวิชัน และโอเวอร์เฮดอื่นๆ
ฉันสามารถรัน DeepSeek-V4.1-Flash ในเครื่องด้วย Ollama ได้ไหม?
รายการปัจจุบันของ Ollama ใช้เส้นทาง :cloud ซึ่งไม่เท่ากับการรันเวททั้งหมดบนเครื่องของคุณเองโดยสมบูรณ์
vLLM หรือ SGLang ดีกว่าสำหรับ DeepSeek-V4.1-Flash?
ทั้งสองมุ่งเป้าไปที่การให้บริการประสิทธิภาพสูง vLLM มีสูตรเฉพาะ V4.1 ที่ละเอียดเป็นพิเศษในตอนนี้ ขณะที่ SGLang ก็เหมาะกับการปรับใช้แบบกระจายขั้นสูงเช่นกัน
วิธีที่ง่ายที่สุดในการใช้ DeepSeek-V4.1-Flash โดยไม่ต้องใช้ฮาร์ดแวร์ในเครื่องคืออะไร?
ใช้ API แบบโฮสต์ DeepSeek มี API ของตนเอง ขณะที่ CometAPI มีเอ็นด์พอยต์ DeepSeek-V4.1-Flash ที่เข้ากันได้กับ OpenAI ควบคู่กับโมเดล AI อื่นๆ