
TL;DR
Kimi K3.1 Pro คือการอัปเกรดของ Moonshot AI สำหรับ Kimi K3 เมื่อวันที่ 24 ตุลาคม 2026 การทำ post-training เพิ่มเติมช่วยยกระดับการเขียนโค้ดแบบอัตโนมัติ การวิจัยด้านการเงิน และเวิร์กโฟลว์การใช้เครื่องมือแบบขยาย โดยยังคงความจุบริบทประมาณหนึ่งล้านโทเค็นเท่าเดิม
การประเมินอิสระชี้ว่าประสิทธิภาพโดยรวมแข็งแรงขึ้น และอัตราราคาโทเค็นรับเข้า/ส่งออกมาตรฐานอย่างเป็นทางการลดลงหนึ่งในสาม อย่างไรก็ตามยังต้องทดสอบกับงานจริง: การให้เหตุผลเชิงลึกขึ้นอาจเพิ่มเวลาเสร็จงานและค่าใช้จ่ายรวม ขณะที่ K3 ยังนำเล็กน้อยใน AA-LCR และน้ำหนักที่พร้อมสำหรับ self-hosting ในปัจจุบัน
ประเด็นสำคัญ
- ความก้าวหน้าชัดเจนที่สุดอยู่ที่การปฏิบัติงานเชิงเอเจนต์. Artificial Analysis รายงานคะแนน Terminal-Bench 4.0 ของ K3.1 Pro ประมาณ 67% เทียบกับ 13% ของ K3; คะแนน Financial Research ภายในของ Moonshot เพิ่มจาก 58.8 เป็น 70.4
- ราคาต่อโทเค็นที่ต่ำลงไม่ได้การันตีว่าต้นทุนงานจะต่ำลง. อัตรามาตรฐานสำหรับโทเค็นรับเข้า/ส่งออกลดจาก $3/$15 เป็น $2/$10 ต่อหนึ่งล้านโทเค็น แต่การให้เหตุผลเพิ่มเติม การเรียกเครื่องมือ และการลองซ้ำอาจหักล้างการประหยัดได้
- หน้าต่างบริบทเท่าเดิม. ทั้งสองโมเดลรองรับได้สูงสุด 1,048,576 โทเค็น K3 ยังนำเล็กน้อยในผลประเมิน AA-LCR v1.1 ที่อ้างอิง จึงควรทดสอบความแม่นยำบริบทยาวกับเอกสารของคุณเอง
- ความพร้อมของน้ำหนักโมเดลอาจเป็นตัวตัดสินใจ. ณ วันที่ 24 ตุลาคม 2026 น้ำหนักของ K3 มีให้ใช้งานแล้ว; น้ำหนักของ K3.1 Pro ตามกำหนดจะปล่อยภายใน 4 พฤศจิกายน ทีมที่ต้อง self-host ทันทีควรคำนึงถึงความต่างนี้
Kimi K3.1 Pro เทียบกับ Kimi K3: ภาพรวมและสเปก
Kimi K3.1 Pro พัฒนาต่อจาก K3 ผ่านการทำ post-training เพิ่มเติม โดยเน้นการปรับปรุงด้านการเขียนโค้ด การวิจัยการเงิน และเวิร์กโฟลว์เอเจนต์แบบขยาย ทั้งคู่ยังคงบริบทประมาณหนึ่งล้านโทเค็น ความต่างหลักคือประสิทธิภาพงาน ราคาโทเค็น ตัวเลือกการให้บริการ และความพร้อมของน้ำหนักโมเดล
| ข้อกำหนด | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Developer | Moonshot AI | Moonshot AI |
| Release date | October 24, 2026 | July 16, 2026 |
| Architecture | K3-derived MoE, further post-trained | MoE with KDA, AttnRes |
| Model size | 3T-class and 104B active parameters | 2.8T total and 104B active parameters |
| Context window | Up to 1,048,576 tokens | Up to 1,048,576 tokens |
| Standard API input / output price | $2 / $10 per million tokens | $3 / $15 per million tokens |
| Highspeed version | Available | No separate K3 Highspeed variant is listed |
| Weight availability | Release planned by November 4, 2026 | Available under the Kimi K3 License |
ความพร้อมของน้ำหนักสะท้อนข้อมูล ณ วันที่ 24 ตุลาคม 2026 ราคา API อยู่ใน USD สำหรับโทเค็นรับเข้าและส่งออกแบบปกติ ไม่รวมค่า cache-write ภาษี และค่าธรรมเนียมอื่นที่เกี่ยวข้อง
สถาปัตยกรรมและ Post-Training
K3 เปิดตัวสถาปัตยกรรมพารามิเตอร์ 2.8 ล้านล้าน ที่ผสาน Kimi Delta Attention, Attention Residuals และ Stable LatentMoE โดยเปิดใช้งานประมาณ 104 พันล้านพารามิเตอร์ต่อโทเค็น
Moonshot อธิบาย K3.1 Pro ว่าเป็นเวอร์ชันที่ทำ post-training จาก K3 ด้วยคอมพิวต์ post-training ที่มากขึ้น เน้นการนำความสามารถไปใช้กับงานหลายขั้นตอน เช่น การใช้เครื่องมือ การดีบัก และการตรวจสอบผลประกอบ การประกาศไม่ได้แยกสถาปัตยฐานใหม่ชื่อเฉพาะ
ความสามารถร่วมและข้อกำหนด API
ทั้งสองโมเดลรองรับอินพุตแบบมัลติโหมด การเรียกใช้เครื่องมือ เอาต์พุตเชิงโครงสร้าง และการแคชบริบท ฟอร์แมตภาพและวิดีโอของอินพุตขึ้นกับเส้นทาง API ที่เลือก ทั้งคู่มีการให้เหตุผลเสมอ และรองรับระดับการให้เหตุผล low, high, และ max โดย max เป็นค่าเริ่มต้น
สำหรับบทสนทนาแบบหลายเทิร์นและการเรียกเครื่องมือ การอินทิเกรตต้องเก็บข้อความผู้ช่วยทั้งหมด รวมถึงเนื้อหาการให้เหตุผลและการเรียกเครื่องมือ ตามที่ API กำหนด ขีดจำกัดบริบทจริงและความพร้อมของฟีเจอร์ควรตรวจสอบตามผู้ให้บริการ ผลิตภัณฑ์ และระดับการสมัครที่เลือก
Kimi K3.1 Pro เทียบกับ Kimi K3: ประสิทธิภาพ
หลักฐานมาจากการทดสอบภายในของ Moonshot และการเปรียบเทียบที่รายงาน ร่วมกับการประเมินอิสระจากบุคคลที่สาม
ควรตีความแยกกัน เนื่องจากฮาร์เนสทดสอบ เซ็ตทดสอบ การตั้งค่าการให้เหตุผล และเกณฑ์การให้คะแนนอาจต่างกัน
ในการประเมินเปิดตัวของ Artificial Analysis คะแนนดัชนี Intelligence โดยรวมเพิ่มขึ้น 11 จุด โดยดีขึ้นชัดเจนด้านการเขียนโค้ดผ่านเทอร์มินัลและเวิร์กโฟลว์เชิงเอเจนต์
| Benchmark อิสระ (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | ส่วนต่าง |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 จุดเปอร์เซ็นต์ |
| AutomationBench-AA | 58% | 73% | +15 pp |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 pp |
| AA-Omniscience hallucination rate | 53% | 44% | −9 pp |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 pp |
นี่คือผลการประเมินอิสระ ค่าบางรายการเป็นการปัดเศษตามที่ผู้ประเมินรายงาน อัตรา hallucination ที่ต่ำกว่าดีกว่า
ความก้าวหน้าที่ใหญ่ที่สุดเกิดในการเขียนโค้ดผ่านเทอร์มินัล K3.1 Pro ทำได้ดีกว่ามากในงานที่ต้องสั่งคำสั่ง โต้ตอบกับสภาพแวดล้อม ดีบัก และตรวจสอบซ้ำ
AutomationBench-AA ก็เพิ่มขึ้นอย่างมีนัยสำคัญ บ่งชี้การดำเนินงานที่แข็งแรงขึ้นในเวิร์กโฟลว์ SaaS
Benchmark เปิดตัวของ Moonshot มุ่งเน้นการเขียนโค้ด วิทยาศาสตร์ การสร้าง 3D การเงิน งานความรู้ และเอเจนต์อัตโนมัติ
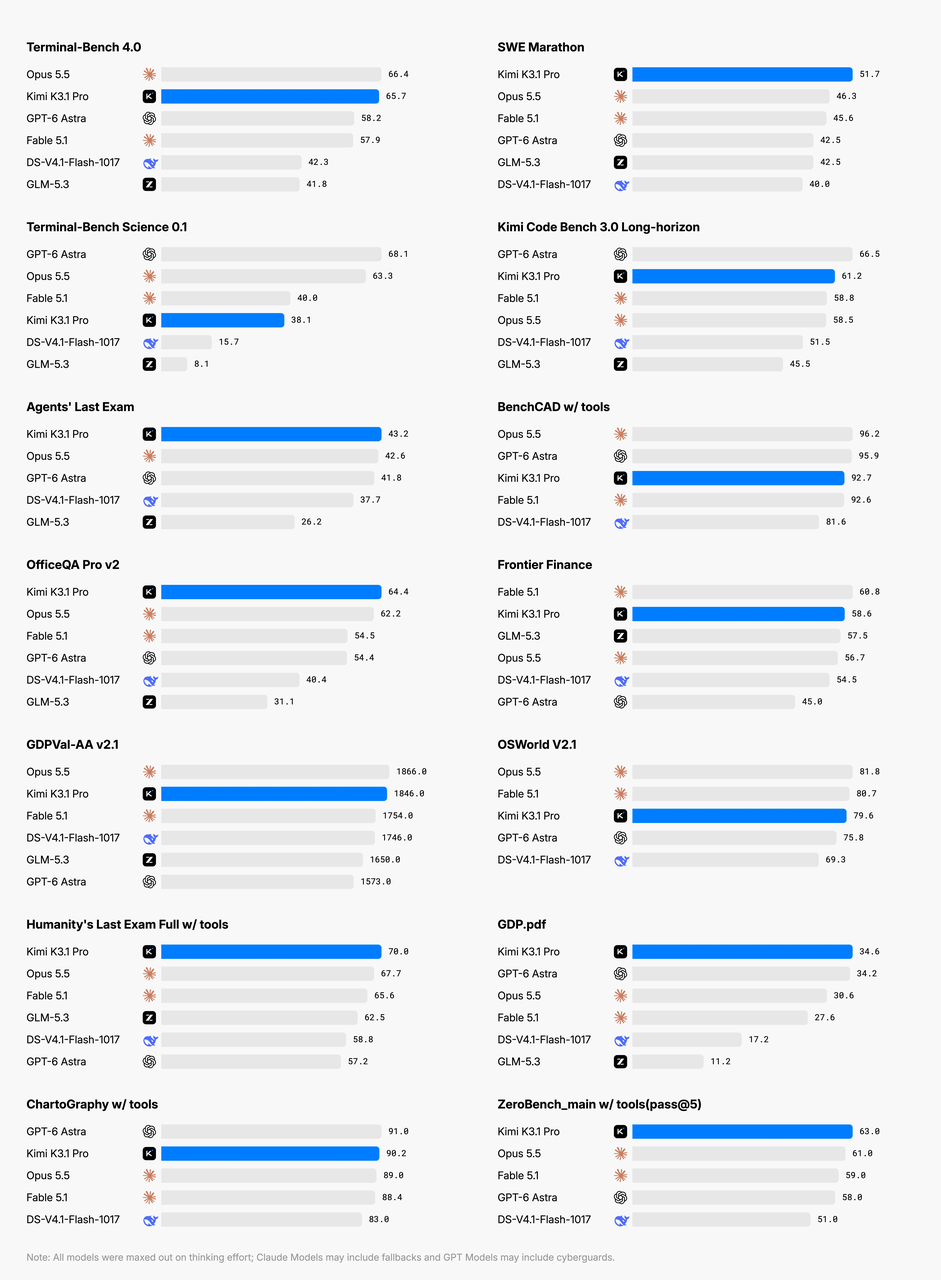
การเปรียบเทียบที่เลือกไว้รวม Claude Opus 5.5 และ GPT-6 Astra เปรียบเทียบแต่ละผลภายในชื่อ benchmark และการตั้งค่าที่ระบุ
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Other Model | Comparison Model Score |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD with tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
K3.1 Pro เข้าใกล้หรือแซงโมเดลเชิงพาณิชย์ชั้นนำบางงาน แต่ไม่ได้ชนะทุกหมวด
เช่น ยังตามหลัง Claude Opus 5.5 ใน BenchCAD และ OSWorld ตามที่ผู้ขายรายงาน และชาร์ตทางการชี้จุดอ่อนใหญ่กว่าใน Terminal-Bench Science
การตั้งค่าการประเมินแตกต่างกัน: Artificial Analysis ใช้ mini-swe-agent สำหรับ Terminal-Bench 4.0 ขณะที่ Moonshot ใช้ Claude Code ควรเปรียบเทียบคะแนนภายในชุดทดสอบเดียวกัน; ฮาร์เนส ระดับ reasoning และขีดจำกัดเวลา runtime ส่งผลต่อผลลัพธ์
การเขียนโค้ดและวิศวกรรมซอฟต์แวร์
สำหรับการเขียนโค้ดอัตโนมัติที่ซับซ้อน โดยทั่วไป K3.1 Pro แข็งแรงกว่า
ผล Kimi Code Bench 3.0 Long-horizon ภายในของ Moonshot เพิ่มจาก 55.95% สำหรับ K3 เป็น 61.2% สำหรับ K3.1 Pro เพิ่มประมาณ 5.25 จุดเปอร์เซ็นต์
ผล Terminal-Bench อิสระก็เพิ่มขึ้นอย่างมาก การทดสอบเหล่านี้วัดการดำเนินงานหลายขั้นตอน: ทำความเข้าใจรีโป เปลี่ยนไฟล์ รันคำสั่ง วินิจฉัยข้อผิดพลาด และตรวจสอบผล
K3.1 Pro เป็นตัวเลือกที่แข็งกว่าในงานพัฒนาหลายไฟล์ งานเทอร์มินัลอัตโนมัติ และดีบักแบบยืดเยื้อ สำหรับการสร้างโค้ดง่ายๆ เปรียบเทียบทั้งสองโมเดลกับงานของคุณเอง; K3 ยังเป็นตัวเลือกทันทีเมื่อจำเป็นต้อง self-host
ข้อแตกต่างสำคัญคือคะแนน benchmark โค้ดขึ้นอยู่กับเฟรมเวิร์กเอเจนต์อย่างมาก เครื่องมือ พรอมต์ ขีดจำกัด runtime และสภาพแวดล้อมทดสอบมีอิทธิพลต่อผล
สำหรับการพัฒนาซอฟต์แวร์จริง การประเมินที่ดีที่สุดยังคงเป็นการเปรียบเทียบในรีโปของคุณเอง
การวิจัยการเงินและการดำเนินงานธุรกิจ
การสร้างแบบจำลองการเงินให้การเปรียบเทียบตรงที่ชัดเจน
Moonshot ทดสอบ K3 และ K3.1 Pro ในการประเมินภายในที่ครอบคลุมการสร้างสเปรดชีต คุณภาพงานวิจัย และการดำเนินงานธุรกิจจำลอง
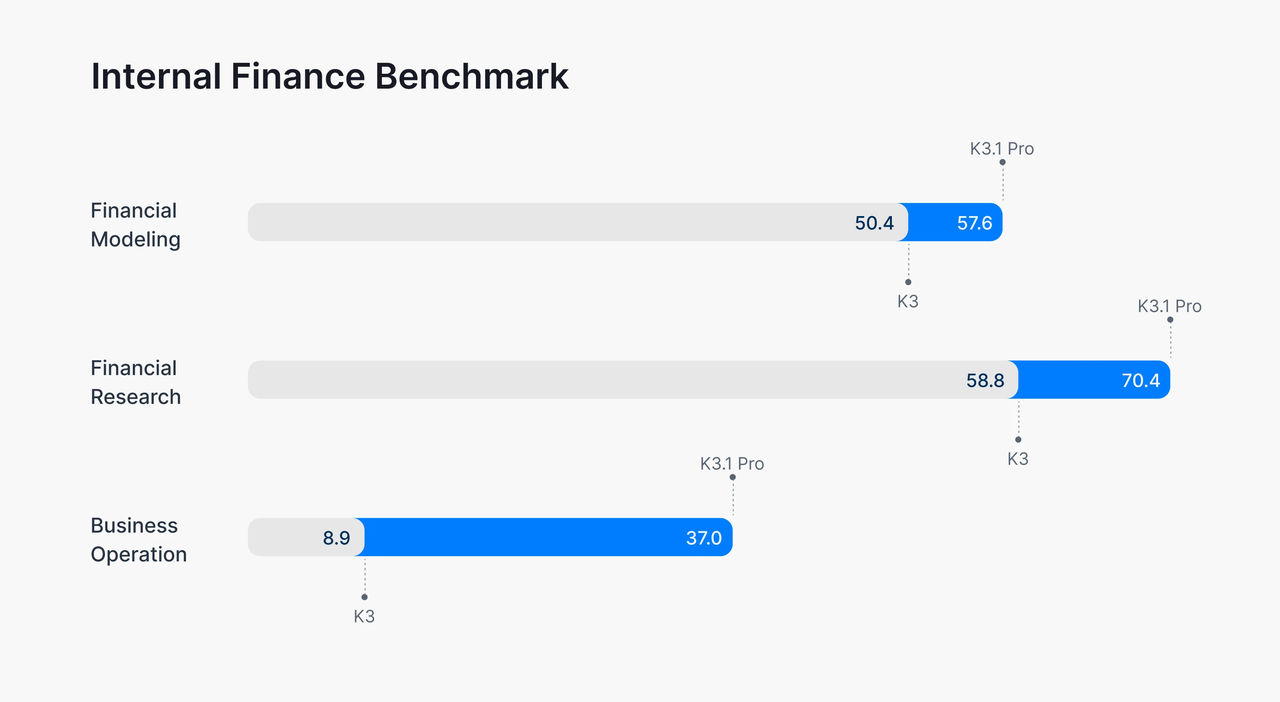
ผลการเงินภายในของ Moonshot ครอบคลุมการสร้างแบบจำลอง การวิจัย และการดำเนินงานธุรกิจจำลอง คะแนนงานที่รายงานโดยผู้ขายเหล่านี้ไม่ใช่มาตรวัดผลตอบแทนจากการลงทุน การตั้งค่าต่อภารกิจไม่ควรสันนิษฐานว่าเหมือนกับ benchmark อื่น
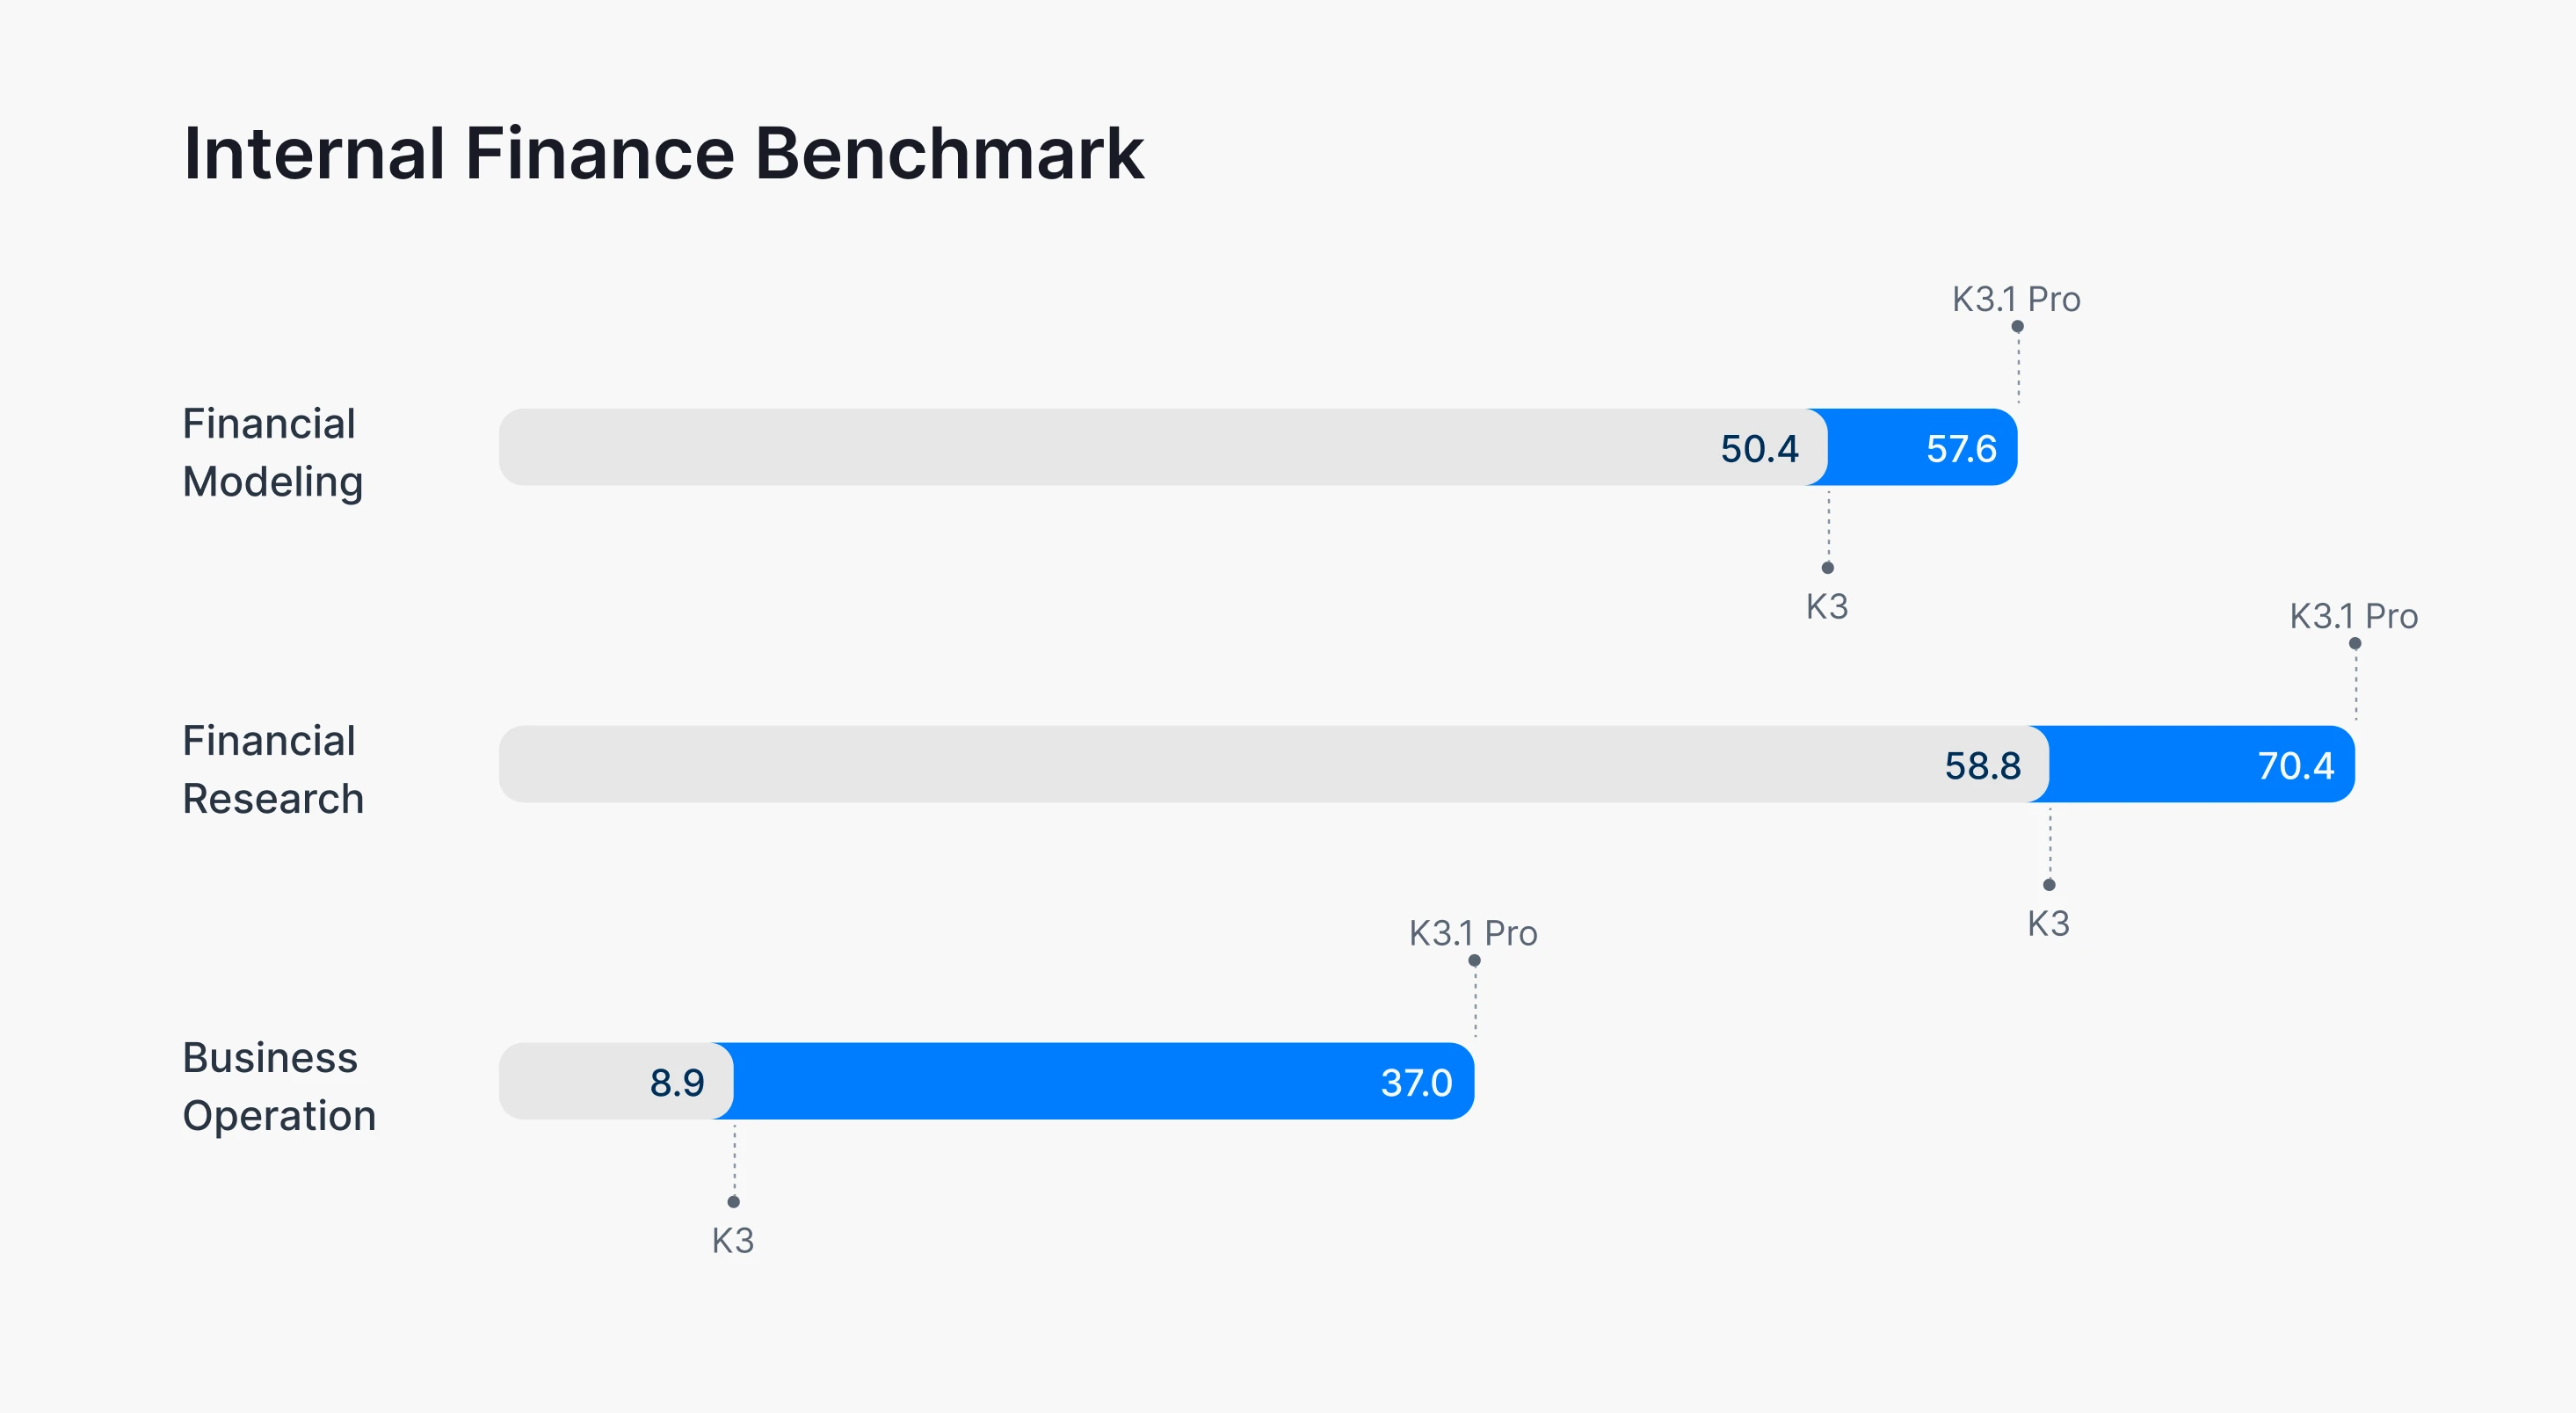
ในการทดสอบภายในของ Moonshot Financial Modeling เพิ่มจาก 50.4 เป็น 57.6 เพิ่ม 7.2 จุด และ Financial Research เพิ่มจาก 58.8 เป็น 70.4 เพิ่ม 11.6 จุด Business Operation เพิ่มจาก 8.9 เป็น 37.0 ประมาณ 4.2 เท่าของ K3
Benchmark นี้ประเมินการจัดการและการตัดสินใจระยะยาวในสภาพแวดล้อมธุรกิจจำลอง จึงใกล้เคียงกับการวางแผนเชิงเอเจนต์มากกว่าการถามตอบทางการเงินอย่างง่าย
Financial Research วัดความสามารถในการผลิตงานวิจัยที่อิงหลักฐาน โดยเคารพข้อกำหนดแหล่งข้อมูลและเส้นตัดข้อมูล Financial Modeling มุ่งที่ความสัมพันธ์ทางคณิตศาสตร์ ตรรกะสเปรดชีต และคุณภาพเวิร์กบุ๊ก
รูปแบบนี้บ่งชี้ว่า K3.1 Pro มีคุณค่าเป็นพิเศษเมื่อภารกิจด้านการเงินต้องการการให้เหตุผลต่อเนื่อง การตรวจสอบ และผลส่งมอบที่มีโครงสร้าง
สำหรับนักลงทุน นักวิเคราะห์ และผู้ใช้ธุรกิจ ประโยชน์เชิงปฏิบัติคือการจัดการเวิร์กโฟลว์หลายเอกสารได้ดีกว่า ทั้งสองโมเดลไม่ควรถูกใช้เป็นอำนาจตัดสินสูงสุดโดยปราศจากการอ้างอิง การตรวจคำนวณ และการทบทวนโดยมนุษย์ในงานที่มีเดิมพันสูง
การให้เหตุผลบริบทยาวและความน่าเชื่อถือเชิงข้อเท็จจริง
อย่างไรก็ดี ผล AA-LCR บริบทยาวชี้ว่า K3 นำเล็กน้อย นี่เตือนว่าโมเดลใหม่อาจดีขึ้นโดยรวมอย่างมากโดยไม่ชนะทุกงานเฉพาะทาง
การประเมินที่รายงานชี้ข้อผิดพลาดเชิงข้อเท็จจจริงลดลงในชุดทดสอบของแต่ละฝ่าย
บน Kimi Hallu Bench Hard พร้อมเครื่องมือ Moonshot รายงานว่าอัตราข้อผิดพลาดระดับข้ออ้างลดจาก 23.4% ของ K3 เหลือ 8.3% ของ K3.1 Pro
นั่นคือการลดสัมพัทธ์ราว 65% บนแบบทดสอบกดดันโดยตั้งใจของ Moonshot มากกว่าการประมาณอัตราข้อผิดพลาดในชีวิตจริง แยกกัน Artificial Analysis รายงานอัตรา hallucination ของ AA-Omniscience ลดจาก 53% เป็น 44% วิธีการต่างกันจึงไม่สามารถเทียบเปอร์เซ็นต์โดยตรงได้
บทเรียนเชิงปฏิบัติคือ K3.1 Pro ดูน่าเชื่อถือขึ้นในงานที่ประเมิน แต่การปรับปรุงด้านข้อเท็จจริงไม่ได้ทำให้ไม่ต้องมี retrieval การอ้างอิง การตรวจคำนวณ และการทบทวนโดยมนุษย์ในเวิร์กโฟลว์ที่สำคัญ
การวิเคราะห์ข้อมูล: หลักฐานจากการประเมินของ Plotly
Plotly ประเมิน K3.1 Pro มาตรฐานผ่าน OpenRouter ด้วยแบบทดสอบส่วนตัว 43 คำถามเหนือคลังข้อมูลลมสังเคราะห์ ไม่ได้ทดสอบ Highspeed ผลลัพธ์แสดงการแลกเปลี่ยนระหว่างคุณภาพคำตอบ เวลาเสร็จงาน และต้นทุนในเวิร์กโฟลว์วิเคราะห์ที่อิง SQL นั้น
| มาตรวัดการวิเคราะห์ข้อมูลของ Plotly | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| คำตอบถูกต้อง | 35/43 | 42/43 |
| ความแม่นยำ | 81.4% | 97.7% |
| รูปแบบแฝงที่ค้นพบ | 0/5 | 5/5 |
| ปัญหาคุณภาพข้อมูลที่ระบุได้ | 1/3 | 3/3 |
| ต้นทุนการประเมินเต็มชุด | $5.01 | $13.47 |
| เวลาเฉลี่ยมัธยฐานต่อคำถาม | 43 วินาที | 2.5 นาที |
ในการประเมินนี้ K3.1 Pro ตอบถูกมากขึ้น และพบรูปแบบแฝง/ปัญหาคุณภาพข้อมูลมากกว่า แต่มีต้นทุนและเวลาเสร็จงานต่อคำถามมากกว่า
ค่าที่รายงานเป็นค่าใช้จ่ายที่สังเกตได้ ไม่ใช่ประมาณจากราคา API มาตรฐานของ Moonshot การตั้งค่าที่เผยแพร่ไม่ได้ยืนยันว่าการตั้งค่าผู้ให้บริการเหมือนกันทุกอย่างระหว่างการรันโมเดลทั้งสอง จึงไม่อาจโยงความต่างไปที่โมเดลล้วนๆ
ผลนี้สนับสนุนการประเมิน K3.1 Pro สำหรับงานวิเคราะห์ที่ข้อค้นพบเพิ่มเติมอาจคุ้มกับเวลาและค่าใช้จ่ายที่เพิ่มขึ้น แต่ไม่ได้ยืนยันความได้เปรียบด้านความแม่นยำหรือค่าใช้จ่ายเดียวกัน
Kimi K3.1 Pro เร็วกว่า Kimi K3 หรือไม่?
แยก throughput การสร้างโทเค็นออกจาก latency งานแบบปลายทางถึงปลายทาง
Artificial Analysis รายงานอัตราการปล่อยโทเค็นส่งออก 73.5 โทเค็น/วินาทีสำหรับ K3.1 Pro เทียบกับ 38.5 สำหรับ K3 ที่ระดับการให้เหตุผลสูงสุด โดยใช้ API ของ Kimi ตัวเลขนี้เป็นการวัดการสร้างโทเค็น ณ วันที่ 24 ตุลาคม 2026; latency รวมของงานยังขึ้นกับความยาว reasoning และการทำงานของเครื่องมือ
อย่างไรก็ตาม การสร้างโทเค็นที่เร็วขึ้นไม่ได้การันตีว่างานเสร็จเร็วกว่า
Moonshot ยังมี K3.1 Pro Highspeed ที่โฆษณาว่าปล่อยเอาต์พุตเร็วกว่าเวอร์ชันมาตรฐานราว 2–3 เท่า นี่คือการปรับปรุงความเร็วการให้บริการ ไม่ใช่การยืนยันความฉลาดที่เพิ่มขึ้นแยกต่างหาก
K3.1 Pro มี throughput โทเค็นส่งออกที่สูงกว่ารายงาน แต่ไม่ได้หมายความว่าจะจบงานเร็วกว่าเสมอ แยกความเร็วการสร้างโทเค็นออกจากเวลาที่ต้องใช้ในการให้เหตุผล เรียกเครื่องมือ และปิดงาน
ความเร็วเอาต์พุต vs เวลาเสร็จสิ้นงาน
Artificial Analysis รายงานความเร็วเอาต์พุต 73.5 โทเค็น/วินาทีสำหรับ K3.1 Pro และ 38.5 สำหรับ K3 ที่การให้เหตุผลสูงสุด โดยใช้ API ของ Kimi ตัวเลขนี้ตรวจสอบเมื่อ 24 ตุลาคม 2026 และบรรยาย throughput การสร้างโทเค็น ไม่ใช่ latency ปลายทางถึงปลายทาง
โมเดลอาจปล่อยโทเค็นได้เร็วกว่าแต่ใช้เวลารวมมากกว่า หากผลิตโทเค็น reasoning มากขึ้นหรือเรียกเครื่องมือเพิ่มเติม ในการประเมินของ Plotly ที่กล่าวข้างต้น เวลาเฉลี่ยมัธยฐานต่อคำถามของ K3.1 Pro คือ 2.5 นาที เทียบกับ 43 วินาทีของ K3 ควบคู่กับความแม่นยำที่สูงกว่า
สำหรับแอปโต้ตอบ ควรวัดเวลาถึงโทเค็นแรกและเวลารวมจนจบงานบนเส้นทางผู้ให้บริการจริง เพียงดู throughput เอาต์พุตไม่พอสำหรับคาดการณ์ความตอบสนอง
พิจารณา K3.1 Pro Highspeed
Moonshot โฆษณาว่า K3.1 Pro Highspeed ให้ความเร็วเอาต์พุตประมาณ 2–3 เท่าของ K3.1 Pro มาตรฐาน ข้อนี้ว่าด้วยความเร็วการให้บริการ; ไม่ควรตีความว่าเวลาจบงานรวมลดลง 2–3 เท่า
พิจารณา Highspeed สำหรับตัวช่วยโค้ดหรือผู้ช่วยโต้ตอบที่ผู้ใช้รอผล เปรียบเทียบ latency ปลายทางถึงปลายทาง ความสำเร็จของงาน และค่าใช้จ่ายที่เรียกเก็บจริงกับเอ็นด์พอยต์มาตรฐานก่อนตัดสินใจ Highspeed มีอัตราโทเค็นรับเข้า/ส่งออกปกติสูงกว่า ขณะที่อัตรา cached-input เท่าเดิม
Kimi K3.1 Pro เทียบกับ Kimi K3: ต้นทุน
ราคา API ทางการและ CometAPI
อัตราโทเค็นรับเข้า ส่งออก และ cache-hit ของ K3.1 Pro มาตรฐานลดลงหนึ่งในสามเมื่อเทียบกับ K3 อัตรา CometAPI ที่ระบุสำหรับรับเข้า/ส่งออกยังต่ำกว่าราคาอย่างเป็นทางการอีก 20%
| Model | Official Input / 1M | Official Output / 1M | Official Cached Input / 1M | CometAPI Input / 1M | CometAPI Output / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Check current quote | Check current quote |
USD ต่อหนึ่งล้านโทเค็น; ตรวจราคาเมื่อ 24 ตุลาคม 2026 คอลัมน์ Input แสดงอัตรา uncached-input ปกติ ไม่รวมภาษีและค่าบริการแยกต่างหาก
ราคาทางการของ Kimi ยังระบุค่า cache-write: $2/$4 ต่อหนึ่งล้านโทเค็นสำหรับ Pro มาตรฐานที่เก็บ 5 นาที/1 ชั่วโมง และ $4/$8 สำหรับ Highspeed การคิดค่าบริการ cache hit, cache write และ regular input แยกกันและไม่ทับซ้อน
Kimi ทางการและ CometAPI เป็นเส้นทางผู้ให้บริการคนละราย กรุณายืนยันราคาและการรองรับ cache ปัจจุบันสำหรับเส้นทางที่เลือก รวมถึงความพร้อมของ Highspeed เปรียบเทียบทั้งต้นทุนรวมต่อภารกิจและอัตราโทเค็น
ตัวอย่างต้นทุนแบบโทเค็นคงที่
พิจารณางานที่ใช้โทเค็นรับเข้าแบบไม่แคช 100,000 โทเค็น และโทเค็นส่งออก 20,000 โทเค็น
สำหรับงานคงที่นี้ ค่าใช้จ่าย API ทางการคือ $0.60 กับ K3 และ $0.40 กับ K3.1 Pro ที่อัตรา CometAPI เดียวกัน ค่าใช้จ่ายเป็น $0.48 และ $0.32 ตามลำดับ ยอดนี้รวมเฉพาะโทเค็นรับเข้าและส่งออกที่ระบุ
แต่นี่คือการเปรียบเทียบแบบโทเค็นคงที่ เวิร์กโฟลว์เอเจนต์ที่ซับซ้อนอาจใช้โทเค็น reasoning และการเรียกเครื่องมือแตกต่างกันไปตามโมเดล
Token Savings Disapears
ให้ I เป็นจำนวนโทเค็นรับเข้าที่ไม่แคชเหมือนกัน O เป็นจำนวนโทเค็นส่งออกที่เรียกเก็บของ Kimi K3 และ P เป็นจำนวนโทเค็นส่งออกที่เรียกเก็บของ Kimi K3.1 Pro ทั้งหมดวัดเป็นหน่วยล้าน ที่อัตราทางการในตาราง คิดเงินเป็น 3I + 15O และ 2I + 10P ดอลลาร์ เท่ากันเมื่อ P = 1.5O + 0.1I
สำหรับคำขอที่พึ่งพาเอาต์พุตมาก K3.1 Pro จึงสามารถใช้โทเค็นส่งออกที่เรียกเก็บได้มากขึ้นประมาณ 50% ก่อนจะเสียข้อได้เปรียบด้านราคา การคำนวณนี้อิงอัตราที่ไม่เปลี่ยนและไม่รวมการแคช ค่าธรรมเนียมเครื่องมือ และการใช้งานที่คิดแยก ควรใช้หมวดโทเค็นที่เรียกเก็บจริง มากกว่าความยาวคำตอบที่มองเห็น
ต้นทุนต่อภารกิจที่สำเร็จ
คำนวณต้นทุนต่อภารกิจที่สำเร็จเป็นค่าใช้จ่ายทั้งหมดของการลองทั้งหมด หารด้วยจำนวนภารกิจที่ไม่ซ้ำซึ่งผ่านเกณฑ์รับรองที่กำหนด รวมค่าใช้จ่ายจากความล้มเหลว การลองซ้ำ และการหมดเวลาเมื่อผู้ให้บริการคิดเงิน; การหารเฉพาะค่าของรันที่สำเร็จด้วยจำนวนครั้งสำเร็จอาจทำให้ต้นทุนต่อความสำเร็จต่ำเกินจริง
ตรึงชุดภารกิจ เกณฑ์รับรอง ขีดจำกัดการลองซ้ำ และนโยบายหมดเวลาให้เหมือนกันระหว่าง Kimi K3 กับ K3.1 Pro รายงานอัตราสำเร็จควบคู่ต้นทุนต่อความสำเร็จเพื่อไม่ให้การตัดภารกิจยากออกทำให้โมเดลดูประหยัดอย่างผิดๆ หากไม่มีภารกิจใดสำเร็จ ต้นทุนต่อความสำเร็จไม่สามารถนิยามได้ ไม่ใช่ศูนย์
Kimi K3.1 Pro เทียบกับ Kimi K3: การเปรียบเทียบและการเลือกใช้
สำหรับเวิร์กโหลดเอเจนต์แบบโฮสต์ส่วนใหญ่ K3.1 Pro เป็นจุดเริ่มที่แข็งกว่า อย่างไรก็ดี การตัดสินใจควรสะท้อนความซับซ้อนของงานและข้อกำหนดการปรับใช้
| Use Case | Recommended Model | Reason |
|---|---|---|
| Autonomous coding | Kimi K3.1 Pro | ประเมินการเปลี่ยนหลายไฟล์ งานเทอร์มินัล การดีบัก และผลการทดสอบสุดท้าย |
| Multi-document financial research | Kimi K3.1 Pro | คะแนนงานวิจัยและการดำเนินงานธุรกิจดีขึ้น |
| Complex data analysis | Kimi K3.1 Pro | ค้นหาปัญหาและทดสอบคุณภาพข้อมูลได้ดีกว่า |
| 3D creation and CAD workflows | Kimi K3.1 Pro | ความสามารถเชิงเครื่องมือเฉพาะทางแข็งแรง |
| Straightforward text tasks | Benchmark both | เปรียบเทียบงานข้อความประจำและโค้ดง่ายบนทั้งสองโมเดล; การให้เหตุผลเพิ่มอาจเพิ่ม latency โดยไม่ทำให้ผลดีขึ้นอย่างมีนัยสำคัญ |
| Long-context retrieval accuracy | Benchmark both | K3 นำเล็กน้อยบน AA-LCR |
| Immediate self-hosting | Kimi K3 | น้ำหนักโมเดลดาวน์โหลดได้แล้ว |
| Interactive high-capability agents | K3.1 Pro Highspeed | บริการเร็วขึ้น ต้องตรวจสอบต้นทุน |
| Cost-sensitive production workflows | Benchmark both | ราคาต่อโทเค็นที่ต่ำลงอาจไม่แปลว่าต้นทุนงานต่ำลง |
ระบบอัตโนมัติแบบโฮสต์และเวิร์กโฟลว์มืออาชีพ
สำหรับเอเจนต์โค้ดแบบโฮสต์และเวิร์กโฟลว์วิเคราะห์ ให้ประเมิน K3.1 Pro บนส่วนยากของงานจริง: การเปลี่ยนหลายไฟล์ การรวบรวมหลักฐาน การตรวจคำนวณ และการฟื้นตัวหลังการเรียกเครื่องมือล้มเหลว ให้ความสำคัญกับการลดงานที่ล้มเหลวหรือการแก้ไขงานที่วัดได้ มากกว่าคะแนนพาดหัวที่สูงกว่าเพียงอย่างเดียว
สำหรับแอป K3 ที่ใช้อยู่ ให้คงเส้นทางเดิมไว้เป็นฐานเปรียบเทียบ งานประจำอาจผ่านเกณฑ์อยู่แล้ว ขณะที่งานบริบทยาวเฉพาะทางอาจมีพฤติกรรมต่างจาก benchmark รวม จัดลำดับความสำคัญส่วนงานที่การอัปเกรดให้ประโยชน์ที่วัดได้
การ self-host และข้อจำกัดการปรับใช้
ณ วันที่ 24 ตุลาคม 2026 น้ำหนักเต็มของ K3 มีให้ใช้ สำหรับการปรับใช้โดยเป็นไปตามไลเซนส์และความต้องการฮาร์ดแวร์ น้ำหนักเต็มของ K3.1 Pro ยังไม่ถูกเผยแพร่
Moonshot วางแผน ปล่อยน้ำหนัก K3.1 Pro ภายใน 4 พฤศจิกายน 2026 นี่คือแผนประกาศ ไม่ใช่เช็คพอยท์ที่มีให้แล้ว; ยืนยันน้ำหนักที่เผยแพร่และเงื่อนไขที่ใช้ก่อนวางแผน self-host
เกณฑ์ประเมินเพื่อผลิตจริง
เปรียบเทียบ K3 และ K3.1 Pro บนงานตัวแทน โดยใช้พรอมต์ เครื่องมือ เกณฑ์รับรอง ขีดจำกัดการลองซ้ำ และหมดเวลาเดียวกัน บันทึกการตั้งค่าผู้ให้บริการและการให้เหตุผล และเก็บข้อความผู้ช่วยครบถ้วนตามที่ API ต้องการ
วัดความสำเร็จของงาน latency การใช้โทเค็น และต้นทุนต่อภารกิจที่สำเร็จ รวมความล้มเหลวที่คิดเงินและการลองซ้ำ ทบทวนเคสที่ K3 สำเร็จแต่ K3.1 Pro ล้มเหลว สำหรับการประเมินโดยมนุษย์ ให้ซ่อนฉลากโมเดลและสุ่มลำดับเอาต์พุต
หาก K3.1 Pro ผ่านเกณฑ์คุณภาพ latency และต้นทุน ให้ปล่อยใช้งานทีละน้อยพร้อม K3 เป็น fallback ที่ทดสอบแล้ว
การย้ายระบบอย่างควบคุมและ Fallback
แนวทางปฏิบัติคือเริ่มส่งทราฟฟิกโปรดักชันส่วนเล็กไปที่ K3.1 Pro
คง K3 เป็น fallback ระหว่างการตรวจสอบ เปรียบเทียบคุณภาพงาน latency อัตราความล้มเหลว และค่าใช้จ่าย ก่อนเพิ่มสัดส่วนการใช้ K3.1 Pro
ให้ใส่ใจเป็นพิเศษกับสคีมาของการเรียกเครื่องมือ ฟิลด์ข้อความที่เกี่ยวกับ reasoning อินพุตมัลติโหมด และการพาร์สเอาต์พุต ความเข้ากันได้ของ API ไม่ได้การันตีว่าพฤติกรรมแอปเหมือนกัน
ผลกำไรและการถดถอยของ Benchmark
หากทั้งสองโมเดลตอบ 43 คำถามเดียวกันและได้ 35 และ 42 คะแนน K3.1 Pro อาจแก้ 7 เคสที่ K3 ผิดโดยไม่ถดถอย หรือแก้ 8 เคสแต่เสีย 1 คำตอบที่เคยถูก คะแนนรวมแยกไม่ออกว่ากรณีใดเกิดขึ้น
ตรวจคำตอบเป็นคู่ และจัดประเภทเป็น ถูกทั้งคู่, ถูกเฉพาะ K3, ถูกเฉพาะ K3.1 Pro, หรือผิดทั้งคู่ ทบทวนความสำเร็จเฉพาะของ K3 ต่อภารกิจที่มีผลกระทบสูงที่สุดก่อนย้าย 42/43 อธิบายเฉพาะชุดทดสอบนั้น; ไม่ได้การันตีอัตราสำเร็จ 97.7% บนงานอื่น
การประเมินเอาต์พุตแบบปิดบัง
ซ่อนฉลากโมเดลและสุ่มลำดับที่รีวิวเอาต์พุต กำหนดรูบริกการรับรองก่อนรีวิว: สำหรับโค้ด ใช้การทดสอบที่รันได้และเช็ครีเกรสชัน; สำหรับงานวิจัย ตรวจแหล่งที่มา การคำนวณ และความครบถ้วนของผลส่งมอบ ให้คะแนนความถูกต้องก่อนพิจารณาการนำเสนอหรือสไตล์
เปิดเผยตัวตนโมเดล latency และค่าที่เรียกเก็บหลังจากบันทึกการประเมินคุณภาพแล้ว แยกคุณภาพเอาต์พุตออกจากความคาดหวังเกี่ยวกับโมเดลใหม่ แก้ความเห็นต่างของผู้รีวิวโดยอิงการทดสอบหรือแหล่งข้อมูลเดียวกัน และเก็บผลการตัดสินเพื่อประเมินการเปลี่ยนโมเดลหรือพรอมต์ในภายหลังอย่างสอดคล้อง
เข้าถึง Kimi K3.1 Pro และ Kimi K3 ได้ที่ไหน?
การเข้าถึงจากผู้ให้บริการทางการ
ใช้ Kimi K3 API หรือ Kimi K3.1 Pro API ตามเอกสารของ Moonshot เพื่อเชื่อมต่อโดยตรง ตรวจสอบตัวระบุโมเดล ฟิลด์คำขอที่รองรับ และขีดจำกัดบัญชีของเอ็นด์พอยต์ที่เลือก การเข้าถึง API สาธารณะและน้ำหนักโมเดลดาวน์โหลดเป็นตัวเลือกการปรับใช้แยกกัน
การเข้าถึงผ่าน CometAPI
นักพัฒนาสามารถเข้าถึง Kimi K3.1 Pro API และ Kimi K3 API ผ่านอินเทอร์เฟซแบบรวมของ CometAPI และเปรียบเทียบทั้งสองเส้นทางด้วยเวิร์กโหลดของแอปเดียวกัน
สิ่งนี้ทำให้การย้ายจาก K3 ไป K3.1 Pro ค่อนข้างตรงไปตรงมา โดยเฉพาะแอปที่ใช้อินเทอร์เฟซแชทที่เข้ากันกับ OpenAI อยู่แล้ว
หากต้องการใช้ CometAPI สร้างบัญชีและคีย์ API จากนั้นกำหนดค่าแอปของคุณด้วยเอ็นด์พอยต์และตัวระบุโมเดลใน เอกสารการเชื่อมต่อ เลือก kimi-k3 สำหรับ K3, kimi-k3.1-pro สำหรับ K3.1 Pro มาตรฐาน หรือ kimi-k3.1-pro-highspeed สำหรับเส้นทาง Highspeed ที่รองรับ เริ่มด้วยคำขอเล็ก แล้วเปรียบเทียบเวิร์กโหลดเดียวกันข้ามโมเดลพร้อมตรวจผลลัพธ์ที่ส่งกลับ latency และการใช้งานที่เรียกเก็บเงิน
บทสรุป
Kimi K3.1 Pro เป็นตัวเลือกที่แข็งแรงกว่าในการเขียนโค้ดอัตโนมัติ งานวิจัยการเงิน และเวิร์กโฟลว์เอเจนต์แบบขยาย ตามการประเมินที่ทบทวน Kimi K3 ยังมีความสำคัญสำหรับการ self-host ทันทีและเวิร์กโหลดที่ความแม่นยำหรือโปรไฟล์ latency ปัจจุบันเพียงพอแล้ว
ตัดสินใจด้วยงานตัวแทนและเส้นทางผู้ให้บริการจริง เปรียบเทียบผลลัพธ์ที่สำเร็จ latency และค่าใช้จ่ายรวม แล้วค่อยๆ ย้ายใช้งาน ราคาต่อโทเค็นที่ต่ำลงและคะแนน benchmark รวมที่สูงขึ้นเป็นจุดเริ่มที่ดี แต่ไม่ได้กำหนดคอนฟิกที่ดีที่สุดสำหรับทุกแอปพลิเคชัน