
TL;DR
MiniMax M3.1 Flash เป็นโมเดล AI ความเร็วสูงที่ออกแบบมาสำหรับเอเจนต์อัตโนมัติ วิศวกรรมซอฟต์แวร์ การใช้งานคอมพิวเตอร์ และระบบอัตโนมัติของเวิร์กโฟลว์ที่ซับซ้อน เปิดตัวอย่างเป็นทางการเมื่อวันที่ 19 ตุลาคม 2026 ผสานหน้าต่างบริบทขนาด 1 ล้านโทเค็นเข้ากับระดับความลึกของการให้เหตุผลที่ปรับได้ และต้นทุนการอนุมานที่ต่ำลง
MiniMax รายงานอัตราการสร้างเอาต์พุตมากกว่า 200 โทเค็นต่อวินาที ลดต้นทุนภาระงานของเอเจนต์ลง 70% เมื่อเทียบกับรุ่นก่อน และมีประสิทธิภาพที่สามารถแข่งขันได้บน Automation-Bench, DeepSWE และ OSWorld ด้วยราคา $0.15 ต่อหนึ่งล้านโทเค็นอินพุต และ $0.60 ต่อหนึ่งล้านโทเค็นเอาต์พุต โมเดลนี้ทำให้เวิร์กโฟลว์เอเจนต์ AI แบบหลายขั้นตอนประหยัดยิ่งขึ้น
Key Takeaways
- ประสิทธิภาพของ MiniMax M3.1 Flash: เกณฑ์วัดจากผู้พัฒนา ได้แก่ Automation-Bench 62.8, DeepSWE v1.1 73.7 และ OSWorld 2.0 61.7 สะท้อนศักยภาพด้านการทำงานอัตโนมัติของเอเจนต์ การเขียนโค้ด และการใช้งานคอมพิวเตอร์
- ราคา API ของ MiniMax M3.1 Flash: อัตราทางการคือ $0.15/ล้านอินพุต, $0.60/ล้านเอาต์พุต และ $0.015/ล้านสำหรับอินพุตที่แคชไว้ ส่วน CometAPI คิด $0.80/ล้านอินพุต และ $3.20/ล้านเอาต์พุต ณ วันที่ 21 ตุลาคม 2026 โดยไม่มีการประกาศอัตราแคชบนหน้ารายการโมเดล
- ความเร็วการอนุมานของ MiniMax M3.1 Flash: MiniMax รายงานมากกว่า 200 โทเค็น/วินาทีภายใต้เงื่อนไขที่เอื้ออำนวย และ P50 สูงกว่า 170 โทเค็น/วินาที รองรับเวิร์กโฟลว์เอเจนต์ที่ตอบสนองทันใจ
- ประสิทธิภาพของเอเจนต์ด้วย MiniMax M3.1 Flash: ระดับความพยายามในการให้เหตุผล 5 ระดับ ช่วยให้นักพัฒนาปรับสมดุลระหว่างอัตราสำเร็จ ความหน่วง และต้นทุนรวมของเอเจนต์ AI
- การเข้าถึง API ของ MiniMax M3.1 Flash: นักพัฒนาสามารถเข้าถึงผ่าน MiniMax หรือสำรวจการเชื่อมต่อผ่าน CometAPI โดยใช้รหัสโมเดลและราคาที่เฉพาะผู้ให้บริการ
What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash เป็นโมเดลภาษารุ่นถัดไปที่ปรับให้เหมาะกับการให้เหตุผลเชิงเอเจนต์ การเขียนโค้ด การใช้เครื่องมือ และการดำเนินเวิร์กโฟลว์อัตโนมัติ MiniMax ได้ประกาศเปิดตัว M3.1 Flash อย่างเป็นทางการ เมื่อวันที่ 19 ตุลาคม 2026
แทนที่จะมุ่งเน้นเฉพาะความฉลาดเชิงสนทนาหรือคะแนนแบบโดดเดี่ยว โมเดลนี้มุ่งเป้าไปที่ต้นทุนรวมของการทำงานให้เสร็จผ่านการให้เหตุผลซ้ำๆ การเรียกใช้เครื่องมือ และการดำเนินการหลายขั้นตอน MiniMax ยังเชื่อมโยงการพัฒนาในช่วงแรกกับ Space Bunny โมเดลที่เปิดใช้งานแบบไม่เปิดเผยตัว ซึ่งระบุว่าสามารถประมวลผลโทเค็นได้มากกว่า 200 ล้านล้านโทเค็นก่อนการประกาศ; นี่เป็นตัวเลขการใช้งานที่รายงาน ไม่ใช่จำนวนโทเค็นฝึกที่เผยแพร่
สำหรับนักพัฒนาที่สร้างผู้ช่วยเขียนโค้ดแบบอัตโนมัติ เพื่อนร่วมงาน AI สำหรับองค์กร และเอเจนต์ที่ทำงานบนเบราว์เซอร์ M3.1 Flash มอบข้อได้เปรียบสำคัญสามประการ: ความจุบริบทขนาดใหญ่ การสร้างผลลัพธ์ที่รวดเร็ว และการใช้โทเค็นที่มีต้นทุนต่ำ
What Are MiniMax M3.1 Flash’s Specifications?
| API specifications | MiniMax M3.1 Flash |
|---|---|
| Developer | MiniMax |
| Official release | October 19, 2026 |
| Model family | MiniMax M3 |
| Context window | 1,000,000 tokens |
| Primary capabilities | การทำงานอัตโนมัติของเอเจนต์, การเขียนโค้ด, การให้เหตุผล, การใช้งานคอมพิวเตอร์ |
| Input modalities | ข้อความ รูปภาพ และวิดีโอ ผ่าน API ที่รองรับรูปแบบ OpenAI ของ MiniMax; โปรดยืนยันการรองรับกับผู้ให้บริการรายอื่น |
| Output modality | ข้อความ |
| Reasoning controls | ต่ำ, ปานกลาง, สูง, สูงมาก, สูงสุด |
| Reported output speed | สูงสุด 200+ tokens/s |
| Reported P50 speed | 170+ tokens/s |
| Access channels | MiniMax API, M Plan, MiniMax Code |
| Open weights | ประกาศว่าจะเปิดเผยในอนาคต |
| M3.1-specific parameter count | ไม่ได้ระบุไว้ในการประกาศ |
หน้าต่างบริบทขนาดใหญ่มีประโยชน์ต่อเวิร์กโฟลว์ด้านโค้ดระดับรีโพสิทอรีและงานเอกสารจำนวนมาก แต่ไม่ได้รับประกันการเรียกคืนข้อมูลที่สมบูรณ์แบบ เอเจนต์สำหรับงานจริงควรใช้การดึงข้อมูลแบบเลือกสรร การตอบสนองของเครื่องมือที่มีโครงสร้าง และการบีบอัดบริบท
การตั้งค่าความพยายามในการให้เหตุผล 5 ระดับช่วยให้นักพัฒนาสงวนการคำนวณอย่างเข้มข้นไว้สำหรับงานที่ซับซ้อน เช่น การวางแผนและการดีบัก แทนที่จะใช้ความพยายามสูงสุดกับทุกงานง่ายๆ เช่น การจัดประเภท การดึงข้อมูล หรือการเลือกเครื่องมือ เนื่องจากคำขอของเอเจนต์ครั้งเดียวอาจกระตุ้นการเรียกโมเดลหลายสิบครั้ง การประหยัดเล็กน้อยในขั้นตอนประจำสามารถลดต้นทุนรวมได้อย่างมีนัยสำคัญ
How Does MiniMax M3.1 Flash Perform on Benchmarks?
MiniMax รายงานผลเบนช์มาร์กครอบคลุมการทำงานอัตโนมัติทางธุรกิจ วิศวกรรมซอฟต์แวร์ การใช้งานคอมพิวเตอร์ ความปลอดภัยไซเบอร์ และการให้เหตุผลแบบมัลติโหมด ซึ่งเป็นการประเมินโดยผู้ขาย ไม่ใช่สิ่งทดแทนการทดสอบแบบอิสระในการใช้งานจริง
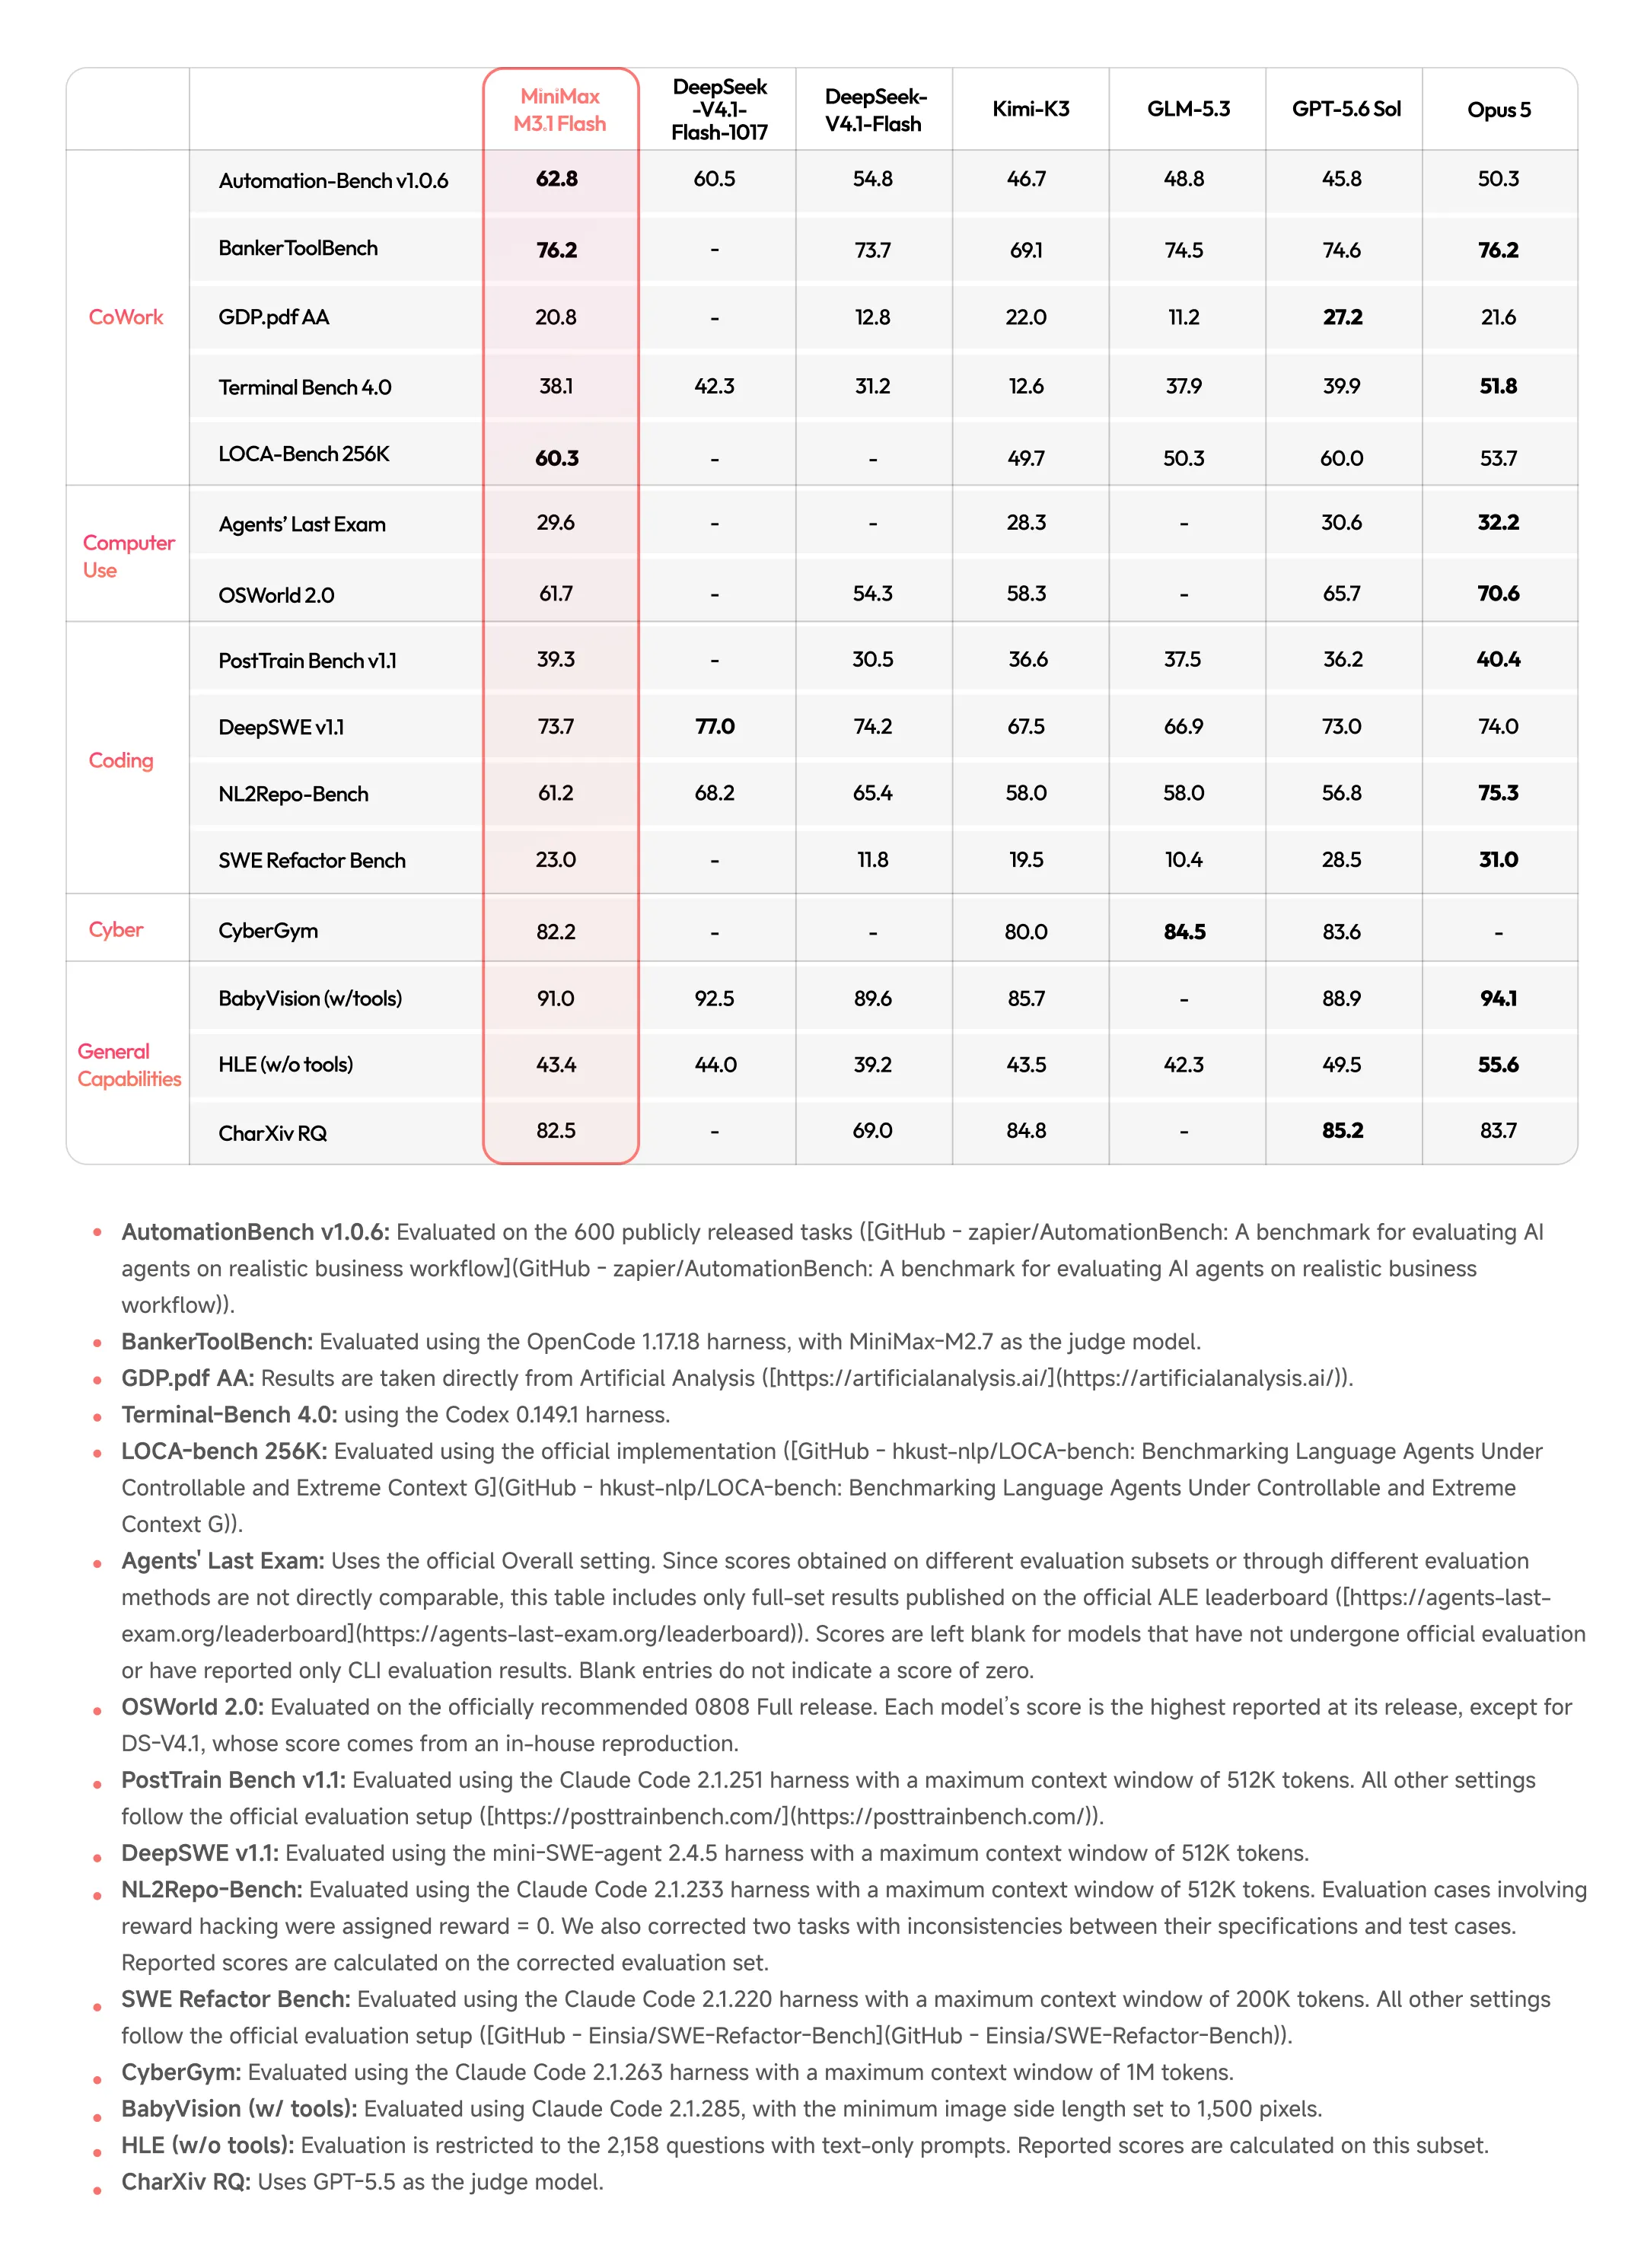
การเปรียบเทียบเบนช์มาร์กอย่างเป็นทางการของ MiniMax พร้อมบันทึกการประเมิน คะแนนเป็นข้อมูลที่ผู้ขายรายงานและไม่ใช่การทดสอบอิสระมาตรฐานเดียวกัน
| Official benchmark results | M3.1 Flash | What it measures |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | การทำงานอัตโนมัติทางธุรกิจแบบหลายขั้นตอน |
| BankerToolBench | 76.2 | การให้เหตุผลด้านการเงินและการใช้เครื่องมือ |
| LOCA-Bench 256K | 60.3 | การดำเนินงานเอเจนต์ในบริบทยาว |
| DeepSWE v1.1 | 73.7 | วิศวกรรมซอฟต์แวร์แบบอัตโนมัติ |
| Terminal Bench 4.0 | 38.1 | การแก้ปัญหาบนเทอร์มินัล |
| OSWorld 2.0 | 61.7 | ปฏิสัมพันธ์กับเดสก์ท็อป/คอมพิวเตอร์ |
| Agents’ Last Exam | 29.6 | งานเศรษฐศาสตร์ที่ซับซ้อน |
| CyberGym | 82.2 | การแก้ปัญหาด้านความปลอดภัยไซเบอร์ |
| BabyVision with tools | 91.0 | การให้เหตุผลด้วยภาพร่วมกับเครื่องมือ |
| HLE without tools | 43.4 | ความรู้และการให้เหตุผลที่ท้าทาย |
Automation-Bench v1.0.6 ใช้งาน 600 งานสาธารณะ BankerToolBench ใช้ OpenCode 1.17.18 โดยมี MiniMax-M2.7 เป็นผู้ตัดสิน; Terminal Bench 4.0 ใช้ Codex 0.149.1 DeepSWE v1.1 ใช้ mini-SWE-agent 2.4.5 พร้อมขีดจำกัดบริบท 512K OSWorld ใช้รุ่น 0808 Full: ตารางรวมคะแนนสูงสุดของแต่ละโมเดลในแต่ละรุ่น ยกเว้น DeepSeek V4.1 ที่ MiniMax ทำซ้ำภายใน การตั้งค่าที่แตกต่างกันเหล่านี้จำกัดความสามารถในการสรุปเปรียบเทียบข้ามโมเดลโดยตรง
สำหรับการทำงานอัตโนมัติทางธุรกิจ ให้ให้ความสำคัญกับ Automation-Bench และ BankerToolBench; สำหรับเอเจนต์ด้านโค้ด ให้พิจารณา DeepSWE และผลลัพธ์บนเทอร์มินัล OSWorld ประเมินการโต้ตอบกับสภาพแวดล้อมคอมพิวเตอร์ ไม่ใช่แค่การสร้างชุดคำสั่งเพียงอย่างเดียว คะแนนรวมเดียวไม่สามารถทดแทนการวิเคราะห์เฉพาะงานได้
How Fast Is MiniMax M3.1 Flash?
ระบบเอเจนต์มักเรียกโมเดลแบบลำดับหลายครั้ง ดังนั้นอัตราการส่งผ่านเพียงอย่างเดียวไม่สามารถอธิบายความคล่องตัวของการตอบสนองได้
| Speed metric | Reported performance |
|---|---|
| Everyday peak output throughput | 200+ tokens/s |
| Median output throughput (P50) | 170+ tokens/s |
| Online inference improvement | เกือบ 3× เทียบกับรุ่นก่อน |
| Agent workload cost reduction | ลดลง 70% เทียบกับรุ่นก่อน |
ตัวเลขความเร็วและต้นทุนภาระงานของเอเจนต์ที่รายงานโดยผู้ขายนี้อธิบายการประเมินในช่วงเปิดตัวของ MiniMax ไม่ใช่การรับประกันอัตราส่งผ่านหรือการประหยัดสำหรับทุกแอปพลิเคชัน รายละเอียดฮาร์ดแวร์ การทำงานพร้อมกัน ความยาวพรอมป์ และความแปรปรวนจากการรันซ้ำไม่ได้ระบุไว้อย่างครบถ้วนในประกาศ
เวลาแฝงปลายทางยังรวมถึงเวลาจนโทเค็นแรก เวลาการให้เหตุผล เวลาทำงานของเครื่องมือ การลองใหม่ และการพึ่งพากันระหว่างขั้นตอน ตัวสร้างที่เร็วกว่าอาจเสียเปรียบได้หากเอเจนต์ต้องเรียกโมเดลมากครั้งขึ้นเพื่อทำงานให้เสร็จ
How Much Does MiniMax M3.1 Flash API Cost?
MiniMax ประกาศอัตรามาตรฐานแบบคงที่สำหรับ M3.1 Flash โดยไม่มีระดับราคาพิเศษสำหรับบริบทยาวในคำอธิบายราคาชุดแรก ขณะเดียวกัน MiniMax M3.1 Flash Preview API ใน CometAPI มีโครงสร้างราคาที่แตกต่าง โดยให้ส่วนลด 20% จากอัตราอ้างอิงที่แสดง
| Pricing category | Official M3.1 Flash | CometAPI Preview (≤512K) | CometAPI Preview (>512K) |
|---|---|---|---|
| Input tokens / 1M | $0.15 | $0.24 | $0.48 |
| Output tokens / 1M | $0.60 | $0.96 | $1.92 |
| Cached input / 1M | $0.02 | $0.05 | $0.10 |
| Pricing structure | อัตราคงที่ | ระดับบริบทสั้น | ระดับบริบทยาว |
ราคา API อย่างเป็นทางการของ MiniMax ทำให้ M3.1 Flash น่าสนใจเป็นพิเศษสำหรับภาระงานของเอเจนต์ โทเค็นเอาต์พุตมีค่าใช้จ่ายสี่เท่าของอัตราอินพุตมาตรฐาน ในขณะที่อินพุตที่แคชมีค่าใช้จ่ายเพียงหนึ่งในสิบ ดังนั้นคำสั่งที่ส่งซ้ำและประวัติการใช้เครื่องมือจึงอาจกลายเป็นเป้าหมายสำคัญสำหรับการปรับให้เหมาะสม
ราคา Preview ของ CometAPI เริ่มที่ $0.24 ต่อหนึ่งล้านโทเค็นอินพุต และ $0.96 ต่อหนึ่งล้านโทเค็นเอาต์พุต ซึ่งคิดเป็นส่วนลด 20% เมื่อเทียบกับราคาอ้างอิงแบบ Preview ที่แสดง อย่างไรก็ตาม อัตราเหล่านี้ยังสูงกว่าราคาทางการของ M3.1 Flash ที่เพิ่งประกาศ เนื่องจากข้อเสนอทั้งสองยึดฐานราคาที่ต่างกัน
สำหรับนักพัฒนา ความแตกต่างสำคัญคือ CometAPI มีประสบการณ์การผสานรวมแบบรวมศูนย์ ในขณะที่เวอร์ชันทางการมีอัตราโทเค็นที่เผยแพร่ต่ำกว่าในขณะนี้ ก่อนการปรับใช้ ควรยืนยันเวอร์ชันโมเดลที่ใช้งาน ระดับความยาวบริบท และกฎการคิดค่าบริการ เพื่อคาดการณ์ต้นทุนของเวิร์กโฟลว์เอเจนต์อัตโนมัติได้อย่างแม่นยำ
MiniMax M3.1 Flash Cost per Agent Task
Estimated inference cost = (uncached input tokens × input rate + cached input tokens × cache rate + output tokens × output rate) / 1,000,000.
| Illustrative workload | Uncached input | Cached input | Output | Est. cost |
|---|---|---|---|---|
| Simple tool assistant | 10K | 0 | 2K | $0.0027 |
| Pull request review | 40K | 20K | 8K | $0.0111 |
| Multi-step coding agent | 100K | 200K | 30K | $0.0360 |
| Enterprise research | 300K | 700K | 80K | $0.1035 |
| Large autonomous workflow | 1M | 3M | 200K | $0.3150 |
เป็นการคำนวณตัวอย่าง ไม่ใช่การเรียกเก็บเงินจริง สมมติว่าอินพุตที่อ่านจากแคชมีสิทธิ์ใช้อัตราแคชที่ประกาศไว้; ไม่รวมค่าบริการของเครื่องมือ การค้นหา เบราว์เซอร์ โครงสร้างพื้นฐาน และการตรวจทานโดยมนุษย์
Reasoning Effort and Task Cost
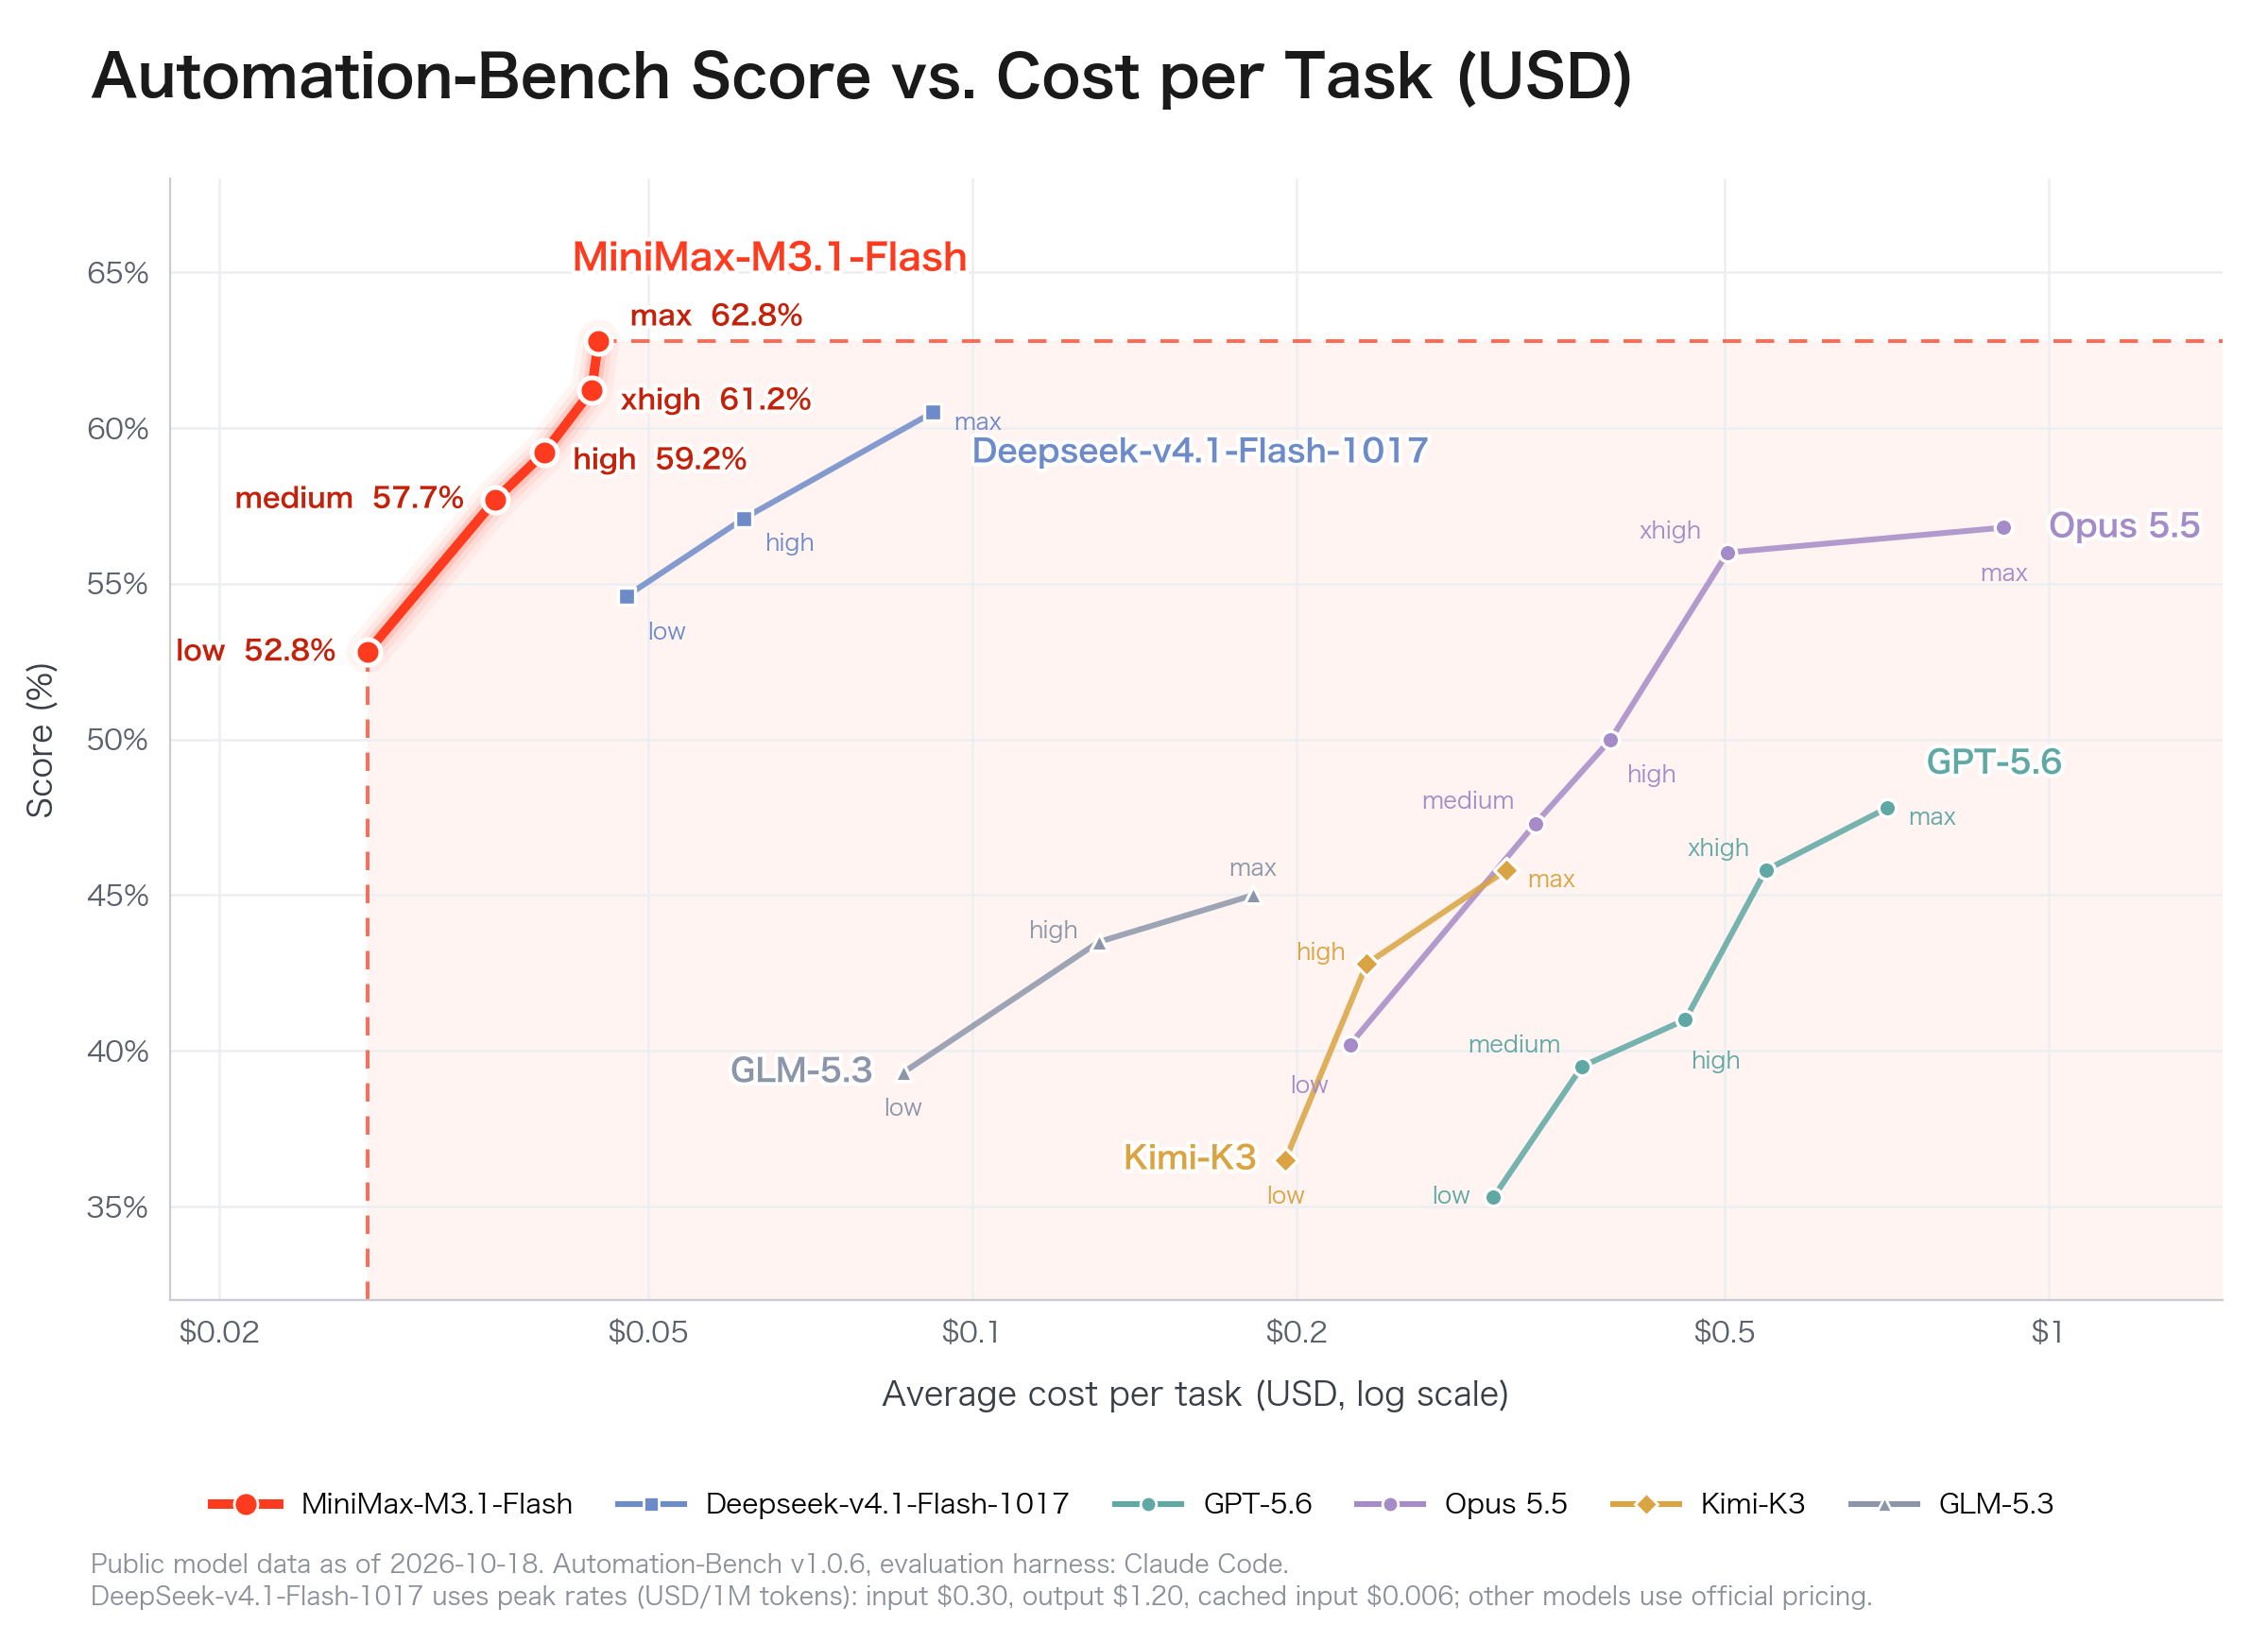
การวิเคราะห์ต้นทุนของ Automation-Bench โดย MiniMax เชื่อมโยงระดับความพยายามในการให้เหตุผลกับความสำเร็จบนเบนช์มาร์กและค่าใช้จ่ายในการอนุมานต่อหนึ่งงาน
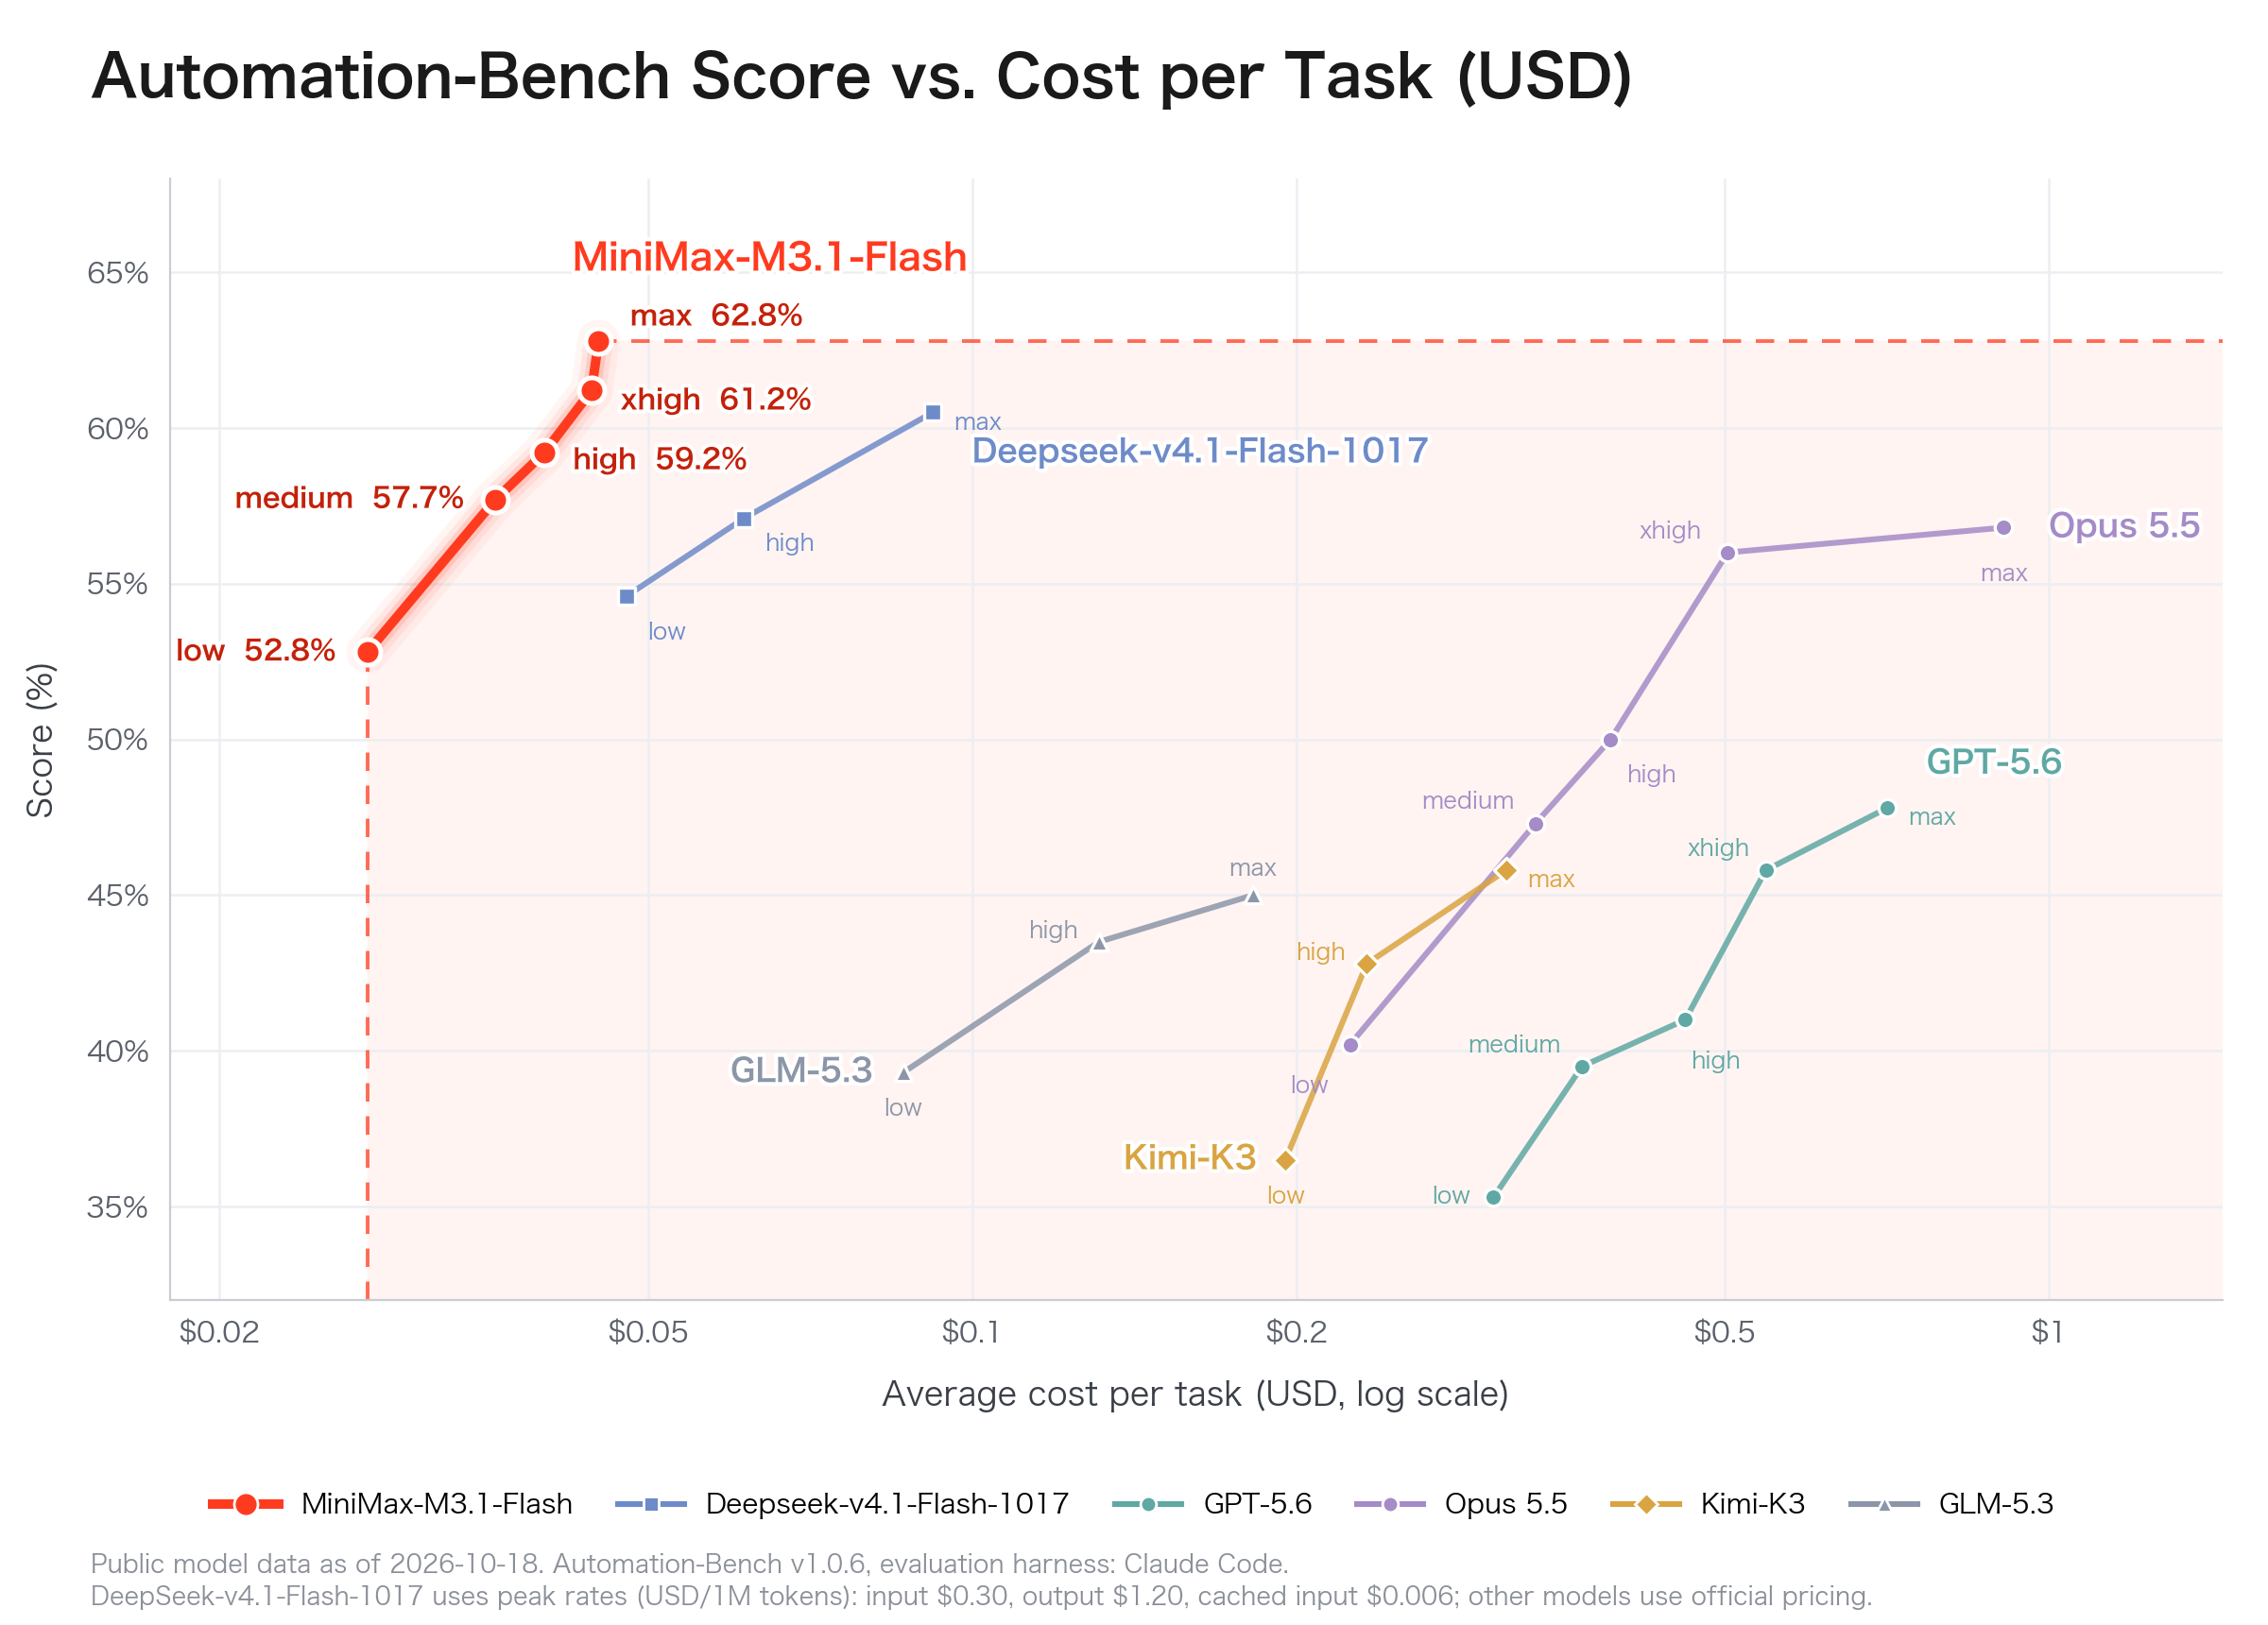
แผนภูมิความสัมพันธ์ระหว่างคะแนนกับต้นทุนบน Automation-Bench อย่างเป็นทางการของ MiniMax แกนแนวนอนเป็นลอการิทมิก; ไม่มีการพิมพ์ต้นทุนเป็นดอลลาร์ที่แน่นอนสำหรับจุดข้อมูลของ MiniMax แต่ละระดับ
บันทึกการประเมินของแผนภูมิอย่างเป็นทางการ ระบุ Automation-Bench v1.0.6 โดยใช้ Claude Code harness และข้อมูลโมเดลสาธารณะ ณ วันที่ 18 ตุลาคม 2026 DeepSeek ใช้อัตราโทเค็นสูงสุด; โมเดลอื่นใช้อัตราทางการ รายละเอียดฮาร์ดแวร์และช่วงความเชื่อมั่นจากการรันซ้ำไม่ได้ระบุไว้
| Reasoning effort | Labeled Automation-Bench score |
|---|---|
| ต่ำ | 52.8% |
| ปานกลาง | 57.7% |
| สูง | 59.2% |
| สูงมาก | 61.2% |
| สูงสุด | 62.8% |
ตารางเปรียบเทียบอย่างเป็นทางการปัจจุบันและจุดที่ใช้ความพยายามสูงสุดต่างก็แสดง 62.8 เส้นโค้งต้นทุนเปรียบเทียบการตั้งค่าความพยายามภายในชุดการประเมินของผู้ขาย; ไม่ได้ระบุต้นทุนดอลลาร์คงที่สำหรับเอเจนต์ในการใช้งานจริง
คะแนนที่ติดฉลากเพิ่มขึ้น 10 จุดเปอร์เซ็นต์จากระดับต่ำไปสูงสุด สำหรับการปรับใช้จริง ให้เปรียบเทียบระดับปานกลางกับระดับที่สูงกว่าในชุดงานคงที่ โดยนับความพยายามที่ล้มเหลวและการลองใหม่ในต้นทุนรวม เลือกการตั้งค่าที่บรรลุเป้าหมายคุณภาพด้วยต้นทุนต่อหนึ่งงานที่ยอมรับได้น้อยที่สุด
How Can Developers Access MiniMax M3.1 Flash Through CometAPI?
นักพัฒนาสามารถเข้าถึง MiniMax M3.1 Flash API ใน CometAPI แค็ตตาล็อกสาธารณะที่ตรวจสอบเมื่อวันที่ 20 ตุลาคม 2026 แสดงรหัสโมเดล minimax-m3.1-flash แม้ว่า URL ยังมีคำต่อท้าย preview อยู่ ควรใช้รหัสโมเดลที่ใช้งานได้กับบัญชีของคุณ แทนการเดาจาก URL ของหน้า
ส่งคำขอ POST ไปที่ https://api.cometapi.com/v1/chat/completions พร้อมส่วนหัว Authorization: Bearer YOUR_COMETAPI_KEY และ Content-Type: application/json ในเนื้อหา JSON ตั้งค่า model เป็น minimax-m3.1-flash (หากเปิดให้บัญชีของคุณ) และระบุอาร์เรย์ messages ดูรายละเอียดคำขอใน เอกสารประกอบ CometAPI
ทำไมต้องใช้ CometAPI? คีย์ API แบบรวม รูปแบบคำขอที่เข้ากันได้ และแดชบอร์ดการใช้งานช่วยให้ทำงานข้ามผู้ให้บริการโมเดลง่ายขึ้น สำหรับ MiniMax M3.1 Flash จงชั่งน้ำหนักความสะดวกในการผสานรวมกับราคาที่เฉพาะผู้ให้บริการ และยืนยันฟีเจอร์ที่ใช้งานได้กับบัญชีของคุณ
Which AI Agents Benefit Most From MiniMax M3.1 Flash?
| Use case | Why it may fit | Deployment consideration |
|---|---|---|
| Enterprise automation | ผลงานที่แข็งแกร่งบน Automation-Bench | ตรวจสอบการทำงานของเครื่องมือและการลองใหม่ |
| Coding assistants | ผลลัพธ์ DeepSWE ที่แข่งขันได้ | รันทดสอบและตรวจทานแพตช์ |
| Customer support | ราคาอินพุตและแคชที่ต่ำ | เฝ้าระวังความแม่นยำ |
| Research agents | หน้าต่างบริบท 1M | ตรวจสอบหลักฐานและแหล่งอ้างอิง |
| Computer-use agents | ความสามารถบน OSWorld | จัดการการเปลี่ยนแปลง UI และการกู้คืน |
| Security code review | ผลลัพธ์บน CyberGym | การตรวจยืนยันอย่างอิสระ |
ประโยชน์จะมากที่สุดเมื่อเอเจนต์ทำงานได้สำเร็จเพียงพอที่จะชดเชยต้นทุนจากการลองใหม่ การจัดการเวิร์กโฟลว์ และการตรวจทานโดยมนุษย์ การใช้งานจริงควรวัดทั้งระดับโมเดลและระดับเวิร์กโฟลว์
Is MiniMax M3.1 Flash the Best Value for AI Agents?
MiniMax M3.1 Flash เป็นตัวเลือกที่แข็งแกร่งสำหรับเอเจนต์ที่อ่อนไหวต่อราคา ซึ่งมีบริบทซ้ำและการใช้เครื่องมือที่มีโครงสร้าง แต่ราคาโทเค็นต่ำที่สุดไม่ได้หมายความว่าต้นทุนต่อหนึ่งงานที่สำเร็จจะต่ำที่สุดเสมอไป คำเรียกที่ล้มเหลว การลองใหม่เพิ่มเติม และการแทรกแซงของมนุษย์สามารถลบล้างการประหยัดได้ ประเมินอัตราการยอมรับผลลัพธ์ เวลาโดยรวม ต้นทุนต่อหนึ่งงานที่สำเร็จ และอัตราการแทรกแซงของมนุษย์
FAQ
ทำไม MiniMax M3.1 Flash จึงอาจส่งคำตอบว่างเปล่า?
บน API ที่เข้ากันได้กับ OpenAI ของ MiniMax โทเค็นสำหรับการคิดใช้โควตาการสร้าง หากโควตาน้อยเกินไป คำขออาจจบลงโดยมี finish_reason เป็น length ก่อนที่จะมีข้อความคำตอบที่มองเห็นได้ ตรวจสอบเหตุผลการสิ้นสุดและการใช้โทเค็น เพิ่มงบประมาณการสร้างเมื่อเหมาะสม และจัดการ reasoning_content แยกจากคำตอบสุดท้าย โปรดยืนยันกติกาการตอบกลับเดียวกันบนเส้นทางของผู้ให้บริการบุคคลที่สาม
ควรเก็บประวัติการเรียกใช้เครื่องมือของ MiniMax M3.1 Flash อย่างไร?
เก็บข้อความของผู้ช่วยทั้งฉบับ รวมทั้งการเรียกใช้เครื่องมือและเนื้อหาการให้เหตุผล ก่อนที่จะต่อท้ายผลลัพธ์ของเครื่องมือที่สอดคล้องกัน การบันทึกเฉพาะคำตอบที่มองเห็นได้อาจลบข้อมูลที่จำเป็นสำหรับขั้นตอนถัดไป รักษา IDs ของการเรียกเครื่องมือและลำดับข้อความ และตรวจสอบพฤติกรรมรีเพลย์โดยใช้เอ็นด์พอยต์ของผู้ให้บริการจริง คำแนะนำด้านประวัติการสนทนาของ MiniMax อธิบายข้อกำหนดของ API ดั้งเดิม
ทีมงานจะตรวจจับการเปลี่ยนแปลงการกำหนดเส้นทางของ MiniMax M3.1 Flash ได้อย่างไร?
เก็บชุดรีเกรสชันขนาดเล็กที่มีอินพุตคงที่ โครงสร้างผลลัพธ์ที่คาดหวัง และข้อกำหนดการเรียกใช้เครื่องมือ บันทึกรหัสโมเดลที่ร้องขอ ตัวระบุโมเดลที่ส่งกลับเมื่อมี ผู้ให้บริการ เวลาประทับ และการใช้งานที่เรียกเก็บเงิน เรียกใช้ซ้ำหลังการอัปเดตของผู้ให้บริการ; ใช้นามแฝงที่คงที่อย่างเดียวไม่อาจยืนยันได้ว่าจุดตรวจหรือพฤติกรรมพื้นฐานยังไม่เปลี่ยน
ควรวางแผนการย้ายไปใช้ MiniMax M3.1 Flash อย่างไร?
เริ่มจากงานอ่านอย่างเดียวหรือการรีเพลย์ จากนั้นส่งทราฟฟิกจริงส่วนเล็กในขณะที่ยังคงมีเส้นทางสำรองที่ทดสอบแล้ว กำหนดเกณฑ์การย้อนกลับสำหรับการเรียกใช้เครื่องมือที่ไม่ถูกต้อง การหมดเวลา และงานที่ไม่สำเร็จ ก่อนจะเพิ่มสัดส่วนทราฟฟิก ตรวจทานตัวอย่างเคสถดถอย แทนที่จะพึ่งค่าเฉลี่ยเพียงอย่างเดียว เพราะความล้มเหลวที่มีต้นทุนสูงจำนวนไม่มากอาจกลบการประหยัดจากราคาโทเค็นที่ต่ำลงได้
Conclusion
MiniMax M3.1 Flash ปรับปรุงเศรษฐศาสตร์ของเอเจนต์ AI อัตโนมัติด้วยโทเค็นราคาถูก การให้เหตุผลที่กำหนดได้ หน้าต่างบริบทขนาดใหญ่ และผลลัพธ์ด้านงานอัตโนมัติและการเขียนโค้ดที่แข็งแกร่งตามรายงาน ข้อได้เปรียบหลักอยู่ที่สมดุลระหว่างประสิทธิภาพ ความหน่วง และต้นทุนงาน — ไม่ใช่ความเป็นเลิศแบบสัมบูรณ์ในทุกเบนช์มาร์ก
นักพัฒนาควรตรวจวัดอัตราการทำงานสำเร็จจริงของเวิร์กโฟลว์และต้นทุนรวมของเอเจนต์ จากนั้นเลือกเส้นทาง MiniMax M3.1 Flash ที่มีการกำหนดค่า ฟีเจอร์ที่รองรับ และการคิดค่าบริการสอดคล้องกับความต้องการของตนเอง