

TL;DR
Muse Wonder, Claude Opus 5.5 และ GPT-6 Sol เป็นโมเดลสมรรถนะสูงที่เน้นงานโค้ดดิ้งและเวิร์กโฟลว์แบบเอเจนต์ Muse Wonder รุ่นใหม่ของ Meta เน้นหน่วยความจำถาวรและการประมวลผลต่อเนื่อง; Opus 5.5 นำในดัชนีสติปัญญาเชิงรวมที่อ้างอิง; GPT-6 Sol มีอัตราราคาอินพุต/เอาต์พุตมาตรฐานแบบบริบทสั้นต่ำสุดในการเปรียบเทียบนี้ ขณะที่ชั้นบริบทยาวมีการคิดราคาแยกต่างหาก ควรเลือกโดยใช้คุณภาพงานตัวแทน ความเชื่อถือได้ และต้นทุนรวม มากกว่าคะแนนลีดบอร์ดรายการเดียว
ประเด็นสำคัญ
- สติปัญญาโดยรวม: Claude Opus 5.5 ได้ 58 เทียบกับ Muse Wonder ที่ 52 บน Intelligence Index v4.3 ที่รายงาน
- การโค้ดระยะยาว: Muse Wonder ได้ 78.8 บน DeepSWE 1.1 และ 53.1 บน SWE-Marathon; Opus 5.5 ได้ 74.2 และ 46.3 ตามตารางของ Meta
- การให้เหตุผลต้นทุนต่ำ: GPT-6 Sol เริ่มต้นที่ $2 อินพุต / $10 เอาต์พุต ต่อ 1 ล้านโทเค็น ผ่าน API มาตรฐานแบบบริบทสั้นของ OpenAI
- เอเจนต์เน้นหน่วยความจำ: Muse Wonder เปิดตัว Active Memory และ Active Focus
- ความพร้อมใช้งานสำคัญ: Muse Wonder Full เป็นผลิตภัณฑ์แยกที่มีข้อจำกัดมากกว่ารุ่น Muse Wonder มาตรฐานสำหรับนักพัฒนา
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol โดยสรุป
เลือก Muse Wonder สำหรับเอเจนต์ที่มีความคงอยู่และงานวิศวกรรมที่ทำงานยาว, เลือก Claude Opus 5.5 สำหรับงานโค้ดดิ้งกว้างและงานที่พึ่งพาเทอร์มินัล, และเลือก GPT-6 Sol สำหรับต้นทุนโทเค็นมาตรฐานแบบบริบทสั้นที่ต่ำกว่า
| ปัจจัยในการตัดสินใจ | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| เริ่มทดสอบกับ | เอเจนต์ที่คงอยู่และวิศวกรรมระยะยาว | โค้ดดิ้งที่เน้นเทอร์มินัลและเวิร์กโฟลว์มืออาชีพ | โค้ดดิ้งและอัตโนมัติที่เน้นงบประมาณ |
| หน้าต่างบริบท | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| จุดแข็งที่ประกาศ | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Standard input/output $2/$10 per 1M tokens |
| อินพุต/เอาต์พุตมาตรฐานต่อ 1M โทเค็น | $4 / $20 | $4 / $20 | $2 / $10; short-context tier |
| การเข้าถึงจากผู้ให้บริการ | Meta Model API; Full เป็นผลิตภัณฑ์สมัครสมาชิกแยกต่างหาก | Anthropic API | OpenAI API |
| เกณฑ์การคัดเลือก | คุณภาพงานที่ยอมรับได้และต้นทุนรวม | คุณภาพงานที่ยอมรับได้และต้นทุนรวม | คุณภาพงานที่ยอมรับได้และต้นทุนรวม |
| ผู้พัฒนา | Meta | Anthropic | OpenAI |
| วันเปิดตัว | October 12, 2026 | September 22, 2026 | September 16, 2026 |
| โหมดอินพุต | Text, image, audio, video; มีเอกสารอินพุต PDF | Text, image | Text, image |
| เอาต์พุต | Text | Text | Text |
| ความสามารถที่โดดเด่น | Active Memory และ Active Focus | เวิร์กโฟลว์เครื่องมือและซับเอเจนต์ | ปรับระดับความพยายามในการให้เหตุผลและ API tools ได้ |
ภาพรวมนี้สรุปสเปกและผลที่เผยแพร่ไว้อย่างมีวันอ้างอิงตามด้านล่าง แถวของเกณฑ์วัดผลใช้วิธีประเมินต่างกัน และอัตราโทเค็นต่ำไม่ได้บ่งชี้ว่าต้นทุนต่อภารกิจที่สำเร็จจะต่ำกว่า รุ่น Muse Wonder มาตรฐานและ Muse Wonder Full เป็นตัวเลือกการเข้าถึงที่แตกต่างกัน
มีการตรวจสอบสเปกเมื่อ October 13, 2026 โมดาลิตีและฟีเจอร์ที่รองรับขึ้นกับปลายทางและพื้นผิวการเปิดตัวที่เลือก รวมถึงความพร้อมของเสียง ความสามารถระดับโมเดลไม่รับประกันการรองรับบนทุกช่องทางการเข้าถึง
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: ภาพรวมและสเปก
Muse Wonder: เวิร์กโฟลว์เอเจนต์แบบคงอยู่
Meta เปิดตัว Muse Wonder และ Muse Wonder Full เมื่อ October 12, 2026 รุ่น Muse Wonder มาตรฐานเน้นงานมืออาชีพที่ทำงานยาว หน่วยความจำเอเจนต์ที่คงอยู่ และการฟื้นตัวจากอุปสรรค Active Memory มีไว้เพื่อเรียกคืนบริบทที่เป็นประโยชน์ก่อนหน้า ขณะที่ Active Focus ออกแบบมาเพื่อคงความก้าวหน้าข้ามงานหลายขั้นตอน Meta ระบุการเขียนโค้ด การวิจัย การวิเคราะห์ทางการเงิน และผู้ช่วยส่วนตัวเป็นสถานการณ์หลัก
Claude Opus 5.5: โค้ดดิ้งมืออาชีพและการใช้เครื่องมือ
Claude Opus 5.5 มุ่งเป้าไปที่โค้ดดิ้ง การให้เหตุผล และเวิร์กโฟลว์มืออาชีพที่ใช้หลายเครื่องมือ Anthropic เปิดตัวเมื่อ September 22, 2026 มีหน้าต่างบริบทหนึ่งล้านโทเค็น และผลโค้ดดิ้งที่รายงานด้านล่างแสดงจุดแข็งที่แตกต่างตามเกณฑ์
GPT-6 Sol: การให้เหตุผลที่คำนึงถึงต้นทุน
GPT-6 Sol ตั้งใจผสานการให้เหตุผลและการใช้เครื่องมือที่แข็งแกร่งเข้ากับการประมวลผลที่คุ้มค่า รองรับเวิร์กโฟลว์แบบโปรแกรมผ่านระบบนิเวศ API ของ OpenAI อัตรามาตรฐานแบบบริบทสั้นต่ำกว่าที่ระบุของ Claude Opus 5.5 แม้ว่าเศรษฐศาสตร์ปลายทางจะขึ้นกับการลองซ้ำและการใช้โทเค็นให้เหตุผลด้วย
OpenAI อธิบาย GPT-6 Sol ว่าเป็นโมเดลสำหรับโค้ดดิ้งซับซ้อนและเวิร์กโฟลว์แบบเอเจนต์ โดยประกาศเปิดตัวพร้อมผลการประเมินที่ใช้ด้านล่าง บทความนี้เปรียบเทียบเวอร์ชันโมเดลที่ระบุ ไม่ใช่ทุกรุ่นใหม่สุดในสายผลิตภัณฑ์ของแต่ละผู้ให้บริการ
สถาปัตยกรรมและการกำหนดระดับการให้เหตุผล
แหล่งข้อมูลที่อ้างถึงไม่ได้ให้รายละเอียดจำนวนพารามิเตอร์และสถาปัตยกรรมที่เทียบกันได้สำหรับทั้งสามโมเดล จึงไม่อาจสรุปการจัดอันดับแบบ dense-versus-mixture-of-experts ได้ Active Memory และ Active Focus อธิบายความสามารถด้านเอเจนต์ของ Meta ไม่ใช่ตัวแทนของสถาปัตยกรรมประสาทที่เปิดเผย GPT-6 Sol เปิดให้กำหนดระดับความพยายามในการให้เหตุผลได้ ขณะที่คะแนนที่ Meta และ Claude รายงานก็ขึ้นกับความพยายามและการตั้งค่าการประเมินด้วย ควรมองการตั้งค่าเหล่านั้นเป็นส่วนหนึ่งของคอนฟิกูเรชันในการเปรียบเทียบ ไม่ใช่มาตรวัดคอมพิวต์ที่เทียบแทนกันได้
ผลการเปรียบเทียบ: ทั้งสามมีหน้าต่างบริบทขนาดใหญ่และ API สำหรับนักพัฒนา Muse Wonder มีเอกสารโมดาลิตีอินพุตในระดับโมเดลที่กว้างกว่า ขณะที่ Opus 5.5 และ GPT-6 Sol เน้นเวิร์กโฟลว์ข้อความและภาพ ความจุบริบทและความพร้อมของฟีเจอร์ยังต้องตรวจสอบบนปลายทางที่เลือก
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: ประสิทธิภาพ
เกณฑ์วัดผลที่เผยแพร่และขอบเขตแหล่งอ้างอิง
โมเดลการ์ดทางการของ Meta มีการเปรียบเทียบ Muse Wonder กับ Claude Opus 5.5 โดยตรง OpenAI เผยแพร่ผลของ GPT-6 Sol แยกกัน ดังนั้นทั้งสามโมเดลจึงยังไม่สามารถอยู่บนลีดบอร์ดเดียวที่ควบคุมเงื่อนไขได้อย่างสมบูรณ์โดยไม่ปรับฮาร์เนสประเมิน เวอร์ชัน และการตั้งค่าให้สอดคล้องกัน
| Benchmark | Muse Wonder | Claude Opus 5.5 | คะแนนสูงกว่า |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
ระเบียบวิธีของโมเดลการ์ดทางการ แยกการทดสอบภายใน การประเมินจากบุคคลที่สาม และคะแนนคู่แข่งที่ผู้ให้บริการรายงาน ตารางนี้ถอดค่าตามที่รายงาน ไม่ได้เป็นการทดสอบที่ควบคุมให้สม่ำเสมอและเป็นอิสระในทุกรายการ
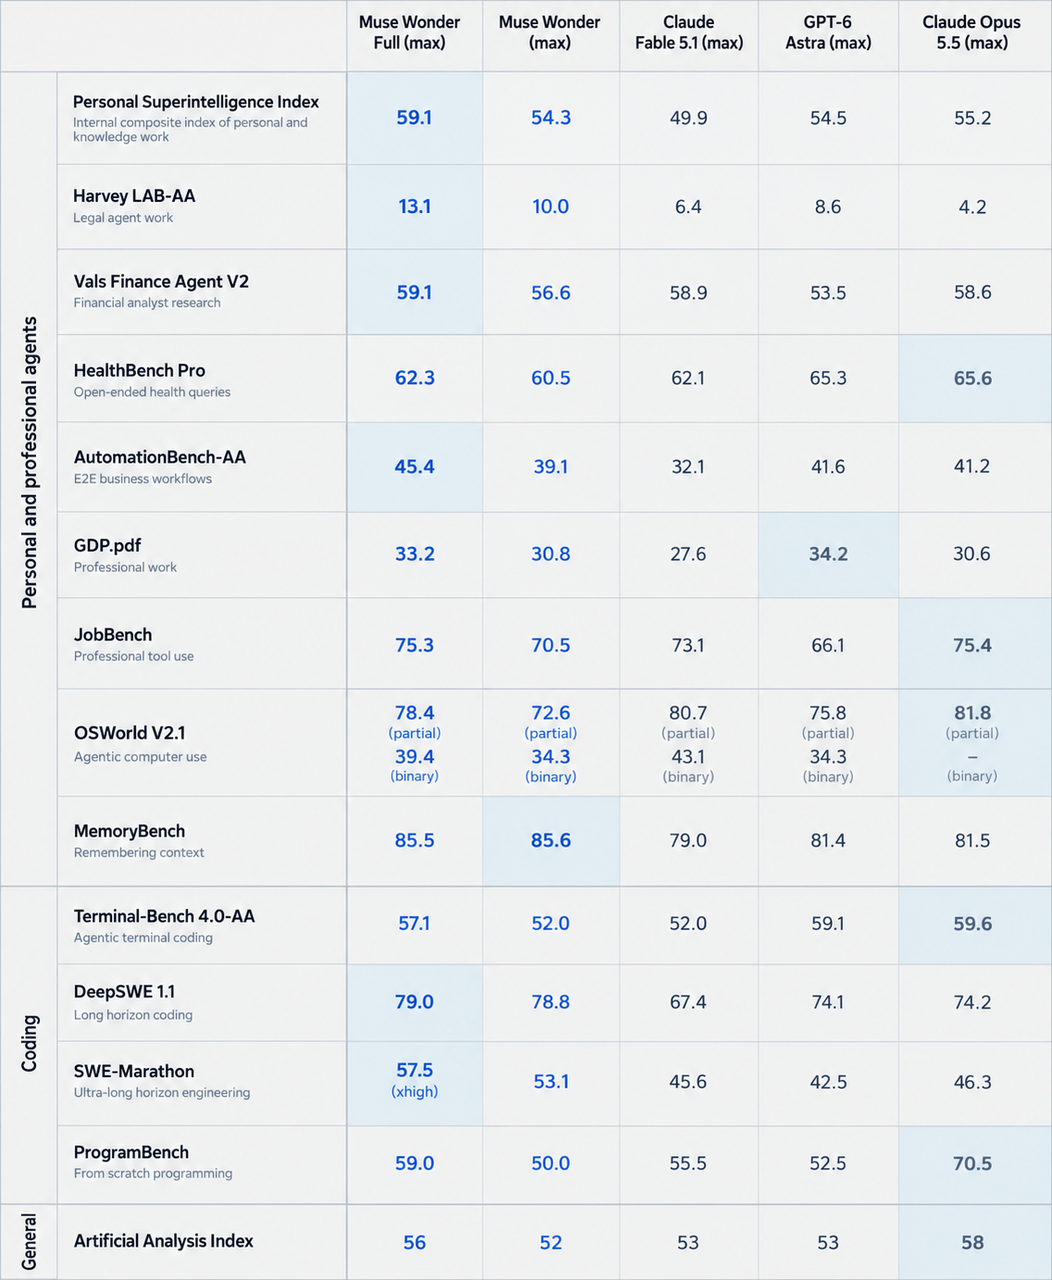
สกอร์การ์ดเกณฑ์วัดผลต้นฉบับจากโมเดลการ์ดของ Muse Wonder โดย Meta คัดลอกมาโดยไม่วาดใหม่ โมเดลของ OpenAI เพิ่มเติมที่แสดงในภาพทางการนี้คือ GPT-6 Astra ไม่ใช่ GPT-6 Sol ตารางประกอบรอบภาพระบุโมเดลที่เกี่ยวข้องกับบทความนี้
เงื่อนไขการประเมิน
DeepSWE v1.1 ครอบคลุม 113 งานใน 91 รีโพซิทอรีและ 5 ภาษา ประเมินด้วยการทดสอบการทำงานและรีเกรสชันโดยใช้ pass@1; สกอร์การ์ดของ Meta ใช้ผล Datacurve สำหรับ Muse Wonder และ Opus 5.5 SWE-Marathon ใช้การทดสอบของโปรเจกต์และรายงาน pass@1 จาก Abundant AI; ฮาร์เนสเอเจนต์แตกต่างกัน และคะแนนของ Wonder Full ถูกทำเครื่องหมายว่า xhigh ProgramBench ใช้ mini-swe-agent และวัดการรันที่ผ่านอย่างน้อย 95% ของเทสต์ที่ซ่อน โดยปิดอินเทอร์เน็ตหลังการตั้งค่า MemoryBench เป็นการทดสอบสนทนา 64K–100K โทเค็นภายในของ Meta ที่ให้คะแนนโดย LLM ผู้ตัดสิน สิ่งแวดล้อมและเมตริกเหล่านี้ไม่ควรถูกรวมเป็นคะแนนความแม่นยำทั่วไปเพียงค่าเดียว
การเขียนโค้ดและวิศวกรรมซอฟต์แวร์
Muse Wonder นำในผล DeepSWE 1.1 และ SWE-Marathon ที่รายงาน ขณะที่ Claude Opus 5.5 นำใน Terminal-Bench 4.0-AA และ ProgramBench ความแตกต่างนี้บ่งชี้ว่างานวิศวกรรมระยะยาว การใช้เครื่องมือผ่านเทอร์มินัล และการประกอบโปรแกรมใหม่ ทดสอบทักษะที่ต่างกัน
ผลของ GPT-6 Sol และความสามารถในการเทียบข้ามแหล่ง
| การประเมินที่ OpenAI เผยแพร่ | GPT-6 Sol | การตั้งค่าที่รายงาน |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maximum reasoning |
| AutomationBench 1.0.6 | 33.2% | xhigh reasoning |
| Agents' Last Exam V1 | 56.4% | Maximum reasoning |
| OSWorld 2.0 offline | 60.5% | xhigh reasoning |
ผลการประเมินที่ OpenAI เผยแพร่ รายงานคะแนนดังกล่าว ผล OSWorld เป็นรางวัลบางส่วนบนชุดออฟไลน์ v2026.08.08 ไม่ใช่อัตราการทำภารกิจสำเร็จอย่างเคร่งครัด OpenAI ระบุว่าการประเมินใช้สภาพแวดล้อมวิจัยหรือ API ของตน; การคอนฟิกในโปรดักชันอาจต่างออกไป
คะแนน DeepSWE ที่รายงานบ่งชี้ช่องว่าง 10.0 จุดเปอร์เซ็นต์ระหว่าง Muse Wonder กับ GPT-6 Sol และ 5.4 จุดระหว่าง Opus 5.5 กับ GPT-6 Sol เหล่านี้เป็นความต่างทางคณิตศาสตร์ระหว่างสิ่งพิมพ์ ไม่ใช่ค่าประมาณข้อได้เปรียบเฉพาะตัวโมเดลภายใต้การควบคุม ปัจจัยอย่างฮาร์เนสเอเจนต์ พรอมป์ต ระดับความพยายาม และงบเครื่องมือ สามารถส่งผลต่อผลลัพธ์ได้
หน่วยความจำและเอเจนต์ที่ทำงานยาว
Muse Wonder มุ่งเป้าเอเจนต์ที่ต้องจดจำการตัดสินใจก่อนหน้า เรียกคืนบริบท และทำงานต่อเมื่อถูกขัดจังหวะ Active Memory ช่วยให้ผู้ช่วยวิจัยจำข้อเท็จจริงเฉพาะโปรเจกต์ได้ ขณะที่ Active Focus สนับสนุนการดำเนินการแบบวนซ้ำเมื่อแผนก่อนหน้าไม่สำเร็จ ความสามารถเหล่านี้ไม่ทดแทนการตรวจสอบสถานะ สิทธิ์การเข้าถึง บันทึกตรวจสอบ หรือการยืนยันโดยมนุษย์ที่จำเป็นสำหรับการกระทำที่อ่อนไหว
ประสิทธิภาพของ Muse Wonder Full
Muse Wonder Full เป็นตัวเลือกผลิตภัณฑ์แยกต่างหาก Meta ให้บริการ Muse Wonder มาตรฐานผ่าน API ขณะที่ Full จำกัดอยู่ในแผนสมัครสมาชิก Power Usage และ Maximum Usage ใน Muse Code คะแนนที่สูงกว่าไม่ได้ทำให้ Full เป็นตัวแทน API แทนรุ่นมาตรฐานโดยอัตโนมัติ
ผลที่ Meta รายงานสำหรับ Wonder Full คือ 56 บน Intelligence Index, 59.1 บน Personal Superintelligence, 13.1 บน Harvey LAB-AA และ 45.4 บน AutomationBench-AA นอกจากนี้ยังได้ 79.0 บน DeepSWE 1.1, 57.5 บน SWE-Marathon, 85.5 บน MemoryBench และ 75.3 บน JobBench ผลที่เผยแพร่นี้อธิบายผลิตภัณฑ์ Full ที่เข้าถึงแยก ไม่ใช่มาตรวัดใหม่จากการเปรียบเทียบในฮาร์เนสร่วมเดียวกัน
เมื่อเทียบกับคะแนนของ Muse Wonder มาตรฐานด้านบน Full ดีขึ้นใน 7 จาก 8 มาตรวัดที่รายงาน; MemoryBench ต่ำลงเล็กน้อยที่ 85.5 เทียบกับ 85.6 Opus 5.5 ยังคงนำใน Intelligence Index ที่รายงานที่ 58
เวลาแฝงและความเชื่อถือได้
หลักฐานที่อ้างอิงไม่ได้นำเสนอการเปรียบเทียบเวลาแฝงสามโมเดลที่จับคู่กัน วัดเวลาถึงเอาต์พุตที่มีประโยชน์ครั้งแรก เวลางานสำเร็จแบบปลายทางถึงปลายทางค่ากลางและเปอร์เซ็นไทล์ที่ 95 ความถี่การหมดเวลา และการเสร็จสิ้นโดยไม่ต้องแทรกแซง คงค่าคงที่อินพุตภารกิจ สิทธิ์เครื่องมือ ความขนาน และเกณฑ์การยอมรับ; บันทึกการตั้งค่าความพยายามและงบประมาณการลองซ้ำ ความเร็วในการสร้างโทเค็นเพียงอย่างเดียวไม่ชี้ว่าการทำงานหลายขั้นตอนจะเสร็จเร็วกว่า
ผลการเปรียบเทียบ: Muse Wonder นำในแบบทดสอบวิศวกรรมต่อเนื่องที่อ้างอิง ขณะที่ Opus 5.5 นำในแบบทดสอบเทอร์มินัลและการประกอบโปรแกรม GPT-6 Sol ยังคงเป็นตัวเลือกที่มีอัตราโทเค็นต่ำกว่า แต่สิ่งพิมพ์ที่มีอยู่ไม่ได้พิสูจน์การจัดอันดับคุณภาพหรือความเร็วในสภาพแวดล้อมเท่าเทียมกันสำหรับทั้งสาม
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: ต้นทุน
ราคาต่อโทเค็นของ API ทางการ
| ราคา ต่อ 1M โทเค็น | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| อินพุตมาตรฐาน | $4 | $4 | $2 |
| เอาต์พุตมาตรฐาน | $20 | $20 | $10 |
| อินพุตที่แคช | $0.20 | $0.20 | $0.20 |
| อินพุตแบบบริบทยาว | $4 | $4 | $4 |
| เอาต์พุตแบบบริบทยาว | $20 | $20 | $15 |
| อินพุตแคชแบบบริบทยาว | $0.20 | $0.20 | $0.40 |
Meta เผยแพร่ราคา $4 อินพุต, $20 เอาต์พุต และ $0.20 อินพุตที่แคช ต่อ 1 ล้านโทเค็น Anthropic ระบุ Opus 5.5 ที่ $4 อินพุต, $20 เอาต์พุต และ $0.20 ต่อโทเค็นแคช OpenAI ตารางราคา ระบุ GPT-6 Sol ที่ $2/$10 สำหรับอินพุต/เอาต์พุตบริบทสั้น และ $4/$15 สำหรับบริบทยาว; อัตราอินพุตที่แคชก็แตกต่างตามชั้นด้วย ใช้อัตราและเงื่อนไขปลายทางตามชั้นบริบท โหมดประมวลผล และปลายทางคำขอที่เกี่ยวข้องก่อนประเมินงาน
สำหรับ GPT-6 Sol คำขอที่มีอินพุตมากกว่า 272,000 โทเค็น จะคิดราคาในอัตราที่สูงกว่า:
- โทเค็นอินพุต: 2× อัตรามาตรฐาน จาก $2 เป็น $4 ต่อ 1 ล้านโทเค็น
- โทเค็นอินพุตที่แคช: 2× อัตรามาตรฐาน จาก $0.20 เป็น $0.40 ต่อ 1 ล้านโทเค็น
- โทเค็นเอาต์พุต: 1.5× อัตรามาตรฐาน จาก $10 เป็น $15 ต่อ 1 ล้านโทเค็น
อัตราที่สูงกว่านี้ใช้กับคำขอทั้งฉบับ ไม่ใช่เฉพาะโทเค็นที่เกิน 272,000 คำขอที่มีอินพุต 272,001 โทเค็นจึงเข้าสู่ชั้นราคาบริบทยาวสำหรับอินพุต อินพุตที่แคช และเอาต์พุตทั้งหมดของคำขอนั้น
เมื่อเปรียบเทียบ Muse Wonder และ Claude Opus 5.5 ไม่มีการเพิ่มราคาบริบทยาวแบบเดียวกันภายใต้อัตรา API มาตรฐานของตน
ความแตกต่างนี้สำคัญเป็นพิเศษสำหรับการวิเคราะห์เอกสารขนาดใหญ่ การโค้ดทั้งรีโพซิทอรี และเอเจนต์ที่ทำงานยาว ซึ่งข้อได้เปรียบด้านราคาบริบทสั้นของ GPT-6 Sol อาจแคบลงเมื่อคำขอมีขนาดใหญ่ขึ้น
ราคาและเงื่อนไขการเรียกเก็บเงินของ CometAPI
ขณะรีวิว CometAPI ระบุ Opus 5.5 ที่ $3.20 อินพุต / $16 เอาต์พุต และ GPT-6 Sol ที่ $1.60 อินพุต / $8 เอาต์พุต ต่อ 1 ล้านโทเค็น นี่คืออัตราอิสระของ CometAPI และต้องไม่สับสนกับราคาอย่างเป็นทางการด้านบน ยืนยันเส้นทางที่ใช้ ชั้นบริบท และเงื่อนไขการเรียกเก็บเงินของบัญชีก่อนประเมินต้นทุน; ราคาและเงื่อนไขอาจเปลี่ยนแปลง
ต้นทุนต่อภารกิจที่ผ่านการยอมรับ
คำนวณต้นทุนต่อภารกิจที่ผ่านการยอมรับเป็นค่าใช้จ่ายรวมของโมเดลและเครื่องมือที่ถูกเรียกเก็บ รวมถึงการลองซ้ำและโมเดลสำรองที่มีค่าใช้จ่าย หารด้วยจำนวนผลลัพธ์ที่ผ่านเกณฑ์การยอมรับที่กำหนด บันทึกเวลาทบทวนของมนุษย์แยกต่างหากหรือแปลงด้วยอัตราค่าจ้างที่ระบุ ติดตามคำขอที่ล้มเหลวและค่าใช้จ่ายจริงอย่างเป็นอิสระ: การล้มเหลวเพียงอย่างเดียวไม่ได้บอกว่าคำขอมีการคิดเงินหรือไม่
ผลการเปรียบเทียบ: GPT-6 Sol มีอัตรามาตรฐานแบบบริบทสั้นต่ำสุดสำหรับอินพุตและเอาต์พุต ขณะที่ Muse Wonder และ Opus 5.5 มีอัตราฐานที่ระบุเท่ากัน ต้นทุนจริงต่อภารกิจที่ยอมรับขึ้นกับเส้นทางการเรียกเก็บเงินที่เลือก การใช้แคช ชั้นบริบท ค่าธรรมเนียมเครื่องมือ การลองซ้ำ และความพยายามในการทบทวน
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: การเปรียบเทียบและการคัดเลือก
การคัดเลือกตามความสามารถและลักษณะงาน
- สำหรับโค้ดดิ้งกว้างและเวิร์กโฟลว์ที่เน้นเทอร์มินัล เริ่มที่ Claude Opus 5.5 เพราะนำใน Intelligence Index, Terminal-Bench และ ProgramBench ที่อ้างอิง ตรวจสอบบนงานรีแฟกเตอร์ การรันเครื่องมือ และความสอดคล้องระดับโปรแกรม
- สำหรับโปรเจกต์วิศวกรรมระยะยาว เริ่มที่ Muse Wonder เพราะผล DeepSWE และ SWE-Marathon ที่รายงานแข็งแกร่งกว่า Opus 5.5 วัดการทำภารกิจสำเร็จ การฟื้นตัวจากอุปสรรค และต้นทุนรวมของงาน
- สำหรับเอเจนต์ส่วนตัวที่คงอยู่ เริ่มที่ Muse Wonder เพราะมี Active Memory และ Active Focus และได้คะแนน MemoryBench สูงกว่า Opus 5.5 ทดสอบการจดจำ การแก้ไข ความต่อเนื่อง และการแยกโปรเจกต์
- สำหรับเวิร์กโฟลว์เครื่องมือหลายขั้นตอน ประเมินทั้งสามโมเดล Muse มี Active Focus, Opus เน้นการประสานเครื่องมือ, และ GPT-6 Sol รองรับ Responses API tools เปรียบเทียบสแตกเอเจนต์ทั้งหมด รวมถึงสิทธิ์เครื่องมือ การลองซ้ำ และการจัดการสถานะ
- สำหรับเอกสารมืออาชีพและการวิเคราะห์ ประเมิน Muse Wonder หรือ Claude Opus 5.5 Muse มีจุดแข็งเฉพาะด้าน ขณะที่ Opus มีค่าดัชนีรวมที่อ้างอิงสูงกว่า ใช้เอกสารตัวแทนและเกณฑ์การยอมรับตามงาน
- สำหรับระบบอัตโนมัติปริมาณสูงที่คำนึงถึงต้นทุน เริ่มที่ GPT-6 Sol เพราะมีอัตราโทเค็นมาตรฐานแบบบริบทสั้นต่ำสุด ตรวจสอบต้นทุนต่อภารกิจที่ยอมรับ ชั้นบริบท เวลาแฝง และการลองซ้ำ
- สำหรับตัวเลือกระดับบนสุดของ Meta ประเมิน Muse Wonder Full หากเข้าถึงได้ มีคะแนนที่รายงานสูงขึ้นในหลายงานเฉพาะ แต่เป็นผลิตภัณฑ์แยกจากโมเดล API มาตรฐาน ยืนยันการสมัครและความเหมาะสมก่อนทดสอบ
โค้ดดิ้งระดับมืออาชีพ
Claude Opus 5.5 เป็นค่าตั้งต้นที่ดีสำหรับทีมที่ต้องการผู้ช่วยวิศวกรรมแบบกว้าง โดยเฉพาะเมื่อการรันเครื่องมือ การรีแฟกเตอร์ และความสอดคล้องระดับโปรแกรมสำคัญ ข้อได้เปรียบใน Terminal-Bench และ ProgramBench ที่รายงานช่วยตอกย้ำ แต่ทีมควรยืนยันสแตกเอเจนต์ทั้งหมด ไม่ใช่เฉพาะตัวโมเดล
ระบบอัตโนมัติปริมาณสูง
GPT-6 Sol น่าดึงดูดเมื่อมีคำขอจำนวนมากและเน้นต้นทุน ต่อให้คุณภาพด้อยลงเล็กน้อยก็ยอมรับได้สำหรับงานความเสี่ยงต่ำ ตรวจสอบง่าย เช่น ร่างเอกสาร ดึงฟิลด์โครงสร้าง หรืออธิบายโค้ด สำหรับการรันแบบอัตโนมัติยาว ๆ ให้ติดตามคุณภาพ โทเค็น เวลาแฝง และการลองซ้ำร่วมกัน
รายการตรวจสอบการประเมินสำหรับการใช้งานจริง
การประเมินโปรดักชันควรติดตาม 6 เมตริก: ความถูกต้อง วัดจากคำตอบที่ยอมรับหรือเทสต์ที่ผ่าน; ความเชื่อถือได้ วัดจากงานที่เสร็จโดยไม่ต้องช่วยเหลือ; เวลาแฝง วัดจากระยะเวลาปลายทางถึงปลายทาง; การใช้โทเค็น วัดจากอินพุตและเอาต์พุตที่ถูกคิดเงินทั้งหมด; ประสิทธิภาพของเอเจนต์ วัดจากการเรียกเครื่องมือและการลองแก้ไข; และต้นทุนที่มีผลจริง คำนวณจากค่าใช้จ่ายรวมหารด้วยงานที่ยอมรับ
ผลการเปรียบเทียบ: จัดเข้าชอร์ตลิสต์ Muse Wonder สำหรับเอเจนต์ที่คงอยู่และงานวิศวกรรมระยะยาว, Opus 5.5 สำหรับเวิร์กโฟลว์โค้ดดิ้งกว้างที่เน้นเทอร์มินัล, และ GPT-6 Sol เมื่อโทเค็นคอสต์เป็นข้อจำกัดหลัก เลื่อนชั้นผู้ท้าชิงก็ต่อเมื่อผ่านเกณฑ์คุณภาพและความเชื่อถือได้ตามงาน
เข้าถึง Muse Wonder, Claude Opus 5.5 และ GPT-6 Sol ได้ที่ไหน?
การเข้าถึงจากผู้ให้บริการทางการ
ใช้ Meta Model API สำหรับ Muse Wonder มาตรฐาน, Anthropic API สำหรับ Opus 5.5 หรือ OpenAI API สำหรับ GPT-6 Sol Muse Wonder Full มีให้ผ่านแผนบอกรับ Muse Code ที่ระบุ แทนที่จะเป็นตัวแทนหยิบใช้แทนโมเดล API มาตรฐาน ตรวจสอบสิทธิ์บัญชี ขีดจำกัดการใช้งาน และฟีเจอร์คำขอที่รองรับสำหรับเส้นทางที่เลือก
การเข้าถึงผ่าน CometAPI
เกตเวย์แบบรวมสามารถทำให้การยืนยันตัวตน การเรียกเก็บเงิน และการกำหนดเส้นทางง่ายขึ้น ใช้โมเดลสมรรถนะสูงสำหรับรีวิวสถาปัตยกรรมที่ซับซ้อน และโมเดลราคาถูกกว่าสำหรับงานร่างซ้ำ ๆ ความเสี่ยงต่ำ ระบุไอดีโมเดลและรูปแบบคำขอที่รองรับให้ตรงกับปลายทาง API เป้าหมายเสมอ
นักพัฒนาสามารถเข้าถึง Claude Opus 5.5 API ใน CometAPI และ GPT-6 Sol API ใน CometAPI เพื่อประเมินเวิร์กโหลดตัวแทน ยืนยันพื้นผิว API ที่รองรับสำหรับแต่ละโมเดล แทนที่จะสันนิษฐานว่าเกตเวย์ร่วมทำให้รูปแบบคำขอทั้งหมดใช้แทนกันได้
เส้นทาง CometAPI ที่อ้างถึงในบทความนี้ครอบคลุม Opus 5.5 และ GPT-6 Sol บทความนี้ไม่ได้ยืนยันเส้นทาง CometAPI สำหรับ Muse Wonder หรือ Wonder Full; ใช้เส้นทางผู้ให้บริการที่ยืนยันแล้วเมื่อประเมินผลิตภัณฑ์เหล่านั้น
บทสรุป
ไม่มีโมเดลใดชนะทุกเวิร์กโหลด Muse Wonder เป็นผู้ท้าชิงที่แข็งแกร่งที่สุดสำหรับพฤติกรรมเอเจนต์ที่คงอยู่และงานวิศวกรรมที่ทำงานยาว Claude Opus 5.5 เป็นผู้ท้าชิงที่แข็งแกร่งสำหรับโค้ดดิ้งกว้าง เวิร์กโฟลว์ที่เน้นเทอร์มินัล และงานความรู้ และนำในค่า Artificial Analysis Intelligence Index ที่ Meta รายงาน GPT-6 Sol มีราคาโทเค็นมาตรฐานแบบบริบทสั้นต่ำสุดและน่าสนใจสำหรับระบบอัตโนมัติที่คำนึงถึงต้นทุน ทีมโปรดักชันควรตัดสินใจสุดท้ายโดยใช้คุณภาพงานที่ยอมรับ ความเชื่อถือได้ เวลาแฝง การลองซ้ำ การใช้เครื่องมือ และต้นทุนรวมบนเวิร์กโหลดตัวแทน
คำถามที่พบบ่อย
ทีมจะทดสอบ Muse Wonder, Opus 5.5 และ GPT-6 Sol อย่างเป็นธรรมได้อย่างไร?
ใช้ชุดงานกันสำรองของงานจริงที่มีเกณฑ์การยอมรับคงที่ สิ่งประดิษฐ์อินพุตเหมือนกัน และสิทธิ์การใช้เครื่องมือที่มีเอกสารกำกับ บันทึกเวอร์ชันโมเดล การตั้งค่าความพยายาม ฮาร์เนสเอเจนต์ เวลาหมด และงบโทเค็น รันซ้ำเมื่อผลลัพธ์แปรผัน รายงานทั้งความล้มเหลวและความสำเร็จ และแยกการเปรียบเทียบในฮาร์เนสร่วมออกจากการเปรียบเทียบระบบที่ปรับจูนดีที่สุด วิธีนี้สร้างหลักฐานที่ใช้ได้กับเวิร์กโฟลว์ของคุณ มากกว่าการตั้งค่ามาตรวัดของทีมอื่น
เกตเวย์ API สามารถคงสถานะเอเจนต์เมื่อสลับโมเดลได้หรือไม่?
ที่อยู่เกตเวย์ร่วมเพียงอย่างเดียวไม่รับประกันสถานะบทสนทนาที่พกพาได้ ตัวระบุการเรียกเครื่องมือ หรือการอ้างอิงการตอบกลับที่จัดเก็บไว้ รักษาบันทึกมาตรฐานฝั่งแอปพลิเคชันของข้อความ เอาต์พุตเครื่องมือ และสถานะงานที่ตรวจยืนยันแล้ว ทดสอบสถานะและสภาวะเครื่องมือของแต่ละเส้นทางก่อนส่งงานที่กำลังดำเนินการไปยังโมเดลอื่น มิฉะนั้น โมเดลสำรองที่ถูกกว่าอาจสูญเสียข้อมูลที่จำเป็นต่อการทำงานให้ถูกต้อง
ทีมควรตั้งงบสำหรับการลองซ้ำและการทบทวนโดยมนุษย์อย่างไร?
กำหนดผลลัพธ์ที่ยอมรับก่อนทดสอบ จากนั้นหารค่าใช้จ่ายรวมของโมเดลและเครื่องมือที่ถูกคิดเงินด้วยจำนวนผลลัพธ์ที่ยอมรับ รายงานแรงงานทบทวนแยกต่างหากหรือรวมโดยใช้อัตรารายชั่วโมงที่ระบุ นับความพยายามที่ล้มเหลว การเรียกแก้ไข และโมเดลสำรอง และเปรียบเทียบทั้งงานทั่วไปและงานที่มีต้นทุนสูง หลีกเลี่ยงการมองราคาโทเค็นต่ำว่าเท่ากับการลดต้นทุนงานที่มีประโยชน์โดยอัตโนมัติ
การประเมินเอเจนต์ที่อ่อนไหวต่อหน่วยความจำควรครอบคลุมอะไรบ้าง?
ทดสอบว่าเอเจนต์จดจำข้อเท็จจริงที่เกี่ยวข้อง ผนวกการแก้ไข เพิกเฉยคำสั่งที่ล้าสมัย และแยกโปรเจกต์ต่าง ๆ ออกจากกัน รวมการติดตามผลที่ล่าช้าและการอัปเดตที่ขัดแย้งกัน แทนที่จะมีเพียงพรอมป์ตยาวเดียว ตรวจสอบพฤติกรรมหน่วยความจำทั้งในระดับแอปพลิเคชันและระดับโมเดล เพราะการคงอยู่ การเรียกคืน และการลบขึ้นกับระบบที่ปรับใช้ด้วย