
TLDR OpenAI Bel เป็นการรันพรีเทรนภายในที่ยังไม่ยืนยัน (โค้ดเนม) ซึ่งถูกกล่าวถึงครั้งแรกบน X เมื่อวันที่ 25 สิงหาคม 2026 โดย @synthwavedd โดยอ้างว่าเป็นโมเดลฐานที่ฝึกเสร็จแล้วซึ่งมีพารามิเตอร์รวมมากกว่า 10 ล้านล้านตัว—สืบทอดจากการรันก่อนหน้าที่ชื่อ Doug—ตั้งใจใช้เป็นรากฐานสำหรับระบบหลัง GPT-6 และอาจกลายเป็นโมเดลระดับ “AGI-threshold” หลังจากทำ reinforcement learning เพิ่มเติม
ณ วันที่ 13 ตุลาคม 2026 OpenAI ไม่เคยใช้ชื่อ Bel (หรือ Doug ในสื่อสาธารณะของผลิตภัณฑ์) ไม่ได้เผยแพร่จำนวนพารามิเตอร์ วันที่ออก เบนช์มาร์ก หรือ system card ใดๆ และ Bel ไม่พร้อมใช้งานผ่าน API หรือ ChatGPT
ประเด็นสำคัญ
- Bel มีที่มาจากโพสต์เดียวบน X โดย @synthwavedd เมื่อวันที่ 25 สิงหาคม 2026; OpenAI ไม่เคยยืนยัน
- ขนาดที่อ้าง: >10T พารามิเตอร์รวม อยู่ในระดับใกล้เคียง GPT-4.5 ตามโพสต์ต้นทาง
- ในข่าวลือถูกวางให้เป็นผู้สืบทอด “Doug” และเป็นฐานสำหรับระบบหลัง GPT-6 / Astra หลังทำ RL
- GPT-6 Astra เปิดให้ใช้สาธารณะตั้งแต่ต้นกันยายน 2026 และเป็นรุ่นเรือธงปัจจุบันของ OpenAI
- ไม่มีเบนช์มาร์กอิสระ วันที่ออก API ราคา หรือ weights สำหรับ Bel
- Claude Fable 5.5 ยังไม่ถูกประกาศ; รุ่นระดับสูงของ Claude ปัจจุบันคือ Fable 5.1
- สำหรับงานโปรดักชันวันนี้ สามารถใช้งาน GPT-6 Astra / Sol / Luna และรุ่น Claude ผ่านคีย์เดียวบน CometAPI เพื่อลดค่าใช้จ่ายและเลี่ยงการล็อกอินโดนผู้ขาย
OpenAI Bel คืออะไร?
OpenAI Bel (บางครั้งเขียนเป็น “BEL”) เป็นโค้ดเนมที่ถูกพูดถึงในชุมชน AI ว่าเป็นการรันพรีเทรนขนาดใหญ่ที่ OpenAI น่าจะเสร็จสิ้นในช่วงครึ่งหลังของเดือนสิงหาคม 2026 ตามรายงานต้นทาง Bel เป็นโมเดลพื้นฐานดิบ—not a finished product—ที่มีพารามิเตอร์รวมมากกว่า 10 ล้านล้านตัว ถูกกรอบให้เป็นผู้สืบทอดโครงการภายในก่อนหน้าที่ชื่อ Doug และตั้งใจเป็นฐานซึ่งหลังจากทำ reinforcement learning และการฝึกภายหลังเพิ่มเติมแล้ว อาจขับเคลื่อนระบบที่ไกลกว่า GPT-6 Astra และอาจแตะสิ่งที่วงในบางรายเรียกว่า “ระดับ AGI-threshold”
ที่สำคัญ Bel ไม่ใช่ GPT-7 ไม่ใช่โมเดล ChatGPT ที่ผู้ใช้พูดคุยได้ และไม่ใช่สิ่งที่พร้อมใช้งานผ่าน OpenAI API โดยถูกอธิบายอย่างเคร่งครัดว่าเป็นผลลัพธ์จากการพรีเทรน—โครงข่ายประสาทขนาดมหึมาที่ฝึกจากข้อความ (และอาจรวมข้อมูลอื่น) ซึ่งยังต้องการการจูนละเอียด การจัดแนว และงานด้านความปลอดภัยอย่างกว้างขวางก่อนจะกลายเป็นผลิตภัณฑ์ที่ส่งมอบได้
Bel เป็นโค้ดเนมที่ถูกรายงานของความพยายามทำโมเดลพื้นฐานของ OpenAI โดยข้อกล่าวอิงมาจาก โพสต์วันที่ 25 สิงหาคม 2026 เกี่ยวกับการพรีเทรนที่เสร็จสิ้น ของ @synthwavedd โพสต์ที่ถูกรวบรวมซ้ำอ้างว่ามีพารามิเตอร์รวมมากกว่า 10 ล้านล้านตัวและมีความสัมพันธ์การสืบทอดกับ Doug รายละเอียดเหล่านี้ยังเป็นคำกล่าวอ้างจากแหล่งเดียว: ภาพหน้าจอบันทึกข้อกล่าวอ้าง ไม่ใช่ผลการฝึกของ OpenAI ที่ยืนยันแล้ว
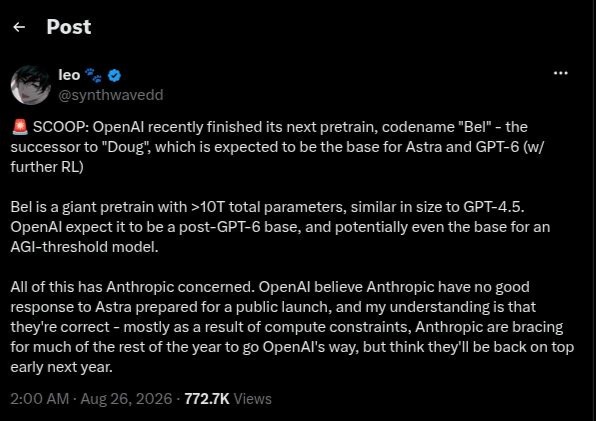
ภาพหน้าจอถูกรวบรวมจาก การเก็บภาพโพสต์ X ที่อ้างถึงโดย Mukhtada แสดงวันที่ 26 สิงหาคม เวลา 2:00 น. ตามเวลาจาการ์ตาของแหล่งที่มา ซึ่งสอดคล้องกับวันที่ 25 สิงหาคม เวลา 19:00 น. UTC เป็นการเก็บโดยบุคคลที่สาม ไม่ใช่การยืนยันอิสระเกี่ยวกับจำนวนพารามิเตอร์ สถานะการฝึก หรือข้ออ้างเชิงการแข่งขันส่วนตัว
ไทม์ไลน์หลักฐาน Doug–Bel
บริบทของ Doug แยกกัน: สิ่งพิมพ์ของ SemiAnalysis วันที่ 7 สิงหาคม นำเสนอหมายเหตุวันที่ 9 กรกฎาคมที่กล่าวถึงโมเดล OpenAI ขนาดใหญ่ชื่อ Doug ซึ่งเกิดก่อนโพสต์ Bel แต่ไม่ยืนยันสายสืบทอด Doug → Bel หรือเชื่อมโค้ดเนมใดเข้ากับผลิตภัณฑ์ที่เปิดตัวแล้ว
- 9 กรกฎาคม 2026: บันทึกวิจัยที่กล่าวถึงโมเดล OpenAI ขนาดใหญ่ชื่อ Doug ถูกนำมาเผยแพร่อีกครั้งใน บทความ SemiAnalysis ที่เผยแพร่เมื่อ 7 สิงหาคม วันที่บันทึกและวันที่เผยแพร่เป็นหมุดคนละจุด; นี่เป็นฉากหลังของ Doug ไม่ใช่การยืนยัน Bel
- 7 สิงหาคม 2026: SemiAnalysis เผยแพร่บทความที่นำการอ้างอิง Doug มาเผยแพร่อีกครั้ง ซึ่งมาก่อนข้อกล่าวอ้างเรื่อง Bel แต่ไม่ได้สร้างสายสืบทอด Doug-to-Bel หรือชื่อผลิตภัณฑ์สาธารณะ
- 25 สิงหาคม 2026: โพสต์ที่อ้างถึงของ @synthwavedd อ้างว่าการพรีเทรน Bel เสร็จสิ้นและมีพารามิเตอร์รวมมากกว่า 10 ล้านล้านตัว มี การเก็บโดยบุคคลที่สาม ที่รวบรวมข้ออ้างนี้; ไม่ใช่การยืนยันอิสระ
- 1 กันยายน 2026: รายงาน Path to Astra ที่อ้างถึงในบทความนี้ ให้ข้อมูลพื้นหลังเกี่ยวกับโครงการพัฒนาโมเดลอีกสายหนึ่ง ไม่ได้ยืนยันตัวตนของ Bel จำนวนพารามิเตอร์ หรือความเชื่อมโยงกับ GPT-7 หรือชื่อ GPT-6 Bel ที่เป็นไปได้
- 23 กันยายน 2026: มีการอ้างถึงบัญชีที่เผยแพร่ข้อความให้รอเป็นเดือนจาก โพสต์ติดตามของบัญชีเดียวกัน เนื่องจากไม่สามารถเข้าถึงข้อความต้นฉบับได้โดยตรงในการทบทวนแหล่งที่มา ข้อนี้จึงยังเป็นคำแนะนำเรื่องเวลาแบบไม่ยืนยัน และไม่ได้ระบุคำมั่นสัญญาเปิดตัว
- 12 ตุลาคม 2026 — จุดตรวจทานบทความ: โพสต์ที่อ้างถึงเกี่ยวกับ Bel, การรายงานเกี่ยวกับ Doug และ รายงานอย่างเป็นทางการที่แยกต่างหาก ที่อ้างถึงที่นี่ไม่ได้สร้างตัวตนเชิงพาณิชย์ให้กับ Bel ทั้ง GPT-7 และ GPT-6 Bel ไม่ได้รับการยืนยันโดยห่วงหลักฐานนี้; วันที่นี้เป็นการบันทึกการทบทวนบทความ ไม่ใช่การประกาศโมเดล
ในช่วงเวลาใกล้เคียงกัน OpenAI ได้พูดถึงโมเดลภายในที่ไม่เปิดชื่อว่า “มีความสามารถมากกว่า GPT-6 Astra อย่างมีนัยสำคัญ” ในบริบทของงานคณิตศาสตร์ (รวมถึงผลลัพธ์ที่เกี่ยวข้องกับสมการ Navier–Stokes)
สมมติฐานการตั้งชื่อสองแบบ: GPT-7 หรือ GPT-6 Bel?
การพรีเทรนและการเปิดตัวผลิตภัณฑ์เป็นหมุดคนละจุด เช็กพอยต์ของโมเดลพื้นฐานอาจยังต้องการ instruction tuning, reinforcement learning, การประเมินด้านความปลอดภัย การฝึกการใช้เครื่องมือ และการปรับให้พร้อมให้บริการ ผลิตภัณฑ์หลายตัวอาจมีที่มาจากโมเดลพื้นฐานเดียวกัน และหมายเลขเวอร์ชันสาธารณะไม่ได้ชี้ตัวการรันการฝึก รายงาน Path to Astra ของ OpenAI ให้พื้นหลังด้าน reinforcement learning อย่างเป็นทางการ โดยไม่ได้ยืนยันตัวตนของ Bel
สมมติฐาน 1 — GPT-7: หาก Bel แทนความก้าวหน้าของโมเดลพื้นฐานที่ก้าวข้ามเจเนอเรชัน GPT-6 OpenAI อาจทำการค้าโมเดลที่ได้จากมันในชื่อ GPT-7 การตีความนี้ขึ้นกับเจเนอเรชันความสามารถใหม่และการตัดสินใจตั้งชื่อสาธารณะ; ทั้งจำนวนพารามิเตอร์ที่อ้างหรือการพรีเทรนที่เสร็จสิ้นไม่ได้ยืนยันผลลัพธ์นี้โดยลำพัง
สมมติฐาน 2 — GPT-6 Bel: หรือ OpenAI อาจคงผลิตภัณฑ์ที่ได้จาก Bel ไว้ในตระกูล GPT-6 โดยอาจใช้ฉลากอย่างเช่น GPT-6 Bel สำหรับข้อเสนอที่อัปเกรดหรือเชี่ยวชาญเฉพาะด้าน นี่เป็นสถานการณ์ตั้งชื่อเชิงบรรณาธิการเพื่อการเปรียบเทียบ ไม่ใช่ผลิตภัณฑ์ที่ประกาศหรือการรั่วไหลจากแหล่งอื่น โค้ดเนมภายในไม่จำเป็นต้องปรากฏในชื่อเชิงพาณิชย์
สิ่งที่ยังไม่ชัดเจน: ความพยายามฝึกเดียวกันอาจรองรับหลายผลิตภัณฑ์ ใช้อีกชื่อหนึ่ง หรือไม่เปิดตัวสาธารณะเลย ไทม์ไลน์ให้บริบทกับทั้งสองการตีความแต่ยังตัดสินไม่ได้ การยืนยันต้องอาศัยเอกสารที่เชื่อมความพยายามฝึก Bel เข้ากับโมเดลสาธารณะจริงและชื่อของมัน
OpenAI Bel เทียบกับรุ่นก่อน: ดีขึ้นอะไรบ้าง?
เนื่องจากรายละเอียดเชิงเทคนิคที่เป็นรูปธรรมของ Bel ยังไม่มี การอภิปรายเรื่องการปรับปรุงจึงต้องยึดกับ (1) ข้ออ้างระดับสูงของการรั่วไหล (2) แนวโน้มที่ทราบของ GPT-4o → GPT-5.x → GPT-6 Astra และ (3) ความสามารถที่โมเดลภายในที่ไม่เปิดชื่อแสดงให้เห็นในการทำงานทางคณิตศาสตร์ระดับ Navier–Stokes แต่ละพื้นที่ที่อาจปรับปรุงจะถูกพิจารณาแยกกันด้านล่าง
สเกลและคอมพิวต์สำหรับพรีเทรน
ข้ออ้างหลักคือการก้าวข้ามการรันก่อนหน้าไปสู่ระดับพารามิเตอร์ >10T หากถูกต้อง นี่จะสะท้อนการยึดตามกฎการสเกลต่อไปทั้งด้านข้อมูล พารามิเตอร์ และคอมพิวต์ ยืนยันได้: OpenAI เดินหน้าการรันขนาดใหญ่ต่อเนื่องและอ้างถึงโมเดลที่มีความสามารถมากกว่า Astra ในที่สาธารณะ ยังไม่ยืนยัน: จำนวนพารามิเตอร์เฉพาะ FLOPs การฝึก ส่วนผสมข้อมูล หรือการเปลี่ยนสถาปัตยกรรม (dense vs. mixture-of-experts กลไก attention ใหม่ ฯลฯ) ความคาดหวังที่สมเหตุสมผลจากประวัติ: ประสิทธิภาพการใช้ตัวอย่างดีขึ้นและครอบคลุมความรู้กว้างขึ้น แต่จะให้ผลตอบแทนลดลงหากไม่มีความก้าวหน้าที่สอดคล้องกันในงานหลังการฝึกและคุณภาพข้อมูล
หลังการฝึกและการจัดแนวสำหรับความเป็นเอเจนต์ระยะยาว
GPT-6 Astra พัฒนาขึ้นอย่างมากในเวิร์กโฟลว์หลายขั้น การใช้คอมพิวเตอร์ และการรักษาขอบเขตงาน โมเดลฐานที่แข็งแรงขึ้นบวก RL เพิ่มเติมอาจผลักความน่าเชื่อถือในการทำงานแบบเอเจนต์จากระดับชั่วโมงไปสู่หลายวันหรือหลายสัปดาห์โดยต้องการการชี้นำจากมนุษย์น้อยลง การทดลองหลายเอเจนต์เกี่ยวกับ Navier–Stokes (เอเจนต์ประสานงานนับพัน) แสดงว่า OpenAI ดำเนินงานที่สเกลฝูงเอเจนต์ขนาดใหญ่บนปัญหายากแล้ว ทิศทางความสามารถ: ใช่ ส่วนที่เป็น Bel โดยเฉพาะ: ยังไม่ยืนยัน
การให้เหตุผลเชิงวิทยาศาสตร์และคณิตศาสตร์
Astra เองก็ช่วยผลักดันความก้าวหน้าทางคณิตศาสตร์; โมเดลภายในที่แข็งแรงกว่าสร้างผลลัพธ์ที่เป็นทางการในปัญหาระดับ Millennium Prize โมเดลฐานที่ใหญ่และฝึกดีกว่าอาจย่นเวลาและต้นทุนในการสำรวจพื้นที่ค้นหา STEM ที่ยาก ยืนยัน: OpenAI ลงทุนอย่างหนักในด้านนี้ ส่วนที่เฉพาะของ Bel: ยังไม่ยืนยัน
การใช้คอมพิวเตอร์ การใช้เครื่องมือ และความเสถียรแบบมัลติโหมด
Astra ทำสถิติใหม่ในการใช้คอมพิวเตอร์และเบราว์เซอร์ ฐานในอนาคตคาดว่าจะลดอัตราความผิดพลาดบนเส้นทางยาวๆ ปรับปรุงการยึดโยงภาพ และรับมือสภาพแวดล้อมซอฟต์แวร์ที่ซับซ้อนขึ้น เป็นการคาดการณ์เชิงสมมติแต่สอดคล้องกับโรดแมปผลิตภัณฑ์
ประสิทธิภาพ ความเร็วอินเฟอเรนซ์ และต้นทุน
ถึงแม้ฐานจะใหญ่ขึ้น การดิสทิลเลชัน สถาปัตยกรรมที่ดีกว่า และชิปเฉพาะ (OpenAI เคยพูดถึง ASICs ของตนเอง) ก็ยังอาจให้สมดุลต้นทุน/ประสิทธิภาพที่ใช้งานได้ ปัจจุบันยังไม่มีข้ออ้างเฉพาะด้านประสิทธิภาพสำหรับ Bel
OpenAI Bel หรือ GPT-7 อาจเปิดตัวเมื่อใด?
ไม่มีวันเปิดตัวอย่างเป็นทางการสำหรับ Bel หรือ GPT-7 ที่ได้จาก Bel จากแหล่งที่ทบทวน บัญชีที่อ้างหมุนเวียนของ โพสต์ติดตามเมื่อ 23 กันยายนของ @synthwavedd ที่กล่าวให้รอเป็นเดือนนั้นมาจากแหล่งที่ไม่เป็นทางการเดียวกับการรั่วไหลต้นทาง และไม่สามารถเข้าถึงข้อความฉบับเต็มได้โดยตรงในระหว่างการทบทวน ดังนั้นจึงไม่ควรใช้ทำนายหน้าต่างการเปิดตัว การพรีเทรนที่เสร็จสิ้น หากเป็นจริง อาจยังตามมาด้วยการฝึกภายหลัง การประเมิน การทำงานด้านให้บริการ และการปล่อยใช้งานแบบเป็นขั้นตอน
| สถานการณ์ | จะเกิดอะไรขึ้น | มีนัยว่า |
|---|---|---|
| เสร็จเร็ว | การประเมินที่เหลือและการปล่อยใช้งานสำเร็จค่อนข้างเร็ว | ผู้สืบทอดอาจมาถึงเร็วขึ้น |
| พัฒนานานขึ้น | ต้องการการฝึก การบรรเทาความเสี่ยง และงานให้บริการมากขึ้น | กรอบเวลาเลื่อนไปข้างหน้า |
| การปล่อยทางเลือก | โมเดลพื้นฐานขับเคลื่อนระบบเฉพาะทางหรือแบรนด์ต่างออกไป | อาจไม่มีผลิตภัณฑ์ชื่อ Bel |
สำหรับ Fable 5.5 แบบสมมติ ยังไม่มีตารางเวลาในแหล่งที่ทบทวน จึงไม่รองรับการทำนายลำดับการเปิดตัว
Bel อาจเปลี่ยนดุลระหว่าง OpenAI และ Anthropic ได้หรือไม่?
ยังเปิดได้สามผลลัพธ์ที่น่าเชื่อถือ ประการแรก Bel อาจนำการก้าวกระโดดของพรีเทรนที่กว้างและยกระบบโค้ดดิ้งและให้เหตุผลถัดไป ประการที่สอง ข้อได้เปรียบอาจแคบ โดยผู้ให้บริการรายอื่นยังคงชนะในด้านความน่าเชื่อถือของเอเจนต์ ความหน่วงต่ำ หรือค่าใช้จ่าย ประการที่สาม สเกลขนาดมหึมาที่รายงานอาจไม่แปลเป็นประโยชน์เชิงปฏิบัติอย่างเป็นสัดส่วน จนกว่าจะมีหลักฐานที่ทำซ้ำได้ กรอบที่ถูกต้องคือการมองว่าเป็นการตอบสนองเชิงแข่งขันที่เป็นไปได้ ไม่ใช่ผู้ชนะที่ประกาศชัด
ข้อแนะนำเชิงปฏิบัติสำหรับนักพัฒนาและทีม (CometAPI)
ขณะที่อุตสาหกรรมเฝ้ารอการยืนยันอย่างเป็นทางการของ Bel หรือโมเดลฐานหลักตัวถัดไปของ OpenAI ระบบโปรดักชันต้องเข้าถึงโมเดลที่มีอยู่จริงในวันนี้ CometAPI ให้เอนด์พอยต์ที่เข้ากันได้กับ OpenAI เดียว (https://api.cometapi.com/v1) และคีย์เดียวที่เข้าถึงได้ 500+ โมเดล รวมถึงตระกูล GPT-6 ปัจจุบันทั้งหมด (Astra, Sol, Luna และอัปเดต) และสายผลิตภัณฑ์ Claude ของ Anthropic (Fable 5.1, Opus 5.5, Sonnet 5.5 ฯลฯ)
บทสรุป
แนวหน้าของ AI เคลื่อนที่เร็วอย่างต่อเนื่อง Bel ในท้ายที่สุดอาจกลายเป็นหมุดหมายภายในที่สำคัญ ชื่อโค้ดที่ถูกรายงานผิด หรือบางอย่างระหว่างนั้น จนกว่า OpenAI จะเผยข้อมูลที่เป็นรูปธรรม ท่าทีที่รับผิดชอบคือปฏิบัติต่อข้อกล่าวอ้างเหล่านี้ว่าไม่ยืนยัน ขณะเดียวกันก็ดึงค่าสูงสุดจากโมเดลที่มีอยู่แล้ว—และทำให้อินฟราสตรักเจอร์ยืดหยุ่นพอจะผนวกรุ่นถัดไปได้ทันทีที่มันกลายเป็นจริง สำหรับหลายทีม ความยืดหยุ่นนั้นทำได้ง่ายที่สุดวันนี้ผ่านแพลตฟอร์มแบบรวมอย่าง CometAPI