
TL;DR
OpenAI Decisions API และ TypeSafe Jev ต่างก็ส่งคืน “การตัดสินใจ” ที่มีขอบเขตและรองรับด้วยความน่าจะเป็น แทนที่จะเป็นร้อยแก้วทั่วไป OpenAI ใช้ GPT-6 Luna ผ่านเอ็นด์พอยต์เฉพาะ; TypeSafe Jev เป็นโมเดล System One เฉพาะทาง Jev มีราคาถูกกว่าตามอัตราค่าบริการต่อโทเค็นอินพุตที่เผยแพร่ ($0.042 เทียบกับ $0.10 ต่อหนึ่งล้าน) ขณะที่ OpenAI รองรับภาพโดยกำเนิด ตัวเลขจากผู้ให้บริการที่ทบทวนในที่นี้ยังไม่ชี้ชัดผู้ชนะด้านความแม่นยำหรือความเร็วแบบตัวต่อตัว
ประเด็นสำคัญ
- ราคา: Jev ถูกกว่าร้อยละ 58 ต่อโทเค็นอินพุตตามอัตราฐานที่เผยแพร่
- สถาปัตยกรรม: OpenAI Decisions API ใช้ GPT-6 Luna; Jev ถูกออกแบบเฉพาะสำหรับการประมวลผลการตัดสินใจ
- โหมดข้อมูล: OpenAI รองรับข้อความและภาพ; Jev มุ่งที่ข้อความและอินพุตแบบมีโครงสร้าง
- เบนช์มาร์ก: คำกล่าวด้านความเร็วของผู้ขายใช้อ้างอิงต่างกัน; เปรียบเทียบบนชุดข้อมูลติดฉลากเดียวกัน
- การเลือกใช้: ให้ความสำคัญกับการรองรับมัลติโมดัลและการผสานกับ OpenAI หรือให้ความสำคัญกับปริมาณงานข้อความล้วนและต้นทุน ขึ้นกับแอปพลิเคชันของคุณ
ภาพรวมโดยย่อ: OpenAI Decisions API vs Jev
ภาพรวมด้านล่างเปรียบเทียบเอ็นด์พอยต์การตัดสินใจและอัตราฐานที่เผยแพร่ โดยตรวจสอบเมื่อวันที่ 12 ตุลาคม 2026 การเข้าถึงโมเดล ข้อจำกัด และข้อกำหนดการให้บริการควรยืนยันตามบัญชีที่ใช้ดีพลอย
| คุณลักษณะ | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| ผู้ให้บริการ | OpenAI | TypeSafe AI |
| เอนจิน | GPT-6 Luna | Jev System One |
| เอ็นด์พอยต์ | POST /v1/decisions | POST /v1/systemone |
| ตัวระบุโมเดล | gpt-6-luna | jev-1.13.0 / jev-latest |
| อินพุต | ข้อความ + ภาพ | ข้อความ / ข้อความแบบมีโครงสร้าง |
| ประเภทคำถาม | Predicate (ความน่าจะเป็นของเงื่อนไข), choice (หมวดหมู่), score (รูบริก) | Noul (ความน่าจะเป็นของเงื่อนไข), choice (หมวดหมู่), score (ระดับ) |
| คำถามในคำขอ | อาร์เรย์พร้อมชื่อ | ออบเจ็กต์ที่คีย์ด้วย ID |
| ขีดจำกัดบริบท | ไม่ระบุในคู่มือ Decisions ที่ลิงก์ | รวม 64K; state + คำถามที่ยาวที่สุด ≤32K |
| ค่าอินพุตฐาน / 1M | USD 0.10 | USD 0.042 |
| ค่าบริการโทเค็นเอาต์พุต | ไม่มีค่าใช้จ่าย | ไม่มีค่าใช้จ่าย |
| คำกล่าวด้านความเร็วของผู้ขาย | เร็วกว่า Responses API ประมาณ 10× | 70–500 ms แบบ end-to-end |
| ความพร้อมใช้งาน | เบต้าสาธารณะ | เข้าถึงแบบ early access ในประกาศเปิดตัว; ยืนยันการเข้าถึงของบัญชีปัจจุบัน |
| ข้อได้เปรียบเด่น | การตัดสินใจบนฐานภาพ | ค่าอินพุตที่เผยแพร่ต่ำกว่า |
| การให้เหตุผล/การโค้ดแบบกำเนิด | ไม่อยู่ในขอบเขตเอาต์พุตของเอ็นด์พอยต์นี้ | ไม่อยู่ในขอบเขตเอาต์พุตของเอ็นด์พอยต์นี้ |
หลายเวิร์กโฟลว์ของ AI ต้องการหมวดหมู่ ความน่าจะเป็น หรือคะแนน มากกว่าหนึ่งย่อหน้า ทิกเก็ตซัพพอร์ตต้องการการจัดเส้นทาง ตัวเอเจนต์ต้องเลือกการกระทำที่ได้รับอนุมัติ คิวรีวิวต้องระบุอินพุตที่ไม่แน่ชัด ทั้งสองผลิตภัณฑ์ทำให้การตัดสินใจดังกล่าวเป็นเอาต์พุต API ชั้นหนึ่ง
OpenAI เปิดตัว Decisions API แบบเบต้าเมื่อวันที่ 6 ตุลาคม 2026 เอ็นด์พอยต์ GPT-6 Luna ของมันรับทั้งข้อความและภาพ Jev เป็นโมเดล System One เฉพาะทางของ TypeSafe AI สำหรับการประเมินแบบไม่กำเนิด โดยมีแนวทางการฝึกสอนที่เรียกว่า Reinforcement Learning for Calibrated Decisions (RLCD)
ประเภทคำถามในตารางครอบคลุมสามงานร่วมกัน Predicate ของ OpenAI และ noul ของ Jev ประมาณว่ามีเงื่อนไขเป็นจริงหรือไม่ เช่น เจตนาคืนเงินหรือคุณสมบัติ Choice เลือกจากหมวดหมู่ที่กำหนดไว้ล่วงหน้า เช่น Billing, Technical และ Shipping เพื่อการจัดเส้นทาง Score ประเมินอินพุตตามรูบริกหรือระดับ เช่น ความเร่งด่วนหรือความสำคัญ คำอธิบายเหล่านี้สรุปภาพรวมของผลิตภัณฑ์ทั้งสอง; สคีมาคำขอและความหมายของความน่าจะเป็นยังต้องจัดการเฉพาะผู้ให้บริการ
OpenAI Decisions API และ Jev คืออะไร?
OpenAI Decisions API และ TypeSafe Jev เป็นบริการ AI ที่โฟกัสการตัดสินใจ ออกแบบมาเพื่อเปลี่ยนข้อมูลอินพุตเป็นเอาต์พุตที่มีขอบเขตและคุมรูปแบบ แทนที่จะเป็นข้อความแบบปลายเปิด แตกต่างจากโมเดลภาษาขนาดใหญ่แบบดั้งเดิมที่สร้างคำอธิบายหรือการตอบสนองเชิงสนทนา API เหล่านี้ประเมินคำถามที่กำหนดไว้ล่วงหน้าและส่งคืนการตัดสินใจ ความน่าจะเป็น หรือคะแนน ทำให้มีประโยชน์อย่างยิ่งสำหรับเวิร์กโฟลว์อัตโนมัติ เช่น การจัดเส้นทางคำขอลูกค้า การจัดหมวดหมู่คอนเทนต์ การประเมินความเสี่ยง และการเลือกเครื่องมือของเอเจนต์ AI ที่ต้องการเอาต์พุตที่คาดเดาได้และการประมวลผลที่มีประสิทธิภาพ
OpenAI Decisions API ใช้พลังของ GPT-6 Luna และทำงานผ่านเอ็นด์พอยต์ /v1/decisions รองรับทั้งข้อความและภาพ โดยมีสามประเภทการตัดสินใจ: predicate, choice และ score ข้อได้เปรียบหลักคือการผสานความเข้าใจบริบทของโมเดลอเนกประสงค์เข้ากับอินเทอร์เฟซการตัดสินใจเฉพาะ เหมาะสำหรับการจัดหมวดหมู่แบบมัลติโมดัลและแอปที่ผสานกับระบบนิเวศของ OpenAI อยู่แล้ว
TypeSafe Jev ต่างออกไป โดยเป็นโมเดลการตัดสินใจเฉพาะทางที่เข้าถึงผ่านเอ็นด์พอยต์ /v1/systemone มุ่งเน้นการประเมินบนพื้นฐานข้อความโดยใช้สามประเภทคำถาม: noul, choice และ score Jev เน้นการอนุมานที่มีประสิทธิภาพ การทำนายแบบมีโครงสร้าง และการปรับเทียบความน่าจะเป็น ทำให้เป็นตัวเลือกที่น่าสนใจสำหรับการจัดหมวดหมู่ปริมาณมากและไปป์ไลน์การตัดสินใจอัตโนมัติ แม้ว่าทั้งสองบริการจะตอบโจทย์คล้ายกัน ความแตกต่างด้านสถาปัตยกรรม ความสามารถด้านอินพุต ราคา และการออกแบบ API สามารถส่งผลอย่างมีนัยสำคัญต่อความเหมาะสมต่อแอปใดแอปหนึ่ง
แนวทางโมเดล ขีดจำกัดอินพุต และขอบเขต
การเปรียบเทียบนี้อ้างอิงพฤติกรรม API ที่บันทึกไว้และการจัดวางผลิตภัณฑ์ OpenAI เปิดเผย GPT-6 Luna ผ่านเอ็นด์พอยต์การตัดสินใจ ขณะที่ TypeSafe วางตำแหน่ง Jev เป็นโมเดล System One เฉพาะคำอธิบายเหล่านี้เพียงอย่างเดียวไม่ได้ระบุข้อได้เปรียบด้านความแม่นยำหรือเผยรายละเอียดการใช้งานทั้งหมด
Jev อนุญาต โทเค็น 64K สำหรับคำขอทั้งหมด โดยมีขีดจำกัด 32K แยกต่างหากสำหรับ state รวมกับคำถามที่ยาวที่สุด ให้รวมคำสั่งคำถามและเกณฑ์ รวมถึงอินพุตที่ใช้ร่วมกันไว้ด้วย คู่มือ Decisions ของ OpenAI ที่ลิงก์ไว้ไม่ได้ระบุขีดจำกัดบริบทเป็นตัวเลขสำหรับเอ็นด์พอยต์นี้; ควรยืนยันขีดจำกัดที่ใช้ แทนที่จะถือว่าค่าหน้าต่างบริบทของโมเดลทั่วไปใช้ได้โดยไม่เปลี่ยนแปลง
เบนช์มาร์กการให้เหตุผลและการเขียนโค้ดแบบกำเนิดอยู่นอกขอบเขตของเอ็นด์พอยต์การตัดสินใจที่มีขอบเขตเหล่านี้ หากต้องการสร้างคำอธิบายหรือโค้ด ให้ประเมินเอ็นด์พอยต์แบบกำเนิดที่เหมาะสมแยกต่างหาก ผลลัพธ์ของโมเดลอเนกประสงค์ที่อยู่เบื้องหลังไม่ได้ยืนยันประสิทธิภาพของเอ็นด์พอยต์ Decisions
ความแม่นยำและหน่วงเวลา
เอกสารของผู้ขายที่อ้างถึงไม่ได้ให้การทดสอบแบบตัวต่อตัวที่จับคู่กันซึ่งชี้ชัดผู้ชนะด้านความแม่นยำหรือความหน่วงเวลา คำกล่าว ความเร็วประมาณ 10× ของ OpenAI เปรียบเทียบ Decisions กับ Responses API ของตน TypeSafe รายงาน หน่วงเวลาแบบ end-to-end 70–500 ms และระบุว่าการประเมินที่เผยแพร่โดยทั่วไปทำจากแล็ปท็อปในภาคตะวันตกของสหรัฐฯ
| เมตริก | OpenAI Decisions API | Jev | การประเมิน |
|---|---|---|---|
| ความแม่นยำแบบตัวต่อตัว | ไม่มีการทดสอบที่จับคู่ในแหล่งที่อ้างอิง | ไม่มีการทดสอบที่จับคู่ในแหล่งที่อ้างอิง | ไม่มีผู้ชนะ |
| ความเร็ว | คำกล่าวเชิงสัมพัทธ์ของผู้ขาย | ช่วงเวลาที่เป็นจำนวนจริงของผู้ขาย | เปรียบเทียบโดยตรงไม่ได้ |
| การปรับเทียบ | ความน่าจะเป็น; ความเชื่อมั่นแยกสำหรับ choice/score | ความน่าจะเป็น; ความเชื่อมั่นที่ได้จากการกระจาย | ทดสอบการปรับเทียบที่สังเกต |
| การจัดหมวดหมู่ข้อความ | รองรับ | รองรับ | ทั้งสองทำได้ |
| การจัดหมวดหมู่ภาพ | รองรับภาพโดยกำเนิด | ไม่รองรับภาพโดยกำเนิด | ข้อได้เปรียบของ OpenAI |
การปรับเทียบความน่าจะเป็นและเกณฑ์การรีวิว
โมเดลอาจแม่นยำแต่ปรับเทียบไม่ดี ในบรรดาการทำนายที่กำหนดความน่าจะเป็น 0.90 ให้กับคลาสที่เลือก ประมาณ 90% ควรจะถูกต้องหากความน่าจะเป็นนั้นปรับเทียบบนการกระจายการประเมิน อย่าแทนค่าความน่าจะเป็นนี้ด้วยฟิลด์ที่ชื่อ confidence ใน API โดยไม่ตรวจสอบความหมายของมัน Jev คำนวณค่า confidence สำหรับ Choice จากการกระจายความน่าจะเป็น: confidence = (p_max − 1/n) / (1 − 1/n) โดย n คือจำนวนตัวเลือก ผลลัพธ์ Noul ไม่มีฟิลด์ confidence แยก วัด ECE และ Brier score จากความน่าจะเป็นที่เหมาะสม ควบคู่กับ precision, recall และ macro F1; เลือกเกณฑ์การรีวิวจากตัวอย่างที่ติดฉลาก
ราคาและต้นทุนต่อการตัดสินใจที่ยอมรับ
OpenAI ระบุ ราคา $0.10 ต่อหนึ่งล้านโทเค็นอินพุตสำหรับ /v1/decisions; Jev ระบุ ราคา $0.042 ต่อหนึ่งล้านโทเค็นอินพุต ทั้งสองไม่มีค่าใช้จ่ายโทเค็นเอาต์พุตสำหรับบริการการตัดสินใจเหล่านี้ บนราคาอ้างอิงดังกล่าว Jev ถูกกว่าร้อยละ 58 ต่อโทเค็นอินพุต อาจมีค่าใช้จ่ายเพิ่มสำหรับการประมวลผลตามภูมิภาคและตัวคูณบริบทยาวของ OpenAI; การลองใหม่ การเตรียมข้อมูลล่วงหน้า และการรีวิวสามารถเพิ่มต้นทุนเวิร์กโฟลว์
สมมติว่าคำขอแต่ละรายการใช้โทเค็นอินพุตแบบคิดเงิน 500 โทเค็นกับทั้งสองบริการ นี่เป็นการคำนวณเชิงตัวอย่าง ไม่ใช่ใบแจ้งหนี้ของผู้ขาย
| การตัดสินใจรายเดือน | โทเค็นอินพุต | ค่าใช้จ่าย OpenAI | ค่าใช้จ่าย Jev | ความต่าง |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
ต้นทุนต่อการตัดสินใจที่ถูกต้องซึ่งยอมรับได้ = (ค่าใช้จ่าย API + ค่าใช้จ่ายการลองใหม่ + ค่าใช้จ่ายการรีวิวโดยมนุษย์) / จำนวนการตัดสินใจที่ถูกต้องซึ่งยอมรับได้ อัตราค่าบริการต่อโทเค็นที่ต่ำอาจถูกหักล้างด้วยอัตราการจัดเส้นทางผิดหรือการยกระดับที่สูงกว่า
สำหรับเวิร์กโฟลว์ GPT-6 Luna แบบดั้งเดิม ตารางราคาโมเดลของ CometAPI ระบุอัตรา USD ต่อหนึ่งล้านโทเค็น โดยตรวจเมื่อวันที่ 12 ตุลาคม 2026 นี่เป็นอัตราของโมเดล-เอ็นด์พอยต์; หน้าที่ลิงก์แสดงตัวอย่าง Responses API และไม่ได้ยืนยันการรองรับ /v1/decisions โดยกำเนิดหรือราคาของมัน
| ระดับที่เผยแพร่ | อินพุต / 1M โทเค็น | เอาต์พุต / 1M โทเค็น |
|---|---|---|
| บริบทสั้น (เงื่อนไขหน้า: ≤272,000 โทเค็น) | $0.08 | $0.40 |
| บริบทยาว (ตามที่ระบุบนหน้า) | $0.16 | $0.60 |
เอาต์พุตโทเค็นของ GPT-6 Luna ปกติใน CometAPI จะถูกคิดเงิน แยกการประมาณนี้ออกจากบริการการตัดสินใจสองรายการข้างต้น ซึ่งตามที่เผยแพร่ไม่มีค่าโทเค็นเอาต์พุต ตัวอย่างเช่น 500 โทเค็นอินพุตบวก 20 โทเค็นเอาต์พุตมีค่า $0.000048 ต่อคำขอบริบทสั้น หรือ $48 ต่อหนึ่งล้านคำขอ ก่อนค่าบริการอื่น ยืนยันระดับและอัตราบัญชีที่ใช้ได้ใน แค็ตตาล็อกโมเดลสด ก่อนวางงบประมาณ
เวิร์กโฟลว์เอเจนต์และการแลกเปลี่ยนเรื่องโมดัล
ทั้งสองสามารถจัดเส้นทางการเรียกเครื่องมือ ประเมินว่าเงื่อนไขป้องกันเป็นจริงหรือไม่ หรือให้คะแนนการกระทำ ทั้งสองไม่ทดแทนการอนุญาต การตรวจสอบความถูกต้องของอินพุต หรือสิทธิ์เครื่องมือที่ชัดเจน สำหรับงานอัตโนมัติที่เกี่ยวกับภาพ OpenAI ที่รองรับภาพโดยกำเนิดจะทำให้ไปป์ไลน์ง่ายขึ้น; สำหรับการจัดเส้นทางข้อความล้วน ค่าอินพุตที่ต่ำกว่าของ Jev อาจน่าสนใจ
การจัดการเอาต์พุตต่างกันที่ขอบเขตการตอบกลับ OpenAI ส่งคืน answers array โดยใช้ names ระบุคำถาม; Jev ส่งคืน answers object คีย์ด้วย ID คำถาม ทำให้โครงสร้างเหล่านี้เป็นมาตรฐานก่อนนำกฎธุรกิจร่วมไปใช้ Jev คำนวณ confidence จากการกระจายความน่าจะเป็น; อย่าคิดว่าฟิลด์ที่ชื่อเหมือนกันมีความหมายเทียบเท่ากันระหว่างผู้ให้บริการ ตรวจสอบป้ายกำกับและปรับเทียบเกณฑ์รีวิวบนข้อมูลแอปพลิเคชัน
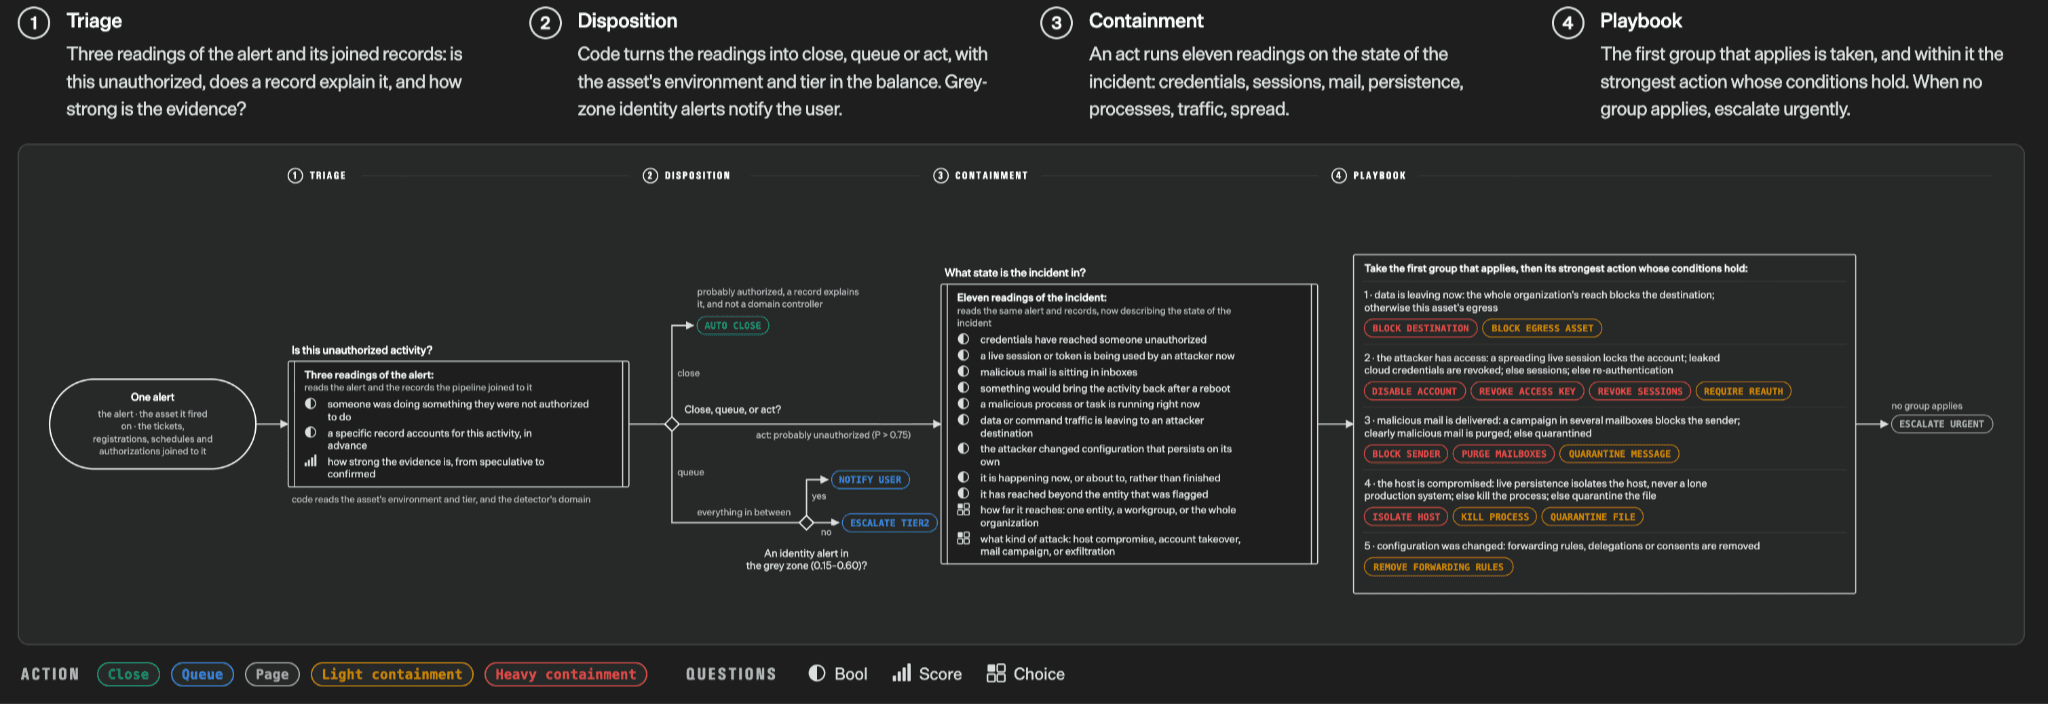
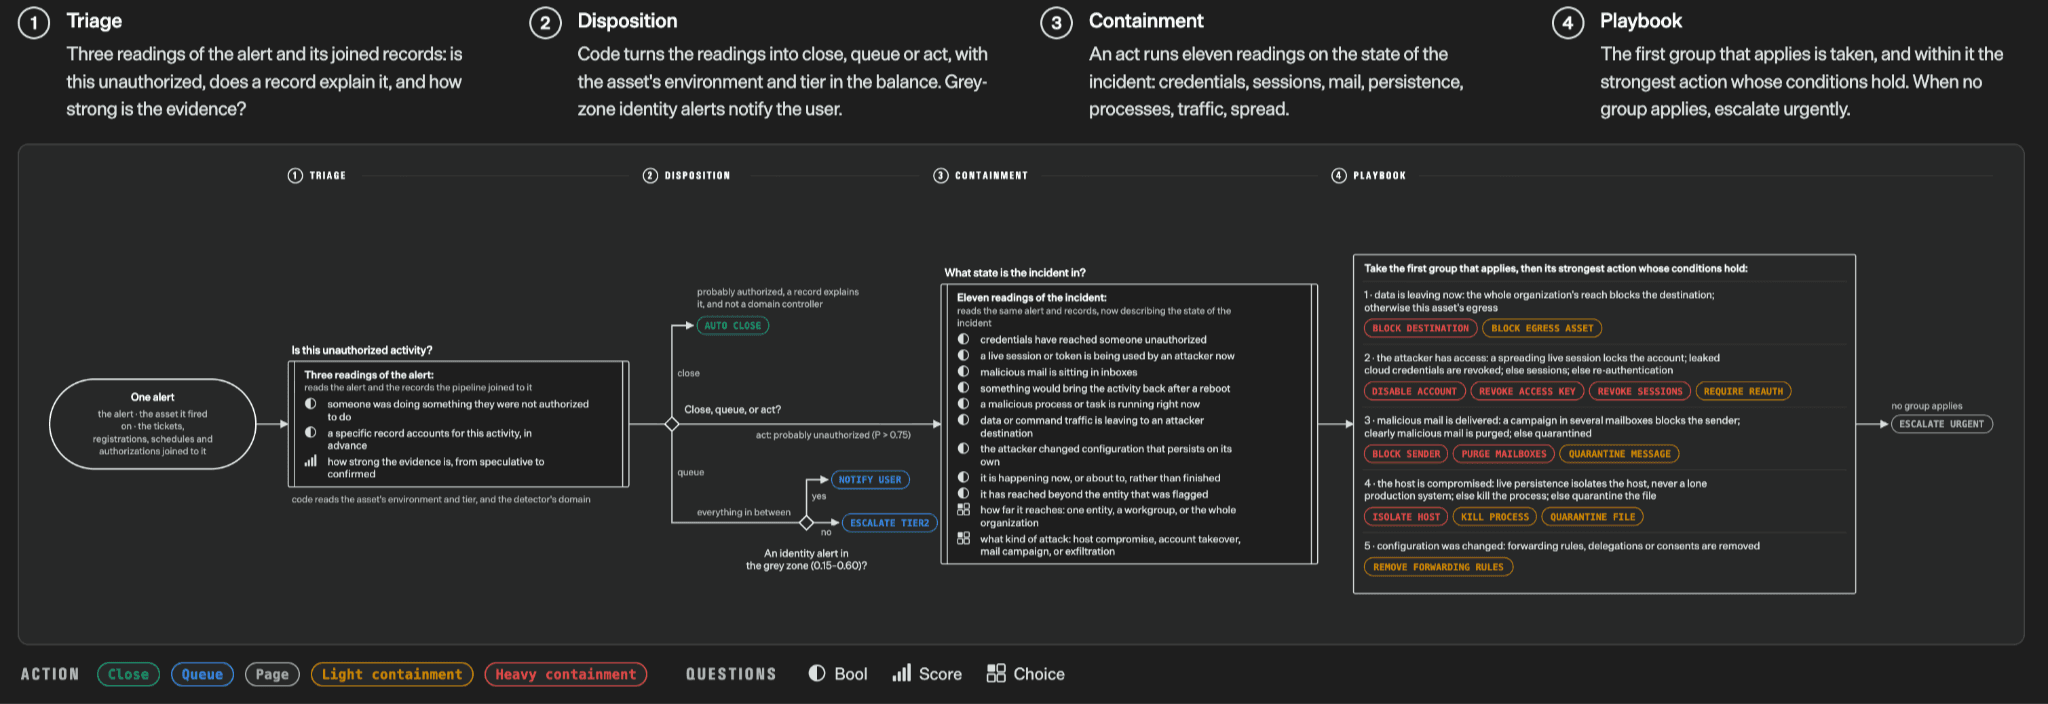
ที่มา: Introducing System One Models & Jev; ภาพต้นฉบับ สิ่งนี้แสดงองค์ประกอบเวิร์กโฟลว์ ไม่ใช่เบนช์มาร์กที่จับคู่กับ OpenAI Decisions API
การใช้งาน API ต่างกันอย่างไร: OpenAI Decisions API vs Jev
ต้องกำหนดการเข้าถึงแยกกันสำหรับแต่ละผู้ให้บริการ: ตัวอย่างด้านล่างแต่ละรายการใช้โฮสต์และคีย์ API ของตนเอง OpenAI จัดทำเอกสาร Decisions เป็น เอ็นด์พอยต์แบบเบต้าสาธารณะ สำหรับ Jev ให้ยืนยันการเข้าถึงและข้อมูลรับรองกับ TypeSafe ก่อนดีพลอย สำหรับบริการใด ๆ ให้ยืนยันสิทธิ์บัญชี ความพร้อมในภูมิภาค โควตา และข้อกำหนดการให้บริการ; ตัวอย่างคำขอไม่ได้รับประกันการเข้าถึงโปรดักชัน การเข้าถึงบุคคลที่สามไปยังโมเดลแบบกำเนิดไม่ได้ยืนยันการรองรับเอ็นด์พอยต์การตัดสินใจโดยกำเนิดของมันโดยอัตโนมัติ
วิธีใช้ OpenAI Decisions API
แนวคิดทับซ้อนกัน แต่สคีมาคำขอต่างกัน OpenAI ส่งอินพุตและอาร์เรย์ของคำถามที่มีชื่อ; Jev ใช้ state และออบเจ็กต์ questions ที่คีย์ด้วย ID จัดทำอแดปเตอร์เฉพาะผู้ให้บริการก่อนนำนโยบายการตัดสินใจร่วมไปใช้
จัดเส้นทางทิกเก็ตซัพพอร์ตด้วย OpenAI Decisions API
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
วิธีใช้ Jev API
คำขอ cURL ต่อไปนี้ใช้ เอ็นด์พอยต์ System One ของ Jev เพื่อจัดหมวดหมู่ทิกเก็ตซัพพอร์ต ตั้งค่า TYPESAFE_API_KEY ในสภาพแวดล้อม ใส่ทิกเก็ตไว้ใน state และนิยาม department ภายในออบเจ็กต์ questions แผนที่ criteria ระบุป้ายกำกับการจัดเส้นทางที่อนุญาตและคำอธิบาย หลังคำขอสำเร็จ อ่านรายการ department ใน answers และตรวจสอบป้ายกำกับที่เลือกก่อนจัดเส้นทางทิกเก็ต ยืนยันว่าตัวระบุโมเดลพร้อมใช้งานในบัญชีของคุณ
จัดเส้นทางทิกเก็ตซัพพอร์ตด้วย TypeSafe Jev
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| องค์ประกอบการผสาน | OpenAI | Jev |
|---|---|---|
| อินพุต | input | state |
| คำถาม | อาร์เรย์ | ออบเจ็กต์แบบคีย์ |
| ID คำถาม | name | คีย์ของออบเจ็กต์ |
| คำถามแบบไบนารี | predicate | noul |
| ตัวเลือก | choices | criteria |
| รูปแบบคำตอบ | answers array | answers object |
นโยบายรีวิวร่วมสำหรับความน่าจะเป็นของคลาสที่เลือก
ใช้เกณฑ์ที่ปรับเทียบไว้อย่างชัดเจนกับความน่าจะเป็นของคลาสที่เลือก
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
ตัวอย่าง Python 3.10+ นี้เป็นเลเยอร์นโยบายของแอป ไม่ใช่พาร์เซอร์การตอบกลับของ API อแดปเตอร์ของแต่ละผู้ให้บริการต้องตรวจสอบความถูกต้องของการตอบกลับและดึงความน่าจะเป็นของคลาสที่เลือก อย่าส่งต่อฟิลด์ confidence ดิบของ Jev เป็น selected_probability จัดหาเกณฑ์ที่ปรับเทียบสำหรับผู้ให้บริการ คำถาม และชุดข้อมูลการประเมินนั้น ๆ; จัดการการปฏิเสธและข้อผิดพลาดการขนส่งก่อนเรียกนโยบาย
OpenAI Decisions API vs Jev: ควรเลือกอย่างไร
เลือกสองช่วง ขั้นแรก คัดกรองตามข้อกำหนดการดีพลอย: อินพุตภาพ การเข้าถึงบัญชี ขีดจำกัดอินพุต และความพยายามในการผสาน จากนั้นเบนช์มาร์กบริการที่มีสิทธิ์บนงานที่ติดฉลากเดียวกัน สำหรับการจัดเส้นทางข้อความล้วน ทดลองว่าอัตราราคาอินพุตที่ต่ำกว่าของ Jev แปลเป็นต้นทุนรวมที่ต่ำกว่าหรือไม่; สำหรับการตัดสินใจที่ขึ้นกับภาพ ให้ประเมินเส้นทางภาพโดยกำเนิดของ OpenAI เปรียบเทียบการจัดเส้นทางผิด การปรับเทียบ หน่วงเวลาหาง การลองใหม่ และการรีวิวโดยมนุษย์ที่เป้าหมายคุณภาพที่ตกลงกัน ตารางด้านล่างเป็นรายการสั้นเริ่มต้น ไม่ใช่หลักฐานของผู้ชนะด้านประสิทธิภาพโดยรวม
| กรณีใช้งาน | OpenAI Decisions API | Jev | คำแนะนำเชิงปฏิบัติ |
|---|---|---|---|
| การจัดเส้นทางซัพพอร์ต | รองรับ | รองรับ | เบนช์มาร์ก Jev ก่อนเพื่อประหยัดต้นทุน |
| การจัดหมวดหมู่ข้อความ | รองรับ | รองรับ | เปรียบเทียบการปรับเทียบ |
| ตรวจภาพหน้าจอ | รองรับโดยกำเนิด | ต้องมีการประมวลผลวิชันล่วงหน้า | OpenAI |
| การเลือกเครื่องมือเอเจนต์ | รองรับ | รองรับ | วัดผลลัพธ์แบบ end-to-end |
| โมเดอเรชันมัลติโมดัล | ข้อความและภาพ | ข้อความเท่านั้น | OpenAI |
| สแต็ก OpenAI ที่มีอยู่ | เนทีฟ | การผสานใหม่ | OpenAI |
สำหรับระบบอัตโนมัติธุรกิจปริมาณมาก เช่น การจัดเส้นทางซัพพอร์ตและการจัดหมวดหมู่ข้อความ Jev ควรได้รับความสำคัญเมื่ออัตราราคาอินพุตและปริมาณงานเป็นปัจจัยสำคัญ สำหรับแอปแบบมัลติโมดัล เช่น การตรวจภาพหน้าจอ โมเดอเรชันภาพ และการตัดสินใจบนภาพ OpenAI Decisions API เป็นตัวเลือกที่ใช้งานจริงมากกว่าเพราะรองรับภาพโดยกำเนิด สำหรับเอเจนต์ AI และเวิร์กโฟลว์องค์กร ทางเลือกขึ้นกับโครงสร้างพื้นฐานที่มีอยู่ ความซับซ้อนของการผสาน และผลกระทบของการตัดสินใจผิด OpenAI อาจให้เส้นทางที่ราบรื่นกว่าแก่ทีมที่ใช้งานระบบนิเวศของตนอยู่แล้ว ขณะที่ Jev ควรพิจารณาสำหรับงานข้อความขนาดใหญ่ ในทุกสถานการณ์ การตัดสินใจสุดท้ายควรอิงจากความแม่นยำ การปรับเทียบ หน่วงเวลาหาง และต้นทุนการดำเนินงานรวมที่วัดได้ มากกว่าราคาในหน้าหลักเพียงอย่างเดียว
ควรเบนช์มาร์ก OpenAI Decisions API เทียบกับ Jev อย่างไร?
รันทั้งสองบริการบนอินพุตจริงที่ติดฉลากชุดเดียวกัน โดยนิยามคำถามให้ตรงกันและใช้ภูมิภาคไคลเอนต์เดียวกัน ติดตามความแม่นยำ macro F1 ECE Brier score ค่าหน่วงเวลา p50/p95/p99 การหมดโควตา การหมดเวลา การปฏิเสธ อัตราการรีวิว และต้นทุนต่อการตัดสินใจที่ถูกต้องซึ่งยอมรับได้
| มิติ | เมตริกที่แนะนำ | เหตุผลที่สำคัญ |
|---|---|---|
| การจัดหมวดหมู่ | Accuracy, precision, recall, macro F1 | คุณภาพของป้ายกำกับ |
| การปรับเทียบ | ECE, Brier score | ความน่าเชื่อถือของความน่าจะเป็น |
| หน่วงเวลา | p50 / p95 / p99 | การตอบสนองเชิงปฏิบัติการ |
| ความเสถียร | อัตรา 429 / หมดเวลา / ปฏิเสธ | พฤติกรรมในการโปรดักชัน |
| เศรษฐศาสตร์ | ต้นทุนต่อการตัดสินใจที่ถูกต้องซึ่งยอมรับได้ | ค่าใช้จ่ายดำเนินงานจริง |
ขั้นตอนที่แนะนำ: สร้างชุดข้อมูลตัวแทนที่ติดฉลาก; รวมเคสที่คลุมเครือและนอกการกระจาย; ส่งงานที่มีความหมายเหมือนกัน; ทำซ้ำคำขอมากพอเพื่อวัดความแปรปรวน; ปรับเทียบเกณฑ์ของแต่ละระบบอย่างเป็นอิสระ; และเปรียบเทียบต้นทุน end-to-end รวมการยกระดับและการลองใหม่
บทสรุป
เลือก OpenAI Decisions API เมื่อการตัดสินใจขึ้นกับหลักฐานจากภาพ หรือเมื่อการผสานกับ OpenAI ที่มีอยู่ช่วยลดงานดีพลอย ประเมิน Jev สำหรับงานการตัดสินใจแบบข้อความล้วนที่อัตราราคาโทเค็นอินพุตที่ต่ำกว่าของมันสามารถลดค่าอนุมาน วัดคุณภาพป้ายกำกับ การปรับเทียบ หน่วงเวลาหาง และภาระงานรีวิวบนข้อมูลแอปเดียวกันก่อนเลือก
Jev มีอัตราค่าอินพุตฐานที่เผยแพร่ต่ำกว่า; OpenAI Decisions API รองรับอินพุตภาพโดยกำเนิด ตัวเลขจากผู้ขายที่อ้างถึงไม่ยืนยันผู้ชนะโดยรวมด้านความแม่นยำหรือความเร็ว ทางเลือกที่ดีที่สุดขึ้นกับต้นทุนและคุณภาพของการตัดสินใจที่ยอมรับได้ในเวิร์กโฟลว์ครบถ้วน
นักพัฒนาสามารถใช้ GPT-6 Luna API ใน CometAPI เพื่อสร้างต้นแบบการจัดหมวดหมู่แบบน้ำหนักเบาในเวิร์กโฟลว์หลายโมเดลที่กว้างขึ้น หน้ารุ่นที่ลิงก์ให้ตัวอย่าง Responses API การเข้าถึงเอ็นด์พอยต์แบบกำเนิดนั้นไม่ได้ยืนยันการรองรับเอ็นด์พอยต์ /v1/decisions โดยกำเนิด นี่คือต้นแบบการสร้างข้อความตามปกติ ไม่ได้ส่งคืนสคีมา answers แบบเนทีฟของ Decisions หรือการกระจายความน่าจะเป็นของคลาสที่ปรับเทียบ ตรวจสอบป้ายกำกับที่ได้กับหมวดหมู่ที่อนุญาตและจัดการข้อผิดพลาด API ก่อนเชื่อมต่อกับการกระทำปลายน้ำ ยืนยันการรองรับ /v1/decisions โดยกำเนิดแยกต่างหากหากต้องการเอ็นด์พอยต์นั้น