Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Gemini 4 Carbon คืออะไร? ผลทดสอบประสิทธิภาพ, คุณสมบัติ & ราคา ai-model / งานวิจัย CometAPI
Gemini 4 Carbon คืออะไร? ผลทดสอบประสิทธิภาพ, คุณสมบัติ & ราคา ค้นพบ Gemini 4 Carbon โมเดล AI ระดับแนวหน้าใหม่ของ Google
สำรวจเกณฑ์มาตรฐานด้านความปลอดภัยไซเบอร์ คุณสมบัติ ราคา การเปรียบเทียบ และความพร้อมใช้งาน
Deon Goodwin ทีมวิจัยโมเดล AI และ API ค้นพบ Gemini 4 Carbon โมเดล AI ระดับแนวหน้าใหม่ของ Google
สำรวจเกณฑ์มาตรฐานด้านความปลอดภัยไซเบอร์ คุณสมบัติ ราคา การเปรียบเทียบ และความพร้อมใช้งาน
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
Gemini 4 Carbon คือโมเดลแนวหน้าของ Google DeepMind สำหรับงานวิศวกรรมที่ต้องการสูงและความปลอดภัยไซเบอร์เชิงป้องกัน เปิดตัวเมื่อวันที่ 28 ตุลาคม 2026 และปรับปรุงจาก Argon ในการประเมินด้านโค้ด ความปลอดภัย และบริบทยาวที่เผยแพร่ อัตราราคาแนะนำอยู่ที่ $2 ต่อ 1M โทเค็นอินพุต และ $10 ต่อ 1M โทเค็นเอาต์พุต แต่การเข้าถึงช่วงแรกจำกัดเฉพาะผู้พิทักษ์ไซเบอร์ที่คัดเลือกและพาร์ทเนอร์ที่เชื่อถือได้ สำหรับนักพัฒนา โอกาสคือการทำงานอัตโนมัติที่แข็งแกร่งขึ้น; ข้อจำกัดเร่งด่วนคือการเข้าถึง
Key Takeaways
Gemini 4 Carbon คือโมเดลแนวหน้าถัดจาก Argon ของ Google ที่ปรับให้เหมาะกับวิศวกรรมเชิงเอเจนต์หลายวันและการป้องกันความปลอดภัยไซเบอร์
Gemini 4 Carbon อยู่อันดับ #1 บน Artificial Analysis Intelligence Index v5.0 (คะแนน 59) นำหน้า Claude Opus 5.5 (58) และ GPT-6 Astra (57) มีพัฒนาการเด่นในโค้ด, ฟูลสแตกเว็บ (+89 Elo บน WebDev Arena ขึ้นสู่อันดับ #4), การให้เหตุผลเชิงวิทยาศาสตร์, ความเข้าใจมัลติโหมด และ alignment (อัตราความสำเร็จ 0.0% บน Gray Swan Indirect Prompt Injection Benchmark)
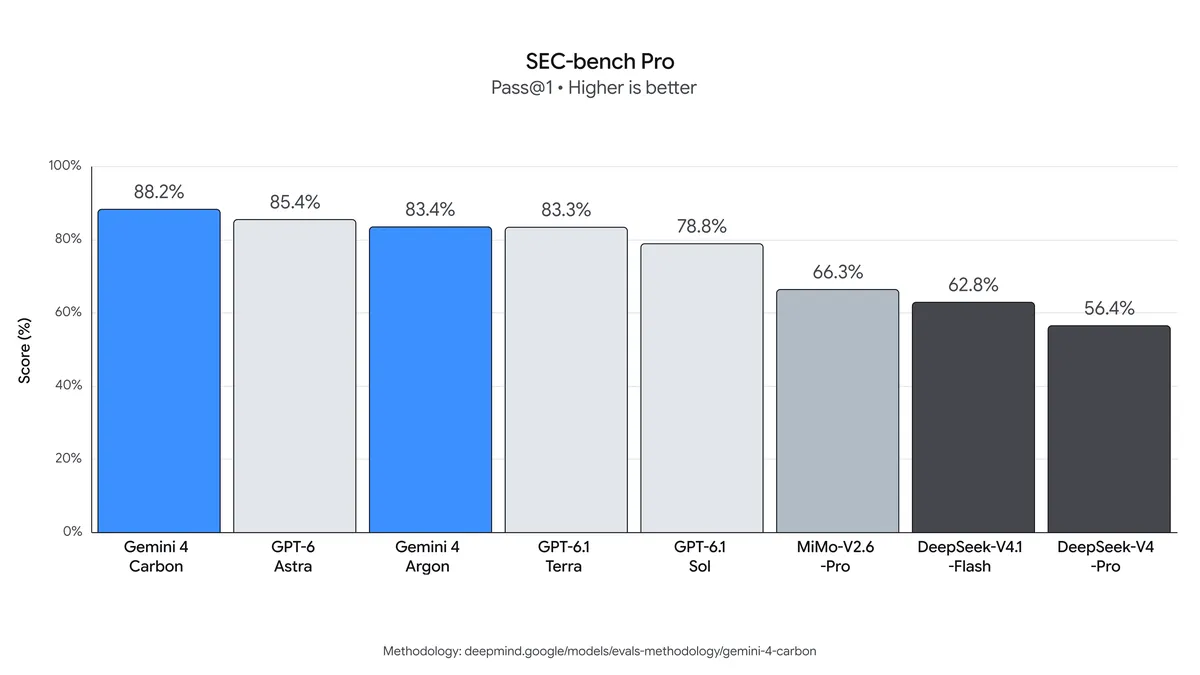
คะแนนความปลอดภัยไซเบอร์โดดเด่น (โดยไม่มี guardrails): 88.2% บน SEC-bench Pro (ค้นหาช่องโหว่), 54.8% บน ExploitGym (การใช้ประโยชน์), และ 71.0% บน CWE-bench (การแพตช์)
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ เผยแพร่เมื่อ Oct 29, 2026 อัปเดตล่าสุด Oct 29, 2026 ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
การเข้าถึงช่วงแรกแบบจำกัดผ่าน Fairwind Program สำหรับผู้พิทักษ์ไซเบอร์; API สาธารณะและการเปิดตัววงกว้างจะตามมา
ราคาแนะนำเหมือนกับ Argon; หลังช่วงแนะนำจะใช้ราคาแบบมาตรฐาน
แพลตฟอร์มอย่าง CometAPI รองรับตระกูล Gemini (รวม Argon) ผ่าน API แบบเข้ากันกับ OpenAI ทำให้สลับโมเดลและเตรียมพร้อมสำหรับ Carbon ได้ง่าย รายละเอียด API สาธารณะและวันวางจำหน่ายแบบวงกว้างยังไม่ประกาศ ณ วันที่ 29 ตุลาคม 2026
What Is Gemini 4 Carbon? Gemini 4 Carbon คือโมเดลแนวหน้ารุ่นใหม่ล่าสุดของ Google ที่ออกแบบมารองรับงานวิศวกรรมซอฟต์แวร์ซับซ้อน งานวิจัยความปลอดภัยไซเบอร์ และเวิร์กโฟลว์อัตโนมัติ
ตามประกาศทางการ Carbon สร้างต่อยอดจากพื้นฐานของ Gemini 4 Argon พร้อมการปรับปรุงอย่างมากในด้านโค้ด การให้เหตุผลเชิงเอเจนต์ และงานที่เน้นความปลอดภัย
Carbon ถูกออกแบบมาสำหรับงานที่ต้องสืบค้น ปฏิบัติ และตรวจยืนยันหลายขั้นตอน เอเจนต์วิศวกรรมเชิงป้องกันอาจตรวจสอบรีโพซิทอรี ยืนยันช่องโหว่ที่สงสัยในสภาพแวดล้อมแยก ออกแพตช์ และทดสอบว่าการเปลี่ยนแปลงแก้ไขปัญหาเดิมได้หรือไม่
Google รายงานว่าทีมภายในสังเกตเห็น Carbon ดำเนินงานวิศวกรรมซับซ้อนต่อเนื่องข้ามหลายวัน นี่เป็นการสังเกตภายใน ไม่ใช่การรับประกันเวลาทำงานอัตโนมัติที่เฉพาะเจาะจง Google ยังไม่เผยรายงานเทคนิคเต็มจำนวน พารามิเตอร์ หรือรายละเอียดสถาปัตยกรรม Context window และขีดจำกัดเอาต์พุตคาดว่าจะใกล้เคียงหรือดีกว่า Argon (รายงานว่าอยู่ในระดับหลายล้านโทเค็นพร้อมความจุเอาต์พุตสูง) และรองรับอินพุตแบบมัลติโหมดรวมถึงข้อความ รูปภาพ วิดีโอ เสียง และ PDF
What Are the Key Features of Gemini 4 Carbon?
Long-Horizon Software Engineering Carbon ถูกออกแบบมาสำหรับปัญหาวิศวกรรมที่ไม่สามารถทำเสร็จได้อย่างน่าเชื่อถือในขั้นคิดครั้งเดียว
ตัวอย่างได้แก่ การวิเคราะห์สาเหตุราก (root-cause) ในรีโพซิทอรีขนาดใหญ่ ความล้มเหลวที่เกี่ยวกับ dependency การดีบักระบบระดับต่ำ และการรีแฟคเตอร์ที่ซับซ้อน
การปรับปรุงมุ่งเป้าความสามารถในการทำงานต่อหลังจากความพยายามแรกไม่สำเร็จ
เอเจนต์เขียนโค้ดที่มีประสิทธิภาพต้องรู้ว่าเมื่อใดวิธีแรกล้มเหลว ตรวจหลักฐานใหม่ และปรับวิธีโดยไม่หลุดจากงานเดิม
Defensive Cybersecurity Workflows ผลด้านความปลอดภัยของ Carbon ครอบคลุมการค้นหาช่องโหว่ การยืนยันความสามารถในการใช้ประโยชน์ และการแพตช์ข้อบกพร่อง คำถามที่เป็นประโยชน์สำหรับทีมรักษาความปลอดภัยคือเอเจนต์สามารถเดินจากประเด็นที่สงสัยไปสู่หลักฐานที่ทำซ้ำได้และการแก้ไขที่ผ่านการทดสอบ ขณะเคารพสิทธิ์และสภาพแวดล้อมที่กำหนดให้หรือไม่
Long-Context and Multimodal Understanding Carbon ทำคะแนน GraphWalks BFS F1 ที่ 96.2% ในชุดย่อย 256K–1M โทเค็น เพิ่มจาก 84.2% ของ Argon นี่เป็นหลักฐานเกี่ยวกับการให้เหตุผลบนกราฟในบริบทยาว ไม่ใช่การรับประกันการดึงข้อมูลถูกต้องจากเอกสารระดับล้านโทเค็นใดๆ
ผลของ Chartography และ Blueprint-Bench 2 ที่เผยแพร่ยังครอบคลุมความเข้าใจเชิงภาพ การทดสอบเหล่านี้ช่วยระบุเวิร์กโฟลว์เอกสารและชาร์ตที่มีแนวโน้ม แต่ไม่ได้กำหนด schema มัลติโหมดทั้งหมดของ API สาธารณะในอนาคต
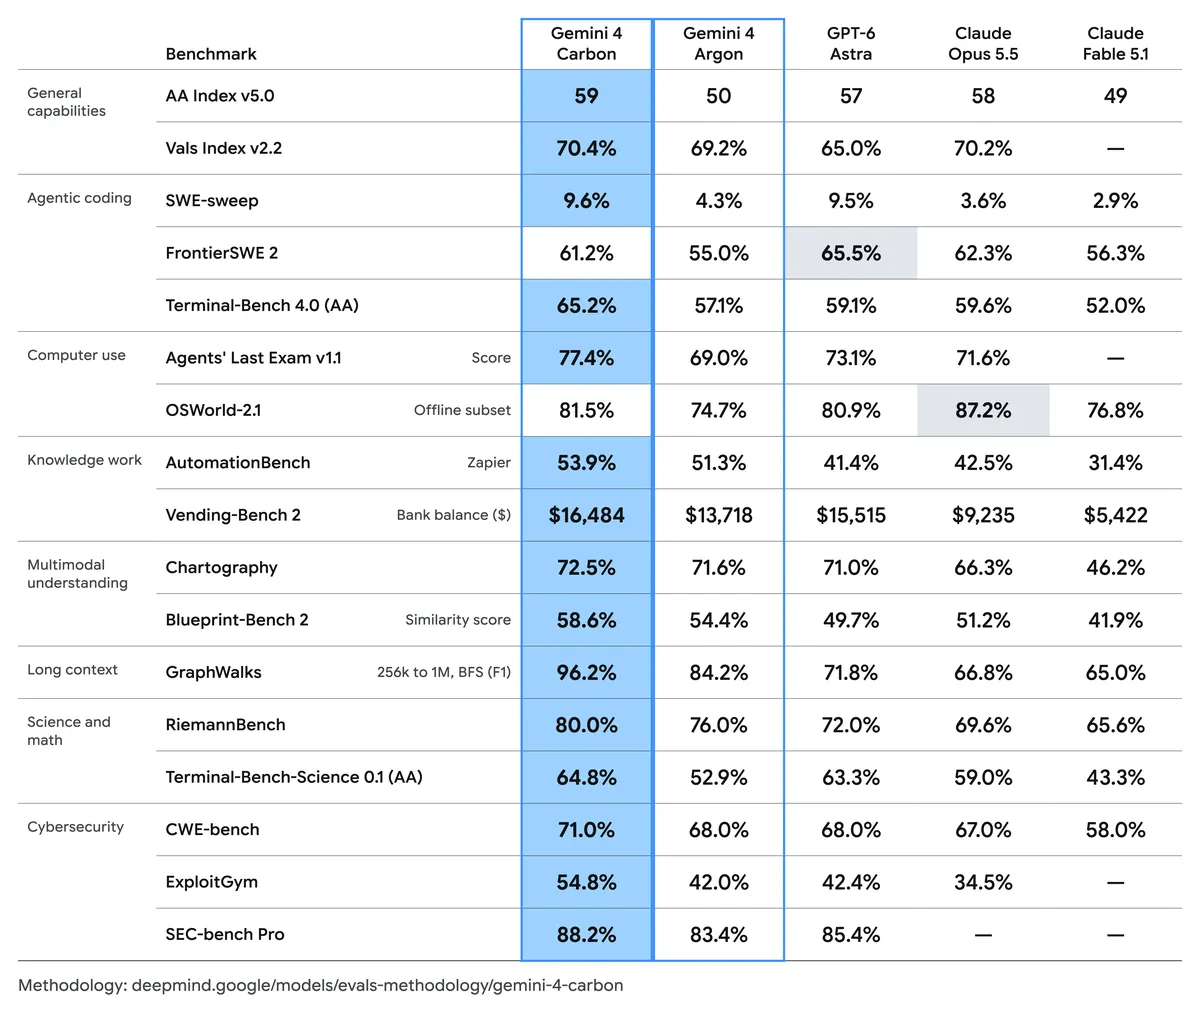
ผลที่เผยแพร่ชี้สามเหตุผลในการประเมิน Carbon: ประสิทธิภาพโค้ดที่แข็งแรงขึ้น การให้เหตุผลบริบทยาวที่ดีขึ้น และการพัฒนาข้ามเวิร์กโฟลว์ความปลอดภัยไซเบอร์ ประกาศทางการ รวมแผนภูมิเปรียบเทียบต้นฉบับด้านล่าง; สาระสำคัญสรุปไว้ในส่วนถัดไป
เลือกเกณฑ์ที่คล้ายกับงานของคุณเอง โมเดลที่นำดัชนีสติปัญญาทั่วไปอาจยังตามหลังโมเดลอื่นในงานวิศวกรรมเฉพาะด้าน
Benchmark Results and Test Conditions การให้เหตุผลโดยรวม: Carbon ทำคะแนน 59 บน AA Intelligence Index v5.0 เทียบกับ 50 ของ Argon, 57 ของ GPT-6 Astra และ 58 ของ Claude Opus 5.5
โค้ด: Terminal-Bench 4.0 เพิ่มจาก 57.1% เป็น 65.2% เพิ่มขึ้น 8.1 จุดเปอร์เซ็นต์เหนือ Argon SWE-sweep เพิ่มจาก 4.3% เป็น 9.6%
การให้เหตุผลบริบทยาว: Carbon ทำคะแนน 96.2% บนชุดย่อย GraphWalks 256K–1M โทเค็น BFS F1 เพิ่มจาก 84.2% ของ Argon
จุดที่ทางเลือกอื่นเหนือกว่า: GPT-6 Astra ทำ 65.5% บน FrontierSWE 2 เทียบกับ 61.2% ของ Carbon; Claude Opus 5.5 ทำ 87.2% บนชุดย่อยออฟไลน์ OSWorld เทียบกับ 81.5% ของ Carbon การเปรียบเทียบเหล่านี้อ้างถึงโมเดลและการตั้งค่าประเมินในแผนภูมิที่เผยแพร่
จากผลที่เลือก 17 รายการในแผนภูมิต้นฉบับ Carbon นำ 15 รายการ ความกว้างดังกล่าวทำให้เป็นผู้สมัครที่น่าคาดหวังสำหรับเวิร์กโฟลว์ซับซ้อน แต่สองข้อยกเว้นชี้ว่ามิกซ์งานของคุณสำคัญ เปรียบเทียบโมเดลบนผลที่ยอมรับได้ เวลาแล้วเสร็จ และต้นทุน แทนที่จะเฉลี่ยคะแนนเกณฑ์ที่ไม่เกี่ยวข้องกัน
วิธีการประเมิน โดยทั่วไปใช้การตั้งค่า thinking สูงสุดและ pass@1 เว้นแต่ระบุเป็นอย่างอื่น ผสานผลที่ Google รันกับผู้ประเมินภายนอกและคะแนนที่ผู้ให้บริการรายงาน ดังนั้น agent scaffolding และงบประมาณ reasoning จึงไม่เหมือนกันทุกแถว
GraphWalks: ชุดย่อยที่อ้างถึงใช้ 200 ปัญหาและรายงาน BFS F1Agents’ Last Exam: การประเมินใช้ชุด v1.1 จำนวน 122 งาน ฮาร์เนส ALE-Claw หน้าต่างเวลา 5 ชั่วโมง และเปิดใช้งานตัวกรองความปลอดภัยOSWorld: ผลที่รายงานครอบคลุมชุดย่อยออฟไลน์ 82 งาน และใช้ค่าสูงสุดจากสามการรันแบบครั้งเดียว
Carbon ปรับ Terminal-Bench 4.0 จาก 57.1% เป็น 65.2% เพิ่ม 8.1 จุดเปอร์เซ็นต์ SWE-sweep เพิ่มจาก 4.3% เป็น 9.6% มากกว่าสองเท่าแม้ยังต่ำกว่า 10% ในเชิงสัมบูรณ์ ผลลัพธ์เหล่านี้สนับสนุนการประเมินงานรีโพซิทอรีที่ยาก ขณะเดียวกันก็ชี้เหตุผลว่าทำไมการทดสอบอิสระและการรีวิวจึงยังจำเป็น
How Strong Is Gemini 4 Carbon at Cybersecurity? SEC-bench Pro — การค้นหาช่องโหว่ 88.2% 83.4% +4.8 จุดเปอร์เซ็นต์ ExploitGym — การตรวจสอบการใช้ประโยชน์ 54.8% 42.0% +12.8 จุดเปอร์เซ็นต์ CWE-bench — การแก้ไขช่องโหว่ 71.0% 68.0% +3.0 จุดเปอร์เซ็นต์
การเพิ่มที่ใหญ่ที่สุดอยู่ในการตรวจสอบการใช้ประโยชน์ สำหรับทีมป้องกันที่ได้รับอนุญาต หลักฐานที่ทำซ้ำได้ว่าช่องโหว่สามารถใช้ประโยชน์ได้ช่วยปรับปรุงการจัดลำดับความสำคัญ; เพียงข้อค้นพบที่น่าเชื่อยังไม่พอ แพตช์ยังต้องมีการทดสอบเพื่อยืนยันว่าข้อบกพร่องเดิมได้รับการแก้ไขและฟังก์ชันที่มีอยู่ยังคงทำงาน
Google รายงานการประเมินความปลอดภัยภายนอกโดยไม่เปิดใช้ guardrails SEC-bench Pro ใช้ชุดแยก 183 งานของ JavaScript engine; ExploitGym ใช้การตั้งค่าออฟไลน์ลองครั้งเดียวโดยปิดมาตรการลดผลกระทบ เงื่อนไขเหล่านี้ไม่ได้กำหนดพฤติกรรมโปรดักชันแบบไม่จำกัดหรืออัตราการตรวจจับสำหรับซอฟต์แวร์โลกจริงแบบใดก็ได้
Is Gemini 4 Carbon Safer and More Reliable Than Argon?
ข้อกล่าวอ้างที่ไม่ได้รับการสนับสนุนลดลงประมาณ 50% เมื่อเทียบกับ Argon ในการทดสอบภายใน
การเกินขอบเขตของเอเจนต์ลดลง 26%
การให้บริการไม่เพียงพอลดลง 29%
การแจ้งเตือนการไม่สอดคล้องระดับความรุนแรงสูงลดลงเกือบ 80% ในสภาพแวดล้อมการโค้ดภายใน
การโกงที่สำเร็จบน Terminal-Bench 4.0 ลดลงเหลือ 0.0% ในการประเมินของ Google
บนเกณฑ์ Gray Swan สำหรับ indirect prompt injection อัตราความสำเร็จของการโจมตีของ Carbon อยู่ที่ 0.0% เทียบกับ 0.7% ของ Argon ซึ่งหมายความว่าการโจมตีที่ประเมินไม่สำเร็จภายใต้การตั้งค่านั้น ไม่ใช่ภูมิคุ้มกันต่อการโจมตีแบบใหม่หรือสภาพแวดล้อมเครื่องมือที่ต่างไป
ตัวเลขเหล่านี้มาจากการประเมินต่างชนิดกันและไม่ควรถูกรวมเป็นคะแนนความเชื่อถือได้เดียว
สำหรับเอเจนต์ในโปรดักชัน ควรรักษาการตรวจสิทธิ์อิสระ บันทึกการดำเนินการ และการตรวจยืนยันผลที่อ้าง โมเดลที่ปรับปรุงพฤติกรรมช่วยได้ แต่แอปพลิเคชันยังต้องควบคุมว่าไฟล์ บริการ และการกระทำใดที่อนุญาต
How Much Does the Gemini 4 Carbon API Cost? Google ได้ประกาศอัตราโทเค็นช่วงแนะนำและช่วงถัดไป ตัวเลข cached-input ด้านล่างคำนวณจากส่วนลดที่ประกาศ 95%; การใช้งาน API สาธารณะและรายละเอียดคุณสมบัติยังรอประกาศ
โทเค็นอินพุต $2.00 $4.00 โทเค็นเอาต์พุต $10.00 $20.00 โทเค็นอินพุตแบบแคชที่มีสิทธิ์ $0.10 $0.20
ช่วงราคาแนะนำของ Carbon ยังไม่มีวันสิ้นสุดที่ประกาศไว้ ราคาช่วงแนะนำของ Argon ที่เผยแพร่จะสิ้นสุดวันที่ 30 พฤศจิกายน 2026 ; เส้นตายนี้ไม่ควรนำมาใช้กับ Carbon ราคาแบบ batch ค่าธรรมเนียมเครื่องมือเพิ่มเติม และระดับฟรียังไม่ได้ประกาศสำหรับ Carbon
Example Request Cost สมมุติว่าคำขอใช้โทเค็นอินพุตที่ไม่แคช 200,000 และโทเค็นเอาต์พุตที่คิดค่าบริการรวม 10,000 ที่อัตราช่วงแนะนำ อินพุตมีค่า $0.40 และเอาต์พุต $0.10 รวม $0.50 ใช้โทเค็นเท่าเดิมจะมีค่า $1.00 ที่อัตราช่วงถัดไป
หากโทเค็นอินพุต 200,000 ทั้งหมดมีสิทธิ์ส่วนลดอินพุตแบบแคช การประเมินช่วงแนะนำจะเป็น $0.12 รวมเอาต์พุต นี่เป็นตัวอย่างแบบมีเงื่อนไข ไม่ใช่คำสัญญาว่าอินพุตซ้ำทุกกรณีจะมีสิทธิ์
สิทธิ์เอาต์พุตต้องรวมโทเค็น thinking ใดๆ ที่ถูกคิดเป็นเอาต์พุตภายใต้กฎที่ใช้งานจริงสุดท้าย หาก 10,000 อ้างเฉพาะคำตอบที่มองเห็น โทเค็น thinking ที่คิดเป็นเอาต์พุตเพิ่มเติมจะเพิ่มประมาณการ เครื่องมือ การลองใหม่ และบริการอื่นๆ ไม่รวมอยู่
How Can Developers Prepare for the Gemini 4 Carbon API?
Current Gemini 4 Carbon API Availability ณ วันที่ 29 ตุลาคม 2026 การเข้าถึงเริ่มจากผู้พิทักษ์ความปลอดภัยไซเบอร์ที่คัดเลือก และค่อยๆ ขยายสู่พาร์ทเนอร์ที่เชื่อถือได้ Fairwind Program ของ Google อธิบายเส้นทางการเข้าถึงแบบควบคุม วันที่เปิดให้นักพัฒนาใช้งานวงกว้างและตัวระบุโมเดล Carbon สำหรับสาธารณะยังไม่ประกาศ
ดังนั้นราคาที่ประกาศยังไม่ได้หมายความว่าแอปพลิเคชันสามารถเรียก Carbon API ที่พร้อมใช้งานทั่วไปได้ในวันนี้ ขีดจำกัด context สูงสุด เอาต์พุตสูงสุด schema มัลติโหมด ความเข้ากันได้ของเครื่องมือ และข้อจำกัดการปฏิบัติงานสุดท้ายยังต้องมีสเปคโปรดักชันที่เป็นเอกสาร
ณ วันที่ 29 ตุลาคม 2026 Google ยังไม่เปิด Carbon API ที่พร้อมใช้งานทั่วไป ดังนั้น Carbon จึงยังไม่พร้อมผ่าน CometAPI ขณะรอ คุณสามารถใช้ Gemini 4 Argon เพื่อการประเมินเบื้องต้น ตรวจหน้า CometAPI Carbon เพื่อความพร้อมใช้งานและราคาผู้ให้บริการเมื่อเปิดการเข้าถึง
Alternatives While You Wait for the Carbon API คุณสามารถเริ่มประเมินเวิร์กโฟลว์การโค้ดของคุณก่อนที่ Carbon จะพร้อมใช้งานวงกว้าง สร้าง baseline ด้วยโมเดลที่เข้าถึงได้วันนี้ จากนั้นเปรียบเทียบ Carbon บนงานเดียวกันเมื่อ API เปิด ตัวเลือกสามทางที่ควรพิจารณา ได้แก่ Gemini 4 Argon, GPT-6.1 Astra และ Claude Opus 5.5; ยืนยันชื่อโมเดล การเข้าถึง และราคากับผู้ให้บริการก่อนเลือกเส้นทาง
Gemini 4 Argon:
**GPT-6.1 Astra :** รวมไว้เป็นการเปรียบเทียบข้ามผู้ให้บริการสำหรับงานวิศวกรรมเดียวกัน วัดจำนวนการแก้ไขที่ยอมรับได้ เวลาแล้วเสร็จ และต้นทุนรวม ผลของ GPT-6 Astra ที่กล่าวถึงก่อนหน้าถูกต้องกับเวอร์ชันที่ทดสอบนั้นและไม่ควรถูกถือเป็นคะแนนของ GPT-6.1 Astra
**Claude Opus 5.5 :** เพิ่มเป็นอีกผู้สมัครสำหรับการวิเคราะห์รีโพซิทอรี รีแฟคเตอร์ และรีวิว ใช้คำอธิบายงานและเกณฑ์ตรวจยืนยันเดียวกันเพื่อเปรียบเทียบคุณค่าจริงของแต่ละผลลัพธ์
เก็บการเลือกโมเดลให้กำหนดค่าได้และบันทึกพรอมป์ต์ เคสทดสอบ และผลลัพธ์จากแต่ละการรัน นั่นจะให้จุดเริ่มต้นที่มีประโยชน์สำหรับการประเมิน Carbon โดยไม่ผูกเวิร์กโฟลว์ของคุณกับรูปแบบ API ที่ยังไม่ประกาศ
AA Intelligence Index v5.0 59 50 57 58 Vals Index v2.2 70.4% 69.2% 65.0% 70.2% SWE-sweep 9.6% 4.3% 9.5% 3.6% FrontierSWE 2 61.2% 55.0% 65.5% 62.3% Terminal-Bench 4.0 (AA) 65.2% 57.1% 59.1% 59.6% Agents' Last Exam v1.1 77.4% 69.0% 73.1% 71.6% OSWorld-2.1, offline subset 81.5% 74.7% 80.9% 87.2% AutomationBench, Zapier 53.9% 51.3% 41.4% 42.5%
Prepare a Model Evaluation Workflow กรอบการประเมินเชิงปฏิบัติควรประเมินมากกว่าคุณภาพคำตอบทั่วไป
สำหรับเวิร์กโฟลว์โค้ดและความปลอดภัย เมตริกที่มีประโยชน์รวมถึง:
อัตราความสำเร็จของงาน: เอเจนต์ทำตาม acceptance tests ที่กำหนดไว้สำเร็จบ่อยแค่ไหนความถูกต้องของแพตช์: การเปลี่ยนแปลงแก้ข้อบกพร่องเดิมโดยไม่ทำให้พฤติกรรมที่มีอยู่เสียหรือไม่อัตราบวกเทียม: รายงานปัญหากี่ครั้งที่ไม่ผ่านการยืนยันLatency ปลายทาง-ถึง-ปลายทาง: เวิร์กโฟลว์ทั้งหมดใช้เวลานานเท่าไร รวมการรันเครื่องมือต้นทุนงานรวม: แต่ละผลลัพธ์ที่ยอมรับมีค่าใช้จ่ายเท่าไรหลังการลองใหม่และการใช้เครื่องมือการปฏิบัติตามคำสั่ง: เอเจนต์ทำงานภายในไฟล์ เครื่องมือ และการกระทำที่ได้รับอนุญาตหรือไม่ ใช้ชุดงานจริงที่ตายตัวและเก็บบันทึกโมเดล การตั้งค่า การใช้โทเค็น และผลการทดสอบ รวมการลองใหม่และการแก้ไขด้วยมือในต้นทุน เมื่อ Carbon พร้อมใช้งาน ให้รันการประเมินเดียวกันเพื่อดูว่ามันส่งงานที่ยอมรับได้มากขึ้นต่อเวลาและงบประมาณของคุณหรือไม่
Conclusion Gemini 4 Carbon เป็นการอัปเกรดที่มีแนวโน้มสำหรับงานโค้ดยาก การให้เหตุผลบริบทยาว และการป้องกันความปลอดภัย ผลที่เผยแพร่ชี้ถึงความก้าวหน้าชัดเจนเหนือ Argon ขณะที่การเข้าถึงยังจำกัด ณ วันที่ 29 ตุลาคม 2026 สำหรับตอนนี้ สร้าง baseline ด้วยโมเดลที่ใช้ได้และทำให้การผสานงานยืดหยุ่น เมื่อ API สาธารณะของ Carbon เปิด ให้เปรียบเทียบคุณภาพงานที่เสร็จ เวลา ที่ประหยัดได้ และต้นทุนรวมก่อนตัดสินใจสลับ
FAQ
Can Gemini 4 Carbon run without human supervision? รายงานการทำงานวิศวกรรมภายในหลายวันไม่ได้ยืนยันความเชื่อถือได้แบบไร้ผู้ดูแลสำหรับงานใดๆ ทีมที่พิจารณาการทำงานอัตโนมัติควรกำหนดการกระทำที่อนุญาต เงื่อนไขหยุด และ acceptance tests จากนั้นวัดความถี่ที่เอเจนต์ทำงานเสร็จโดยไม่ต้องแก้ไข เวลา runtime เพียงอย่างเดียวไม่ได้ชี้ว่าผลลัพธ์เอเจนต์ถูกต้อง
Can an existing Argon integration switch directly to Carbon? ไม่จากหลักฐานที่มีอยู่ที่นี่ รักษาการเลือกผู้ให้บริการให้กำหนดค่าได้ แต่ตรวจสอบตัวระบุโมเดลจริงของ Carbon schema ที่รองรับ เครื่องมือ ขีดจำกัด และการเข้าถึงบัญชีก่อนเปลี่ยนการปรับใช้ การใช้พรอมป์ต์ซ้ำช่วยการเปรียบเทียบแบบควบคุม แต่ไม่พิสูจน์ความเข้ากันได้ของ API
Which Gemini 4 Carbon tests matter for a private codebase? รวมบั๊ก การเปลี่ยนแปลงรีโพซิทอรี และการค้นพบความปลอดภัยที่แทนงานจริงพร้อมเกณฑ์การยอมรับที่รู้จัก ตรวจว่าแพตช์ผ่านการทดสอบที่เกี่ยวข้องหรือไม่ การค้นพบทำซ้ำได้หรือไม่ และไม่มีการเปลี่ยนแปลงพฤติกรรมที่ไม่เกี่ยวข้อง รวมความพยายามที่ล้มเหลวและการแก้ด้วยมือในต้นทุน เพื่อป้องกันไม่ให้คะแนนเกณฑ์สาธารณะซ่อนงานเชิงปฏิบัติการ