

TL;DR
Claude Opus 5.5 là ứng viên khởi đầu mạnh vì có mức giá token thấp hơn đáng kể trong khi đạt ngang bằng hoặc vượt Fable 5.1 trên nhiều đánh giá đã công bố, với giá $4 cho mỗi triệu token đầu vào và $20 cho mỗi triệu token đầu ra, so với Fable 5.1 lần lượt là $10 và $50.
Fable 5.1 vẫn có vai trò khi tác vụ đặc biệt khó, chạy lâu, tốn kém để thử lại, hoặc dự kiến vận hành không có giám sát chặt. Quy tắc thực tế rất đơn giản: bắt đầu với Opus 5.5, sau đó chỉ nâng cấp khi các thử nghiệm sản xuất đại diện cho thấy Fable 5.1 giảm thất bại, chi phí chỉnh sửa hoặc thử lại đủ để biện minh cho mức giá cao hơn.
Claude Opus 5.5 vs Claude Fable 5.1 — Tổng quan nhanh
| Chiều cạnh | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Ngày phát hành | 22 Thg 9, 2026 | 1 Thg 9, 2026 |
| API model ID | claude-opus-5-5 | claude-fable-5-1 |
| Ngữ cảnh / đầu ra tối đa | 1M / 128K | 1M / 128K |
| Giá đầu vào / đầu ra mỗi MTok | $4 / $20 | $10 / $50 |
| Đọc cache mỗi MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| Di chuyển HAProxy C-to-Rust | 9.5 giờ; chi phí tác vụ thấp hơn 51% | 12 giờ; chi phí tác vụ cơ sở |
| Tùy chọn tốc độ | Chế độ Nhanh, tối đa 2.5× tốc độ bình thường | Không có chế độ khởi chạy tương đương |
| Điểm khởi đầu về nỗ lực | Định hướng mức trung bình | Cao |
| Mặc định phù hợp nhất | Lập trình tiên phong hằng ngày, tác tử, sản xuất có giám sát, và lưu lượng API lớn | Công việc giá trị cao, khó, chạy lâu, hoặc tự chủ không giám sát |
| Truy cập API | Anthropic API và nhà cung cấp tương thích, bao gồm CometAPI | Anthropic API và nhà cung cấp tương thích, bao gồm CometAPI |
Lưu ý khi đọc: Các số liệu benchmark do Anthropic báo cáo và phụ thuộc vào mức nỗ lực, bộ khung, biện pháp bảo vệ, phiên bản tác vụ, số lần thử và sai số chuẩn. Chỉ nên so sánh khi điều kiện đánh giá được khớp.
Điểm chính
- Mức giá đầu vào và đầu ra tiêu chuẩn của Opus 5.5 thấp hơn 60% so với Fable 5.1.
- Cả hai model hỗ trợ cửa sổ ngữ cảnh 1M token và đầu ra tối đa 128K, vì vậy chi phí, cài đặt nỗ lực và độ phù hợp khối lượng công việc quan trọng hơn kích thước ngữ cảnh danh nghĩa.
- Kết quả công bố của Anthropic nghiêng về Opus 5.5 trên nhiều đánh giá lập trình và tác tử, nhưng cài đặt benchmark ảnh hưởng đáng kể đến kết quả.
- Đánh giá độc lập ủng hộ vị thế tiên phong của Opus 5.5 dù báo cáo điểm tuyệt đối khác, củng cố nhu cầu thử nghiệm có điều kiện khớp.
- Với hầu hết công việc sản xuất có giám sát, Opus 5.5 là điểm xuất phát mạnh hơn. Fable 5.1 là tầng nâng cấp, không phải mặc định tự động.
Claude Opus 5.5 là gì?
Claude Opus 5.5 là model Claude 5.5 đầu tiên của Anthropic. Nó được định vị cho lập trình tác tử, tác tử chạy lâu, công việc tri thức chuyên nghiệp, quy trình doanh nghiệp, phân tích tài chính, thị giác và sử dụng máy tính.
API model ID là claude-opus-5-5. Tư duy thích ứng luôn bật, và nhà phát triển điều khiển cường độ suy luận thông qua các mức nỗ lực low, medium, high, xhigh và max. Anthropic cũng cung cấp Fast mode, có thể chạy nhanh gấp đến 2.5 lần với giá $8/M đầu vào và $40/M đầu ra.
Claude Fable 5.1 là gì?
Claude Fable 5.1 được định vị cho các dự án khó, chạy lâu như lập trình nhiều giờ, nghiên cứu phức tạp, tương tác trình duyệt, tác tử tự chủ và quy trình qua nhiều ứng dụng.
API model ID là claude-fable-5-1. Model dùng tư duy thích ứng, khởi đầu từ mức nỗ lực API cao hơn, và tốt nhất được xem là lựa chọn cao cấp khi chi phí kỳ vọng của thất bại hoặc thử lại nhiều lần vượt chi phí suy luận bổ sung.
Cách đọc đơn giản là Opus 5.5 cung cấp gần như cùng biên độ khả năng với 40% mức giá token tiêu chuẩn của Fable. Nhưng đây chính là chỗ bảng thông số đơn giản dễ gây hiểu lầm.
So sánh Lập trình và Benchmark
Anthropic báo cáo Opus 5.5 vượt Fable 5.1 trên Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam with tools, Terminal-Bench-Science, OSWorld 2.0 và Chartography.
Cách đọc kết quả benchmark
Anthropic báo cáo Opus 5.5 vượt Fable 5.1 trên Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam with tools, Terminal-Bench-Science, OSWorld 2.0 và Chartography. Các con số này là kết quả đánh giá, không phải hằng số model độc lập với cấu hình.
Hầu hết điểm nổi bật của Opus 5.5 dùng mức nỗ lực max, còn Terminal-Bench 4.0 dùng xhigh. Thiết kế bộ khung, cấu hình công cụ, biện pháp bảo vệ, số lần thử, sai số chuẩn, hành vi dự phòng và trần chi phí đều có thể thay đổi kết quả. Ngay cả Anthropic cũng cảnh báo rằng biên độ benchmark có thể phóng đại khoảng cách thực tế giữa các model tiên phong.
Hiệu năng lập trình
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Diễn giải |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | Dẫn trước 10.6 điểm cho tác vụ tác tử dựa trên terminal |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | Opus 5.5 ở mức medium vẫn cạnh tranh về hiệu quả kinh tế sản xuất |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | Mức medium hơi vượt kết quả báo cáo của Fable |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Lợi thế trên công việc chuyên nghiệp mang tính tác tử |
Các con số này là kết quả benchmark do Anthropic báo cáo. Bảng cần được đọc cùng với các lưu ý về cài đặt đánh giá trong các phần sau và trang model Claude Opus chính thức.
Ba kết quả đầu đáng chú ý vì chúng bao quát khối lượng công việc nơi Claude ngày càng quan trọng về thương mại: tác tử kỹ sư phần mềm. Terminal-Bench 4.0 cho thấy chênh lệch tuyệt đối 10.6 điểm phần trăm; FrontierCode chênh 4.1 điểm; CursorBench 4.0 chênh 6 điểm.
GDPval-AA, đo lường công việc chuyên nghiệp mang tính tác tử, cũng báo cáo 1846 Elo cho Opus 5.5 so với 1735 cho Fable 5.1. Nếu chỉ nhìn các con số này, trật tự sản phẩm có vẻ đảo ngược. Không đơn giản như vậy.
Đánh giá độc lập
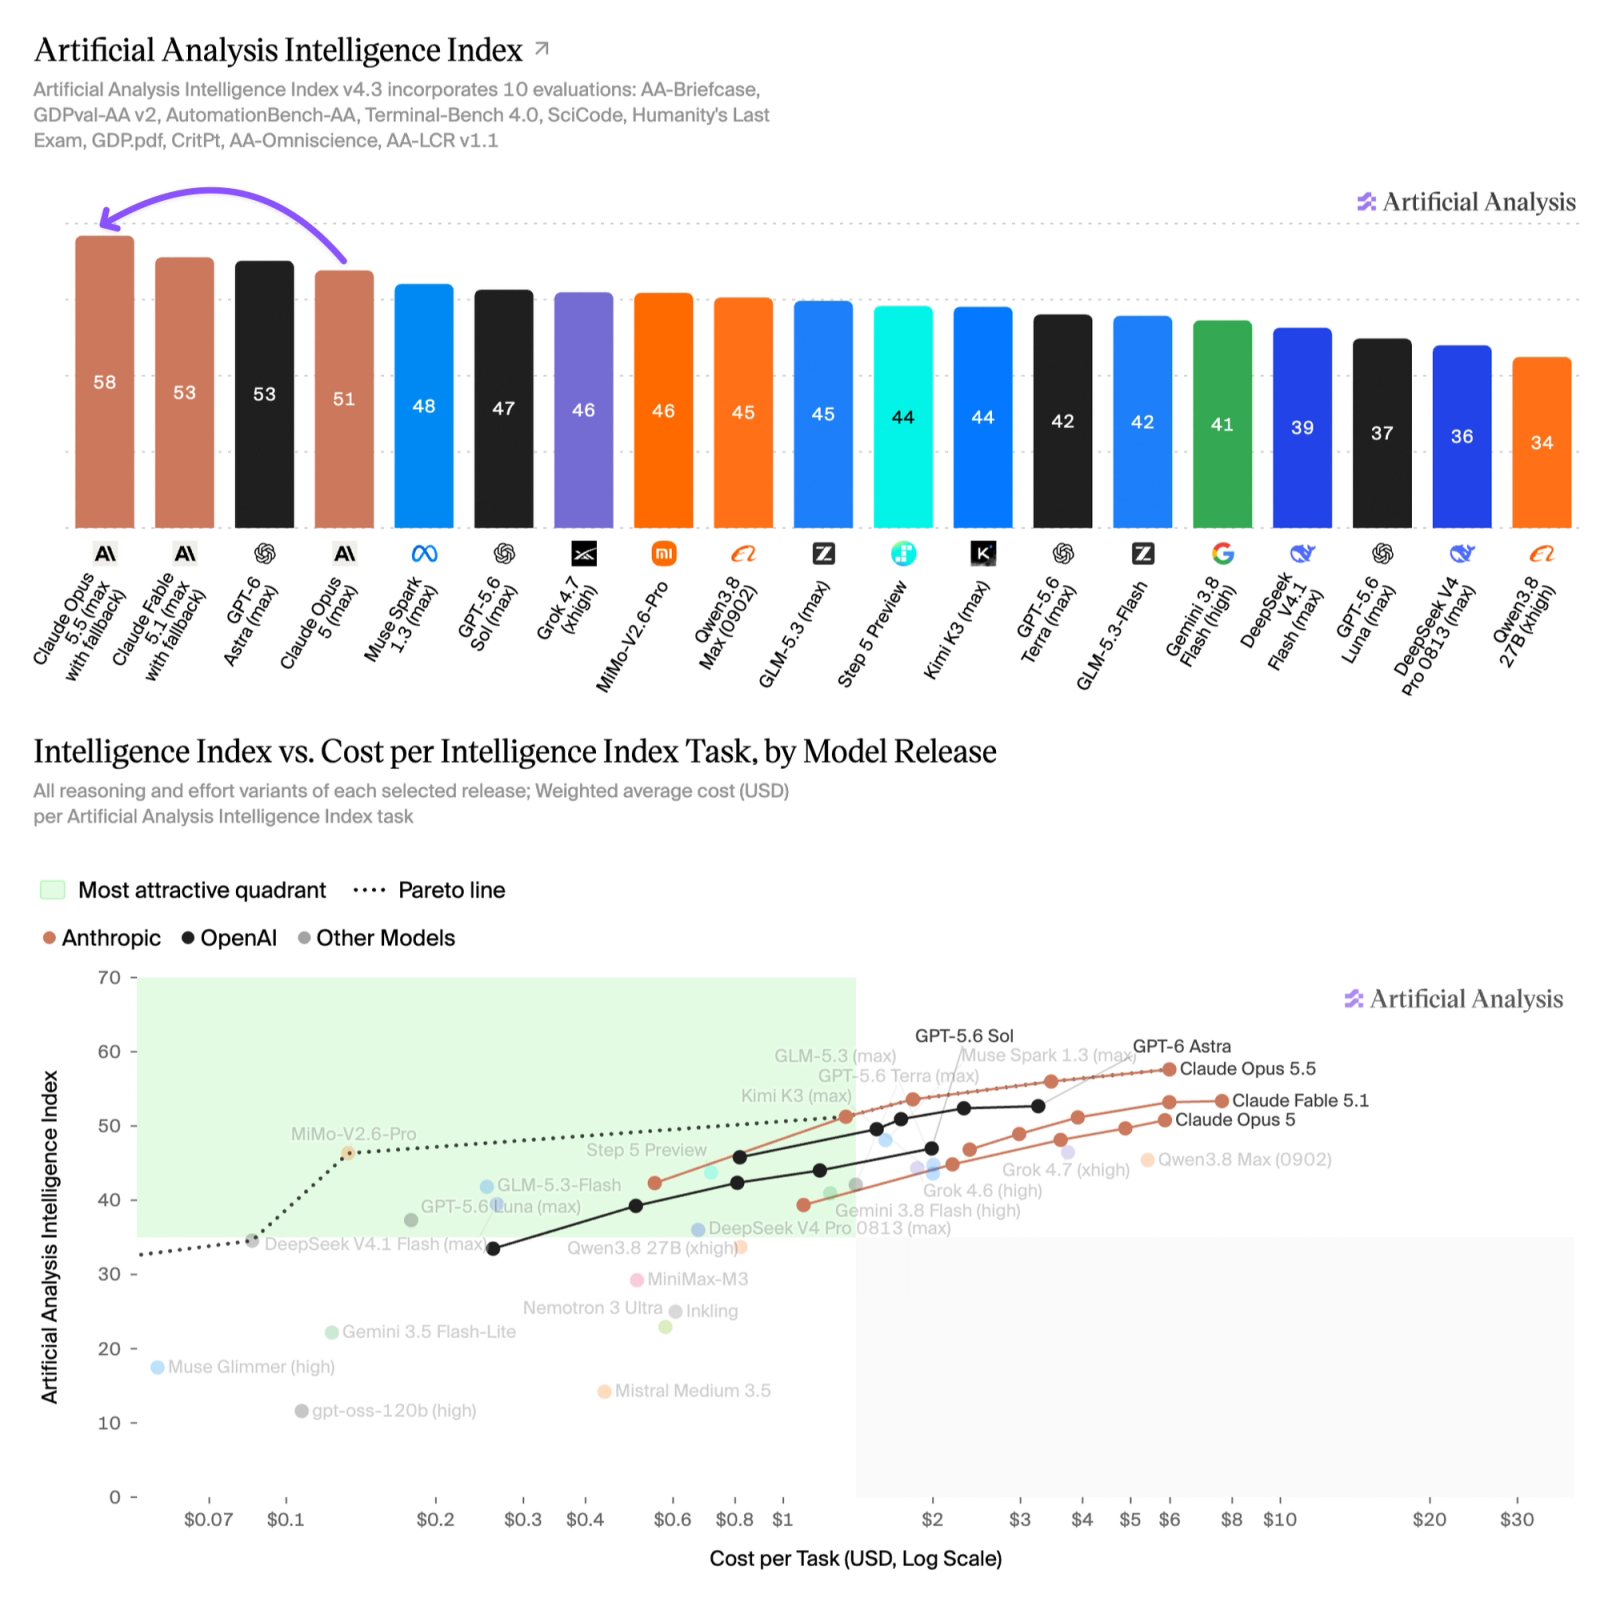
Artificial Analysis xếp Opus 5.5 Max ở mức 58 trên Intelligence Index và báo cáo kết quả mạnh ở AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode và Humanity's Last Exam. Kết quả Terminal-Bench 4.0 là 59.6%, thấp hơn mức 66.4% của Anthropic, cho thấy vì sao các nhóm nên ghi lại phiên bản model, mức nỗ lực, bộ khung, công cụ, số lần thử và trần chi phí khi điểm số khác nhau.
So sánh giá và chi phí hoàn thành tác vụ
CometAPI cung cấp giá token thấp hơn mức chính thức, cho phép nhà phát triển đạt cùng hiệu năng như API chính thức với định dạng yêu cầu message tiêu chuẩn.
Giá token
| Giá | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Đầu vào | $4 | $10 |
| Đầu ra | $20 | $50 |
| Ghi cache 5 phút | $5 | $12.50 |
| Ghi cache 1 giờ | $8 | $20 |
| Đọc cache | $0.20 | $0.25 |
| Đầu vào/đầu ra theo lô | Giảm 50% | Giảm 50% |
Giả sử một khối lượng công việc tiêu thụ 10 triệu token đầu vào mới và 2 triệu token đầu ra. Không có hiệu ứng cache:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
Với giả định đó, Opus 5.5 rẻ hơn 60%. Tuy nhiên, con số này không nên nhầm với tuyên bố của Anthropic rằng Opus 5.5 rẻ hơn khoảng 40% để chạy so với Opus 5.
Đó là hai phép so sánh hoàn toàn khác nhau. Con số 40% bao gồm mức giá Opus 5.5 thấp hơn trong phân khúc Opus và giảm tiêu thụ token cho mỗi tác vụ so với Opus 5. Con số 60% đến trực tiếp từ so sánh bảng giá tiêu chuẩn của Opus 5.5 và Fable 5.1.
Chi phí trên mỗi tác vụ hoàn thành
API model thực ra không bán token. Nhà phát triển mua công việc đã hoàn thành.
Một nhóm lập trình không quan tâm model dùng 6.2 triệu token. Họ quan tâm model có sửa lỗi không, hoàn tất di chuyển, vượt bộ kiểm thử hay hoàn thành nhiệm vụ nghiên cứu không.
Anthropic nêu trực tiếp điểm này trong phân tích What a task costs on Opus 5.5: hai model có giá tương tự có thể có chi phí tác vụ rất khác nếu một model cần nhiều lượt hơn, đọc lại nhiều ngữ cảnh hơn, thử lại nhiều hơn hoặc tạo ra nhiều token suy nghĩ hơn.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Mục cuối thường bị bỏ qua. Một model rẻ hơn nhưng thất bại hai lần có thể trở nên đắt hơn model đắt hơn nhưng hoàn thành trong một lần chạy. Tương tự, mức nỗ lực cao hơn mà tránh được mười lượt thử lại có thể thực sự giảm tổng chi phí.
Kinh tế học bộ nhớ đệm trong prompt
Các tác tử dùng cache nặng thường tái sử dụng định nghĩa công cụ, ngữ cảnh kho mã, chỉ dẫn hệ thống, lịch sử hội thoại và đầu ra kiểm thử. Do giá đọc cache là $0.20/M cho Opus 5.5 và $0.25/M cho Fable 5.1, khoảng cách nhỏ hơn nhiều so với chênh $6/M ở đầu vào mới. Vì vậy, các nhóm nên theo dõi riêng đầu vào mới, đọc cache, ghi cache, đầu ra, lượt công cụ và lượt thử lại.
Kinh tế theo mức nỗ lực
Tiềm năng là có. Artificial Analysis đã thử năm mức nỗ lực của Opus 5.5 và thấy một đường cong chi phí–năng lực rõ ràng.
| Mức nỗ lực Opus 5.5 | Artificial Analysis Intelligence Index | Chi phí mỗi tác vụ trong bộ Index |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Mức medium là điểm khởi đầu hợp lý cho thay đổi mã thường lệ, refactor đã biết và gỡ lỗi có giám sát. High hoặc xhigh có thể hợp lý cho sự cố hệ thống mơ hồ, di chuyển qua đêm hoặc tác vụ mà một kế hoạch sai gây tái công việc đáng kể.
So sánh an toàn và độ tin cậy
Không model nào nên được dán nhãn an toàn hơn chỉ dựa trên benchmark năng lực. So sánh có thể bảo vệ cần prompt, công cụ, quyền hạn, mức nỗ lực, giới hạn thử lại và tiêu chí chấp nhận được khớp. Năng lực cao hơn có thể giảm lỗi vô ý, nhưng quyền tự chủ lớn hơn và thời gian chạy dài hơn cũng làm tăng tác động của một kế hoạch tệ, prompt injection, lệnh công cụ không an toàn hoặc trôi dạt không được chú ý.
| Chiều cạnh an toàn | So sánh thực tế | Kiểm soát trong sản xuất |
|---|---|---|
| Lý luận và mức nỗ lực | Opus 5.5 lộ ra nhiều mức nỗ lực, còn Fable 5.1 khởi đầu ở tư thế nỗ lực cao hơn. Nhiều lý luận không thay thế cho thực thi chính sách. | Cố định chính sách mức nỗ lực theo khối lượng công việc và kiểm tra lại hành vi an toàn mỗi khi thay đổi. |
| Tự chủ chạy lâu | Fable 5.1 được định vị cho công việc khó, không giám sát; Opus 5.5 cũng hỗ trợ quy trình tác tử. Rủi ro tăng theo thời lượng, quyền hạn và số hành động không thể đảo ngược. | Dùng checkpoint, điểm phê duyệt, trần thời gian và chi phí, và điều kiện tự động quay lui hoặc dừng. |
| Sử dụng công cụ và máy tính | Cả hai model đều có thể vận hành công cụ, nên lựa chọn model không tự thân kiểm soát phơi lộ dữ liệu hay hành động hủy hoại. | Áp dụng đặc quyền tối thiểu, danh sách cho phép, sandbox, tách biệt bí mật và xác nhận trước khi hành động ra ngoài hoặc không thể đảo ngược. |
| Đánh giá và khả năng kiểm toán | Điểm benchmark công khai không xác lập chất lượng từ chối, khả năng chống prompt injection, hay tỷ lệ sự cố trong sản xuất. | Ghi log lần gọi công cụ và quyết định chính sách; đo tỷ lệ tuân thủ không an toàn, từ chối sai, thành công injection, rò rỉ bí mật, nỗ lực phá hoại và chất lượng khôi phục. |
Quy tắc an toàn thực tế: bắt đầu với cấu hình Opus 5.5 ít đặc quyền nhất đáp ứng tác vụ, và chỉ nâng cấp lên Fable 5.1 sau khi cùng bộ kiểm tra an toàn vượt qua. Với quy trình có tác động cao, yêu cầu phê duyệt của con người bất kể model nào có điểm năng lực cao hơn.
- Chạy kiểm thử prompt injection và trích xuất dữ liệu đối kháng với bộ công cụ sản xuất thực tế.
- Tách quyền đọc, ghi, xuất bản, xóa và tài chính thay vì cấp một vai trò công cụ rộng.
- Định nghĩa trigger quay lui cho vi phạm chính sách, lặp lỗi công cụ, mở rộng phạm vi bất ngờ và vượt chi phí.
- Tái xác thực sau khi thay đổi model, system prompt, mức nỗ lực, công cụ, quyền hạn hoặc định tuyến.
Cách chọn giữa Opus 5.5 và Fable 5.1
| Khối lượng công việc | Điểm khởi đầu khuyến nghị | Điều kiện nâng cấp |
|---|---|---|
| Lập trình hàng ngày và code review | Opus 5.5, mức medium | Chỉ nâng cấp cho trường hợp khó bất thường hoặc rủi ro cao |
| Tính năng nhiều tệp | Opus 5.5, medium hoặc high | Dùng Fable khi chi phí chủ yếu do thất bại lập kế hoạch lặp lại |
| Di chuyển toàn kho | Thử Opus 5.5 high hoặc xhigh trước | Nâng cấp cho dự án tự chủ khó nhất |
| Chạy tự chủ qua đêm | Opus 5.5 với checkpoint chặt chẽ | Ưu tiên Fable khi chi phí của hướng đi sai là cực lớn |
| Lưu lượng API lớn | Opus 5.5 | Chỉ nâng cấp số ít tác vụ dễ thất bại |
| Triển khai Fable đã xác thực | Giữ triển khai hiện tại khi thử nghiệm | Chỉ chuyển sau khi Opus đạt cùng ngưỡng chấp nhận |
Bài kiểm tra sản xuất thực tế
Chạy cùng tác vụ đại diện, prompt, công cụ, chính sách nỗ lực, tiêu chí chấp nhận và giới hạn thử lại qua cả hai model. Ghi nhận tỷ lệ tác vụ được chấp nhận, độ trễ, đầu vào mới và đọc cache, token đầu ra và suy nghĩ, lần gọi công cụ, số lần thử lại, chỉnh sửa của con người và tổng chi phí trên mỗi kết quả được chấp nhận. Bao gồm cả tác vụ thường lệ và trường hợp thất bại khó.
Hướng dẫn chuyển đổi cho người dùng Claude Opus 5 hiện tại
Người dùng Opus 5 hiện tại nên thử Opus 5.5 như bản kế nhiệm thay vì giả định đổi model ID là an toàn. So sánh độ sâu lập kế hoạch, mẫu gọi công cụ, độ dài phản hồi, tuân thủ định dạng, độ trễ, hành vi cache của prompt, khả năng phục hồi sau lỗi gọi công cụ, điều phối an toàn và chi phí hoàn thành tác vụ. Giữ tiêu chí quay lui và model hiện có cho đến khi Opus 5.5 vượt qua các kiểm thử gần với sản xuất.
Người dùng Fable 5.1 hiện tại không cần phần chuyển đổi chung. Thay vào đó, hãy xem Opus 5.5 là ứng viên tối ưu hóa và đánh giá theo cùng tiêu chí chấp nhận sản xuất trước khi thay đổi một triển khai đã được xác thực.
Truy cập qua CometAPI
Nhà phát triển đánh giá model nào cũng có thể xem các hướng dẫn liên quan của CometAPI cho Claude Opus 5.5 và Claude Fable 5.1. Khi tích hợp qua bất kỳ nhà cung cấp API tương thích nào, hãy xác nhận chính xác model ID, tham số nỗ lực được hỗ trợ, hành vi cache, giới hạn tốc độ, khu vực khả dụng và giá hiện tại trước khi đưa vào sản xuất.
Dùng claude-opus-5-5 cho Opus 5.5 và claude-fable-5-1 cho Fable 5.1 ở nơi các định danh đó được hỗ trợ. Tránh âm thầm định tuyến cả hai lớp khối lượng công việc qua một mức nỗ lực cố định; lựa chọn model và chính sách mức nỗ lực nên được cấu hình độc lập.
Python — Anthropic Messages API qua CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
Kết luận
Claude Opus 5.5 thay đổi ranh giới thực tế giữa model tiên phong hằng ngày của Anthropic và tầng nâng cấp cao cấp. Model này rẻ hơn đáng kể ở mức giá token tiêu chuẩn, dẫn đầu nhiều benchmark lập trình và tác tử, và cung cấp đủ linh hoạt về mức nỗ lực để bao phủ phạm vi sản xuất rộng.
Claude Fable 5.1 vẫn phù hợp khi tác vụ khó, giá trị cao, chạy lâu hoặc tự chủ và chi phí thất bại vượt chi phí suy luận cao hơn. Với hầu hết các nhóm, chính sách tốt nhất là bắt đầu với Opus 5.5, đo lường kết quả hoàn thành tác vụ và nâng cấp có chọn lọc.
Câu hỏi thường gặp
Các nhóm nên thiết kế A/B test sản xuất cho Opus 5.5 và Fable 5.1 như thế nào?
Dùng cùng tác vụ đại diện, prompt, công cụ, chính sách nỗ lực, tiêu chí chấp nhận và giới hạn thử lại cho cả hai model. Ghi tỷ lệ tác vụ được chấp nhận, độ trễ, đầu vào mới và đọc cache, token đầu ra và suy nghĩ, lần gọi công cụ, số lần thử lại, chỉnh sửa của con người và tổng chi phí trên mỗi kết quả được chấp nhận. Chạy đủ số tác vụ để bao quát công việc thường lệ cũng như các ca thất bại khó.
Khi nào giá token thấp hơn vẫn không giảm chi phí tác vụ tổng?
Một model giá thấp vẫn có thể tốn hơn nếu cần thêm lượt, đọc lại ngữ cảnh, tạo nhiều token suy nghĩ hoặc cần thử lại nhiều lần. Hành vi cache cũng quan trọng: khoảng cách giá đầu vào thu hẹp trong phiên dài do đọc cache chi phối. Hãy so sánh chi phí hoàn thành tác vụ thay vì chỉ bảng giá.
Cần ghi lại những gì khi kết quả benchmark bất nhất?
Ghi lại phiên bản model, mức nỗ lực, bộ khung, cài đặt dự phòng và an toàn, số lần thử, phiên bản tác vụ, sai số chuẩn và trần chi phí. Gắn nhãn mỗi kết quả là chính thức hay độc lập và tránh kết hợp điểm từ cấu hình không khớp trong một bảng xếp hạng.
Rủi ro chuyển đổi nào người dùng Fable 5.1 hiện tại nên theo dõi?
Theo dõi thay đổi về độ sâu lập kế hoạch, mẫu gọi công cụ, độ dài phản hồi, tuân thủ định dạng, độ trễ, hành vi cache của prompt, phục hồi sau lỗi, và điều phối an toàn. Giữ triển khai hiện có trong quá trình đánh giá, thiết lập tiêu chí quay lui, và chỉ chuyển sau khi Opus 5.5 đạt cùng ngưỡng chấp nhận trên tác vụ gần với sản xuất.
SEO Metadata
Meta title: Claude Opus 5.5 so với Fable 5.1: Mã, Chi phí và Điểm chuẩn
Meta description: Compare Claude Opus 5.5 và Claude Fable 5.1 về điểm chuẩn lập trình, giá API, tốc độ, bộ nhớ đệm, mức nỗ lực, chi phí hoàn thành tác vụ và độ phù hợp khối lượng công việc.
Keywords: Claude Opus 5.5 so với Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, điểm chuẩn lập trình Claude, định giá API Claude, CometAPI, mô hình AI cho lập trình
URL slug: claude-opus-5-5-vs-claude-fable-5-1