
Tóm tắt nhanh
Claude Opus 5.5 và Claude Sonnet 5.5 cung cấp ngữ cảnh 1M và đầu ra tiêu chuẩn tối đa 128K, hỗ trợ đầu vào văn bản và hình ảnh, với mốc kiến thức đến tháng 6/2026. Opus nhắm tới công việc phức tạp, mở; Sonnet nhắm tới thực thi nhanh cho các tác vụ hằng ngày có phạm vi rõ.
Theo mức giá API tiêu chuẩn của Anthropic, Sonnet 5.5 có giá $2/M cho đầu vào và $10/M cho đầu ra, bằng đúng một nửa so với Opus 5.5 ở mức $4/M đầu vào và $20/M đầu ra. Nhiều điểm số đã công bố khá sát nhau, nhưng thứ hạng thay đổi theo từng benchmark. Opus điểm cao hơn trên CursorBench, trong khi Sonnet cao hơn trên Terminal-Bench. Các kết quả này dùng các mức nỗ lực khác nhau và không nên coi là phép đối đầu có kiểm soát.
Hãy chọn mô hình đáp ứng yêu cầu chất lượng và độ trễ với chi phí tổng cho tác vụ thấp nhất. Các nhóm nên so sánh chi phí trên mỗi tác vụ được chấp nhận, độ trễ, hành vi gọi công cụ, số lần thử lại và lượng phán đoán cần thiết trước khi quyết định nơi nào Opus xứng đáng với mức giá cao hơn.
Những điểm chính
- Giá: Sonnet 5.5 có giá đầu vào/đầu ra bằng một nửa so với Opus 5.5.
- Thông số: Cả hai đều hỗ trợ cửa sổ ngữ cảnh 1M token và đầu ra tiêu chuẩn tối đa 128K.
- Lập trình: Opus dẫn đầu FrontierCode và CursorBench, trong khi Sonnet đạt điểm Terminal-Bench 4.0 cao hơn.
- Công việc tri thức: Opus giữ lợi thế nhỏ trên GDPval-AA và AA-Briefcase.
- Triển khai: Thử Sonnet nhanh hơn cho thực thi có phạm vi và Opus cho các ca leo thang phức tạp; xác thực cả hai theo mục tiêu chất lượng, độ trễ và chi phí.
So sánh nhanh Claude Opus 5.5 và Sonnet 5.5
| Yếu tố quyết định | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Ngữ cảnh / đầu ra tiêu chuẩn tối đa | 1M / 128K | 1M / 128K |
| Phương thức đầu vào/đầu ra | Văn bản + hình ảnh -> văn bản | Văn bản + hình ảnh -> văn bản |
| Suy luận | Tư duy thích ứng, luôn bật | Tư duy thích ứng |
| Mức nỗ lực mặc định trên Claude Platform | Medium | High |
| Giá chính thức đầu vào/đầu ra | $4 / $20 mỗi 1M | $2 / $10 mỗi 1M |
| Đọc cache | $0.20 / 1M | $0.10 / 1M |
| Độ trễ tương đối | Vừa phải | Nhanh |
| Điểm nhấn về lập trình | FrontierCode 54.4%; CursorBench 57.8% | Terminal-Bench 70.6%; CursorBench 55.5% |
| Điểm nhấn về công việc tri thức | GDPval-AA 1846 | GDPval-AA 1844 |
| Phù hợp chính | Công việc phức tạp, mơ hồ, kéo dài | Công việc sản xuất nhanh, có phạm vi, lặp lại |
Claude Opus 5.5
Claude Opus 5.5 ra mắt ngày 22/09/2026, là mô hình đầu tiên trong dòng Claude 5.5 của Anthropic. Anthropic định vị model này cho lập trình nâng cao, tác tử phức tạp, công việc tri thức chuyên nghiệp và quy trình dài hơi nơi việc giữ nguyên ý đồ qua nhiều bước quan trọng hơn mức độ trễ tối thiểu.
Hành vi vận hành khác biệt nhất là tư duy thích ứng luôn bật. Nhà phát triển có thể kiểm soát mức nỗ lực suy luận, nhưng bản thân tư duy thích ứng không thể tắt. Điều này khiến thử nghiệm di trú quan trọng đối với các tác tử cũ vốn dựa vào đường đi “tắt suy nghĩ” hoặc mức nỗ lực mặc định khác.
API Claude Opus 5.5 trên CometAPI cung cấp một tuyến thống nhất cho cùng ID mô hình, claude-opus-5-5, cùng với các mô hình khác để định tuyến tải công việc.
Claude Sonnet 5.5
Claude Sonnet 5.5 ra mắt ngày 28/09/2026, là mô hình thứ hai trong dòng Claude 5.5. Anthropic mô tả nó như một bổ sung nhanh hơn, chi phí thấp hơn so với Opus 5.5 cho công việc hằng ngày được xác định phạm vi tốt, bao gồm sửa lỗi, tạo tài liệu, lập trình, tác tử và các tác vụ thiên về thiết kế.
Anthropic báo cáo Sonnet 5.5 tạo đầu ra nhanh hơn hơn 30% so với Sonnet 5 và có thể giảm chi phí mỗi tác vụ tới 30% so với tiền nhiệm. Đây là các so sánh do nhà cung cấp báo cáo với Sonnet 5, không phải tỷ lệ tốc độ hay chi phí/tác vụ đo đạc đối đầu với Opus 5.5.
API Claude Sonnet 5.5 trên CometAPI dùng ID mô hình claude-sonnet-5-5 và phù hợp để thử nghiệm Sonnet như lớp thực thi chi phí thấp trong các ứng dụng mô hình hỗn hợp.
Claude Opus 5.5 vs Sonnet 5.5: Hiệu năng
Kết quả công bố của Anthropic cho thấy chênh lệch điểm nhỏ trên một số đánh giá về công việc tri thức và sử dụng máy tính. Opus báo cáo điểm cao hơn trên FrontierCode, CursorBench và Humanity’s Last Exam, trong khi Sonnet có điểm Terminal-Bench cao hơn. Các so sánh phụ thuộc mức nỗ lực và điều kiện đánh giá.
| Benchmark | Claude Opus 5.5 | Claude Sonnet 5.5 | Đo lường gì |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 70.6% | Tác vụ tác tử ở dòng lệnh |
| FrontierCode 1.1 Main | 54.4% | 46.2% (Max) | Kỹ nghệ phần mềm thực tế |
| CursorBench 4.0 | 57.8% | 55.5% | Tác vụ mã nhiều tệp, mơ hồ |
| GDPval-AA v2.1 | 1846 | 1844 | Công việc tri thức chuyên nghiệp |
| AA-Briefcase v1.1 | 1822 | 1811 | Công việc tri thức dài hạn |
| Humanity's Last Exam, tools | 67.7% | 64.5% | Suy luận liên ngành |
| OSWorld 2.1 | 81.8% | 80.1% | Sử dụng máy tính |
| Chartography | 64.4% | 61.6% | Nhận diện biểu đồ trực quan |
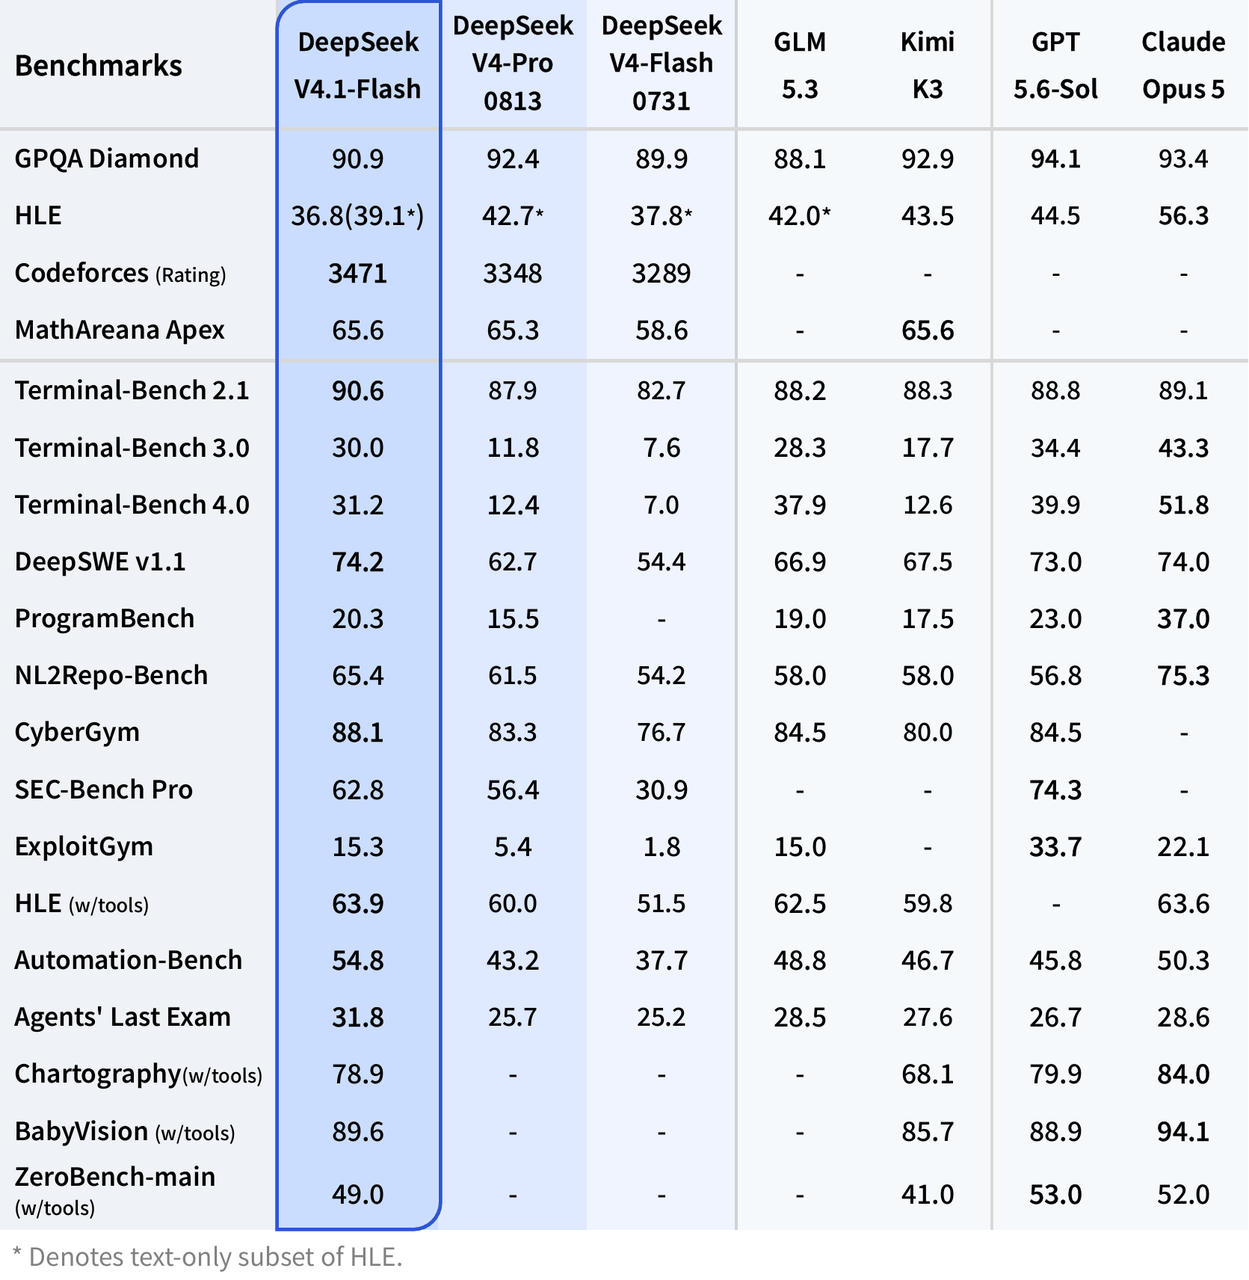
Đây là các kết quả đã công bố, không phải phép so sánh có kiểm soát được thực hiện cho bài viết này.
- Effort: Kết quả Terminal-Bench của Opus dùng Xhigh. Điểm FrontierCode của Sonnet cao hơn ở Xhigh so với Max.
- Chấm điểm và công cụ: OSWorld dùng chấm điểm một phần; kết quả Chartography ở đây không dùng công cụ.
- Triển khai: Kết quả GDPval-AA và AA-Briefcase của Sonnet được đo trên bản triển khai tiền phát hành có lỗi đầu ra có cấu trúc, hiện đã được sửa.
Lập trình tác tử
Điểm 70.6% Terminal-Bench 4.0 của Sonnet 5.5 cao hơn điểm 66.4% của Opus 5.5, nhưng chú thích chính thức nói kết quả của Opus ở mức nỗ lực Xhigh. Trên FrontierCode 1.1 Main, Opus dẫn 54.4% so với 46.2% Max của Sonnet; trên CursorBench 4.0, Opus dẫn 57.8% so với 55.5%.
Sự phân hóa này quan trọng vì các benchmark tác tử lập trình thưởng cho hành vi khác nhau. Terminal-Bench nhấn mạnh thực thi nhiều bước thành công trong môi trường dòng lệnh, trong khi CursorBench dùng các tác vụ nhiều tệp mơ hồ từ phiên mã thực. Với lập trình có phạm vi và thực thi lặp, Sonnet có thể rất cạnh tranh; với công việc quy mô kho mã rộng, Opus vẫn có bằng chứng mạnh hơn trong các đánh giá công bố của Anthropic.
Công việc tri thức và suy luận
Trên GDPval-AA v2.1, Sonnet 5.5 đạt 1844 so với Opus 5.5 ở 1846. Trên AA-Briefcase v1.1, chênh lệch là 1811 so với 1822. Những kết quả này đáng chú ý vì khoảng cách giá lớn hơn nhiều so với khoảng cách benchmark.
Anthropic xác định Opus 5.5 mạnh hơn ở công việc phức tạp, mở, đòi hỏi phán đoán bền bỉ. Với nghiên cứu, kiến trúc và kiểm định, hãy kiểm tra liệu hành vi đó có giảm quyết định sai hay nhu cầu chỉnh sửa của con người trong tác vụ của bạn, thay vì suy ra lợi thế kinh tế từ các chênh lệch benchmark nhỏ.
Sử dụng máy tính và tác vụ thị giác
Trên OSWorld 2.1, dùng chấm điểm một phần, Opus đạt 81.8% và Sonnet 80.1%. Trên Chartography không dùng công cụ, điểm lần lượt là 64.4% và 61.6%. Với tác tử trình duyệt hoặc GUI, điều này gợi ý độ trễ, hiệu quả gọi công cụ và chi phí cấp độ tác vụ có thể quan trọng ngang khoảng cách benchmark tiêu đề.
Diễn giải benchmark
Câu chuyện benchmark không phải là Sonnet đã thay thế Opus. Mà là Anthropic đã thu hẹp khoảng cách năng lực đủ để hình dạng tải công việc quan trọng hơn cấp bậc mô hình. Các tác vụ có phạm vi tốt và nhạy độ trễ ngày càng ủng hộ kinh tế của Sonnet, trong khi tính mơ hồ, chân trời dài và chi phí thất bại đắt đỏ vẫn là lý do mạnh nhất để thử Opus.
Claude Opus 5.5 vs Sonnet 5.5: Giá
Bảng giá chính thức Claude API
Đặc tả giá Opus và đặc tả giá Sonnet phân biệt mức token tiêu chuẩn, cửa sổ lưu cache và chiết khấu Batch. Giá bên dưới tính theo USD trên mỗi triệu token; xác nhận riêng các tùy chọn dịch vụ.
| Chỉ số giá | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Đầu vào / 1M token | $4.00 | $2.00 |
| Đầu ra / 1M token | $20.00 | $10.00 |
| Đọc cache / 1M token | $0.10 | $0.20 |
| Ghi cache 5 phút / 1M token | $5.00 | $2.50 |
| Ghi cache 1 giờ / 1M token | $8.00 | $4.00 |
| Batch đầu vào / 1M token | $2.00 | $1.00 |
| Batch đầu ra / 1M token | $10.00 | $5.00 |
Sonnet có mức giá đầu vào, đầu ra và ghi cache bằng một nửa.
Đọc cache theo cùng tỷ lệ giá 2:1: Sonnet 5.5 có giá $0.10/M dữ liệu cache, trong khi Opus 5.5 có giá $0.20/M. Tái sử dụng tiền tố cache giảm chi phí đầu vào cho cả hai trong khi vẫn giữ mức giá theo token thấp hơn của Sonnet. Tiết kiệm tổng mỗi tác vụ vẫn phụ thuộc độ dài đầu ra, ghi cache, số lần thử lại và tỷ lệ chấp nhận.
Chi phí trên mỗi tác vụ được chấp nhận
Ví dụ đơn giản, một yêu cầu với 100K token đầu vào không cache và 10K token đầu ra có chi phí khoảng $0.60 trên Opus 5.5 và $0.30 trên Sonnet 5.5 ở mức tiêu chuẩn. Nhưng chênh lệch giá token 2x không đảm bảo chênh lệch chi phí/mỗi tác vụ thành công là 2x. Số lần thử lại, gọi công cụ, độ dài đầu ra, lượt cache hit, lần thất bại và chỉnh sửa của con người có thể thay đổi kết quả.
Do đó, đánh giá sản xuất nên ghi nhận chi phí trên mỗi tác vụ được chấp nhận cùng với tỷ lệ hoàn thành, độ trễ p50/p95, số lần thử lại, số lần gọi công cụ và mức độ can thiệp của con người.
Giá CometAPI
Danh mục model của CometAPI quảng cáo mức giảm giá 20% cho nhiều tuyến Anthropic. Với API Claude Opus 5.5 trên CometAPI, giá tham chiếu trong danh mục là $3.20/M đầu vào và $16/M đầu ra. Với API Claude Sonnet 5.5 trên CometAPI, dữ liệu danh mục địa phương hiển thị $1.60/M đầu vào và $8/M đầu ra. Do giá cổng có thể thay đổi, hãy xác nhận tuyến model trực tiếp trước khi lập ngân sách.
| Mức giá CometAPI | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Đầu vào / 1M | $3.20 | $1.60 |
| Đầu ra / 1M | $16.00 | $8.00 |
| Giảm so với giá chính thức | 20% | 20% |
Claude Opus 5.5 vs Sonnet 5.5: Thông số kỹ thuật
Cả hai model chia sẻ giới hạn ngữ cảnh và đầu ra cốt lõi như trong bảng So sánh nhanh. Giới hạn đầu ra bổ sung 300K là khả năng beta của Batch API, không phải giới hạn đầu ra tương tác tiêu chuẩn.
Độ dài ngữ cảnh không phải khác biệt chính giữa hai model này. Cả hai đều hỗ trợ cửa sổ 1M token và trần đầu ra tiêu chuẩn 128K. Khác biệt có ý nghĩa hơn là hành vi suy luận, tốc độ và mức độ phán đoán khó mà tác vụ yêu cầu.
Cải thiện tốc độ đầu ra của Sonnet được báo cáo là so với Sonnet 5. Opus cũng có Fast mode với thông lượng token đầu ra lên tới 2.5x, có giá $8/M đầu vào và $40/M đầu ra. Đây là bản xem trước nghiên cứu trên Claude API; điều này không đảm bảo tác vụ đầu-cuối nhanh hơn 2.5x hay thời gian đến token đầu tiên nhanh hơn.
Công bố kiến trúc và hành vi tích hợp
Tài liệu trích dẫn không công bố số tham số hay chi tiết kiến trúc nội bộ đủ để so sánh dense-versus-MoE một cách có cơ sở. Hãy so sánh giao diện và hành vi được tài liệu hóa thay vào đó. Cả hai lộ trình di trú đều cần thử nghiệm ràng buộc lựa chọn công cụ và tư duy được bảo lưu; tư duy thích ứng của Opus không thể tắt. Xác thực trạng thái hội thoại khi định tuyến giữa các model thay vì chuyển tiếp các khối tư duy không minh bạch mà không kiểm tra tính tương thích.
Claude Opus 5.5 vs Sonnet 5.5: Trường hợp sử dụng
Một chiến lược triển khai hữu ích là coi Sonnet 5.5 là mô hình thực thi mặc định và Opus 5.5 là mô hình leo thang. Điều này có thể giảm chi tiêu cho các tác vụ được xác định rõ và lặp lại, đồng thời dành Opus cho công việc hưởng lợi từ phán đoán bền bỉ. Mức tiết kiệm phụ thuộc vào tỷ lệ chấp nhận của Sonnet và tần suất cần leo thang tác vụ.
Lựa chọn dựa trên tải công việc
| Tải công việc | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Lập trình thường nhật | Đủ khả năng, chi phí cao hơn | Rất phù hợp |
| Sửa lỗi | Hữu ích cho ca khó | Rất phù hợp |
| Lưu lượng API lớn | Chi phí đơn vị cao hơn | Rất phù hợp |
| Tạo tài liệu / slide | Mạnh | Kinh tế hơn |
| Tác tử lập trình phụ | Dùng có chọn lọc | Rất phù hợp |
| Di trú quy mô kho mã | Rất phù hợp | Kiểm thử cho công việc có phạm vi |
| Kiến trúc mơ hồ | Rất phù hợp | Phụ thuộc vào độ phức tạp |
| Tác tử tự chủ chạy dài | Rất phù hợp | Lớp thực thi tốt |
| Nghiên cứu / phân tích khó | Rất phù hợp | Tốt cho công việc có phạm vi |
| UX nhạy độ trễ | Vừa phải | Rất phù hợp |
| Tải sản xuất hỗn hợp | Mô hình leo thang | Mô hình thực thi mặc định |
Một bộ định tuyến thực dụng có thể bắt đầu với Sonnet và leo thang khi tác vụ vượt ngưỡng về độ mơ hồ, độ dài vòng lặp công cụ, thất bại lặp lại hoặc tác động kinh doanh. Quy tắc định tuyến nên được xác thực bằng tác vụ giống sản xuất thay vì suy đoán từ điểm benchmark.
Cách gọi Opus 5.5 và Sonnet 5.5 qua CometAPI
Tạo khóa API CometAPI và cấu hình client tương thích Anthropic để dùng endpoint CometAPI. Chọn ID mô hình cho tác vụ, gửi prompt qua Messages API và đọc phản hồi văn bản. Khi so sánh các model, giữ nguyên prompt, giới hạn đầu ra, công cụ và tiêu chí chấp nhận, và ghi nhận mức nỗ lực suy luận hiệu dụng.
Ví dụ Opus 5.5
Cho một đánh giá kế hoạch di trú, chọn claude-opus-5-5 và yêu cầu model xác định các bước rủi ro cao nhất, giải thích tác động và đề xuất biện pháp bảo vệ. Gửi yêu cầu qua Messages API của CometAPI và xem xét văn bản trả về.
Ví dụ Sonnet 5.5
Với cùng đánh giá kế hoạch di trú, chọn claude-sonnet-5-5 và gửi cùng prompt và giới hạn đầu ra qua CometAPI. So sánh phản hồi theo cùng tiêu chí chấp nhận, rồi ghi độ trễ, số lần thử lại và chi phí thực tế trước khi quyết định model nào phù hợp.
Đối với định tuyến sản xuất, giữ cả hai ID model sau cùng một giao diện ứng dụng và ghi nhận chất lượng hoàn thành, độ trễ, số lần thử lại và chi phí thực tính. Tránh leo thang chỉ vì prompt dài; mơ hồ và chi phí thất bại thường là tín hiệu tốt hơn.
Kết luận
Claude Opus 5.5 và Sonnet 5.5 giờ có bao kỹ thuật gần như tương đồng, nên lựa chọn model ngày càng dựa vào kinh tế và hành vi tải công việc hơn là kích thước ngữ cảnh. Sonnet kết hợp tốc độ thực thi nhanh hơn và giá token tiêu chuẩn bằng một nửa với hiệu năng benchmark thường sát với Opus.
Opus trở nên giá trị hơn khi mức độ mơ hồ, thời lượng tác vụ và chi phí của quyết định sai tăng lên. Giá trị của nó ít nằm ở cửa sổ ngữ cảnh lớn hơn, mà ở khả năng duy trì phán đoán qua quy trình khó, mở.
Với nhiều nhóm sản xuất, kiến trúc hiệu quả nhất sẽ dùng cả hai: Sonnet cho phần lớn công việc lặp lại có thể dự đoán, và Opus cho tập con tác vụ nơi suy luận mạnh mẽ hơn giúp giảm thất bại, thử lại hoặc can thiệp của con người một cách đo lường được.
Câu hỏi thường gặp
Bộ định tuyến Claude 5.5 nên ngăn các vòng leo thang tốn kém như thế nào?
Đặt số lần thử tối đa và ngân sách trước khi thực thi. Leo thang sau một thất bại có thể tái hiện, thiếu bằng chứng, hoặc không đạt ngưỡng chất lượng theo tác vụ, thay vì sau mỗi câu trả lời chưa chắc chắn. Ghi nhận thất bại nào đã kích hoạt Opus và liệu nó có cải thiện kết quả được chấp nhận không. Nếu không model nào đạt, trả lại vấn đề chưa giải quyết để xem xét thay vì thử vô hạn.
Làm sao so sánh công bằng Opus và Sonnet trên cùng một tải công việc?
Dùng cùng tập tác vụ, cùng công cụ, bằng chứng đầu vào, giới hạn đầu ra và thang chấm điểm. Ghi nhận mức nỗ lực hiệu dụng và thử riêng các lượt chạy cold cache và warm cache. Xem xét kết quả mà không tiết lộ model khi khả thi. Báo cáo tỷ lệ chấp nhận và tổng chi phí gồm cả lần thất bại; giá token bằng nhau hay một benchmark không khẳng định giá trị tương đương.
Cần giữ lại gì khi chuyển đổi model Claude 5.5 giữa chừng tác vụ?
Giữ nguyên hướng dẫn người dùng, bằng chứng liên quan, kết quả công cụ và tóm tắt tiến độ rõ ràng. Xem trạng thái tư duy không minh bạch như phụ thuộc vào model và hội thoại; đừng giả định có thể phát lại qua các tuyến. Thử nghiệm hành vi bàn giao do nhà cung cấp hỗ trợ trước khi đưa vào sản xuất, đặc biệt nếu quy trình trộn tài khoản, cổng hoặc SDK.
Khi nào nên đánh giá lại lựa chọn model Claude 5.5?
Chạy lại các bài kiểm thử chấp nhận bị ảnh hưởng sau khi có bản sửa triển khai, thay đổi định tuyến, thay đổi giá, thay đổi công cụ hoặc cập nhật prompt đáng kể. Giữ lại lần chạy trước làm chuẩn so sánh và ghi ngày, ID model, endpoint, cấu hình và phiên bản khung thử nghiệm. Điều này giúp phân biệt thay đổi do model với thay đổi trong ứng dụng xung quanh.