
TL;DR
GLM-5.3 Flash là lựa chọn mặc định tốt hơn cho đa số khối lượng công việc sản xuất: bổ sung đầu vào thị giác bản địa và cửa sổ ngữ cảnh 1M token, trong khi giá niêm yết tiêu chuẩn thấp hơn rất nhiều. GLM-5.3 vẫn là lựa chọn mạnh hơn khi độ sâu lập trình tối đa, suy luận tầm xa khó hoặc hiệu năng an ninh mạng quan trọng hơn chi phí đơn vị.
Đây không phải câu chuyện “mô hình nhỏ so với mô hình lớn”. Flash là MoE 320B tổng/18B đang hoạt động, được huấn luyện từ một nền tảng đa phương thức mới với chú ý thưa lai chú ý tuyến tính. Mẫu flagship là MoE 744B tổng/40B đang hoạt động với các cải thiện GLM-5.3 đến từ hậu huấn luyện quy mô trên nền GLM-5.2.
Các điểm chính
- Chọn Flash cho lập trình đa phương thức, hiểu tài liệu, tác tử trình duyệt hoặc GUI, tự động hóa khối lượng lớn và các ứng dụng nhạy về chi phí.
- Chọn flagship cho các tác vụ kỹ thuật ở quy mô kho mã khó nhất, suy luận có trợ giúp công cụ sâu hơn và nghiên cứu an ninh phòng thủ.
- Cả hai mô hình hỗ trợ ngữ cảnh 1M token, suy luận luôn bật, gọi hàm, streaming và triển khai với trọng số mở.
- Trên các benchmark do Z.ai báo cáo có đối sánh, flagship dẫn đầu DeepSWE, NL2Repo, HLE with tools và Agents’ Last Exam; Flash dẫn đầu AutomationBench, Toolathlon và GDPval-AA v2.
- Kiểm thử độc lập cho thấy flagship có Chỉ số Trí tuệ cao hơn và tốc độ xuất ra nhanh hơn, trong khi Flash có thời gian đến token đầu tiên nhỉnh hơn và chi phí tổng hợp thấp hơn nhiều.
GLM-5.3 Flash và GLM-5.3 trong nháy mắt
| Dimension | GLM-5.3 Flash | GLM-5.3 | Kết quả thực tế |
|---|---|---|---|
| Định vị | Mô hình tác tử và lập trình đa phương thức hiệu quả | Flagship suy luận văn bản, lập trình, tác tử tầm xa, an ninh mạng | Phụ thuộc khối lượng công việc |
| Kích thước mô hình | 320B tổng / 18B hoạt động | 744B tổng / 40B hoạt động | Flash kích hoạt ít tham số hơn 55% |
| Nền tảng | Nền đa phương thức 30T token mới huấn luyện | Cùng nền tảng với GLM-5.2; cải thiện đến từ hậu huấn luyện | Lộ trình phát triển khác nhau |
| Đầu vào / đầu ra | Văn bản + thị giác / văn bản | Văn bản / văn bản | Flash cho quy trình thị giác |
| Ngữ cảnh / tối đa đầu ra | 1M / 128K | 1M / 128K | Hòa |
| Nỗ lực suy luận | thấp, cao, tối đa; suy luận luôn bật | thấp, cao, tối đa; suy luận luôn bật | Hòa |
| Independent Intelligence Index | 57 | 60 ở nỗ lực tối đa | GLM-5.3 |
| Tốc độ xuất ra độc lập | 50.2 token/s | 76.6 token/s | GLM-5.3 trên API đã kiểm thử |
| Giá niêm yết input/output | $0.15 / $0.50 mỗi 1M token | $1.40 / $4.40 mỗi 1M token | Flash |
| Phù hợp nhất | Định tuyến mặc định, tác tử đa phương thức, mở rộng | Tác vụ văn bản phức tạp nhất và an ninh | Dùng định tuyến chọn lọc |
Nguồn: Tài liệu mô hình Z.ai và So sánh của Artificial Analysis.
GLM-5.3 Flash là gì?
Z.ai định vị Flash là mô hình đa phương thức bản địa đầu tiên trong dòng GLM-5. Nó có 320B tham số tổng và 18B tham số hoạt động, nhưng “Flash” không đồng nghĩa “nhỏ”. Checkpoint đầy đủ vẫn là mô hình rất lớn; hiệu quả đến từ việc kích hoạt một tập chuyên gia nhỏ hơn và tái thiết kế ngăn chú ý.
Nền mô hình được huấn luyện trên corpus đa phương thức 30 nghìn tỷ token. Khả năng thị giác bản địa được tích hợp vào vòng lặp lập trình, cho phép mô hình quan sát ảnh chụp màn hình, giao diện đã render, biểu đồ, bố cục trang và phản hồi thị giác khác trước khi tinh chỉnh hành động tiếp theo.
Thông số kỹ thuật GLM-5.3 Flash
| Thông số | GLM-5.3 Flash |
|---|---|
| Nhà phát triển | Z.ai / Zhipu AI |
| Model ID | glm-5.3-flash |
| Loại mô hình | Mixture-of-Experts đa phương thức bản địa |
| Tham số tổng / hoạt động | 320B / 18B |
| Số lớp | 45 |
| Kiến trúc | Chú ý thưa lai chú ý tuyến tính; mHC; MTP |
| Corpus huấn luyện | Corpus tiền huấn luyện đa phương thức 30T token |
| Kiểu đầu vào | Văn bản và thị giác, gồm hình ảnh và quy trình video/tệp được hỗ trợ |
| Kiểu đầu ra | Văn bản |
| Ngữ cảnh / tối đa đầu ra | 1M / 128K token |
| Suy luận | Luôn bật; nỗ lực thấp, cao, tối đa |
| Công cụ | Gọi hàm, gọi công cụ streaming, quy trình có cấu trúc |
| Trọng số / giấy phép | Trọng số mở; Apache-2.0 trong kho chính thức |
Nguồn: Tài liệu Flash của Z.ai và kho GLM-5 chính thức.
GLM-5.3 là gì?
Mô hình flagship được tối ưu cho kỹ thuật phần mềm phức tạp, tác tử tầm xa và an ninh mạng. Z.ai cho biết mô hình dùng cùng nền tảng với GLM-5.2; nâng cấp đến từ hậu huấn luyện quy mô thay vì một đợt tiền huấn luyện mới.
Kho chính thức liệt kê checkpoint 744B tham số tổng với 40B tham số hoạt động. So với Flash, nó kích hoạt hơn gấp đôi tham số trên mỗi token và phân bổ nhiều năng lực hơn cho suy luận đa bước khó.
Thông số kỹ thuật GLM-5.3
| Thông số | GLM-5.3 |
|---|---|
| Nhà phát triển | Z.ai / Zhipu AI |
| Model ID | glm-5.3 |
| Loại mô hình | Mô hình văn bản flagship Mixture-of-Experts |
| Tham số tổng / hoạt động | 744B / 40B |
| Nền tảng | Nền GLM-5.2; mọi cải thiện GLM-5.3 đến từ hậu huấn luyện |
| Đầu vào / đầu ra | Văn bản / văn bản |
| Ngữ cảnh / tối đa đầu ra | 1M / 128K token |
| Suy luận | Luôn bật; nỗ lực thấp, cao, tối đa |
| Công cụ | Gọi hàm, gọi công cụ streaming, bộ nhớ đệm ngữ cảnh, đầu ra có cấu trúc |
| Trọng tâm chính | Lập trình phức tạp, tác tử tầm xa, kỹ thuật, an ninh mạng |
| Trọng số / giấy phép | Trọng số mở theo giấy phép GLM-5.3 riêng; mã kho hỗ trợ theo Apache-2.0 |
Nguồn: tài liệu flagship của Z.ai và kho GLM-5 chính thức.
Kiến trúc: Tại sao Flash rẻ hơn mà không hề nhỏ
Flash xen kẽ các khối chú ý tuyến tính với các khối chú ý thưa và dùng mHC quanh các thành phần chú ý và MoE. Cơ chế IndexPool nén bốn vector khóa indexer thành một. Z.ai báo cáo tính toán chú ý trên mỗi lớp thấp hơn 3,01× và bộ nhớ đệm KV trên mỗi lớp nhỏ hơn 4,44× so với flagship ở độ dài chuỗi 1M token.
Đây là các so sánh ở cấp kiến trúc, không phải các hệ số độ trễ đầu-cuối đảm bảo. Tốc độ API thực tế còn phụ thuộc phần cứng, lượng tử hóa, batching, độ dài suy luận, phần mềm phục vụ và tải nhà cung cấp.
Kiến trúc chú ý lai của GLM-5.3-Flash và so sánh tính toán/bộ nhớ đệm cho ngữ cảnh dài.
Nguồn: tài liệu kiến trúc chính thức của Z.ai
Hiệu năng benchmark: Mỗi mô hình thắng ở đâu
So sánh rõ nhất là tách các benchmark do nhà cung cấp báo cáo khỏi số đo API độc lập. Ngay cả khi tên benchmark trùng nhau, phiên bản harness, cấu hình công cụ, quản lý ngữ cảnh và mức nỗ lực suy luận có thể khác. Bảng dưới dùng các giá trị đối sánh gần nhất trong đánh giá flagship và đánh giá Flash, coi chênh lệch nhỏ mang tính định hướng hơn là kết luận dứt khoát.
| Benchmark | GLM-5.3 Flash | GLM-5.3 | Điểm cao hơn | Kiểm tra điều gì |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 88.2 | GLM-5.3 | Lập trình trong terminal và tác tử |
| DeepSWE v1.1 | 63.4 | 66.9 | GLM-5.3 | Kỹ thuật phần mềm |
| NL2Repo | 56.3 | 58.0 | GLM-5.3 | Sinh kho mã |
| Toolathlon Verified | 78.4 | 73.0 | Flash | Sử dụng công cụ |
| AutomationBench | 48.8 | 48.2 | Gần hòa / Flash | Tự động hóa sử dụng máy tính |
| Agents’ Last Exam | 26.3 | 28.5 | GLM-5.3 | Suy luận tác tử tầm xa |
| HLE with tools | 55.3 | 62.5 | GLM-5.3 | Suy luận khó có trợ giúp công cụ |
| GDPval-AA v2 | 1773 Elo | 1769 Elo | Gần hòa / Flash | Công việc tri thức chuyên nghiệp |
Nguồn: đánh giá flagship và đánh giá Flash. So sánh theo hướng dẫn vì thiết lập đánh giá có thể khác.
Lập trình và kỹ thuật kho mã
Flagship có trần hiệu năng cao hơn. Nó dẫn Flash 3,5 điểm trên DeepSWE và 1,7 điểm trên NL2Repo. Trên Z.ai Code Bench v1.0, với cả hai mô hình được đánh giá bằng Claude Code 2.1.207, flagship đạt 34,5% ở nỗ lực tối đa, trong khi Flash đạt 29,0% — chênh 5,5 điểm.
Flash vẫn đủ cạnh tranh để là mô hình đầu tiên thử nghiệm cho bảo trì kho thường kỳ, sinh test, gỡ lỗi, tái cấu trúc và tác tử lập trình khối lượng lớn. Chỉ nâng cấp những tác vụ khó nhất hoặc lộ trình thất bại lên flagship.
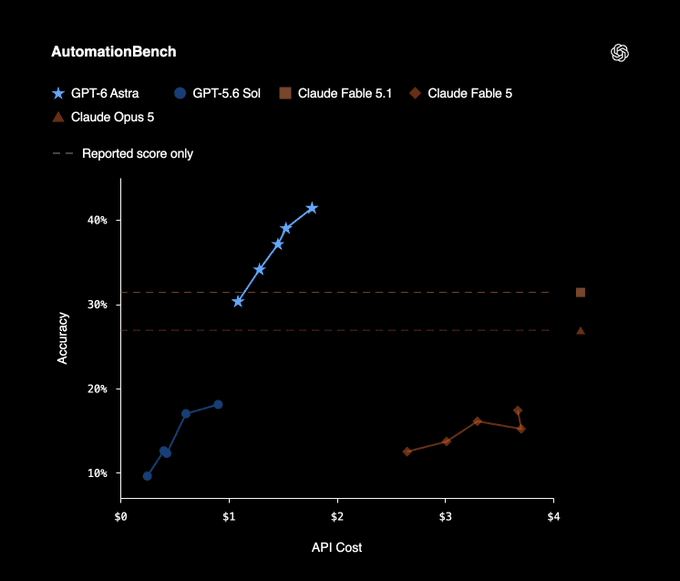
Đánh giá sáu benchmark của Z.ai về GLM-5.3-Flash và các mô hình lập trình/tác tử khác.
Nguồn: tài liệu Flash chính thức của Z.ai
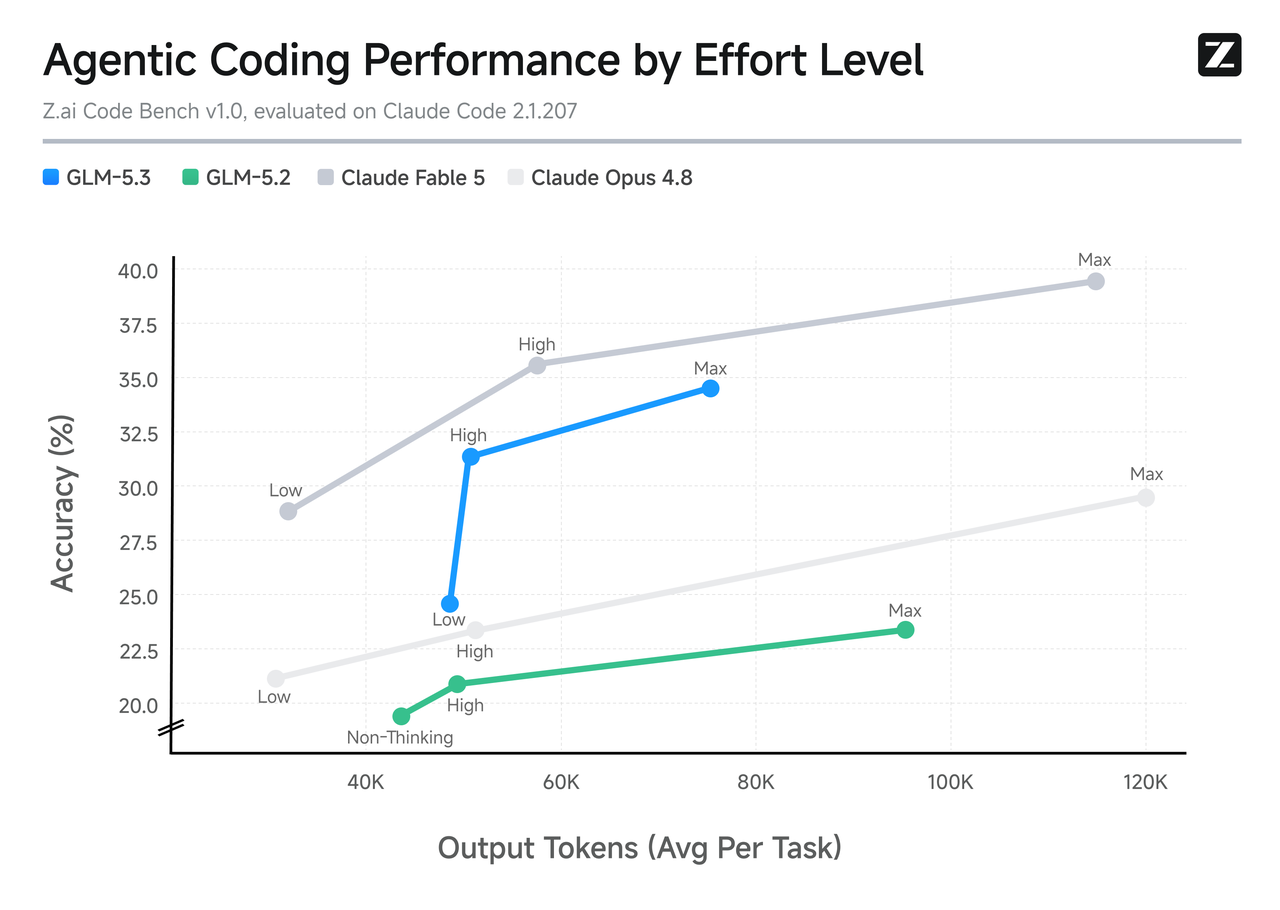
Độ chính xác lập trình tác tử của GLM-5.3 và mức sử dụng token đầu ra theo các mức nỗ lực suy luận.
Nguồn: tài liệu flagship chính thức của Z.ai
Sử dụng công cụ, tự động hóa và công việc tri thức
Flash không phải lúc nào cũng yếu hơn. Nó đạt 78,4 trên Toolathlon Verified so với 73,0 của flagship, và nhỉnh hơn AutomationBench 48,8 so với 48,2. Nó gần như hòa trên GDPval-AA v2. Điều này khiến Flash đặc biệt hấp dẫn khi tác vụ ít về một chuỗi suy luận cực khó và nhiều hơn về phối hợp công cụ đáng tin cậy trên nhiều yêu cầu rẻ.
Trí tuệ, tốc độ và độ trễ độc lập
| Số đo độc lập | GLM-5.3 Flash | GLM-5.3 (tối đa) | Kết quả |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 57 | 60 | GLM-5.3 |
| Tốc độ xuất ra | 50.2 token/s | 76.6 token/s | GLM-5.3 |
| Thời gian đến token đầu tiên | 1.49 s | 1.61 s | Flash |
| Cửa sổ ngữ cảnh | 1M | 1M | Hòa |
| Giá pha trộn trong so sánh AA | $0.10 / 1M token | $0.90 / 1M token | Flash |
Nguồn: so sánh API đối sánh của Artificial Analysis.
Kết quả độc lập bổ sung một điều chỉnh quan trọng cho giả định “Flash nghĩa là nhanh hơn”. Flash phản hồi sớm hơn đôi chút, nhưng endpoint flagship được kiểm thử tạo token nhanh hơn khi đầu ra bắt đầu. Hãy coi các phép đo này là ảnh chụp theo nhà cung cấp, không phải thuộc tính bất biến của mô hình.
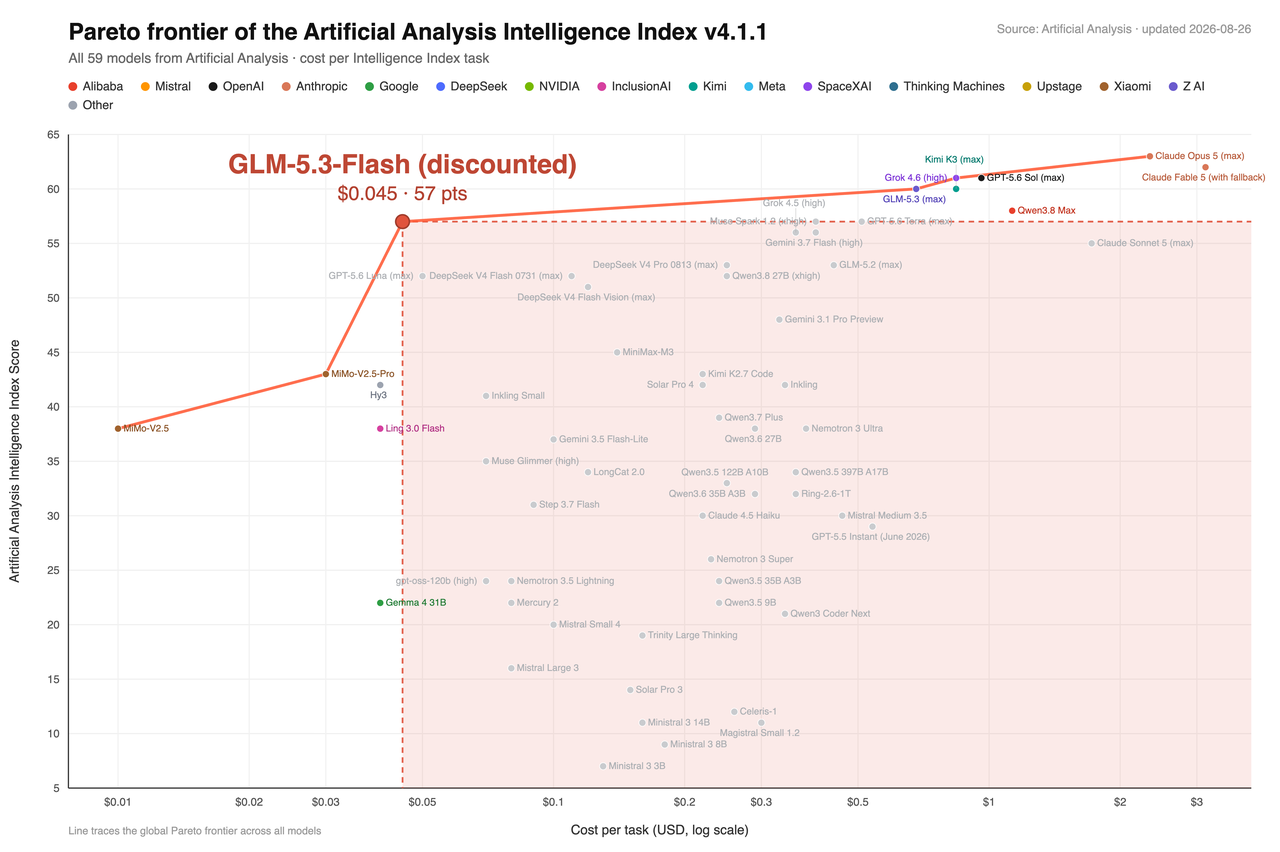
Biên giới chi phí–trí tuệ của Artificial Analysis được tái hiện trong tài liệu Flash chính thức của Z.ai.
Nguồn: tài liệu Flash chính thức của Z.ai
Đa phương thức: Flash có lợi thế rõ rệt
Flash chấp nhận đầu vào thị giác và tích hợp chúng vào quy trình tác tử. Nó có thể quan sát ảnh chụp màn hình, ảnh trang, biểu đồ, trạng thái giao diện, bản ghi màn hình và tệp được hỗ trợ, rồi dùng bằng chứng thị giác khi lập trình hoặc vận hành công cụ. Flagship hiện chỉ hỗ trợ đầu vào văn bản.
- Frontend và design-to-code: Flash có thể xem ảnh tham chiếu và xác thực bản render triển khai.
- Quy trình tài liệu và Office: Flash có thể suy luận về cấu trúc trang, biểu đồ, bố cục và vị trí hình ảnh.
- Sử dụng trình duyệt và máy tính: Flash kết hợp trạng thái thị giác với gọi công cụ và hiệu chỉnh lặp.
- Công việc kho văn bản thuần: flagship vẫn thích hợp hơn khi đầu vào là mã và văn bản, và tác vụ cần độ sâu suy luận tối đa.
Ngữ cảnh dài và kiểm soát suy luận
GLM-5.3 Flash hỗ trợ cửa sổ ngữ cảnh 1M token và tối đa 128K token đầu ra; GLM-5.3 cung cấp giới hạn tương tự. Cả hai giữ suy luận bật và chấp nhận mức nỗ lực thấp, cao và tối đa. Z.ai khuyến nghị tối đa cho lập trình khó và tái hiện benchmark.
Do đó, dung lượng ngữ cảnh không phải khác biệt chính. Khác biệt là mức độ kinh tế khi phục vụ chuỗi dài và lượng năng lực suy luận mà mỗi mô hình có thể mang tới cho tác vụ khó nhất. Flash rẻ hơn ở kiến trúc cho ngữ cảnh dài; flagship có trần chất lượng mạnh hơn.
An ninh mạng: GLM-5.3 là chuyên gia
An ninh mạng là năng lực nổi bật nhất của flagship. Z.ai báo cáo 84,5 trên CyberGym và 54,4 trên ExploitBench. Với ngân sách chuẩn hóa hai giờ và sáu giờ, nó hoàn thành lần lượt 105 và 130 tác vụ ExploitGym.
Flash không có điểm nhấn ra mắt tương đương hoặc bộ kiểm thử công khai phù hợp về an ninh. Cho rà soát mã, phát triển an toàn và phát hiện lỗ hổng được ủy quyền, dùng flagship làm mô hình chính và giữ phê duyệt của con người, công cụ cách ly, nhật ký kiểm toán và kiểm soát công bố trong quy trình.
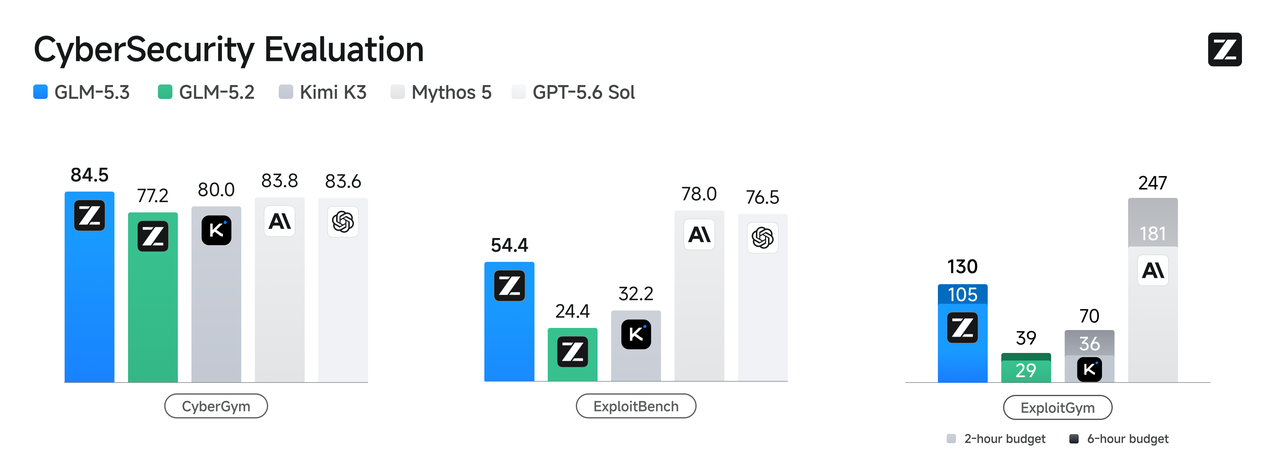
Hiệu năng GLM-5.3 trên các benchmark phát hiện lỗ hổng và chuỗi khai thác.
Nguồn: tài liệu an ninh mạng chính thức của Z.ai
Chi phí và triển khai
Giá API
Z.ai niêm yết Flash ở $0,15 mỗi triệu token đầu vào và $0,50 mỗi triệu token đầu ra trước khuyến mãi, so với $1,40 và $4,40 cho flagship.
| Kênh truy cập | Flash input | Flash cached | Flash output | 5.3 input | 5.3 cached | 5.3 output |
|---|---|---|---|---|---|---|
| Z.ai standard list | $0.15 | $0.03 | $0.50 | $1.40 | $0.26 | $4.40 |
| Z.ai promotional Flash rate | $0.075 | $0.015 | $0.25 | $1.40 | $0.26 | $4.40 |
| CometAPI route | $0.06 | Check live route | $0.20 | $1.12 | Check live route | $3.528 |
Giá tính bằng USD mỗi 1M token. Nguồn: giá Z.ai, tuyến Flash và tuyến GLM-5.3. Khuyến mãi có thể thay đổi.
Ví dụ chi phí hàng tháng
Với khối lượng 100M token đầu vào và 20M token đầu ra, mức giá CometAPI hiện tại ước tính $10,00 cho Flash so với $182,56 cho flagship, trước ảnh hưởng của cache hoặc chi phí công cụ. Flash giảm hóa đơn token khoảng 94,5% trong ví dụ này.
| Thành phần chi phí | GLM-5.3 Flash | GLM-5.3 |
|---|---|---|
| Chi phí input | 100 × $0.06 = $6.00 | 100 × $1.12 = $112.00 |
| Chi phí output | 20 × $0.20 = $4.00 | 20 × $3.528 = $70.56 |
| Tổng | $10.00 | $182.56 |
Trọng số mở và tự lưu trữ
Cả hai mô hình đều có checkpoint FP8 và BF16 có thể tải xuống. Trọng số GLM-5.3 Flash được phát hành theo Giấy phép MIT. GLM-5.3 dùng Giấy phép GLM-5.3 riêng, yêu cầu xem xét bảo mật trước khi sử dụng thương mại bởi nhà vận hành Model-as-a-Service có tổng doanh thu vượt US$10 tỷ trong bất kỳ 12 tháng liên tiếp nào. Kho GLM-5 trên GitHub được cấp phép Apache-2.0.
Flash dễ phục vụ hơn flagship, nhưng không phải mô hình cho GPU tiêu dùng. Checkpoint 320B, các thành phần đa phương thức, bộ nhớ đệm KV và ngữ cảnh 1M vẫn đòi hỏi hạ tầng nghiêm túc. Tự lưu trữ hấp dẫn nhất khi kiểm soát dữ liệu, phục vụ tùy biến hoặc mức sử dụng cao bền vững biện minh cho chi phí vận hành.
Bạn nên chọn mô hình nào?
Chọn GLM-5.3 Flash nếu?
- Bạn cần hiểu hình ảnh, ảnh chụp màn hình, biểu đồ, tài liệu, trình duyệt hoặc GUI.
- Bạn vận hành tác tử lập trình khối lượng lớn, quy trình nghiên cứu hoặc tự động hóa doanh nghiệp.
- Bạn muốn hiệu năng sử dụng công cụ và công việc tri thức mạnh với chi phí token thấp nhất.
- Bạn cần cửa sổ ngữ cảnh 1M nhưng không muốn chi phí theo mức flagship cho mọi yêu cầu.
- Bạn dự định tự lưu trữ và 320B/18B thực tế hơn 744B/40B.
Chọn GLM-5.3 nếu?
- Bạn đang giải các tác vụ kỹ thuật ở quy mô kho mã khó nhất.
- Đánh giá của bạn coi trọng suy luận sâu hơn là chi phí đơn vị thấp.
- Bạn cần kết quả mạnh hơn trên DeepSWE, HLE with tools hoặc Agents’ Last Exam.
- Bạn xây dựng quy trình an ninh phòng thủ hoặc phát hiện lỗ hổng được ủy quyền.
- Tỷ lệ thành công cao hơn có thể bù đắp mức chênh lệch chi phí token khoảng một bậc độ lớn.
Ma trận quyết định theo trường hợp sử dụng
| Khối lượng công việc | Mô hình khởi điểm khuyến nghị | Lý do |
|---|---|---|
| Chat và tự động hóa khối lượng lớn | GLM-5.3 Flash | Chi phí thấp hơn nhiều; sử dụng công cụ mạnh |
| Lập trình thị giác và gỡ lỗi UI | GLM-5.3 Flash | Đầu vào thị giác bản địa |
| Phân tích tài liệu, biểu đồ và Office | GLM-5.3 Flash | Quy trình chuyên nghiệp đa phương thức |
| Bảo trì kho thường kỳ | Bắt đầu với Flash | Nâng cấp khi thất bại hoặc bất thường |
| Kỹ thuật kho khó | GLM-5.3 | Trần lập trình cao hơn |
| Nghiên cứu tầm xa với công cụ | GLM-5.3 | Kết quả HLE-with-tools mạnh hơn |
| An ninh phòng thủ và phát hiện lỗ hổng | GLM-5.3 | Huấn luyện và benchmark an ninh chuyên biệt |
| Tự lưu trữ nhạy chi phí | GLM-5.3 Flash | Dấu chân hoạt động và tổng nhỏ hơn |
| Khối lượng hỗn hợp chưa chắc chắn | Định tuyến lai | Mặc định Flash; nâng cấp flagship |
Chiến lược sản xuất tốt hơn: định tuyến, không thay thế
Với hầu hết đội ngũ, thiết kế mạnh nhất không phải lựa chọn độc quyền. Dùng Flash làm tuyến mặc định, rồi chỉ nâng cấp các tác vụ có độ phức tạp cao, kiểm định thất bại, nhạy cảm an ninh, hoặc có giá trị kinh tế kỳ vọng đủ để biện minh cho premium của flagship.
- Gửi các tác vụ thị giác, thường lệ và khối lượng lớn tới Flash.
- Đo tỷ lệ chấp nhận, token, độ trễ, lỗi công cụ và mức can thiệp của con người.
- Nâng cấp các tác vụ văn bản thất bại hoặc rủi ro cao lên flagship.
- Định tuyến công việc nhạy cảm an ninh qua các lớp ủy quyền và sandbox bổ sung.
- Tối ưu cho chi phí trên mỗi kết quả được chấp nhận thay vì chỉ dựa vào hạng benchmark hoặc đơn giá.
Cách kiểm thử cả hai mô hình qua CometAPI
CometAPI công bố tuyến GLM-5.3 Flash và tuyến GLM-5.3 sau cùng một base URL tương thích OpenAI. Tạo API key, rồi chạy cùng một tác vụ văn bản qua cả hai Model ID. Để bài test công bằng, giữ nguyên prompt, mức nỗ lực suy luận, định nghĩa công cụ, tối đa đầu ra và tiêu chí chấp nhận.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Review this migration plan and identify its three highest-risk assumptions.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Với đánh giá đa phương thức, dùng tài liệu tuyến Flash trực tiếp để xác minh schema nội dung hình ảnh được hỗ trợ. So sánh với flagship nên dùng tương đương văn bản vì nó không chấp nhận đầu vào thị giác.
Hạn chế của so sánh này
- Nhiều điểm số lập trình và tác tử do nhà cung cấp báo cáo. Việc tái hiện độc lập có thể dùng công cụ, prompt và thiết lập suy luận khác.
- Tên benchmark khớp không luôn đảm bảo phiên bản harness hoặc chiến lược quản lý ngữ cảnh giống nhau.
- Giảm tính toán chú ý và bộ nhớ đệm KV ở cấp kiến trúc không trực tiếp dự đoán độ trễ API.
- Giá, khuyến mãi, khả dụng mô hình, giới hạn tốc và khả năng tuyến có thể thay đổi; hãy kiểm tra trang mô hình trực tiếp trước khi triển khai.
- Trọng số mở không khiến checkpoint nào rẻ để tự lưu trữ ở ngữ cảnh đầy đủ.
- Năng lực an ninh mạng mang tính hai mặt và cần ủy quyền, sandbox, logging, rà soát chuyên gia và công bố có trách nhiệm.
Kết luận
GLM-5.3 Flash là mặc định thực dụng. Nó giữ ngữ cảnh dài, bổ sung thị giác bản địa, thể hiện mạnh ở sử dụng công cụ và công việc chuyên nghiệp, và thay đổi kinh tế đủ để hỗ trợ triển khai rộng hơn nhiều. GLM-5.3 là mô hình leo thang chuyên biệt: đắt hơn, chỉ văn bản, nhưng mạnh hơn ở các tác vụ lập trình, suy luận và an ninh mạng khó nhất.
Phán quyết cuối cùng dựa trên khối lượng công việc: bắt đầu với Flash, đo tỷ lệ chấp nhận thực tế, và chỉ định tuyến sang flagship khi năng lực suy luận bổ sung của nó tạo thêm đủ kết quả thành công để biện minh cho premium.
Câu hỏi thường gặp
GLM-5.3 Flash có tốt hơn GLM-5.3 không?
Không phải trong mọi trường hợp. Flash tốt hơn về giá, đa phương thức và một số benchmark công cụ/tự động hóa. Flagship mạnh hơn ở các khối lượng lập trình khó nhất, suy luận có trợ giúp công cụ và an ninh mạng.
GLM-5.3 Flash có phải mô hình nhỏ không?
Không. Nó có 320B tham số tổng và kích hoạt 18B mỗi token. Nó hiệu quả hơn flagship 744B/40B, nhưng vẫn cần phần cứng đáng kể để tự lưu trữ.
Mô hình nào rẻ hơn?
Flash rẻ hơn rất nhiều. Giá niêm yết tiêu chuẩn của Z.ai chỉ khoảng một phần mười giá flagship, và các tuyến CometAPI hiện tại cho thấy chênh lệch còn lớn hơn khi có khuyến mãi.
Mô hình nào nhanh hơn?
Phụ thuộc chỉ số và nhà cung cấp. Artificial Analysis đo thời gian đến token đầu tiên thấp hơn một chút cho Flash nhưng tốc độ xuất ra cao hơn cho flagship.
Mô hình nào hỗ trợ hình ảnh?
Flash hỗ trợ đầu vào thị giác bản địa. Flagship hiện chỉ hỗ trợ đầu vào văn bản.
Cả hai có hỗ trợ ngữ cảnh 1M token không?
Có. Flash hỗ trợ ngữ cảnh 1M và tối đa 128K đầu ra; flagship cung cấp giới hạn tương tự.
Mô hình nào tốt hơn cho lập trình?
Dùng Flash cho tác tử lập trình thường kỳ và khối lượng lớn. Dùng flagship cho các tác vụ kỹ thuật quy mô kho khó nhất hoặc khi chi phí thất bại lớn hơn chênh lệch giá.
Mô hình nào tốt hơn cho an ninh mạng?
Flagship. Z.ai huấn luyện và đánh giá riêng cho phát hiện lỗ hổng và suy luận chuỗi khai thác. Chỉ dùng trong môi trường được ủy quyền và kiểm soát.
Cả hai có thể tự lưu trữ không?
Có. Kho của Z.ai liệt kê checkpoint có thể tải và các framework phục vụ hỗ trợ, nhưng cả hai vẫn là dự án hạ tầng lớn.
Chiến lược triển khai tốt nhất là gì?
Dùng Flash làm tuyến mặc định và nâng cấp các tác vụ văn bản khó, thất bại hoặc nhạy cảm an ninh lên flagship. Đo chi phí trên mỗi kết quả được chấp nhận.