
TL;DR
GLM 5.4 là tên gọi trong cộng đồng cho một phiên bản kế nhiệm tiềm năng trong dòng GLM của Z.ai. Tính đến ngày 14 tháng 10 năm 2026, tài liệu mô hình chính thức và hồ sơ phát hành được rà soát cho bài viết này không thiết lập việc ra mắt, bảng thông số kỹ thuật hay định danh API cho GLM-5.4. Union Alpha là một đầu mối tin đồn, trong khi khả năng ra mắt vào tháng 10 chỉ dựa trên nhịp phát hành. Câu hỏi hữu ích là liệu bản phát hành tương lai có cải thiện độ tin cậy khi lập trình và chi phí trên mỗi tác vụ hoàn thành hay không; các mô hình GLM hiện có cung cấp mốc tham chiếu để đánh giá điều đó.
Key Takeaways
- Tình trạng phát hành: Nguồn chính thức được rà soát vào ngày 14 tháng 10 năm 2026 không xác nhận GLM-5.4; chưa có ngày ra mắt cụ thể.
- Bằng chứng tin đồn: Mối liên hệ của Union Alpha với GLM-5.4 vẫn chưa được xác minh, và bản tổng hợp được trích dẫn không xác định bài viết quy chiếu gốc.
- Mốc hiệu năng tham chiếu: Kết quả GLM-5.3 hiện có hữu ích để tham chiếu, nhưng không phải là đo lường GLM-5.4.
- Kiến trúc: GLM-5.3-Flash cho thấy một hướng đi khác về hiệu suất và đa phương thức; việc GLM-5.4 kế thừa hay không vẫn là câu hỏi bỏ ngỏ.
- Khuyến nghị cho nhà phát triển: Đánh giá các mô hình sẵn có ngay bây giờ và yêu cầu định danh mô hình đã xác thực, khả năng tương thích, cùng các phép đo ở cấp tác vụ trước khi nâng cấp.
Has GLM 5.4 Been Released?
GLM 5.4 là tên không chính thức cho một phiên bản kế nhiệm GLM tiềm năng. Chỉ mục tài liệu chính thức và ghi chú phát hành được rà soát vào ngày 14 tháng 10 năm 2026 liệt kê các mô hình GLM hiện có nhưng không thiết lập việc phát hành GLM-5.4. Đây là kiểm tra nguồn có ghi ngày, không phải bằng chứng rằng không có phát triển riêng tư.
Có hai lộ trình phát triển đã được ghi nhận giải thích vì sao một phiên bản kế nhiệm khả dĩ thu hút sự chú ý.
Z.ai xác nhận GLM-5.3 tái sử dụng mô hình nền GLM-5.2 và đạt được cải thiện thông qua hậu huấn luyện. GLM-5.3-Flash thay vào đó sử dụng nền tảng đa phương thức mới và kiến trúc attention lai. Đây là các thực tế mô tả mô hình hiện có, không phải thiết kế GLM-5.4 đã được công bố.
Về mặt thực tiễn, một hướng cải thiện mô hình hiện có thông qua huấn luyện bổ sung, trong khi hướng kia tái thiết kế kiến trúc để giảm chi phí tính toán và hỗ trợ năng lực mới.
Một GLM-5.4 trong tương lai có thể xây dựng dựa trên một trong hai hướng, nhưng hiện chưa có đủ bằng chứng để xác định Z.ai sẽ chọn phương án nào.
How Reliable Are the GLM-5.4 Rumors and Leaks?
Thông tin đã xác nhận
Nền tảng kỹ thuật đã xác nhận đến từ GLM-5.3 và GLM-5.3-Flash, không phải GLM-5.4. Tên GLM-5.4, thông số cuối cùng, ngày phát hành và kết quả benchmark vẫn chưa được xác nhận trong các nguồn chính thức được rà soát cho bài viết này.
Báo cáo cộng đồng / Rò rỉ
Một bài đăng trên X ngày 8 tháng 10 năm 2026 của @NFT_Chen quy cho định hướng phát triển GLM-5.4/5.5 dựa trên bình luận của Tang Jie. Bài đăng mô tả ba ưu tiên mở rộng: mở rộng tiền huấn luyện, tăng cường hậu huấn luyện thông qua SFT, RLHF và RLVR, và mở rộng suy luận và thực thi tác tử qua các tác vụ khó hơn, dài hơn.
Tác giả diễn giải hướng tiếp theo là các tác tử tự chủ dài hơn và tự cải thiện đệ quy (RSI). Đây là tường thuật cộng đồng về một bài nói, không phải thông báo phát hành của Z.ai. Tên phiên bản và tuyên bố phát triển vẫn do bài đăng quy kết; chúng không thiết lập ngày ra mắt, kiến trúc cuối cùng, số lượng tham số hay khả năng tự cải thiện được chứng minh cho GLM-5.4.
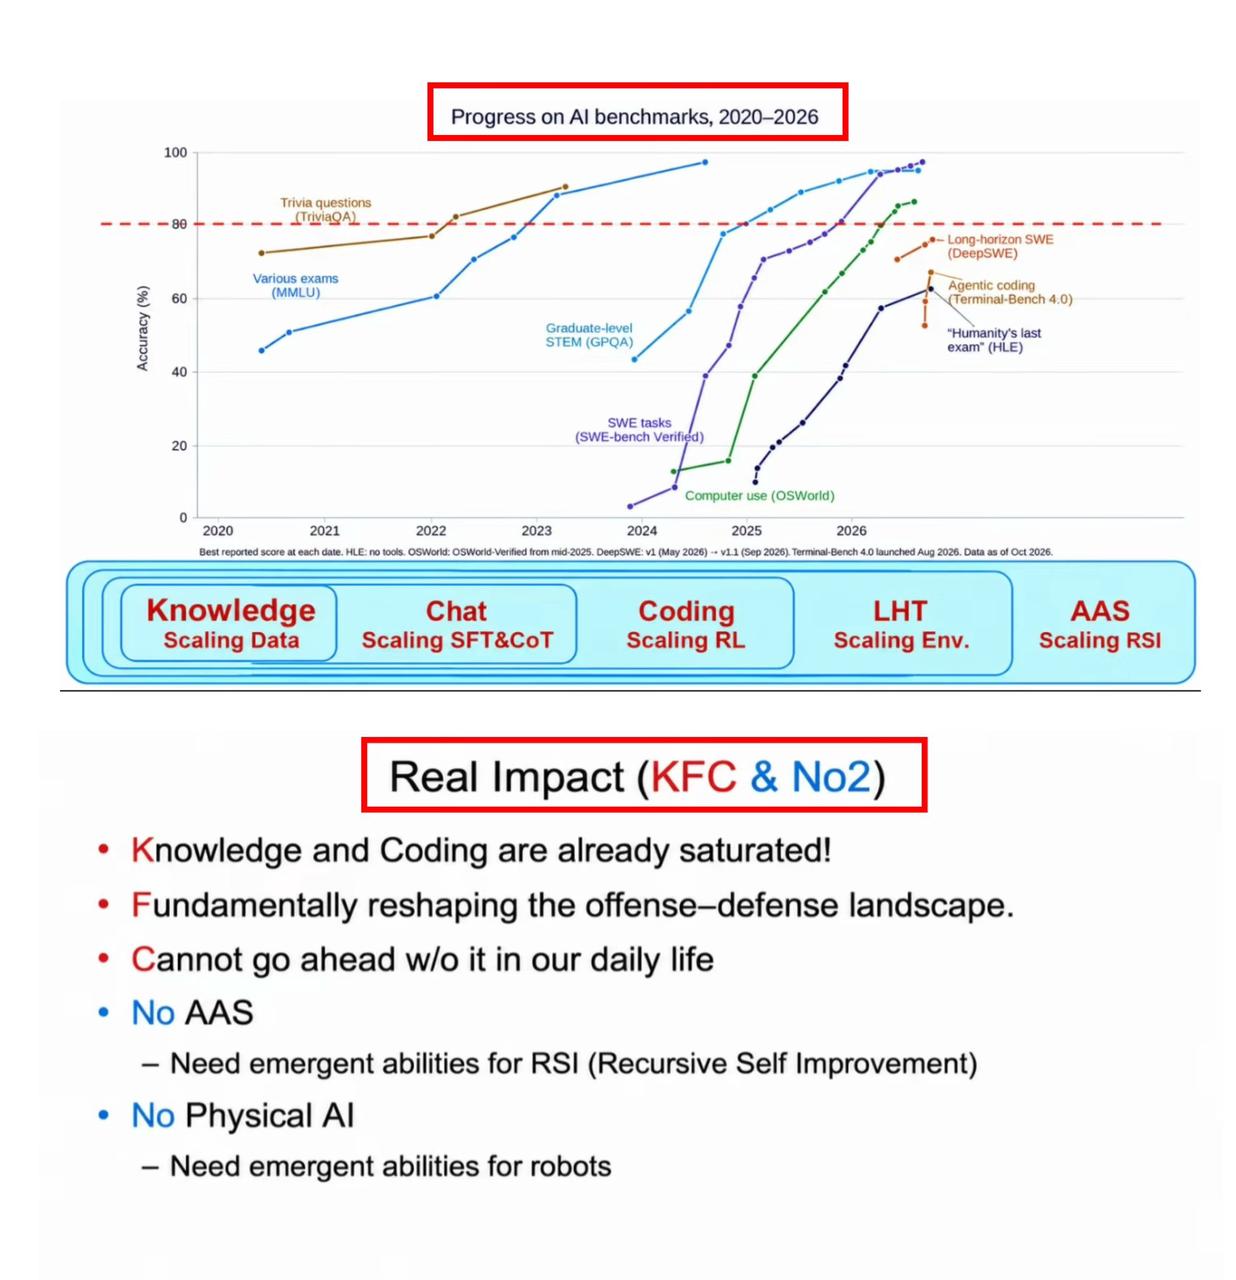
Hình ảnh slide thuyết trình đính kèm bài đăng X gốc của @NFT_Chen, ngày 8 tháng 10 năm 2026. Nó thảo luận tiến bộ benchmark và RSI như hướng đi tương lai; đây không phải báo cáo benchmark GLM-5.4.
Ảnh buổi nói chuyện đính kèm bài đăng X gốc của @NFT_Chen, ngày 8 tháng 10 năm 2026.
Phân tích
Một phân tích tin đồn hữu ích nên hỏi quan sát nào sẽ thay đổi kết luận. Một định danh mô hình chính thức, thông báo phát hành, hoặc phép ánh xạ được công bố từ một bí danh ẩn danh sẽ tăng cường đáng kể lập luận. Một mẫu đặt tên tương tự hoặc khoảng thời gian phát hành tương tự thì không thể làm được điều đó. Suy đoán cũ về các số phiên bản GLM tương lai khác không thiết lập thông số cho GLM-5.4.
When Could GLM 5.4 Be Released?
Dòng thời gian ghi chú phát hành của Z.ai ghi nhận GLM-5 vào ngày 12 tháng 2, GLM-5.1 vào ngày 7 tháng 4, GLM-5.2 vào ngày 16 tháng 6, GLM-5.3 vào ngày 18 tháng 8, và GLM-5.3-Flash vào ngày 26 tháng 8 năm 2026. Đây là các ngày được ghi trong ghi chú phát hành; không nên đánh đồng chúng với mọi thông báo nghiên cứu hay ngày nhà cung cấp mở khả dụng.
Nhịp tiến khoảng hai tháng của các phiên bản chính khiến tháng 10 trở thành cửa sổ theo dõi hợp lý về mặt phân tích. Điều này không thiết lập việc ra mắt vào tháng 10, một ngày cụ thể, hay thậm chí tên phiên bản tiếp theo. Nếu không có nguồn dự báo có thể truy vết cùng phương pháp, dự đoán chính xác ngày 20 hoặc 23 tháng 10 sẽ hàm ý mức độ chính xác vượt quá bằng chứng hỗ trợ.
Khả năng ra mắt muộn hơn, tên khác, hoặc biến thể sản phẩm riêng vẫn có thể xảy ra. Các nhà phát triển nên lập kế hoạch dựa trên API hiện có thay vì ước tính theo lịch.
What Are GLM 5.4's Expected Specs?
Không có bảng thông số GLM-5.4 đáng tin cậy nào hiện có. Thay vì gán phần cứng và tham số mô hình theo tin đồn cho một sản phẩm chưa ra mắt, việc so sánh các mô hình GLM được ghi nhận gần đây nhất và xác định những điều còn chưa biết sẽ hữu ích hơn.
| Thông số | GLM-5.3 | GLM-5.3-Flash | GLM-5.4 |
|---|---|---|---|
| Phát hành | 18 tháng 8, 2026 | 26 tháng 8, 2026 | Chưa công bố |
| Nền tảng mô hình | Nền GLM-5.2; hậu huấn luyện bổ sung | Nền đa phương thức mới | Chưa biết |
| Kiến trúc | Nền tảng MoE | MoE; attention lai thưa-tuyến tính | Chưa biết |
| Hỗ trợ ngữ cảnh | Ngữ cảnh API 1M đã được ghi nhận | 1M | Chưa biết |
| Đa phương thức gốc | Chỉ đầu vào văn bản | Đầu vào văn bản, hình ảnh, video, tệp | Chưa biết |
| Trọng tâm chính | Lập trình, tác tử, an ninh mạng | Hiệu quả, lập trình, đa phương thức | Chưa biết |
| Benchmark đã công bố | Có | Có | Chưa có |
| Trọng số mô hình | Đã phát hành | Đã phát hành | Chưa có |
Bảng trên báo cáo các khả năng đã được ghi nhận của các mô hình hiện có. Các mục GLM-5.4 vẫn là chưa biết thay vì kế thừa giá trị từ bất kỳ tiền nhiệm nào. Bối cảnh đánh giá của mô hình, cửa sổ ngữ cảnh API và độ dài đầu ra tối đa là các giới hạn khác nhau.
Tổng quan kiến trúc GLM-5.3-Flash báo cáo 320B tham số tổng, 18B tham số kích hoạt và attention lai thưa-tuyến tính. Đây là thông số của Flash đã được công bố và không nên gán cho GLM-5.4.
Lập trình tác tử như một hướng nâng cấp tiềm năng
Lập trình tác tử là một trong những lĩnh vực đáng theo dõi nhất. GLM-5.3 đã cho thấy việc mở rộng hậu huấn luyện có thể cải thiện đáng kể hiệu năng trên các tác vụ kỹ thuật nhiều bước. Nhóm phát triển nhấn mạnh công việc với kho mã phức tạp, tầm thực thi dài hơn, và giải quyết vấn đề dựa trên công cụ tốt hơn.
Một mô hình tương lai có thể mở rộng các khả năng này thông qua tương tác môi trường tốt hơn, lập kế hoạch đáng tin cậy hơn, và ít lần gọi công cụ thất bại hơn.
Đánh giá hữu ích nhất không chỉ đo phần trăm câu hỏi lập trình trả lời đúng. Nó sẽ đo xem một tác tử có thể hoàn thành các tác vụ phức tạp từ đầu đến cuối hay không, bao gồm gỡ lỗi, kiểm thử, chỉnh sửa và phục hồi sau thất bại.
Kiến trúc đa phương thức hiệu quả như một hướng đi khả dĩ
GLM-5.3-Flash cung cấp một điểm tham chiếu kiến trúc cho phát triển tương lai, trong khi chưa có nguồn chính thức nào được rà soát xác lập việc dùng nó trong GLM-5.4.
Z.ai mô tả một kho tiền huấn luyện đa phương thức 30T token như một phần thiết kế hướng tới hiệu quả của GLM-5.3-Flash. Điều này mô tả quy mô dữ liệu huấn luyện của một mô hình hiện có và không phải cam kết lộ trình cho GLM-5.4.
Tổng quan Flash chính thức báo cáo tính toán attention thấp hơn 3,01× và yêu cầu KV-cache thấp hơn 4,44× so với GLM-5.3 theo phép so sánh đã nêu. Đây là kết quả hiệu quả ở cấp thành phần, không phải đảm bảo tăng tốc ứng dụng hay giảm giá API.
Đây là những cải tiến kỹ thuật có ý nghĩa, nhưng chưa có xác nhận rằng GLM-5.4 sẽ kế thừa cùng kiến trúc. Một mô hình thế hệ tiếp theo lớn hơn có thể ưu tiên hiệu năng suy luận tối đa, trong khi một biến thể Flash riêng có thể tiếp tục tối ưu độ trễ và chi phí.
GLM 5.4 vs GLM-5.3 vs GLM-5.3-Flash
Mốc benchmark của GLM-5.3
Dữ liệu benchmark hiện có hỗ trợ phân tích quỹ đạo hiệu năng của GLM-5.3, không phải đo lường trực tiếp GLM-5.4. Các giá trị dưới đây là đánh giá do Z.ai báo cáo cho các mô hình hiện có. Chúng chưa được tái hiện độc lập cho bài viết này và không đo GLM-5.4. Mỗi benchmark sử dụng tập tác vụ và phương pháp chấm điểm riêng; chênh lệch điểm không nên được hiểu là mức tăng tương đương trên các tác vụ.
| Bộ kiểm chuẩn và phương pháp | GLM-5.2 | GLM-5.3 | GLM-5.3-Flash | Chênh lệch GLM-5.3 so với GLM-5.2 |
|---|---|---|---|---|
| Terminal Bench 3.0 | 4.6 | 28.3 | Không được báo cáo trong so sánh Flash dẫn | +23.7 điểm |
| DeepSWE v1.1 | 46.2 | 66.9 | 63.4 | +20.7 điểm |
| AutomationBench v1.0.6 | 26.2 | 48.2 | 48.8 | +22.0 điểm |
| CyberGym | 77.2 | 84.5 | Không được báo cáo trong so sánh Flash dẫn | +7.3 điểm |
| ExploitBench | 24.4 | 54.4 | Không được báo cáo trong so sánh Flash dẫn | +30.0 điểm |
| HLE with Tools | 54.7 | 62.5 | 55.3 | +7.8 điểm |
| GDPval-AA v2 | 1508 | 1769 | Không được báo cáo trong so sánh Flash dẫn | +261 Elo |
| Toolathlon Verified | 59.9 | Không được báo cáo trong so sánh GLM-5.3 dẫn | 78.4 | Không khả dụng |
Bảng tổng hợp đặt kết quả mô hình hiện có cạnh nhau; nó không chứa phép đo GLM-5.4. Một giá trị không được báo cáo không phải là điểm bằng 0. Hãy lưu ý điều kiện đánh giá của từng benchmark, và coi chênh lệch GDPval-AA là Elo chứ không phải điểm phần trăm.
Phương pháp: DeepSWE v1.1 dùng mini-swe-agent, temperature 0.95, top_p 1.0, thời gian chờ 6 giờ, và ngữ cảnh 400K. AutomationBench dùng v1.0.6. HLE with Tools dùng temperature 1.0, top_p 0.95, giới hạn sinh 163.840 token, và giới hạn ngữ cảnh 300K với quản lý ngữ cảnh. GDPval-AA v2 dùng thang Elo, nên chênh lệch của nó không phải mức tăng điểm phần trăm.
Đối với CyberGym và ExploitBench, Z.ai báo cáo Claude Code 2.1.207 với max reasoning effort, không dùng công cụ web, temperature 1.0, top_p 1.0, và giới hạn đầu ra 128.000 token. CyberGym báo cáo pass@1 cho một lần chạy trên 1.507 tác vụ với thời gian chờ không giới hạn cho mỗi tác vụ. ExploitBench dùng tới 300 vòng tương tác và trung bình độ phủ trên 41 tác vụ qua ba lần hiệu chỉnh. Phần chú thích thẻ mô hình cung cấp chi tiết môi trường cụ thể cho từng benchmark.
Phương pháp Flash: DeepSWE dùng mini-swe-agent, ngữ cảnh 400K, và thời gian chờ 6 giờ; AutomationBench dùng v1.0.6. Toolathlon Verified báo cáo pass@1 trung bình qua ba lần chạy độc lập thông qua dịch vụ đánh giá chính thức. HLE dùng cài đặt lấy mẫu và quản lý ngữ cảnh như mô tả ở trên. Xem phương pháp thẻ mô hình Flash. Các kết quả benchmark này không thiết lập độ trễ hoặc chi phí sản xuất.
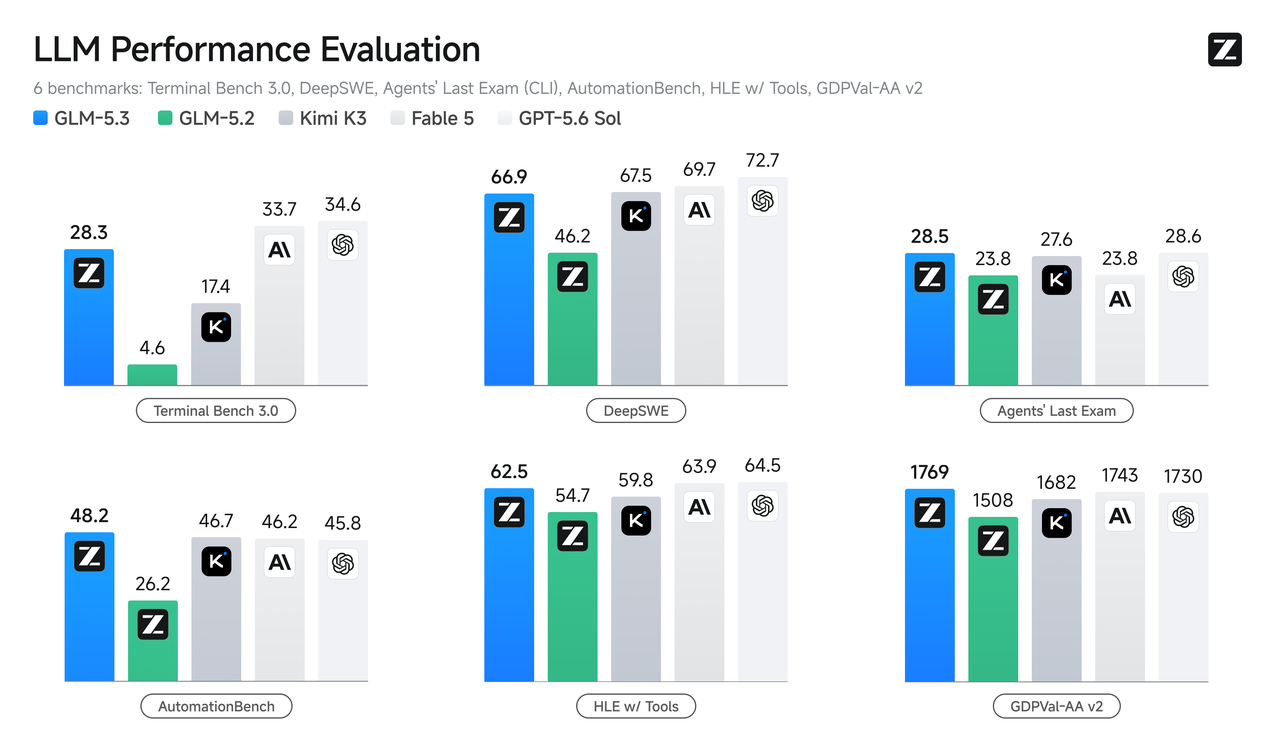
Đồ họa hiệu năng GLM-5.3 chính thức, tái hiện từ thông báo benchmark của Z.ai. Hình ảnh cho thấy đánh giá các mô hình tiền nhiệm; nó không chứa kết quả GLM-5.4.
Những cải thiện lớn nhất xuất hiện ở các tác vụ đòi hỏi tương tác bền bỉ với môi trường. Terminal Bench 3.0 tăng từ 4.6 lên 28.3, trong khi ExploitBench tăng từ 24.4 lên 54.4.
Những mức tăng này gợi ý rằng hậu huấn luyện và môi trường hướng tác tử có thể thay đổi mạnh cách một mô hình hoạt động mà không cần thay đổi kiến trúc nền. Tuy vậy, không nên ngoại suy chúng thành dự đoán số học cho GLM-5.4.
Khả năng và mức độ phù hợp sản xuất
Đối với môi trường sản xuất, GLM-5.3 là tham chiếu mạnh hơn cho lập trình phức tạp, kỹ thuật tầm nhìn dài, và đánh giá an ninh mạng. GLM-5.3-Flash bổ sung đầu vào thị giác gốc và nhấn mạnh sử dụng công cụ hiệu quả. Các lựa chọn GLM-5.2, GLM-5.3 và Flash hiện có cung cấp mốc tham chiếu; không có khả năng hay mức độ sẵn sàng tương đương cho GLM-5.4 được thiết lập trong các nguồn đã rà soát.
Các mô hình đã được ghi nhận hỗ trợ ngữ cảnh tới 1M, nhưng giới hạn đó không đảm bảo khả năng sử dụng ngữ cảnh hay hiệu năng tác vụ giống hệt trên mọi endpoint. Hãy lựa chọn giữa chúng bằng cách dùng khối lượng công việc đại diện và chi phí trên mỗi tác vụ hoàn thành.
Một GLM-5.4 trong tương lai sẽ cần mang lại cải thiện đo lường được để biện minh cho việc di trú. Cải thiện độ chính xác benchmark trong khi gấp đôi chi phí hoàn thành tác vụ có thể không hấp dẫn cho triển khai sản xuất. Ngược lại, mức tăng chính xác vừa phải cùng số lần gọi công cụ ít hơn đáng kể có thể rất giá trị ở quy mô.
So sánh tỷ lệ thành công tác vụ, token đầu vào và đầu ra, độ trễ, lỗi gọi công cụ, và chi phí trên mỗi tác vụ thành công dưới cùng một khung đánh giá. Mô tả định tính về mô hình không phải là bài kiểm tra đối đầu có kiểm soát.
What Is the Current GLM-5.4 API Status on CometAPI?
CometAPI đã tạo một trang mô hình GLM 5.4 riêng với mục định danh mô hình ổn định. Tuy nhiên, trang này vẫn gắn nhãn mô hình là “Coming soon” và mô tả nó là mô hình tiền phát hành. Các nhà phát triển nên xác minh mã mô hình thực tế, quyền truy cập tài khoản, khả dụng của endpoint, tham số được hỗ trợ, giới hạn ngữ cảnh và giá trước khi cố gắng dùng trong sản xuất.
Để tích hợp đã được ghi nhận hiện tại, hãy dùng một mô hình GLM sẵn có như GLM-5.2 hoặc GLM-5.3. Trang GLM-5.4 của CometAPI hiện nên được coi là mục danh mục tiền ra mắt cho đến khi mã mô hình và endpoint được xác nhận có thể gọi.
Chuẩn bị tích hợp API GLM 5.4
Chuẩn bị thực tiễn nhất là tránh ghép chặt logic ứng dụng với một phiên bản mô hình duy nhất. Một mã định danh mô hình có thể cấu hình giúp dễ đánh giá nâng cấp mà không cần viết lại đường ống yêu cầu.
Giữ mã định danh mô hình có thể cấu hình và dùng một mô hình GLM sẵn có để thiết lập mốc hoạt động. Trước khi chuyển sang GLM-5.4, hãy xác nhận mã mô hình có thể gọi, quyền truy cập tài khoản, tham số yêu cầu được hỗ trợ, giới hạn ngữ cảnh và đầu ra, hành vi truyền phát, và khả năng tương thích gọi công cụ. Luôn sẵn sàng phương án quay lui.
Khi GLM-5.4 chính thức khả dụng, xác minh mã mô hình, tham số được hỗ trợ, giới hạn ngữ cảnh và khả năng tương thích endpoint. Chạy mô hình cũ và mới trên cùng bộ dữ liệu đánh giá, theo dõi tỷ lệ thành công, độ trễ, token đầu ra, lỗi gọi công cụ và chi phí trên mỗi lần thực thi thành công.
What Could GLM 5.4 API Pricing Look Like?
Chưa có mức giá API GLM-5.4 chính thức nào được công bố. Vì vậy sẽ gây hiểu nhầm nếu đăng tải một mức giá token vào/ra cụ thể như thể đó là rò rỉ thực.
Họ nhà GLM hiện tại cho thấy vì sao chỉ dựa vào kích thước mô hình là không đủ để dự đoán giá. GLM-5.3-Flash giới thiệu các tối ưu kiến trúc được thiết kế để mang lại trí tuệ cạnh tranh với chi phí suy luận thấp hơn đáng kể.
Bài so sánh Artificial Analysis Intelligence Index v4.1.1 của Z.ai báo cáo điểm 57 với chi phí ước tính đã chiết khấu $0.045 mỗi tác vụ cho GLM-5.3-Flash. Chi phí đánh giá này không phải biểu giá token vào/ra và không dự đoán giá GLM-5.4.
Giá GLM-5.4 trong tương lai có thể phụ thuộc vào kiến trúc, mức nỗ lực suy luận, chiết khấu token được cache, hạ tầng lưu trữ, và các biến thể. Đối với lập kế hoạch sản xuất, chi phí trên mỗi tác vụ hoàn thành thành công thường giá trị hơn mức giá tiêu đề thấp nhất cho token đầu vào.
Should Developers Wait for GLM 5.4?
Đối với hầu hết nhà phát triển, chờ một mô hình chưa được công bố là không cần thiết. Các mô hình GLM hiện có cung cấp khả năng lập trình và tác tử đã được ghi nhận, có thể kiểm thử trong ứng dụng thực.
Các đội xây dựng trợ lý lập trình hoặc tác tử kỹ thuật nhiều bước có thể thiết lập mốc với GLM-5.3. Ứng dụng nhấn mạnh hiểu hình ảnh, ngữ cảnh dài và các lần gọi lặp hiệu quả có thể đánh giá GLM-5.3-Flash.
Hãy xây dựng bộ khung đánh giá ngay bây giờ và dành một suất so sánh trong tương lai cho GLM-5.4. Khi sẵn sàng, bản phát hành sẽ có ý nghĩa nếu nó cải thiện các kết quả quan trọng đối với ứng dụng cụ thể.
Các nhà nghiên cứu nên theo dõi kiến trúc nền tảng mới, thay đổi trong các benchmark tầm nhìn dài, và độ tin cậy đầu-cuối. Doanh nghiệp nên ưu tiên mức độ sẵn sàng, chi phí, độ trễ, khả năng tương thích, và chất lượng trên dữ liệu sản xuất đại diện.
Conclusion
GLM 5.4 là một bước tiếp theo hợp lý trong dòng mô hình phát triển nhanh của Z.ai, nhưng câu chuyện hiện tại về nó vẫn thiên về suy đoán hơn là xác nhận.
Union Alpha là một manh mối danh tính chưa được xác minh, và nhịp phát hành chỉ hỗ trợ giả thuyết về khoảng thời gian. Cả hai đều không thiết lập ngày ra mắt. Nguồn chính thức được rà soát vào ngày 14 tháng 10 năm 2026 cung cấp mốc cho các mô hình hiện có hơn là xác nhận phát hành GLM-5.4.
Điều có thể kiểm chứng là tiến bộ mà GLM-5.3 và GLM-5.3-Flash đã đạt được. Những cải thiện đáng kể trong lập trình tác tử, đánh giá an ninh mạng và hiệu quả suy luận đặt ra mốc thách thức cho bất kỳ phiên bản kế nhiệm nào.
Câu hỏi then chốt là liệu Z.ai có thể mang lại thực thi tự chủ đáng tin cậy, suy luận mạnh hơn và chi phí cạnh tranh trên mỗi tác vụ hoàn thành hay không. Cho tới khi xuất hiện thông số và benchmark chính thức, GLM-5.4 nên được coi là phát hành tiềm năng, không phải sản phẩm sẵn sàng.
FAQ
Làm thế nào để xác minh danh sách API GLM 5.4?
Kiểm tra xem nhà cung cấp có cung cấp mã định danh mô hình có thể gọi, endpoint được hỗ trợ, điều kiện truy cập và giá hiện hành hay không. Sau đó so sánh định danh này với thông báo hoặc tài liệu chính thức của Z.ai. Một danh sách từ nhà cung cấp có thể thiết lập dịch vụ của họ, nhưng tự thân nó không xác thực nhà phát triển đứng sau một mô hình ẩn danh.
Những kiểm tra tương thích nào quan trọng trước khi chuyển sang GLM 5.4?
Xác thực tham số yêu cầu, cài đặt suy luận, schema gọi công cụ, đầu ra có cấu trúc, hành vi truyền phát, giới hạn ngữ cảnh và đầu ra tối đa trên endpoint thực tế của bạn. Bao gồm các kiểm thử phủ định cho tham số không được hỗ trợ và giữ mô hình hiện tại để có thể quay lui. Tính tương thích với OpenAI mô tả một giao diện; nó không đảm bảo hành vi mô hình giống hệt.
Tôi nên đánh giá GLM 5.4 cho tác tử lập trình như thế nào?
Dùng một tập cố định các tác vụ kho mã đại diện với cùng công cụ, quyền hạn, thời gian chờ và bộ khung cho cả hai mô hình. Đếm số thay đổi đã kiểm thử thành công, khả năng phục hồi sau lỗi gọi công cụ, lượng token, độ trễ và tổng chi phí. Ghi lại mọi lần chạy và lặp lại đủ để bộc lộ biến thiên thay vì chỉ nêu một ví dụ thuận lợi.
Điều gì biện minh cho việc chờ GLM 5.4?
Việc chờ là hợp lý chỉ khi một khả năng sắp ra mắt đã được ghi nhận giải quyết yêu cầu mà các mô hình hiện có không đáp ứng, và sự trì hoãn phù hợp với lịch giao hàng của bạn. Khi chỉ có tin đồn, hãy xây dựng dựa trên mô hình sẵn có và giữ việc lựa chọn mô hình có thể cấu hình. Xác định ngưỡng khả năng và chi phí mà bản phát hành sau cần đạt để thay thế mốc hiện tại của bạn.