
Tóm tắt
Claude Fable 5.1 có bằng chứng benchmark mạnh hơn cho các tác vụ lập trình tự trị khó và công việc dài hạn. GPT-5.6 Sol có chi phí token thông thường thấp hơn, bộ công cụ gốc phong phú và thời gian tới token đầu tiên thấp hơn trong so sánh độc lập ở cấu hình nỗ lực tối đa. Mặc định đúng phụ thuộc vào chi phí của một tác vụ thất bại, không chỉ điểm benchmark cao nhất.
Trong bản chụp Intelligence Index ngày 8 tháng 9, 2026, Fable 5.1 đạt 53, so với 47 của GPT-5.6 Sol. Thông lượng đầu ra gần như ngang nhau ở mức 69,9 so với 69,8 token/giây. Những kết quả này ủng hộ quyết định chất lượng-so-với-chi phí; chúng không xác lập một kẻ chiến thắng tốc độ phổ quát.
Điểm chính
- Chọn Fable 5.1 cho những tác vụ tự trị khó nhất khi đánh giá nội bộ của bạn biện minh cho mức giá cao hơn.
- Bắt đầu với GPT-5.6 Sol cho suy luận biên nhạy cảm chi phí và các ứng dụng hưởng lợi từ bộ công cụ tích hợp của nó.
- So sánh độ trễ khởi động tách biệt với tốc độ đầu ra: GPT-5.6 Sol có thời gian tới token đầu tiên đo được thấp hơn, trong khi thông lượng gần như bằng nhau.
- Mô hình hóa riêng chi phí ghi/đọc cache, thời gian lưu giữ và mức giá long-context. Giá đầu vào/đầu ra “tiêu đề” không phản ánh toàn bộ khối lượng công việc của tác nhân.
Dữ liệu kiểm tra ngày 8 tháng 9, 2026. Kết quả độc lập dùng GPT-5.6 Sol ở mức nỗ lực tối đa và Fable 5.1 với Adaptive Reasoning, Max Effort, Default Fallback. Benchmark của nhà cung cấp và benchmark độc lập dùng thiết lập đánh giá khác nhau. Giá tính bằng USD trên mỗi triệu token (MTok), trừ khi nêu khác.
GPT-5.6 Sol vs Fable 5.1: kết luận nhanh
| Khía cạnh | GPT-5.6 Sol | Claude Fable 5.1 | Lựa chọn tốt hơn |
|---|---|---|---|
| Independent Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable 5.1 |
| Independent Terminal-Bench 4.0 (Sep 7) | 39.9% | 52.0% | Fable 5.1 |
| Anthropic-run Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Cửa sổ ngữ cảnh | 1.05M | 1M | Gần như ngang nhau |
| Đầu ra tối đa | 128K | 128K | Tương đương |
| Đầu vào văn bản/hình ảnh | Yes | Yes | Tương đương |
| Giá đầu vào chính thức / MTok | $4 | $10 | Sol |
| Giá đầu ra chính thức / MTok | $20 | $50 | Sol |
| Đọc cache chính thức / MTok | $0.40 | $0.25 | Fable 5.1 |
| Tốc độ đầu ra độc lập (8/9) | 69.8 tok/s | 69.9 tok/s | Gần như ngang nhau |
| Độ phong phú công cụ API | Rất rộng | Mạnh | Sol |
| Công việc tự trị chạy dài | Tuyệt vời | Thế mạnh lõi | Fable 5.1 |
| Sản xuất nhạy cảm chi phí | Mặc định tốt hơn | Nâng cấp cao cấp | Sol |
Một chính sách khởi đầu hữu ích là Sol cho công việc biên thường lệ, với Fable 5.1 làm hướng leo thang khi một tác vụ không đạt ngưỡng chất lượng hay tự trị của bạn. Xác thực chính sách đó so với chi phí trên mỗi tác vụ thành công.
GPT-5.6 Sol cung cấp sáu mức nỗ lực suy luận, từ không đến tối đa, với mặc định là trung bình. Fable 5.1 sử dụng tư duy thích ứng luôn bật; mức nỗ lực điều khiển độ sâu suy luận, mặc định là cao.
Thêm 50.000 token trong ngữ cảnh của GPT-5.6 Sol hiếm khi quyết định kiến trúc. Tính phí và tái sử dụng cache trở nên quan trọng hơn khi một yêu cầu tiến gần một triệu token; phần long-context bên dưới cho thấy lý do.
GPT-5.6 Sol là gì?
GPT-5.6 Sol là cấp độ năng lực cao trong họ GPT-5.6 của OpenAI dành cho lập trình, nghiên cứu, lập kế hoạch và quy trình tác nhân đòi hỏi khắt khe. Điểm hấp dẫn chính trong so sánh này là sự kết hợp giữa điều khiển suy luận và môi trường thực thi xung quanh.
Thông qua Responses API, GPT-5.6 Sol hỗ trợ bộ công cụ gốc rất rộng: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills và tool search. Điều này có thể giảm số thành phần runtime riêng biệt mà ứng dụng cần tích hợp.
OpenAI cũng mô tả gọi công cụ theo lập trình và thực thi đa tác nhân cho họ model này. Những tính năng nền tảng này quan trọng khi mô hình phải phối hợp công việc qua nhiều công cụ thay vì trả về một câu trả lời đơn lẻ.
Claude Fable 5.1 là gì?
Claude Fable 5.1 nhắm đến lập trình yêu cầu cao, công việc tri thức chuyên nghiệp, nghiên cứu và các tác nhân chạy dài. Kết quả benchmark trực tiếp của nó khiến nó là ứng viên mạnh cho các tác vụ mà khả năng phục hồi, bền bỉ và hoàn tất thành công quan trọng hơn phản hồi ngắn.
Anthropic nhấn mạnh thực thi tự trị bền vững trên nhiều ứng dụng, gồm lập kế hoạch, phục hồi khi bước thất bại và thông báo tiến độ. Hãy coi định vị đó là lý do để thử nghiệm tác vụ dài hơn, không phải đảm bảo rằng mọi quy trình đều hoàn tất chính xác.
Fable 5.1 cũng khác GPT-5.6 Sol ở hành vi API: hạn chế ép buộc lựa chọn công cụ quan trọng với các quy trình yêu cầu mô hình gọi một công cụ cụ thể. Kiểm tra các chế độ tool_choice được hỗ trợ khi di chuyển một vòng lặp tác nhân quyết định.
Câu hỏi tích hợp vì thế mang tính thực tiễn: ứng dụng của bạn có chịu được vòng lặp suy luận tự trị hơn, hay cần kiểm soát chi tiết từng bước? Hãy kiểm thử hành vi công cụ chính xác trước khi chọn lộ trình.
So sánh benchmark: Fable 5.1 có bằng chứng trực tiếp mạnh hơn
So sánh benchmark giữa các nhà cung cấp cạnh tranh rất dễ bị lạm dụng. Đánh giá ra mắt GPT-5.6 ban đầu của OpenAI có trước Fable 5.1, trong khi bản phát hành Fable 5.1 của Anthropic chứa các so sánh trực tiếp GPT-5.6 Sol mới hơn.
Cách sạch nhất để đọc bằng chứng là ba lớp: so sánh trực tiếp của Anthropic, thử nghiệm độc lập hiện tại và hồ sơ năng lực GPT-5.6 Sol do OpenAI công bố.
Kết quả Fable 5.1 vs GPT-5.6 Sol trực tiếp từ Anthropic
Các kết quả benchmark chính thức gồm năm tác vụ có điểm cho cả hai mô hình. Chênh lệch điểm phần trăm và Elo dưới đây được tính từ các giá trị đã công bố.
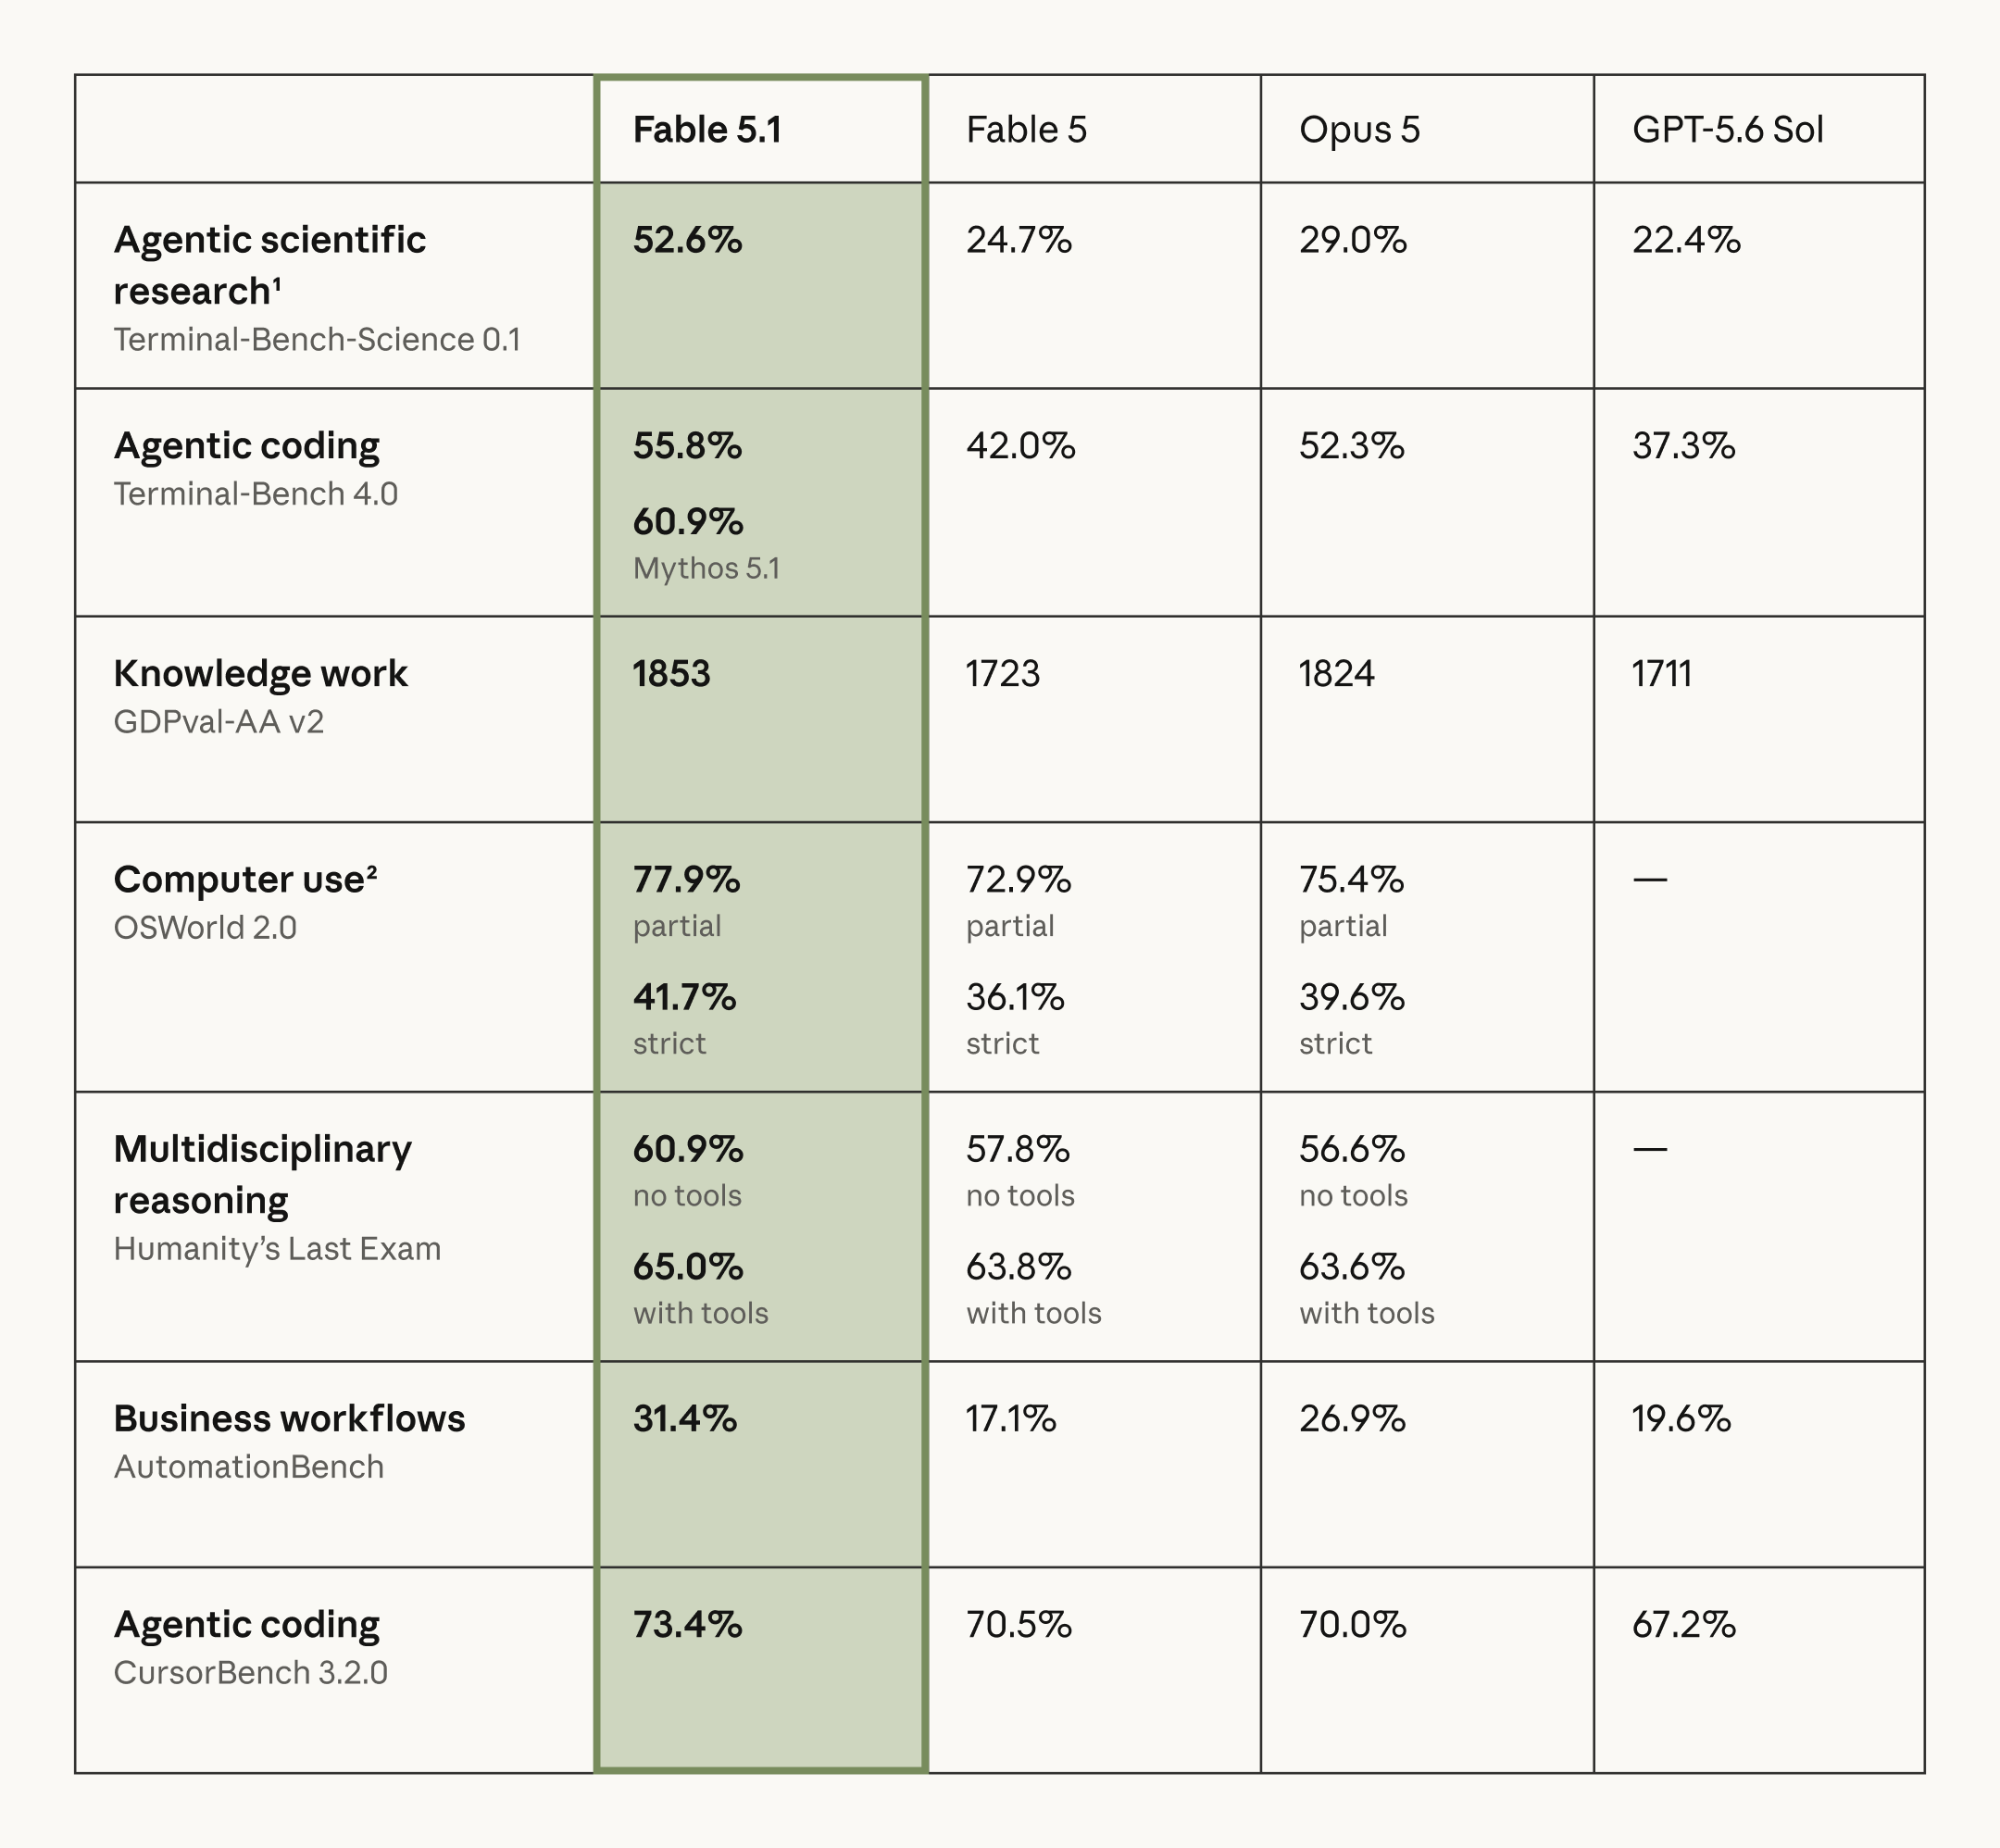
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Fable 5.1 dẫn trước |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 điểm |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 điểm |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 điểm |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 điểm |
Kết quả này bất thường ở tính nhất quán: Fable 5.1 dẫn GPT-5.6 Sol ở mọi hàng trực tiếp mà Anthropic công bố. Chênh lệch lớn nhất xuất hiện ở nghiên cứu khoa học theo tác nhân và lập trình qua terminal thay vì suy luận ngắn thông thường.
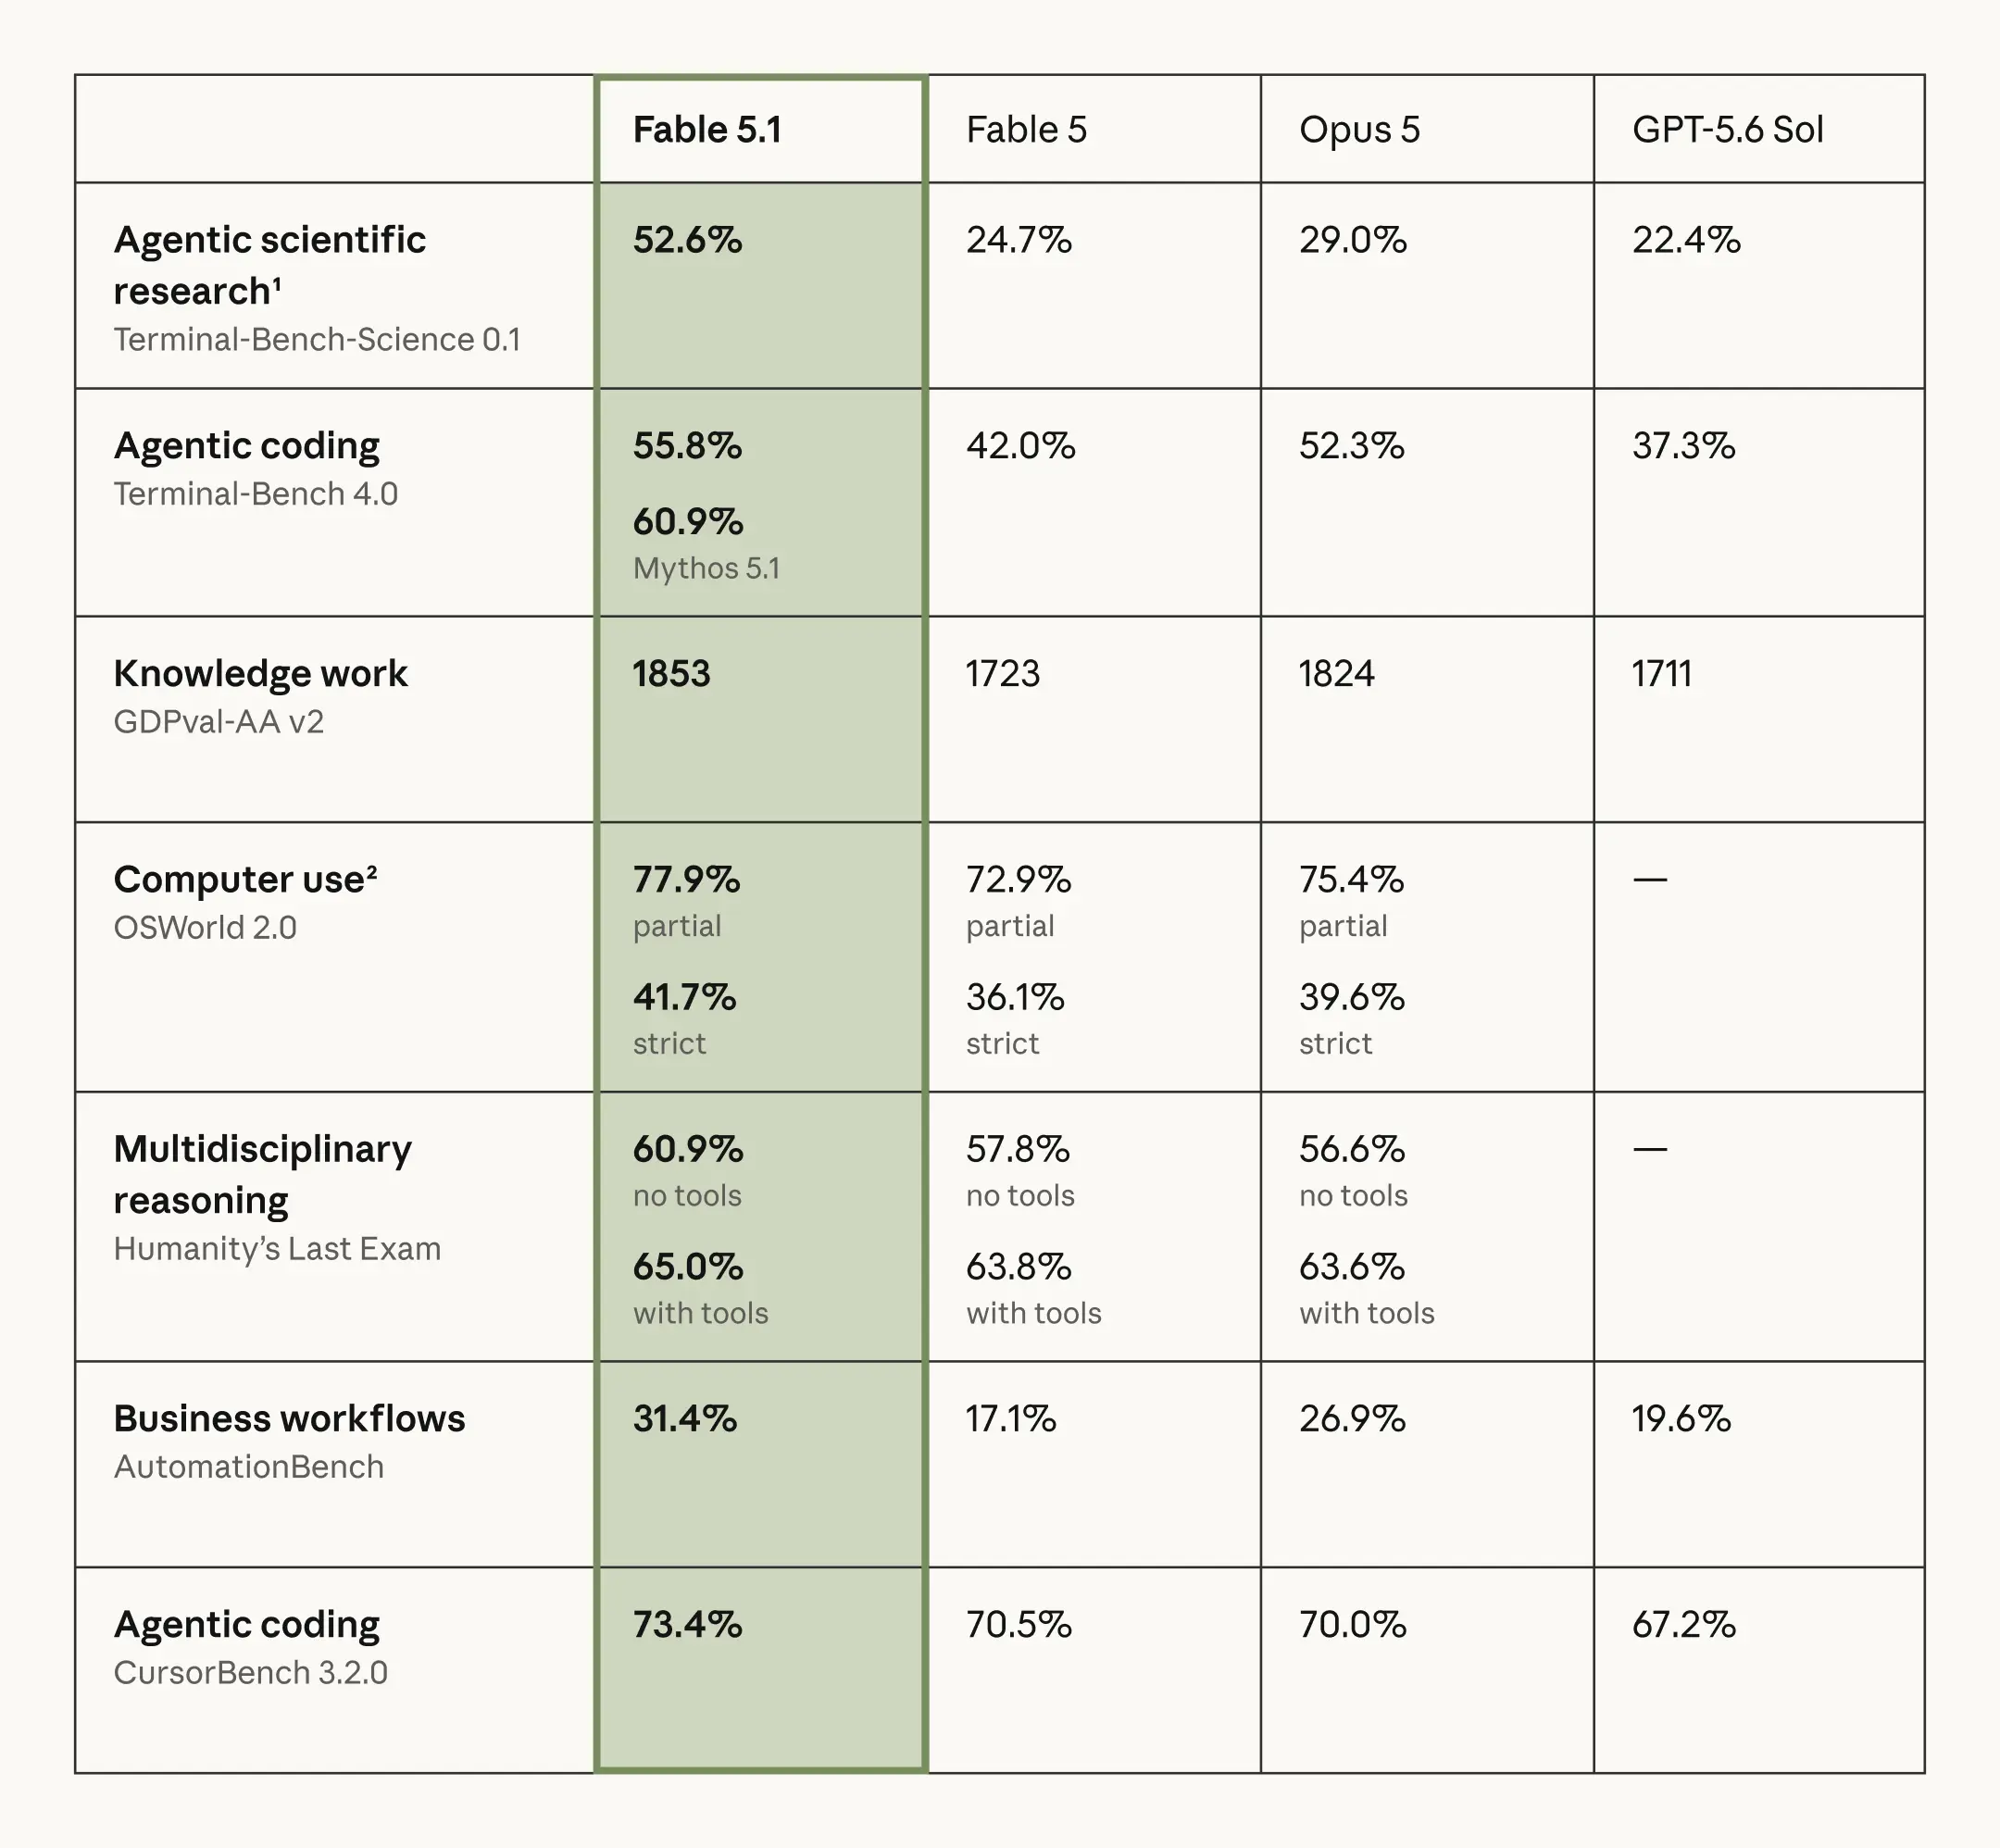
Nguồn: Anthropic — đồ họa benchmark gốc.
Đây là đánh giá do nhà cung cấp thực hiện: Anthropic kiểm thử cả mô hình của họ và mô hình cạnh tranh. Chúng cung cấp bằng chứng so sánh trực tiếp, nhưng không phải thử nghiệm độc lập. Anthropic báo cáo sai số chuẩn ±3.5–4.5 điểm phần trăm mỗi mô hình trên Terminal-Bench-Science; bảng trên hiển thị ước lượng điểm, không phải khoảng tin cậy.
Kết quả từ nhà cung cấp nghiêng về Fable 5.1, nhưng bằng chứng độc lập cần ngày tháng và cấu hình riêng.
Benchmark độc lập: tách biệt kết quả theo ngày với phép đo trực tiếp
Artificial Analysis giới thiệu Intelligence Index v4.3 ngày 7 tháng 9, thay Terminal-Bench 2.1 bằng Terminal-Bench 4.0 và thêm AutomationBench-AA. Bản phát hành báo cáo 53 cho Fable 5.1 và 47 cho GPT-5.6 Sol, khớp với điểm đã làm tròn trong so sánh ngày 8 tháng 9. Bảng phân biệt kết quả terminal của bản phát hành với ảnh chụp hiệu năng sau đó.
| Chỉ số AA độc lập / bản phát hành v4.3 | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Kết quả |
|---|---|---|---|
| Intelligence Index v4.3 (8/9) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (bản phát hành 7/9) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Tốc độ đầu ra (8/9) | 69.8 tok/s | 69.9 tok/s | Gần như ngang nhau |
| Thời gian tới token đầu tiên (8/9) | 132.10 s | 277.47 s | Sol |
| Giá chuẩn hóa token-mix AA / MTok | $3.08 | $7.175 | Sol |
Ảnh chụp: ngày 8/9/2026, trừ hàng Terminal-Bench ngày 7/9 ghi rõ. Fable 5.1 dùng Adaptive Reasoning, Max Effort, Default Fallback; Sol dùng max. Phép đo trực tuyến có thể thay đổi. Giá chuẩn hóa token-mix của AA dùng tỷ lệ 7:2:1 cache-hit/đầu vào/đầu ra; đó không phải chi phí của mọi request API.
OSWorld 2.0 là lợi thế lớn nhất được báo cáo cho Sol trong so sánh này: 62.6% so với 41.7% cho Fable 5.1, dẫn 20.9 điểm. Điều này cân bằng lợi thế Fable mạnh hơn trên Intelligence Index và Terminal-Bench.
Bằng chứng ủng hộ một sự đánh đổi cụ thể: Fable 5.1 có Intelligence Index cao hơn, trong khi Sol có thời gian tới token đầu tiên thấp hơn và giá chuẩn hóa thấp hơn. Thông lượng đầu ra gần như ngang nhau. Những phép đo này ủng hộ lựa chọn khác nhau cho công việc theo lô nhạy chất lượng và ứng dụng tương tác.
So sánh Terminal-Bench độc lập theo ngày cũng cùng hướng với thử nghiệm của Anthropic: 52.0% so với 39.9%, so với 55.8% so với 37.3% của nhà cung cấp. Hai khoảng cách không thể hoán đổi vì thiết lập đánh giá khác nhau.
Điều benchmark của OpenAI vẫn cho biết gì về GPT-5.6 Sol
Đánh giá ra mắt của OpenAI cung cấp bối cảnh bổ sung cho năng lực GPT-5.6 Sol. Chúng có trước các kết quả đối đầu mới hơn ở trên, nên không nên dùng để so sánh trực tiếp với Fable 5.1.
OpenAI báo cáo 88.8% trên Terminal-Bench 2.1 cho GPT-5.6 Sol. Đó là bằng chứng về năng lực lập trình theo tác nhân mạnh dưới thiết lập ra mắt; phiên bản benchmark cũ hơn không nên so sánh số học với điểm Terminal-Bench 4.0.
GPT-5.6 Sol vs Fable 5.1 cho lập trình
Với sinh mã trực tiếp, cả hai mô hình đều dư khả năng cho nhiều khối lượng sản xuất. Sự tách biệt rõ hơn khi lập trình chuyển thành kỹ nghệ phần mềm theo tác nhân: kiểm tra kho lớn, chỉnh sửa nhiều tệp, chạy lệnh, chẩn đoán lỗi, viết kiểm thử và lặp cho đến khi hoàn tất.
Ở đây, Claude Fable 5.1 có bằng chứng benchmark hiện tại mạnh hơn. Nó dẫn cả so sánh Terminal-Bench 4.0 của nhà cung cấp và độc lập, và kết quả CursorBench của Anthropic cũng nghiêng 73.4% so với 67.2%.
Cho đánh giá thực tế, hãy bao gồm thay đổi toàn kho, kiểm thử, review và hiệu năng. Một đoạn mã ngắn thành công là đại diện yếu cho việc hoàn tất tác vụ trải rộng nhiều tệp và nhiều lần thất bại.
GPT-5.6 Sol vẫn hấp dẫn khi môi trường thực thi xung quanh quan trọng không kém chất lượng mô hình cốt lõi. Hỗ trợ gốc cho shell execution, apply-patch, code interpreter, file search, computer use và MCP có thể giảm hạ tầng điều phối bạn phải tự xây.
Kết luận cho lập trình: chọn Fable 5.1 khi đánh giá của bạn nhấn mạnh công việc kho mã tự trị khó nhất. Chọn GPT-5.6 Sol khi chấp nhận khả năng benchmark thấp hơn một chút để đổi lấy chi phí thấp hơn và ngăn xếp thực thi tích hợp rộng.
Điều khiển suy luận và trải nghiệm nhà phát triển
Hai API bộc lộ “trí” theo cách khác nhau.
Phạm vi nỗ lực từ none đến max của Sol cho phép đội ngũ thử nghiệm chất lượng và độ trễ ở nhiều mức. Nỗ lực thấp hơn có thể giảm công việc suy luận, nhưng mức phù hợp phụ thuộc chi phí thất bại của tác vụ.
Tư duy thích ứng luôn bật của Fable khiến việc tinh chỉnh nỗ lực là một bài toán khác. So sánh các thiết lập ứng dụng sẽ triển khai thay vì coi nhãn nỗ lực giống nhau là ngân sách tính toán giống nhau.
Do đó không có so sánh “mặc định Sol” và “mặc định Fable” nào công bằng phổ quát. Cấu hình suy luận mặc định của chúng khác nhau. Đánh giá sản xuất nên so sánh hoặc ngân sách nỗ lực tương đương, hoặc chính xác các thiết lập ứng dụng của bạn sẽ triển khai.
GPT-5.6 Sol vs Fable 5.1: mô hình nào tốt hơn cho tác nhân AI?
Lựa chọn phụ thuộc vào điểm nghẽn là suy luận khó hay runtime bao quanh nó.
Lợi thế của Fable trong các benchmark terminal, automation và công việc chuyên nghiệp được trích dẫn khiến nó là ứng viên hợp lý cho tác vụ khó nhất. Đo tỷ lệ hoàn tất và phục hồi sau bước thất bại trước khi khái quát hóa lợi thế đó cho tác nhân của bạn.
Danh mục công cụ Responses được công bố của GPT-5.6 Sol khiến nó hấp dẫn cho ứng dụng xây quanh tìm kiếm, tệp, thực thi shell và patch. Đó là lợi thế tích hợp cần đánh giá song song với độ chính xác tác vụ, không phải thay thế.
| Yêu cầu của tác nhân | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Suy luận dài hạn khó | Tuyệt vời | Phù hợp nhất |
| Tự trị trên terminal/kho mã | Tuyệt vời | Bằng chứng mạnh hơn |
| Bộ công cụ tích hợp gốc | Mạnh hơn | Mạnh |
| Buộc chọn công cụ | Hỗ trợ; kiểm tra API đã chọn | Bị hạn chế; kiểm tra chế độ tool_choice |
| Tích hợp nền tảng đa tác nhân | Lợi thế mạnh | Sẵn qua kiến trúc tác nhân |
| Truyền đạt tiến độ trong tác vụ dài | Tốt | Hành vi lõi |
| Tác nhân khối lượng lớn nhạy chi phí | Tốt hơn | Cao cấp |
| Tái sử dụng ngữ cảnh khổng lồ qua cache | Tốt | Có thể rất hấp dẫn |
Dùng cả hai có thể kinh tế khi chỉ một phần nhỏ tác vụ cần leo thang. Đo xem các hoàn tất bổ sung có bù được giá cao hơn và độ trễ khởi động của mô hình thứ hai không.
Long context: 1.05M vs 1M không phải khác biệt quan trọng
Con số tiêu đề trông gần như giống nhau: GPT-5.6 Sol cung cấp 1.05M token và Fable cung cấp 1M. Chênh lệch dung lượng 5% hiếm khi quyết định liệu bạn có thể phân tích một kho mã lớn, kho tư liệu pháp lý, kho nghiên cứu hay lịch sử tác nhân nhiều giờ. Cả hai đều thuộc lớp một triệu token.
Với GPT-5.6 Sol, đầu vào trên 272K kích hoạt mức giá long-context cao hơn cho request: $8/MTok đầu vào, $0.80/MTok đầu vào từ cache và $30/MTok đầu ra. Ghi cache cũng tăng từ $5 lên $10/MTok.
Fable 5.1 giữ mức giá ngữ cảnh 1M chuẩn: $10/MTok đầu vào, $50/MTok đầu ra và $0.25/MTok đọc cache. Không có mức premium riêng trên 272K trong cấu hình đã công bố này.
Xét một lượt với 100K token đầu vào chưa cache, 900K token đọc từ cache và 20K token đầu ra được tính phí. GPT-5.6 Sol tốn 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Fable 5.1 tốn 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Lượt thiên về cache này gần như đóng khoảng cách giá vì Fable có giá đọc cache rẻ hơn. Kết quả phụ thuộc vào tổ hợp token của khối lượng công việc; nó không có nghĩa hai mô hình có chi phí như nhau cho cả phiên tác nhân.
Giả định chi phí: tiền tố 900K token đã được cache sẵn, và 100K đầu vào mới không bị tính như ghi cache mới. Ước tính loại trừ ghi cache ban đầu và phí công cụ. Mức 20K đầu ra gồm mọi đầu ra bị tính phí, bao gồm token suy luận nếu bị tính.
Giá: Sol thắng khối lượng công việc thông thường, Fable thắng một chỉ số cache quan trọng
Ở mức giá đã kiểm tra, Sol có giá $4 đầu vào / $20 đầu ra mỗi MTok, với $0.40 đọc cache. Fable 5.1 có $10 đầu vào, $50 đầu ra và $0.25 đọc cache. Bảng tách giá của nhà cung cấp khỏi mức qua GPT-5.6 Sol API trong CometAPI và Claude Fable 5.1 API trong CometAPI.
| Thành phần giá | Giá chính thức GPT-5.6 Sol | Giá chính thức Claude Fable 5.1 |
|---|---|---|
| Giá đầu vào chính thức / MTok | $4.00 | $10.00 |
| Giá đầu ra chính thức / MTok | $20.00 | $50.00 |
| Giá đọc cache chính thức / MTok | $0.40 | $0.25 |
| Giá ghi cache chính thức / MTok | $5.00 (30 phút) | $12.50 (5 phút) |
| Trên 272K đầu vào: input / cache read / cache write / output | $8 / $0.80 / $10 / $30 | Cùng mức cơ bản đã công bố |
| CometAPI input / MTok | $3.20 | $8.00 |
| CometAPI output / MTok | $16.00 | $40.00 |
Thời lượng ghi cache khác nhau: Sol dùng thời gian lưu giữ mặc định 30 phút, trong khi mức của Fable 5.1 hiển thị là cho ghi 5 phút. Kiểm tra hành vi tạo, làm mới và hết hạn cache cho nhà cung cấp và tuyến bạn dùng.
Ở mức giá trực tiếp đã kiểm tra, Fable 5.1 đắt gấp 2.5× so với Sol cho cả đầu vào chưa cache ($10 vs $4/MTok) và đầu ra ($50 vs $20/MTok). Coi các mức đã kiểm tra này là so sánh theo thời điểm, vì khuyến mãi nhà cung cấp và giá gateway có thể thay đổi.
Một request ngữ cảnh ngắn với 100K đầu vào và 10K đầu ra bị tính phí tổng tốn khoảng $0.60 với Sol hoặc $1.50 với Fable ở giá nhà cung cấp trực tiếp. Ở mức CometAPI nêu trên, cùng tổ hợp tốn $0.48 hoặc $1.20. Những ví dụ này không gồm ghi cache và phí công cụ.
Giá đọc cache ngữ cảnh ngắn của Fable thấp hơn 37.5%: ($0.40 − $0.25) ÷ $0.40. Điều đó có thể quan trọng cho tác nhân tái sử dụng một tiền tố lớn ổn định, nhưng tổng tiết kiệm vẫn phụ thuộc đầu vào mới, tần suất ghi và khối lượng đầu ra.
Kết luận về giá: Sol là điểm khởi đầu rẻ hơn cho lưu lượng ngữ cảnh mới. Fable trở nên cạnh tranh hơn khi tỷ lệ đọc cache tăng; so sánh chi phí cả phiên, gồm tạo và làm mới cache.
Tốc độ và độ trễ
Các thử nghiệm nỗ lực tối đa có thể dành nhiều thời gian suy luận trước token hiển thị đầu tiên.
Phép đo thông lượng và độ trễ ngày 8/9 cho thấy 69.9 token/giây cho Fable và 69.8 cho Sol. Thời gian tới token đầu tiên là 277.47 giây so với 132.10 giây. Thông lượng đầu ra gần như bằng nhau; Sol bắt đầu tạo đầu ra hiển thị sớm hơn trong cấu hình này.
Đây là phép đo benchmark ở nỗ lực tối đa, không phải cam kết độ trễ cho mọi cuộc gọi API. Độ dài prompt, cấu hình suy luận, tải nhà cung cấp, công cụ và trạng thái cache có thể thay đổi kết quả. Thời gian tới token đầu tiên và thời gian phản hồi đầy đủ là hai chỉ số khác nhau.
Với công việc tương tác, độ trễ khởi động thấp hơn quan sát được có thể nghiêng về Sol. Với nghiên cứu bất đồng bộ hoặc công việc kho mã qua đêm, hoàn tất thành công có thể quan trọng hơn chờ token đầu tiên. Benchmark cả hai mô hình ở các thiết lập và đồng thời bạn định dùng.
Biện pháp bảo vệ là một khác biệt trong sản xuất
Cả hai mô hình áp dụng biện pháp bảo vệ mạnh hơn vì năng lực của chúng mở rộng vào miền an ninh mạng và khoa học nhạy cảm, nhưng chúng triển khai khác nhau.
OpenAI mô tả bảo vệ nhiều lớp và giám sát cho họ GPT-5.6. Ứng dụng trong miền nhạy cảm nên đánh giá các biện pháp liên quan như một phần hành vi triển khai.
Điều khoản định tuyến lại và lưu giữ của Anthropic mô tả việc định tuyến một số yêu cầu an ninh mạng hay sinh học nhạy cảm sang mô hình kém năng lực hơn, mà không tính phí theo mức Fable cho các yêu cầu đó. Thời gian lưu giữ dữ liệu mặc định là 30 ngày, có ngoại lệ cho thỏa thuận doanh nghiệp đủ điều kiện.
Với lập trình và công việc tri thức thông thường, khác biệt này có thể không bao giờ xuất hiện. Với sản phẩm an ninh, khối lượng công việc tuân thủ hay nhạy cảm quyền riêng tư, chúng nên nằm trong danh sách kiểm tra đánh giá cùng với chất lượng benchmark và giá.
Nên chọn mô hình nào?
So sánh tổng thể có thể quy về hình dạng khối lượng công việc.
| Khối lượng công việc | GPT-5.6 Sol | Claude Fable 5.1 | Khuyến nghị |
|---|---|---|---|
| Lập trình tự trị khó | Tuyệt vời | Benchmark hiện tại mạnh hơn | Fable 5.1 |
| Nghiên cứu dài hạn | Tuyệt vời | Thế mạnh lõi | Fable 5.1 |
| API biên khối lượng lớn | Rẻ hơn nhiều | Đắt | Sol |
| Trợ lý lập trình tương tác | TTFT tối đa đo được thấp hơn | TTFT tối đa đo được cao hơn | Kiểm thử thiết lập triển khai |
| Tác nhân API dùng nhiều công cụ | Bộ công cụ gốc rộng hơn | Mạnh | Sol |
| Tác nhân cache triệu token | Cạnh tranh | Giá đọc cache rất thấp | Thử cả hai |
| Chất lượng suy luận tối đa | Tuyệt vời | Dẫn đầu độc lập | Fable 5.1 |
| Chi phí mỗi yêu cầu thường | Lợi thế rõ ràng | Cao cấp | Sol |
| Suy luận ảnh/tài liệu | Mạnh | Mạnh | Kiểm thử theo khối lượng |
| Ngăn xếp một nhà cung cấp OpenAI | Phù hợp tự nhiên | Cần di trú/gateway | Sol |
| Định tuyến độc lập mô hình | Mạnh | Mạnh | Dùng cả hai qua CometAPI |
Một chính sách định tuyến nên xứng đáng với độ phức tạp của nó. So sánh đường cơ sở một mô hình với chính sách ưu tiên Sol và leo thang sang Fable 5.1 cho tác vụ khó, và chỉ giữ bộ định tuyến nếu nó cải thiện chất lượng hoặc chi phí trên mỗi tác vụ thành công.
Cách so sánh GPT-5.6 Sol và Fable 5.1 qua CometAPI
CometAPI đã tích hợp GPT-5.6 Sol và Claude Fable 5.1. Truy cập cả hai mô hình với định dạng yêu cầu gốc của chúng, gửi cùng bộ đánh giá và so sánh kết quả trả về dưới các thiết lập khớp nhau.
Dùng yêu cầu định dạng gốc cho từng mô hình và giữ nguyên prompt, tập dữ liệu, mức nỗ lực, đồng thời và quy tắc chấm điểm. Lặp lại các lượt chạy; một request tuần tự cho mỗi mô hình là không đủ để ước tính độ trễ hay chất lượng đáng tin.
Cho đánh giá sản xuất, dùng bộ prompt cố định, lặp lại lượt chạy theo thứ tự xen kẽ, ghi nhận mức nỗ lực và chấm tính đúng, tỷ lệ pass kiểm thử, thành công công cụ, số lần thử lại, sử dụng token, thời gian trôi và tổng chi phí trên mỗi tác vụ thành công. Tinh chỉnh từng mô hình riêng sau đường cơ sở chung.
Kết luận cuối cùng: GPT-5.6 Sol hay Claude Fable 5.1?
Fable 5.1 có bằng chứng trực tiếp mạnh hơn cho lập trình tự trị khó và công việc dài hạn. Nó dẫn ở năm hàng benchmark chung của nhà cung cấp và so sánh terminal độc lập theo ngày. Điều đó khiến nó là ứng viên leo thang mạnh, tùy thuộc xác thực trên tác vụ của riêng bạn.
Sol có giá token thông thường thấp hơn, điều khiển suy luận tinh hơn và bộ công cụ gốc rộng. Trong cấu hình tối đa độc lập đã kiểm tra, nó cũng có thời gian tới token đầu tiên thấp hơn; thông lượng đầu ra gần như ngang nhau.
Ưu tiên Fable 5.1 khi các tác vụ tự trị khó nhất quyết định tỷ lệ thành công của bạn. Bắt đầu với Sol cho suy luận biên chú trọng chi phí hoặc ứng dụng dùng nhiều công cụ. Với khối lượng công việc tương tác, hãy kiểm thử các thiết lập nỗ lực triển khai để xác nhận lợi thế độ trễ khởi động quan sát được có duy trì không.
Chọn một mô hình duy nhất khi nó đáp ứng yêu cầu của bạn một cách đơn giản. Thêm định tuyến khi kết quả đánh giá cho thấy chuyển đổi giữa hai mô hình cải thiện chất lượng hoặc chi phí trên mỗi tác vụ thành công.
Câu hỏi thường gặp
Claude Fable 5.1 có tốt hơn GPT-5.6 Sol không?
Nó có Intelligence Index độc lập cao hơn trong ảnh chụp ngày 8/9: 53, so với 47 của Sol. Nó cũng dẫn ở bài test terminal độc lập theo ngày. Điều đó ủng hộ lợi thế chất lượng trên các đánh giá này, không phải tuyên bố rằng nó tốt hơn cho mọi khối lượng công việc.
GPT-5.6 Sol có rẻ hơn Claude Fable 5.1 không?
Với lưu lượng API thông thường chưa cache, có: mức giá nhà cung cấp trực tiếp đã kiểm tra là $4/$20 mỗi MTok cho Sol và $10/$50 cho Fable 5.1. Khối lượng công việc thiên về cache có thể thu hẹp khoảng cách vì giá đọc cache của Fable thấp hơn. Bao gồm hành vi ghi và hết hạn trong ước tính.
Mô hình nào tốt hơn cho lập trình?
Fable 5.1 có bằng chứng benchmark mạnh hơn cho lập trình tự trị trong so sánh này. Sol vẫn hấp dẫn cho quy trình chi phí thấp hơn và công cụ thực thi tích hợp. Dùng tác vụ trên kho với kiểm thử chạy được để quyết định liệu khoảng cách năng lực đo được có quan trọng với ứng dụng của bạn không.
Mô hình nào có cửa sổ ngữ cảnh lớn hơn?
Sol dẫn kỹ thuật ở 1.05M so với 1M token của Fable 5.1, trong khi cả hai cho phép đến 128K đầu ra. Trên thực tế, ngưỡng giá >272K của Sol và giá đọc cache rẻ của Fable thường quan trọng hơn chênh lệch dung lượng 50K token.
Tôi có thể truy cập cả hai mô hình qua CometAPI không?
Có. GPT-5.6 Sol API trong CometAPI và Claude Fable 5.1 API trong CometAPI hỗ trợ điểm khởi đầu chung cho đánh giá văn bản. Kiểm tra hỗ trợ suy luận, cache và công cụ theo tuyến trước khi mở rộng đường cơ sở sang tác nhân sản xuất.