
TL;DR
Bắt đầu với GPT-6.1 Sol khi bạn đã dùng công cụ Responses của OpenAI hoặc cần “nấc thang” mức nỗ lực suy luận rõ ràng; thử Claude Sonnet 5.5 cho vòng lặp mã hóa phạm vi rõ ràng và các sản phẩm chuyên nghiệp theo mẫu. Đây là các ưu tiên đánh giá, không phải bảng xếp hạng chất lượng đã được chứng thực. Cả hai bắt đầu ở mức $2/M input và $10/M output và tính $0.10/M cho lượt đọc cache cơ bản. Với context khoảng 1M và output tối đa chuẩn 128K, khác biệt thực tế nằm ở tích hợp, hành vi tác vụ, thời hạn lưu cache và cách tính phí long-context, chứ không phải ưu đãi ở mức đọc cache cơ bản.
Điểm đánh đổi chính là hành vi tác vụ và điều kiện tính phí. GPT-6.1 Sol dùng năm mức nỗ lực và yêu cầu Responses để gọi công cụ; Sonnet 5.5 dùng tư duy thích ứng. Trên 272K token input, GPT-6.1 Sol áp dụng mức giá cao hơn cho toàn bộ request. Các nguồn được xem xét không đưa ra một bên thắng cuộc theo benchmark khớp đúng phiên bản, vì vậy hãy chọn model đáp ứng tiêu chí chấp nhận của bạn với tổng chi phí quy trình thấp nhất.
Key Takeaways
- Giá cơ sở bằng nhau: cả hai tính $2/M input, $10/M output, và $0.10/M cho đọc cache. So sánh thêm chi phí ghi cache, thời hạn lưu, tầng long-context và mức dùng thực tế bị tính phí.
- Context tương đương: 1.05M so với 1M token; cả hai hỗ trợ output tối đa chuẩn 128K.
- Khác biệt tích hợp: GPT-6.1 Sol yêu cầu Responses để gọi công cụ và không chấp nhận none hoặc minimal effort; Sonnet 5.5 dùng tư duy thích ứng và ràng buộc công cụ theo model.
- Giữ bằng chứng theo phiên bản: điểm số GPT-6 Sol không thể gán nhãn lại thành kết quả của GPT-6.1 Sol.
- Chọn theo công việc đã hoàn thành: đo chất lượng, độ trễ, số lần retry, ghi/đọc cache, phí công cụ và mức sửa của con người.
GPT-6.1 Sol vs Claude Sonnet 5.5 at a Glance
| Yếu tố quyết định / thông số | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Nhà cung cấp | OpenAI | Anthropic |
| Ngày phát hành | September 29, 2026 | September 28, 2026 |
| Model ID | gpt-6.1-sol | claude-sonnet-5-5 |
| Context / output tối đa chuẩn | 1,050,000 / 128,000 token | 1,000,000 / 128,000 token |
| Input → output | Văn bản và hình ảnh → văn bản | Văn bản và hình ảnh → văn bản |
| Điều khiển suy luận | low, medium, high, xhigh, max; mặc định: medium | Tư duy thích ứng; mặc định: high trên Claude Platform |
| Mức nỗ lực mặc định | medium | high trên Claude Platform |
| Ngày chặn kiến thức | April 30, 2026 | June 2026 |
| Giá cơ sở chính thức input/output mỗi 1M | $2 / $10; Yêu cầu Standard với tối đa 272K token input | $2 / $10 |
| Giá cơ sở đọc cache mỗi 1M | $0.10 | $0.10 |
| Giá cơ sở ghi cache mỗi 1M | $2.50 | $2.50 trong 5 phút; $4.00 trong 1 giờ |
| Tính phí long-context | Trên 272K input: $4 input, $0.20 đọc cache, $5 ghi cache, $15 output mỗi 1M; áp dụng cho toàn bộ yêu cầu Standard | Không có phụ phí tương đương được nêu trong phần tổng quan đã trích dẫn |
| Định vị chính | Mã hóa phức tạp, sử dụng máy tính và công việc chuyên nghiệp | Vòng lặp mã nhanh và quy trình công việc chuyên nghiệp |
| Nên thử trước khi | Bạn đã dùng công cụ Responses hoặc cần điều khiển mức nỗ lực rõ ràng | Công việc xoay quanh mã hóa, tài liệu, slide hoặc bảng tính |
| Giới hạn bằng chứng và quyết định | Khả năng đã được tài liệu hóa; chưa có người thắng bằng số liệu khớp đúng phiên bản ở đây | Kết quả công việc mã hóa và tri thức đã công bố; không phải chiến thắng có kiểm soát trước GPT-6.1 Sol |
Tổng quan về GPT-6.1 Sol
GPT-6.1 Sol là bản phát hành Sol ngày 29/9/2026 của OpenAI dành cho mã hóa phức tạp, sử dụng máy tính và công việc chuyên nghiệp. OpenAI mô tả nó là gần hiệu năng Astra với chi phí thấp hơn (https://developers.openai.com/api/docs/models/gpt-6.1-sol); định vị đó cần được xác thực trên tác vụ của bạn. Context lớn và khả năng điều chỉnh suy luận khiến nó phù hợp cho tác tử trên kho mã và quy trình chuyên nghiệp nhiều bước.
Các ràng buộc vận hành quan trọng không kém định vị: medium là mức mặc định, low là mức thấp nhất được hỗ trợ, và gọi công cụ yêu cầu dùng Responses. Một quy trình làm việc dựa trên đường dẫn không suy luận hoặc công cụ của Chat Completions cần di trú trước khi có thể dùng model này ổn định.
Tổng quan về Claude Sonnet 5.5
Claude Sonnet 5.5 là bản phát hành ngày 28/9/2026 của Anthropic cho mã hóa hằng ngày có phạm vi rõ ràng, tác tử và công việc chuyên nghiệp. Phần tổng quan model (https://platform.claude.com/docs/en/models/sonnet-5-5/overview) ghi nhận tư duy thích ứng, mức nỗ lực mặc định cao trên Claude Platform, input văn bản và hình ảnh, và output tối đa chuẩn 128K. Anthropic nhấn mạnh sửa lỗi, tài liệu rõ ràng, slide chỉn chu và vòng lặp hiệu quả.
Với đội phát triển, Sonnet là ứng viên hữu ích cho vòng triển khai và rà soát lặp lại. Với quy trình văn phòng, hãy đánh giá chất lượng bản nháp đầu và độ tuân thủ mẫu. Tuyên bố tốc độ của nhà cung cấp so sánh Sonnet 5.5 với Sonnet 5; nó không khẳng định ưu thế tốc độ so với GPT-6.1 Sol.
GPT-6.1 Sol vs Claude Sonnet 5.5: Hiệu năng
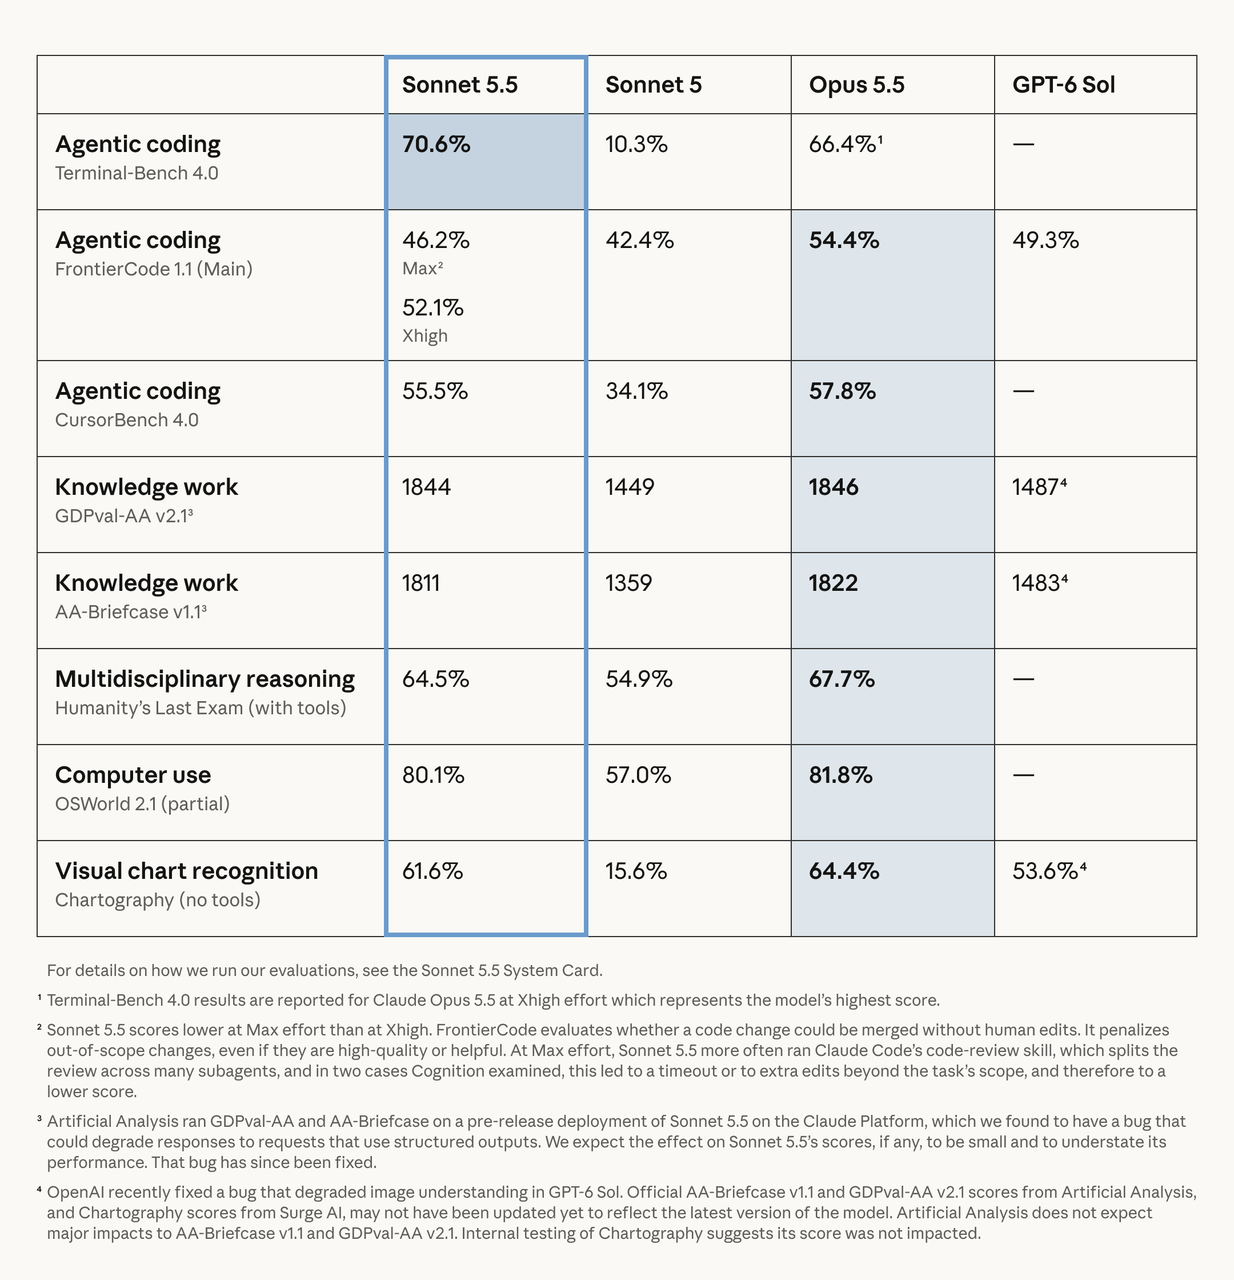
Kết quả ra mắt Sonnet 5.5 của Anthropic (https://www.anthropic.com/claude-sonnet-5-5) cung cấp một tập tín hiệu tải công việc hữu ích. So sánh đó gồm GPT-6 Sol cũ hơn, vì vậy các giá trị cột OpenAI bị loại khỏi bảng model hiện tại bên dưới. “Chưa được thiết lập” nghĩa là các nguồn trích dẫn không hỗ trợ điểm số khớp đúng phiên bản cho so sánh này; không có nghĩa là hiệu năng bằng 0.
| Benchmark / điều kiện | GPT-6.1 Sol | Claude Sonnet 5.5 | Nội dung đo lường |
|---|---|---|---|
| Terminal-Bench 4.0 | Chưa được thiết lập | 70.6% | Tác vụ mã hóa trên terminal |
| FrontierCode 1.1 Main | Chưa được thiết lập | 52.1% Xhigh; 46.2% Max | Thay đổi trong kho mã có thể merge |
| CursorBench 4.0 | Chưa được thiết lập | 55.5% | Phát triển theo kiểu agent trong Cursor |
| GDPval-AA v2.1 | Chưa được thiết lập | 1844 | Công việc tri thức chuyên nghiệp |
| AA-Briefcase v1.1 | Chưa được thiết lập | 1811 | Công việc tri thức tầm dài |
| Humanity’s Last Exam, tools | Chưa được thiết lập | 64.5% | Suy luận đa lĩnh vực |
| OSWorld 2.1, partial | Chưa được thiết lập | 80.1% | Điểm thưởng một phần cho dùng máy tính |
| Chartography, no tools | Chưa được thiết lập | 61.6% | Nhận diện biểu đồ trực quan |
Điều kiện thử: mức nỗ lực và khung agent ảnh hưởng kết quả mã hóa. GDPval-AA và AA-Briefcase là đánh giá của Artificial Analysis, trong khi Chartography đến từ Surge AI. Anthropic lưu ý lỗi structured-output trong triển khai tiền phát hành của Sonnet đã được sửa sau đó có thể làm hơi giảm nhẹ kết quả công việc chuyên nghiệp. Dùng liên kết System Card của thông báo để xem môi trường thử và phương pháp đầy đủ; đừng gộp các chỉ số khác loại thành một xếp hạng tổng.
Hình ảnh gốc của Anthropic bên dưới bao gồm chú thích đánh giá. Cột GPT-6 Sol chỉ là bối cảnh lịch sử và không báo cáo hiệu năng của GPT-6.1 Sol.
Mã hóa theo tác tử và Kỹ nghệ phần mềm
Sonnet 5.5 có bằng chứng đã công bố về mã hóa trên terminal, thay đổi có thể merge và tác vụ agent kiểu IDE. GPT-6.1 Sol được tài liệu hóa cho mã hóa phức tạp và tích hợp với hệ sinh thái công cụ của OpenAI. Cả định vị sản phẩm lẫn điểm số tiền nhiệm đều không xác lập người thắng mã hóa hiện tại. Để đánh giá hữu ích, hãy chọn thay đổi thực có kiểm thử hồi quy và yêu cầu người rà soát đánh giá phạm vi, khả năng bảo trì và mức sẵn sàng merge.
Công việc tri thức, suy luận, toán và khoa học
Kết quả GDPval-AA và AA-Briefcase của Sonnet khiến báo cáo, phân tích và sản phẩm văn phòng trở thành mục tiêu đánh giá hợp lý. GPT-6.1 Sol cũng nhắm tới công việc chuyên nghiệp, nhưng các nguồn ở đây không cung cấp so sánh khớp giữa các model này. Hãy dùng mẫu tài liệu, bảng tính và trình chiếu của riêng bạn. Các tuyên bố về toán nâng cao và khoa học cần bằng chứng theo tác vụ thay vì suy diễn từ điều khiển suy luận tổng quát.
Sử dụng máy tính, tự động hóa trình duyệt và quy trình đa phương thức
Cả hai model nhận hình ảnh, hỗ trợ gỡ lỗi ảnh chụp màn hình và phân tích trực quan. Kết quả OSWorld và Chartography của Sonnet là bằng chứng cho các đánh giá cụ thể đó. GPT-6.1 Sol tài liệu hóa khả năng sử dụng máy tính qua công cụ Responses. Hãy thử toàn bộ quy trình: độ chính xác điều hướng, phục hồi sau lần gọi công cụ thất bại, độ đúng đầu ra và thời gian hoàn thành. Input văn bản và hình ảnh tự nó không đảm bảo tích hợp sử dụng máy tính giống hệt nhau.
Đánh giá độc lập và chất lượng bằng chứng
Một bảng do nhà cung cấp công bố có thể chứa kết quả bên thứ ba mà không trở thành một thí nghiệm có kiểm soát duy nhất. Với mọi so sánh độc lập, hãy ghi nhận chính xác model ID, ngày triển khai, mức nỗ lực, công cụ, biện pháp bảo vệ, timeout, chính sách retry và quy tắc dừng. Một chỉ số trí tuệ tổng hợp, tỷ lệ thành công mã hóa và điểm thưởng một phần cho dùng máy tính trả lời các câu hỏi khác nhau. Các nguồn được xem không thiết lập một tập kết quả độc lập khớp đầy đủ cho cặp này.
GPT-6.1 Sol vs Claude Sonnet 5.5: Chi phí
Bảng giá API chính thức
| Chỉ số giá | Mức chính thức GPT-6.1 Sol | Mức chính thức Claude Sonnet 5.5 |
|---|---|---|
| Input / 1M token, Standard cơ sở | $2.00 | $2.00 |
| Output / 1M token, Standard cơ sở | $10.00 | $10.00 |
| Đọc cache / 1M token, cơ sở | $0.10 | $0.10 |
| Ghi cache / 1M token, cơ sở | $2.50 | $2.50 trong 5m; $4.00 trong 1 giờ |
| Xử lý theo lô | Thấp hơn Standard 50% | Giảm 50% input/output |
| Input trên 272K, toàn bộ yêu cầu Standard | $4 input / $0.20 đọc cache / $5 ghi cache / $15 output | Không có phụ phí tương đương trong tổng quan trích dẫn |
Tất cả mức là USD mỗi triệu token. Đọc cache cơ sở của GPT-6.1 Sol là $0.10/M (https://developers.openai.com/api/docs/models/gpt-6.1-sol) và Sonnet 5.5 cũng là $0.10/M (https://platform.claude.com/docs/en/models/sonnet-5-5/overview). Điều kiện trên 272K input của Sol nâng giá cho toàn bộ yêu cầu Standard, không chỉ phần token vượt mức. Hãy so sánh chi phí ghi cache, thời hạn lưu, tầng long-context, xử lý theo vùng và tầng dịch vụ; riêng mức đọc cơ sở không cho model nào lợi thế.
Chi phí cho mỗi tác vụ hoàn tất
Cost per accepted result = total cost across all attempted tasks / number of accepted results. Tổng chi phí gồm input mới bị tính phí, đọc và ghi cache, output (bao gồm token suy luận bị tính phí nếu có), công cụ trả phí, và rà soát/sửa của con người. Chi phí retry được tính theo mức dùng thực tế, không cộng lặp như một khoản phí trùng.
Với một triệu token đọc cache được tính hoàn toàn ở mức cơ sở, model nào cũng là $0.10; chênh lệch giá đọc cơ sở là $0.00. Đây là phép minh họa mức, không phải giá cho một request Sol 1 triệu token input ở tầng cơ sở. Chi phí phiên thực tế còn gồm input mới, ghi cache, output, công cụ và retry. Hãy so sánh phiên cold/warm dưới tầng context áp dụng và báo cáo tỷ lệ kết quả được chấp nhận cùng mức dùng bị tính phí.
Giá CometAPI
| Tầng CometAPI đã công bố | GPT-6.1 Sol API trong CometAPI | Claude Sonnet 5.5 API trong CometAPI |
|---|---|---|
| Input/output cơ sở mỗi 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| Mức giảm so với nhà cung cấp | 20% | 20% |
| GPT long-context input/output | $3.20 / $12.00 | Kiểm tra điều khoản theo route hiện hành |
| Đọc cache GPT, cơ sở / long | $0.08 / $0.16 | Không nêu trong bảng giá cơ bản đã trích dẫn |
Đây là giá theo route model đã công bố tại thời điểm rà soát này, tách biệt với giá nhà cung cấp. Giá CometAPI của GPT-6.1 Sol phân biệt context ngắn và dài. Bảng cơ bản của Sonnet liệt kê input và output, nên không đủ cơ sở giả định chính sách cache của gateway giống hệt. Hãy kiểm tra điều khoản tính phí theo route đã chọn trước khi ước tính phiên sản xuất.
Cửa sổ ngữ cảnh, tốc độ và thông số kỹ thuật so sánh thế nào?
GPT-6.1 Sol hỗ trợ 1.05M token, còn Claude Sonnet 5.5 hỗ trợ 1M token. Chênh lệch danh nghĩa khoảng 5%, nên riêng dung lượng context hiếm khi quyết định hầu hết triển khai.
Nấc nỗ lực của GPT-6.1 Sol gồm low, medium, high, xhigh và max; mặc định là medium. Sonnet 5.5 dùng tư duy thích ứng với mặc định high trên Claude Platform. Các tên gọi đó không hàm ý ngân sách suy luận bằng nhau. Ở cùng yêu cầu chất lượng, hãy đo thời gian tới token đầu tiên, tốc độ sinh output, độ trễ vòng lặp công cụ và thời gian hoàn tất đầu-cuối riêng rẽ.
Anthropic báo cáo Sonnet 5.5 sinh output nhanh hơn 30% so với Sonnet 5. Hãy coi đó là so sánh với tiền nhiệm. Bằng chứng trong bài này không thiết lập một con số độ trễ phổ quát cho GPT-6.1 Sol hay một kẻ thắng tốc độ trực tiếp giữa hai model hiện tại. Với tác vụ tương tác, hãy thử các mức nỗ lực thấp hơn theo cùng tiêu chí chấp nhận thay vì mặc định max là cấu hình tốt nhất.
Điều gì quan trọng về an toàn, căn chỉnh và triển khai?
Quyết định triển khai cần phân biệt hành vi model được tài liệu hóa với kiểm soát ứng dụng. So sánh model tự nó không xác lập triển khai nào đáp ứng yêu cầu xử lý dữ liệu hay truy cập của tổ chức bạn. Hãy đánh giá nhà cung cấp hoặc gateway bạn thực dùng, gồm ghi log request, nơi lưu dữ liệu, quyền công cụ và xử lý lỗi.
- Di trú suy luận: GPT-6.1 Sol không hỗ trợ none hoặc minimal. Hướng dẫn di trú của OpenAI (https://developers.openai.com/api/docs/guides/latest-model) chỉ dẫn quy trình gọi công cụ sang Responses.
- Hành vi công cụ của Claude: thay đổi tương thích của Sonnet 5.5 (https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5) gồm chế độ ép buộc công cụ không hỗ trợ và các khối thinking bị ràng buộc theo hội thoại. Hãy thử các luồng này trước khi triển khai.
- Kiểm soát vận hành: chỉ cấp cho tác tử những công cụ cần thiết, ghi nhận các lần gọi thất bại, và giữ rà soát của con người cho hành động bên ngoài hệ quả. Đây là lựa chọn thiết kế ứng dụng, không phải ưu thế đo được của model nào.
GPT-6.1 Sol vs Claude Sonnet 5.5: Bạn nên chọn cái nào?
Hãy thử GPT-6.1 Sol trước khi bạn đã dùng công cụ Responses hoặc cần nấc nỗ lực có thể dự đoán. Thử Sonnet 5.5 cho vòng lặp mã, slide, bảng tính và tài liệu, nơi bằng chứng đã công bố của nó khớp tác vụ của bạn. Với phiên có prefix được cache ổn định, hãy thử cả hai: giá đọc cache cơ sở bằng nhau, trong khi chi phí ghi, thời hạn lưu, tầng long-context và tỷ lệ thành công có thể thay đổi tổng chi phí. Chỉ điều phối công việc sau khi các đánh giá đại diện xác lập khác biệt hữu ích về chất lượng, chi phí hoặc độ trễ.
Lựa chọn theo loại tải công việc
| Tải công việc | Điểm khởi đầu | Cần xác minh |
|---|---|---|
| Tác tử OpenAI Responses sẵn có | GPT-6.1 Sol | Tương thích công cụ và thay đổi mức nỗ lực |
| Vòng lặp sửa lỗi / mã hóa | Sonnet 5.5, rồi so sánh với Sol | Mức sẵn sàng merge, độ trễ và số lần retry |
| Slide / bảng tính / báo cáo | Sonnet 5.5, rồi so sánh với Sol | Tuân thủ mẫu và thời gian biên tập của con người |
| Phiên có prefix cache ổn định | Cả hai; giá đọc cache bằng nhau | Tỷ lệ hit, số lần ghi, tầng context và chất lượng |
| Yêu cầu đầy đủ trên 272K input | Cả hai | Hóa đơn long-context thực tế và chất lượng truy xuất |
| Tự động hóa máy tính/trình duyệt | Cả hai | Phục hồi, hoàn tất tác vụ và quyền hạn |
| Phân tích toán/khoa học | Cả hai trên bài kiểm tra cụ thể | Độ đúng với đáp án kiểm chứng |
| Sản xuất nhạy cảm chi phí | Cả hai | Tổng chi phí trên mỗi kết quả được chấp nhận |
Một so sánh trong sản xuất nên giữ nguyên hệ thống xung quanh. Dùng cùng prompt, cùng kho mã hoặc tài liệu, quyền công cụ, timeout, chính sách retry và tiêu chí chấp nhận output.
Ghi lại input mới, ghi và đọc cache, mức dùng output, công cụ trả phí, retry, thời gian rà soát của con người, tỷ lệ thành công tác vụ và độ trễ đầu-cuối. Một phản hồi ban đầu rẻ hơn vẫn có thể dẫn tới kết quả được chấp nhận đắt hơn.
Cách truy cập GPT-6.1 Sol và Claude Sonnet 5.5?
Nhà phát triển có thể truy cập GPT-6.1 Sol API trong CometAPI (https://www.cometapi.com/models/openai/gpt-6-1-sol/) và Claude Sonnet 5.5 API trong CometAPI (https://www.cometapi.com/models/anthropic/claude-sonnet-5-5/) qua các route model đã được tài liệu hóa. Tạo API key, lưu trữ an toàn và xác minh quyền truy cập model cùng điều khoản tính phí theo route trước khi dùng trong sản xuất.
Truy cập GPT-6.1 Sol
Với Sol, dùng route Responses khi cần gọi công cụ. Chọn gpt-6.1-sol và mức nỗ lực được hỗ trợ, mặc định là medium. Truyền input tác vụ, chỉ cấu hình công cụ cần thiết, và xác thực văn bản trả về, lời gọi công cụ, lỗi và usage. Xác nhận gateway hỗ trợ tính năng đặc thù của nhà cung cấp thay vì giả định mọi tùy chọn của OpenAI đều khả dụng.
Truy cập Claude Sonnet 5.5
Với Sonnet, chọn claude-sonnet-5-5 trên một giao diện tương thích đã được tài liệu hóa và gửi tác vụ dưới dạng tin nhắn hội thoại với ngân sách output phù hợp. Xác nhận route đó xử lý thinking gốc và tham số công cụ ra sao; trường reasoning của OpenAI không tự động thay thế bằng tùy chọn của Claude. Xác nhận khả năng tiếp tục hội thoại và xử lý lỗi trước khi triển khai tác tử.
Kiểm tra endpoint chỉ xác minh kết nối, không phải hiệu năng so sánh. Để đánh giá, hãy đồng nhất prompt, ngân sách output và suy luận hiệu dụng, công cụ, retry, timeout và tiêu chí chấp nhận, rồi so sánh công việc được chấp nhận, độ trễ và tổng chi phí bị tính.
Kết luận
GPT-6.1 Sol và Claude Sonnet 5.5 có cùng mức giá cơ sở cho input, output và đọc cache, với dung lượng context tương tự. Sol là ứng viên tự nhiên cho tác tử Responses sẵn có và điều khiển nỗ lực rõ ràng. Tư duy thích ứng và các kết quả đã công bố của Sonnet trong mã hóa và công việc chuyên nghiệp khiến nó hữu ích cho sản phẩm hằng ngày. Quy trình nặng cache cần so sánh cả phiên: giá đọc cơ sở bằng nhau không đảm bảo chi phí ghi, thời hạn lưu, tầng long-context hay chi phí hoàn tất tác vụ cũng bằng nhau.
Hãy chọn model hoàn thành công việc thực tế của bạn trong giới hạn chất lượng, độ trễ và chi phí. Giữ tách bạch điểm số tiền nhiệm khỏi bằng chứng model hiện tại, định giá theo tầng context mà tải công việc của bạn dùng, và so sánh cả hai route trước khi chọn mặc định.
FAQ
GPT-6.1 Sol và Sonnet 5.5 có thể dùng chung một schema công cụ không?
Một định nghĩa công cụ JSON chung có thể là điểm khởi đầu, nhưng hỗ trợ endpoint, chế độ ép buộc công cụ, khối thinking và cách xử lý phản hồi khác nhau. Hãy xác minh lời gọi công cụ của từng model bằng test hợp đồng cho tham số, đường lỗi và tiếp tục hội thoại. Giữ adapter riêng theo model cho tùy chọn không được hỗ trợ thay vì giả định một request văn bản thành công chứng minh tương thích agent.
Nên đối sánh mức nỗ lực suy luận giữa hai model thế nào?
Đừng coi các thiết lập trùng tên là ngân sách tính toán tương đương. Hãy định nghĩa tiêu chí chấp nhận và hoặc là giới hạn chi phí hoặc mục tiêu độ trễ, rồi quét các mức nỗ lực cho từng model. So sánh cấu hình tốt nhất đáp ứng cùng ràng buộc vận hành, bao gồm retry và sửa của con người, thay vì chỉ so sánh mức cao nhất của cả hai.
Khi nào quy trình 1M-context nên dùng retrieval thay thế?
Dùng retrieval khi tác vụ cần một phần nhỏ, có thể xác định của một kho lớn và kiểm thử retrieval của bạn cho thấy vật liệu liên quan luôn được thu hồi. Thử full-context khi bằng chứng phân tán hoặc quan hệ liên tệp quan trọng. So sánh độ đúng câu trả lời, phạm vi trích dẫn, chi phí input và độ trễ; giới hạn context lớn tự nó không xác lập rằng lấp đầy toàn bộ cửa sổ là kinh tế hoặc đáng tin.
Làm sao nhóm tránh so sánh chi phí cache gây hiểu lầm?
Tách đo phiên cold-cache và warm-cache, ghi lại cả ghi lẫn đọc cache, và áp dụng đúng cửa sổ lưu giữ và tầng long-context. Giữ prefix dùng chung ổn định và so sánh các phiên lặp lại thực tế, không chỉ một request được chiết khấu. Báo cáo tỷ lệ hit và mức dùng bị tính phí để một khoản tiết kiệm biểu kiến có thể tái lập.
Điều gì nên kích hoạt một lần đánh giá mới giữa GPT-6.1 Sol và Sonnet 5.5?
Chạy lại bộ tác vụ bị ảnh hưởng sau khi có cập nhật triển khai, sửa lỗi của nhà cung cấp, thay đổi routing, công cụ hoặc prompt, hoặc điều chỉnh giá đáng kể. Ghi ngày đánh giá, model ID, endpoint, mức nỗ lực và phiên bản harness. Giữ bản chạy trước làm baseline để thay đổi chất lượng hoặc độ trễ không bị nhầm với thay đổi ở hệ thống xung quanh.