Xây dựng với CometAPICần một API cho nhiều mô hình?Kiểm thử quy trình trong Playground, sau đó tạo API key khi mô hình và chi phí phù hợp với trường hợp sử dụng của bạn.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Điểm chuẩn, tính năng, giá
Tôi không có dữ liệu công khai/đáng tin về các mô hình “GPT-6.1 Terra”, “DeepSeek V4.1 Flash” hay dịch vụ “CometAPI” tính đến 10/2024, nên không thể đưa ra so sánh thực chứng về benchmark, coding, vision, context, giá API hoặc khả năng truy cập CometAPI.
Nếu bạn cung cấp tài liệu chính thức (liên kết trang sản phẩm, bảng benchmark, specs, bảng giá, tài liệu API), tôi sẽ trích xuất và lập bảng so sánh theo các tiêu chí sau:
- Benchmarks: MMLU, GSM8K, MATH, HumanEval/MBPP (coding), HellaSwag, Big-Bench; với vision có thể gồm MMMU, TextCaps/DocVQA/Chart/ChartQA.
- Coding: pass@1/pass@10 trên HumanEval/MBPP, năng lực debug, sửa lỗi theo test, hỗ trợ tool-calling, code interpreter/exec an toàn.
- Vision: hiểu hình ảnh/tài liệu/bảng/biểu đồ, OCR (tiếng Anh/đa ngôn ngữ), grounding, video (nếu có), giới hạn độ phân giải và kích thước.
- Context: cửa sổ ngữ cảnh tối đa (tokens), chất lượng truy hồi (recall) ở bối cảnh dài, cơ chế nén/attention đặc biệt (nếu có), chi phí ở ngữ cảnh dài.
- Giá API: giá input/output mỗi 1K tokens, giá ảnh/video (nếu có), chính sách rate limit, mức giá theo gói, vùng/khu vực tính phí.
- Truy cập API/CometAPI: độ ổn định, độ trễ (p50/p95), thông lượng, SDK/ngôn ngữ hỗ trợ, quyền/quotas, vùng triển khai, SLA, điều khoản sử dụng.
Nếu bạn đang nói đến các tên gọi khác (ví dụ GPT-4.1/4o/mini của OpenAI, DeepSeek V3/R1, hay một “Comet API” cụ thể), vui lòng xác nhận đúng tên phiên bản hoặc gửi đường dẫn, tôi sẽ so sánh và kết luận mô hình nào phù hợp hơn theo mục tiêu bạn quan tâm (độ chính xác, chi phí, tốc độ, vision, hay ngữ cảnh dài).
TL;DR: GPT-6.1 Terra là điểm khởi đầu mạnh hơn khi chất lượng lập luận và các quy trình thị giác phức tạp là quan trọng nhất; DeepSeek V4.1 Flash hấp dẫn khi chi phí token, tốc độ sinh hoặc nhu cầu tự lưu trữ được ưu tiên. So sánh này sử dụng bản cập nhật ngày 17 tháng 10 của DeepSeek, Flash-1017.
DeepSeek Flash-1017 có giá token thấp hơn, nhưng chi phí cho một tác vụ hoàn tất còn phụ thuộc vào độ dài phần lập luận, số lần thử lại và số lần gọi công cụ.
So sánh dưới đây bao gồm kiến trúc, ngữ cảnh, lập luận, lập trình, thị giác, tốc độ, giá và triển khai. Giá và các trang đánh giá trực tiếp được kiểm tra vào ngày 28 tháng 10, 2026.
Các điểm chính
Terra dẫn đầu trong phép so sánh độc lập Intelligence Index được trích dẫn, khiến nó trở thành ứng viên đầu tiên hợp lý cho các tác vụ lập luận đòi hỏi cao.
DeepSeek có giá token niêm yết thấp hơn. Hãy so sánh độ trễ đầu-cuối và chi phí cho mỗi tác vụ thành công, bao gồm mức giá giờ cao điểm, sử dụng bộ nhớ đệm, token lập luận và số lần thử lại.
Đã được xem xét về độ rõ ràng, ghi nguồn và thuật ngữ API hiện tại.
Đánh giá lập trình dựa trên số bản vá được chấp nhận và các quy trình thị giác dựa trên số tác vụ hoàn tất. Điểm số benchmark đã công bố cung cấp bằng chứng hữu ích, nhưng thiết lập kiểm thử khác nhau.
Terra là mô hình sở hữu và được lưu trữ. DeepSeek cung cấp trọng số có thể tải về với giấy phép MIT để tự lưu trữ, kèm yêu cầu về phần cứng và chi phí vận hành cần cân nhắc.
CometAPI cung cấp giao diện văn bản dùng chung để thử nghiệm cả hai mô hình. Kiểm tra phiên bản mô hình thực tế và khả năng hỗ trợ công cụ, điều khiển lập luận, cùng đầu ra có cấu trúc trước khi triển khai.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Tổng quan và thông số
Khác biệt thông số chính liên quan đến giới hạn đầu ra, điều khiển lập luận, gọi công cụ và triển khai. Bảng dưới đây tóm tắt hai mô hình.
Thông số Terra API và DeepSeek API định nghĩa các giới hạn khi lưu trữ; tuyến bên thứ ba hoặc cấu hình tự lưu trữ có thể áp đặt giới hạn khác.
Thông số
GPT-6.1 Terra
DeepSeek Flash-1017
Kiến trúc và tham số
Kiến trúc độc quyền; không công bố số lượng tham số
MoE Mã hóa–Giải mã nhân quả 552B; khoảng 8B tham số hoạt động cho đầu vào và 16B cho đầu ra
Cửa sổ ngữ cảnh
1,050,000 tokens
1M tokens
Đầu ra tối đa
128,000 tokens
384K tokens
Phương thức đầu vào
Văn bản, hình ảnh
Văn bản, hình ảnh
Phương thức đầu ra
Văn bản
Văn bản
Điều khiển mức lập luận
none, low, medium, high, xhigh, max
Thinking toggle; low, high, max in Chat Completions
Gọi công cụ
Hỗ trợ qua Responses API
Được hỗ trợ; hành vi phụ thuộc vào endpoint và chế độ thinking
Trọng số mở
Không
Có, giấy phép MIT
Kiến trúc và phiên bản mô hình
Terra sử dụng kiến trúc độc quyền với số lượng tham số không công bố. DeepSeek-V4.1-Flash sử dụng kiến trúc MoE Mã hóa–Giải mã nhân quả, với ngân sách tham số hoạt động khác nhau cho xử lý đầu vào và sinh đầu ra.
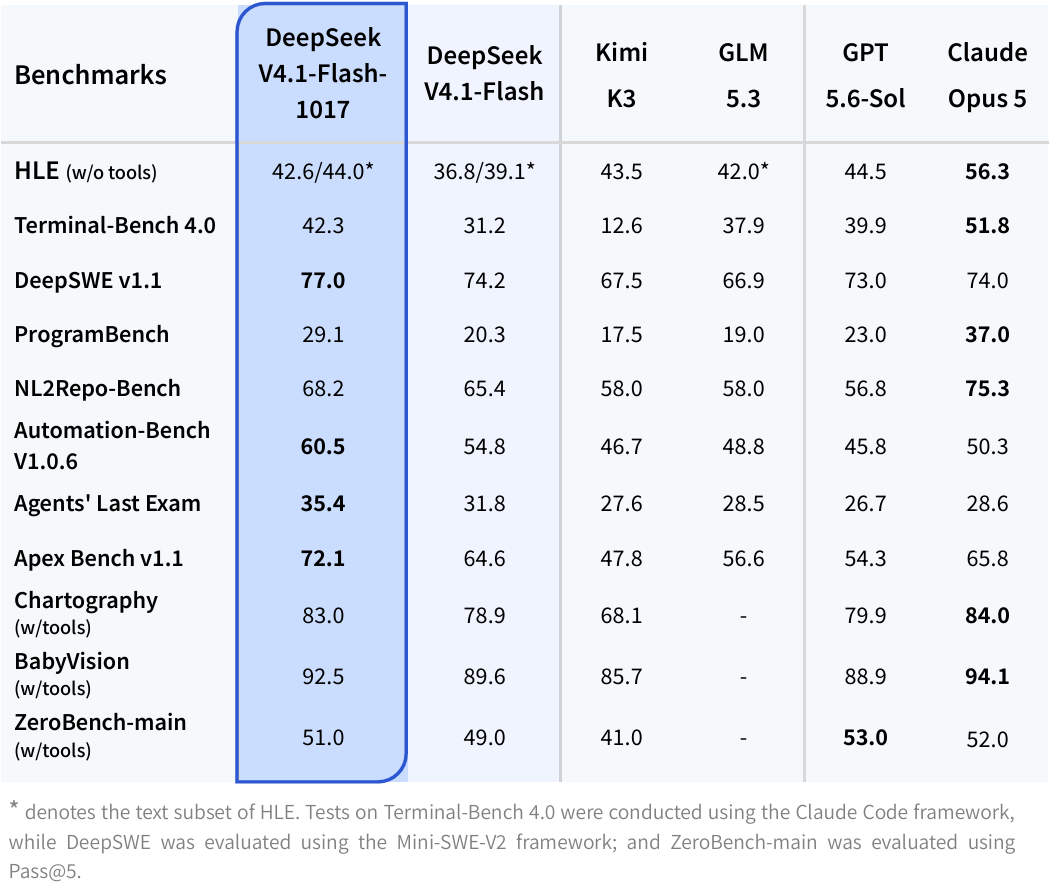
Bản phát hành V4.1 Flash của DeepSeek mô tả một backbone MoE Mã hóa–Giải mã nhân quả 552B tham số, với khoảng 8B tham số hoạt động trong quá trình xử lý đầu vào và 16B trong quá trình sinh đầu ra. Bản cập nhật ngày 17 tháng 10 cải thiện các kết quả đã công bố về lập trình, tác nhân và thị giác.
Trong toàn bài, Flash-1017 ám chỉ checkpoint tháng Mười đó. Một bí danh API tổng quát có thể trỏ tới phiên bản khác về sau, vì vậy bản ghi đánh giá nên bao gồm phiên bản mô hình thực tế đã được phục vụ.
Bộ đệm KV và yêu cầu triển khai
DeepSeek báo cáo dung lượng bộ đệm KV toàn cục xấp xỉ 890 byte mỗi token, khoảng một phần tư so với DeepSeek-V4-Flash. Điều này cải thiện hiệu quả bộ đệm, mặc dù tự lưu trữ vẫn đòi hỏi nguồn lực đáng kể cho trọng số mô hình. Terra có sẵn qua dịch vụ lưu trữ, trong khi trọng số có thể tải về của DeepSeek cung cấp thêm lựa chọn tự lưu trữ.
Điều khiển lập luận và gọi công cụ
Cả hai mô hình đều hỗ trợ quy trình tác nhân, nhưng điều khiển lập luận và yêu cầu gọi công cụ khác nhau. Hỗ trợ gọi công cụ của Terra được ghi nhận qua Responses API. Thẻ mô hình của DeepSeek mô tả mức nỗ lực lập luận dạng số từ 1 đến 100; các điều khiển API dạng lưu trữ cần được kiểm tra riêng. Khi chuyển đổi mô hình, hãy điều chỉnh tham số lập luận và định nghĩa công cụ cho endpoint đã chọn.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Hiệu năng
So sánh dưới đây bao gồm lập luận, lập trình, thị giác và tác vụ ngữ cảnh dài. Phân biệt đánh giá độc lập và benchmark do nhà cung cấp báo cáo, với diễn giải kết quả gắn với cấu hình mô hình và khung tác nhân.
Lập luận và tri thức
Artificial Analysis báo cáo điểm Intelligence Index v5.0 là 51 cho GPT-6.1 Terra (Max) và 32 cho DeepSeek Flash-1017 (Max) trong các cấu hình được trích dẫn, tính đến ngày 28 tháng 10, 2026. Chỉ số kết hợp chín bài đánh giá.
Điểm tổng hợp cao hơn của Terra ủng hộ việc thử nghiệm nó trước cho các tác vụ lập luận đòi hỏi. Với khối lượng công việc hẹp hơn, DeepSeek vẫn có thể là lựa chọn tốt hơn nếu đáp ứng độ chính xác yêu cầu với chi phí mỗi tác vụ thành công thấp hơn.
Điểm chuẩn chính thức về lập trình và tác nhân
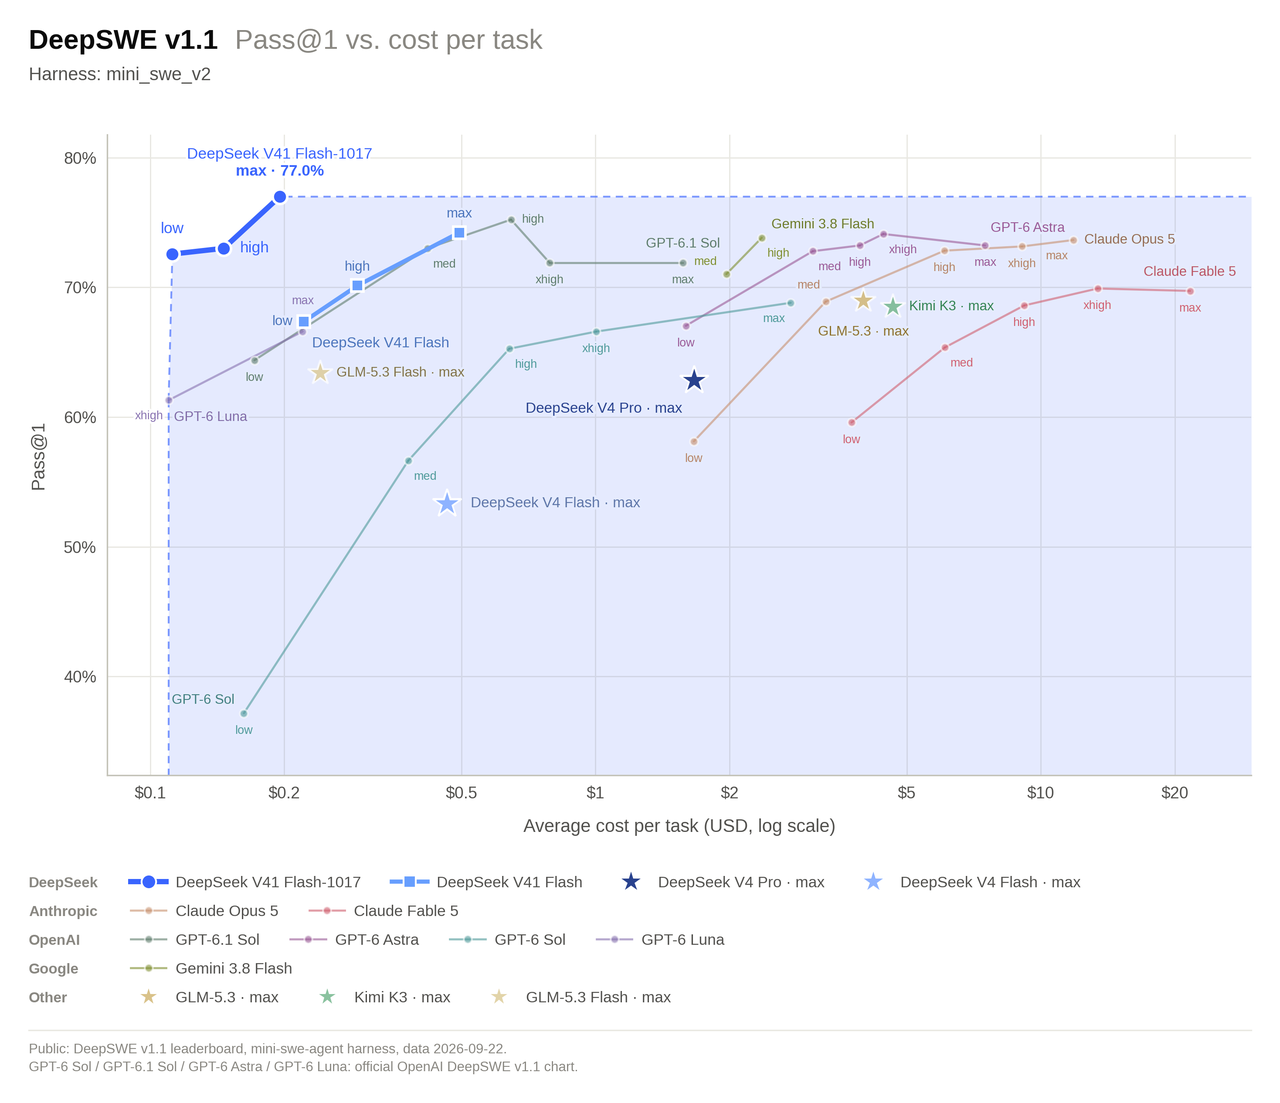
Terminal-Bench 4.0 và DeepSWE v1.1 cung cấp bằng chứng về hiệu năng lập trình và tác nhân. Khi so sánh kết quả của nhà cung cấp, hãy xác định chính xác phiên bản mô hình, mức lập luận, khung tác nhân và chỉ số chấm điểm; khác biệt ở các thiết lập này có thể ảnh hưởng đáng kể đến điểm số.
Trong công việc lập trình thực tế, hãy so sánh việc mỗi mô hình tạo ra các bản vá vượt qua bài kiểm thử hiện có, bảo toàn giao diện công khai, xử lý các trường hợp biên và tránh thay đổi không liên quan. Độ tin cậy khi gọi công cụ và khả năng phục hồi sau lỗi thực thi cũng ảnh hưởng đến khối lượng công việc mà một tác nhân có thể hoàn thành.
Giá token niêm yết thấp hơn của DeepSeek khiến nó trở thành ứng viên hữu ích cho bảo trì kho mã lặp đi lặp lại với tiêu chí chấp nhận rõ ràng. Với thay đổi phức tạp, hãy so sánh cả hai mô hình dựa trên số bản vá được chấp nhận, tổng chi phí tác vụ và thời gian chỉnh sửa thủ công.
Thị giác và sử dụng máy tính
Cả hai mô hình đều nhận đầu vào hình ảnh, nhưng hiểu hình ảnh và tương tác máy tính để bàn yêu cầu năng lực khác nhau. Tài liệu ra mắt Terra của OpenAI đề cập MMMU-Pro và OSWorld 2.1, trong khi thẻ mô hình của DeepSeek báo cáo các tác vụ thị giác gồm Chartography và BabyVision, với thiết lập có hỗ trợ công cụ.
Đối với trích xuất tài liệu, hãy so sánh độ chính xác trường dữ liệu, văn bản bị bỏ sót và cấu trúc bảng. Với tự động hóa trên desktop, so sánh quy trình hoàn tất, hành động sai và khả năng phục hồi sau khi giao diện thay đổi. Một mô hình mô tả ảnh chụp màn hình chính xác vẫn có thể gặp khó khăn khi thao tác ứng dụng trong ảnh.
Hãy chọn theo quy trình: độ chính xác trích xuất quan trọng nhất cho xử lý tài liệu, trong khi hành động đáng tin cậy và khả năng phục hồi quan trọng hơn với tác nhân sử dụng máy tính. Chỉ so sánh chi phí sau khi cả hai mô hình đạt ngưỡng chất lượng yêu cầu.
Lập luận ngữ cảnh dài và truy xuất
Cả hai mô hình hỗ trợ quy trình tài liệu dài, nhưng dung lượng ngữ cảnh không tự quyết định chất lượng truy xuất. Hãy so sánh chúng trên cùng một tập tài liệu, đặt chứng cứ quan trọng ở đầu, giữa và cuối.
Đánh giá độ chính xác câu trả lời, đoạn dẫn chứng, tính nhất quán giữa các tài liệu và độ đầy đủ phản hồi. Với nghiên cứu và phân tích tài liệu, ưu tiên mô hình có khả năng truy xuất và kết nối chứng cứ liên quan một cách ổn định trong phạm vi độ trễ và chi phí chấp nhận được.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Tốc độ
Thông lượng đầu ra và thời gian hoàn thành tác vụ
Độ trễ cần được xem xét tách biệt với chất lượng lập luận.
Trên các trang Artificial Analysis ngày 28 tháng 10, tốc độ đầu ra của Flash-1017 (Max) là 173.4 token mỗi giây, trong khi tốc độ đầu ra của Terra (Max) là 90.9. Các phép đo này mô tả cấu hình mà bên đánh giá được phục vụ, không phải tốc độ đảm bảo trên mọi nhà cung cấp.
Một mô hình tạo token nhanh hơn vẫn có thể mất nhiều thời gian hơn để kết thúc nếu nó tạo nhiều lập luận hơn, chờ công cụ hoặc thử lại. Hãy đo riêng thời gian đến token đầu tiên, tổng thời gian hoàn tất và độ trễ cho tác vụ được chấp nhận.
Độ trễ tương tác trên tuyến API của bạn
Với sản phẩm tương tác, hãy thử prompt ngắn và dài ở mức đồng thời thực tế và ghi nhận độ trễ trung vị và bách phân vị 95%. Giữ nguyên khu vực, tuyến API, bộ đệm prompt, cài đặt lập luận và chính sách thử lại trong kết quả. Bản ghi đó sẽ cho biết trải nghiệm người dùng nhiều hơn một con số token mỗi giây đơn lẻ.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Chi phí
Giá là một trong những khác biệt rõ ràng nhất giữa hai mô hình này.
Bảng giá Terra và chính sách giá DeepSeek đưa ra mức giá bên thứ nhất như đã kiểm tra vào ngày 28 tháng 10, 2026. Tất cả giá bằng đô la Mỹ trên mỗi triệu token.
Mức giá API chính thức
Nhóm token
GPT-6.1 Terra Standard
DeepSeek Flash off-peak
DeepSeek Flash peak
Đầu vào, cache miss
$1.00
$0.15
$0.30
Đầu vào, cache hit
$0.05
$0.003
$0.006
Đầu ra
$5.00
$0.60
$1.20
Giá giờ cao điểm của DeepSeek áp dụng Thứ Hai–Thứ Sáu, 01:00–04:00 và 06:00–10:00 UTC, không bao gồm các ngày nghỉ lễ công tại Trung Quốc. Tương ứng là 09:00–12:00 và 14:00–18:00 theo Giờ chuẩn Trung Quốc (UTC+8). Các khung giờ khác sử dụng mức off-peak.
Với các yêu cầu Terra vượt 272,000 token đầu vào, OpenAI quy định nhân 2× cho giá đầu vào và đầu vào có bộ đệm, và nhân 1.5× cho giá đầu ra áp dụng cho toàn bộ yêu cầu. Hãy so sánh các điều kiện đó với kích thước prompt thực tế trước khi coi giá cơ bản là giá hiệu dụng.
Mức giá CometAPI
Mức cơ bản CometAPI trên 1M token
GPT-6.1 Terra API
DeepSeek V4.1 Flash API
Đầu vào không bộ đệm
$0.80
$0.12
Đầu ra
$4.00
$0.48
Đầu vào có bộ đệm
Not separately specified
$0.0024
Hệ số theo thời gian
Not specified in base pricing
2× trong các khung giờ cao điểm đã liệt kê
CometAPI liệt kê khung giờ cao điểm của DeepSeek là Thứ Hai–Thứ Sáu, 01:00–04:00 và 06:00–10:00 UTC. Lịch đã nêu không xác lập ngoại lệ ngày nghỉ lễ như chính sách bên thứ nhất của DeepSeek. Hãy kiểm tra điều khoản tính phí của tuyến đã chọn cho thời điểm bạn dự định thực thi.
Ví dụ chi phí với số token cố định
Xem xét một yêu cầu tiêu thụ 100,000 token đầu vào không bộ đệm và sinh 10,000 token đầu ra.
Nếu đó là tổng số token được tính phí hoàn chỉnh, chi phí token là $0.150 cho Terra, $0.021 cho DeepSeek off-peak, hoặc $0.042 cho DeepSeek vào giờ cao điểm. Mức giảm off-peak là 86%. Ví dụ này loại trừ phí công cụ bổ sung, hạ tầng và thử lại; mọi token lập luận được tính riêng (nếu có) cũng phải đưa vào tính toán.
Theo mức cơ bản đã liệt kê của CometAPI, cùng 100,000 đầu vào và 10,000 đầu ra có chi phí $0.120 cho Terra hoặc $0.0168 cho Flash. Áp dụng hệ số 2× giờ cao điểm đã liệt kê cho Flash cho ra $0.0336. Đây là các phép tính chỉ dựa trên token với số đếm đã nêu, không phải đo lường của một tác vụ thực tế.
Khi đầu ra bổ sung xóa lợi thế giá theo token
Giữ đầu vào không bộ đệm ở 100,000 token và tổng đầu ra tính phí của Terra ở 10,000 token. Hóa đơn token chuẩn của Terra khi đó là $0.150. Flash đạt cùng hóa đơn ở 225,000 token đầu ra tính phí trong off-peak, hoặc 100,000 trong giờ cao điểm. Phép tính này cô lập khối lượng đầu ra; bộ đệm, đầu vào lặp lại, phí công cụ và thử lại sẽ làm thay đổi so sánh.
Chi phí cho mỗi tác vụ thành công
Đánh giá một lô tác vụ cố định và chia tổng chi tiêu API và công cụ cho số tác vụ vượt qua kiểm tra chấp nhận. Tính cả chi tiêu cho các lần thử thất bại. Báo cáo tỷ lệ thành công bên cạnh chi phí này để một mô hình không được “thưởng” chỉ vì chỉ hoàn thành các công việc dễ.
Chi phí cho mỗi tác vụ thành công = Tổng chi phí API và công cụ / Số tác vụ hoàn thành thành công
Nên chọn GPT-6.1 Terra hay DeepSeek-V4.1-Flash?
Hãy chọn theo yêu cầu chất lượng, mục tiêu chi phí và nhu cầu triển khai của tác vụ. Sử dụng kết quả benchmark ở trên để quyết định mô hình nào nên thử trước.
Trường hợp sử dụng
Ứng viên khởi đầu
Tiêu chí quyết định lựa chọn
Lập luận đòi hỏi cao
GPT-6.1 Terra
Độ chính xác và công việc hiệu chỉnh trên các tác vụ khó đại diện
Tác nhân lập trình
Thử cả hai
Bản vá được chấp nhận, kiểm thử hồi quy, lỗi công cụ và tổng chi phí
Quy trình thị giác phức tạp
GPT-6.1 Terra
Quy trình hoàn tất và phục hồi sau lỗi giao diện
Trích xuất văn bản/hình ảnh khối lượng lớn
DeepSeek Flash-1017
Việc đạt ngưỡng độ chính xác trích xuất yêu cầu
Truy xuất tài liệu dài
Thử cả hai
Truy xuất chứng cứ và độ chính xác câu trả lời trên các vị trí nhập
Tự lưu trữ
DeepSeek Flash-1017
Phần cứng sẵn có, chi phí vận hành và quyền kiểm soát trọng số
Ứng dụng tương tác
Thử cả hai
Độ trễ trung vị và ở đuôi trên tuyến nhà cung cấp đã chọn
Khi nào chọn GPT-6.1 Terra
Ưu tiên đánh giá Terra khi lập luận phức tạp là trung tâm của tác vụ. Với quy trình thị giác hoặc sử dụng máy tính đòi hỏi, hãy đưa Terra vào bộ thử nghiệm và đo số quy trình hoàn tất, số lỗi và khả năng phục hồi.
Câu hỏi then chốt là liệu Terra có giảm số lần thất bại và chỉnh sửa thủ công đủ để biện minh cho giá token cao hơn hay không.
Khi nào chọn DeepSeek-V4.1-Flash
Bắt đầu với DeepSeek-V4.1-Flash cho các tác vụ lặp lại, khối lượng lớn, có tiêu chí chấp nhận rõ ràng và mục tiêu chi phí chặt chẽ. Chọn nếu đầu ra đáp ứng yêu cầu chất lượng với chi phí mỗi tác vụ thành công thấp hơn.
Trọng số với giấy phép MIT của DeepSeek cũng khiến nó là lựa chọn phù hợp khi yêu cầu tự lưu trữ. Hãy tính cả chi phí phần cứng và vận hành trong quyết định đó.
Khi nào nên thử cả hai mô hình
Hãy thử cả hai khi chất lượng lập trình, độ tin cậy của công cụ, độ trễ hoặc độ chính xác ngữ cảnh dài là quan trọng. Dùng tác vụ đại diện với cùng đầu vào, công cụ, giới hạn thực thi và tiêu chí chấp nhận.
So sánh tỷ lệ hoàn tất thành công, tổng chi phí cho mỗi tác vụ thành công, độ trễ đầu-cuối và thời gian chỉnh sửa thủ công. Ghi lại phiên bản mô hình và cài đặt lập luận để có thể tái lập kết quả.
Một thiết lập lai có thể bắt đầu tác vụ thường lệ bằng DeepSeek và leo thang các trường hợp thất bại đã chọn sang Terra. Đo chi phí và tỷ lệ hoàn tất của toàn bộ quy trình để xác nhận cuộc gọi thêm mô hình là đáng giá.
Truy cập GPT-6.1 Terra và DeepSeek V4.1 Flash ở đâu?
Sử dụng API lưu trữ của OpenAI cho Terra hoặc API lưu trữ của DeepSeek cho Flash. Xác nhận định danh mô hình hiện tại, giới hạn tài khoản và endpoint được hỗ trợ trước khi tích hợp. Trọng số tải về của Flash-1017 cung cấp lựa chọn tự lưu trữ riêng.
Truy cập qua CometAPI
CometAPI cung cấp giao diện tương thích OpenAI giúp đơn giản hóa phát triển ứng dụng đa mô hình.
Sử dụng GPT-6.1 Terra API và DeepSeek V4.1 Flash API với một client văn bản dùng chung, sau đó chỉ thêm điều khiển đặc thù mô hình sau khi kiểm tra hỗ trợ của tuyến.
So sánh phản hồi văn bản qua CometAPI
Để thử cả hai mô hình qua một client văn bản, sử dụng OpenAI Python SDK với khóa CometAPI của bạn và endpoint https://api.cometapi.com/v1. Lưu khóa trong biến môi trường, sau đó gửi cùng prompt tới các tuyến gpt-6.1-terra và deepseek-v4.1-flash rồi so sánh câu trả lời và mức dùng token trả về.
Ví dụ, yêu cầu mỗi mô hình rà soát một quy trình thanh toán thử lại các yêu cầu hết thời gian chờ mà không có khóa idempotency và ghi log toàn bộ nội dung yêu cầu. So sánh mức độ rõ ràng khi câu trả lời nêu rủi ro về độ tin cậy và quyền riêng tư, cùng cách giải pháp thực tiễn. Một prompt dùng chung giúp phản hồi dễ kiểm tra hơn, nhưng một yêu cầu văn bản mặc định không đồng nhất ngân sách lập luận hay thiết lập xếp hạng hiệu năng. Hãy xác nhận checkpoint được phục vụ bởi mỗi tuyến trước khi coi kết quả là bằng chứng về Flash-1017.
Kết luận
GPT-6.1 Terra hiện cho kết quả lập luận tổng hợp mạnh hơn, trong khi DeepSeek Flash-1017 kết hợp giá token thấp hơn, tốc độ sinh đầu ra đo được nhanh hơn và triển khai trọng số mở. Lựa chọn hữu ích là mô hình đáp ứng yêu cầu chất lượng và độ trễ với chi phí tổng thấp nhất.
Hãy bắt đầu với khối lượng công việc đại diện, giữ nguyên môi trường công cụ và tiêu chí chấp nhận, rồi so sánh chi phí cho các lần hoàn tất thành công. Tích hợp văn bản dùng chung qua CometAPI có thể giúp việc đánh giá dễ dàng hơn, trong khi các tính năng đặc thù mô hình vẫn cần cấu hình riêng.
Câu hỏi thường gặp
Tại sao cùng một tác vụ có thể tạo hóa đơn token khác nhau giữa Terra và Flash-1017?
Một prompt văn bản không nhất thiết trở thành cùng số token ở hai mô hình. Câu trả lời sinh ra và độ dài lập luận cũng có thể khác. Hãy so sánh mức dùng được báo cáo bởi mỗi tuyến cho các tác vụ giống hệt nhau, bao gồm token lập luận có bộ đệm và tính phí (nếu có), thay vì áp cả hai bảng giá lên một số token ước tính.
GPT-6.1 Terra và DeepSeek V4.1 Flash có thể chia sẻ bộ đệm prompt không?
Bạn có thể tái sử dụng văn bản prompt trong ứng dụng, nhưng đừng giả định một bộ đệm tạo cho một mô hình hay nhà cung cấp sẽ giảm hóa đơn của bên kia. Điều kiện đủ điều kiện bộ đệm và cách hạch toán là theo từng tuyến. Kiểm tra trường usage trong mỗi phản hồi và thử các yêu cầu lặp lại trước khi xây dựng khoản tiết kiệm vào dự báo.
Tôi nên xác thực đầu ra có cấu trúc từ Terra và Flash-1017 như thế nào?
Xác định trước các trường và kiểu dữ liệu yêu cầu trong ứng dụng rồi mới chọn mô hình. Nếu một tuyến cung cấp chế độ JSON hoặc đầu ra ràng buộc theo schema, hãy xác minh chính xác chế độ nó hỗ trợ, sau đó phân tích và xác thực phản hồi theo schema của bạn. Xem thiếu trường, giá trị không hợp lệ, đầu ra bị cắt và từ chối như các kết quả riêng. JSON hợp lệ không đồng nghĩa các dữ kiện được trích xuất là chính xác.