Xây dựng với CometAPICần một API cho nhiều mô hình?Kiểm thử quy trình trong Playground, sau đó tạo API key khi mô hình và chi phí phù hợp với trường hợp sử dụng của bạn.
GPT-6.1 Terra so với GPT-6.1 Sol: Điểm chuẩn, giá cả và nên chọn phiên bản nào
So sánh GPT-6.1 Terra và GPT-6.1 Sol về các điểm chuẩn chính thức, khả năng suy luận, giá API và khối lượng công việc thực tế, kèm một ví dụ Python sử dụng CometAPI.
lesileĐội ngũ nghiên cứu mô hình AI và API
Đã cập nhật Oct 28, 2026 18 phút đọc
Câu trả lời trước
So sánh GPT-6.1 Terra và GPT-6.1 Sol về các điểm chuẩn chính thức, khả năng suy luận, giá API và khối lượng công việc thực tế, kèm một ví dụ Python sử dụng CometAPI.
Dùng phần tóm tắt này để nhận câu trả lời nhanh, sau đó đọc hướng dẫn để hiểu thêm ngữ cảnh, ví dụ và chi tiết triển khai.
Bắt đầu với GPT-6.1 Terra cho các tác vụ khối lượng lớn, có thể kiểm chứng và nhạy về chi phí. Đánh giá GPT-6.1 Sol cho lập trình phức tạp, dùng công cụ nhiều bước và các luồng công việc mà thất bại gây tốn kém. Mặc định thực tiễn là dùng Terra trước và nâng cấp lên Sol khi các bài test hoặc kiểm tra xác thực được định trước thất bại.
Key Takeaways
Đơn giá token tiêu chuẩn: Trên OpenAI Standard, Terra có giá $1 cho mỗi triệu token đầu vào và $5 cho mỗi triệu token đầu ra; Sol lần lượt là $2 và $10.
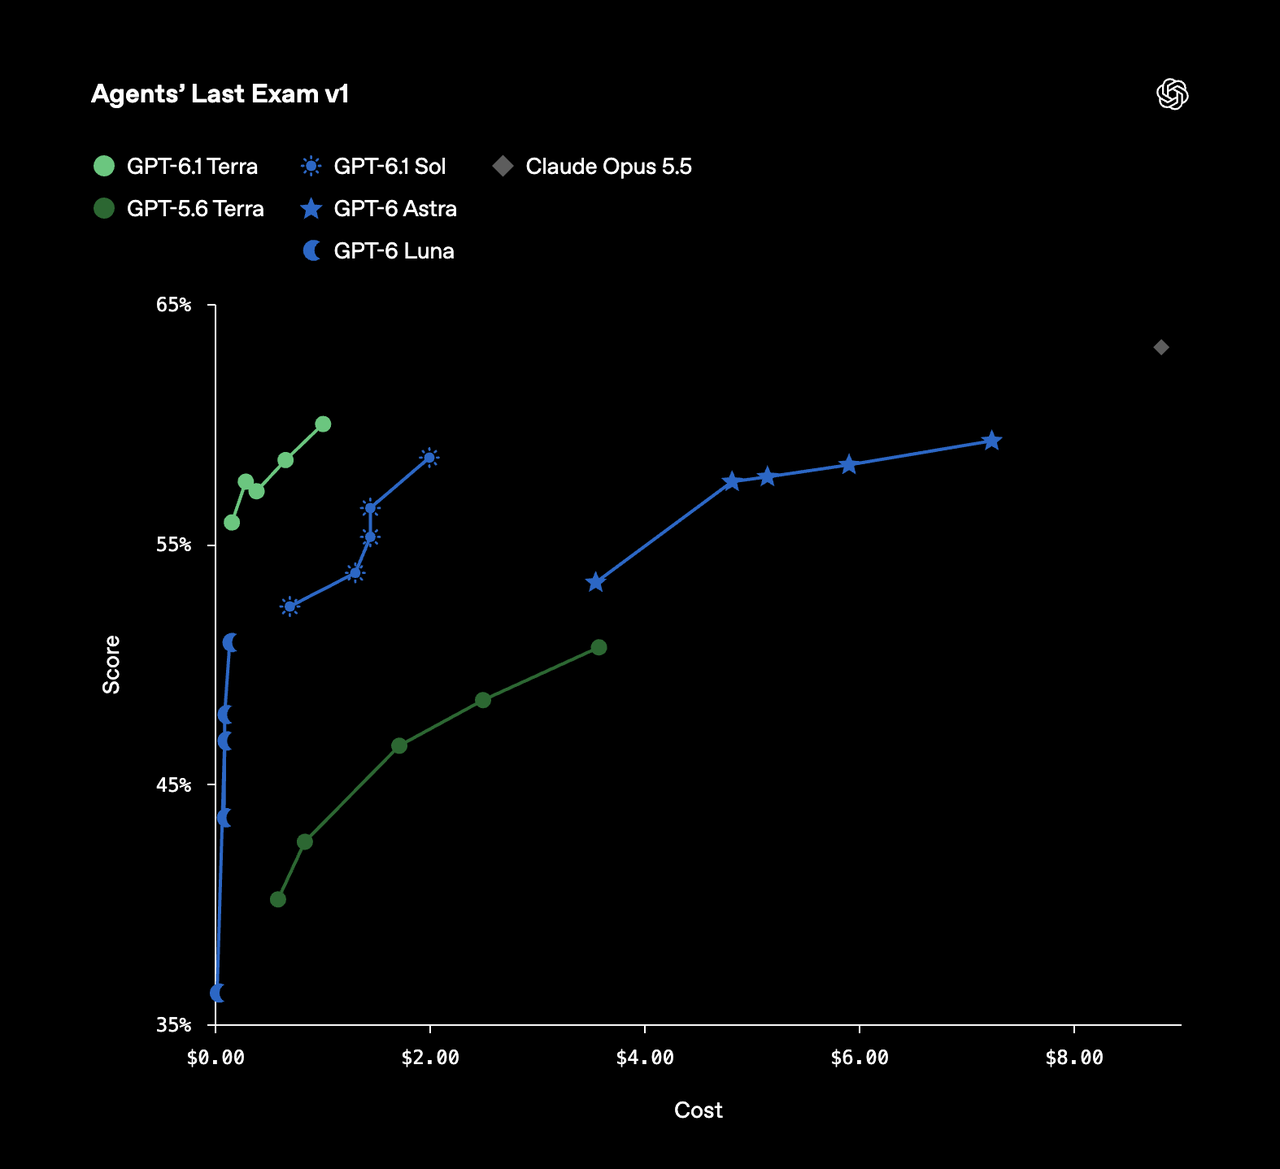
Hiệu năng theo tác vụ: Ở mức nỗ lực lập luận tối đa, Terra nhỉnh hơn một chút trên Agents’ Last Exam v1 và Terminal-Bench-Science 0.1, trong khi Sol dẫn trước trên Terminal-Bench 4.0 và OSWorld 2.1.
Dung lượng ngữ cảnh dùng chung: Cả hai mô hình đều cung cấp cửa sổ ngữ cảnh 1,05 triệu token và chấp nhận đầu vào văn bản và hình ảnh.
Điều khiển lập luận khác nhau: Terra hỗ trợ tắt lập luận với ; Sol yêu cầu ít nhất mức lập luận .
Đã được xem xét về độ rõ ràng, ghi nguồn và thuật ngữ API hiện tại.
none
low
Chi phí vận hành quan trọng: So sánh chi tiêu cho mỗi tác vụ hoàn thành thành công, bao gồm thử lại và gọi công cụ, và theo dõi chi phí kiểm duyệt của con người riêng biệt.
GPT-6.1 Terra vs GPT-6.1 Sol: Tổng quan và thông số kỹ thuật
Bảng tổng quan dưới đây tóm tắt các đánh đổi. Các phần chi tiết giải thích bằng chứng, giả định tính phí và giới hạn đằng sau mỗi lựa chọn.
GPT-6.1 Terra: Luồng công việc thị giác và tác tử hiệu quả
OpenAI giới thiệu GPT-6.1 Terra vào ngày 26 tháng 10, 2026. Nó kết hợp lập luận thị giác, sử dụng máy tính và sinh văn bản đa dụng cho các luồng công việc chuyên nghiệp thường xuyên. Mức giá token thấp hơn khiến nó hữu ích làm điểm khởi đầu khi tác vụ diễn ra thường xuyên và kết quả có thể kiểm chứng.
GPT-6.1 Sol: Lập trình phức tạp và lập luận chuyên nghiệp
GPT-6.1 Sol ra mắt ngày 29 tháng 9, 2026. Nó nhắm tới công việc lập trình và chuyên môn đòi hỏi cao. Hãy đánh giá khi một kho mã lạ, chuỗi hành động phụ thuộc dài, hoặc chi phí sửa sai đắt đỏ khiến năng lực lập luận bổ sung trở nên giá trị.
Ngữ cảnh, lập luận và thông số API
API features: Cả hai mô hình hỗ trợ Đầu ra có cấu trúc, streaming và Batch API. Gọi công cụ sử dụng Responses API, và không hỗ trợ fine-tuning. Hãy kiểm tra nhà cung cấp và endpoint bạn chọn có cung cấp các tính năng ứng dụng của bạn cần hay không.
Cả hai mô hình cho phép tối đa 128.000 token đầu ra trong một cửa sổ ngữ cảnh 1.050.000 token. Dành trọn mức cho phép đầu ra để lại 922.000 token cho phần còn lại của phiên trao đổi, bao gồm đầu vào của bạn, hướng dẫn hệ thống và lịch sử công cụ. Đây là phép tính lập kế hoạch, không phải một giới hạn đầu vào cố định riêng.
Architecture disclosure: Các thông số mô hình công khai được liên kết không cung cấp đủ chi tiết kiến trúc nội bộ để so sánh đáng tin cậy. Dung lượng ngữ cảnh và thiết lập lập luận không nên được xem là bằng chứng về số tham số hay kiến trúc.
Reasoning controls: Thiết lập none của Terra hữu ích cho các biến đổi và trích xuất đơn giản. Cho so sánh đầu tiên, hãy dùng cùng một mức lập luận được hỗ trợ trên cả hai mô hình, rồi tinh chỉnh từng mô hình theo chất lượng và độ trễ mà khối lượng công việc của bạn yêu cầu.
Cả hai mô hình có cùng dung lượng ngữ cảnh công bố, nhưng điều đó không hàm ý độ chính xác truy hồi hay chất lượng lập luận ngữ cảnh dài giống nhau. Do đó, chọn mô hình nên cân nhắc chất lượng lập luận, hiệu quả luồng công việc, chi phí và hiệu năng truy hồi theo tác vụ cụ thể.
GPT-6.1 Terra vs GPT-6.1 Sol: Hiệu năng
Các kết quả báo cáo cho thấy bức tranh pha trộn: Terra nhỉnh hơn chút ở một số đánh giá tác tử và lập trình khoa học, trong khi Sol đạt điểm cao hơn ở lập trình terminal tổng quát, tự động hóa desktop và thị giác. Các so sánh dưới đây tách kết quả ra mắt của OpenAI khỏi các đánh giá độc lập và giải thích những gì mỗi loại có — và không — cho bạn biết về hiệu năng sản xuất.
Kết quả benchmark chính thức và điều kiện thử nghiệm
Các kết quả sau đến từ đánh giá ra mắt Terra của OpenAI. Terra được hiển thị ở mức lập luận medium và tối đa; Sol được hiển thị ở mức tối đa. Cột cuối chỉ so sánh các cấu hình nỗ lực tối đa.
OSWorld sử dụng đánh giá offline 2.1. Bài kiểm tra tính xác thực sử dụng prompt nội bộ của OpenAI được thiết kế để gây lỗi. Đây là kết quả do nhà cung cấp báo cáo từ các thiết lập đánh giá cụ thể, không phải phép đo khối lượng công việc sản xuất của bạn.
Tất cả điểm đều là phần trăm; chênh lệch được biểu diễn bằng điểm phần trăm (pp). Chỉ riêng tỷ lệ sai sự thật là càng thấp càng tốt. Chênh 0,1 điểm ở tỷ lệ sai sự thật tự thân không thiết lập lợi thế độ tin cậy có ý nghĩa.
Đối với kỹ nghệ phần mềm, lợi thế ở Terminal-Bench của Sol và lợi thế sát sao ở Terminal-Bench-Science của Terra gợi ý rằng kết quả phụ thuộc vào loại tác vụ lập trình. Với luồng ứng dụng, điểm OSWorld cao hơn của Sol ủng hộ việc đánh giá nó cho tự động hóa desktop, trong khi kết quả Agents’ Last Exam của Terra biến nó thành ứng viên cho tác vụ tác tử chuyên nghiệp. Không mẫu nào thiết lập một người thắng cuộc tuyệt đối.
Giàn dựng agent, quyền truy cập công cụ và cấu hình môi trường có thể ảnh hưởng các kết quả này. Dùng các con số để xác định ứng viên cho thử nghiệm, sau đó xác thực chúng với thay đổi kho mã và luồng ứng dụng mà bạn thực sự cần hoàn thành.
Biểu đồ Agents’ Last Exam v1 của OpenAI vẽ điểm so với chi phí tác vụ ước tính trên các cấu hình mô hình. Nó bổ sung góc nhìn hiệu quả chi phí cho bảng điểm ở trên; các chi phí được vẽ là cụ thể cho thiết lập đánh giá.
Đánh giá độc lập về trí tuệ và lập trình
Đánh giá ngày 26 tháng 10 của Artificial Analysis đặt Terra thấp hơn Sol bốn điểm trên Intelligence Index ở mức nỗ lực lập luận tối đa. Coding Agent Index v2.0 chấm Terra 48 và Sol 54. Đây là các đánh giá riêng với phương pháp và thang điểm riêng; không nên cộng gộp số liệu với kết quả benchmark của OpenAI.
Phân tích tương tự xác định các mức lập luận thấp và trung bình của Terra đặc biệt hiệu quả về chi phí trên đánh giá trí tuệ. Điều này ủng hộ việc thử nghiệm các cấu hình thực tiễn song song với thiết lập nỗ lực tối đa. Chi phí đánh giá vẫn cụ thể cho thiết lập thử nghiệm và không nên được xem là ước tính chi tiêu của ứng dụng bạn.
Tốc độ và độ trễ: Hoàn thành tác vụ so với tạo token
OpenAI báo cáo rằng Terra hoàn thành các tác vụ Agents’ Last Exam được đánh giá nhanh hơn Sol hơn ba lần. Đây là phép đo tác vụ từ đầu đến cuối bao gồm lập luận và tương tác phần mềm. Nó không hàm ý thông lượng token đầu ra cao gấp ba hay cùng mức tăng tốc cho mọi yêu cầu API.
Với ứng dụng tương tác, phân biệt thời gian đến token đầu tiên, đo thời gian chờ trước khi đầu ra bắt đầu, với số token đầu ra mỗi giây, đo tốc độ câu trả lời tiếp diễn. Với agent, hãy ưu tiên thời gian hoàn thành từ đầu đến cuối, bao gồm gọi công cụ, thử lại và phục hồi.
So sánh cả hai mô hình bằng cùng prompt, công cụ, mức lập luận được hỗ trợ và tiêu chí chấp nhận. Ghi nhận độ trễ cùng với thành công tác vụ: phản hồi nhanh hơn có giá trị hạn chế nếu cần sửa nhiều hoặc không hoàn tất luồng công việc.
Thị giác và hiệu năng ngữ cảnh dài: Những gì kết quả thiết lập
Lợi thế 0,8 điểm phần trăm của Sol trên MMMU-Pro ở nỗ lực tối đa là một kết quả thị giác được báo cáo, chứ không phải đảm bảo hiệu năng tốt hơn trên mọi luồng thị giác. Hãy thử nghiệm nhãn nhỏ, bản quét kém, sơ đồ dày đặc và bố cục lạ với đầu vào đại diện.
Các đánh giá trên không thiết lập mô hình nào tốt hơn ở truy hồi ngữ cảnh dài hay lập luận. Dù cả hai có cùng dung lượng ngữ cảnh công bố, chỉ dung lượng không chứng minh độ chính xác truy hồi hay khả năng ghi nhớ qua phiên. Hãy kiểm tra liệu mỗi mô hình có thể tìm và sử dụng bằng chứng phù hợp trong tài liệu của bạn, và duy trì trạng thái ứng dụng một cách tường minh qua các yêu cầu.
GPT-6.1 Terra vs GPT-6.1 Sol: Chi phí
Giá token là điểm khởi đầu để so sánh chi phí. Thử lại, token lập luận, gọi công cụ và kiểm duyệt của con người cũng ảnh hưởng số tiền bạn chi để hoàn thành tác vụ thành công.
Các mức sau là USD cho mỗi triệu token và bảng giá.
Giá API OpenAI
Mức Standard niêm yết của Terra bằng một nửa Sol trên các hạng mục này. Chi phí thực tế phụ thuộc cấu hình yêu cầu: yêu cầu ngữ cảnh dài, tầng xử lý, xử lý theo khu vực và sử dụng công cụ có thể có điều khoản khác. Hãy kiểm tra tài liệu giá của OpenAI áp dụng trước khi ước tính chi phí sản xuất.
Giá CometAPI
CometAPI là tuyến truy cập bên thứ ba với giá và khả dụng tính năng riêng. Mức giá đầu vào và đầu ra thường được liệt kê của nó được hiển thị riêng bên dưới.
Ở các mức này, giá đầu vào và đầu ra thường của CometAPI thấp hơn 20% so với mức OpenAI Standard ở trên. Xác nhận giá hiện tại, phí ngữ cảnh dài, hỗ trợ cache và khả dụng công cụ cho tài khoản của bạn trước khi triển khai.
Ví dụ chi phí cho 1,000 yêu cầu
Giả sử một ứng dụng thực hiện 1,000 yêu cầu, mỗi yêu cầu dùng 2,000 token đầu vào không cache và 500 token đầu ra tính phí. Điều này tạo tổng 2 triệu token đầu vào và 500,000 token đầu ra.
Với 1,000 yêu cầu, mỗi yêu cầu dùng 2,000 token đầu vào không cache và 500 token đầu ra tính phí, chi phí ước tính là:
Terra qua OpenAI: $2.00 cho đầu vào và $2.50 cho đầu ra, tổng cộng $4.50.
Sol qua OpenAI: $4.00 cho đầu vào và $5.00 cho đầu ra, tổng cộng $9.00.
Terra qua CometAPI: $1.60 cho đầu vào và $2.00 cho đầu ra, tổng cộng $3.60.
Sol qua CometAPI: $3.20 cho đầu vào và $4.00 cho đầu ra, tổng cộng $7.20.
Các phép tính này sử dụng mức giá thường liệt kê ở trên, không có chiết khấu Batch API. Chúng không bao gồm ghi cache, phí công cụ riêng và thử lại. Bất kỳ token lập luận nào được tính vào đầu ra phải được bao gồm trong tổng đầu ra.
Chi phí hiệu dụng trên mỗi tác vụ thành công
Trong bài viết này, một tác vụ thành công là tác vụ vượt qua các tiêu chí chất lượng, schema khi áp dụng và kiểm tra hoàn thành được định trước mà không cần sửa của con người.
Giá token thấp hơn không phải lúc nào cũng tạo chi phí vận hành thấp hơn. Khoản tiết kiệm của Terra có thể thu hẹp nếu nó cần nhiều lần thử, token lập luận hoặc can thiệp của con người hơn. Mức giá cao hơn của Sol có thể xứng đáng nếu nó hoàn thành nhiều tác vụ hơn ngay từ lần đầu.
Effective model-and-tool cost per successful task = tổng chi tiêu mô hình và công cụ trên tất cả lần thử ÷ số tác vụ thành công.
Theo dõi chi phí kiểm duyệt và sửa của con người riêng biệt. Chọn mô hình đạt mục tiêu chất lượng với chi phí kết hợp thấp nhất, thay vì chỉ so sánh giá token.
Nên chọn mô hình nào: GPT-6.1 Terra hay GPT-6.1 Sol?
Hãy chọn dựa trên độ phức tạp tác vụ, chất lượng đầu ra có thể kiểm chứng và chi phí hoàn thành tổng thể. Terra hữu ích làm điểm khởi đầu cho luồng công việc thường lệ; Sol đáng để đánh giá khi lập luận khó hoặc thất bại tốn kém biện minh cho chi tiêu bổ sung.
Khi nào nên chọn GPT-6.1 Terra
Bắt đầu với Terra cho trích xuất khối lượng lớn, soạn thảo tài liệu, đối sánh danh mục và các luồng ứng dụng dự đoán được. Các tác vụ này là ứng viên tốt khi có thể kiểm tra kết quả so với tài liệu nguồn, trường bắt buộc hoặc quy tắc xác thực tự động.
Chọn Terra khi nó đáp ứng mục tiêu độ chính xác và hoàn thành trong phạm vi ngân sách thử lại và kiểm duyệt. Mức giá token thấp không có lợi nếu thất bại lặp lại xóa sạch khoản tiết kiệm.
Khi nào nên chọn GPT-6.1 Sol
Đánh giá Sol cho gỡ lỗi khó, thay đổi kho mã có nhiều phụ thuộc và luồng desktop với chuỗi hành động phụ thuộc dài.
Chọn Sol khi thử nghiệm cho thấy nó tạo nhiều bản vá được chấp nhận hơn, vượt qua nhiều test hơn hoặc cần ít sửa thủ công hơn. Chi phí token cao hơn được biện minh khi các cải thiện đó giảm chi phí tổng để hoàn thành công việc.
Khi nào dùng Terra trước và nâng cấp lên Sol
Một luồng lai có thể dùng Terra cho lần thử đầu và nâng cấp lên Sol khi các kiểm tra định trước thất bại. Căn cứ nâng cấp trên kết quả quan sát được thay vì chỉ dựa vào độ tự tin của mô hình.
Ví dụ, một luồng tạo mã có thể:
Yêu cầu Terra tạo thay đổi được đề xuất.
Chạy các test và kiểm tra xác thực liên quan.
Nâng cấp lên Sol nếu thay đổi không vượt qua các kiểm tra đó hoặc vượt ngoài khả năng đã kiểm chứng của Terra.
Gửi các trường hợp chưa giải quyết cho con người xem xét khi ngân sách thử lại đã cạn.
Khi nâng cấp, bảo toàn yêu cầu gốc, ngữ cảnh liên quan, đầu ra thất bại và kết quả xác thực. Ghi nhận mức sử dụng của cả hai mô hình để so sánh chi phí bao gồm toàn bộ luồng công việc.
Danh sách kiểm tra đánh giá triển khai
Trước khi chọn mô hình mặc định hoặc triển khai luồng nâng cấp:
Sử dụng tác vụ đại diện: Bao gồm yêu cầu thường lệ và các trường hợp mà thất bại gây tốn kém.
Giữ so sánh có kiểm soát: Dùng hướng dẫn, bằng chứng, công cụ và tiêu chí chấp nhận tương đương. Ghi lại ID mô hình, endpoint, thiết lập lập luận và ngày test.
Đo kết quả được chấp nhận: Kiểm tra độ chính xác, tính hợp lệ schema khi áp dụng, kết quả test và hoàn thành không cần sửa thủ công.
Đo thời gian và chi tiêu: Theo dõi độ trễ trung vị và đuôi, token tính phí, số lần gọi công cụ, thử lại và nỗ lực kiểm duyệt của con người.
Lặp lại so sánh: Chạy tác vụ nhiều lần và hoán đổi thứ tự mô hình để giảm ảnh hưởng của kết quả ngẫu nhiên.
Định nghĩa giới hạn vận hành: Đặt ngân sách thử lại, ngưỡng kích hoạt nâng cấp và yêu cầu phê duyệt của con người trước khi triển khai.
So sánh toàn bộ luồng: Bao gồm lần thử không thành công và chi phí nâng cấp khi tính chi tiêu cho mỗi tác vụ thành công.
Bạn có thể truy cập GPT-6.1 Terra và GPT-6.1 Sol ở đâu?
Truy cập từ nhà cung cấp chính thức
Cả hai mô hình đều khả dụng qua OpenAI API. Với yêu cầu văn bản, hỗ trợ Chat Completions; gọi công cụ yêu cầu Responses API. Xác nhận tham số được hỗ trợ của mô hình, giới hạn tài khoản của bạn và công cụ khả dụng trên tuyến bạn định dùng.
Truy cập qua CometAPI
Để dùng bất kỳ mô hình nào qua CometAPI, hãy làm theo hướng dẫn bắt đầu nhanh để thiết lập SDK tương thích OpenAI. Cung cấp khóa CometAPI của bạn một cách an toàn qua biến môi trường COMETAPI_KEY và đặt base URL thành https://api.cometapi.com/v1. Chọn gpt-6.1-terra hoặc gpt-6.1-sol làm định danh mô hình, và xác nhận tuyến này được bật cho tài khoản của bạn.
Cho lần so sánh đầu tiên, giao cho cả hai mô hình các tác vụ đại diện giống nhau và dùng mức nỗ lực lập luận medium. Giữ hướng dẫn và tiêu chí chấp nhận nhất quán, lặp lại mỗi tác vụ và hoán đổi thứ tự mô hình. So sánh kết quả thành công, thời gian trôi qua, token tính phí và số lần thử lại thay vì phán xét bất kỳ mô hình nào từ một phản hồi đơn lẻ.
Kết luận
Bắt đầu với GPT-6.1 Terra cho các luồng công việc thường xuyên, có thể kiểm chứng, nơi giá token thấp và thời gian hoàn thành nhanh quan trọng. Đánh giá GPT-6.1 Sol khi lập trình khó, dùng công cụ nhiều bước hoặc thất bại tốn kém khiến năng lực lập luận cao hơn trở nên giá trị. Quyết định cuối cùng nên dựa trên chi phí cho tác vụ được chấp nhận dưới bộ thử nghiệm đại diện, không dựa vào giá hay một benchmark đơn lẻ.
Với nhiều ứng dụng, bước tiếp theo hữu ích là một thử nghiệm nhỏ, có tính đại diện, với điều kiện đạt rõ ràng và tuyến nâng cấp có giới hạn. Hãy để kết quả đo lường quyết định mô hình, thay vì dựa trên giá hay một benchmark duy nhất.
Yếu tố quyết định
GPT-6.1 Terra
GPT-6.1 Sol
Khối lượng công việc ban đầu
Công việc thị giác thường lệ và tác tử có thể lặp
Lập trình phức tạp và lập luận chuyên nghiệp bền bỉ
Ngữ cảnh và phương thức
Cùng tổng dung lượng ngữ cảnh; đầu vào văn bản và hình ảnh
Cùng tổng dung lượng ngữ cảnh; đầu vào văn bản và hình ảnh
Điều khiển lập luận
Bao gồm tùy chọn tắt lập luận
Yêu cầu ít nhất mức lập luận thấp
Mẫu hiệu năng đã công bố
Hiệu năng chi phí thấp trên tác vụ tác tử lặp lại
Mạnh hơn ở nhiều bài test lập trình và tự động hóa desktop khó
Truy cập API
OpenAI và CometAPI
OpenAI và CometAPI
Thông số
GPT-6.1 Terra
GPT-6.1 Sol
Ngày phát hành chính thức
26 tháng 10, 2026
29 tháng 9, 2026
ID mô hình API
gpt-6.1-terra
gpt-6.1-sol
Cửa sổ ngữ cảnh
1.050.000 token
1.050.000 token
Mốc kiến thức
1 tháng 6, 2026
30 tháng 4, 2026
Đầu vào / đầu ra
Văn bản và hình ảnh / văn bản
Văn bản và hình ảnh / văn bản
Mức nỗ lực lập luận
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Mặc định mức lập luận
medium
medium
Benchmark
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
So sánh ở nỗ lực tối đa
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 pp
Tỷ lệ sai sự thật trên prompt khó
10.10%
4.30%
4.40%
Terra thấp hơn 0.1 pp
Nhà cung cấp và hạng mục token
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — đầu vào
$1.00
$2.00
OpenAI Standard — đầu vào được cache
$0.05
$0.10
OpenAI Standard — đầu ra
$5.00
$10.00
OpenAI Standard — ghi cache 30 phút
$1.25
$2.50
OpenAI Standard — ghi cache 12 giờ
$2.50
$5.00
CometAPI đầu vào thường
$0.80
$1.60
CometAPI đầu ra thường
$4.00
$8.00
GPT-6.1 Terra so với GPT-6.1 Sol: Điểm chuẩn, giá cả và nên chọn phiên bản nào - CometAPI