
TL;DR
Grok 4.7 và Xiaomi MiMo-V2.6 ra mắt cách nhau chỉ một ngày, nhưng đại diện cho hai cách tiếp cận khác nhau đối với AI tuyến đầu. Grok 4.7 nhấn mạnh ngăn xếp agent độc quyền, tích hợp chặt cho lập trình và công việc tri thức chuyên nghiệp, trong khi MiMo-V2.6-Pro kết hợp trọng số mở, cửa sổ ngữ cảnh lớn hơn, khả năng hiểu đa phương thức gốc và mức giá API cạnh tranh mạnh.
SpaceXAI định vị Grok 4.7 là mô hình tuyến đầu cho lập trình, tác vụ agent và công việc tri thức với cửa sổ ngữ cảnh 500K token và mức nỗ lực suy luận có thể cấu hình.
Xiaomi định vị MiMo-V2.6-Pro là flagship đa phương thức ngữ cảnh 1M với trọng số mở và hỗ trợ hiểu văn bản, hình ảnh, âm thanh và video.
Tóm lại: Grok 4.7 là sản phẩm agent được quản lý, tích hợp theo chiều dọc; MiMo-V2.6-Pro trao cho nhà phát triển nhiều quyền kiểm soát triển khai hơn và mức giá token thô thấp hơn nhiều. Phù hợp nhất phụ thuộc vào khối lượng công việc chứ không phải một điểm số benchmark.
Những điểm chính
- Grok 4.7 được xây dựng cho lập trình tầm dài và agent chuyên nghiệp. Trong đánh giá do SpaceXAI công bố, nó đạt 46,3% trên CursorBench 4.0, 71,0% trên DeepSWE v1.1 ở mức nỗ lực cao và 1.657 trên AA Briefcase v1.1.
- MiMo-V2.6-Pro có tính cạnh tranh khác thường đối với một mô hình mở. Xiaomi công bố trọng số mô hình và báo cáo kết quả tiệm cận các hệ thống độc quyền tuyến đầu trên một số benchmark lập trình và agent, nhưng điểm số giữa các nhà cung cấp không thể hoán đổi trực tiếp.
- MiMo có lợi thế về ngữ cảnh và đa phương thức. MiMo-V2.6-Pro hỗ trợ cửa sổ ngữ cảnh 1M token và hiểu văn bản, hình ảnh, âm thanh, video, trong khi Grok 4.7 là 500K ngữ cảnh với đầu vào văn bản và hình ảnh.
- MiMo rẻ hơn đáng kể về token API thô. Giá tiêu chuẩn chính thức là $0,435/$0,87 mỗi triệu token đầu vào/đầu ra chưa cache cho MiMo-V2.6-Pro so với $2/$6 cho Grok 4.7.
- Kiến trúc triển khai là điểm đánh đổi quyết định. Grok cung cấp ngăn xếp công cụ first-party mạnh hơn, được lưu trữ bởi nhà cung cấp; trọng số mở của MiMo cho phép triển khai riêng tư, phục vụ tùy biến và kiểm soát hạ tầng sâu hơn.
Grok 4.7 vs MiMo-V2.6-Pro — Tổng quan nhanh
| Dimension | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Release | September 21, 2026 | September 22, 2026 |
| Access and control | API độc quyền và hệ sinh thái agent được quản lý | Trọng số mở, tùy chọn tự lưu trữ và truy cập API |
| Performance evidence | Sức mạnh do nhà cung cấp báo cáo trong lập trình và tác vụ agent chạy lâu; xác thực trên cùng harness | Sức mạnh do nhà cung cấp báo cáo trên suy luận, lập trình và đa phương thức; xác thực trên cùng harness |
| Distinctive strengths | Công cụ first-party, quy trình được quản lý và agent kết nối web/X | Kiểm soát triển khai, ngữ cảnh 1M token và hiểu văn bản/hình ảnh/âm thanh/video |
| Context window | 500K tokens | 1M tokens |
| Input modalities | Văn bản và hình ảnh | Văn bản, hình ảnh, âm thanh và video |
| Official standard uncached input / output per 1M tokens | $2 / $6 | $0.435 / $0.87 |
| Reasoning | Low to xHigh | Deep reasoning |
| Open weights | No | No |
| Best fit | Quy trình lập trình và agent được quản lý | Triển khai riêng tư, đầu vào đa phương thức và chi phí token thô thấp hơn |
Grok 4.7 là gì?
SpaceXAI chính thức phát hành Grok 4.7 vào ngày 21 tháng 9, 2026 như mô hình mạnh nhất cho lập trình và công việc tri thức. Lần ra mắt này quan trọng vì các báo cáo trước phát hành đã trộn lẫn sự kiện xác nhận với các tuyên bố rò rỉ về kiến trúc. Tài liệu ra mắt cuối cùng không công bố tổng số hoặc số tham số hoạt động, vì vậy ước tính tham số trước phát hành không nên coi là thông số chính thức.
Theo bài ra mắt chính thức, Grok 4.7 sử dụng một mô hình nền mới, lớn hơn so với Grok 4.6 và được huấn luyện với một lượt học tăng cường dài hơn, thiên về các bài toán mất nhiều giờ để hoàn thành.
Các mô hình tối ưu hóa những lớp khác nhau của ngăn xếp. Grok 4.7 cung cấp một môi trường được quản lý phong phú hơn xung quanh mô hình; MiMo-V2.6-Pro phơi bày nhiều lớp mô hình và triển khai hơn cho nhà phát triển.
Đối với prompt trên 200K token, SpaceXAI áp dụng mức giá ngữ cảnh cao hơn. Bậc công bố là $4 mỗi triệu token đầu vào, $1 mỗi triệu token đầu vào đã cache và $12 mỗi triệu token đầu ra.
Những thay đổi trong Grok 4.7
Thay đổi ý nghĩa nhất là mục tiêu huấn luyện, không chỉ là số benchmark cao hơn. SpaceXAI nói rằng phối trộn học tăng cường đã chuyển về các tác vụ dài, nhiều giờ, trong khi mô hình được huấn luyện để tự kiểm chứng kỹ lưỡng hơn và hiểu native bộ khung Grok Bot. Sự kết hợp đó nhắm vào thực thi agent thực tế: duy trì trạng thái, dùng công cụ, kiểm tra kết quả trung gian và giữ mạch lạc trong các quỹ đạo tác vụ dài.
Hiệu năng Grok 4.7
| SpaceXAI-published benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0* | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
* SpaceXAI đánh dấu DeepSWE của Grok 4.7 là high effort. Đây là các đánh giá do nhà cung cấp công bố và nên được diễn giải theo harness và cài đặt suy luận đã tài liệu hóa.
SpaceXAI trình bày biểu đồ ra mắt dưới dạng nội dung web-native trên trang thông báo chính thức; bảng ở trên bảo toàn các giá trị benchmark đã công bố mà không vẽ lại biểu đồ.
Xiaomi MiMo-V2.6 là gì?
Xiaomi chính thức phát hành và mở nguồn MiMo-V2.6 vào ngày 22 tháng 9, 2026. Dòng này gồm MiMo-V2.6-Pro và MiMo-V2.6-Flash, với tùy chọn phục vụ Pro-UltraSpeed cho khối lượng công việc nhạy cảm độ trễ. Để so sánh trực tiếp với Grok 4.7, MiMo-V2.6-Pro là flagship tương xứng.
Tài liệu chính thức của Xiaomi tách bạch trọng số mở, đầu vào đa phương thức gốc và giá API. Sự kết hợp này khiến MiMo-V2.6 có ý nghĩa vượt ra ngoài bảng xếp hạng benchmark.
MiMo-V2.6 so với MiMo-V2.5: Có gì cải thiện?
Tựa đề kiến trúc không chỉ là một checkpoint lớn hơn. Bản phát hành công khai của Xiaomi tập trung mạnh vào hậu huấn luyện và Live RL. Theo ghi chú phát hành chính thức, Pro và Flash mỗi mô hình hoàn tất 30 bước học tăng cường và cùng tạo ra khoảng 750.000 quỹ đạo; chi phí giai đoạn RL được công bố xấp xỉ $2,62 triệu cho Pro và $850.000 cho Flash.
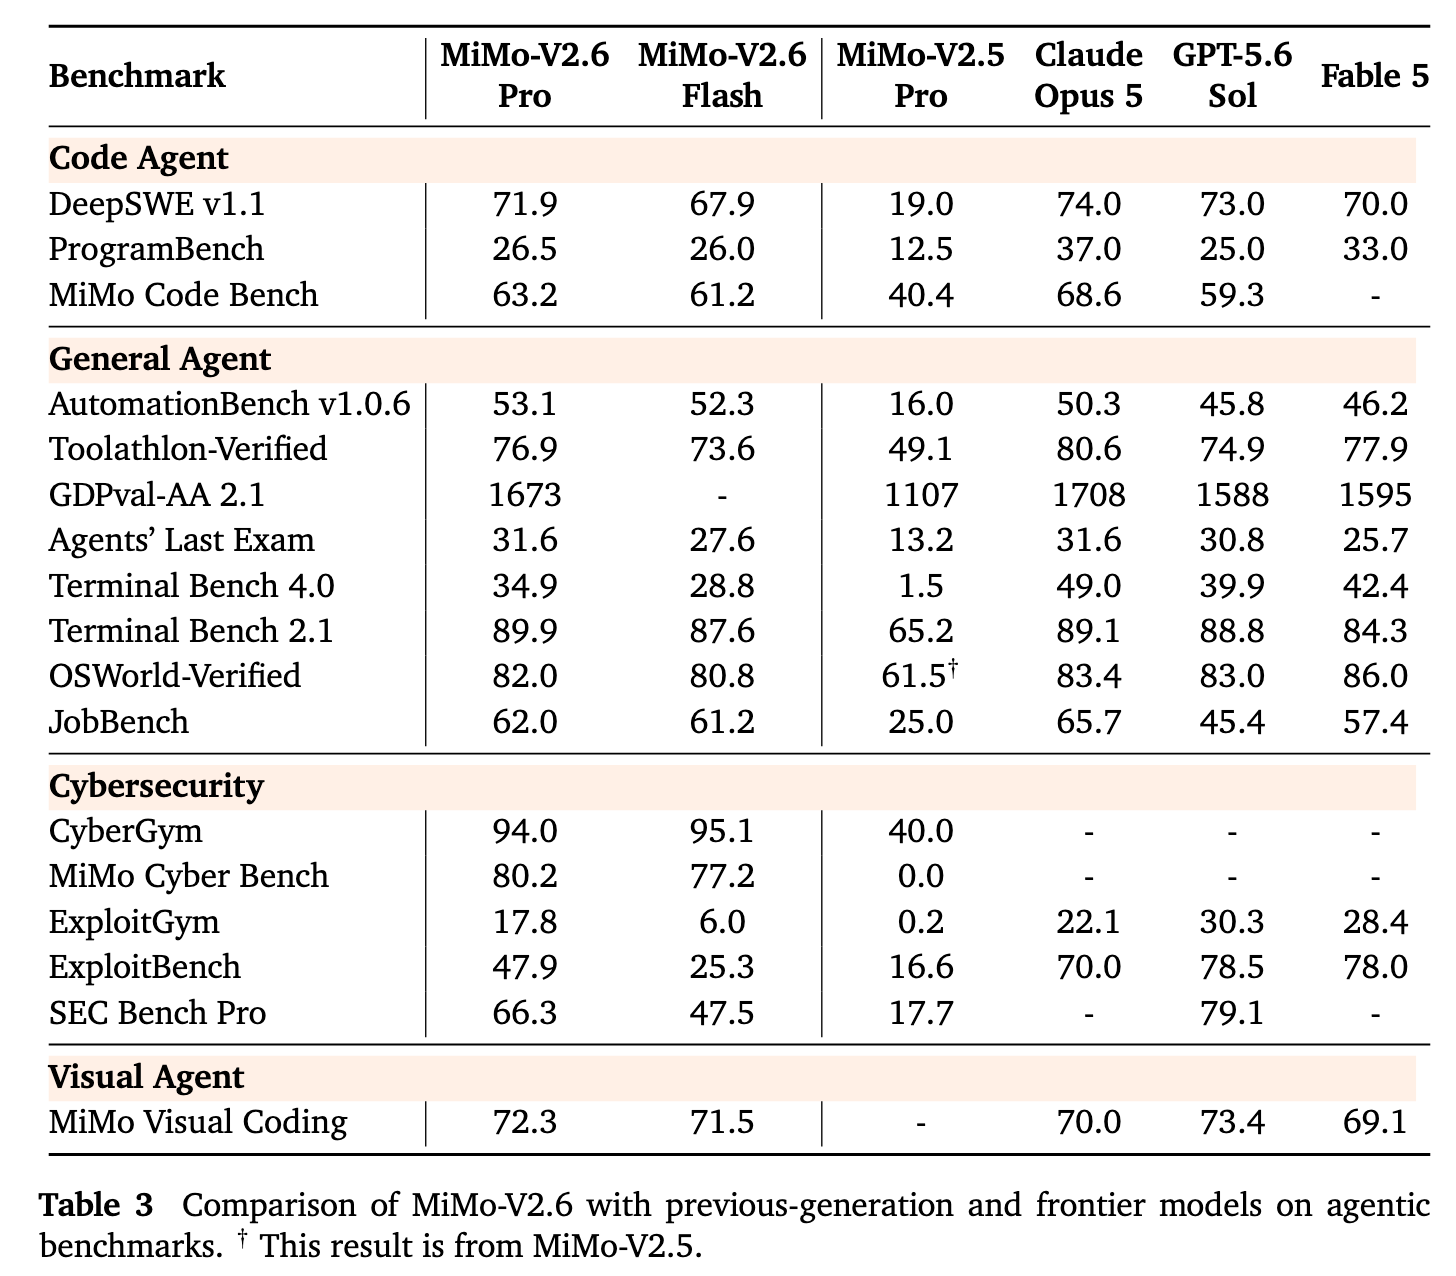
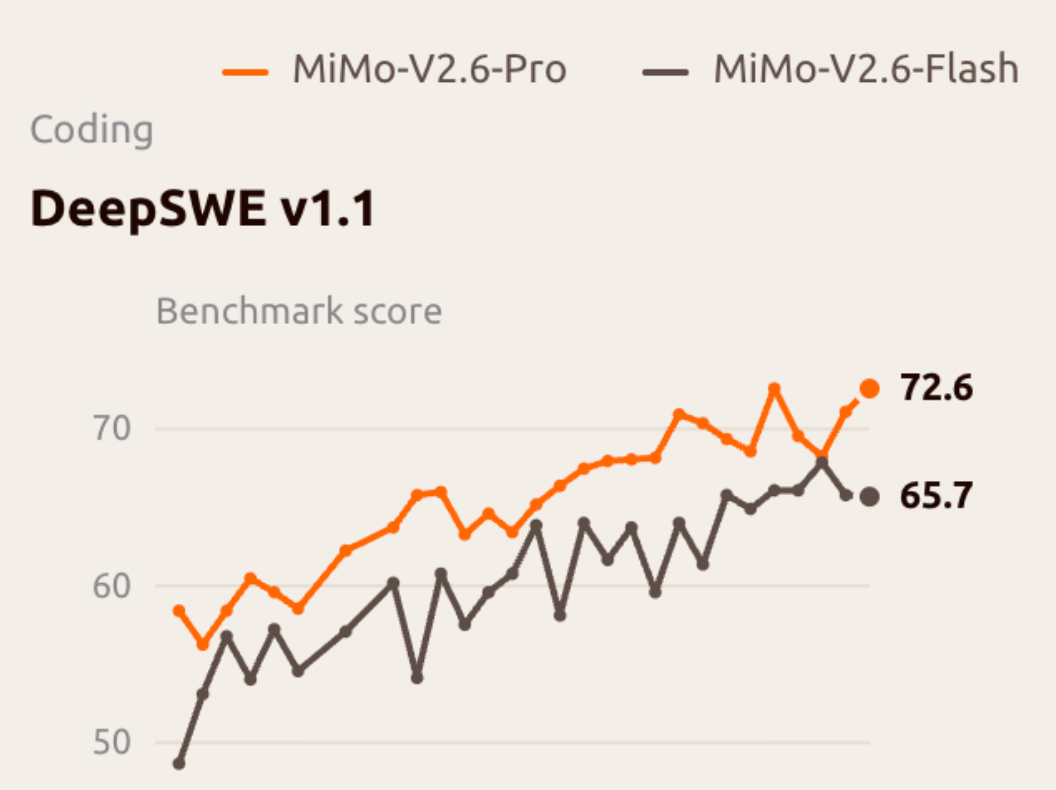
Một chi tiết benchmark cần xử lý cẩn trọng: đường cong Live RL của Xiaomi cho thấy MiMo-V2.6-Pro đạt khoảng 72,6 trên DeepSWE v1.1 trong quá trình huấn luyện, trong khi bảng so sánh cuối cùng báo cáo 71,9. Những con số này thuộc các ngữ cảnh đánh giá khác nhau và không nên trộn lẫn.
So sánh benchmark: Grok 4.7 vs MiMo-V2.6-Pro
So sánh benchmark trực tiếp cần thận trọng. Các nhà cung cấp không phải lúc nào cũng dùng cùng một harness, ngân sách suy luận, checkpoint hay cấu hình công cụ. Ngay cả khi tên benchmark trùng nhau, chênh lệch nhỏ có thể ít ý nghĩa hơn vẻ ngoài. Cách an toàn nhất là tách các phép đo thực sự tương thích khỏi bằng chứng mang tính định hướng.
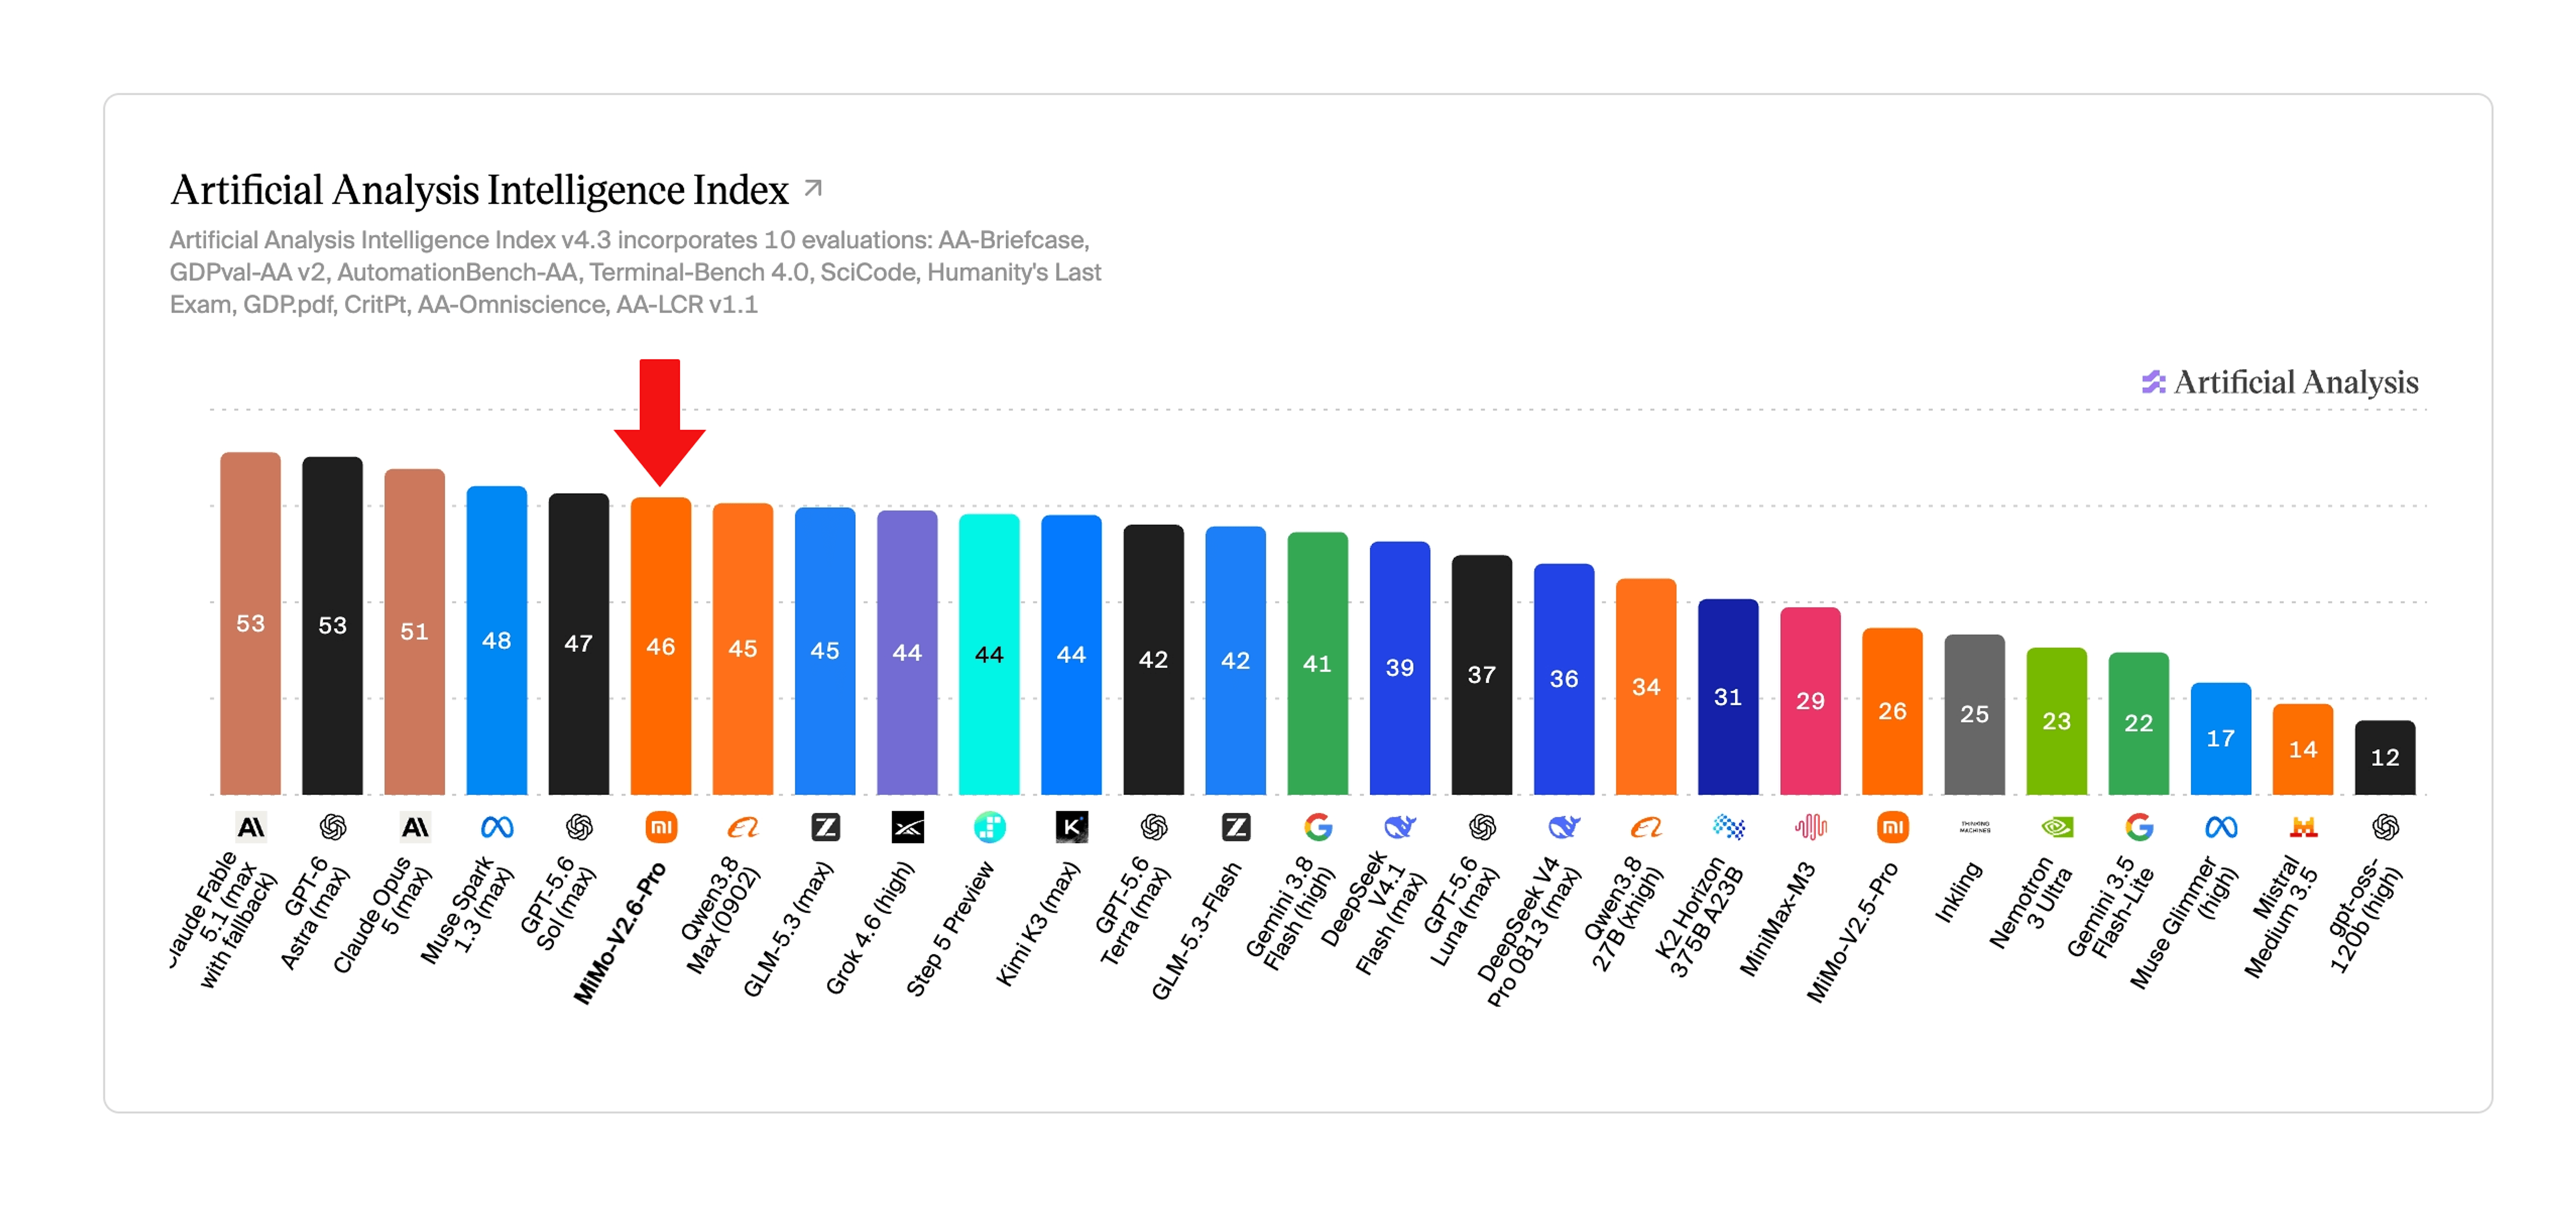
Artificial Analysis Intelligence Index
Xiaomi báo cáo 46,32 cho MiMo-V2.6-Pro trên chỉ số tổng hợp Artificial Analysis. Bất kỳ so sánh Grok nào cũng nên gắn với ảnh chụp Artificial Analysis và cấu hình mô hình chính xác đã dùng; không nên nêu tuyên bố ngang bằng đã làm tròn mà không có nguồn đó.
Hiệu năng lập trình và agent
| Benchmark | Grok 4.7 — SpaceXAI | MiMo-V2.6-Pro — Xiaomi | Diễn giải |
|---|---|---|---|
| DeepSWE v1.1 | 71.0* | 71.9** | Gần nhau về số; lượt chạy và cài đặt đã công bố khác |
| GDPval-AA | Xem biểu đồ SpaceXAI | 1,673 | Chỉ mang tính định hướng trừ khi harness được căn chỉnh |
| AA Briefcase | 1,657 | Xem biểu đồ Xiaomi | Dùng giá trị do nhà cung cấp báo cáo với ngữ cảnh nguồn |
| Terminal-Bench 4.0 | 38.0 | 34.9 | Xu hướng tương tự; harness rất quan trọng |
| Context window | 500K | 1M | MiMo hỗ trợ ngữ cảnh làm việc lớn hơn |
* SpaceXAI báo cáo DeepSWE của Grok 4.7 ở high effort. ** Bảng so sánh cuối của Xiaomi báo 71,9; đường cong huấn luyện Live RL đạt khoảng 72,6. Các con số này đến từ ngữ cảnh đánh giá khác nhau.
Phù hợp quy trình lập trình
Với lập trình, khác biệt tùy thuộc việc “lập trình” nghĩa là giải bài toán kho mã thuần hay một trải nghiệm coding-agent được quản lý đầy đủ. Trên DeepSWE v1.1, các con số đã công bố đủ gần nhau nên chênh lệch dưới một điểm không nên tự quyết định lựa chọn sản xuất.
Ưu thế của Grok 4.7 nằm cao hơn trong ngăn xếp. Nó tích hợp với Grok Build, có mặt trong Cursor, được thiết kế để hiểu harness Grok Bot, và đi kèm công cụ thực thi mã và tìm kiếm first-party.
Ưu thế của MiMo-V2.6-Pro nằm thấp hơn trong ngăn xếp. Trọng số mở giúp xây dựng trợ lý lập trình riêng tư, tùy biến phục vụ, áp đặt kiểm soát lưu trú dữ liệu hoặc thử nghiệm một harness agent sở hữu riêng.
Với các đội nhóm đang chọn giữa hai bên, thử nghiệm A/B trong sản xuất trên các kho đại diện sẽ thông tin hơn một benchmark lập trình công khai đơn lẻ.
Grok 4.7 vs MiMo-V2.6-Pro: Khác biệt năng lực đa phương thức
Đây là một khác biệt rõ ràng. Grok 4.7 nhận đầu vào văn bản và hình ảnh và xuất văn bản. Nền tảng Grok rộng hơn có các sản phẩm media riêng, nhưng không nên nhầm lẫn với bề mặt phương thức của chính mô hình grok-4.7.
MiMo-V2.6-Pro hỗ trợ hiểu văn bản, hình ảnh, âm thanh và video. Kết hợp với cửa sổ ngữ cảnh 1M token, điều này mở rộng phạm vi quy trình có thể xử lý trong cùng một ngữ cảnh mô hình.
- Chụp màn hình và phân tích mã trong cùng tác vụ
- Hiểu video kèm hướng dẫn
- Xử lý âm thanh dài
- Agent sử dụng máy tính với phản hồi thị giác
- Trợ lý nghiên cứu đa phương thức
- Trích xuất và QA đa phương thức quy mô lớn
Grok 4.7 vs MiMo-V2.6-Pro: So sánh giá API
| Official API pricing | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Input / 1M tokens | $2.00 | $0.435 |
| Cached input / 1M | $0.50 | $0.0036 |
| Output / 1M | $6.00 | $0.87 |
| Long-context surcharge | Có, trên 200K token trong prompt | Chưa công bố bậc tiêu chuẩn tương đương |
| Open-weight/self-host option | Không | Có |
Theo mức niêm yết, MiMo-V2.6-Pro rẻ hơn nhiều lần ở cả đầu vào thường và đầu ra, với khác biệt đặc biệt lớn cho ngữ cảnh được cache. Điều đó có thể ảnh hưởng đáng kể đến kinh tế của các agent xử lý lặp lại kho mã, tài liệu dài hoặc ngữ cảnh bền bỉ.
Lưu ý giá quan trọng: Cửa sổ ngữ cảnh 500K của Grok 4.7 không có nghĩa toàn bộ ngữ cảnh được tính theo mức giá tiêu chuẩn. Yêu cầu vượt quá 200K token trong prompt sẽ bị tính theo bậc ngữ cảnh dài.
Tính đến ngày 24 tháng 9, 2026, CometAPI liệt kê Grok 4.7 ở mức $1,60 đầu vào và $4,80 đầu ra mỗi 1M token, so với mức chính thức $2,00 và $6,00. CometAPI liệt kê MiMo-V2.6-Pro ở mức $0,348 đầu vào và $0,696 đầu ra, so với mức chính thức $0,435 và $0,87. Các mức tiêu chuẩn liệt kê này thấp hơn 20% so với mức chính thức tương ứng. Giá và điều kiện có thể thay đổi; hãy xác nhận các trang mô hình trực tiếp trước khi lập ngân sách.
Giá token không đồng nghĩa với chi phí cho mỗi tác vụ hoàn tất. Các mô hình suy luận có thể tiêu thụ khối lượng token khác nhau, dùng số lượt gọi công cụ khác nhau và cần tỷ lệ thử lại khác nhau. Vì vậy, đánh giá sản xuất nên theo dõi chi phí/tác vụ hoàn tất, độ trễ và tỷ lệ thành công cùng nhau.
Grok 4.7 vs MiMo-V2.6-Pro: Truy cập và khả dụng
Khác biệt truy cập khá thẳng thắn: Grok 4.7 có qua API và các quy trình Grok được quản lý, trong khi trọng số mô hình không được cung cấp để tự lưu trữ. MiMo-V2.6-Pro có qua API và trọng số mở, cho phép các đội có thêm con đường tự lưu trữ.
Tính khả dụng khác với cấp phép hay linh hoạt triển khai. Tính đến ngày 24 tháng 9, 2026, cả hai mô hình đều có trang danh mục CometAPI trực tiếp. Các đội nên xác nhận endpoint, khu vực, giới hạn tốc độ và điều kiện tài khoản trước khi đưa vào sản xuất; một mô hình được liệt kê không đảm bảo mức khả dụng hay dịch vụ giống nhau cho mọi tài khoản.
| Availability question | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Official API | Có qua xAI | Có qua Xiaomi MiMo |
| CometAPI catalog | Được liệt kê là khả dụng | Được liệt kê là khả dụng |
| Self-hosted weights | Không có | Tùy chọn trọng số mở |
| Operational check | Xác nhận quyền truy cập tài khoản, khu vực, giới hạn tốc độ và công cụ | Xác nhận quyền truy cập tài khoản, mức sẵn sàng endpoint và yêu cầu tự lưu trữ |
Trọng số mở và truy cập độc quyền
MiMo-V2.6-Pro có trọng số mở thay đổi phép so sánh nhiều hơn chênh lệch một điểm benchmark. Nó tạo ra các lựa chọn triển khai riêng tư, tinh chỉnh động cơ suy luận, hậu huấn luyện tùy biến, kiểm soát lưu trú dữ liệu và tích hợp hạ tầng sâu hơn.
Grok 4.7 chọn hướng ngược lại: ít kiểm soát nội tại mô hình hơn để đổi lấy một dịch vụ được vận hành quản lý liên tục và một hệ sinh thái first-party tích hợp chặt. Với nhiều tổ chức, các yêu cầu quản trị và hạ tầng sẽ quyết định danh sách rút gọn trước khi hiệu năng benchmark kịp làm điều đó.
Cách dùng API Grok 4.7 và MiMo V2.6 trong CometAPI
Nhà phát triển có thể truy cập API Grok 4.7 trong CometAPI thông qua quy trình API hợp nhất, giảm nhu cầu duy trì tích hợp riêng theo nhà cung cấp.
Với các đội benchmark nhiều mô hình tuyến đầu, một lớp API hợp nhất đặc biệt hữu ích vì cùng prompt sản xuất, bộ khung thử nghiệm, hạch toán token và mã ứng dụng có thể được phát lại trên nhiều mô hình với ít biến tích hợp hơn.
CometAPI hiện liệt kê MiMo-V2.6-Pro là khả dụng, với khả dụng API được xác nhận vào ngày 22 tháng 9, 2026. Kiểm tra danh mục trực tiếp và quyền truy cập tài khoản trước khi dùng sản xuất.
Với việc cả hai trang mô hình đều đã được liệt kê là khả dụng, một thử nghiệm A/B ở cấp ứng dụng có thể giữ nguyên prompt, công cụ, cài đặt suy luận và tiêu chí thành công nhất quán nhất có thể, rồi so sánh hoàn tất tác vụ, độ trễ, sử dụng token và chế độ lỗi.
Grok 4.7 vs MiMo-V2.6-Pro: Phù hợp mô hình theo trường hợp sử dụng
| Requirement | Hướng dẫn phù hợp mô hình / đánh giá |
|---|---|
| Tìm kiếm web và X first-party | Grok 4.7 |
| Agent chạy lâu được quản lý | Grok 4.7 |
| Quy trình Grok Build / Cursor | Grok 4.7 |
| Ngữ cảnh 1M token | MiMo-V2.6-Pro |
| Hiểu âm thanh/video gốc | MiMo-V2.6-Pro |
| Trọng số mở, tự lưu trữ và kiểm soát mô hình | MiMo-V2.6-Pro |
| Chi phí token API thô thấp nhất | MiMo-V2.6-Pro |
| Lập trình kho mã | Benchmark cả hai trên các kho đại diện |
| Agent kiến thức chuyên nghiệp | Benchmark cả hai trên tác vụ sản xuất |
Vì vậy, quyết định nên được đóng khung quanh kiến trúc khối lượng công việc. Grok 4.7 được thiết kế để làm cho ngăn xếp agent được quản lý trở nên mạnh hơn; MiMo-V2.6-Pro được thiết kế để làm cho trí tuệ cao cấp rẻ hơn, đa phương thức hơn và dễ kiểm soát hơn.
Nên chọn cái nào?
Chọn Grok 4.7 nếu bạn muốn trải nghiệm agent được quản lý với tìm kiếm web và X first-party, thực thi mã gốc và ít hạ tầng phải vận hành hơn. Đây là lựa chọn thực tế hơn cho các đội coi trọng ngăn xếp công cụ tích hợp và quy trình chuyên nghiệp hay lập trình chạy dài.
Chọn MiMo-V2.6-Pro nếu bạn cần trọng số mở, triển khai riêng tư, cửa sổ ngữ cảnh 1M token, khả năng hiểu âm thanh và video gốc hoặc mức giá API token thô thấp hơn đáng kể. Đây là lựa chọn mạnh hơn khi kiểm soát triển khai, độ phủ đa phương thức và hiệu quả chi phí là ràng buộc chính.
Nếu vẫn chưa rõ, hãy chạy cả hai mô hình trên cùng các tác vụ đại diện với prompt, công cụ, ngân sách suy luận, timeout và chính sách thử lại giống hệt nhau. Chọn mô hình mang lại kết hợp tốt nhất giữa tỷ lệ hoàn tất, độ trễ, tổng chi phí cho mỗi tác vụ thành công và nỗ lực rà soát của con người.
Kết luận
Grok 4.7 vs MiMo V2.6 cho thấy trí tuệ thuần không còn là khác biệt ý nghĩa duy nhất. Cả hai mô hình cùng chiếm dải năng lực cao tương tự trong các đánh giá công khai hiện tại, nhưng chiến lược sản phẩm lại khác biệt mạnh.
Grok 4.7 kết hợp cửa sổ ngữ cảnh 500K, suy luận có thể cấu hình, huấn luyện agent tầm dài mạnh và ngăn xếp tìm kiếm, thực thi first-party trưởng thành. MiMo-V2.6-Pro kết hợp ngữ cảnh 1M, đầu vào đa phương thức gốc, trọng số mở và giá API thấp hơn nhiều so với nhiều hệ thống độc quyền tuyến đầu.
Với nhà phát triển, câu hỏi thực tế vì vậy ít mang tính “điểm benchmark nào cao hơn?” và nhiều hơn “trí tuệ nên nằm ở đâu?” Một hệ sinh thái agent được quản lý và một ngăn xếp mô hình mở có thể tùy biến giải quyết các bài toán vận hành khác nhau. Lựa chọn đúng là lựa chọn phù hợp nhất với khối lượng công việc sản xuất, ràng buộc hạ tầng và mô hình chi phí.
Câu hỏi thường gặp
Grok 4.7 có phải là mô hình 2,1 nghìn tỷ tham số không?
Một con số khoảng 2,1T đã lan truyền trước khi phát hành, nhưng tài liệu Grok 4.7 cuối cùng của SpaceXAI không công bố tổng số hoặc số tham số hoạt động. Khẳng định đã xác nhận là Grok 4.7 dùng mô hình nền lớn hơn Grok 4.6.
MiMo-V2.6 có phải mã nguồn mở không?
Xiaomi phát hành MiMo-V2.6 như một dòng mô hình mở với trọng số có thể tải xuống và tài nguyên nghiên cứu liên quan. Trong lập kế hoạch sản xuất, các đội vẫn nên xem xét kỹ giấy phép mô hình và điều khoản phân phối lại cho mục đích sử dụng dự định.
Grok 4.7 vs MiMo-V2.6-Pro tốn bao nhiêu cho mỗi tác vụ agent hoàn tất?
Chuẩn hóa bộ tác vụ, prompt, quyền dùng công cụ, chính sách thử lại và tiêu chí thành công. Theo dõi tổng token đầu vào, đầu vào được cache, suy luận và đầu ra, lượt gọi công cụ, độ trễ, thử lại và thời gian rà soát của con người. Giá token thô chỉ là một thành phần của chi phí/tác vụ hoàn tất.
So sánh benchmark Grok 4.7 vs MiMo-V2.6-Pro đáng tin cậy đến đâu?
Dùng cùng kho hoặc bộ tác vụ, harness agent, công cụ, ngân sách suy luận, timeout, chính sách thử lại và thang chấm điểm. Báo cáo khoảng tin cậy hoặc biến thiên giữa các lần chạy lặp lại, và giữ tách biệt số liệu do nhà cung cấp công bố khỏi kết quả nội bộ.
Grok 4.7 có tính phí cao hơn cho prompt ngữ cảnh dài không?
SpaceXAI tài liệu hóa mức giá cao hơn khi token trong prompt vượt 200K. Vì bậc cao hơn áp dụng cho toàn bộ yêu cầu, các đội dùng kho lớn hoặc ngữ cảnh agent bền bỉ nên mô hình hóa ngưỡng này một cách tường minh.