
Chạy Qwen3.8-Max cục bộ hiện đã khả thi, nhưng cụm từ “Qwen 3.8 Max cục bộ” cần một điểm làm rõ quan trọng. Sản phẩm Max được Alibaba lưu trữ và checkpoint có thể tải về có liên quan chặt chẽ, nhưng không phải là các sản phẩm giống hệt nhau.
Qwen lần đầu ra mắt dịch vụ Max được lưu trữ vào đầu tháng 8 năm 2026 và phát hành Qwen3.8-2.4T-A95B dưới dạng trọng số mở vào 12 tháng 8, 2026. Đó là checkpoint mà bạn thực sự triển khai trên hạ tầng của riêng mình.
Đây không phải là một hướng dẫn kiểu Ollama-trên-PC-chơi-game. Checkpoint chưa lượng tử hóa là một mô hình Mixture-of-Experts 2,4 nghìn tỷ tham số, và công thức vLLM hiện tại ước tính trọng số BF16 của nó ở mức 4,45 TiB. Ngay cả các biến thể số thực 4-bit định hướng sản xuất vẫn chiếm khoảng 1,3–1,5 TiB trọng số.
Câu trả lời nhanh: tự lưu trữ đầy đủ Qwen 3.8 Max-class là một triển khai cấp trung tâm dữ liệu. Một điểm khởi đầu thực tế cho sản xuất là checkpoint FP4 trên 8× B300 hoặc 8× MI355X; các triển khai H200 cần nhiều GPU hơn. Với máy trạm thông thường, hãy dùng Qwen3.8-27B.
Qwen 3.8 Max so với Mô hình Mở mà bạn thực sự triển khai
Checkpoint Qwen3.8-2.4T-A95B có thể tải về được mô tả chính thức là một mô hình ngôn ngữ nhân quả 2,4T tham số với khoảng 95B tham số hoạt hóa mỗi token. Dịch vụ Max được lưu trữ bổ sung các năng lực ở tầng sản phẩm không xuất hiện trong checkpoint mở hiện tại.
| Thông số | Dịch vụ lưu trữ Qwen3.8-Max | Checkpoint mở Qwen3.8-2.4T-A95B |
|---|---|---|
| Tổng tham số | 2.4T | 2.4T |
| Tham số hoạt hóa | ~95B | ~95B |
| Kiến trúc | MoE thưa | MoE thưa |
| Đầu vào | Văn bản, hình ảnh, video | Văn bản |
| Ngữ cảnh | Ngữ cảnh quản lý 1M | 262.144 gốc; mở rộng tới ~1,01M |
| Hành vi tư duy | Tư duy được quản lý/không tư duy | Bắt buộc tư duy; nỗ lực suy luận có thể cấu hình |
| Công cụ tích hợp sẵn | Có trên dịch vụ được quản lý | Ứng dụng phải cung cấp công cụ |
| Tự lưu trữ | Không cần quản lý trọng số | Có; checkpoint mở |
Sản phẩm được lưu trữ cung cấp đầu vào văn bản, hình ảnh và video với ngữ cảnh 1.000.000 token. Ngược lại, checkpoint mở chỉ hỗ trợ văn bản và có ngữ cảnh gốc 262.144 token. Sự khác biệt này quan trọng nếu ứng dụng của bạn phụ thuộc vào đầu vào đa phương thức hoặc các công cụ tích hợp được quản lý.
Kiến trúc và Thông số Qwen 3.8
CometAPI đã đề cập nền tảng mô hình trong What is Qwen3.8 Max, vì vậy hướng dẫn triển khai này chỉ tập trung kiến trúc vào các chi tiết ảnh hưởng tới bộ nhớ, song song và phục vụ.
| Thông số liên quan triển khai | Qwen3.8-2.4T-A95B |
|---|---|
| Tổng/tham số hoạt hóa | 2.4T / ~95B mỗi token |
| Bố cục lớp | 92 lớp: 69 Gated DeltaNet + 23 full attention |
| Điều phối MoE | 512 chuyên gia định tuyến; 10 định tuyến + 1 dùng chung hoạt hóa |
| Đầu full-attention | 64 query / 4 key-value heads |
| Ngữ cảnh gốc | 262.144 token |
| Ngữ cảnh mở rộng | Tới xấp xỉ 1.010.000 token |
| Dự đoán đa token | Hỗ trợ |
| Phương thức checkpoint mở | Chỉ văn bản |

Kiến trúc mô hình lai Qwen chính thức được sử dụng trong hướng dẫn triển khai SGLang Qwen3.8.
Đừng diễn giải “95B tham số hoạt hóa” như dấu chân bộ nhớ của một mô hình 95B. Kích hoạt thưa giảm lượng tính toán mỗi token, nhưng hệ thống phục vụ vẫn cần truy cập toàn bộ tập trọng số chuyên gia.
Ảnh chụp Benchmark Qwen 3.8 Max
Vì tổng quan Qwen3.8 Max của CometAPI đã bàn về benchmark chi tiết, bài viết này chỉ dùng một tập con liên quan triển khai từ bảng benchmark trong model card chính thức của Qwen.
| Benchmark | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 74.5 | 88.8 |
| SWE-bench Pro | 67.7 | 60.6 | 64.6 |
| PaperBench | 93.0 | 64.8 | 90.5 |
| FrontierSWE | 73.5 | 40.7 | — |
| CoWorkBench | 74.8 | 64.6 | 71.5 |
| GPQA Diamond | 92.6 | 92.4 | 94.1 |
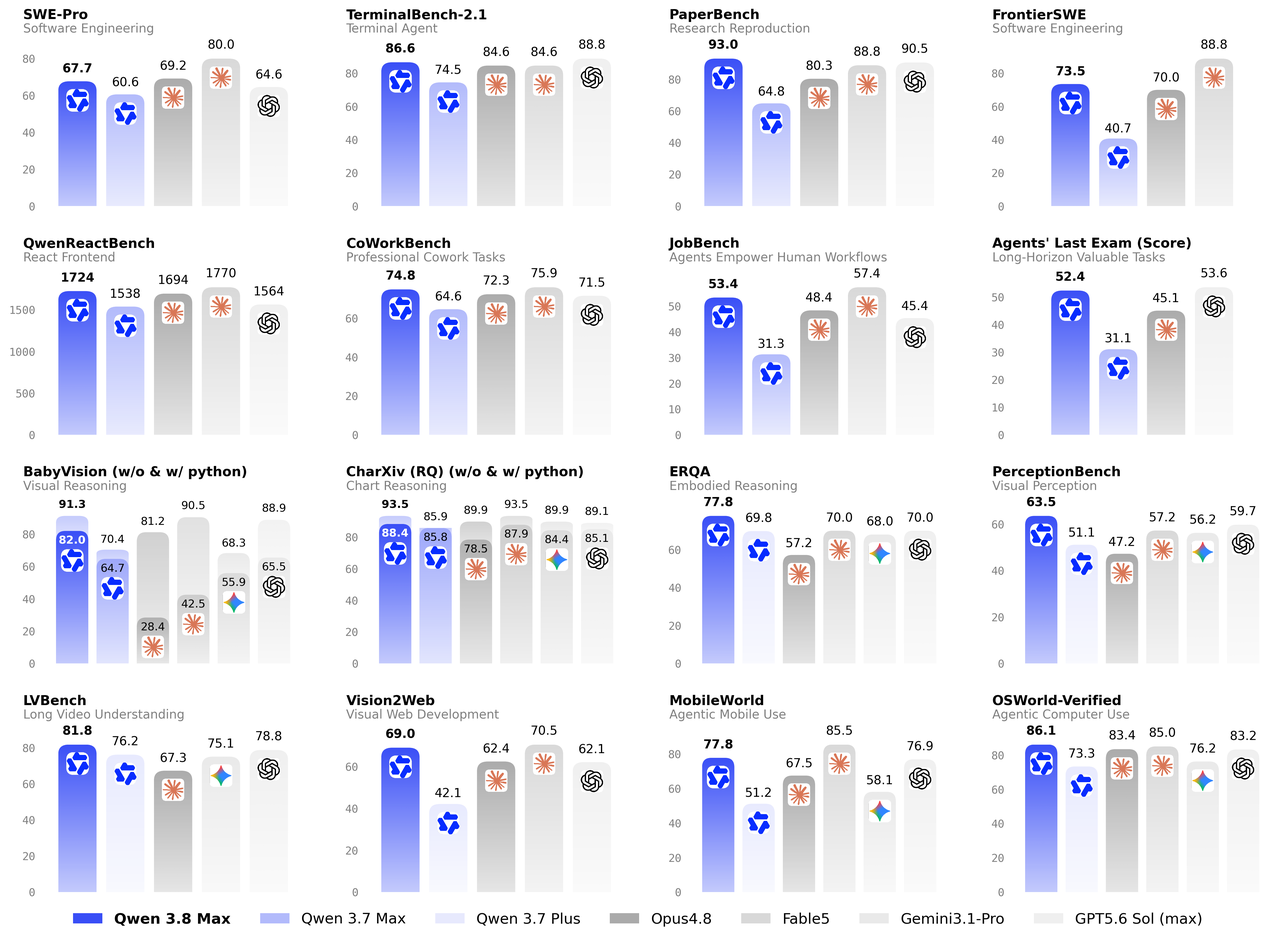
Biểu đồ hiệu năng Qwen3.8 chính thức do nhóm Qwen* công bố.*
Những mức tăng lớn nhất so với Qwen3.7-Max trong tập con này là PaperBench và FrontierSWE. Qwen3.8-Max cũng vượt GPT-5.6 Sol trên SWE-bench Pro và PaperBench, trong khi GPT-5.6 Sol vẫn dẫn trên Terminal Bench 2.1. Đối với quyết định triển khai, hãy xem đây là ngữ cảnh năng lực; các phép đo bộ nhớ và thông lượng phục vụ dưới đây mang tính vận hành hơn.
Bảng benchmark không phải là xếp hạng phổ quát. Bộ harness, timeout, giới hạn ngữ cảnh, quyền truy cập công cụ và lượng tử hóa có thể thay đổi kết quả. Hãy benchmark đúng checkpoint, độ chính xác, engine phục vụ và phân phối prompt mà bạn định sử dụng.
Qwen3.8 cần phần cứng nào cho triển khai cục bộ?
Yêu cầu GPU cho Qwen3.8-2.4T-A95B
Đây là câu hỏi triển khai then chốt. Công thức vLLM Qwen3.8 hiện tại công bố dấu chân checkpoint và số lượng GPU thực tế với phần dư runtime, hữu ích hơn việc ước tính VRAM chỉ từ số tham số.
| Độ chính xác | Dấu chân trọng số | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Phù hợp nhất |
|---|---|---|---|---|---|
| BF16 | 4,45 TiB | 24 GPU | 24 GPU | 48 GPU | Độ trung thực tối đa/nghiên cứu |
| FP8 | 2,27 TiB | 16 GPU | 16 GPU | 32 GPU | Sản xuất độ trung thực cao |
| MXFP4 | 1,45 TiB | — | 8 GPU | 16 GPU | Triển khai AMD thực tiễn |
| NVFP4 W4A4 | 1,32 TiB | 8 GPU | — | 16 GPU | Triển khai NVIDIA thực tiễn |
Với hầu hết tổ chức thực sự cần tự lưu trữ Qwen3.8, FP4 là điểm khởi đầu thực tế. Cấu hình NVIDIA nổi bật là NVFP4 W4A4 trên 8× B300; lộ trình tương ứng trên AMD là MXFP4 trên 8× MI355X.
Một máy chủ 8× H200 là không đủ cho các triển khai full-model được khuyến nghị này. Công thức chính thức hiện định kích thước H200 ở 16 GPU cho FP4, 32 cho FP8 và 48 cho BF16.
Yêu cầu VRAM cho Qwen3.8-27B
Qwen3.8-27B là lựa chọn thay thế lớp máy trạm thực tế. Bộ nhớ trọng số thô xấp xỉ 54 GB ở BF16, 27 GB ở FP8 và 13,5 GB ở độ chính xác 4-bit. Phần dư runtime và KV cache làm tăng yêu cầu thực tế, đặc biệt ở độ dài ngữ cảnh lớn.
| Độ chính xác | Bộ nhớ trọng số xấp xỉ | Hướng dẫn triển khai thực tế |
|---|---|---|
| BF16 | ~54 GB | Dùng GPU 64–80 GB, tùy ngữ cảnh và phần dư phục vụ. |
| FP8 / INT8 | ~27 GB | GPU 40–48 GB cung cấp phần dư runtime thực tế hơn. |
| 4-bit | ~13,5 GB | GPU tiêu dùng 20–24 GB có thể khả thi ở độ dài ngữ cảnh vừa phải. |
Các con số này là ước tính lập kế hoạch dựa trên số tham số. Hãy xác nhận checkpoint, định dạng lượng tử hóa, engine phục vụ, độ dài ngữ cảnh và thiết lập KV cache chính xác trước khi định cỡ phần cứng sản xuất.
Qwen3.8 có chạy trên GPU tiêu dùng không?
Mô hình đầy đủ Qwen3.8-2.4T-A95B không thực tế trên các GPU tiêu dùng thông thường, ngay cả khi lượng tử hóa mạnh tay. Một dự án cộng đồng đã trình diễn bản dựng UD-Q1_0 nén mạnh 397 GB trên bốn hệ thống DGX Spark, nhưng đó là một hướng lượng tử hóa cực đoan mang tính thử nghiệm chứ không phải chuẩn gốc cho phục vụ nhạy cảm chất lượng.
Với máy trạm hoặc home lab, mô hình thích hợp hơn là Qwen3.8-27B, có trọng số mở phát hành vào 14 tháng 8, 2026. Mô hình này dễ lưu trữ hơn nhiều bậc và là lựa chọn đúng đắn nếu “cục bộ” nghĩa là một máy trạm thay vì một cụm GPU.
Trước khi bạn cài Qwen 3.8 Max
Hãy lập kế hoạch hạ tầng trước khi chạy lệnh cài đặt. Bạn cần Linux, một stack gia tốc tương thích, đủ bộ nhớ lưu trữ cục bộ hoặc chia sẻ cho checkpoint, liên kết liên GPU băng thông cao, và—khi qua các nút—một mạng được thiết kế cho suy luận phân tán. Công thức vLLM hiện khuyến nghị vLLM nightly và Transformers 5.4.0 trở lên.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Cách triển khai Qwen 3.8 FP8 với vLLM
FP8 là lựa chọn hợp lý khi bạn muốn checkpoint do Qwen cung cấp và có thể chi trả hạ tầng đa nút. Checkpoint chính thức là Qwen/Qwen3.8-2.4T-A95B-FP8.
Với một triển khai lớp B300 hai nút, 16 GPU, chạy nút đầu với:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Đừng sao chép ví dụ 16 GPU này lên máy chủ H200 mà không thay đổi lại cấu hình. Cùng biến thể FP8 hiện được định ở 32× H200 trong công thức vLLM.
Cách chạy Qwen 3.8 trên một máy chủ 8× B300
Với NVIDIA Blackwell, cấu hình full-model thực tế nhất là NVFP4. vLLM hiện xác thực NVFP4 W4A4 với song song theo tensor trên tám GPU B300.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Bản NVFP4 của Inferact là một checkpoint đã lượng tử hóa thay vì artifact BF16 gốc của Qwen. Hãy xác thực chất lượng mô hình trên tập chấp nhận của riêng bạn trước khi coi nó là thay thế trực tiếp cho BF16 hoặc FP8.
Cách triển khai Qwen 3.8 với SGLang
SGLang đã thêm hỗ trợ Day-0 cho Qwen3.8 vào ngày 12 tháng 8 và đặc biệt hấp dẫn cho phục vụ thông lượng cao, prefix caching, song song theo chuyên gia, giải mã dự đoán (speculative), và tách rời prefill/giải mã.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang báo cáo 346 token đầu ra/giây ở batch size 1 trên TP8 B300 với MTP, và thông lượng tổng hợp cao hơn đáng kể trong các bố cục phục vụ tách rời. Hãy coi các con số đó là phép đo stack phục vụ, không phải benchmark chất lượng mô hình.
Kiểm thử endpoint cục bộ tương thích OpenAI
Cả vLLM và SGLang đều cung cấp API tương thích OpenAI, giúp tích hợp ứng dụng trở nên đơn giản.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
Model card chính thức khuyến nghị temperature=1.0, top_p=0.95 và top_k=20 như các tham số lấy mẫu cơ sở. Với công việc tác nhân (agentic), hãy để đủ ngân sách đầu ra cho suy luận thay vì chỉ định cỡ max_tokens cho câu trả lời cuối cùng hiển thị.
Bật cửa sổ ngữ cảnh 1M
Checkpoint mở Qwen3.8-2.4T-A95B có ngữ cảnh gốc 262.144 token và có thể mở rộng tới khoảng 1,01M. Công thức vLLM ghi nhận mẫu sau:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Đừng đặt 1M làm mặc định chỉ vì nó được hỗ trợ. Ngữ cảnh tối đa lớn hơn sẽ dự trữ nhiều dung lượng bộ đệm hơn và có thể giảm mạnh khả năng đồng thời. Hãy đặt --max-model-len theo đúng khối lượng công việc thực.
Cải thiện hiệu năng suy luận Qwen3.8 như thế nào?
Dùng MTP-3 để giảm độ trễ đơn người dùng
Qwen3.8 hỗ trợ Dự đoán đa token. Trong các phép đo đã công bố của vLLM, MTP-3 tăng đầu ra mỗi người dùng từ 130 lên 307 tok/s cho FP8 TP16 và từ 133 lên 304 tok/s cho NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Dùng fastsafetensors để tăng tốc khởi động
Với các mô hình quy mô terabyte, thời gian khởi động rất quan trọng. Trong một phép đo của vLLM, thời gian nạp trọng số giảm từ 545 s xuống 306 s với fastsafetensors và lazy loading.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Dùng Expert Parallelism để tăng thông lượng đồng thời
Với đồng thời cao, Qwen3.8 hưởng lợi từ bố cục song song theo chuyên gia vì nó có 512 chuyên gia được định tuyến. vLLM báo cáo tới 3.200 tổng tok/s/GPU cho FP8 EP và tới 4.300 tổng tok/s/GPU cho cấu hình NVFP4 DEP16 tối ưu hóa.
Đặt --max-model-len để cân bằng VRAM và đồng thời
Đặt --max-model-len theo chuỗi dài nhất mà khối lượng công việc thực sự cần. Giá trị lớn hơn dự trữ nhiều dung lượng KV cache hơn, tăng áp lực bộ nhớ và có thể giảm số yêu cầu đồng thời ngay cả khi trọng số mô hình đã vừa.
Bắt đầu với một phân vị đại diện cho sản xuất thay vì ngữ cảnh tối đa được quảng bá của mô hình. Kiểm thử tải giới hạn đã chọn với cùng độ chính xác, mô hình batch và engine phục vụ dùng trong sản xuất, rồi chỉ tăng khi yêu cầu thực cần nhiều ngữ cảnh hơn.
Triển khai cục bộ Qwen 3.8 Max so với API
Trọng số mở không tự động khiến suy luận cục bộ kinh tế. Quyết định đúng phụ thuộc vào mức sử dụng, cư trú dữ liệu, nhân sự, mục tiêu sẵn sàng và việc bạn có thực sự cần các tính năng đa phương thức của mô hình được quản lý hay không.
| Chiều | Tự lưu trữ Qwen3.8-2.4T-A95B | Qwen3.8-Max qua CometAPI |
|---|---|---|
| Hạ tầng | Máy chủ đa GPU hoặc cụm | Không cần hạ tầng GPU |
| Phương thức vào | Văn bản | Văn bản, hình ảnh, video |
| Ngữ cảnh | 262K gốc; ~1,01M mở rộng | 1M được quản lý |
| Kiểm soát dữ liệu | Tối đa | API đám mây |
| Vận hành | Bạn sở hữu giám sát, nâng cấp và HA | Nhà cung cấp quản lý |
| Phù hợp nhất | Cư trú dữ liệu, sử dụng bền vững, đội hạ tầng | Hầu hết đội ứng dụng và tải biến động |
Nếu bạn đã sở hữu các bộ gia tốc phù hợp và có mức sử dụng cao ổn định, tự lưu trữ có thể hợp lý. Nếu bạn sẽ mua cụm chỉ cho mô hình này, Qwen3.8-Max trên CometAPI thường là con đường ít ma sát hơn. Hướng dẫn API hiện có bao phủ tích hợp lưu trữ, trong khi hướng dẫn định giá bao phủ mô hình chi phí; do đó bài viết này tập trung vào triển khai cục bộ.
Các vấn đề thường gặp khi triển khai cục bộ Qwen 3.8
Máy chủ hết bộ nhớ GPU trong khi khởi động
Trước tiên hãy giảm --max-model-len nếu vấn đề là bộ đệm. Nếu chính trọng số không vừa, việc giảm ngữ cảnh sẽ không giải quyết gốc rễ; hãy chuyển sang checkpoint độ chính xác thấp hơn đã được xác thực hoặc thêm GPU.
Song song theo tensor thất bại do kích thước không hợp lệ
Qwen3.8 có 64 attention head trong các lớp full-attention, nên vLLM yêu cầu TP phải chia hết 64. Các kích thước TP trực tiếp là 1, 2, 4, 8, 16 và 32. Vì vậy tổng VRAM thô không đủ để chọn một cấu hình.
Máy chủ mất nhiều thời gian để khởi động
Nạp từ một đến vài terabyte trọng số cộng với kernel JIT có thể mất vài phút. Tăng VLLM_ENGINE_READY_TIMEOUT_S và thăm dò một endpoint suy luận thực thay vì giả định một cửa sổ khởi động ngắn.
Mô hình cục bộ không xử lý được hình ảnh
Điều đó là kỳ vọng. Checkpoint mở Qwen3.8-2.4T-A95B chỉ hỗ trợ văn bản. Hạn chế này là riêng cho Qwen3.8-2.4T-A95B. Qwen3.8-27B hỗ trợ đầu vào thị giác khi tải các tệp chiếu thị giác riêng của nó.
Ngữ cảnh 1M làm giảm mạnh thông lượng
Giảm --max-model-len xuống chuỗi dài nhất mà khối lượng công việc thực sự cần. Cửa sổ ngữ cảnh lớn nhất được hỗ trợ không nhất thiết là thiết lập sản xuất tốt nhất; hãy chọn giới hạn ngữ cảnh cân bằng giữa yêu cầu khối lượng công việc, sử dụng KV cache và đồng thời.
Ollama hoặc LM Studio có chạy được Qwen 3.8 Max không?
Hệ sinh thái có thể đóng gói trọng số Qwen3.8 đã lượng tử hóa mạnh cho suy luận kiểu llama.cpp, nhưng không nên nhầm lẫn điều đó với quy trình Ollama trên máy bàn thông thường. Một bản dựng lượng tử hóa chiếm hàng trăm gigabyte vẫn yêu cầu hàng trăm gigabyte bộ nhớ truy cập được và có nhiều đánh đổi về chất lượng và hiệu năng.
Với phát triển cục bộ thông thường, Qwen3.8-27B là mục tiêu phù hợp. Mô hình 2,4T đầy đủ nên được coi là mô hình máy chủ/cụm ngay cả khi các bản lượng tử cộng đồng cực đoan khiến nó có thể khởi động kỹ thuật trên phần cứng khác thường.
Nên chọn phương pháp triển khai nào?
Với NVIDIA Blackwell, triển khai NVFP4 trên 8× B300 hiện là điểm khởi đầu full-model gọn gàng nhất. Với AMD, 8× MI355X với MXFP4 là cấu hình thực tế tương ứng. Dùng FP8 khi bạn ưu tiên nguồn gốc checkpoint và chất lượng hơn kích cỡ hạ tầng, và chỉ dùng BF16 khi độ trung thực tối đa biện minh cho yêu cầu bộ nhớ cấp nhiều rack.
Với máy trạm, hãy dùng Qwen3.8-27B. Với các đội ứng dụng cần khả năng Max mà không vận hành cụm GPU, hãy dùng mô hình Qwen3.8-Max trên CometAPI.
Kết luận
Qwen3.8-Max đã vượt qua một ranh giới quan trọng kể từ khi ra mắt API ban đầu: họ Qwen lớp Max nay có checkpoint 2,4T mở mà các tổ chức có thể vận hành hoàn toàn trên hạ tầng riêng.
Nhưng trọng số mở không đồng nghĩa phần cứng tiêu dùng. Dấu chân BF16 4,45 TiB, checkpoint FP8 2,27 TiB và các biến thể FP4 1,3–1,5 TiB khiến Qwen3.8-2.4T-A95B trở thành một trong những mô hình mở đòi hỏi hạ tầng nặng nhất. Điểm tích cực thực tế là vLLM và SGLang đã hỗ trợ kiến trúc này, và FP4 làm cho triển khai một nút 8× B300 hoặc 8× MI355X khả thi.
Hãy tự lưu trữ khi kiểm soát dữ liệu, sử dụng bền vững và sở hữu hạ tầng biện minh cho cụm. Nếu không, hãy dùng Max API được quản lý—hoặc Qwen3.8-27B khi điều bạn thực sự muốn là một mô hình Qwen mạnh trên một máy trạm.