
TL;DR
DeepSeek-V4.1-Flash có trọng số mở và có thể tự lưu trữ, nhưng “local” không có nghĩa là “chạy trên PC chơi game.” DeepSeek mô tả đây là một xương sống Mixture-of-Experts 552B tham số sử dụng kiến trúc Causal Encoder-Decoder, với chỉ 8B tham số hoạt động trong giai đoạn xử lý prompt và 16B trong giai đoạn sinh. Mô hình đầy đủ vẫn hướng tới quy mô triển khai tuyến đầu.
Công thức triển khai vLLM hiện tại đặt checkpoint khoảng 511 GB trên đĩa và tối thiểu khoảng 614 GB VRAM, khiến một máy chủ lớp 8×H200 hoặc hệ thống bộ nhớ cao tương đương thực tế hơn nhiều so với một workstation tiêu dùng.
Đối với các đội chỉ cần truy cập thay vì kiểm soát ở cấp độ trọng số, DeepSeek V4.1 Flash API trong CometAPI đơn giản hơn nhiều so với việc duy trì một máy chủ suy luận đa GPU.
Các điểm chính
- DeepSeek-V4.1-Flash sử dụng xương sống MoE 552B với 8B tham số hoạt động trong prefill và 16B trong decode; tham số hoạt động không đại diện cho yêu cầu bộ nhớ cư trú.
- Cửa sổ ngữ cảnh 1.048.576 token và global KV cache 890 byte/token của mô hình giúp giảm áp lực cache, nhưng trọng số mô hình vẫn chi phối việc lập kế hoạch dung lượng.
- Checkpoint chính thức khoảng 511 GB trên đĩa. Công thức vLLM ước tính khoảng 614 GB tổng VRAM khả dụng là ngân sách tối thiểu để nạp mô hình và chi phí runtime; đây là ước tính cơ bản, không phải đảm bảo cho mọi kích thước batch, độ dài ngữ cảnh, hay cấu hình đa phương thức.
- vLLM là con đường phục vụ sản xuất rõ ràng nhất, trong khi SGLang nhắm tới suy luận phân tán nâng cao; tuyến hiện tại của Ollama là cloud-hosted thay vì suy luận toàn bộ tại chỗ.
- Tự lưu trữ hấp dẫn nhất cho quyền riêng tư, vận hành air-gapped, nghiên cứu cấp trọng số, hoặc sử dụng cụm liên tục; đa số nhà phát triển sẽ thấy API được lưu trữ đơn giản hơn.
DeepSeek-V4.1-Flash là gì? Kiến trúc, tham số và kích thước mô hình
DeepSeek chính thức phát hành V4.1-Flash vào ngày 10 tháng 9 năm 2026 như mô hình nhỏ nhất trong họ kiến trúc mới, với khả năng hiểu hình ảnh gốc. Bất chấp tên “Flash”, đây không phải là một mô hình dense nhỏ.
Thay đổi kiến trúc chủ chốt là thiết kế Causal Encoder-Decoder (CED). Mô hình phân bổ tính toán bất đối xứng giữa việc hấp thụ prompt và sinh token, giảm compute hoạt động trong khi vẫn giữ một bể chuyên gia rất lớn.
| Thông số | DeepSeek-V4.1-Flash |
|---|---|
| Kiến trúc | MoE đa phương thức với Causal Encoder-Decoder |
| Tham số xương sống | 552B |
| Tham số hoạt động, input | 8B |
| Tham số hoạt động, output | 16B |
| Số lớp Transformer | 40: 20 encoder + 20 decoder |
| Cửa sổ ngữ cảnh | 1.048.576 token |
| Global KV cache | 890 byte/token |
| Phương thức | Input văn bản + hình ảnh, output văn bản |
| Giấy phép trọng số | MIT |
| Sampling khuyến nghị | Nhiệt độ 1.0; top_p 0.95 hoặc 1.0 |
| Trọng số chính thức | Hugging Face |
| Tùy chọn phục vụ local chính | vLLM, SGLang, DeepSeek reference inference |
Phân biệt giữa tham số hoạt động và tham số cư trú là rất quan trọng. MoE routing giảm lượng tính toán dùng cho một token riêng lẻ, nhưng máy chủ vẫn cần truy cập các trọng số chuyên gia có thể được chọn. Đó là lý do tại sao một mô hình “8B active” vẫn có thể yêu cầu hàng trăm gigabyte lưu trữ và bộ nhớ tăng tốc.
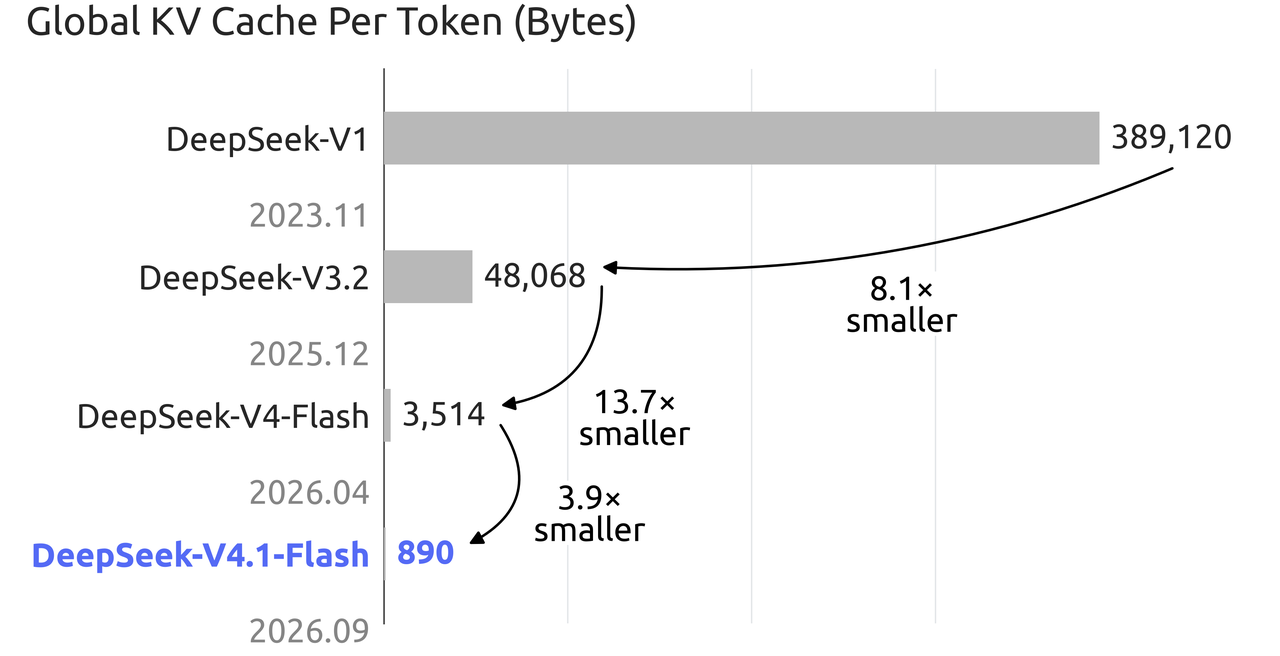
Biểu đồ KV-cache chính thức của DeepSeek cho thấy global cache giảm từ 3.514 byte mỗi token trong V4 Flash xuống 890 byte mỗi token trong V4.1 Flash, giảm khoảng 3,9×. Điều đó quan trọng đối với suy luận một triệu token, nhưng không loại bỏ yêu cầu bộ nhớ lớn hơn nhiều do chính trọng số mô hình tạo ra.
DeepSeek-V4.1-Flash tốt đến mức nào trước khi bạn triển khai?
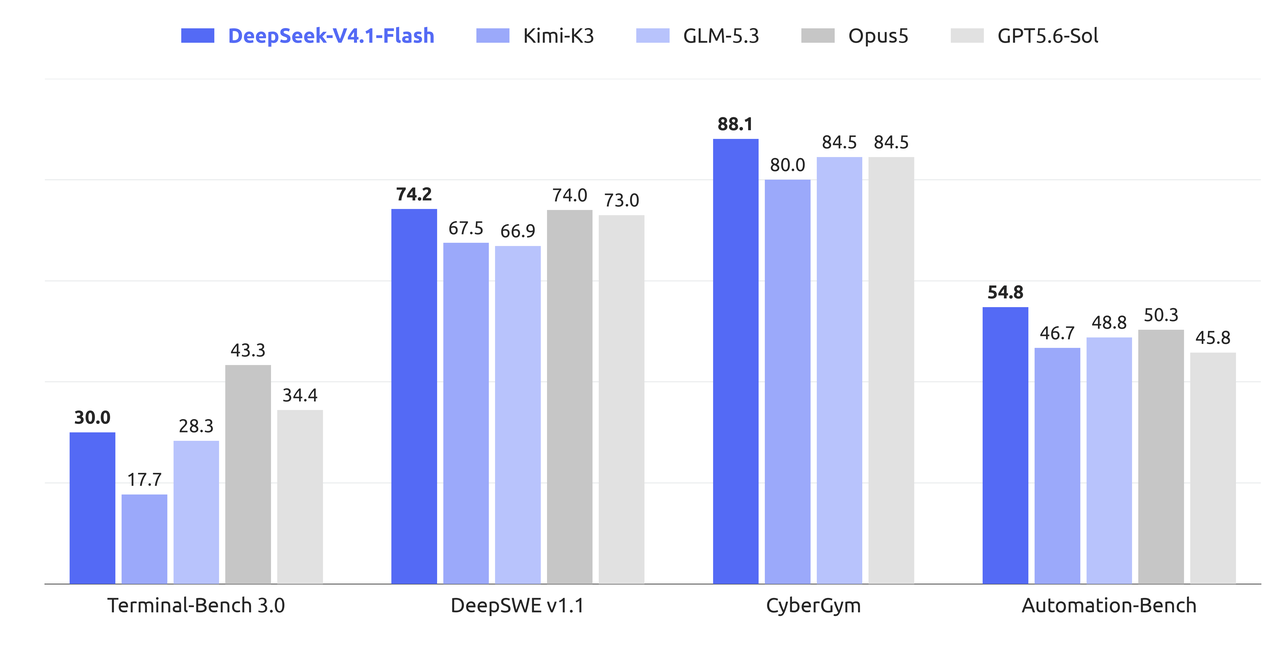
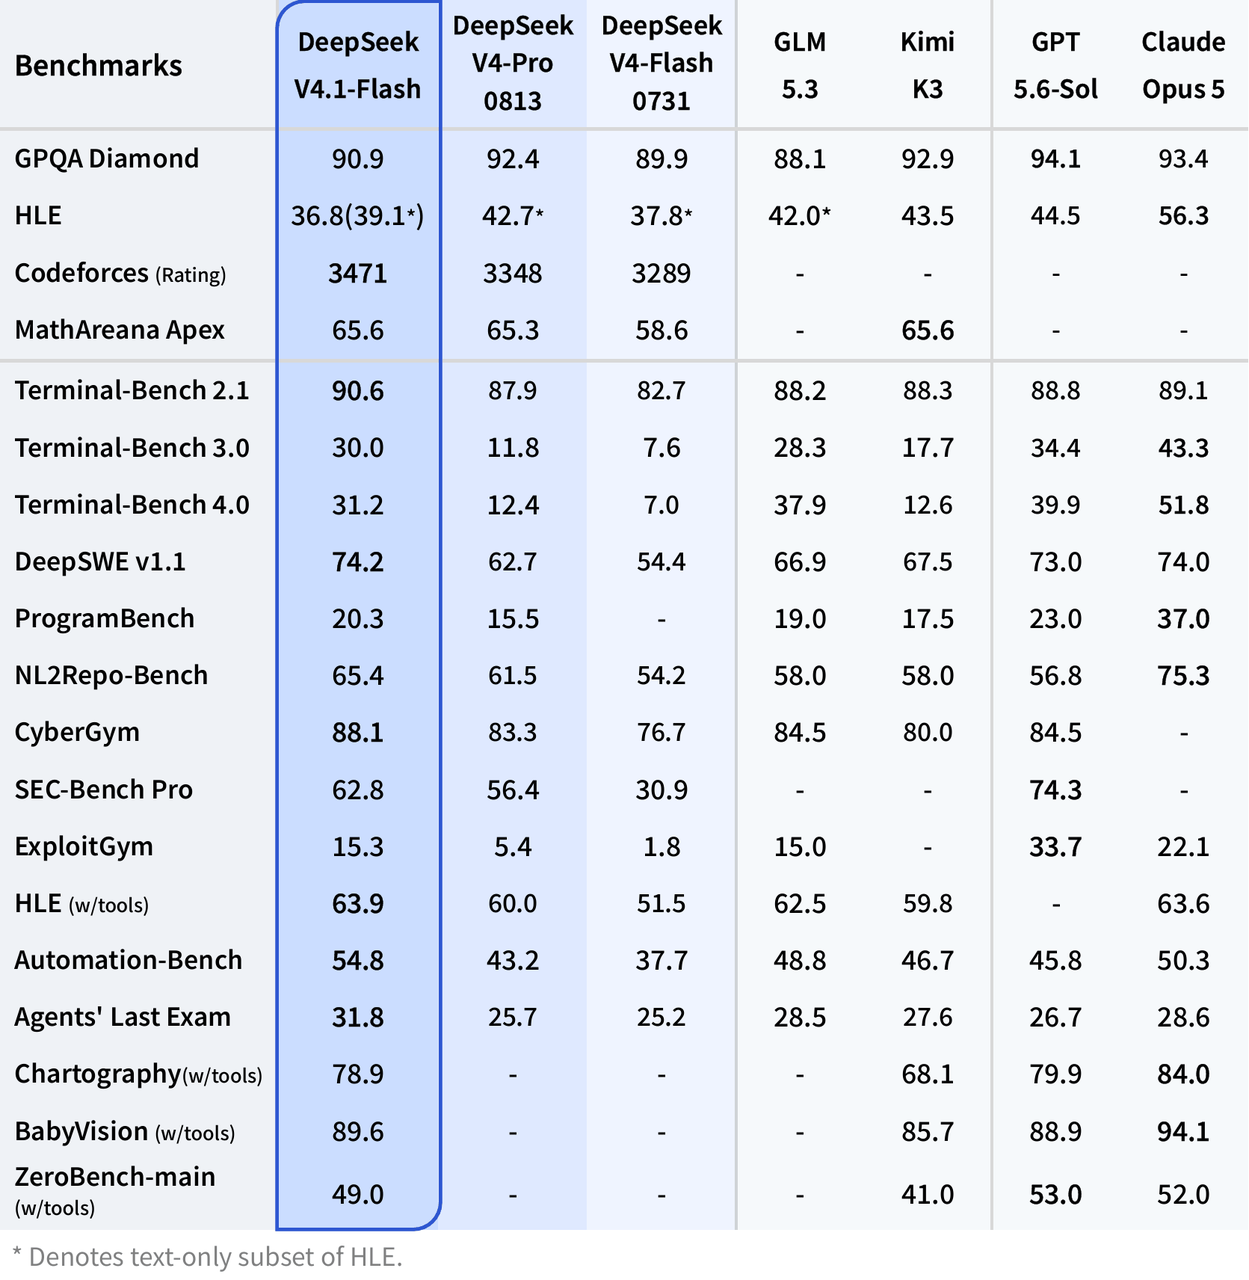
Bảng benchmark do DeepSeek công bố định vị V4.1-Flash chủ yếu là bản nâng cấp lớn cho coding theo hướng agent, vận hành terminal, tự động hóa và khối lượng công việc kỹ nghệ phần mềm. Đây là kết quả benchmark do nhà cung cấp báo cáo, nên nên coi là số đo tham chiếu thay vì hiệu năng ứng dụng được đảm bảo.
Để tái lập, model card chính thức khuyến nghị nhiệt độ 1.0 và top_p 0.95, trong khi nỗ lực reasoning và ngân sách token khác nhau theo đánh giá. Các con số dưới đây là kết quả tham chiếu do nhà cung cấp chạy, không phải đảm bảo hiệu năng trung lập phần cứng; chi tiết harness theo từng benchmark nên được tham khảo trước khi tái hiện.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
Mẫu hình quan trọng hơn bất kỳ điểm đơn lẻ nào. V4.1-Flash không dẫn đầu mọi benchmark, nhưng bước nhảy từ V4 Flash 0731 đặc biệt lớn trên Terminal-Bench, DeepSWE, tự động hóa và khối lượng cybersecurity. Điều này khiến triển khai local đặc biệt phù hợp cho coding agent riêng tư, phân tích ở quy mô repository, tự động hóa nội bộ và hạ tầng agent air-gapped.
Bạn có thực sự chạy DeepSeek-V4.1-Flash tại chỗ được không?
Có, nhưng từ “local” cần được làm rõ. Công thức DeepSeek-V4.1-Flash vLLM mới nhất phân tích checkpoint khoảng nửa terabyte và khuyến nghị ngân sách VRAM lớn hơn nhiều khi tính cả chi phí runtime.
| Thành phần | Kích thước lưu trữ xấp xỉ |
|---|---|
| Routed + DSpark experts | 259,5 GiB |
| Engram tables | 183,1 GiB |
| Attention, dense projections và routers | 6,9 GiB |
| Embeddings, LM head và norms | 3,9 GiB |
| UE8M0 block scales | 21,9 GiB |
| Full checkpoint | ~476 GiB / ~511 GB |
| Ngân sách VRAM tối thiểu vLLM khuyến nghị | ~614 GB |
Điểm bất ngờ là V4.1-Flash đã được nén nội bộ mạnh. Trọng số chuyên gia có định tuyến sử dụng định dạng low-precision, vì vậy checkpoint chính thức không đơn giản là một mô hình BF16 khổng lồ chờ chuyển đổi 4-bit dễ dàng.
Yêu cầu phần cứng của DeepSeek-V4.1-Flash
| Cấu hình phần cứng | Tình trạng thực tiễn | Ghi chú |
|---|---|---|
| 1× RTX 4090 / 5090 | Không | Thấp xa so với dấu chân bộ nhớ của mô hình |
| 2–4 GPU tiêu dùng | Không cho full checkpoint chính thức | Tổng VRAM vẫn không đủ |
| Workstation 128 GB | Không | Tham số hoạt động không quyết định bộ nhớ cư trú trọng số |
| Workstation 256 GB | Không cho tuyến phục vụ chính thức | Vẫn thấp hơn nhiều so với dấu chân checkpoint chính thức |
| 512 GB RAM + GPU offload | Thử nghiệm | Lãnh thổ cộng đồng/offload, không tương đương tuyến phục vụ sản xuất đã xác minh |
| 4× GPU datacenter bộ nhớ cao | Tùy phần cứng | Có thể nếu accelerator hiện đại đủ lớn; kiểm tra công thức runtime |
| 8× H200 | Có, lớp đã được ghi nhận | Khoảng 1.128 GB HBM tổng |
| Hệ thống lớp GB200 NVL4 | Có | vLLM dẫn chiếu một khay 768 GB là vừa mô hình |
Quan trọng: 8B tham số hoạt động không có nghĩa 8 GB VRAM. “Hoạt động” mô tả mức mạng MoE tham gia tính toán cho một token. Toàn bộ tập chuyên gia vẫn phải được lưu trữ ở đâu đó để engine suy luận có thể truy cập.
Nên dùng runtime nào cho DeepSeek-V4.1-Flash?
| Runtime | Trạng thái V4.1-Flash hiện tại | Trường hợp tốt nhất |
|---|---|---|
| vLLM | Có công thức triển khai hiện tại; cần image mới | Phục vụ sản xuất tương thích OpenAI |
| SGLang | Hỗ trợ qua build triển khai DeepSeek-V4.1 hiện tại | Suy luận phân tán hiệu năng cao |
| DeepSeek reference inference | Triển khai tham chiếu TP8 chính thức | Nghiên cứu kiến trúc và xác thực |
| Transformers | Tích hợp mô hình trên Hugging Face | Phát triển và thử nghiệm; vẫn cần phần cứng |
| Ollama | Tuyến thư viện chính thức hiện dùng :cloud | Gọi cloud tiện lợi, không tương đương tự lưu trữ |
Đối với tự lưu trữ sản xuất, vLLM hiện là điểm khởi đầu rõ ràng nhất. Hướng dẫn triển khai SGLang cung cấp một tuyến khác được hỗ trợ cho suy luận phân tán nâng cao.
Cách chạy DeepSeek-V4.1-Flash local bằng vLLM
Đây là lộ trình thực tế cho một máy chủ Linux đa GPU.
Tất cả ví dụ lệnh bên dưới được định dạng lại thành các khối mã theo ngôn ngữ với mô tả tiếng Anh ngắn gọn.
Bước 1: Kiểm tra môi trường của bạn
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- Vài trăm gigabyte dung lượng SSD trống.
- Cấu hình đa GPU được hỗ trợ.
- Khoảng 614 GB tổng bộ nhớ tăng tốc khả dụng cho hồ sơ phục vụ trọng số chính thức hiện tại.
- Mạng nhanh nếu mô hình chưa được cache cục bộ.
Bước 2: Tải trọng số DeepSeek-V4.1-Flash
Trọng số chính thức được lưu trữ trong kho Hugging Face DeepSeek-V4.1-Flash theo giấy phép MIT.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Đảm bảo hệ thống tệp giữ ~./.cache/huggingface có dung lượng trống lớn hơn đáng kể so với 511 GB. Tệp tạm và các hiện vật engine bổ sung có thể làm tăng mức sử dụng đỉnh trên đĩa.
Bước 3: Khởi động DeepSeek-V4.1-Flash với vLLM
Theo công thức vLLM hiện tại, hỗ trợ DeepSeek-V4.1 yêu cầu image vLLM đủ mới. Một cấu hình khởi điểm văn bản-only với tám GPU có thể như sau:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
Có hai lựa chọn cố ý ở đây. Thứ nhất, --language-model-only vô hiệu hóa bộ mã hóa thị giác cho khối lượng công việc chỉ văn bản. Thứ hai, bắt đầu ở 131.072 token an toàn hơn so với bật ngay cửa sổ ngữ cảnh một triệu token. Khi máy chủ ổn định, bạn có thể tăng nó:
--max-model-len 1048576
Thiết lập tensor-parallel phù hợp phụ thuộc vào topology của accelerator, vì vậy đừng sao chép --tensor-parallel-size 8 một cách mù quáng cho mọi máy chủ.
Bước 4: Kiểm thử endpoint DeepSeek-V4.1-Flash local
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Bước 5: Gọi máy chủ DeepSeek-V4.1-Flash local bằng Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
Làm thế nào bật Thinking Mode của DeepSeek-V4.1-Flash local?
V4.1-Flash hỗ trợ kiểm soát reasoning rõ ràng thông qua chat template. Một ví dụ:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Nếu mô hình dường như trả về rất ít hoặc không có nội dung cuối cùng với giá trị max_tokens nhỏ, hãy kiểm tra xem thinking mode có đang tiêu thụ ngân sách sinh hay không trước khi cho rằng triển khai bị lỗi.
Chạy DeepSeek-V4.1-Flash bằng mã tham chiếu như thế nào?
DeepSeek cũng bao gồm một triển khai suy luận TP8 tối giản trong kho mô hình. Nó chủ yếu nhằm mục đích làm mã tham chiếu dễ đọc hơn là máy chủ sản xuất throughput cao.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
Tuyến này hữu ích để kiểm tra CED, MoE routing, Engram memory, speculative decoding và các chi tiết triển khai liên quan. Đối với phục vụ sản xuất bình thường, vLLM hoặc SGLang dễ vận hành hơn.
Có thể chạy DeepSeek-V4.1-Flash local với Ollama không?
Không theo cùng nghĩa với việc chạy một mô hình Ollama 7B hoặc 32B thông thường. Ollama hiện phơi bày V4.1-Flash qua:
ollama run deepseek-v4.1-flash:cloud
Điểm quan trọng là :cloud. Mục thư viện Ollama hiện tại sử dụng tuyến cloud, vì vậy lệnh này không tương đương với việc tải về toàn bộ mô hình và thực hiện suy luận hoàn toàn trên máy của bạn.
Triển khai DeepSeek-V4.1-Flash local vs API: Phương án nào hợp lý hơn?
| Chiều | DeepSeek-V4.1-Flash local | Hosted API |
|---|---|---|
| Phần cứng ban đầu | Rất cao | Không |
| Bộ nhớ tăng tốc | ~614 GB mục tiêu chính thức thực tiễn | Nhà cung cấp quản lý |
| Kiểm soát mô hình | Toàn phần | Hạn chế |
| Dữ liệu tại chỗ | Có | Không |
| Sửa đổi trọng số | Có | Không |
| Bảo trì | Trách nhiệm của bạn | Nhà cung cấp quản lý |
| Độ phức tạp thiết lập | Cao | Thấp |
| Mở rộng | Yêu cầu hạ tầng | Dựa trên API |
| Phù hợp nhất cho | Air-gapped, riêng tư, nghiên cứu, cụm sử dụng cao | Hầu hết dev và ứng dụng sản xuất |
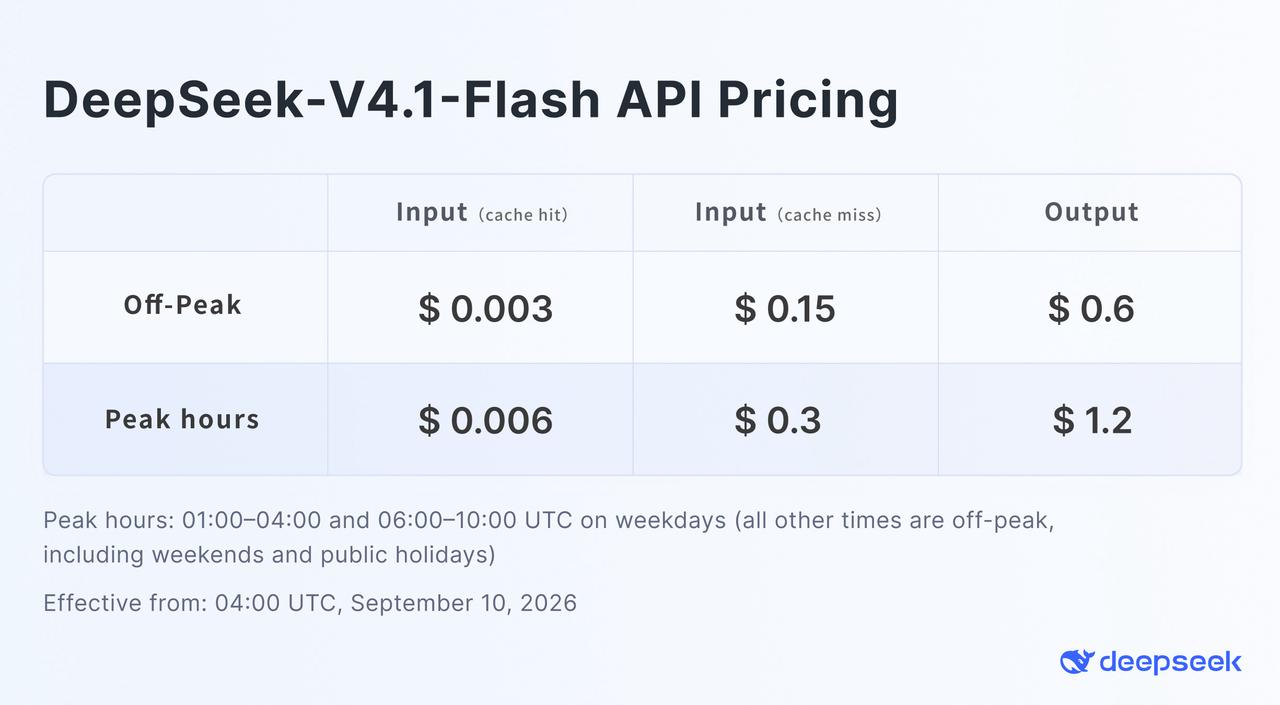
Bảng giá off-peak chính thức của DeepSeek được hiển thị trong đồ họa giá V4.1-Flash của họ. Đối với nhà phát triển không cần sở hữu vật lý trọng số, DeepSeek V4.1 Flash API trong CometAPI cung cấp một lựa chọn tương thích OpenAI. Ví dụ sau dùng định danh model của CometAPI. Đây không phải là định danh dùng bởi API chính thức của DeepSeek.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
Quyết định thực tiễn khá rõ: triển khai local trở nên hấp dẫn khi quyền riêng tư, vận hành air-gapped, thử nghiệm cấp trọng số, sử dụng nặng có thể dự đoán, hoặc yêu cầu quy định vượt trội so với chi phí hạ tầng. Với phát triển ứng dụng thông thường, một endpoint được lưu trữ tránh được hàng trăm gigabyte quản trị mô hình và điều phối đa GPU.
Những vấn đề có thể gặp khi chạy DeepSeek-V4.1-Flash local?
Máy chủ hết bộ nhớ trước khi bắt đầu sinh
Checkpoint đầy đủ, không phải số 8B/16B tham số hoạt động, quyết định phần lớn yêu cầu bộ nhớ. Kiểm tra tensor parallelism, mức sử dụng bộ nhớ GPU, nạp vision và HBM sẵn có.
DeepSeek-V4.1-Flash khởi động rất lâu
Một checkpoint nửa terabyte cần thời gian để tải, map, khởi tạo và chia shard. Thời gian chờ engine-ready dài là bình thường đối với lớp mô hình này.
Phản hồi rỗng hoặc kết thúc với finish_reason=length
Thinking mode có thể đang tiêu thụ ngân sách sinh. Tăng max_tokens, giảm reasoning effort, hoặc tắt thinking cho các yêu cầu đơn giản.
Tool call phân tích không đúng
Đảm bảo máy chủ dùng tokenizer, tool-call parser, reasoning parser của DeepSeek V4.1 và các cờ auto-tool-choice.
Input hình ảnh không hoạt động
Nếu bạn khởi động với --language-model-only, bạn đã cố ý vô hiệu hóa bộ mã hóa thị giác. Khởi động lại với hỗ trợ đa phương thức bật trước khi thử hình ảnh.
Có nên chạy DeepSeek-V4.1-Flash local?
DeepSeek-V4.1-Flash đặc biệt thú vị từ góc độ tự lưu trữ vì kiến trúc của nó giảm đáng kể compute trên mỗi token và chi phí KV-cache, nhưng nó không biến một mô hình open-weight tuyến đầu thành một mô hình desktop.
Đối với phòng thí nghiệm nghiên cứu, nền tảng AI doanh nghiệp, stack coding agent riêng tư hoặc môi trường air-gapped, vLLM và SGLang khiến tự lưu trữ trở nên khả thi về mặt kỹ thuật. Đối với một nhà phát triển chỉ có một hoặc hai GPU, đây không phải mục tiêu triển khai full-model thực tế. Trong trường hợp đó, dùng DeepSeek V4.1 Flash qua CometAPI giúp truy cập mô hình mà không biến việc phục vụ thành một dự án hạ tầng lớn.
Câu hỏi thường gặp
DeepSeek-V4.1-Flash có phải open source không?
Trọng số và kho của mô hình được phát hành theo giấy phép MIT, cho phép sử dụng, sửa đổi và phân phối rộng rãi theo các điều khoản của giấy phép.
Tôi có thể chạy DeepSeek-V4.1-Flash trên RTX 4090 hoặc RTX 5090 không?
Không đối với full model chính thức. Một GPU tiêu dùng đơn lẻ chỉ có một phần nhỏ bộ nhớ cần thiết cho checkpoint đầy đủ.
8B tham số hoạt động có nghĩa DeepSeek-V4.1-Flash chỉ cần 8 GB VRAM không?
Không. Con số 8B mô tả các tham số tham gia trong quá trình xử lý prompt. Toàn bộ mạng chuyên gia và trạng thái hỗ trợ vẫn phải được lưu trữ và truy cập.
DeepSeek-V4.1-Flash cần bao nhiêu VRAM?
Công thức vLLM hiện tại sử dụng khoảng 614 GB làm con số lập kế hoạch cho checkpoint chính thức cộng chi phí runtime. Nhu cầu thực tế thay đổi theo phần cứng, kích thước batch, ngữ cảnh, hỗ trợ vision và cấu hình phục vụ.
DeepSeek-V4.1-Flash lớn bao nhiêu trên đĩa?
Phân tích của vLLM đặt checkpoint khoảng 476 GiB, tương đương khoảng 511 GB.
DeepSeek-V4.1-Flash có thể chạy ngữ cảnh 1M token local không?
Kiến trúc hỗ trợ tới 1.048.576 token, nhưng sử dụng bộ nhớ thực tế còn phụ thuộc kích thước batch, bộ đệm runtime, trạng thái vision và chi phí overhead khác.
Tôi có thể chạy DeepSeek-V4.1-Flash local với Ollama không?
Mục Ollama hiện tại sử dụng tuyến :cloud, không giống với việc chạy toàn bộ trọng số hoàn toàn trên máy của bạn.
vLLM hay SGLang tốt hơn cho DeepSeek-V4.1-Flash?
Cả hai đều nhắm tới phục vụ hiệu năng cao. vLLM hiện có công thức cụ thể cho V4.1 khá chi tiết, trong khi SGLang cũng phù hợp cho triển khai phân tán nâng cao.
Cách dễ nhất để dùng DeepSeek-V4.1-Flash mà không cần phần cứng local là gì?
Dùng API lưu trữ. DeepSeek cung cấp API riêng, trong khi CometAPI cung cấp endpoint DeepSeek-V4.1-Flash tương thích OpenAI cùng với các mô hình AI khác.