
TL;DR
Kimi K3.1 Pro là bản nâng cấp ngày 24 tháng 10, 2026 của Moonshot AI cho Kimi K3. Hậu huấn luyện bổ sung cải thiện lập trình tự động, nghiên cứu tài chính và các quy trình sử dụng công cụ mở rộng, đồng thời vẫn giữ dung lượng ngữ cảnh xấp xỉ một triệu token.
Đánh giá độc lập cho thấy hiệu năng tổng thể mạnh hơn, và mức giá chuẩn cho token vào/ra chính thức giảm một phần ba. Bản nâng cấp vẫn cần kiểm thử khối lượng công việc: suy luận sâu hơn có thể làm tăng độ trễ tác vụ và tổng chi phí, trong khi K3 vẫn giữ lợi thế nhỏ trên AA-LCR và trọng số hiện có để tự lưu trữ.
Key Takeaways
- Sự cải thiện rõ rệt nhất là ở thực thi mang tính tác tử. Artificial Analysis báo cáo điểm Terminal-Bench 4.0 xấp xỉ 67% cho K3.1 Pro so với 13% cho K3; điểm Financial Research nội bộ của Moonshot tăng từ 58.8 lên 70.4.
- Giá token thấp hơn không đảm bảo chi phí tác vụ thấp hơn. Mức giá chuẩn vào/ra chính thức giảm từ $3/$15 xuống $2/$10 mỗi triệu token, nhưng suy luận bổ sung, gọi công cụ và thử lại có thể bù trừ khoản tiết kiệm này.
- Cửa sổ ngữ cảnh giữ nguyên. Cả hai mô hình hỗ trợ tối đa 1,048,576 token. K3 nhỉnh hơn một chút trong đánh giá AA-LCR v1.1 đã dẫn, nên hãy tự kiểm thử độ chính xác ngữ cảnh dài trên tài liệu của bạn.
- Tính sẵn có của trọng số có thể quyết định lựa chọn. Tính đến ngày 24 tháng 10, 2026, trọng số K3 đã có; trọng số K3.1 Pro dự kiến phát hành trước ngày 4 tháng 11. Các đội cần tự lưu trữ ngay nên tính đến khác biệt này.
Kimi K3.1 Pro vs Kimi K3: Tổng quan và Thông số
Kimi K3.1 Pro được xây dựng trên K3 thông qua hậu huấn luyện bổ sung, tập trung cải thiện lập trình, nghiên cứu tài chính và các quy trình tác tử mở rộng. Cả hai đều giữ ngữ cảnh khoảng một triệu token. Khác biệt chính là hiệu năng tác vụ, định giá token, phương án phục vụ và tính sẵn có của trọng số.
| Specification | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Developer | Moonshot AI | Moonshot AI |
| Release date | October 24, 2026 | July 16, 2026 |
| Architecture | MoE dẫn xuất từ K3, hậu huấn luyện thêm | MoE với KDA, AttnRes |
| Model size | Lớp 3T và 104B tham số kích hoạt | 2.8T tổng và 104B tham số kích hoạt |
| Context window | Tối đa 1,048,576 token | Tối đa 1,048,576 token |
| Standard API input / output price | $2 / $10 mỗi triệu token | $3 / $15 mỗi triệu token |
| Highspeed version | Có | Không có biến thể K3 Highspeed riêng được liệt kê |
| Weight availability | Dự kiến phát hành trước 4 Nov, 2026 | Sẵn có theo Giấy phép Kimi K3 |
Thông tin về trọng số phản ánh tình hình đến ngày 24 tháng 10, 2026. Giá API tính bằng USD cho đầu vào và đầu ra thông thường, không bao gồm phí ghi bộ nhớ đệm, thuế và các khoản phí áp dụng khác.
Kiến trúc và Hậu huấn luyện
K3 giới thiệu kiến trúc 2.8 nghìn tỷ tham số kết hợp Kimi Delta Attention, Attention Residuals và Stable LatentMoE. Mỗi token kích hoạt xấp xỉ 104 tỷ tham số.
Moonshot mô tả K3.1 Pro là phiên bản hậu huấn luyện của K3 được phát triển với lượng tính toán hậu huấn luyện lớn hơn đáng kể. Bản nâng cấp tập trung vào áp dụng năng lực của mô hình cho các tác vụ nhiều bước, bao gồm sử dụng công cụ, gỡ lỗi và xác minh kết quả. Thông báo không giới thiệu kiến trúc nền riêng có tên khác.
Năng lực chung và Yêu cầu API
Cả hai mô hình đều hỗ trợ đầu vào đa phương thức, gọi công cụ, đầu ra có cấu trúc và bộ nhớ đệm ngữ cảnh. Định dạng ảnh và video đầu vào phụ thuộc vào tuyến API được chọn. Cả hai luôn thực hiện suy luận và hỗ trợ mức nỗ lực suy luận low, high và max, với max là mặc định.
Đối với hội thoại nhiều lượt và gọi công cụ, tích hợp phải bảo toàn đầy đủ thông điệp trợ lý, bao gồm nội dung suy luận và các lần gọi công cụ, theo yêu cầu của API. Giới hạn ngữ cảnh thực tế và tính sẵn có của tính năng cũng cần được kiểm tra theo nhà cung cấp, sản phẩm và hạng thuê bao đã chọn.
Kimi K3.1 Pro vs Kimi K3: Hiệu năng
Bằng chứng đến từ các bài kiểm thử nội bộ của Moonshot và so sánh được báo cáo, cùng với các đánh giá độc lập của bên thứ ba.
Cần diễn giải riêng vì khung đánh giá, bộ đề, thiết lập suy luận và tiêu chí chấm điểm có thể khác nhau.
Bài đánh giá ra mắt của Artificial Analysis báo cáo mức tăng 11 điểm trên Chỉ số Trí tuệ tổng hợp, với cải thiện lớn ở lập trình dựa trên terminal và quy trình tác tử.
| Independent Benchmark (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Difference |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 điểm phần trăm |
| AutomationBench-AA | 58% | 73% | +15 điểm phần trăm |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 điểm phần trăm |
| AA-Omniscience hallucination rate | 53% | 44% | −9 điểm phần trăm |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 điểm phần trăm |
Đây là các kết quả đánh giá độc lập. Giá trị làm tròn được sử dụng khi bên đánh giá báo cáo điểm số đã làm tròn. Tỷ lệ ảo giác thấp hơn là tốt hơn.
Cải thiện lớn nhất xuất hiện ở lập trình dựa trên terminal. K3.1 Pro thể hiện tốt hơn đáng kể trên các tác vụ yêu cầu thực thi lệnh, tương tác môi trường, gỡ lỗi và xác minh lặp lại.
AutomationBench-AA cũng cho thấy mức tăng đáng kể, gợi ý khả năng thực thi mạnh hơn trong các quy trình phần mềm dạng dịch vụ.
Benchmark phát hành của Moonshot tập trung vào lập trình, khoa học, tái tạo 3D, tài chính, công việc tri thức và tác tử tự động.
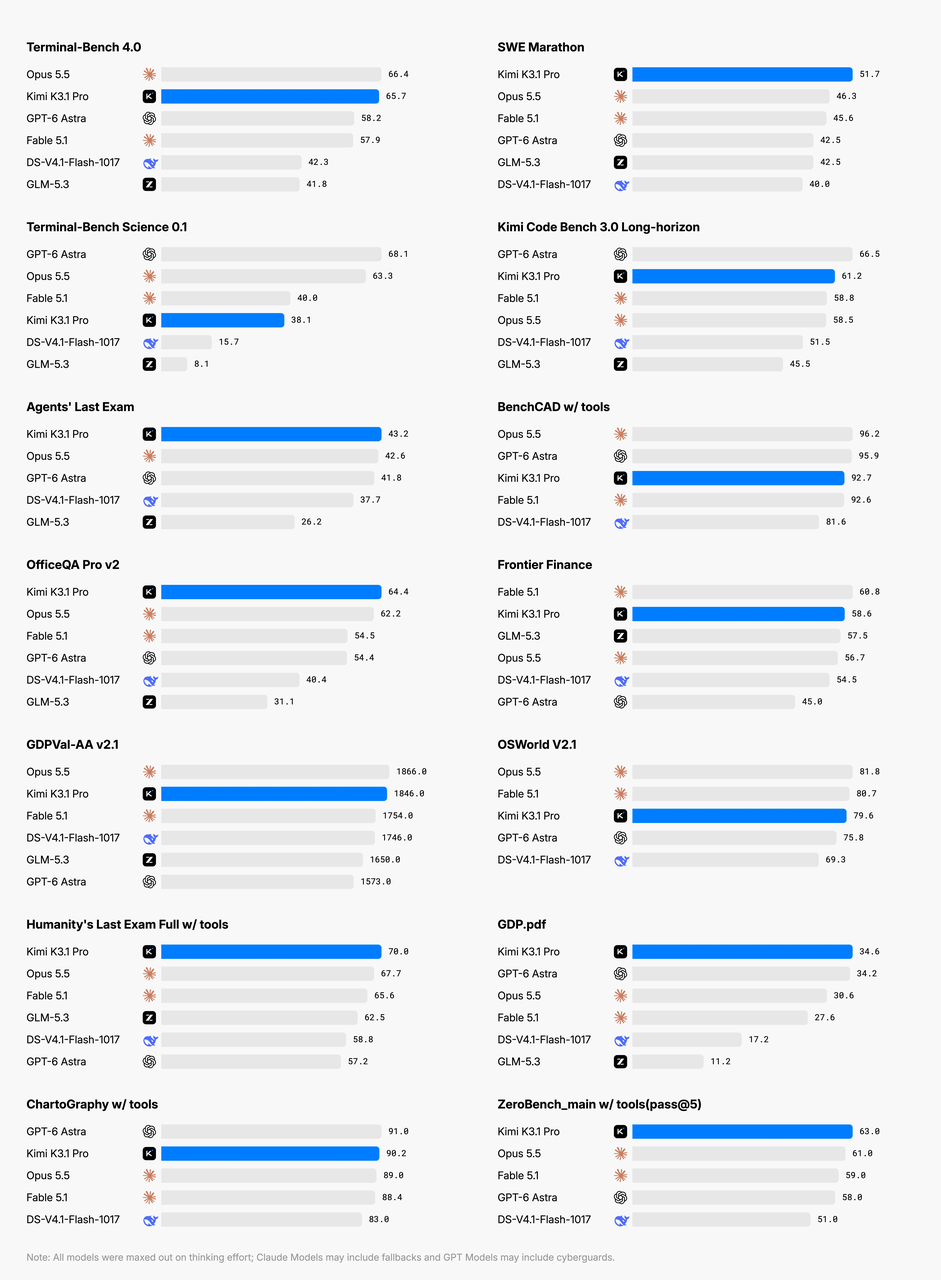
Các so sánh đã chọn bao gồm Claude Opus 5.5 và GPT-6 Astra. So sánh từng kết quả trong phạm vi benchmark được nêu và cấu hình đã chỉ định.
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Model khác | Điểm mô hình so sánh |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD with tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
K3.1 Pro tiệm cận hoặc vượt qua một số mô hình độc quyền hàng đầu trong các tác vụ được chọn. Nhưng nó không vượt trội ở mọi hạng mục.
Ví dụ, nó vẫn xếp sau Claude Opus 5.5 trong so sánh BenchCAD và OSWorld do nhà cung cấp báo cáo, và biểu đồ chính thức cho thấy điểm yếu lớn hơn ở Terminal-Bench Science.
Thiết lập đánh giá khác nhau: Artificial Analysis dùng bộ khung mini-swe-agent cho Terminal-Bench 4.0, còn Moonshot dùng Claude Code. Hãy so sánh điểm số trong cùng bộ kiểm tra; bộ khung, mức nỗ lực suy luận và giới hạn thời gian chạy có thể ảnh hưởng kết quả.
Lập trình và Kỹ thuật phần mềm
Đối với lập trình tự động phức tạp, K3.1 Pro thường là lựa chọn mạnh hơn.
Kết quả Kimi Code Bench 3.0 Long-horizon nội bộ của Moonshot tăng từ 55.95% với K3 lên 61.2% với K3.1 Pro, tăng khoảng 5.25 điểm phần trăm.
Kết quả Terminal-Bench độc lập cũng cho thấy mức tăng đáng kể. Các bài này đánh giá thực thi nhiều bước: hiểu kho mã, thay đổi tệp, chạy lệnh, chẩn đoán lỗi và xác minh kết quả.
K3.1 Pro là ứng viên mạnh hơn cho phát triển nhiều tệp, làm việc tự động với terminal và gỡ lỗi mở rộng. Với tạo mã đơn giản, hãy so sánh cả hai trên tác vụ riêng; K3 vẫn là lựa chọn ngay lập tức khi cần tự lưu trữ.
Một khác biệt quan trọng là điểm số benchmark lập trình phụ thuộc rất lớn vào khung tác tử. Công cụ, prompt, giới hạn thời gian chạy và môi trường kiểm thử ảnh hưởng kết quả.
Đối với phát triển phần mềm sản xuất, đánh giá tốt nhất vẫn là so sánh phù hợp trên kho mã của chính bạn.
Nghiên cứu tài chính và Vận hành doanh nghiệp
Mô hình tài chính cung cấp một số so sánh trực tiếp rõ ràng nhất giữa hai mô hình.
Moonshot kiểm thử cả K3 và K3.1 Pro trên các đánh giá nội bộ bao trùm xây dựng bảng tính, chất lượng nghiên cứu và vận hành doanh nghiệp mô phỏng.
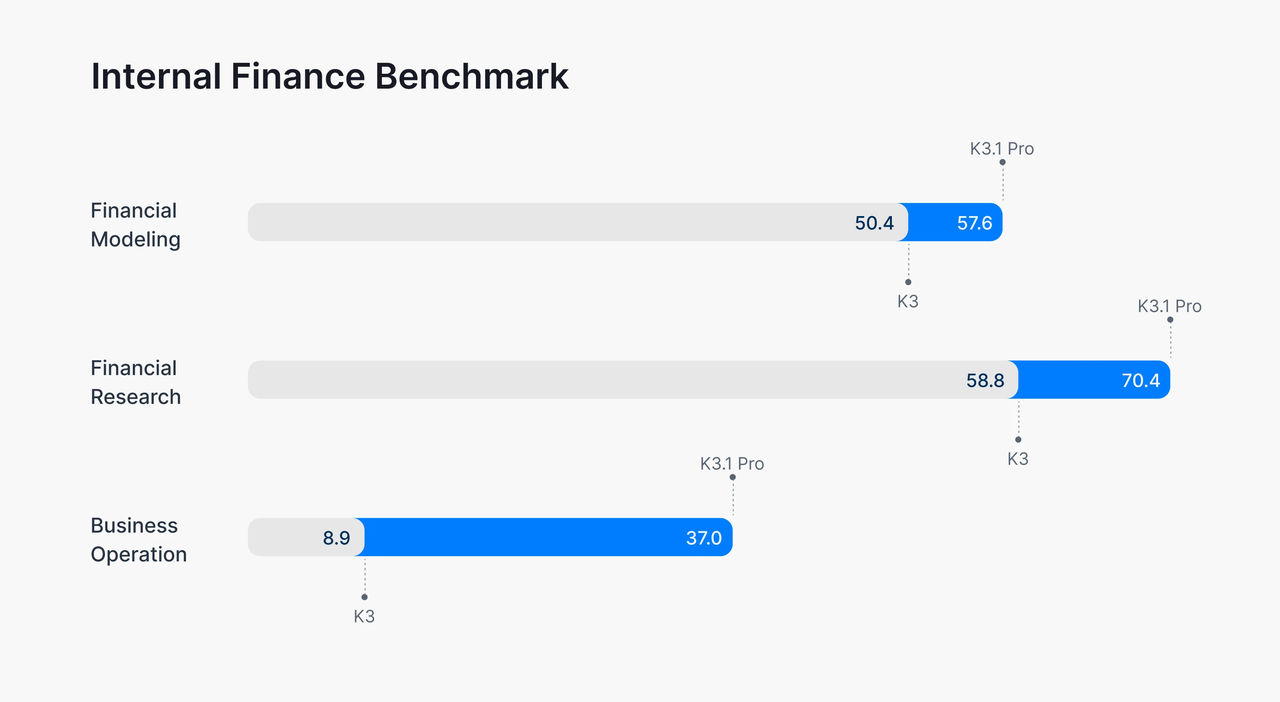
Kết quả tài chính nội bộ của Moonshot bao gồm mô hình tài chính, nghiên cứu và vận hành doanh nghiệp mô phỏng. Các điểm số tác vụ do nhà cung cấp báo cáo này không phải là đo lường lợi nhuận đầu tư. Thiết lập theo tác vụ không nên được giả định là giống với các benchmark không liên quan.
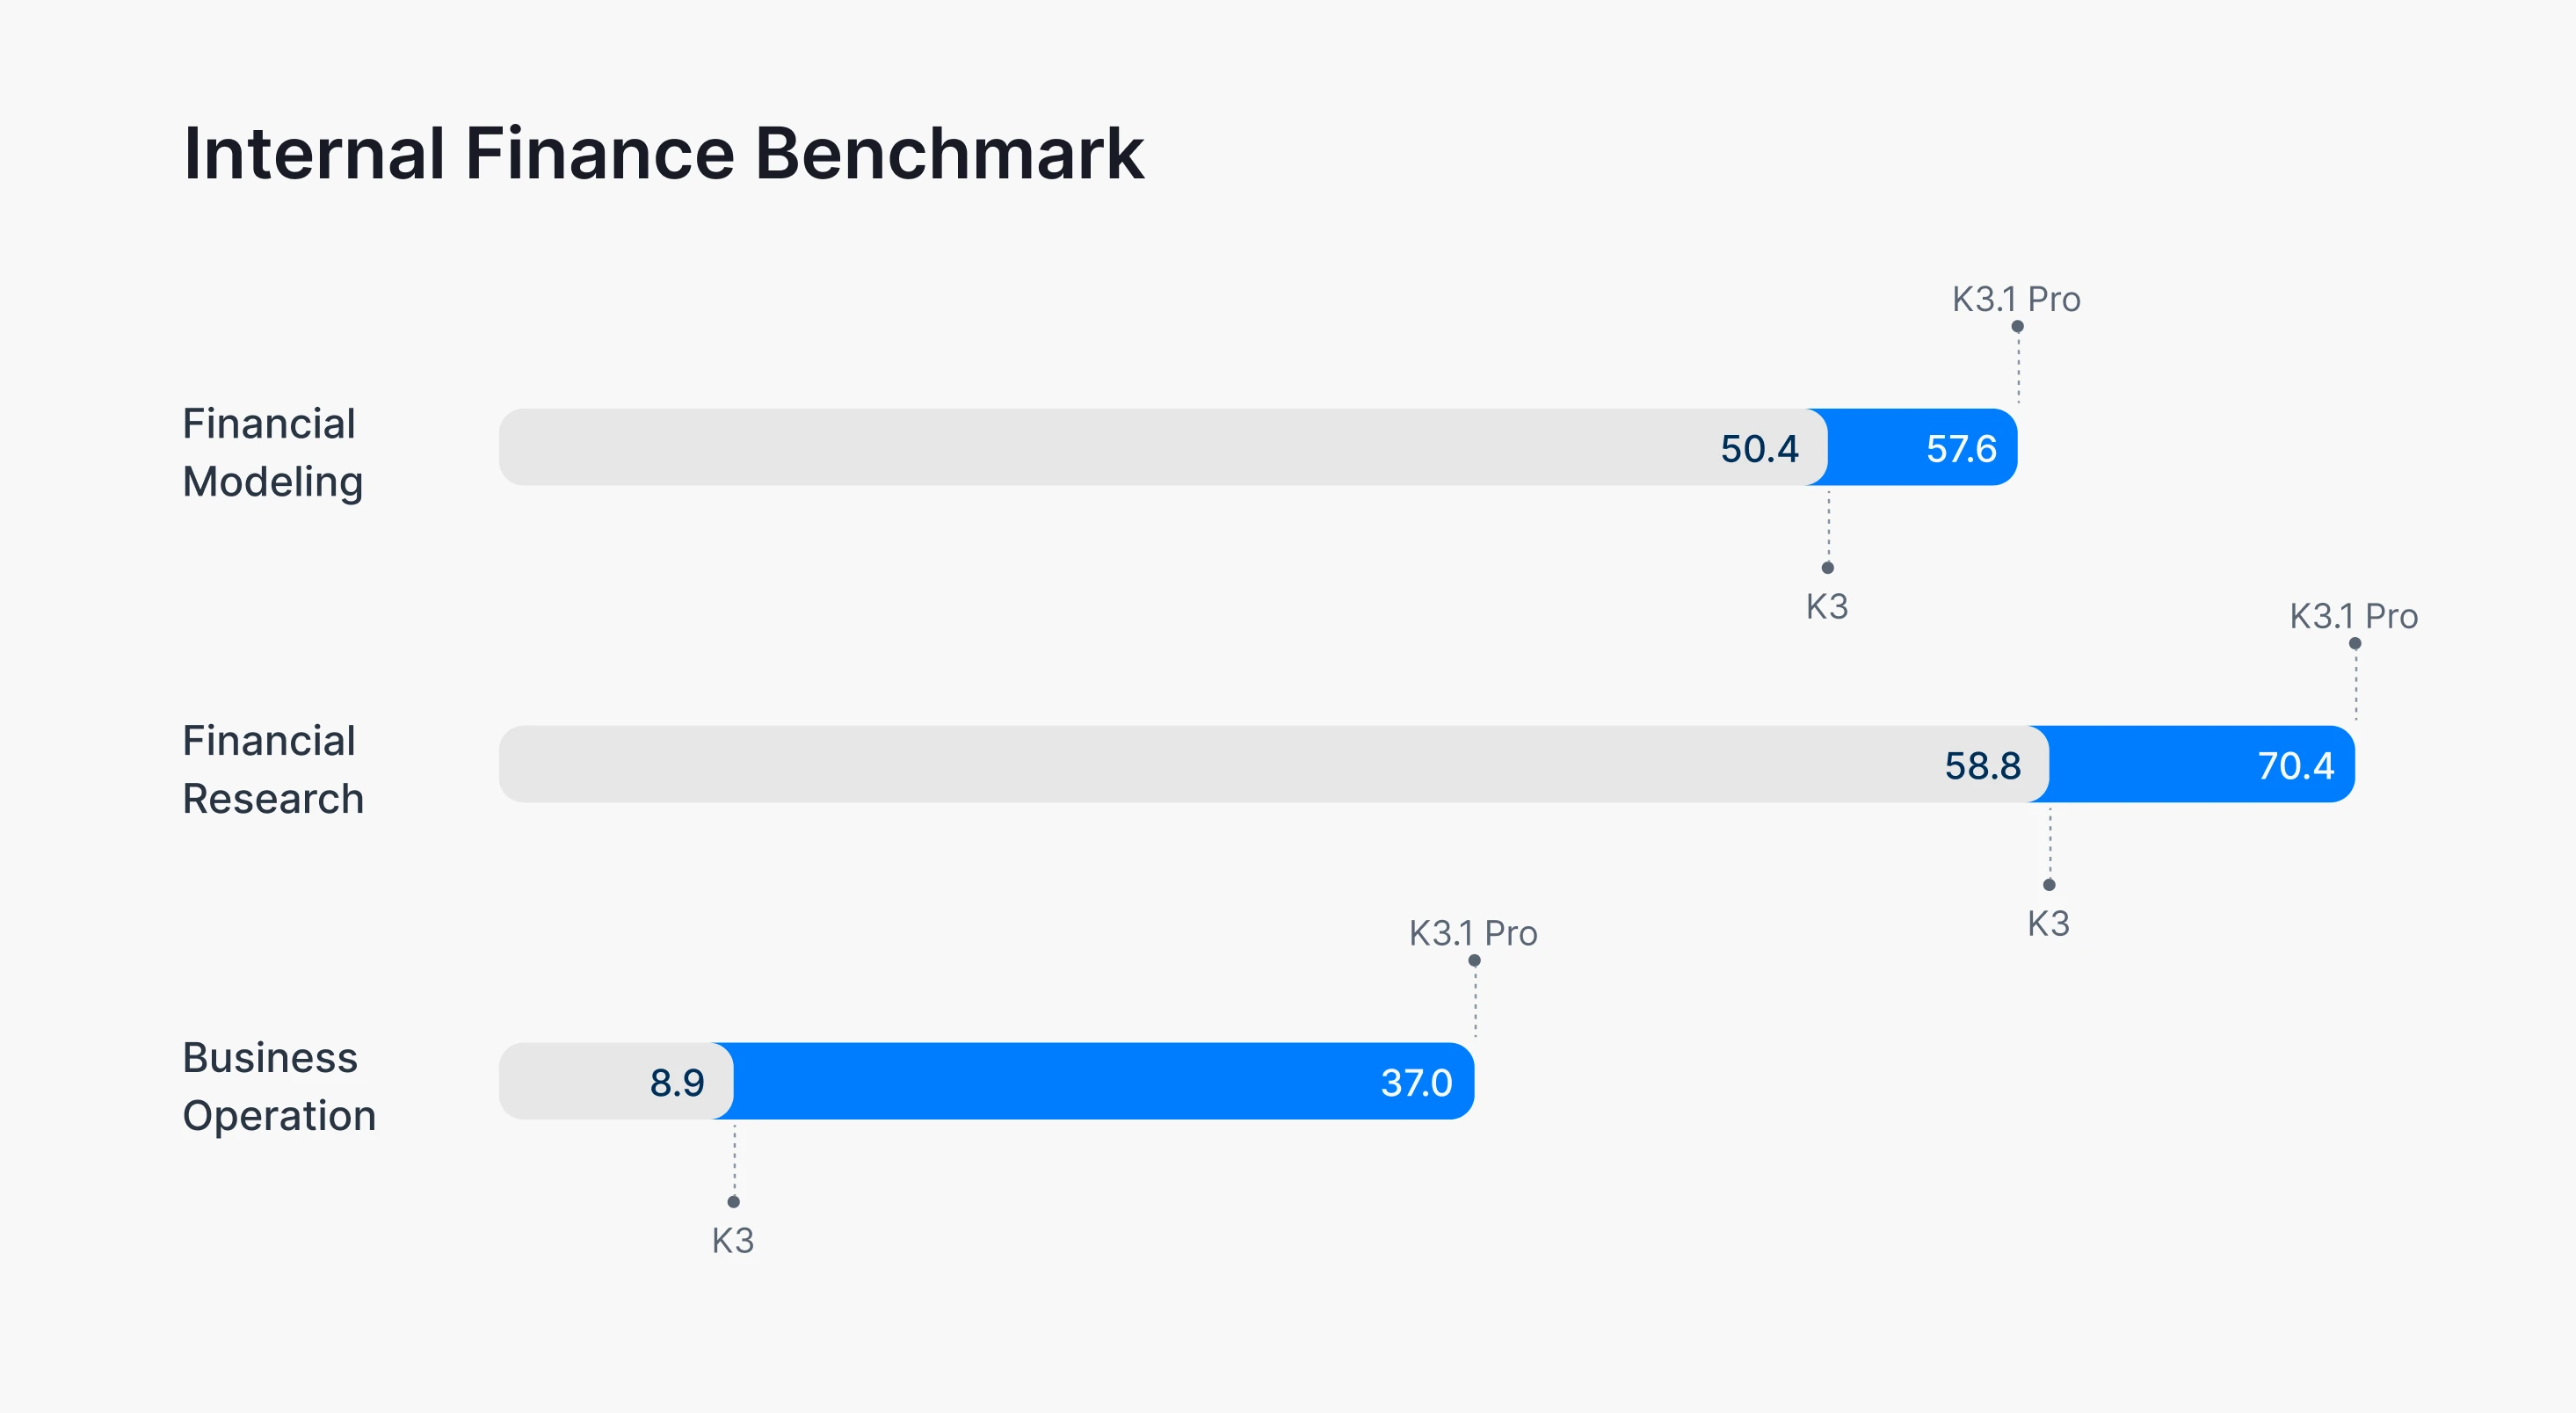
Trong kiểm thử nội bộ của Moonshot, Financial Modeling tăng từ 50.4 lên 57.6, tăng 7.2 điểm, và Financial Research tăng từ 58.8 lên 70.4, tăng 11.6 điểm. Business Operation tăng từ 8.9 lên 37.0, khoảng 4.2 lần điểm K3.
Benchmark này đánh giá quản trị và ra quyết định dài hạn trong môi trường doanh nghiệp mô phỏng. Vì vậy, nó liên quan chặt chẽ hơn đến lập kế hoạch tác tử thay vì hỏi đáp tài chính đơn giản.
Financial Research đo năng lực tạo nghiên cứu dựa trên bằng chứng đồng thời tuân thủ yêu cầu nguồn và mốc cắt thông tin. Financial Modeling tập trung vào quan hệ toán học, logic bảng tính và chất lượng workbook.
Mẫu hình gợi ý K3.1 Pro đặc biệt hữu ích khi tác vụ tài chính đòi hỏi suy luận bền bỉ, xác minh và sản phẩm đầu ra có cấu trúc.
Đối với nhà đầu tư, nhà phân tích và người dùng doanh nghiệp, lợi ích thực tế là khả năng xử lý tốt hơn các quy trình nhiều tài liệu. Không mô hình nào nên được dùng như thẩm quyền không cần kiểm tra cho quyết định tài chính.
Suy luận ngữ cảnh dài và Độ tin cậy thực chứng
Tuy nhiên, kết quả ngữ cảnh dài AA-LCR cho thấy K3 nhỉnh hơn. Đây là lời nhắc hữu ích rằng một mô hình mới hơn có thể cải thiện đáng kể tổng thể nhưng không thắng trong mọi tác vụ chuyên biệt.
Các đánh giá được báo cáo cho thấy ít lỗi thực chứng hơn trên bộ đề tương ứng.
Trên Kimi Hallu Bench Hard với công cụ, Moonshot báo cáo tỷ lệ lỗi cấp độ mệnh đề giảm từ 23.4% với K3 xuống 8.3% với K3.1 Pro.
Đó là khoảng 65% giảm tương đối trên bài kiểm tra căng thẳng cố ý khó của Moonshot, chứ không phải ước lượng tỷ lệ lỗi hàng ngày. Riêng biệt, Artificial Analysis báo cáo tỷ lệ ảo giác AA-Omniscience giảm từ 53% xuống 44%. Hai đánh giá dùng phương pháp khác nhau, nên phần trăm không thể so sánh trực tiếp.
Bài học thực tế là K3.1 Pro có vẻ đáng tin cậy hơn trên các tác vụ đã đánh giá, nhưng cải thiện về thực chứng không loại bỏ nhu cầu truy xuất tài liệu, trích dẫn, kiểm tra tính toán và đánh giá của con người trong các quy trình hệ trọng.
Phân tích dữ liệu: Bằng chứng từ đánh giá của Plotly
Plotly đánh giá K3.1 Pro chuẩn thông qua OpenRouter bằng bài kiểm tra riêng gồm 43 câu hỏi trên kho dữ liệu gió tổng hợp. Không kiểm thử bản Highspeed. Kết quả minh họa đánh đổi giữa chất lượng câu trả lời, thời gian hoàn tất và chi phí trong quy trình phân tích SQL cụ thể đó.
| Plotly Data Analytics Measure | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Correct answers | 35/43 | 42/43 |
| Accuracy | 81.4% | 97.7% |
| Hidden patterns discovered | 0/5 | 5/5 |
| Data-quality issues identified | 1/3 | 3/3 |
| Full evaluation cost | $5.01 | $13.47 |
| Median time per question | 43 seconds | 2.5 minutes |
Trong đánh giá này, K3.1 Pro trả lời đúng nhiều câu hơn và phát hiện nhiều mẫu ẩn cũng như vấn đề chất lượng dữ liệu hơn, nhưng phát sinh chi phí cao hơn và thời gian hoàn tất trung vị lâu hơn.
Các khoản phí được báo cáo là chi phí quan sát khi đánh giá, không phải ước tính tính từ mức giá API chuẩn của Moonshot. Thiết lập công bố không khẳng định mọi cài đặt nhà cung cấp là giống nhau giữa hai lần chạy, nên khác biệt không thể quy hoàn toàn cho mô hình.
Các kết quả này ủng hộ việc đánh giá K3.1 Pro cho các tác vụ phân tích nơi phát hiện bổ sung có thể biện minh thời gian và chi tiêu nhiều hơn. Chúng không thiết lập cùng một độ chính xác hoặc lợi thế chi phí advantag
Kimi K3.1 Pro có nhanh hơn Kimi K3 không?
Phân biệt thông lượng token đầu ra với độ trễ tác vụ đầu-cuối.
Artificial Analysis báo cáo 73.5 token đầu ra mỗi giây cho K3.1 Pro, so với 38.5 cho K3 ở mức nỗ lực suy luận tối đa, dùng API của Kimi. Đây là đo lường tốc độ tạo token, kiểm tra ngày 24 tháng 10, 2026; độ trễ tác vụ tổng thể cũng phụ thuộc độ dài suy luận và thời gian thực thi công cụ.
Tuy nhiên, tạo token nhanh hơn không đảm bảo hoàn tất tác vụ nhanh hơn.
Moonshot cũng cung cấp K3.1 Pro Highspeed, được quảng cáo cho tốc độ đầu ra nhanh hơn khoảng hai đến ba lần so với bản chuẩn. Đây là cải thiện tốc độ phục vụ, không phải nâng cấp trí tuệ đã được thẩm định riêng.
K3.1 Pro có thông lượng token đầu ra được báo cáo cao hơn, nhưng không nhất thiết hoàn tất tác vụ nhanh hơn. Hãy phân biệt tốc độ tạo token với thời gian cần để suy luận, gọi công cụ và hoàn tất công việc.
Tốc độ đầu ra vs. Thời gian hoàn tất tác vụ
Artificial Analysis báo cáo tốc độ đầu ra 73.5 token mỗi giây cho K3.1 Pro và 38.5 cho K3 ở mức nỗ lực suy luận tối đa, dùng API của Kimi. Các số đo này được kiểm tra ngày 24 tháng 10, 2026 và mô tả thông lượng tạo token hơn là độ trễ đầu-cuối.
Một mô hình có thể tạo token nhanh hơn nhưng tổng thời gian dài hơn nếu nó tạo nhiều token suy luận hơn hoặc thực hiện thêm các lần gọi công cụ. Trong đánh giá Plotly đã nêu, thời gian hoàn tất trung vị của K3.1 Pro là 2.5 phút mỗi câu hỏi, so với 43 giây của K3, đồng thời độ chính xác cao hơn.
Với ứng dụng tương tác, hãy đo thời gian tới token đầu tiên và tổng thời gian hoàn tất tác vụ trên tuyến nhà cung cấp thực tế. Chỉ thông lượng đầu ra là không đủ để dự đoán độ phản hồi.
Cân nhắc K3.1 Pro Highspeed
Moonshot quảng cáo K3.1 Pro Highspeed cho tốc độ đầu ra nhanh hơn khoảng hai đến ba lần so với K3.1 Pro chuẩn. Tuyên bố này liên quan đến tốc độ phục vụ; không nên diễn giải như giảm hai đến ba lần thời gian hoàn tất tác vụ.
Hãy cân nhắc Highspeed cho lập trình tương tác hoặc trợ lý nơi người dùng chờ phản hồi. So sánh độ trễ đầu-cuối, tỷ lệ thành công tác vụ và tổng chi phí tính phí so với endpoint chuẩn trước khi chọn. Highspeed có giá token đầu vào và đầu ra thông thường cao hơn, trong khi mức giá đầu vào từ bộ nhớ đệm là như nhau.
Kimi K3.1 Pro vs Kimi K3: Chi phí
Mức giá API chính thức và CometAPI
Mức giá đầu vào, đầu ra và cache-hit chính thức của K3.1 Pro chuẩn thấp hơn một phần ba so với K3. Mức giá đầu vào và đầu ra do CometAPI liệt kê còn thấp hơn thêm 20% so với mức chính thức tương ứng.
| Model | Official Input / 1M | Official Output / 1M | Official Cached Input / 1M | CometAPI Input / 1M | CometAPI Output / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Check current quote | Check current quote |
USD mỗi triệu token; mức giá kiểm tra ngày 24 tháng 10, 2026. Cột đầu vào hiển thị mức giá đầu vào thông thường không từ bộ nhớ đệm. Thuế và các khoản phí tính riêng được loại trừ.
Giá Kimi chính thức cũng liệt kê phí ghi bộ nhớ đệm: $2/$4 mỗi triệu token cho Pro chuẩn với thời gian giữ 5 phút/1 giờ, và $4/$8 cho Highspeed. Cache hit, cache write và đầu vào thông thường là các hạng mục tính phí riêng, loại trừ lẫn nhau.
Kimi chính thức và CometAPI là các tuyến nhà cung cấp riêng. Hãy xác nhận mức giá hiện tại và hỗ trợ bộ nhớ đệm cho tuyến bạn chọn, bao gồm tính sẵn có của Highspeed. So sánh tổng chi phí tác vụ được tính phí cũng như mức giá token.
Ví dụ chi phí với số token cố định
Giả sử một khối công việc tiêu thụ 100,000 token đầu vào không từ bộ nhớ đệm và 20,000 token đầu ra.
Với khối công việc cố định này, chi phí API chính thức là $0.60 với K3 và $0.40 với K3.1 Pro. Ở mức giá CometAPI đã liệt kê, cùng số token đó có chi phí $0.48 và $0.32, tương ứng. Các tổng này chỉ bao gồm số token đầu vào và đầu ra đã nêu.
Nhưng đây là so sánh với số token cố định. Quy trình tác tử phức tạp có thể tiêu thụ lượng token suy luận và số lần gọi công cụ khác nhau tùy mô hình.
Tiết kiệm token biến mất
Gọi I là số token đầu vào không từ bộ nhớ đệm giống nhau, O là số token đầu ra được tính phí của Kimi K3, và P là số token đầu ra được tính phí của Kimi K3.1 Pro, tất cả tính theo đơn vị triệu. Ở mức giá chính thức chuẩn trong bảng giá, các khoản phí là 3I + 15O và 2I + 10P đô la. Chúng bằng nhau khi P = 1.5O + 0.1I.
Với yêu cầu nặng đầu ra, K3.1 Pro do đó có thể dùng nhiều hơn xấp xỉ 50% token đầu ra được tính phí trước khi mất lợi thế giá. Tính toán này giả định mức giá không đổi và loại trừ bộ nhớ đệm, phí công cụ và các khoản sử dụng tính phí riêng khác. Hãy dùng các hạng mục token được tính phí thực tế thay vì độ dài câu trả lời hiển thị.
Chi phí trên mỗi tác vụ hoàn tất thành công
Tính chi phí trên mỗi tác vụ thành công là tổng chi phí tính phí của tất cả lần thử đánh giá chia cho số tác vụ riêng biệt đạt tiêu chí chấp nhận được xác định trước. Bao gồm chi phí từ các lần thử không thành công, thử lại và hết thời gian nếu nhà cung cấp tính phí; chỉ chia chi phí các lần chạy thành công cho số lần đó có thể làm hạ thấp chi phí trên mỗi tác vụ thành công.
Giữ nguyên bộ tác vụ, tiêu chí chấp nhận, giới hạn thử lại và chính sách timeout giữa Kimi K3 và K3.1 Pro. Báo cáo tỷ lệ thành công cùng với chi phí trên mỗi lần thành công để việc loại bỏ các tác vụ khó không khiến mô hình có vẻ “kinh tế” giả tạo. Nếu không tác vụ nào thành công, chi phí trên mỗi lần thành công là không xác định, không phải bằng 0.
Kimi K3.1 Pro vs Kimi K3: So sánh và Lựa chọn
Với hầu hết khối lượng công việc tác tử được lưu trữ, K3.1 Pro là điểm khởi đầu mạnh hơn. Tuy nhiên, quyết định nên phản ánh độ phức tạp tác vụ và yêu cầu triển khai.
| Use Case | Recommended Model | Reason |
|---|---|---|
| Autonomous coding | Kimi K3.1 Pro | Đánh giá thay đổi nhiều tệp, làm việc với terminal, gỡ lỗi và kết quả kiểm thử cuối cùng. |
| Multi-document financial research | Kimi K3.1 Pro | Cải thiện benchmark nghiên cứu và vận hành doanh nghiệp |
| Complex data analysis | Kimi K3.1 Pro | Khả năng phát hiện vấn đề và kiểm thử chất lượng dữ liệu tốt hơn |
| 3D creation and CAD workflows | Kimi K3.1 Pro | Năng lực chuyên biệt mạnh khi có công cụ hỗ trợ |
| Straightforward text tasks | Benchmark cả hai | So sánh tác vụ văn bản thường lệ và lập trình đơn giản trên cả hai; suy luận thêm có thể tăng độ trễ mà không cải thiện kết quả chấp nhận được. |
| Long-context retrieval accuracy | Benchmark cả hai | K3 nhỉnh hơn một chút trên AA-LCR |
| Immediate self-hosting | Kimi K3 | Trọng số có thể tải xuống đã sẵn sàng |
| Interactive high-capability agents | K3.1 Pro Highspeed | Phục vụ nhanh hơn, cần xác thực chi phí |
| Cost-sensitive production workflows | Benchmark cả hai | Giá token thấp hơn có thể không đồng nghĩa chi phí tác vụ thấp hơn |
Tự động hóa lưu trữ và Quy trình chuyên nghiệp
Với tác tử lập trình lưu trữ và quy trình phân tích, hãy đánh giá K3.1 Pro trên những phần khó của công việc thực: thay đổi nhiều tệp, thu thập bằng chứng, kiểm tra tính toán và khôi phục sau một lần gọi công cụ thất bại. Ưu tiên giảm đo lường được ở tác vụ thất bại hoặc công việc sửa chữa thay vì chỉ dựa vào điểm số tiêu đề cao hơn.
Với ứng dụng K3 hiện tại, giữ tuyến hiện có làm đường cơ sở so sánh. Tác vụ thường lệ có thể đã đạt ngưỡng chấp nhận, trong khi tác vụ ngữ cảnh dài chuyên biệt có thể hành xử khác với benchmark tổng hợp. Ưu tiên các phân đoạn khối lượng công việc mà nâng cấp mang lại lợi ích đo lường được.
Tự lưu trữ và Ràng buộc triển khai
Tính đến ngày 24 tháng 10, 2026, trọng số đầy đủ của K3 đã sẵn có để triển khai theo giấy phép của mô hình và yêu cầu phần cứng. Trọng số đầy đủ của K3.1 Pro chưa được công bố.
Moonshot dự định phát hành trọng số K3.1 Pro trước ngày 4 tháng 11, 2026. Đây là kế hoạch phát hành đã công bố, không phải checkpoint đã có; hãy xác nhận trọng số đã xuất bản và điều khoản áp dụng trước khi lên kế hoạch tự lưu trữ.
Tiêu chí đánh giá cho sản xuất
So sánh K3 và K3.1 Pro trên tác vụ đại diện bằng cùng prompt, công cụ, tiêu chí chấp nhận, giới hạn thử lại và timeout. Ghi lại cài đặt nhà cung cấp và suy luận, và bảo toàn đầy đủ thông điệp trợ lý theo yêu cầu của API.
Đo tỷ lệ thành công tác vụ, độ trễ, mức dùng token và chi phí trên mỗi tác vụ thành công, bao gồm các lần thất bại và thử lại bị tính phí. Rà soát các trường hợp K3 thành công nhưng K3.1 Pro thất bại. Với đánh giá của con người, ẩn nhãn mô hình và xáo trộn thứ tự đầu ra.
Nếu K3.1 Pro đáp ứng ngưỡng chất lượng, độ trễ và chi phí của bạn, hãy triển khai dần với K3 làm phương án dự phòng đã kiểm thử.
Di trú có kiểm soát và Phương án dự phòng
Cách tiếp cận thực tế là bắt đầu với một tỷ lệ nhỏ lưu lượng sản xuất trên K3.1 Pro.
Giữ K3 sẵn sàng làm dự phòng trong quá trình xác nhận. So sánh chất lượng tác vụ, độ trễ, tỷ lệ lỗi và chi tiêu trước khi tăng mức dùng K3.1 Pro.
Đặc biệt chú ý đến schema gọi công cụ, các trường thông điệp liên quan đến suy luận, đầu vào đa phương thức và phân tích cú pháp đầu ra. Tương thích API không tự động đảm bảo hành vi ứng dụng giống hệt.
Mức tăng và Thụt lùi trên benchmark
Nếu cả hai mô hình trả lời cùng 43 câu hỏi và đạt 35 và 42, K3.1 Pro có thể đã sửa bảy lỗi của K3 mà không có thụt lùi, hoặc sửa tám lỗi trong khi mất một câu trước đó đúng. Tổng điểm không thể phân biệt các trường hợp này.
Hãy kiểm tra cặp câu trả lời và phân loại: cả hai đúng, chỉ K3 đúng, chỉ K3.1 Pro đúng, hoặc cả hai sai. Rà soát các thành công chỉ của K3 đối chiếu với các tác vụ có ảnh hưởng cao nhất trước khi di trú. Kết quả 42/43 mô tả bộ kiểm tra đó; nó không đảm bảo tỷ lệ thành công 97.7% trên khối lượng công việc khác.
Đánh giá mù đầu ra của mô hình
Ẩn nhãn mô hình và xáo trộn thứ tự người đánh giá nhìn thấy đầu ra. Định nghĩa thang chấp nhận trước khi xem xét: với mã, dùng bài kiểm thử thực thi và kiểm thử hồi quy; với nghiên cứu, kiểm tra nguồn, tính toán và yêu cầu sản phẩm có đầy đủ không. Chấm điểm tính đúng đắn trước khi xét đến cách trình bày hay phong cách viết.
Chỉ tiết lộ danh tính mô hình, độ trễ và chi phí tính phí sau khi ghi nhận đánh giá chất lượng. Điều này tách chất lượng đầu ra khỏi kỳ vọng về mô hình mới hơn. Giải quyết bất đồng giữa người đánh giá theo cùng bài kiểm thử hoặc nguồn, và lưu lại quyết định để có thể đánh giá nhất quán khi mô hình hoặc prompt thay đổi sau này.
Bạn có thể truy cập Kimi K3.1 Pro và Kimi K3 ở đâu?
Truy cập từ nhà cung cấp chính thức
Dùng Kimi K3 API hoặc Kimi K3.1 Pro API đã được Moonshot tài liệu hóa để tích hợp trực tiếp. Kiểm tra định danh mô hình của endpoint đã chọn, các trường yêu cầu được hỗ trợ và giới hạn tài khoản. Truy cập API công khai và trọng số mô hình có thể tải xuống là các phương án triển khai riêng biệt.
Truy cập qua CometAPI
Nhà phát triển có thể truy cập Kimi K3.1 Pro API và Kimi K3 API qua giao diện hợp nhất của CometAPI và so sánh cả hai tuyến với cùng khối lượng công việc ứng dụng.
Điều này khiến việc di trú từ K3 lên K3.1 Pro tương đối trực tiếp, đặc biệt cho ứng dụng đã dùng giao diện chat tương thích OpenAI.
Để dùng CometAPI, tạo tài khoản và khóa API, rồi cấu hình ứng dụng với endpoint và định danh mô hình theo tài liệu tích hợp. Chọn kimi-k3 cho K3, kimi-k3.1-pro cho K3.1 Pro chuẩn, hoặc kimi-k3.1-pro-highspeed cho tuyến Highspeed nếu được hỗ trợ. Bắt đầu với yêu cầu nhỏ, rồi so sánh cùng khối lượng công việc giữa các mô hình đồng thời kiểm tra kết quả trả về, độ trễ và mức sử dụng bị tính phí.
Kết luận
Kimi K3.1 Pro là ứng viên mạnh hơn cho lập trình tự động đòi hỏi cao, nghiên cứu tài chính và quy trình tác tử mở rộng theo các đánh giá được xem xét ở đây. Kimi K3 vẫn phù hợp cho tự lưu trữ ngay và các khối lượng công việc nơi hồ sơ độ chính xác hoặc độ trễ hiện tại đã đáp ứng yêu cầu.
Hãy lựa chọn bằng tác vụ đại diện và tuyến nhà cung cấp thực tế. So sánh kết quả thành công, độ trễ và tổng chi tiêu, rồi di trú dần. Giá token thấp hơn và điểm benchmark tổng hợp cao hơn là điểm khởi đầu hữu ích, nhưng không xác lập cấu hình tốt nhất cho mọi ứng dụng.