Xây dựng với CometAPICần một API cho nhiều mô hình?Kiểm thử quy trình trong Playground, sau đó tạo API key khi mô hình và chi phí phù hợp với trường hợp sử dụng của bạn.
MiMo-V2.5 là lựa chọn mặc định mạnh hơn cho công việc đa phương thức, tác tử thông thường và sản xuất nhạy về chi phí. MiMo-V2.5-Pro là lựa chọn chuyên biệt cho suy luận khó, lập trình ở quy mô kho mã và sử dụng công cụ dài hạn. Cả hai đều cung cấp cửa sổ ngữ cảnh 1M token và tối đa 128K token đầu ra, nhưng Pro dùng xương sống ngôn ngữ lớn hơn nhiều và chi phí khoảng 3,1× đối với token đầu vào và đầu ra thông thường.
Đã được xem xét về độ rõ ràng, ghi nguồn và thuật ngữ API hiện tại.
Thông số — theo công bố chính thức
MiMo-V2.5
MiMo-V2.5-Pro
Model khuyến nghị
Lý do
Định vị chính
Model đa phương thức và tác tử hiệu quả
Tác tử flagship và lập trình phức tạp
Chọn theo workload
Đầu vào đa phương thức nghiêng về V2.5; văn bản khó, kéo dài nghiêng về Pro.
Kiến trúc
MoE thưa
MoE thưa
Chọn theo workload
Kích thước model không tự thân quyết định lựa chọn tốt hơn cho mọi tác vụ.
Tổng tham số
310B
1.02T
Chọn theo workload
Model lớn hơn nhắm tới suy luận khó, nhưng tổng kích thước không là kết quả tác vụ.
Tham số kích hoạt
15B
42B
Chọn theo workload
Quyết định dựa trên hoàn thành tác vụ và chi phí.
Số lớp LLM
48
70
Chọn theo workload
Số lớp mô tả kiến trúc, không phải ưu thế phổ quát.
Chuyên gia được định tuyến
256
384
Chọn theo workload
Khác biệt chỉ quan trọng nếu cải thiện workload mục tiêu.
Chuyên gia kích hoạt mỗi token
8
8
Cả hai
Cả hai kích hoạt tám chuyên gia mỗi token.
Cửa sổ ngữ cảnh
1M tokens
1M tokens
Cả hai
Cả hai công bố cửa sổ 1M token; cần thử nghiệm khả năng truy xuất hiệu quả.
Tối đa đầu ra
128K tokens
128K tokens
Cả hai
Cả hai công bố tối đa 128K token đầu ra.
Phương thức đầu vào
Văn bản, hình ảnh, video và âm thanh
Văn bản
MiMo-V2.5
Chấp nhận hình ảnh, video và âm thanh; Pro tập trung vào đầu vào văn bản.
Gọi công cụ
Có
Có
Chọn theo workload
Cả hai có thể gọi công cụ; cần thử tỉ lệ thành công trên quỹ đạo thực tế.
Trọng số mở và giấy phép
Có; MIT
Có; MIT
Cả hai
Cả hai có trọng số mở theo MIT; chi phí phục vụ khác nhau.
Sự khác biệt mang tính quyết định: Đa phương thức vs. ưu tiên tác tử
V2.5 hỗ trợ tự nhiên văn bản, hình ảnh, video và âm thanh. Xiaomi kết hợp xương sống ngôn ngữ với bộ mã hóa thị giác 729M tham số và bộ mã hóa âm thanh 261M tham số, cho phép thông tin đa phương thức tham gia trực tiếp vào cùng một quy trình suy luận.
Phân tích ảnh chụp màn hình trước khi gọi công cụ.
Hiểu video và bản âm thanh của nó cùng nhau.
Trích xuất thông tin từ sơ đồ và ảnh tài liệu.
Vận hành tác tử hỗ trợ giao diện trực quan và đa phương thức.
Suy luận trên các chuỗi video dài.
V2.5-Pro đi theo thiết kế khác. Xiaomi hiện chỉ định văn bản là phương thức đầu vào và nhấn mạnh suy luận sâu, phát triển mã và điều phối công cụ chạy dài.
Nếu quy trình làm việc chứa đầu vào hình ảnh, video hoặc âm thanh, hãy bắt đầu với V2.5. Thử Pro khi phần khó nằm ở suy luận trên văn bản, mã nguồn, công cụ hoặc một quỹ đạo tác tử dài.
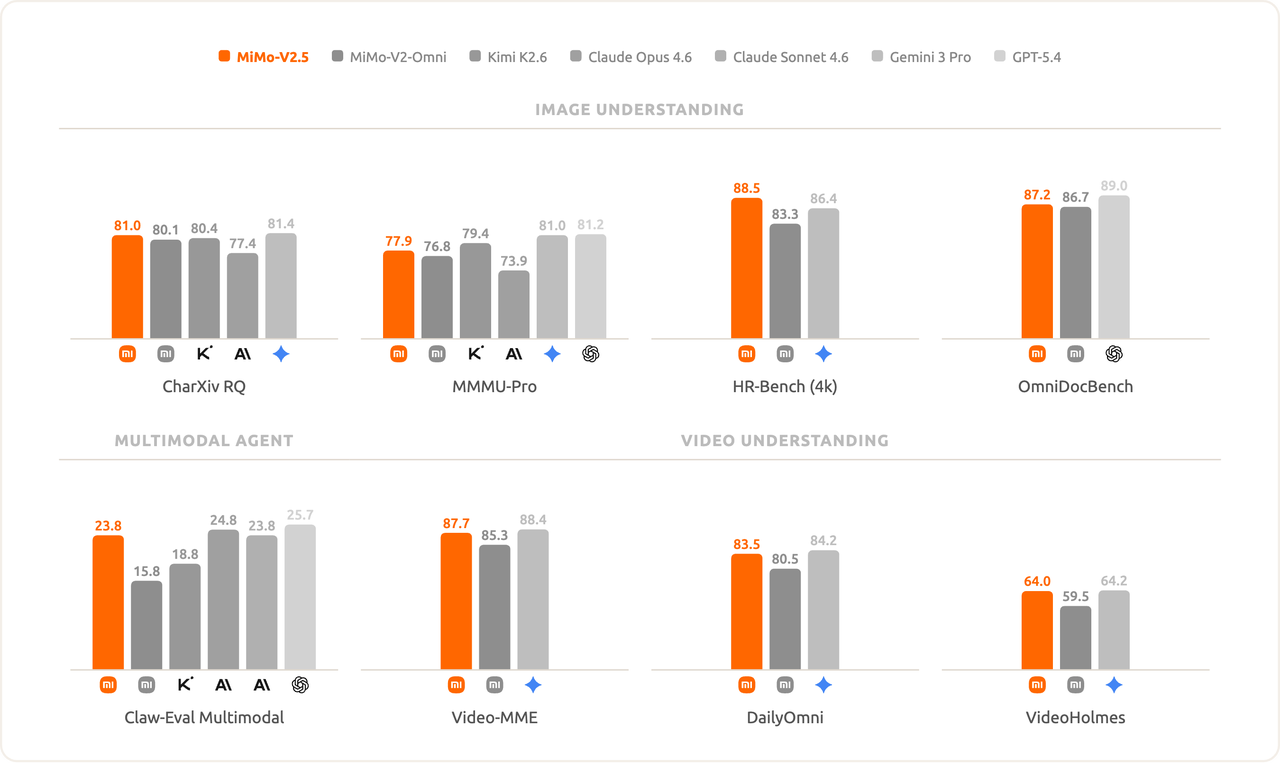
So sánh benchmark đa phương thức chính thức của Xiaomi.
Vì sao V2.5-Pro có thể tốt hơn cho tác vụ khó
Quy mô model: 310B/15B so với 1.02T/42B
Cả hai model sử dụng xương sống MoE thưa, cơ chế chú ý kết hợp cửa sổ trượt và toàn cục, cùng ba mô-đun Dự đoán đa token (MTP). Thẻ model V2.5 ghi nhận xương sống tổng 310B, kích hoạt 15B; thẻ model Pro mở rộng lên tổng 1.02T với 42B tham số kích hoạt mỗi token.
Kiến trúc — theo thẻ model chính thức
V2.5
Pro
Khác biệt
Tổng tham số
310B
1.02T
Khoảng 3,3×
Tham số kích hoạt
15B
42B
2,8×
Kích thước ẩn
4.096
6.144
1,5×
Số lớp LLM
48
70
+22
Số đầu chú ý
64
128
2×
Chuyên gia được định tuyến
256
384
1,5×
Chuyên gia mỗi token
8
8
Giống nhau
Lớp MTP
3
3
Giống nhau
V2.5 dùng mẫu chú ý 5:1, trong khi Pro chuyển sang mẫu cục bộ:toàn cục 6:1. Xiaomi cho biết các thiết kế này giảm yêu cầu KV-cache gần 6× và 7× so với chú ý đầy đủ khắp mạng.
Tổng tham số không chuyển hóa tuyến tính thành chất lượng trả lời. Xương sống lớn hơn của Pro quan trọng nhất khi độ khó suy luận hoặc độ dài quỹ đạo khiến các lợi ích nhỏ về độ tin cậy trên mỗi bước cộng dồn.
Vì sao các cải thiện nhỏ về độ tin cậy cộng dồn
Một tác vụ tác tử dài có nhiều bước phụ thuộc. Lỗi ở một lần gọi công cụ sớm có thể buộc thử lại hoặc làm sai các bước sau, vì vậy một cải thiện khiêm tốn về độ tin cậy trên mỗi bước có thể tác động lớn hơn đến hoàn thành đầu-cuối. Hãy đánh giá hiệu ứng đó trên các tác vụ đại diện thay vì giả định kích thước model bảo đảm.
V2.5-Pro thực sự cải thiện ở đâu?
So sánh số liệu sạch nhất là đánh giá mô hình cơ sở của Xiaomi, nơi cả hai model xuất hiện dưới cùng thiết lập. Điều này tránh trộn lẫn kết quả do các harness không liên quan hoặc cấu hình hậu huấn luyện khác nhau tạo ra.
Kiến thức tổng quát: Tăng nhỏ đến vừa
Trong so sánh mô hình cơ sở, Pro tăng 1,2 điểm trên BBH, 3,1 trên MMLU và 2,7 trên MMLU-Pro. Đây là những cải thiện đo được nhưng nhỏ hơn so với các tác vụ suy luận khó.
Toán học và khoa học: Tăng lớn hơn
Pro tăng 8,6 điểm trên GPQA-Diamond, 16,3 trên GSM8K và 18,5 trên MATH trong cùng đánh giá mô hình cơ sở. Đây là bằng chứng rõ ràng nhất để chọn Pro khi thành công phụ thuộc vào suy luận khó.
Lập trình: Tốt hơn, nhưng không đồng đều
Các mức tăng được báo cáo là 4,3 điểm trên HumanEval+, 3,2 trên MBPP+, 4,1 trên LiveCodeBench v6 và 4,9 trên SWE-Bench AgentLess. Hãy thử riêng các tác vụ ở quy mô kho mã và sử dụng công cụ: các điểm số mô hình cơ sở này không đo lường mọi quy trình tác tử trong sản xuất.
Kết quả benchmark: Pro không tốt hơn gấp ba lần chỉ vì chi phí khoảng gấp ba. Giá trị của nó tăng dần theo độ khó suy luận và thời lượng tác vụ.
Các dòng này là đánh giá mô hình cơ sở, không phải lời hứa rằng API sản xuất sẽ tái tạo cùng điểm số. Kết quả tác tử phụ thuộc vào công cụ, prompt, số lần thử lại, môi trường thực thi và ngân sách token.
Hậu huấn luyện và tác tử quỹ đạo dài
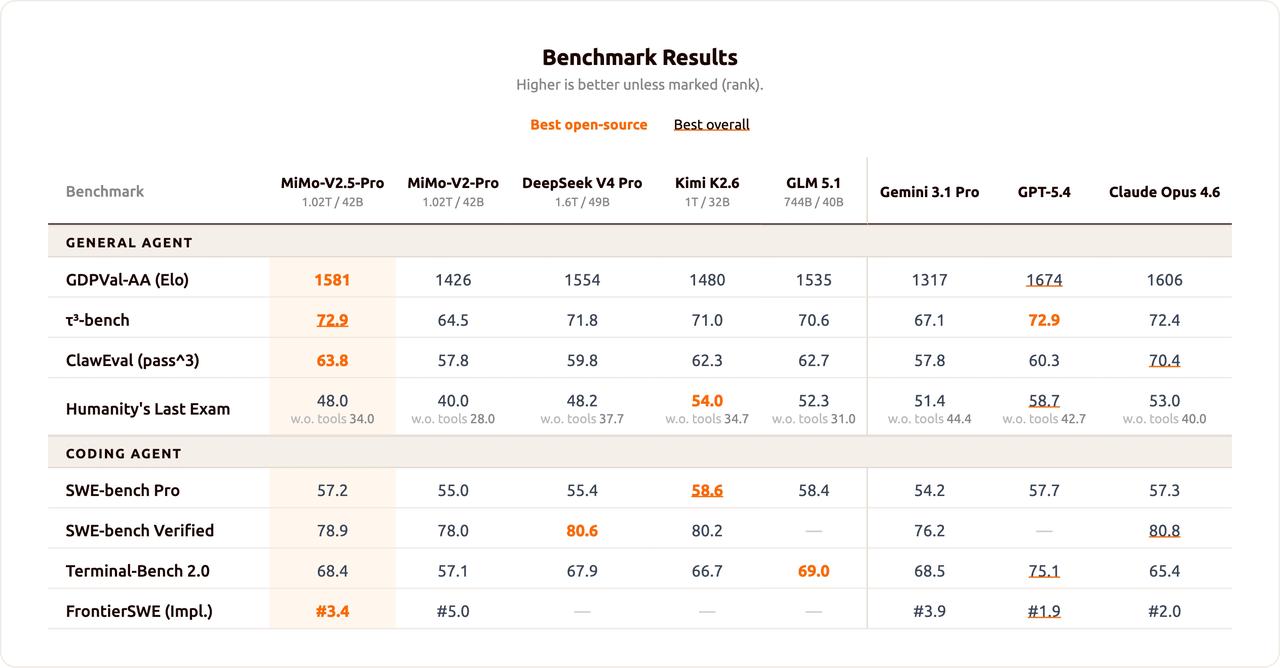
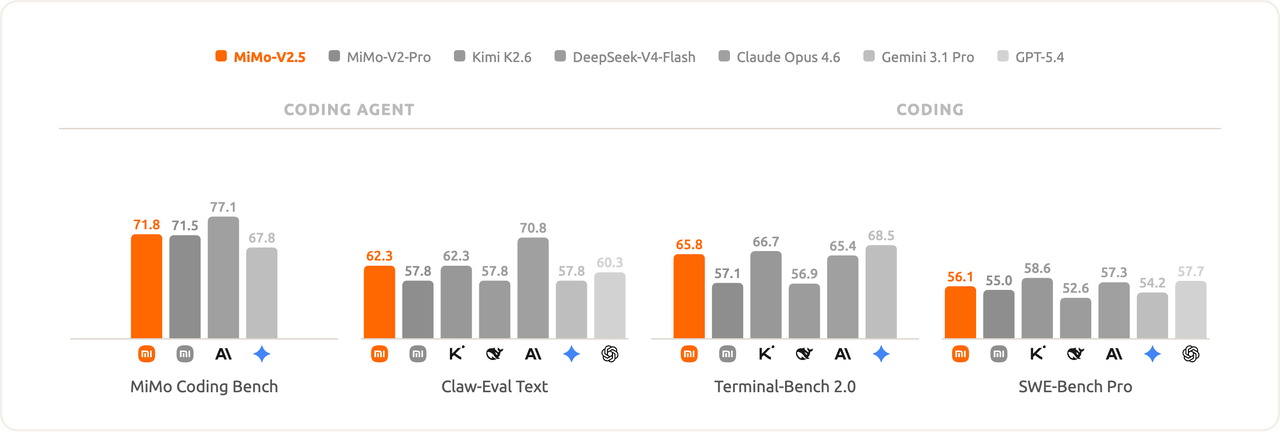
Các model sản xuất bổ sung tinh chỉnh có giám sát, học tăng cường theo hướng tác tử và chưng cất on-policy đa giáo viên. Xiaomi báo cáo điểm hậu huấn luyện 56,1 trên SWE-bench Pro, 65,8 trên Terminal-Bench 2.0 và 62,1 Pass³ trên phần tổng quát của Claw-Eval cho V2.5.
Pro được tối ưu rõ ràng hơn cho kỹ nghệ phần mềm quỹ đạo dài. Xiaomi mô tả hàng trăm lần gọi công cụ trong các quỹ đạo kéo dài và công bố kết quả 78,9% SWE-bench Verified.
Một nghiên cứu tình huống chính thức cho thấy Pro hoàn thành một trình biên dịch SysY trong 4,3 giờ với 672 lần gọi công cụ và vượt qua cả 233 bài kiểm tra. Bài học không phải là mọi yêu cầu viết mã đều cần Pro; mà là khác biệt nhỏ về độ tin cậy có thể quyết định liệu một quy trình gồm hàng trăm hành động phụ thuộc có hoàn thành hay không.
Hình benchmark mã hóa và tác tử chính thức của Xiaomi.
Ngữ cảnh dài: Cùng dung lượng, khác workload
Cả hai model cung cấp cửa sổ ngữ cảnh 1M token và tối đa 128K token đầu ra qua API hiện tại của Xiaomi. Vì vậy, kích thước ngữ cảnh thô không phân tách chúng.
V2.5 hấp dẫn khi ngữ cảnh dài bao gồm vật liệu đa phương thức như video, ảnh tài liệu hoặc dấu vết tác tử trực quan. Pro là model cần thử khi chính ngữ cảnh trở thành vấn đề suy luận: một kho mã lớn, hợp đồng dài, tập nghiên cứu hoặc quỹ đạo tác tử chứa nhiều hành động tuần tự.
Cửa sổ ngữ cảnh lớn mô tả dung lượng, không phải độ trung thực suy luận được đảm bảo. Hãy đánh giá truy xuất, giữ chỉ dẫn và sử dụng bằng chứng ở độ dài quan trọng với ứng dụng.
Một yêu cầu với 1M token đầu vào chưa cache và 200K token đầu ra có chi phí ước tính $0,196 trên V2.5 và $0,609 trên Pro trước khi tính lượt trúng cache, phí tìm kiếm web hoặc cách tính phí theo nhà cung cấp.
Chênh lệch giá cache nhỏ hơn: Pro đắt hơn khoảng 29% cho đầu vào trúng cache thay vì 211% cho đầu vào không cache. Vì vậy, các tác tử chạy dài với prompt hệ thống ổn định, định nghĩa công cụ hoặc tiền tố kho mã ổn định nên đo tỉ lệ trúng cache thực tế.
Ước tính chi phí trên mỗi tác vụ thành công. Một tác tử Pro hoàn thành một quy trình khó có thể rẻ hơn so với nhiều lần thất bại trên model rẻ hơn.
Nên dùng model nào?
Workload — hướng dẫn chính thức
Lựa chọn tốt hơn
Lý do
Trò chuyện văn bản thường
V2.5
Chi phí thấp hơn; Pro thường không cần thiết
Tạo nội dung khối lượng lớn
V2.5
Giá token chuẩn thấp hơn khoảng 3,1×
Hiểu hình ảnh, video hoặc âm thanh
V2.5
Hỗ trợ đầu vào đa phương thức tự nhiên
Gọi công cụ thông thường
V2.5
Năng lực tác tử mạnh với chi phí thấp hơn
Toán và khoa học khó
Pro
Tăng benchmark lớn hơn
Lập trình ở quy mô kho mã
Pro
Thiết kế cho kỹ nghệ phần mềm phức tạp
Hàng trăm lần gọi công cụ phụ thuộc
Pro
Phù hợp hơn cho thực thi kéo dài
Ngữ cảnh 1M nhạy về chi phí
V2.5
Cùng ngữ cảnh danh nghĩa với chi phí thấp hơn
Kết luận lựa chọn: V2.5 là mặc định cho ứng dụng đa phương thức, tác tử thông thường và workload nhạy về chi phí. Pro là nâng cấp cho suy luận khó, kỹ nghệ phần mềm phức tạp và quỹ đạo tự động dài.
Chiến lược sản xuất tốt hơn: định tuyến giữa cả hai
Một lựa chọn model toàn cục thường không cần thiết. Hãy định tuyến yêu cầu đa phương thức và thông thường sang V2.5, rồi chỉ nâng cấp các yêu cầu suy luận văn bản khó, lập trình phức tạp hoặc thực thi dài hạn sang Pro.
Chiều đánh giá
Thước đo
Lý do quan trọng
Tín hiệu định tuyến
Hoàn thành
Tác vụ thành công/số lần thử
Phản ánh độ tin cậy đầu-cuối
Nâng cấp các lớp có tỉ lệ thấp
Chất lượng
Điểm do người/chấm theo rubric
Ngăn chi phí token chi phối
Nâng cấp tác vụ rủi ro cao
Độ tin cậy công cụ
Lỗi và số lần thử lại
Lỗi nhỏ cộng dồn trong tác tử
Nâng cấp quỹ đạo dài
Độ trễ
Thời gian đến kết quả chấp nhận
Bao gồm chi phí thử lại
Giữ tác vụ tương tác nhẹ
Chi phí
Chi tiêu/tác vụ chấp nhận
Phản ánh thất bại và chạy lại
Dùng model rẻ nhất vẫn thành công
Thử cả hai API trên CometAPI
MiMo-V2.5 API trên CometAPI và MiMo-V2.5-Pro API trên CometAPI hỗ trợ đánh giá song song qua một lớp tổng hợp. Gửi cùng prompt, hướng dẫn hệ thống, công cụ và giới hạn đầu ra tới cả hai model, rồi so sánh tỉ lệ thành công và chi phí.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Chạy một lô đại diện chứa yêu cầu đơn giản, suy luận khó, chỉnh sửa mã, tác vụ ngữ cảnh dài và gọi công cụ tác tử. Ghi nhận tỉ lệ hoàn thành, số token, độ trễ, lỗi công cụ, số lần thử lại, chất lượng câu trả lời và chi phí trên mỗi tác vụ thành công.
Hạn chế
Hạn chế của V2.5
Xương sống ngôn ngữ nhỏ hơn khiến hiệu năng giảm khi độ khó suy luận tăng. Khoảng cách khiêm tốn trên BBH nhưng lớn hơn nhiều trên GPQA-Diamond và MATH. Cửa sổ ngữ cảnh 1M token cũng không nên bị nhầm với độ trung thực suy luận 1M token đảm bảo.
Hạn chế của Pro
Giá token đầu vào và đầu ra thông thường của Pro cao hơn khoảng 3,1× so với V2.5, và đầu vào chỉ văn bản khiến nó không phù hợp làm thay thế trực tiếp cho ứng dụng đa phương thức. Model trọng số mở 1,02T tham số cũng là một dự án tự triển khai đòi hỏi cao dù 42B tham số được kích hoạt mỗi token.
Kết luận cuối cùng
Chọn V2.5 cho ứng dụng đa phương thức, tác tử thông thường và sản xuất nhạy về chi phí. Chọn Pro cho suy luận khó, kỹ nghệ phần mềm phức tạp và tác tử tự động chạy dài. Với workload hỗn hợp, định tuyến phần lớn lưu lượng sang V2.5 và chỉ nâng cấp các yêu cầu có độ khó hoặc độ dài quỹ đạo biện minh cho chi phí tăng thêm.
Câu hỏi thường gặp
Pro có luôn tốt hơn V2.5 không?
Không. Pro mạnh hơn trong suy luận văn bản khó và lập trình, nhưng V2.5 hỗ trợ đầu vào hình ảnh, video, âm thanh và rẻ hơn đáng kể.
Cả hai model có hỗ trợ cửa sổ ngữ cảnh 1M token không?
Có. Cả hai công bố 1M token ngữ cảnh và tối đa 128K token đầu ra. Ứng dụng vẫn nên thử truy xuất và suy luận ở độ dài vận hành thực tế.
Tác tử đa phương thức nên dùng model nào?
Bắt đầu với V2.5 vì nó chấp nhận đầu vào hình ảnh và âm thanh một cách tự nhiên. Pro hiện nhắm tới workflow đầu vào văn bản.
Khi nào Pro đáng với giá cao hơn?
Khi độ tin cậy suy luận tốt hơn ảnh hưởng đến hoàn thành toán học khó, lập trình ở quy mô kho mã hoặc quỹ đạo dài chứa nhiều lần gọi công cụ phụ thuộc.
Hệ thống sản xuất có nên chỉ dùng một model không?
Không nhất thiết. Một lớp định tuyến có thể giữ công việc thông thường và đa phương thức trên V2.5 trong khi nâng cấp suy luận văn bản khó và tác vụ tác tử sang Pro.