Thông số kỹ thuật của GLM-5.3-Flash
| Thông số | GLM-5.3-Flash |
|---|---|
| Nhà cung cấp | Z.ai (Zhipu AI) |
| Họ mô hình | GLM-5 |
| Loại mô hình | Mô hình Mixture-of-Experts đa phương thức gốc |
| Tổng số tham số | 320B |
| Tham số kích hoạt | 18B |
| Kiến trúc | Chú ý thưa kết hợp + chú ý tuyến tính |
| Cửa sổ ngữ cảnh | 1.048.576 token (1M) |
| Đầu ra tối đa | 131.072 token |
| Phương thức đầu vào | Văn bản, hình ảnh, video |
| Phương thức đầu ra | Văn bản |
| Lập luận | Hỗ trợ |
| Thị giác | Hỗ trợ |
| Gọi hàm | Hỗ trợ |
| Sử dụng công cụ | Hỗ trợ |
| Tìm kiếm web | Hỗ trợ thông qua các tích hợp API được hỗ trợ |
| Trọng số mở | Có |
| Giấy phép | MIT |
| Phát hành | 26 tháng 8, 2026 |
Z.ai mô tả GLM-5.3-Flash là mô hình natively multimodal đầu tiên trong họ GLM-5. Mô hình có tổng 320B tham số nhưng chỉ kích hoạt 18B tham số cho mỗi bước suy luận. Mô hình giới thiệu một kiến trúc lai kết hợp chú ý thưa và chú ý tuyến tính và sử dụng mHC để cải thiện hiệu quả mở rộng.
GLM-5.3-Flash là gì?
GLM-5.3-Flash là thành viên định hướng hiệu suất của thế hệ GLM-5 của Z.ai, được thiết kế để kết hợp khả năng lập luận ở tuyến đầu và năng lực lập trình tác tử với chi phí suy luận thấp hơn đáng kể.
Điểm khác biệt quan trọng nhất so với một mô hình "Flash" thông thường là Flash không đồng nghĩa với một mô hình nhỏ. GLM-5.3-Flash có tổng 320B tham số, nhưng kiến trúc MoE của nó chỉ kích hoạt 18B tham số mỗi token. Điều này cho phép Z.ai nhắm đến mức tính toán suy luận thấp hơn nhiều trong khi vẫn giữ một bể tham số lớn cho năng lực mô hình.
Đây cũng là mô hình GLM-5 đầu tiên có khả năng đa phương thức gốc. Mô hình hỗ trợ đầu vào hình ảnh ngoài văn bản và được định vị cho mã hóa, tương tác trình duyệt, hiểu tài liệu, mã hóa dựa trên hình ảnh và các quy trình làm việc mang tính tác tử.
Z.ai cho biết GLM-5.3-Flash được huấn luyện từ một mô hình nền mới được huấn luyện thay vì chỉ là phiên bản nén của GLM-5.2. Quá trình huấn luyện sử dụng một corpus tiền huấn luyện đa phương thức 30 nghìn tỷ token, trong khi kiến trúc được thiết kế lại xoay quanh năng lực và hiệu quả suy luận.
Tính năng chính của GLM-5.3-Flash
- 320B MoE với 18B tham số kích hoạt: GLM-5.3-Flash kết hợp dung lượng tham số tổng rất lớn với dấu chân tham số kích hoạt tương đối nhỏ, giúp mô hình hiệu quả hơn nhiều khi phục vụ so với một mô hình dày 320B.
- Hiểu đa phương thức gốc: Khác với các mô hình GLM-5 trước đó, GLM-5.3-Flash xử lý đầu vào hình ảnh một cách bản địa. Thẻ mô hình cung cấp các ví dụ hiểu hình ảnh và xác định mô hình là đa phương thức.
- Ngữ cảnh 1M token: Mô hình được thiết kế cho các ứng dụng ngữ cảnh dài liên quan đến kho lớn, tài liệu dài, quỹ đạo tác tử dài và quy trình đa bước phức tạp. Cloudflare và Vercel đều liệt kê cửa sổ ngữ cảnh 1.048.576 token.
- Chú ý thưa + chú ý tuyến tính lai: GLM-5.3-Flash là mô hình GLM đầu tiên kết hợp chú ý thưa và chú ý tuyến tính. Z.ai cho biết kiến trúc này giảm chi phí phục vụ ngữ cảnh dài trong khi vẫn bảo toàn khả năng ngữ cảnh dài chính xác.
- Lập trình tác tử và sử dụng công cụ: Mô hình được tối ưu cho kỹ nghệ phần mềm, tác vụ terminal, tương tác trình duyệt và các quy trình làm việc dẫn dắt bởi công cụ. Điểm Terminal-Bench 2.1 được báo cáo là 84,3.
- Triển khai trọng số mở: Trọng số theo giấy phép MIT có thể triển khai với Transformers, vLLM, SGLang, TokenSpeed và KTransformers, mang lại lựa chọn tự lưu trữ và tối ưu suy luận cho nhà phát triển.
Hiệu năng kiểm chuẩn của GLM-5.3-Flash
GLM-5.3-Flash đặc biệt mạnh ở các kiểm chuẩn mã hóa và tác tử.
| Kiểm chuẩn | GLM-5.3-Flash | GLM-5.2 | Ghi chú |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 81.0 | Terminal / lập trình tác tử |
| DeepSWE v1.1 | 63.4 | 46.2 | Kỹ nghệ phần mềm |
| AutomationBench | 48.8 | 26.2 | Tự động hóa sử dụng máy tính |
| Toolathlon-Verified | 78.4 | 59.9 | Năng lực sử dụng công cụ |
| NL2Repo-Bench | 56.3 | 48.9 | Mã hóa từ ngôn ngữ tự nhiên sang kho |
| Agent's Last Exam | 26.3 | 20.4 | Lập luận tác tử |
| Humanity's Last Exam | 55.3 | — | Kèm công cụ |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | Năng suất / công việc tri thức |
| OfficeQA-Pro | 62.4 | — | Năng suất đa phương thức |
| CharXiv RQ | 89.4 | — | Lập luận đa phương thức |
Phần đánh giá chính thức trên Hugging Face liệt kê 84,3 cho Terminal-Bench 2.1, 63,4 cho DeepSWE và 55,3 cho HLE. Tài liệu ra mắt của Z.ai báo cáo thêm các kết quả bao gồm AutomationBench, Toolathlon, NL2Repo và GDPval.
Independent Artificial Analysis hiện chấm GLM-5.3-Flash Chỉ số Trí tuệ 57, xếp hạng #3 trong số 108 mô hình trong tập so sánh hiện tại.
Những con số này vẫn cần được diễn giải với các lưu ý riêng của từng kiểm chuẩn: một số kết quả do nhà cung cấp báo cáo, bộ khung đánh giá khác nhau, và điểm kiểm chuẩn không nên được coi là thước đo xếp hạng chung về chất lượng mô hình.
GLM-5.3-Flash so với GLM-5.3 và GLM-5.2
| Tính năng | GLM-5.3-Flash | GLM-5.3 | GLM-5.2 |
|---|---|---|---|
| Thế hệ mô hình | GLM-5 | GLM-5 | GLM-5 |
| Định vị | Mô hình đa phương thức / tác tử hiệu quả | Mô hình lập luận tổng quát cao cấp | Mô hình tổng quát thế hệ trước |
| Thị giác gốc | Có | Không | Phụ thuộc mô hình |
| Tổng số tham số | 320B | Cấu hình flagship lớn hơn | Mô hình quy mô lớn |
| Tham số kích hoạt | 18B | — | — |
| Ngữ cảnh | 1M | Triển khai lớp 200K | Triển khai lớp 200K |
| Chú ý thưa/tuyến tính kết hợp | Có | Không | Không |
| Lập trình tác tử | Xuất sắc | Xuất sắc | Mạnh |
| Trọng số mở | Có | Phụ thuộc triển khai | Phụ thuộc triển khai |
| Ưu thế chính | Năng lực trên mỗi đơn vị tính toán suy luận | Khả năng lập luận tối đa của GLM-5 | Thế hệ GLM trưởng thành và chi phí thấp hơn |
Điểm khác biệt chính là GLM-5.3-Flash không chỉ đơn giản là GLM-5.3 ở kích thước nhỏ hơn. Z.ai cho biết nó bắt đầu từ một mô hình nền mới được huấn luyện và giới thiệu kiến trúc chú ý lai được thiết kế lại, mHC và tiền huấn luyện đa phương thức.
GLM-5.3-Flash vs DeepSeek V4 Flash — Tóm tắt so sánh
| Chiều cạnh | GLM-5.3-Flash (Z.ai / Zhipu) | DeepSeek V4 Flash (DeepSeek) | Lợi thế |
|---|---|---|---|
| Ngày phát hành | 26 tháng 8, 2026 | Xem trước tháng 4/2026; checkpoint lớn (0731) ngày 31 tháng 7, 2026 | — |
| Tổng / Kích hoạt tham số | 320B / 18B | 284B / 13B | GLM lớn hơn chút |
| Cửa sổ ngữ cảnh | 1M token | 1M token | Hòa |
| Đầu ra tối đa | ~131K token | Tối đa 384K token | DeepSeek |
| Phương thức | Đa phương thức gốc (đầu vào văn bản + hình ảnh + video) | Chủ yếu văn bản (các biến thể thị giác thử nghiệm có sẵn) | GLM |
| Nổi bật kiến trúc | Chú ý thưa + chú ý tuyến tính lai (~3× chi phí chú ý thấp hơn, ~4,4× KV cache nhỏ hơn so với GLM-5.3 đầy đủ) | Compressed Sparse Attention (CSA) + Heavily Compressed Attention (HCA) | Mỗi bên có thế mạnh |
| Giấy phép | MIT (trọng số trên Hugging Face) | MIT (trọng số có sẵn) | Hòa |
| Giá API tiêu chuẩn ($ / 1M token) | Đầu vào $0,15 / Đầu ra $0,50 (đầu vào được cache ~ $0,03) | Khoảng phổ biến $0,14–$0,44 đầu vào / $0,28–$1,32 đầu ra (khác nhau theo giờ cao điểm/ngoài cao điểm) | GLM rẻ hơn |
| Giá khuyến mãi ra mắt | ~$0,075 đầu vào / $0,25 đầu ra (thời gian giới hạn, ~đầu tháng 9/2026) | Không có khuyến mãi tương đương | GLM |
| Chỉ số Trí tuệ AA | 57 (do nhà cung cấp báo cáo) | ~50 (đo lường độc lập) | GLM |
| Terminal-Bench 2.1 | 84.3 | 82.7 | GLM |
| DeepSWE | 63.4 | 54.4 | GLM |
| SWE-bench Verified | Dữ liệu độc lập còn hạn chế | ~79% (kết quả độc lập mạnh) | DeepSeek |
| Điểm mạnh chính | Giá thấp hơn, đa phương thức gốc, dẫn đầu ở một số điểm mã hóa/tác tử, hiệu quả ngữ cảnh dài | Xác thực độc lập trưởng thành hơn, thành tích xuất sắc cho tác nhân mã hóa, thiết kế ngữ cảnh dài hiệu quả, hệ sinh thái mạnh | — |
| Điểm yếu chính | Ra mắt mới (một số điểm vẫn do nhà cung cấp báo cáo); tốc độ trung bình | Hỗ trợ đa phương thức yếu hơn; giá hiệu dụng cao hơn ở nhiều kênh | — |
| Phù hợp nhất cho | Sử dụng chung, khối lượng công việc đa phương thức, dự án nhạy chi phí, khả năng tác tử cân bằng | Tác nhân thuần mã hóa, lập luận văn bản ngữ cảnh dài, kịch bản cần kiểm chuẩn độc lập đã được chứng thực | — |
Tóm tắt một câu:
Tính đến cuối tháng 8/2026, GLM-5.3-Flash hiện dẫn đầu về giá, khả năng đa phương thức và một số kiểm chuẩn chồng lấp, mang lại giá trị tổng thể tốt hơn. DeepSeek V4 Flash vẫn là lựa chọn đáng tin cậy cho các tác nhân tập trung mã hóa nhờ xác thực độc lập mạnh và hiệu quả ngữ cảnh dài. Hãy thử cả hai trên khối lượng công việc cụ thể của bạn trước khi quyết định.
Các trường hợp sử dụng GLM-5.3-Flash
1. Kỹ nghệ phần mềm tác tử
GLM-5.3-Flash đặc biệt phù hợp với các tác nhân mã hóa cần kiểm tra kho, sửa nhiều tệp, chạy lệnh terminal, chạy kiểm thử và lặp lại triển khai.
Điểm 84,3 ở Terminal-Bench 2.1 và 63,4 ở DeepSWE cho thấy kỹ nghệ phần mềm là một trong những lĩnh vực ứng dụng mạnh nhất của mô hình.
2. Mã hóa dựa trên hình ảnh
Vì GLM-5.3-Flash là đa phương thức gốc, nhà phát triển có thể cung cấp ảnh chụp màn hình, sơ đồ và các đầu vào hình ảnh khác kèm theo hướng dẫn mã hóa. Điều này hữu ích cho triển khai UI, gỡ lỗi giao diện trực quan và quy trình từ thiết kế tới mã.
3. Phân tích tài liệu ngữ cảnh dài
Cửa sổ ngữ cảnh 1M token khiến mô hình phù hợp với các bộ tài liệu kỹ thuật lớn, kho mã, báo cáo dài và lịch sử tác tử nhiều giai đoạn.
4. Tác nhân trình duyệt và sử dụng máy tính
Khả năng sử dụng công cụ và đa phương thức của mô hình khiến nó phù hợp với các quy trình liên quan tới trình duyệt, giao diện đồ họa và công cụ bên ngoài.
5. Công việc tri thức doanh nghiệp
GLM-5.3-Flash có thể xử lý lượng lớn thông tin có cấu trúc và phi cấu trúc đồng thời dùng công cụ để thực hiện các tác vụ đa bước, phù hợp cho phân tích tài liệu, trợ lý nghiên cứu và tự động hóa quy trình.
6. Hạ tầng AI tự lưu trữ
Giấy phép MIT và trọng số công khai khiến GLM-5.3-Flash hấp dẫn với các tổ chức cần kiểm soát triển khai, xử lý dữ liệu và hạ tầng suy luận.
Tham số API của GLM-5.3-Flash
| Parameter | Description |
|---|---|
| model | Định danh mô hình của nhà cung cấp |
| messages | Đầu vào hội thoại có cấu trúc |
| prompt | Đầu vào prompt đơn trên các API được hỗ trợ |
| max_tokens / max_completion_tokens | Giới hạn token đầu ra |
| temperature | Điều khiển độ ngẫu nhiên khi lấy mẫu |
| tools | Định nghĩa công cụ/hàm |
| stream | Bật truyền phát đầu ra |
| reasoning | Điều khiển mức độ lập luận trên các cổng hỗ trợ |
| Image content | Được hỗ trợ |
| Function calling | Được hỗ trợ |
| Context | Tối đa 1M token |
Vercel AI Gateway hiện ghi nhận tối đa 131.000 token đầu ra, với token lập luận được tính vào giới hạn đầu ra.
Cách sử dụng API GLM-5.3-Flash trong CometAPI
Bước 1: Nhận quyền truy cập API
Đăng nhập vào cometAPI. Nếu bạn chưa phải là người dùng, vui lòng đăng ký trước. Đăng nhập vào CometAPI console. Lấy khóa API truy cập giao diện. Nhấp “Add Token” tại mục API token trong trung tâm cá nhân, nhận khóa token: sk-xxxxx và gửi.
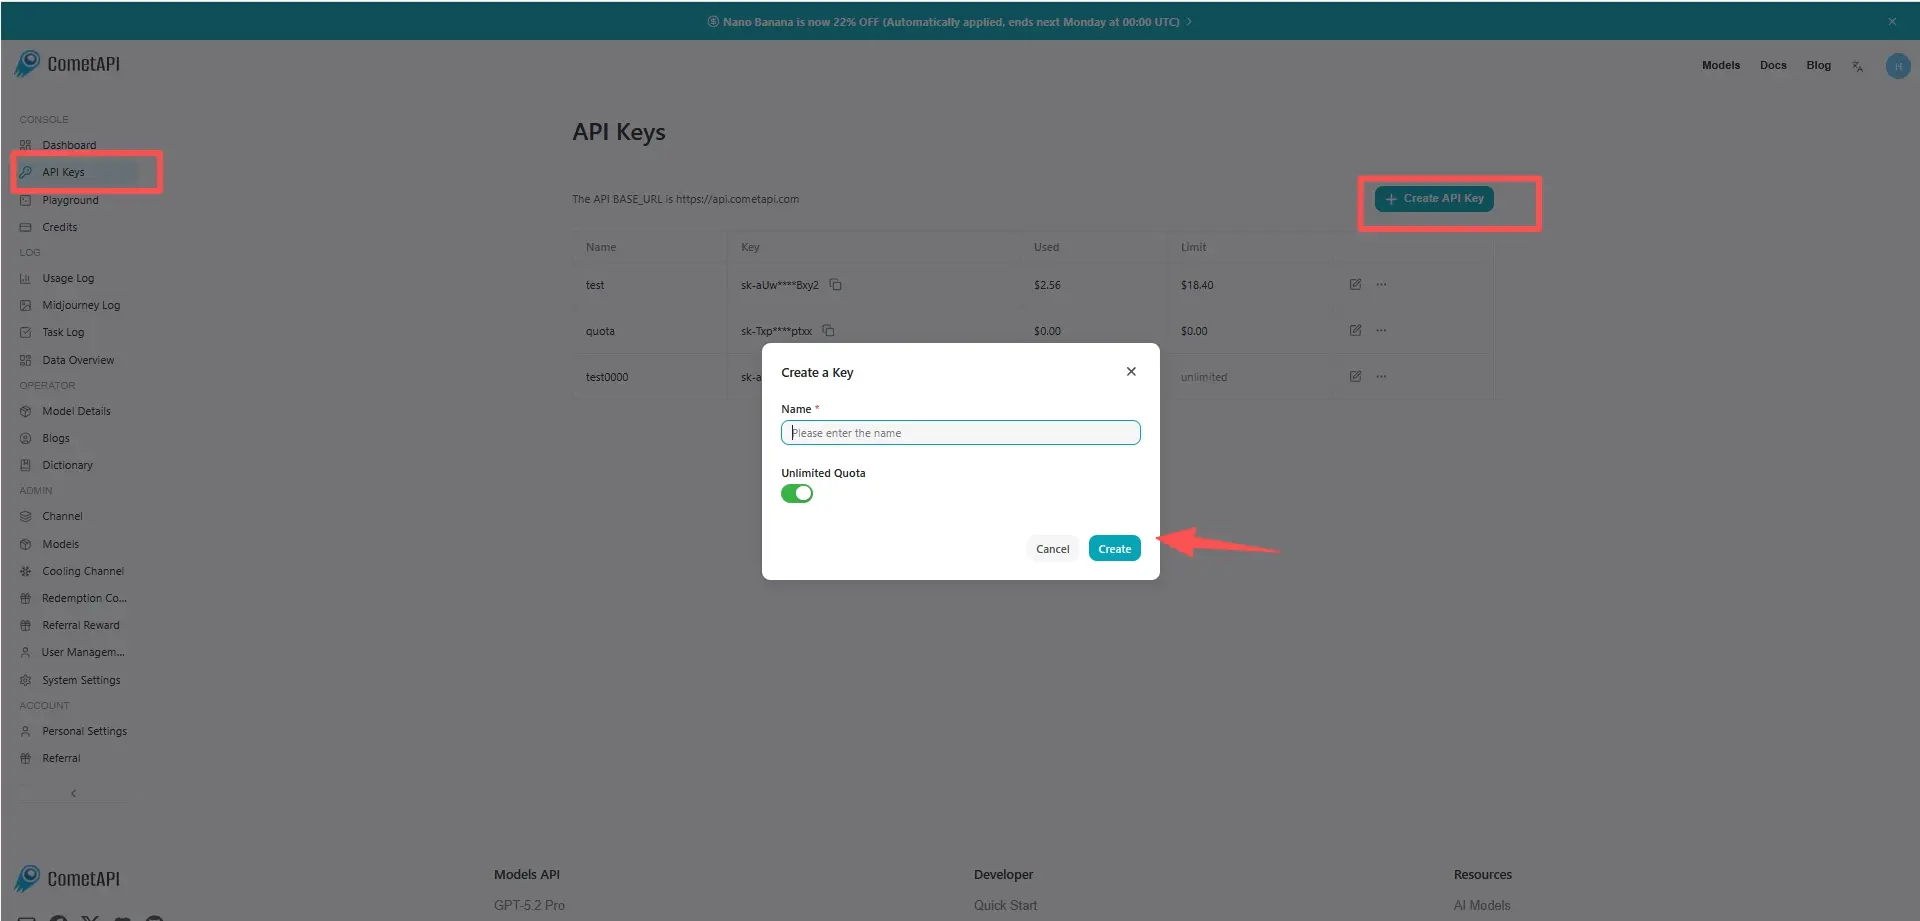
Bước 2: Gửi yêu cầu tới API GLM-5.3-Flash
Chọn endpoint “GLM-5.3-Flash” để gửi yêu cầu API và thiết lập phần thân yêu cầu. Phương thức yêu cầu và phần thân yêu cầu được lấy từ tài liệu API trên trang web của chúng tôi. Trang web của chúng tôi cũng cung cấp Apifox để thử nghiệm thuận tiện. Thay thế <YOUR_API_KEY> bằng khóa CometAPI thực tế từ tài khoản của bạn.
Chèn câu hỏi hoặc yêu cầu của bạn vào trường nội dung—đây là phần mô hình sẽ phản hồi. Xử lý phản hồi API để lấy câu trả lời được tạo.
Bước 3: Xử lý phản hồi
API trả về các phản hồi ứng viên có cấu trúc bao gồm văn bản sinh ra, trích dẫn, siêu dữ liệu an toàn và đầu ra công cụ tùy chọn. Đối với yêu cầu đa phương thức, nội dung thông điệp có thể được cấu trúc với đầu vào văn bản và hình ảnh khi endpoint CometAPI đã chọn cung cấp khả năng thị giác của mô hình.
Endpoint CometAPI chính xác, tham số được hỗ trợ và tình trạng khả dụng hiện tại cần được lấy từ tài liệu API CometAPI đang hoạt động thay vì suy diễn từ API gốc của Z.ai.
Với CometAPI, tích hợp nên sử dụng ID mô hình hiển thị trên endpoint mô hình CometAPI đang hoạt động thay vì tự động sao chép các ID theo nhà cung cấp từ Z.ai, Cloudflare hoặc Vercel.
Hạn chế của GLM-5.3-Flash
- Dấu chân mô hình lớn: Mặc dù chỉ 18B tham số được kích hoạt, mô hình phát hành chứa khoảng 321B tham số, khiến tự lưu trữ đòi hỏi nhiều hơn đáng kể so với triển khai một mô hình 7B–70B thông thường.
- Tốc độ suy luận không nhất thiết “nhanh như chớp” theo nghĩa tuyệt đối: Artificial Analysis hiện đo khoảng 50 token đầu ra/giây trong môi trường so sánh của họ, đặt mô hình thấp hơn nhiều so với các mô hình nhỏ nhanh nhất.
- Ngữ cảnh rất dài làm tăng yêu cầu hạ tầng: Cửa sổ 1M token hữu ích nhưng có thể tăng bộ nhớ và độ phức tạp phục vụ.
- Hiệu năng kiểm chuẩn khác nhau theo tác vụ: GLM-5.3-Flash đặc biệt mạnh ở các kiểm chuẩn lập trình tác tử và sử dụng công cụ, nhưng không có kiểm chuẩn đơn lẻ nào xác lập ưu thế phổ quát so với các mô hình độc quyền ở tuyến đầu.
- Đầu ra đa phương thức bị hạn chế: Khả năng đa phương thức gốc của mô hình chủ yếu ở phía đầu vào; đầu ra chuẩn là văn bản thay vì sinh hình ảnh hoặc video.