
TL;DR
Claude Haiku 5.5 là model nhỏ nhanh nhất của Anthropic ở tốc độ tiêu chuẩn cho các tác vụ khối lượng lớn, nhạy cảm với độ trễ. Model kết hợp cửa sổ ngữ cảnh 1 triệu token, giới hạn đầu ra tiêu chuẩn 128K, lập luận thích ứng và mức giá cơ bản bắt đầu từ $0.10 cho mỗi triệu token đầu vào và $0.50 cho mỗi triệu token đầu ra. Mức giá tăng khi prompt vượt 100,000 token. Với các tác vụ lập trình phức tạp và công việc agent kéo dài, Sonnet 5.5 và Opus 5.5 vẫn là lựa chọn mạnh hơn. Giá Standard của CometAPI thấp hơn 20% so với mức chính thức, bắt đầu từ $0.08 cho mỗi triệu token đầu vào và $0.40 cho mỗi triệu token đầu ra. Trang model CometAPI đã hoạt động và báo cáo quyền truy cập API sản xuất.
Key Takeaways
- Phát hành chính thức: 7 tháng 10, 2026; Claude API model ID: claude-haiku-5-5.
- Mức giá API khởi điểm: $0.10 cho đầu vào và $0.50 cho đầu ra trên mỗi triệu token với prompt tới 100K token. CometAPI: $0.08 cho đầu vào và $0.40 cho đầu ra trên mỗi triệu token ở mức 80% giá Standard chính thức.
- Ngữ cảnh và đầu ra: 1M token ngữ cảnh và 128K token đầu ra tiêu chuẩn.
- Trọng tâm: phân loại, trích xuất tài liệu, định tuyến, hỗ trợ và các tác vụ agent ủy quyền.
- Tokenizer mới có thể đếm nhiều hơn khoảng 30% token cho cùng một văn bản; hãy đánh giá chi phí theo mỗi tác vụ được chấp nhận thay vì chỉ dựa vào giá mỗi token.
What Is Claude Haiku 5.5?
Claude Haiku 5.5 là thành viên nhẹ của dòng Claude hiện tại của Anthropic, được phát triển cho khối lượng yêu cầu lớn nơi khả năng phản hồi và kinh tế vận hành là trọng yếu. Ứng dụng chính của model bao gồm xử lý tài liệu, hỗ trợ hội thoại, trích xuất thông tin và các công việc subagent gọn nhẹ. Tổng quan model của Anthropic xác nhận ngày ra mắt, năng lực và định danh trên nền tảng.
Claude Haiku 5.5 là model Haiku đầu tiên hỗ trợ mức effort có thể cấu hình, cho phép nhà phát triển đánh đổi giữa độ sâu lập luận, độ trễ và mức sử dụng token trong cùng một model.
What Are the Key Features of Claude Haiku 5.5?
Adaptive thinking and adjustable effort
Haiku 5.5 có thể quyết định khi nào và lập luận ở mức nào, trong khi tham số effort cung cấp cho nhà phát triển cách cân bằng giữa chất lượng phản hồi, độ trễ và mức dùng token. Effort mặc định là mức medium. Với phân loại đơn giản, low effort có thể phù hợp; với trích xuất mơ hồ hoặc bước lập kế hoạch công cụ, mức cao hơn có thể hợp lý.
Large-context processing
Cửa sổ ngữ cảnh 1M token cho phép các tài liệu dài và lịch sử hội thoại lớn nằm trong một yêu cầu duy nhất. Nhà phát triển vẫn nên dùng truy xuất, cắt ngắn và bộ nhớ đệm khi phù hợp: ngữ cảnh dài có thể gây chi phí không cần thiết và đánh đổi độ chính xác, đặc biệt vượt ngưỡng giá 100K.
Low-cost high-throughput processing
Mức giá khởi điểm mới $0.10/$0.50 khiến các yêu cầu ngắn lặp lại rẻ hơn đáng kể so với thế hệ Haiku trước trên cơ sở mỗi token. Tuy nhiên, Anthropic ghi nhận tokenizer thay đổi: văn bản giống hệt tạo ra khoảng 30% nhiều token hơn so với Haiku 4.5. Vì vậy, mức tiết kiệm ở cấp độ tác vụ thực tế có thể nhỏ hơn mức giảm giá tiêu đề.
Computer use and delegated agent tasks
Các đánh giá đã công bố cho thấy hiệu năng mạnh hơn trong các tác vụ tương tác máy tính và tác vụ hỗ trợ bởi công cụ so với model Haiku trước. Điều này giúp Haiku 5.5 hữu ích cho các bước agent có phạm vi, nhưng tự động hóa thành công vẫn phụ thuộc vào quyền công cụ chặt chẽ, khả năng phục hồi lỗi và phê duyệt của con người cho các hành động rủi ro.
How Does Claude Haiku 5.5 Perform on Benchmarks?
Anthropic báo cáo mức tăng đáng kể trên các tác vụ kiến thức chuyên môn, sử dụng máy tính, lập trình và lập luận. Kết quả dưới đây dùng thiết lập đánh giá được báo cáo; điểm số từ các benchmark khác nhau không nên gộp lại thành một “điểm thông minh” duy nhất.
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
| AA-Briefcase v1.1 (Elo) | 614 | 1,578 | 1,824 |
| OSWorld 2.1, offline subset, partial credit | 15.7% | 72.4% | 83.9% |
| Humanity's Last Exam, no tools | 10.2% | 45.9% | 56.9% |
| Humanity's Last Exam, with tools | 18.7% | 57.4% | 64.5% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Chartography, no tools | 6.4% | 46.4% | 61.6% |
Cấu hình đánh giá tiêu chuẩn của system card cho Haiku 5.5 dùng tư duy thích ứng ở mức effort tối đa, sampling mặc định và 5 lần thử trừ khi được ghi chú; mặc định sản phẩm là mức medium, nên điểm tiêu đề không phải là đảm bảo ở thiết lập mặc định. OSWorld dùng 82 tác vụ ngoại tuyến, không có truy cập internet, 1080p và giới hạn 500 hành động. Điểm 72.4% là điểm tính một phần; tỷ lệ đậu nghiêm ngặt là 37.1%. GDPval-AA và AA-Briefcase được Anthropic báo cáo từ các đánh giá do Artificial Analysis thực hiện độc lập.
Terminal-Bench 4.0 dùng Claude Code ở chế độ --bare với các cơ chế bảo vệ được bật. Haiku 5.5 dùng effort tối đa, không có model dự phòng và không có egress internet, với 10 lần thử mỗi tác vụ; Sonnet 5.5 dùng 5 lần thử và có fallback cho một số yêu cầu bị gắn cờ. Haiku 4.5 dùng ngân sách thinking cố định 63,999 token. Những khác biệt cấu hình này quan trọng khi diễn giải 39.2% so với 70.6%.
Kết quả benchmark đã công bố của Anthropic cung cấp các điểm số trên. OSWorld dùng tập con ngoại tuyến; Humanity's Last Exam tách chạy có công cụ và không công cụ, và Chartography là không công cụ. Đây là kết quả do nhà cung cấp báo cáo, không phải đo lường độc lập dưới một cấu hình chung phổ quát. Anthropic cung cấp chi tiết đánh giá trong system card Haiku 5.5; hãy tái tạo các thiết lập effort, công cụ, scaffold và ngân sách phù hợp trước khi so sánh kết quả của riêng bạn. Tóm tắt ra mắt không chỉ rõ một môi trường thử nghiệm chung hoàn chỉnh cho mọi hàng.
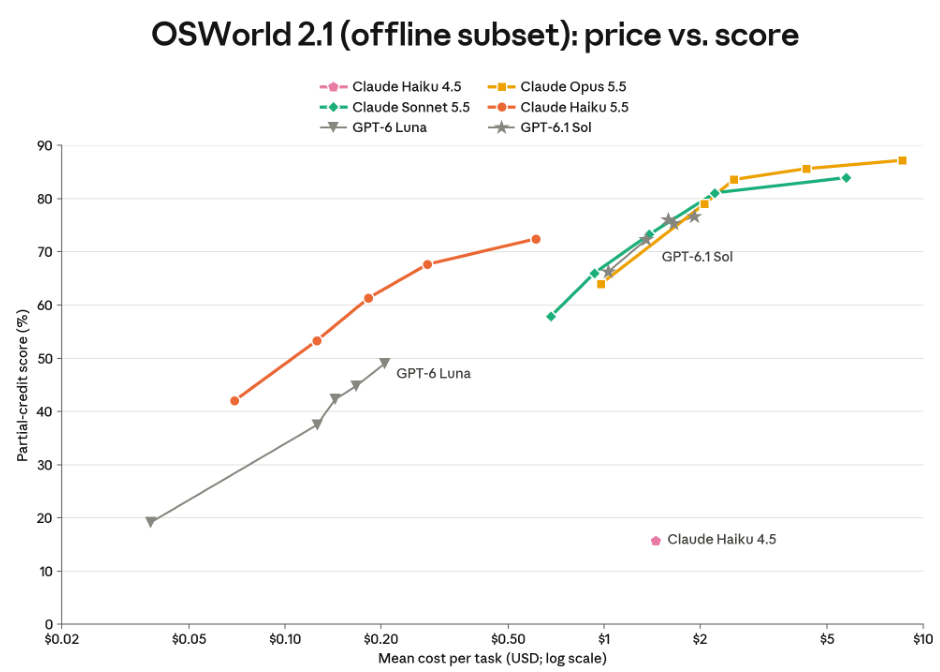
Đồ họa đánh giá chính thức của Anthropic ở trên được trích lại từ system card. Nó cung cấp thêm bằng chứng về các cấu hình được đánh giá; không phải benchmark mới cho bài viết này.
Benchmark Interpretation
Cải thiện trên OSWorld gợi ý Haiku 5.5 trở nên hữu ích đáng kể cho các tác vụ đồ họa có cấu trúc. Tuy nhiên, 70.6% của Sonnet 5.5 so với 39.2% của Haiku 5.5 trong Terminal-Bench cho thấy ưu thế tiếp tục của model lớn hơn trong lập trình dạng agent. Hãy chọn model theo chi phí thất bại và độ khó của quy trình thực tế.
Claude Haiku 5.5 vs Haiku 4.5 vs Sonnet 5.5
| Dimension | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Context | 200K | 1M | 1M |
| Max standard output | 64K | 128K | 128K |
| Standard input / MTok | $1 | $0.10 tới 100K; $0.50 quá | $2 |
| Standard output / MTok | $5 | $0.50 tới 100K; $2.50 quá | $10 |
| Reasoning | Tư duy mở rộng với ngân sách token cố định | Thích ứng; mặc định medium | Thích ứng; mặc định cao |
| Relative latency | Nhanh | Nhanh nhất ở tốc độ tiêu chuẩn | Nhanh |
| Coding depth | Tác vụ giới hạn | Subagent mạnh hơn | Lập trình phức tạp hơn |
| Typical use | Triển khai model nhỏ kế thừa | Quy trình khối lượng lớn | Quy trình sản xuất phức tạp |
Thông số chung: cả ba model chấp nhận đầu vào văn bản và hình ảnh và tạo đầu ra văn bản. Chúng có thể truy cập qua Claude API và các nền tảng đối tác hỗ trợ; định danh model và quyền truy cập tài khoản phụ thuộc nhà cung cấp. Tài liệu sản phẩm trích dẫn không nêu số tham số hay kiến trúc chi tiết.
Haiku 5.5 là lựa chọn đầu tiên hợp lý cho các tác vụ có thể xác minh và lặp lại. Sonnet 5.5 trở nên hấp dẫn nơi phán đoán mạnh hơn giúp giảm các cuộc gọi thất bại, thử lại công cụ hoặc sửa chữa của con người. Opus 5.5 là tùy chọn cho các nhiệm vụ nhiều bước đặc biệt đòi hỏi cao.
Nhãn độ trễ so sánh đề cập tới chế độ tốc độ tiêu chuẩn. Phân loại tốc độ của Anthropic loại trừ Opus Fast Mode khỏi tuyên bố model nhanh nhất. Chi tiết kiến trúc như số tham số không được xác lập bởi các tầng sản phẩm này. Đầu vào văn bản-và-hình ảnh với đầu ra văn bản khác với sinh ảnh.
So sánh năng lực dựa theo thông số model của Anthropic. Khả năng truy cập nền tảng phụ thuộc nhà cung cấp và tài khoản đã chọn; không tầng model nào ngụ ý số tham số được công bố.
Workload Selection
| Workload | Practical default | Why |
|---|---|---|
| Email classification | Haiku 5.5 | Quyết định ngắn, lặp lại, có thể xác minh |
| Document field extraction | Haiku 5.5 | Xử lý có cấu trúc tiết kiệm chi phí |
| Support triage | Haiku 5.5 | Phản hồi nhanh và leo thang |
| Coding subagents | Haiku 5.5 | Tìm kiếm file giá rẻ và chỉnh sửa giới hạn |
| Complex debugging | Sonnet 5.5 | Hiệu năng benchmark lập trình mạnh hơn |
| High-stakes multi-step reasoning | Opus 5.5 | Model tầng trên có năng lực hơn |
| Mixed workload | Haiku + Sonnet | Định tuyến theo độ phức tạp và độ tự tin |
How Much Does Claude Haiku 5.5 Cost?
Why is Haiku 5.5 advertised as “around 75% cheaper” if its token price is 90% lower?
Con số 90% mô tả mức giảm ở giá Standard đầu vào và đầu ra cho prompt tới 100,000 token; prompt dài hơn nhận mức giảm 50%. Anthropic báo cáo Haiku 5.5 rẻ hơn khoảng 75% để vận hành trung bình, tính đến phân bố độ dài yêu cầu của model trước và thay đổi mức dùng token theo tác vụ. Tokenization là một yếu tố: cùng một văn bản đầu vào có thể đếm nhiều hơn khoảng 30% token, nên ước tính chi phí nên dùng số đếm với model mới.
Giá chính thức của Anthropic có hai dải độ dài prompt. Bảng đầu tiên là giá USD chính thức mỗi triệu token; so sánh CometAPI dưới đây áp dụng giảm 20% lên giá Standard đầu vào và đầu ra chính thức.
| Rate category | Prompt up to 100K | Prompt over 100K |
|---|---|---|
| Input | $0.10 | $0.50 |
| Output | $0.50 | $2.50 |
| 5-minute cache write | $0.125 | $0.625 |
| 1-hour cache write | $0.20 | $1.00 |
| Cache read | $0.01 | $0.05 |
| Batch input (50% off) | $0.05 | $0.25 |
| Batch output (50% off) | $0.25 | $1.25 |
Giá Standard, cache và Batch chính thức hiển thị ở trên, kiểm tra ngày 8 tháng 10, 2026. Độ dài prompt quyết định dải giá áp dụng; dải cao hơn áp dụng cho cả yêu cầu thay vì chỉ phần token vượt 100K. Giá Standard của CometAPI dưới đây bằng giá Standard chính thức tương ứng nhân với 0.8. So sánh này không giả định chiết khấu của gateway cộng dồn với chiết khấu Batch hoặc cache.
| Prompt length | Token category | Official Standard / MTok | CometAPI / MTok |
|---|---|---|---|
| Up to 100K tokens | Input | $0.10 | $0.08 |
| Up to 100K tokens | Output | $0.50 | $0.40 |
| Over 100K tokens | Input | $0.50 | $0.40 |
| Over 100K tokens | Output | $2.50 | $2.00 |
Example: 100,000 short requests per month
Giả sử mỗi yêu cầu dùng 2,000 token đầu vào và 500 token đầu ra; mỗi yêu cầu vẫn dưới ngưỡng 100K. Bỏ qua bộ nhớ đệm prompt, công cụ và thử lại, và giả sử số token giống nhau giữa các model để minh họa.
| Model / provider | Input/month | Output/month | Total/month |
|---|---|---|---|
| Haiku 4.5 — official Standard | $200 | $250 | $450 |
| Haiku 5.5 — official Standard | $20 | $25 | $45 |
| Sonnet 5.5 — official Standard | $400 | $500 | $900 |
| Haiku 5.5 — CometAPI | $16 | $20 | $36 |
Trong ví dụ này, 100,000 yêu cầu dùng 200 triệu token đầu vào và 50 triệu token đầu ra. Chi phí đầu vào CometAPI là 200 × $0.08 = $16 và đầu ra là 50 × $0.40 = $20, tổng $36 mỗi tháng so với $45 chính thức: tiết kiệm $9, tương đương 20%. Kịch bản loại trừ cache, công cụ và thử lại và dùng số token cố định; hãy đo chi phí trên mỗi tác vụ được chấp nhận với đầu vào đại diện vì tokenizer mới thay đổi số token.
So sánh $450 xuống $45 là minh họa cố định-token của mức giảm giá 90%, không phải lời hứa tiết kiệm 90% cho khối lượng công việc tương đương trong thực tế. Trong thông báo ra mắt, Anthropic báo cáo chi phí vận hành trung bình thấp hơn khoảng 75% sau khi tính đến độ dài yêu cầu và thay đổi mức sử dụng token. Hãy đếm lại đầu vào đại diện và đo chi phí tác vụ hoàn thành trước khi ước tính mức tiết kiệm của riêng bạn.
Where Can You Access Claude Haiku 5.5?
Official access and cloud platforms
Haiku 5.5 khả dụng qua Claude API và các nền tảng hỗ trợ trên Amazon Web Services, Google Cloud và Microsoft Azure, theo thông báo khả dụng của Anthropic. Model ID trực tiếp trên Claude API là claude-haiku-5-5; Amazon Bedrock dùng anthropic.claude-haiku-5-5. Sử dụng thông tin xác thực do nhà cung cấp bạn chọn cấp và kiểm tra yêu cầu quyền truy cập tài khoản hiện tại của họ.
Third-party access through CometAPI
Trang model CometAPI liệt kê claude-haiku-5-5 là khả dụng, với giá Standard bắt đầu từ $0.08 trên mỗi triệu token đầu vào và $0.40 trên mỗi triệu token đầu ra cho prompt tới 100K, thấp hơn 20% so với giá Standard chính thức tương ứng. Dùng khóa do CometAPI cấp với endpoint và định dạng yêu cầu của CometAPI; đây là tuyến truy cập riêng biệt so với truy cập trực tiếp Anthropic API. Kiểm tra trang trực tiếp để biết tình trạng khả dụng, dải giá và chi tiết tích hợp.
Khi chuyển nhà cung cấp hoặc nâng cấp từ Haiku 4.5, hãy xác minh model ID, đếm lại token và kiểm thử giới hạn phản hồi và xử lý hội thoại. Với chi tiết triển khai và thay đổi gây phá vỡ, hãy tham khảo hướng dẫn migration của Anthropic.
Migration Validation
- Cập nhật model ID và xác thực các trường yêu cầu đặc thù endpoint.
- Đếm lại token với tokenizer cập nhật, bao gồm prefix ổn định và định nghĩa công cụ.
- Kiểm thử thiết lập tư duy thích ứng, phân phối độ trễ và parsing khối phản hồi.
- Kiểm tra lệnh gọi công cụ, phục hồi lỗi và mọi hạn chế tài khoản trên các khối thinking được lưu.
- So sánh độ trễ p50/p95, tỷ lệ tác vụ được chấp nhận và tổng token tính phí.
- Dùng rollout theo giai đoạn và đường quay lui cho các quy trình nghiệp vụ quan trọng.
- Assistant prefill bị cấm
Hướng dẫn migration Haiku 5.5 giải thích hành vi tokenizer, ID và khả năng tương thích yêu cầu. Bỏ qua temperature, top_p và top_k. Nếu cung cấp tường minh, temperature phải là 1 và top_p phải là 0.99; bất kỳ giá trị top_k nào, hoặc cung cấp cả temperature và top_p, sẽ trả lỗi 400.
What Are the Limitations of Claude Haiku 5.5?
Haiku 5.5 không phải là sự thay thế phổ quát cho các model lớn hơn. Lập trình phức tạp và lập luận dài hạn vẫn là khác biệt có ý nghĩa cho Sonnet và Opus. Prompt dài hơn cũng tốn kém hơn, nên cửa sổ 1M token cần được dùng có chọn lọc. Lập luận thích ứng đưa thêm biến thiên trong token sinh và độ trễ; benchmark không thiết lập bảo đảm cho một quy trình nghiệp vụ cụ thể.
Tự động hóa nhạy cảm rủi ro nên xác thực đầu ra có cấu trúc, giới hạn quyền công cụ bên ngoài, lưu nhật ký kiểm toán và yêu cầu xem xét trước các hành động hệ trọng. Định tuyến các tác vụ không chắc chắn tới model mạnh hơn thay vì chỉ dựa vào giá token cơ bản thấp của Haiku.
Conclusion
Đối với xử lý khối lượng lớn với tiêu chí chấp nhận đo lường được, Claude Haiku 5.5 là nâng cấp hấp dẫn: giá vào thấp hơn, ngữ cảnh lớn hơn, lập luận thích ứng và đánh giá công bố mạnh hơn. Với lập trình phức tạp và quyết định mơ hồ, Sonnet 5.5 hoặc Opus 5.5 có thể mang lại kinh tế tổng thể tốt hơn bằng cách giảm thử lại và chỉnh sửa. Chiến lược thắng lợi là benchmark toàn bộ quy trình và định tuyến yêu cầu theo độ khó.
FAQ
How does Haiku 5.5's 100K pricing boundary affect a cached workflow?
Độ dài prompt xác định dải giá áp dụng; đừng ước tính phí chỉ từ văn bản mới hoặc giả định chỉ phần vượt dùng dải cao hơn. Hãy đếm yêu cầu cho model đã chọn, bao gồm lịch sử và định nghĩa công cụ, rồi đối chiếu đầu vào, ghi cache, đọc cache và đầu ra với dải liên quan. So sánh hóa đơn trên các yêu cầu có cache đại diện trước khi đặt ngân sách sản xuất.
Can Haiku 5.5 thinking blocks be replayed across accounts?
Chúng chỉ hoạt động trong tài khoản đã tạo ra hoặc tài khoản liên kết với nó. Nếu một tài khoản không liên quan gửi một khối thinking đã lưu, API sẽ loại bỏ trước khi model thấy; yêu cầu vẫn có thể thành công mà không có lập luận đó. Xem hướng dẫn migration chính thức. Hãy giữ các khối hội thoại và dùng tài khoản gốc hoặc đã liên kết khi tiếp tục một quy trình công cụ. Thay đổi gateway hoặc tài khoản nên được thử nghiệm tường minh; trùng tên model không đảm bảo các khối thinking đã lưu còn dùng được.
Why can Haiku 5.5 truncate a response that Haiku 4.5 completed?
Tokenizer mới có thể đếm nhiều token hơn cho cùng văn bản, nên giới hạn max_tokens không đổi có thể chứa ít đầu ra tương đương hơn. Lập luận thích ứng cũng có thể tiêu thụ ngân sách đầu ra. Hãy kiểm tra stop_reason và usage, đếm lại prompt với model mới, và tinh chỉnh mức cho phép đầu ra trên tác vụ thực tế thay vì sao chép giới hạn cũ.
How should Haiku 5.5 routing thresholds be selected?
Dùng mẫu có nhãn từ khối lượng công việc thực tế để đo tỷ lệ tác vụ được chấp nhận, chi phí chỉnh sửa và độ trễ. Định tuyến yêu cầu không vượt qua xác thực tường minh hoặc vượt phạm vi tác vụ đã thử nghiệm sang model mạnh hơn. Tinh chỉnh ngưỡng theo chi phí toàn quy trình, bao gồm thử lại và leo thang, và theo dõi sau các thay đổi về prompt, công cụ hoặc effort.