Xây dựng với CometAPICần một API cho nhiều mô hình?Kiểm thử quy trình trong Playground, sau đó tạo API key khi mô hình và chi phí phù hợp với trường hợp sử dụng của bạn.
Step 5 Preview là mô hình AI chủ lực của StepFun dành cho kỹ thuật phần mềm, nghiên cứu tài chính và các quy trình tác nhân phức tạp. Mô hình kết hợp hiệu năng nhiệm vụ cạnh tranh với suy luận tiết kiệm chi phí, dù kết quả khác nhau giữa các benchmark. Nhà phát triển có thể truy cập qua API được lưu trữ hoặc triển khai trọng số mở, tùy ngân sách, hạ tầng và yêu cầu hiệu năng.
Key Takeaways
Kiến trúc: Step 5 Preview sử dụng kiến trúc MoE thưa với tổng 600B tham số và 27B tham số hoạt động trên mỗi token, cân bằng dung lượng mô hình và hiệu quả suy luận.
Ngữ cảnh và hỗ trợ đa phương thức: Mô hình hỗ trợ cửa sổ ngữ cảnh 1M token, đầu vào văn bản, hình ảnh và video, cùng tối đa 64K token đầu ra qua API được lưu trữ.
Hiệu năng benchmark: Step 5 Preview đạt 67.7% trên DeepSWE v1.1 và 66.4% trên FrontierFinance, dù tụt sau một số đối thủ trên Terminal-Bench v4.
Giá API: StepFun tính $1.00 cho đầu vào chưa được cache, $0.10 cho đầu vào đã cache, và $2.70 cho đầu ra mỗi triệu token.
Đã được xem xét về độ rõ ràng, ghi nguồn và thuật ngữ API hiện tại.
Linh hoạt triển khai: Nhà phát triển có thể truy cập Step 5 Preview qua API do StepFun lưu trữ hoặc tự lưu trữ trọng số đã phát hành bằng các framework tương thích như vLLM, SGLang và Transformers.
What Is Step 5 Preview?
Step 5 Preview là mô hình suy luận đa phương thức quy mô lớn do StepFun (阶跃星辰) phát triển. Mô hình nhắm đến các tác vụ cần suy luận kéo dài, thực thi công cụ lặp lại, và phân tích trên các tập thông tin lớn. StepFun cung cấp truy cập API được lưu trữ và phát hành trọng số mô hình có thể tải xuống.
Khác với trợ lý đa dụng tối ưu cho phản hồi hội thoại, Step 5 Preview nhấn mạnh thực thi mang tính tác nhân: khả năng lập kế hoạch, sử dụng công cụ, kiểm tra kết quả trung gian, sửa lỗi và tiếp tục hướng tới mục tiêu phức tạp.
Specification (model card and API documentation linked above)
Step 5 Preview
Developer
StepFun
Model identifier
step-5-preview
Model category
Multimodal reasoning and agentic LLM
Architecture
Sparse Mixture-of-Experts
Total parameters
Approximately 600B
Active parameters per token
Approximately 27B
Active parameter proportion
Approximately 4.5%
Context window
Up to 1M tokens
Supported inputs
Text, images, and video on the hosted API
Hosted API maximum output
64k tokens
Primary output
Text
Reasoning modes
low, medium, high; reasoning_effort on Chat Completions
Tool calling
Supported
Structured output
JSON Mode and JSON Schema on the hosted API
Prompt caching
Supported
Hosted API status
Available as of October 19, 2026
Weight availability
Tài liệu API được lưu trữ nêu tối đa 64k token đầu ra, trong khi model card liệt kê khả năng sinh chuỗi lên đến 1M token. Con số sau không phải cam kết rằng endpoint lưu trữ chấp nhận phần hoàn thành 1M token. Với ví dụ tự lưu trữ vLLM, ngân sách chuỗi 1M token được cấu hình bao gồm cả đầu vào và đầu ra; bộ nhớ KV-cache khả dụng và mức đồng thời có thể giảm dung lượng dùng được.
How the 600B/27B MoE Architecture Works
Transformer đặc thù dạng dense kích hoạt phần lớn tham số trong lúc suy luận. Step 5 Preview thay vào đó dùng định tuyến thưa để chọn chuyên gia phù hợp. Với khoảng 27B tham số hoạt động trong tổng 600B, khoảng 4.5% số tham số tổng tham gia tính toán cho một token điển hình.
Sự khác biệt này giúp giải thích chiến lược tiết kiệm chi phí. Tuy nhiên, 27B hoạt động không có nghĩa là dấu chân triển khai 27B. Trọng số của toàn bộ chuyên gia vẫn phải được lưu trữ và truy xuất, khiến dung lượng bộ nhớ GPU, song song chuyên gia và băng thông liên kết nội bộ trở thành cân nhắc thiết yếu.
Supported Inputs and Output Limits
API được lưu trữ chấp nhận văn bản, hình ảnh và video, với cửa sổ ngữ cảnh lên đến 1M token và tối đa 64k token đầu ra. Các đầu vào này hỗ trợ các tác vụ như phân tích repository, nghiên cứu tài liệu tài chính và diễn giải trực quan. Với tự lưu trữ, độ dài chuỗi dùng được tùy thuộc cấu hình runtime, bộ nhớ khả dụng và mức đồng thời.
Hỗ trợ đa phương thức và khả năng API có thể khác nhau giữa cấu hình lưu trữ và tự triển khai.
How Does Step 5 Preview Perform on Benchmarks?
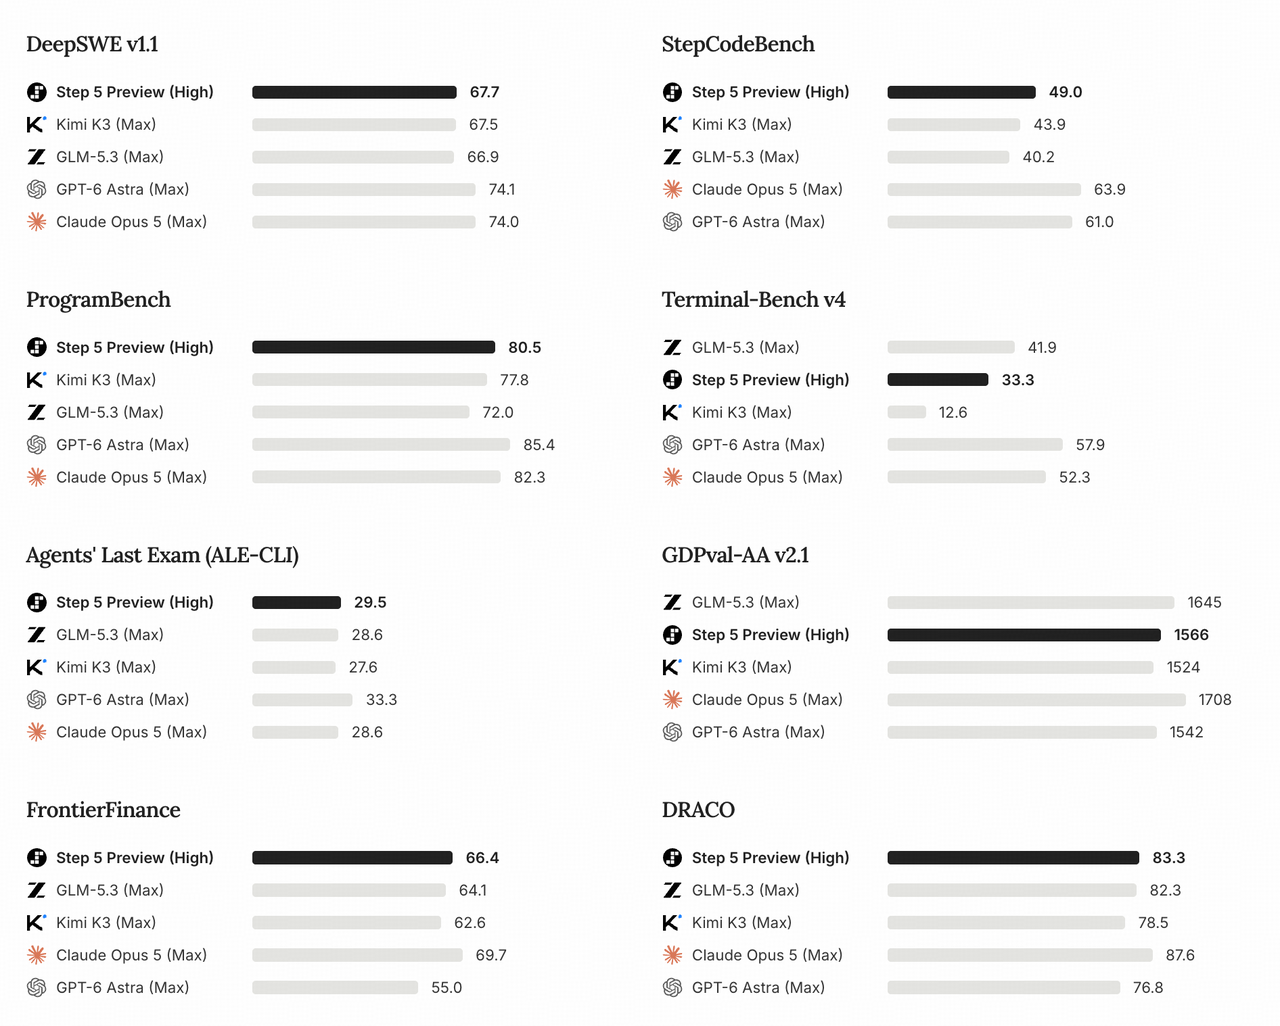
Sau đây là kết quả do StepFun báo cáo. Step 5 Preview dùng cấu hình High reasoning; các mô hình so sánh dùng Max. Khớp tên nhãn không đồng nghĩa với mức tính toán bằng nhau, và các điểm số được công bố này không đo độ trễ ứng dụng hay chi phí cho mỗi tác vụ thành công.
Biểu đồ chính thức tóm tắt kết quả đánh giá của nhà phát hành. Các bảng dưới đây trích xuất điểm số mã hóa, suy luận và tài chính liên quan đến phân tích này.
Coding and Agentic Performance
Benchmark
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
DeepSWE v1.1
67.7
67.5
66.9
74.1
74.0
StepCodeBench
49.0
43.9
40.2
61.0
63.9
ProgramBench
80.5
77.8
72.0
85.4
82.3
Terminal-Bench v4
33.3
12.6
41.9
57.9
52.3
Agents’ Last Exam (ALE-CLI)
29.5
27.6
28.6
33.3
28.6
Điểm là phần trăm, giá trị cao hơn chỉ ra hiệu năng tốt hơn trên mỗi benchmark. DeepSWE v1.1 dùng SWE-agent harness với temperature=1.0 và top_p=0.95; StepCodeBench báo cáo avg@4, trong khi ProgramBench báo cáo tỷ lệ pass. Mỗi benchmark đo một tác vụ khác nhau dưới thiết lập đánh giá riêng, nên các phần trăm không phải thước đo độ chính xác có thể hoán đổi. So sánh được công bố không thiết lập phần cứng hoặc ngân sách thực thi giống hệt giữa các mô hình.
Trên DeepSWE v1.1, Step 5 Preview đạt 67.7%, nhỉnh hơn Kimi K3 và GLM-5.3 một chút. Điều này gợi ý hiệu năng cạnh tranh cho các agent mã hóa làm việc với repository và các tác vụ kỹ thuật phần mềm tự động.
ProgramBench cung cấp một tín hiệu tích cực khác. Step 5 Preview đạt 80.5%, so với 77.8% của Kimi K3 và 72.0% của GLM-5.3.
Tuy nhiên, Terminal-Bench v4 phơi bày một hạn chế đáng chú ý: kết quả 33.3% của Step 5 Preview tụt sau GLM-5.3 ở mức 41.9%, trong khi GPT-6 Astra đạt 57.9%. Hàm ý là Step 5 Preview cạnh tranh trong kỹ thuật phần mềm định hướng repository, nhưng lợi thế tương đối không đồng đều ở thực thi qua terminal và gỡ lỗi phức tạp.
Reasoning and Knowledge Performance
Benchmark
Step 5 Preview (High)
GLM-5.3 (Max)
Kimi K3 (Max)
GPT-6 Astra (Max)
GPQA Diamond
93.5%
91.7%
93.5%
96.1%
Humanity’s Last Exam
46.5%
42.3%
46.9%
54.7%
AA-LCR v1.1
88.3%
79.7%
88.7%
80.7%
CritPt
20.9%
19.1%
23.4%
31.7%
Step 5 Preview đạt 93.5% trên GPQA Diamond, ngang Kimi K3 và sau GPT-6 Astra ở mức 96.1%. Trên AA-LCR v1.1, kết quả 88.3% thấp hơn nhẹ so với 88.7% của Kimi K3 và cao hơn 80.7% của GPT-6 Astra. Mô hình cũng tụt sau Kimi K3 và GPT-6 Astra trên Humanity's Last Exam và CritPt. Các kết quả cho thấy kiến thức và suy luận ngữ cảnh dài cạnh tranh, với điểm mạnh tương đối khác nhau tùy tác vụ.
Financial Research and Valuation Performance
Nghiên cứu tài chính là một trong những lĩnh vực ứng dụng nổi bật nhất của Step 5 Preview. Mô hình được thiết kế để kết hợp suy luận định lượng, truy hồi bằng chứng và phân tích có cấu trúc. Những khả năng này đặc biệt phù hợp với định giá, diễn giải tài liệu tài chính và nghiên cứu đầu tư.
StepFun giới thiệu FinStepBench để đánh giá nghiên cứu tài chính ở nhiều giai đoạn, từ thu thập thông tin đến đưa ra kết luận có cơ sở.
Benchmark
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
FrontierFinance
66.4
62.6
64.1
55.0
69.7
FinStepBench LiveSearch
74.5
70.9
73.3
74.5
76.2
FinStepBench CorporateValuation
60.6
60.6
56.1
77.3
69.7
FinStepBench DeepResearch
55.8
48.9
53.3
45.0
59.1
Điểm cao hơn chỉ ra hiệu năng benchmark mạnh hơn. FinStepBench do StepFun phát triển, vì vậy kiểm chứng độc lập đặc biệt quan trọng.
Step 5 Preview đạt 66.4% trên FrontierFinance, vượt Kimi K3, GLM-5.3 và GPT-6 Astra theo cấu hình đã báo cáo. Tuy nhiên, Claude Opus 5 vẫn dẫn trước với 69.7%.
Kết quả FinStepBench DeepResearch đặc biệt đáng chú ý. Step 5 Preview đạt 55.8%, so với 48.9% của Kimi K3 và 53.3% của GLM-5.3. Điều này cho thấy mô hình có thể phù hợp với quy trình nghiên cứu tài chính yêu cầu truy hồi, tổng hợp và phân tích kéo dài.
Điểm CorporateValuation kể một câu chuyện tinh tế hơn. Ở mức 60.6%, Step 5 Preview tụt sau GPT-6 Astra ở mức 77.3% với khoảng cách đáng kể. Do đó, không nên coi Step 5 Preview là vượt trội toàn diện cho phân tích tài chính. Thứ hạng tương đối của mô hình mạnh hơn ở DeepResearch so với CorporateValuation, củng cố việc đánh giá theo từng tác vụ thay vì khẳng định rộng về ưu thế tài chính.
Trong ứng dụng sản xuất, đầu ra tài chính vẫn cần tính toán được kiểm chứng độc lập, giả định được ghi nhận và bằng chứng hỗ trợ có thể truy xuất.
Step 5 Preview vs Other AI Models
Step 5 Preview cạnh tranh với cả lựa chọn API được lưu trữ và dịch vụ frontier độc quyền. Kết quả benchmark giúp xác định mô hình tiềm năng; truy cập API, hỗ trợ đầu vào, quyền kiểm soát triển khai và chi phí thực tế của khối lượng công việc sẽ quyết định mô hình phù hợp với ứng dụng sản xuất.
Step 5 Preview cung cấp checkpoint MoE thưa 600B/27B được ghi nhận và tùy chọn tự lưu trữ. Với các lựa chọn thay thế, khả dụng trọng số, số lượng tham số, giới hạn ngữ cảnh và đầu vào được chấp nhận phụ thuộc vào mô hình và endpoint. Benchmark được công bố có thể giúp xây dựng danh sách rút gọn; các tác vụ mã hóa và nghiên cứu đại diện sẽ cho thấy cách mỗi dịch vụ hoạt động trong thực tế.
Step 5 Preview vs Kimi K3
Step 5 Preview nhỉnh hơn một chút trên DeepSWE v1.1, ProgramBench và FrontierFinance. Kimi K3 vẫn cạnh tranh trong suy luận và một số đánh giá kỹ thuật khác. Khác biệt thực tế ít liên quan đến lợi thế trí tuệ quyết định mà nhiều hơn về chi phí, điều kiện phục vụ và độ tin cậy theo tác vụ dành cho nhà phát triển.
Step 5 Preview vs GLM-5.3
Step 5 Preview dẫn GLM-5.3 trong một số đánh giá tài chính và phát triển phần mềm. Tuy nhiên, điểm Terminal-Bench v4 mạnh hơn của GLM-5.3 gợi ý lợi thế trong các tác vụ terminal được báo cáo. Với agent mã hóa, hãy so sánh sửa đổi repository thành công, lỗi gọi công cụ, thời gian thực thi và tính đúng đắn của bản vá thay vì dựa vào một điểm tổng hợp.
Step 5 Preview vs GPT-6 Astra and Claude Opus 5
Các mô hình frontier độc quyền thường hoạt động tốt hơn trên những benchmark kỹ thuật phần mềm khó nhất. Điểm hấp dẫn chính của Step 5 Preview là tiếp cận khả năng cạnh tranh trên các khối lượng công việc được chọn trong khi cung cấp tùy chọn triển khai trọng số mở và mức giá API tương đối dễ tiếp cận.
Chọn mô hình cao cấp khi chi phí thất bại lớn và độ chính xác nhiệm vụ tăng thêm biện minh cho chi phí bổ sung. Cân nhắc Step 5 Preview khi giá, quyền kiểm soát triển khai và thực thi tác nhân lặp lại có trọng lượng lớn hơn.
How Much Does Step 5 Preview API Cost?
Giá trị của Step 5 Preview phụ thuộc vào cả khả năng tác vụ và chi phí vận hành. Quy trình tác nhân có thể liên quan đến hàng chục lần gọi, truy hồi tài liệu lặp lại và thử lại, nên giá token thấp chỉ hữu ích khi mô hình hoàn thành nhiệm vụ một cách đáng tin cậy. Chi phí cho mỗi tác vụ hoàn thành thành công là bổ sung hữu ích cho các mức giá dưới đây.
API Availability and Token Pricing
Ảnh chụp ngày 19 tháng 10, 2026 này so sánh mức giá API gốc của StepFun (https://platform.stepfun.ai/docs/en/guides/pricing/details) với mức giá CometAPI liên kết ở phần so sánh mô hình. Tất cả giá tính theo đô la Mỹ mỗi triệu token. Các dịch vụ có điều kiện thanh toán, cache và endpoint khác nhau; “not listed” nghĩa là ảnh chụp nguồn của bài viết này không cung cấp mức giá đầu vào đã cache.
Model
Service channel
Model ID
Uncached input / 1M tokens
Cached input / 1M tokens
Output / 1M tokens
Step 5 Preview
StepFun native API
step-5-preview
$1.00
$0.10
$2.70
Kimi K3
CometAPI
kimi-k3
$2.40
Not listed
$12.00
GLM-5.3
CometAPI
glm-5.3
$1.12
Not listed
$3.53
GPT-6 Astra
CometAPI
gpt-6-astra
$8.00 (short-context tier)
Not listed
$40.00 (short-context tier)
Claude Opus 5
CometAPI
claude-opus-5
$4.00
Not listed
$20.00
Tầng short-context của GPT-6 Astra áp dụng tới 272,000 token; mức giá long-context được báo là $16 cho đầu vào và $60 cho đầu ra mỗi triệu token. Mức giá liệt kê không bao gồm công cụ, thử lại và hạ tầng. Khả dụng Step 5 Preview qua CometAPI không được thiết lập bởi so sánh này; ví dụ Step 5 Preview bên dưới dùng endpoint gốc của StepFun.
Mức giá đầu vào trúng cache thấp hơn 90% so với mức chưa cache. Giá chưa cache bao gồm việc ghi nội dung mới vào cache, trong khi thanh toán đầu ra bao gồm cả token suy luận và token câu trả lời cuối. Văn bản prompt lặp lại chỉ được tính mức giá thấp hơn khi dịch vụ báo cáo một cache hit đủ điều kiện; độ dài câu trả lời nhìn thấy một mình đánh giá thấp đầu ra bị tính phí.
Example Cost Calculations
API workload
Uncached input
Cached input
Output
Estimated cost
Short analytical request
10K
0
5K
$0.0235
Medium coding workflow
100K
0
20K
$0.154
Repeated agent request
10K
90K
20K
$0.073
Large document analysis
500K
0
30K
$0.581
Long-context cached workflow
100K
400K
50K
$0.275
Cost formula: C = (Tu × Pu + Tc × Pc + To × Po) / 1,000,000, where Tu/Tc/To represent uncached input, cached input, and billable output tokens, respectively, and Pu/Pc/Po are their prices per million tokens.
Xem xét hai yêu cầu StepFun với cùng 100,000 token đầu vào và 20,000 token đầu ra bị tính phí:
Cache miss: toàn bộ 100,000 token đầu vào chưa cache. Cost = (100,000 × $1.00 + 20,000 × $2.70) / 1,000,000 = $0.154.
Cache hit: 90,000 token đầu vào đủ điều kiện mức giá cache và 10,000 còn lại chưa cache. Cost = (10,000 × $1.00 + 90,000 × $0.10 + 20,000 × $2.70) / 1,000,000 = $0.073.
Ví dụ cache hit giúp tiết kiệm $0.081, khoảng 52.6%, với cùng khối lượng đầu vào và đầu ra. Khoản tiết kiệm phụ thuộc vào cache hit đủ điều kiện được dịch vụ báo cáo. Cả hai ví dụ đều loại trừ công cụ bên ngoài, thử lại và chi phí hạ tầng.
Giá token một mình không quyết định mô hình giá trị tốt nhất. Một tác nhân cần vài lần thử lại có thể đắt hơn một mô hình giá cao hơn nhưng thành công trong lần đầu. Để so sánh chi phí đáng tin cậy, hãy dùng chi phí cho mỗi tác vụ hoàn thành thành công cùng với giá token.
Is Step 5 Preview Open Source, and Can It Run Locally?
StepFun phát hành trọng số có thể tải xuống qua các repository Hugging Face chính thức, với các biến thể FP8, BF16 và NVFP4 có sẵn tính đến ngày 19 tháng 10, 2026. Truy cập trọng số cho phép tự triển khai, nhưng không khiến mô hình tương đương với mô hình dense nhỏ về yêu cầu bộ nhớ.
Các tệp khả dụng gồm checkpoint Step 5 Preview, phiên bản BF16 và phiên bản NVFP4.
Thuật ngữ rất quan trọng: Step 5 Preview cung cấp trọng số mở theo StepFun Model License 1.0 (https://huggingface.co/stepfun-ai/Step-5-Preview/blob/main/LICENSE.txt). Giấy phép bao gồm ghi nhận đặc thù mô hình và điều kiện giấy phép thương mại. Hãy đánh giá các điều khoản đó cho mục đích sử dụng và phân phối dự kiến trước khi triển khai.
FP8 với vLLM: 4 × NVIDIA B300 hoặc 8 × NVIDIA H200, phục vụ API tương thích OpenAI.
BF16 với vLLM: 8 × NVIDIA B300 hoặc 16 × NVIDIA H200, phục vụ API tương thích OpenAI.
FP8 với SGLang: 4 × NVIDIA B300, phục vụ API tương thích OpenAI; FP8 với Transformers: 8 × NVIDIA H200 cho sinh offline.
Đây là cấu hình tham chiếu, không phải đảm bảo tối thiểu cho mọi checkpoint, runtime, độ dài ngữ cảnh hoặc thiết lập đồng thời. Kích hoạt thưa giảm tính toán, nhưng lưu trữ trọng số chuyên gia và bộ nhớ KV cache vẫn là cân nhắc lớn.
Một mô hình 600B cũng đặt ra thách thức ngoài dung lượng bộ nhớ, bao gồm giao tiếp đa GPU, tương thích framework, tải checkpoint và thông lượng ngữ cảnh dài. Với các đội không có cụm GPU lớn, API được lưu trữ thường là điểm khởi đầu thực tế hơn.
How Can Developers Use the Step 5 Preview API?
StepFun hỗ trợ giao diện Chat Completions tương thích OpenAI. Đặt STEPFUN_API_KEY trong môi trường trước khi chạy ví dụ Python sau; max_tokens giới hạn đầu ra được sinh của yêu cầu này. Sử dụng khóa API và điều khoản thanh toán cho nền tảng khu vực đã chọn: ví dụ này giữ endpoint api.stepfun.ai, trong khi mức giá đô la ở trên đến từ nền tảng quốc tế của StepFun.
Ví dụ Python: gửi yêu cầu văn bản có giới hạn tới API StepFun và in câu trả lời trả về.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "Analyze the architectural risks of migrating "
            "a monolithic application into microservices."
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
Trước khi dùng trong sản xuất, hãy xác nhận tham số được chấp nhận và giới hạn sinh của endpoint StepFun đã chọn. Mức độ suy luận, cache prompt, schema công cụ và ngân sách đầu ra đều có thể ảnh hưởng đến độ tin cậy, độ trễ và hóa đơn cuối cùng.
Step 5 Preview in Agent Workflows
Đọc tài liệu repository và các tệp liên quan.
Xác định thay đổi yêu cầu và đề xuất kế hoạch.
Sửa đổi mã đã chọn và thực thi kiểm thử qua công cụ bên ngoài.
Kiểm tra lỗi và sửa lại triển khai.
Tạo giải thích cuối cùng về các thay đổi đã được xác thực.
Mô hình tạo suy luận và yêu cầu công cụ; ứng dụng cung cấp quyền truy cập tệp thực, môi trường thực thi, quyền hạn và kiểm tra an toàn. Khả năng của mô hình một mình không đảm bảo thực thi tự động.
Alternative Model APIs in CometAPI
CometAPI cung cấp truy cập tới các mô hình thay thế được liên kết ở trên thông qua một dịch vụ tích hợp chung. Chọn endpoint được tài liệu hóa và định dạng yêu cầu của mỗi mô hình, sau đó so sánh tỷ lệ thành công, mức dùng token, thử lại và độ trễ đầu-cuối trên cùng khối lượng công việc.
Ví dụ trên dùng endpoint gốc của StepFun. Chuyển sang gateway cần xác nhận khả dụng Step 5 Preview và model identifier, endpoint, cùng điều khoản thanh toán của gateway.
When Should You Choose Step 5 Preview?
Chọn cho mã hóa repository và nghiên cứu nặng tài liệu khi các bài test đại diện xác nhận kết quả đáng tin cậy. Ngữ cảnh dài và điểm mã hóa/tài chính được công bố khiến mô hình trở thành ứng viên, trong khi kết quả terminal-task và định giá cho thấy lý do đánh giá theo từng khối lượng công việc có ý nghĩa.
Chọn API được lưu trữ khi bạn muốn bắt đầu mà không vận hành cụm GPU lớn. So sánh chi phí cho mỗi tác vụ được chấp nhận, tỷ lệ trúng cache, thử lại và độ trễ; cửa sổ ngữ cảnh lớn không đảm bảo phản hồi nhanh hoặc chi phí tổng thấp hơn.
Chọn tự lưu trữ khi quyền kiểm soát triển khai biện minh cho gánh nặng phần cứng và vận hành. Lập ngân sách cho lưu trữ trọng số chuyên gia đầy đủ, KV cache, giao tiếp đa GPU và yêu cầu giấy phép. Với công việc tài chính hoặc kỹ thuật hệ trọng, hãy bao gồm kiểm tra nguồn, phát hiện lỗi và rà soát của con người.
FAQ
How should you choose Step 5 Preview’s reasoning effort?
Bắt đầu với một tập nhỏ tác vụ đại diện và so sánh low, medium và high bằng cùng tiêu chí chấp nhận. Ghi lại tính đúng đắn, đầu ra bị tính phí, độ trễ và lỗi công cụ. Dùng mức thấp nhất đáp ứng ổn định ngưỡng chất lượng; điểm benchmark High được công bố không dự đoán hành vi của low hoặc medium. Theo hướng dẫn cấu hình suy luận và đặt reasoning_effort một cách rõ ràng trên Chat Completions khi so sánh cấu hình.
Why can a Step 5 Preview request stop before 64k output tokens?
Giới hạn được tài liệu hóa là trần, không phải độ dài mục tiêu. Yêu cầu có thể dừng sớm vì chạm ngân sách max_tokens, trả về điểm dừng tự nhiên, hoặc sinh một lời gọi công cụ mà ứng dụng phải xử lý. Kiểm tra finish reason trả về và mọi yêu cầu công cụ trước khi tự động thử lại. Câu trả lời ngắn đã hoàn thành không cho thấy lỗi cửa sổ ngữ cảnh.
How should you test Step 5 Preview video inputs?
Bắt đầu với một clip ngắn, đại diện và câu hỏi có thể xác minh câu trả lời. Đặc tả đầu vào video của API được lưu trữ chấp nhận video theo URL, Base64 hoặc tham chiếu stepfile; các định dạng được ghi nhận gồm MP4, QuickTime và Matroska. Với đầu vào URL, tài liệu chỉ rõ từng tệp MP4 dưới 128 MB và khuyến nghị dưới năm phút. Xác nhận giới hạn định dạng và kích thước trước khi xử lý theo lô, và kiểm tra câu hỏi theo thời gian cũng như nhận diện khung hình đơn.
Which metrics reveal Step 5 Preview’s real agent cost?
Đo số tác vụ được chấp nhận, tổng token đầu vào và đầu ra qua mọi lượt, trúng cache, thử lại, phí công cụ bên ngoài và thời gian trôi qua. Chia tổng chi phí chạy cho số lần hoàn thành thành công, giữ tiêu chí thành công cố định giữa các mô hình. Điều này nắm bắt tác động kinh tế của một lần gọi rẻ hơn nhưng cần nhiều lần thử, hoặc một lần chạy nỗ lực cao hơn giảm thất bại về sau.
Conclusion
Step 5 Preview đáng để đánh giá khi ứng dụng cần xử lý ngữ cảnh dài, sử dụng công cụ lặp lại hoặc quyền kiểm soát triển khai mô hình. Kết quả do StepFun công bố khiến mô hình trở thành ứng viên cho mã hóa repository và nghiên cứu tài chính, trong khi Terminal-Bench v4 và CorporateValuation cho thấy các lĩnh vực nơi lựa chọn thay thế có điểm cao hơn. Hãy so sánh mô hình bằng tiêu chí chấp nhận cố định, chi phí cho mỗi tác vụ được chấp nhận và độ trễ đầu-cuối. Với tự lưu trữ, bao gồm chi phí hạ tầng và yêu cầu giấy phép trong quyết định.
Official FP8, BF16, and NVFP4 repositories available