Qwen 是什麼?
奎文 (統一千文)是阿里雲開發的一系列大型語言模型(LLM)和多模態模型,最初於 2023 年 2024 月發布 Beta 版本。到 XNUMX 年 XNUMX 月,它在某些基準測試中被評為頂級中文模型,在全球排名第三,僅次於 Anthropic 和 OpenAI 的領先模型。 「統一千問」意為「千問千答」,體現了它能夠針對各種疑問提供準確解答的能力。
該系列基於多語言數據構建,特別強調中文和英文,但也支援西班牙語、法語和日語等其他語言。模型參數範圍從 1.8 億個參數(1.8B)到 72 億個參數(72B),適用於從研究到企業的廣泛應用。該系列已發展到包括版本 2(於 2024 年 2.5 月推出)和版本 2025(於 XNUMX 年初更新),引入了專家混合 (MoE) 架構和即時多模式處理等創新。
Qwen 的開源政策是如何隨著時間演變的?
阿里巴巴開源其模型的方式一直是動態的,反映了促進合作和保持競爭優勢之間的平衡。 2023年72月,阿里巴巴開源了1.8B和7B模型,同年XNUMX月又開源了XNUMXB模型。這些早期版本意義重大,為研究人員和開發人員提供了在特定授權協議下使用強大的人工智慧模型的機會。
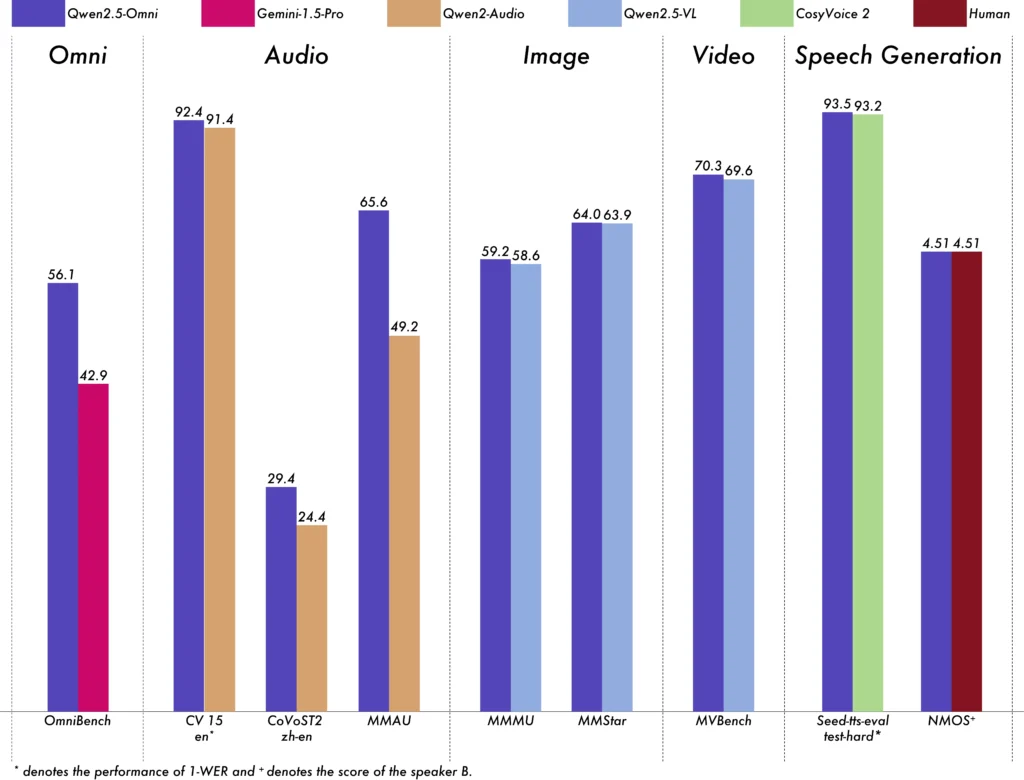
隨著 2 年 2024 月第 2.5 版的推出,阿里巴巴改變了策略,保留其最先進的模型專有,同時選擇性地開源其他模型。這一趨勢在 2.5 系列中得以延續,其中 32-VL-2025B-Instruct(2.5 年 7 月發布)和 2025-Omni-2.0B(2.5 年 XNUMX 月發布)等型號均在 Apache XNUMX 許可下提供,而 XNUMX-Max 仍然是閉源的。這種混合方法引發了關於人工智慧產業開放取用和專有控制之間權衡的討論。