
TL;DR
Z.AI 已公開命名 GLM-6.0,並將全自我訓練置於下一代路線圖的核心位置。已披露的方向把在預訓練、中期訓練與後期訓練中連結起來的自產經驗,與自我評估與校正結合,使訓練從單次資料生成轉變為受治理的回饋迴圈。
困難之處在於控制:GLM-6.0 需要淨化合成資料、偵測並修復錯誤、停止無效迭代,並防止其評估器獎勵投機取巧。這些機制引出關於獨立驗證、安全性、成本與治理的實務問題。由於尚無完整的模型卡、基準套件、API 規格、價格或發佈日期,本文評估的是訓練架構及其證據,而非臆測性的規格。
Key Takeaways for GLM 6.0?
- 目前最強的公開證據聚焦於全自我訓練系統,而非洩露的參數規模或基準成績。
- 已披露的方向涵蓋自產資料、自建訓練環境,以及由模型輔助的基礎設施最佳化。
- 預期的回饋迴圈橫跨預訓練、中期訓練與後期訓練,而非僅將自我訓練視為後期訓練技巧。
- 原生多模態建模、較長時程的強化學習、規劃、工具使用、恢復與驗證是相關研究方向,但尚未成為已發佈的 GLM 6.0 規格。
- Ox Alpha 並非 GLM 6.0 表現外洩的證據;Z.AI 指出它是 GLM-5.3-Flash 的發佈前代號。
What Has Z.AI Actually Confirmed About GLM 6.0?
Z.AI 的公開資料確立了四個具體訊號:GLM-6.0 的名稱、全自我訓練作為核心訓練方向、橫跨預訓練—中期訓練—後期訓練的預期迴圈,以及自我評估與校正機制。公司亦表示約 60% 的淨收益預計用於支持下一代模型、全自我訓練、大規模訓練、推論、算力與相關基礎設施。
Z.AI’s Full Self-Training Framework
全自我訓練被呈現為 GLM-6.0 的核心組織理念,而非小幅的後期訓練功能。預期系統將生成訓練經驗、從結果中學習、過濾弱樣本,並在明確的品質控制下重複此循環。
GLM-6.0 Self-Training Across Pre-, Mid-, and Post-Training
已披露的序列——預訓練、中期訓練與後期訓練——意味著自產經驗可影響基礎知識、能力塑形與任務對齊,而非僅在最終微調階段出現。Z.AI 尚未披露資料集、階段邊界或混合比例,因此應將此視為已確認的方向,而非完整配方。
GLM-6.0 Self-Evaluation and Correction Mechanism
此路線圖將全自我訓練與自我評估、錯誤偵測、校正與資料自我淨化相連結。實務上,模型需要判斷軌跡、修訂失敗步驟、丟棄不可靠資料,並決定何時進一步迭代不再提升由獨立指標量測的效能。評估器設計與停止規則仍未披露。
The GLM-6.0 and Full Self-Training disclosure should be read together with Z.AI’s public proceeds allocation.
What We Know vs What We Don't
公開紀錄支持的是一份路線圖,而非完成的規格。下表將已確認的方向與未解問題分開,以避免把已披露的意圖誤當成無根據的產品宣稱。
| Claim | Evidence status | What is supported | What remains unknown |
|---|---|---|---|
| GLM-6.0 name | Publicly identified | Z.AI 已將下一代模型命名為 GLM-6.0。 | 發佈日期與最終定位。 |
| Full Self-Training | Confirmed roadmap | 它是一項已聲明的策略重點。 | 實作細節與擴縮行為。 |
| Pre-training → Mid-training → Post-training | Confirmed direction | 自我訓練預期覆蓋整個訓練生命週期。 | 資料集、驗證器、階段邊界與資料比例。 |
| Self-evaluation and correction | Confirmed objective | 路線圖包含自我淨化、錯誤偵測與校正。 | 可靠性、獨立驗證與停止標準。 |
| Specifications | Not disclosed | 尚無完整公開規格。 | 參數、上下文長度、模態、價格與 API 識別。 |
| Benchmarks | Not disclosed | 尚無官方 GLM-6.0 結果集。 | 分數、方法學與可獨立重現的結果。 |
What Is Full Self-Training and how it work
全自我訓練是一個封閉學習迴圈,模型協助建立任務或環境、嘗試解題、評估所得軌跡、校正薄弱步驟,並將被接受的經驗回饋至訓練。關鍵轉變是從一次性的合成資料管線,變為持續且受治理的流程。
- 生成:構建問題、工具環境與候選解題路徑。
- 行動:完成任務,並保留動作、觀察與中間推理作為軌跡。
- 評估與校正:以驗證器為結果評分、偵測錯誤、修訂失敗步驟,並拒收低信心樣本。
- 訓練與停止:從被接受的經驗中學習,且僅在獨立評估顯示仍有用的改進時才持續。
將此迴圈延伸至預訓練、中期訓練與後期訓練,可讓 GLM-6.0 在不同階段改善資料品質、能力塑形與任務對齊。此架構仍依賴可信的評估器:若缺乏獨立檢查,自我訓練可能會獎勵自身盲點。
How Could Full Self-Training Change GLM 6.0?
已披露的設計更像是系統架構,而非單一新的 Transformer 模組。其嘗試閉合模型周邊的迴圈,使模型愈來愈多地協助生成下一輪訓練所需的資源。
How could GLM 6.0 produce training data?
第一個迴圈是資料自產。模型不再只依賴人寫或外部收集的資料集,還可用自我博弈、基於規則的檢查、執行結果、模型判斷與人工抽查來生成並過濾新例項。被接受的例項隨後回流至預訓練、中期訓練與後期訓練。
重要的約束是驗證:低成本合成生成唯有在系統能辨識正確、多樣且非退化樣本時才有用。實用的迴圈是 模型生成 → 任務執行 → 規則或工具驗證 → 篩選 → 再訓練。
How could GLM 6.0 construct training environments?
第二個迴圈是環境自建。代理可收集或轉化真實任務、嘗試這些任務、建立驗證器,並在納入訓練素材前檢查任務是否確可解。這對程式與代理工作尤為重要,因為終態、工具輸出、瀏覽器狀態、測試結果與失敗恢復,比僅有文字答案能提供更強的監督。
評估目標從答案聽起來是否合理,轉為行動是否成功、結果是否可獨立驗證,以及代理是否能在失敗後恢復。
How could GLM 6.0 optimize its training infrastructure?
第三個迴圈是基礎設施自我優化。實務上,這最好解讀為 AI 輔助系統工程:強大的程式碼模型對運算子、核心、排程、快取或服務程式碼提出改動建議,由自動化基準與人工控制的驗證決定哪些改動被接受。
由此形成的循環是 更好的模型 → 更好的系統提案 → 經驗證的效率提升 → 更多訓練實驗 → 更好的模型。人工審查與可重現的基準仍是控制點,而非可有可無的附加項。
What Does the Current GLM 5.3 Flash Baseline Tell Us About GLM 6.0?
由於 GLM 6.0 尚無公開模型卡,最穩健的比較是將當前、可量測的 GLM 能力與下一代方向分開。Z.AI 描述 GLM-5.3-Flash 為一個 320B-total、18B-active 的 MoE 模型,訓練於 30T-token 的多模態語料。這些是 GLM-5.3-Flash 的規格,並非 GLM 6.0 的規格。
| Comparison dimension | GLM-5.3-Flash API in CometAPI | GLM 6.0 disclosed direction |
|---|---|---|
| Release status | Available | 開發中;引用的檔案尚未獨立確認最終產品名稱 |
| Parameters | 320B total / 18B active | 未披露 |
| Core architecture | MoE;hybrid sparse + linear attention;mHC | 模組層級未披露 |
| Training data | 30T-token 多模態語料 | 自產資料預計進入遞迴迴圈 |
| Multimodality | 原生多模態輸入 | 統一多模態建模是研究方向,非已發佈的規格 |
| Training stages | 已發佈的分階段訓練配方 | 自我訓練覆蓋預訓練、中期訓練與後期訓練 |
| Training environments | 研究者設計並基準測試的環境 | 代理協助構建與驗證環境 |
| Verification | 既有評估與訓練管線 | 更強的自我評判、執行回饋與自我驗證 |
| Infrastructure | 最佳化的推論堆疊 | 模型協助基礎設施優化 |
| API details | 已發佈的模型 ID 與線上 API | 未披露 |
Z.AI 的發佈文字報告 GLM-5.3-Flash 相較於 GLM-5.3 API 約 3.0× 的注意力計算降低與 4.4× 較小的 KV 快取大小。隨附的官方圖示則將一百萬 token 比較標註為注意力計算 3.40×、每層 KV 快取 3.80×。由於這兩個官方素材使用不同數字,應按各自脈絡分別報導,而非合併為單一量測。
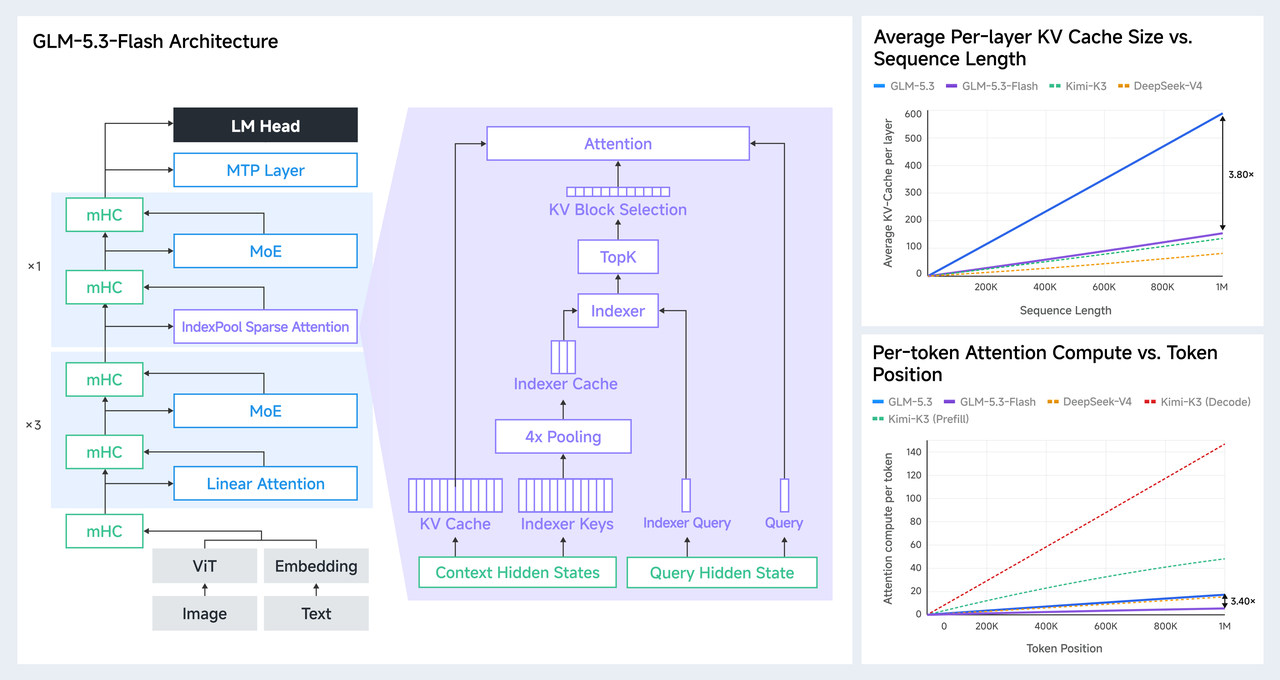
Z.AI 發佈的 GLM-5.3-Flash 架構與效率比較官方圖示
Which Benchmark Results Form the GLM 6.0 Baseline?
目前沒有可驗證的 GLM 6.0 基準表。現有 GLM 世代僅能作為基線,因為下列評估測量的是規劃、程式、工具使用、自動化與長時程執行——這些能力正是已披露之全自我訓練方向最相關的面向。
| Official Z.AI evaluation | GLM-5.3-Flash | GLM-5.2 | Reported difference |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
此比較是多維度的,而非單一分數排名。GLM-5.3-Flash 在 AutomationBench(+22.6)、Toolathlon Verified(+18.5)與 DeepSWE(+17.2)上報告的提升最大,而 HLE-with-Tools 僅 +0.6。此模式暗示在偏執行的代理任務上提升較大,而非所有形式的工具輔助推理。它並不預測 GLM 6.0 分數。
Why these benchmarks matter
在此脈絡下,基準之所以重要,是因為它們是否揭示了全自我訓練旨在改進的能力。嵌入表中的六個類別構成一個從產出正確工作到在真實環境中維持有效行為的進程。程式測試模型能否執行複雜任務;工具使用測試能否把行動轉為回饋並選擇下一步;自動化則測試能否在長工作流程中維持該迴圈。
| Benchmark Category | Why It Matters for GLM-6.0 |
|---|---|
| Coding | 測試複雜任務執行 |
| Tool Use | 測試從行動到回饋的迴圈 |
| Automation | 測試長時程工作流程執行 |
| HLE | 測試複雜的專家級問題求解 |
| GDPval | 測試專業工作品質 |
| Multimodal | 測試運用視覺回饋 |
HLE 進一步提高所解決問題的難度,GDPval 問的是輸出是否對專業工作有用,而多模態評估則測試視覺觀察能否引導隨後的行動。合併來看,這六個類別從孤立能力移向端到端任務完成:制定計畫、行動、觀察回饋、校正錯誤,並持續直至達成目標。
因此,未來的 GLM-6.0 結果之所以有意義,不在於是否產出更高的總分,而是跨這些維度的提升是否顯示自產訓練經驗可轉移為可靠的真實世界執行。全自我訓練的最終目標不是提高測試分數,而是提升模型完成真實世界任務的能力。
Why Could Full Self-Training Matter for GLM 6.0?
真正的潛力不在於 GLM 6.0 將「自行訓練」。更有意義的改變是更多開發管線環節可由機器生成並由機器驗證。如今,研究者仍在模型周邊做大量工作:蒐集資料、設計任務、構建驗證器、搭建環境、診斷失敗,以及調校系統軟體。全自我訓練把模型推向更多這些階段。
若此方法奏效,重要的擴展變數將不再主要是能加多少參數,而是每單位算力能執行多少有用且已驗證的學習迴圈。這是一種對遞迴自我改進的實務詮釋,而非科幻中的不受限自主自我修改。
已披露的策略應作為一個具驗證器、可重現環境、基礎設施基準與人工控制的工程化回饋系統來評估——而非視為不受限自主自我改進的證據。
What Could Go Wrong With Full Self-Training?
自我訓練迴圈同樣可能把錯誤像把有用經驗一樣高效地累積。四種失敗模式值得特別關注:
- 錯誤放大:薄弱的合成軌跡可能成為未來的訓練資料,使看似合理但錯誤的模式自我強化。
- 獎勵與評估器博弈:若同一系統生成工作並判斷其優劣,可能優化於驗證器漏洞,而非真正的任務成功。
- 分佈收窄:反覆從模型生成的資料中學習可能降低多樣性,使罕見的真實世界案例更難處理。
- 成本、安全與治理壓力:環境建構、工具存取與持續迭代提升算力需求並擴大攻擊面。
可信的 GLM-6.0 實作因此需要獨立驗證器、資料來源可追溯性、驗收門檻、紅隊測試、人工稽核與明確的停止規則。自我校正唯有在校正訊號比待校正行為更可信時才有用。
When Could the GLM 6.0 API Become Available?
Z.AI 尚未發佈 GLM 6.0 的 API 發佈日期、模型 ID、上下文窗口、最大輸出、token 價格、開放權重承諾或部署需求。目前任何具體數值都屬臆測。
開發者可透過 CometAPI 的 GLM-5.3-Flash API 評估原生多模態與效率取向工作負載,或使用 CometAPI 的 GLM-5.3 API 作為當前旗艦分支,或 CometAPI 的 GLM-5.2 API 作為上一代的對照基線。
Conclusion
GLM-6.0 的重要性不在於一個承諾中的產品,而在於 Z.AI 能否把全自我訓練轉化為可重複的工程系統。此路線圖把自產經驗、分階段訓練、自我評估、校正與受控迭代連結起來;決定性證據將在於這些機制是否能提升在長、需工具的真實世界工作流程中的可靠性。
證據仍不完整。Z.AI 尚未發佈 GLM-6.0 的模型卡、發佈日期、API 識別、定價或基準套件。在這些成品出現之前,可辯護的結論很有限:公司已披露的是一個訓練方向,而非完整的能力輪廓。
全自我訓練的最終目標不是提高測試分數,而是提升模型完成真實世界任務的能力。