
摘要
GPT-6 Astra 展現出色的頭條指標分數。最大的提升出現在需要把推理轉化為行動的情境:終端操作、軟體使用、自動化、長上下文檢索、科學工作流程與資安。在已接近飽和的學術測試上,相較先前一代的 OpenAI 模型,提升往往小得多。
該模型將1,050,000-token 的上下文視窗與廣泛的工具支援結合。OpenAI 發佈的執行基準顯示,實際升級在長期工作上最為明顯,但工具架構設計、推理投入、延遲與工具存取都會實質影響結果。
關鍵要點
- Astra 最清晰的提升在於代理型執行,而非所有類型的問答。
- Terminal-Bench、AutomationBench、電腦使用與資料庫遷移等結果的進步幅度,顯著大於 GPQA 或 DeepSWE。
- ARC-AGI-3 的結果顯示,模型狀態、上下文管理與評估框架(harness)會主導最終分數。
- 大上下文視窗只有在接近上限時仍可檢索到資訊時才有意義;與僅宣傳容量相比,MRCR 更具資訊量。
- 較高的 token 價格不必然意味較高任務成本;若模型需要更少的 token、輪數、重試或人工修正,成本可能更低。
- 生產決策應同時比較成功率、耗時、總成本、工具可靠性與修正負擔。
GPT-6 Astra 一覽
OpenAI 指定最多可輸出128,000 個 tokens,支援文字與影像輸入、文字輸出,並提供從低到最高的推理投入。這些規格讓大型、多步驟工作流程成為可能,但不保證模型能檢索到正確證據或可靠完成任務。
| 官方規格 | CometAPI 中的 GPT-6 Astra | 實務意義 |
|---|---|---|
| Model ID | gpt-6-astra | 用於 API 路由的穩定識別子 |
| Context window | 1,050,000 tokens | 支援大型程式庫、封存與代理歷史 |
| Maximum output | 128,000 tokens | 可產生大型報告、修補程式與結構化成品 |
| Knowledge cutoff | April 30, 2026 | 更新事實需透過工具或提供來源 |
| Input | Text and images | 支援文件、截圖、圖表與混合證據 |
| Output | Text | 產生散文、程式碼與結構化文本 |
| Reasoning effort | low, medium, high, xhigh, max | 在延遲與成本間交換更深入的搜尋 |
| Agent capabilities | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | 使端到端工作流程成為可能,而非孤立答案 |
| OpenAI Standard input | $10 per million tokens | 輸入大小與快取重用影響總成本 |
| OpenAI cached input | $1 per million tokens | 適用於重用快取的提示前綴 |
| OpenAI cache writes | $12.50 per million tokens | 以未快取輸入費率的 1.25× 計費 |
| OpenAI Standard output | $50 per million tokens | 冗長輸出可能主導任務成本 |
| Requests above 272K input tokens | Input 與快取費率 ×2;Output 費率 ×1.5 | 較高費率套用於整個請求 |
上下文上限衡量的是容量,而非可用的回憶能力。工具清單衡量的是可用性,而非成功執行。需要透過基準測試來驗證這些規格是否轉化為完成的工作。
GPT-6 Astra 的基準測試結果顯示了什麼?
整體表現呈現不均勻的模式。Astra 在某些學術與軟體推理測試上僅略超 Sol,但在終端工作、自動化、資料庫遷移、視覺互動、長上下文檢索與高等數學上則出現兩位數的增幅。
| 已發佈基準 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
可分為三組。其一,DeepSWE 與 GPQA 的 1.4 點差距表示在強模型已表現優異的任務上,增量有限。其二,Terminal-Bench、AutomationBench、資料庫遷移與百萬 token 檢索超過 20 點的增幅,顯示執行能力有更大改變。其三,ARC-AGI-3 是解讀依賴評估框架的離群值。
獨立測試結果
Artificial Analysis 報告 Astra 與 Sol 在其 Intelligence Index 上約為61,但在 Coding Agent Index 上顯示更明顯的提升。這獨立強化了 OpenAI 數據中的模式:最大提升集中在代理型執行。
在 Codex 框架的最大投入下,Astra 在 Coding Agent Index 上 reportedly 使用的 token 約為 Sol 的三分之一。其在 Intelligence Index 的 token 使用僅下降約 10%。由於 Astra 的每 token 費率較高,這兩種效率曲線帶來不同的經濟性。
| 獨立評估 | 觀察結果 | 生產解讀 |
|---|---|---|
| Intelligence Index | 與 Sol 差距不大 | 廣泛推理未必值得支付高額溢價 |
| Coding Agent Index | 代理型能力明顯提升 | 較少的 token 可抵消較高的 token 費率 |
| AA-Omniscience | 在最大投入下,幻覺率從 92% 降至 51% | 更好的棄答有助於研究與檢索系統 |
| 長期知識型工作 | 各任務進展不一 | 仍需在地化評估 |
沒有獨立基準能認證生產品質的事實性或安全性。團隊應另行評分正確答案、合理的不確定性、無依據的主張與未遵守來源限制的情形。
為何 Astra 更適合長期的代理型工作?
GPT-6 Astra 新增三項針對執行中會變化的工作而設計的控制。長時可靠性同樣取決於整個上下文系統:上下文視窗決定容量;壓縮(compaction)控制舊資料的濃縮;持續的推理(persisted reasoning)承接相關的模型狀態;檢索維持較早證據的可搜尋性;應用程式必須保留重要的工具輸出、測試結果、失敗的方案與使用者需求。這些機制應與代理架構一併測試。
- 非同步工具呼叫:Astra 可在應用執行長時間工具時,持續獨立推理或呼叫其他工具。
- 中途導引:應用可透過 WebSocket 在不中斷已完成工作的情況下,發送更正或新需求。
- 對話中調整推理投入:可在保留快取提示前綴的同時,透過設定更新提升或降低推理投入。
Astra 實際提升之處
代理型程式開發:終端工作是更大的升級
Terminal-Bench 4.0 評估代理能否完成困難的終端任務,而非僅生成孤立的程式碼答案。Astra 達到 57.9%,比 Sol 高 20.6 個百分點,亦高於 Fable 2.1 點。對 OpenAI 而言,這是代際上的重大提升,但相較另一套前沿代理系統僅是較窄的優勢。
DeepSWE 呈現不同面貌:Astra 74.1%,Sol 72.7%。1.4 點的差距提醒我們不要從單一程式基準泛化。Astra 的優勢似乎多出現在需要環境互動、迭代、狀態保存與驗證的程式任務。
Database Migration Tasks 進一步強化此解讀。Astra 63.9%,比 Sol 高 21.2 點,亦高於 Fable 6.1 點。遷移工作結合程式理解、工具使用、步驟安排與操作判斷——這類複合工作流程中,小幅推理改進能累積成更大的完成度提升。
對程式代理而言,請同時評估模型與架構。倉庫指令、終端工具、重試行為、上下文保存與測試執行都會影響量測結果。
電腦使用:成功率與執行時間同樣重要
在 Agents’ Last Exam 上,GPT-6 Astra 得分 59.3%,GPT-5.6 Sol 為 53.6%:提升 5.7 個百分點。這為上文的 OSWorld 2.0 與 ScreenSpot-Pro 增添更廣泛的代理任務結果。
除準確度外,OSWorld 的執行時間比較具實務意義:Astra 每個任務約 40 分鐘,Sol 約 75 分鐘,約縮短 47% 的耗時,同時提升任務成功率。
一個僅稍微更常成功、且快得多的代理,能帶來巨大吞吐提升。因此採購測試應同時報告成功率、耗時、工具呼叫、重試與人工介入,而非僅有準確度。
自動化與專業工作
AutomationBench 從 18.1% 上升至 41.4%,提升 23.3 點。絕對分數距離完美仍遠,但失敗型態的變化比在飽和區附近的 1 點變動更有意義。在 BenchCAD 上,Astra 達 95.9%,領先 Sol 12.6 點與 Fable 11.6 點。
這些結果支持一個具體主張:Astra 更擅長把指令轉化為經驗證的行動序列。這並不代表每個商務流程都有同等提升。實際流程可能引入驗證步驟、專有介面、含糊政策或基準未涵蓋的資料格式。
科學
科學領域是 Astra 最明顯的能力提升之一。在 FrontierMath Tier 4 v2 上,Astra 達 97.6%,Sol 為 83.0%,Fable 為 87.8%。相較 Sol 的 14.6 點優勢相當可觀,雖然該基準涵蓋的是選定的任務分佈,而非完整科學工作流程。
資安
資安是第二個重大提升,重要性高於一般榜單名次。在涵蓋 2026 年 6 至 8 月的 ExploitBench 上,Astra 39.0%,Sol 5.5%。OpenAI 報告該新集合針對前 3 個月的漏洞,以降低歷史接觸的影響。在 OpenAI 的資安評估中,Astra 在受控環境下展現出發現並利用兩個先前未知零日漏洞的能力。此結果重要之處在於評估以近期揭露漏洞為設計核心,而非長期已知問題,降低因記憶既有案例而得分的可能。該結果推動 Astra 達到 OpenAI 的 Critical 資安能力門檻,因而改變部署所需的防護措施。這並非表示 Astra 能不受限地自主進行網路作戰,而是其能力等級改變了部署防護的需求。具較強漏洞發掘與利用能力的系統,需要更嚴格的存取控制、監控、沙箱與人工審查機制。
長時間任務:上下文視窗不是全部
Astra 的 1,050,000-token 上下文視窗描述的是容量,而非連續性。長時間表現也取決於壓縮、持續狀態、可檢索的早期上下文、保留的推理狀態,以及工具輸出的保存。在 MRCR v2 上,Astra 在 256K–512K 得分 100.0%,在 512K–1M 為 96.3%,Sol 分別為 91.5% 與 73.8%。最長範圍 22.5 點的差距顯示,接近上限時的可用檢索比宣稱容量更重要。
MRCR 仍是合成檢索測試,因此生產評估應保留摘要常遺失的證據:為何先前修正失敗、某元件的具體行為、改變實作方向的測試結果、歷史需求,以及藏於工具輸出中的細節。程式庫與研究封存也應在重複名稱、交互參照、過時政策、矛盾來源與長干擾段落下進行測試。這能區分原始上下文容量,與長期代理實際需要的上下文保存與檢索行為。
上下文保存:Astra 與傳統長上下文系統的不同
傳統長上下文工作流程通常遵循以下模式:
context → compaction → summary → continue
此作法可降低 token 使用量,但引入關鍵風險:重要的中間資訊可能在摘要中消失。
遺失的往往不是最終答案,而是未來決策所需的操作性細節:
- 為何先前的修正失敗;
- 哪個元件出現異常行為;
- 哪個測試結果改變了實作方向;
- 後續新增了哪些使用者需求;
- 哪個工具輸出包含重要證據。
GPT-6 Astra 透過在長時間代理工作流程中結合上下文保存與檢索機制,來應對此限制。
系統不再僅依賴壓縮摘要,而是可保留重要記錄、在需要時檢索較早資訊,並在多次工具互動間維持連續性。
對如 Codex 的程式代理而言,這表示一個長時間除錯任務能保留:
- 先前失敗的實驗;
- 倉庫修改;
- 測試輸出;
- 架構決策;
- 未解決問題。
因此,Astra 的 100 萬 token 上下文視窗的價值不僅在於可容納多少資訊,也在於能否在數小時互動後保存並找回正確資訊。
推理與解讀
ARC-AGI-3:框架是結果的一部分
ARC-AGI-3 最清楚地展示了前沿基準測試衡量的是整個系統,而非孤立模型。ARC Prize 報告在 Standard 框架、最大投入下為62.7%,在 Provider Adapter、high 投入為99.9%。
| ARC Prize 評估 | Standard Harness | Provider Adapter | Adapter Gain |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
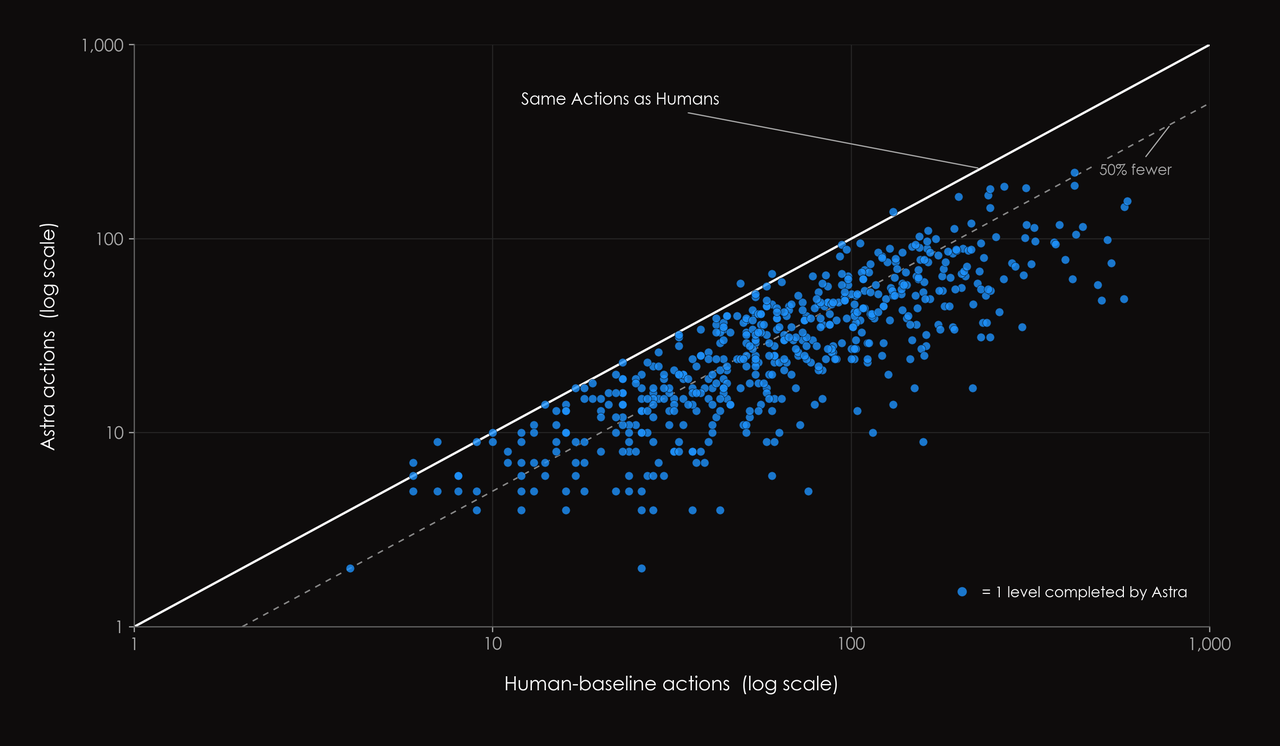
ARC Prize 比較不同評估框架下 Astra 的行動效率
提供者中立框架政策要求模型在可見狀態中保存重要資訊。Provider Adapter 會保留額外推理狀態,並使用供應商特定的上下文管理。對於共同解出的遊戲-推理對,ARC Prize 報告顯示使用 adapter 後執行速度提升 3.66 倍,總 token 減少 49%。
99.9% 的結果衡量的是特定的「模型—提供者—adapter」系統,不能視為與框架無關的原始模型智慧測量。上下文架構是被基準的系統一部分。
推理投入不呈線性擴張
ARC 表也顯示,最大投入不一定產生最高分。在 Provider Adapter 下,high 投入達到 99.9%,而 max 為 98.6%。在 Standard 框架下,max 表現最佳。
OpenAI 指出,發佈表上的數字通常使用觀察到的最佳推理設定。此作法估計表現上限,但無法找出生產中最佳配置。團隊應測試多個投入層級,計算每增加一秒與一美元的邊際品質提升。
數學與學術推理
FrontierMath Tier 4 v2 從 83.0% 上升至 97.6%,提升 14.6 點。這是重大基準進步,但不代表前沿數學已被解決。其評估涵蓋選定任務分佈,並未衡量數學研究的所有階段,包括問題選擇、形式化證明驗證、長期計畫發展或對抗性同儕審查。
GPQA Diamond 呈現相反模式:Astra 96.0%,Sol 94.6%,Fable 93.7%,Gemini 3.8 Flash 95.3%。各模型在天花板附近緊密聚集。報告 Astra 與 Sol 的 1.4 點差距是正確的,但若稱之為廣泛的智慧革命則誇大了證據。
關鍵能力與防護
| 資安評估 | Astra | Sol | 絕對提升 |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, June–August 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI 以過去三個月揭露的漏洞建立 ExploitBench(2026 年 6–8 月),降低歷史漏洞接觸誇大結果的機率。Astra 在該集合得 39.0%,Sol 5.5%,且 OpenAI 報告 Astra 發現並利用兩個先前未知的零日漏洞。這些結果促使 Astra 成為 OpenAI 首個達到 Critical 資安能力門檻並廣泛部署的模型,直接影響防護與存取政策。
如何閱讀接近飽和的分數
90% 以上的分數需要更謹慎的語言。從 50% 到 60% 解出每百題多 10 題;從 95% 到 96% 每百題僅多 1 題,雖然錯誤數從 5 減到 4,乃錯誤減少 20%。兩種描述皆數學正確,但支撐的是截然不同的標題。
反之亦然於低分基準。從 18.1% 上升至 41.4% 仍遠不足以達成可靠自主運行,但它讓成功案例翻倍,能改變受監督的工作流程。絕對分數決定系統是否可用;改善幅度反映能力變化速度。生產決策需要兩者。
多維比較
| 維度 | Astra | Sol | Fable | 決策訊號 |
|---|---|---|---|---|
| 一般學術推理 | 優秀;常接近飽和 | 緊隨其後 | 具競爭力 | 小差距很少單獨決定部署 |
| 終端執行 | 一線水準 | 代際差距大 | 近距競爭者 | 測試完整的程式代理架構 |
| 電腦使用 | 成功率更高且耗時更短 | 較慢且較不準確 | 發佈表缺乏可比數據 | 衡量每小時成功數 |
| 長上下文檢索 | 在 100 萬 tokens 附近仍強 | 接近上限時明顯劣化 | 缺乏直接可比數據 | 使用貼近生產的檢索測試 |
| 推理控制 | low 至 max | 不同投入包絡 | 自適應思維方法 | 調參配置,不僅是模型名稱 |
| 資安能力 | 風險層級質變 | 發佈結果較低 | 此處未比較 | 防護與存取政策至關重要 |
| token 經濟性 | 費率較高;有時使用更少 token | 費率較低 | 依工作負載而定 | 比較每次成功任務的成本 |
結果取決於工作負載。當任務需要與工具與環境持續互動、失敗後復原或在極大上下文中可靠檢索時,Astra 最具吸引力。對上下文需求適中、迭代有限的工作,Sol 可能仍更具經濟性。Fable 是終端工作上的近距競爭者,並在某些外部學術評估領先,因此應用層級的基準測試比供應商層級結論更有用。
誰應該使用 GPT-6 Astra?
| 使用情境 | 建議 |
|---|---|
| 簡單分類 | 不一定值得使用 Astra |
| 簡單摘要 | 不一定值得使用 Astra |
| 標準 RAG | 先基準比較成本與效能 |
| 長文件綜整與分析 | 值得測試 Astra |
| 代理型程式開發 | 強烈建議測試 |
| 電腦使用 | 強烈建議測試 |
| 多步驟自動化 | 強烈建議測試 |
| 複雜研究 | 值得測試 |
| 科學運算/專用軟體 | 值得測試 |
| 資安 | 能力強,但需要適當安全控管 |
| 高吞吐、簡單任務 | 成本較低的模型可能更具成本效益 |
GPT-6 Astra 的性能提升是否值得更高價格?
GPT-6 Astra 明顯比 GPT-5.6 Sol 更昂貴,但基準提升並非在所有工作負載上平均分佈。因此,價格問題不能僅以 token 費率比較來回答。
| 情境 | 表現提升 | 成本合理性 |
|---|---|---|
| 簡單問答 | 提升小 | 通常不值得溢價 |
| 程式代理 | 提升大 | 溢價可被合理化 |
| 長上下文分析 | 提升明顯 | 取決於檢索需求 |
| 電腦自動化 | 提升強 | 常值得測試 |
| 一般推理 | 提升有限 | 謹慎比較成本 |
在 OpenAI Standard 費率下,GPT-6 Astra 的輸入每百萬 tokens 為 $10、快取輸入為 $1、快取寫入為 $12.50、輸出為 $50。相較 GPT-5.6 Sol 的 $4 與 $20,Astra 的標準輸入與輸出分別為 2.5 倍。當請求超過 272K 輸入 tokens 時,Astra 的輸入與快取費率加倍,輸出費率上升 1.5 倍,且套用於整個請求。
價格溢價最清楚地對齊於代理型工作。Astra 在 Terminal-Bench、AutomationBench、資料庫遷移與最長範圍 MRCR 上提升超過 20 個百分點;獨立測試亦報告在 Coding Agent Index 上的 token 使用約為 Sol 的三分之一。在廣泛推理上,匹配度較弱:Intelligence Index 幾乎持平,token 使用僅下降約 10%。因此購買決策應比較每次成功任務的成本,包括輸出、快取活動、工具使用、耗時、重試、失敗與人工修正。
每次成功任務的成本
每次成功任務的成本 = (Input cost + Output cost + Tool cost + Retry cost + Human review cost) / Successful tasks
預期商務成本
預期商務成本 = API cost + Tool cost + Retry cost + Human-review cost + Failure cost
決策指標應是總成本除以成功任務數,並在可接受品質門檻下評估——而非每百萬 tokens 的標價。
開發者應如何為 Astra 做基準測試
公共榜單應決定「值得測試什麼」,而非做出最終部署決策。建立具代表性的任務集,包含日常案例、困難案例、缺失上下文案例、工具故障與對抗性指令。對每個模型使用相同的生產提示、權限、來源檔、時間預算與完成標準。
| 評估維度 | 測量項目 | 原因 |
|---|---|---|
| 任務成功 | 通過驗收標準 | 防止具說服力但不完整的答案被計作成功 |
| 可靠性 | 重複執行的成功分佈 | 揭露不穩定的一次性勝利 |
| 工具執行 | 經驗證的成功行動 | 區分工具呼叫與正確結果 |
| 事實性 | 受支撐的事實主張 | 衡量證據品質與棄答 |
| 延遲 | 中位與尾端完成時間 | 捕捉營運吞吐 |
| 成本 | 每次成功任務的總成本 | 包含重試與失敗嘗試 |
| 人力投入 | 更正與審查分鐘數 | 常在實際部署成本中占主導 |
| 可導引性 | 需求變更後的復原 | 測試長時間代理行為 |
CometAPI 中的 Astra API 使用模型 ID gpt-6-astra。多模型 API 讓在 Astra、Sol、Fable 與 Gemini 上以同一評估執行成為可行,而不必圍繞某家供應商的宣傳表格重設基準。將嚴苛的代理型任務路由至能賺得其溢價的模型,並在優勢消失之處使用成本較低的模型。
結論
Astra 的基準成績單令人印象深刻,但最耀眼的分數不一定最有用。ARC-AGI-3 展現了供應商特定代理框架的潛力;Standard 框架分數則顯示基礎設施對結果的強大影響。GPQA 與獨立的 Intelligence Index 顯示一般推理的提升可能溫和。終端工作、自動化、電腦使用、長上下文檢索、科學工作流程與資安,才是更重要的故事。
這次發佈的重點,不是聊天機器人在每個問題上同比變得更聰明,而是前沿智慧在「完成工作」上變得更好。這項升級是否值得付費,取決於整個模型—系統配置與每次成功生產任務的經濟性。