

المختصر المفيد
Claude Opus 5.5 هو مرشح افتتاحي قوي لأنه يقدم تس定 أسعار رمزية أقل بكثير مع تحقيق نتائج مساوية أو متفوقة على Fable 5.1 في عدة تقييمات منشورة، مع تسعير قدره $4 لكل مليون رمز إدخال و$20 لكل مليون رمز إخراج، مقابل $10 و$50 في Fable 5.1.
لا يزال لـ Fable 5.1 دور عندما تكون المهمة صعبة بشكل غير اعتيادي، طويلة الأمد، باهظة تكلفة المحاولة مجددًا، أو متوقعة أن تعمل دون إشراف وثيق. القاعدة العملية بسيطة: ابدأ بـ Opus 5.5، ثم تصعّد فقط عندما تُظهر اختبارات إنتاجية ممثلة أن Fable 5.1 يقلل الفشل أو التصحيح أو تكاليف إعادة المحاولة بما يكفي لتبرير سعره الأعلى.
Claude Opus 5.5 مقابل Claude Fable 5.1 لمحة سريعة
| البُعد | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| تاريخ الإصدار | 22 سبتمبر 2026 | 1 سبتمبر 2026 |
| معرّف نموذج API | claude-opus-5-5 | claude-fable-5-1 |
| السياق / الحد الأقصى للإخراج | 1M / 128K | 1M / 128K |
| تكلفة الإدخال/الإخراج لكل MTok | $4 / $20 | $10 / $50 |
| قراءة من الذاكرة المؤقتة لكل MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| ترحيل HAProxy من C إلى Rust | 9.5 ساعات؛ تكلفة مهمة أقل بنسبة 51% | 12 ساعة؛ تكلفة المهمة الأساسية |
| خيار السرعة | وضع Fast، حتى 2.5× من السرعة العادية | لا يوجد وضع إطلاق مكافئ |
| نقطة بداية الجهد | موجه نحو المستوى المتوسط | مرتفع |
| أفضل استخدام افتراضي | البرمجة الحدّية اليومية، الوكلاء، الإنتاج الخاضع للإشراف، وحركة مرور API عالية الحجم | الأعمال الأعلى قيمة، الصعبة، طويلة الأمد، أو العمل الذاتي غير المراقب |
| الوصول عبر API | Anthropic API ومزودون متوافقون بما في ذلك CometAPI | Anthropic API ومزودون متوافقون بما في ذلك CometAPI |
ملاحظة قراءة: أرقام المعايير تقريرية من Anthropic وتعتمد على مستوى الجهد، وأداة القياس، وإجراءات الأمان، وإصدار المهمة، وعدد المحاولات، والخطأ المعياري. يجب مقارنتها فقط في ظروف تقييم متطابقة.
أبرز النقاط
- أسعار الإدخال والإخراج القياسية في Opus 5.5 أقل بنسبة 60% من معدلات Fable 5.1.
- كلا النموذجين يدعمان نافذة سياق 1M ورمز إخراج يصل إلى 128K، لذا فإن التكلفة، وإعدادات الجهد، وملاءمة عبء العمل أهم من الحجم الاسمي للسياق.
- النتائج المنشورة من Anthropic تفضّل Opus 5.5 عبر العديد من تقييمات البرمجة والمهام الوكيلية، لكن إعدادات المعايير تؤثر جوهريًا على النتيجة.
- التقييم المستقل يدعم موقع Opus 5.5 الحدّي مع الإبلاغ عن درجات مطلقة مختلفة، مما يعزز الحاجة لاختبارات متطابقة.
- لمعظم الأعمال الإنتاجية الخاضعة للإشراف، Opus 5.5 هو نقطة البداية الأقوى. Fable 5.1 هو طبقة تصعيد، وليس الافتراضي تلقائيًا.
ما هو Claude Opus 5.5؟
Claude Opus 5.5 هو أول نموذج Claude 5.5 من Anthropic. يُوضع للبرمجة الوكيلية، والوكلاء طويلة الأمد، وأعمال المعرفة المهنية، وسير عمل المؤسسات، والتحليل المالي، والرؤية، واستخدام الحاسوب.
معرّف نموذج API هو claude-opus-5-5. التفكير التكيفي مفعل دائمًا، بينما يتحكم المطورون في شدة الاستدلال عبر إعدادات جهد low وmedium وhigh وxhigh وmax. كما تقدم Anthropic وضع Fast، الذي يمكن أن يعمل بسرعة تصل إلى 2.5 مرة من السرعة العادية مقابل $8 لكل مليون إدخال و$40 لكل مليون إخراج.
ما هو Claude Fable 5.1؟
Claude Fable 5.1 يُوضع للمشاريع المتطلبة طويلة الأمد مثل البرمجة لعدة ساعات، والبحث المعقد، والتفاعل عبر المتصفح، والوكلاء الذاتيون، وسير العمل التي تمتد عبر تطبيقات متعددة.
معرّف نموذج API هو claude-fable-5-1. يستخدم التفكير التكيفي، وينطلق من إعداد جهد API أعلى، ومن الأفضل اعتباره خيارًا مميزًا عندما تكون تكلفة الفشل المتوقعة أو إعادة المحاولات أكبر من تكلفة الاستدلال الإضافية.
قراءة مبسطة ستكون أن Opus 5.5 يقدم تقريبًا نفس الغلاف بسعر 40% من السعر الرمزي القياسي لـ Fable. لكن هنا تحديدًا يمكن أن يكون جدول المواصفات البسيط مضللًا.
مقارنة الشيفرة والمعايير
تبلغ Anthropic أن Opus 5.5 يتفوق على Fable 5.1 في Terminal-Bench 4.0 وFrontierCode v1.1 وCursorBench 4.0 وGDPval-AA v2.1 وAutomationBench وHumanity's Last Exam مع الأدوات وTerminal-Bench-Science وOSWorld 2.0 وChartography.
كيفية قراءة نتائج المعايير
تبلغ Anthropic أن Opus 5.5 يتفوق على Fable 5.1 في Terminal-Bench 4.0 وFrontierCode v1.1 وCursorBench 4.0 وGDPval-AA v2.1 وAutomationBench وHumanity's Last Exam مع الأدوات وTerminal-Bench-Science وOSWorld 2.0 وChartography. هذه الأرقام هي نتائج تقييم، وليست ثوابت نموذج مستقلة عن التهيئة.
معظم درجات Opus 5.5 الرئيسية استخدمت جهد max، بينما استخدم Terminal-Bench 4.0 جهد xhigh. تصميم الأداة، تهيئة الأدوات، إجراءات الأمان، عدد المحاولات، الخطأ المعياري، سلوك السقوط الاحتياطي، وسقوف التكلفة كلها يمكن أن تغير النتيجة. تحذر Anthropic نفسها من أن هوامش المعايير قد تبالغ في الفجوة العملية بين النماذج الحدّية.
أداء البرمجة
| المعيار | Claude Opus 5.5 | Claude Fable 5.1 | التفسير |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | تقدم مُبلّغ عنه بمقدار 10.6 نقطة لمهام الوكلاء القائمة على الطرفية |
| FrontierCode v1.1 | 54.4% max؛ 54.6% medium | 50.3% | Opus 5.5 عند مستوى medium يظل منافسًا لاقتصاديات الإنتاج |
| CursorBench 4.0 | 57.8% max؛ 52.5% medium | 51.8% | مستوى medium يتجاوز قليلًا نتيجة Fable المُعلنة |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | أفضلية مُعلنة في العمل الوكائيلي المهني |
هذه الأرقام هي نتائج معايير مُعلنة من Anthropic. يجب قراءة الجدول مع التحفظات الخاصة بإعدادات التقييم في الأقسام التالية ومع الصفحة الرسمية لنموذج Claude Opus.
تبرز النتائج الثلاثة الأولى لأنها تغطي عبء العمل حيث يصبح Claude ذا أهمية متزايدة تجاريًا: وكلاء هندسة البرمجيات. يُظهر Terminal-Bench 4.0 فرقًا مطلقًا قدره 10.6 نقطة مئوية؛ يُظهر FrontierCode 4.1 نقطة؛ ويُظهر CursorBench 4.0 ست نقاط.
يبلغ GDPval-AA، الذي يقيس العمل الوكائيلي المهني، أيضًا عن 1846 Elo لـ Opus 5.5 مقابل 1735 لـ Fable 5.1. لو كانت هذه الأرقام كل القصة، لبدت هرميّة المنتج مقلوبة. الأمر ليس بهذه البساطة.
تقييم مستقل
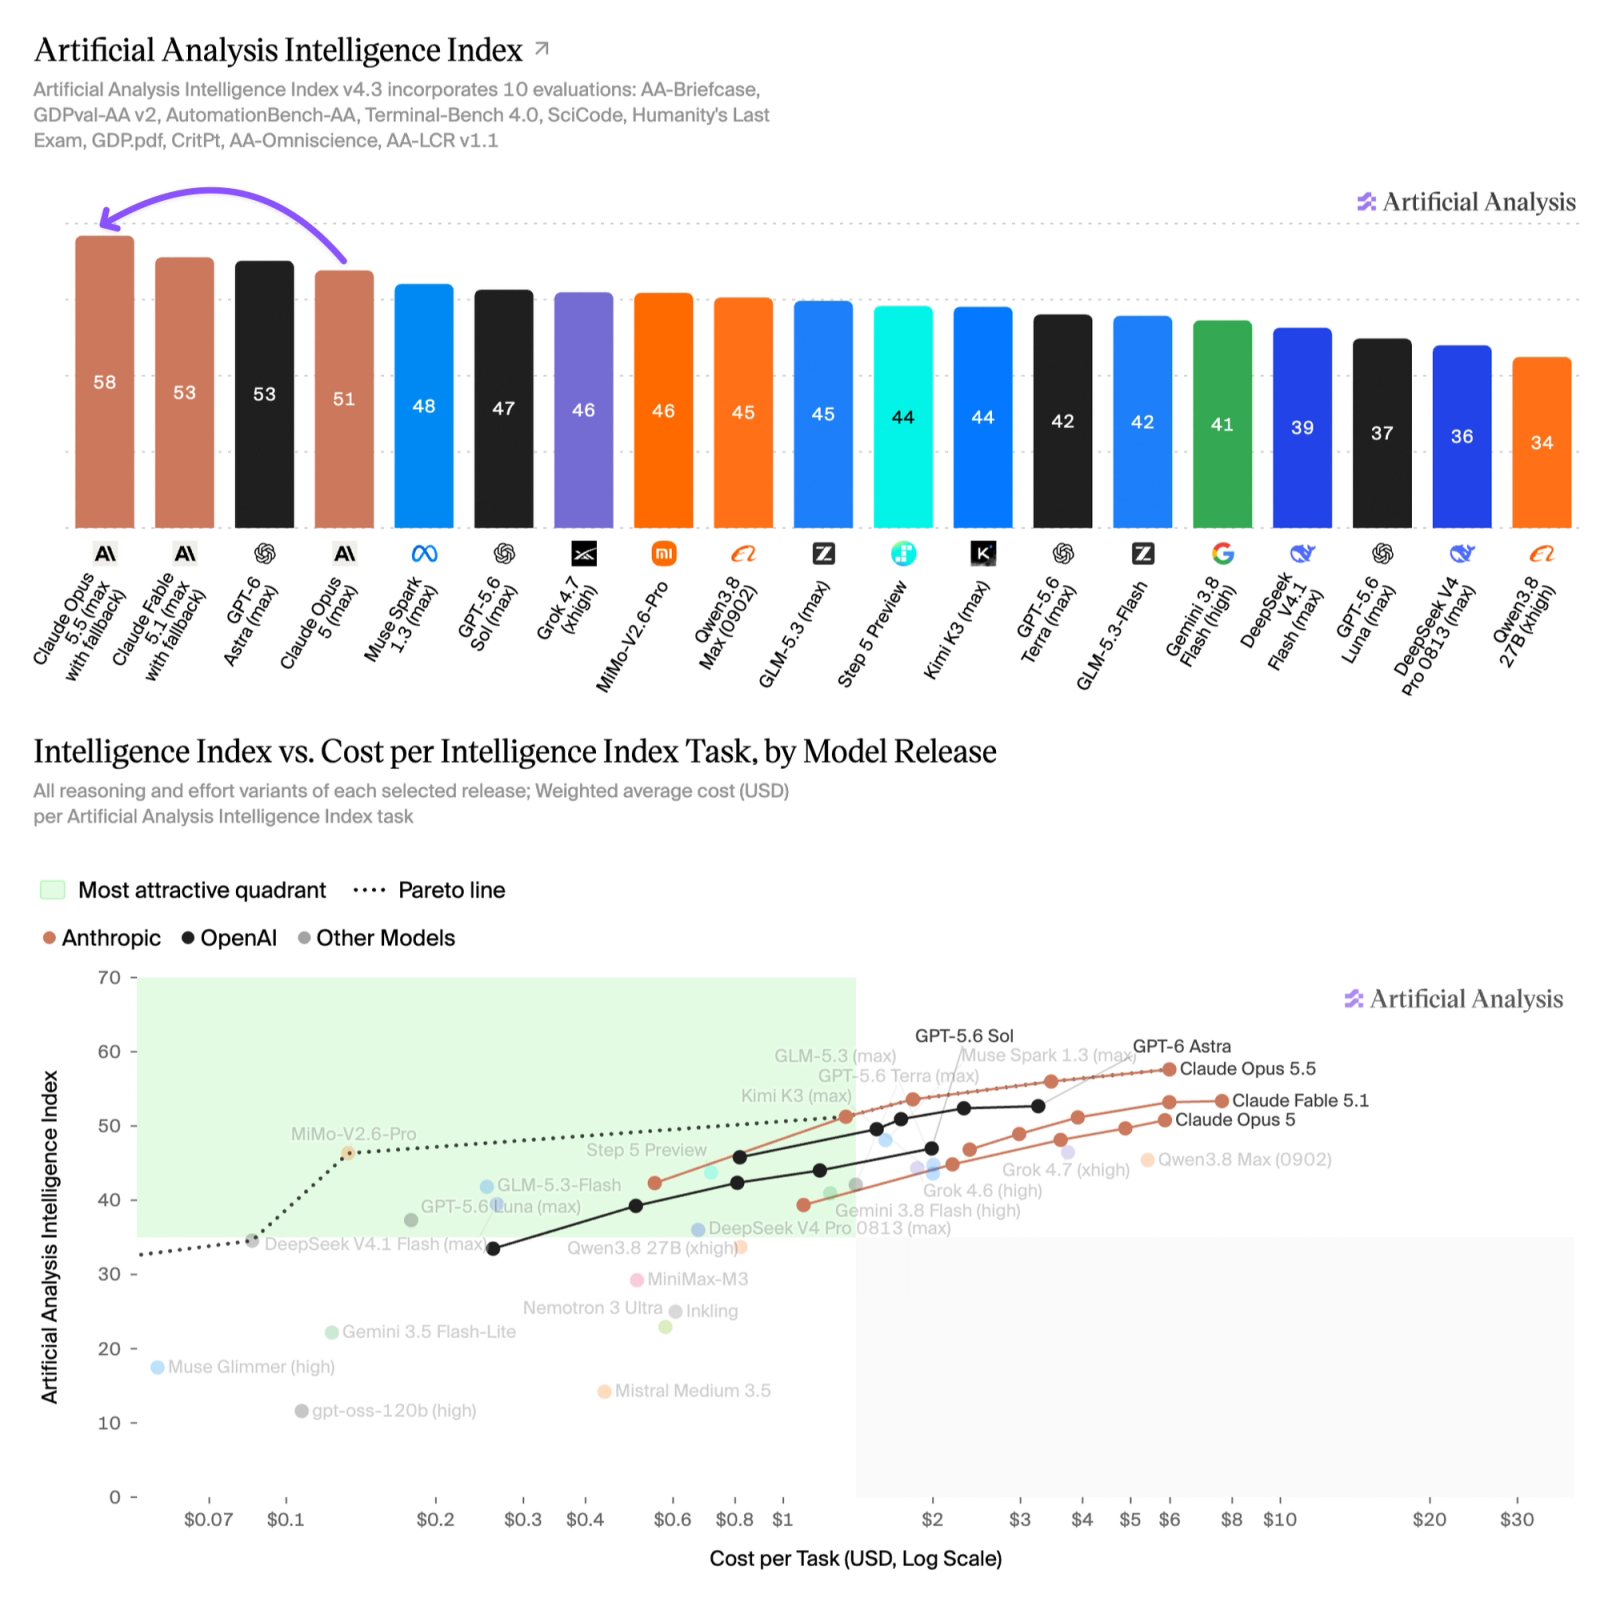
وضع Artificial Analysis Opus 5.5 Max عند 58 على مؤشر الذكاء الخاص به وأبلغ عن نتائج قوية عبر AA-Briefcase وGDPval-AA وAutomationBench-AA وTerminal-Bench 4.0 وSciCode وHumanity's Last Exam. كانت نتيجته في Terminal-Bench 4.0 هي 59.6%، أقل من 66.4% لدى Anthropic، ما يُظهر سبب ضرورة توثيق إصدار النموذج، وإعداد الجهد، والأداة، والأدوات، وعدد المحاولات، وحد التكلفة كلما اختلفت الدرجات.
مقارنة السعر وتكلفة إكمال المهمة
تقدم CometAPI أسعار رموز أقل من الأسعار الرسمية، مما يسمح للمطورين بتحقيق نفس الأداء كما في API الرسمي باستخدام تنسيق طلب الرسائل القياسي.
تسعير الرموز
| التسعير | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| الإدخال | $4 | $10 |
| الإخراج | $20 | $50 |
| كتابة ذاكرة مؤقتة 5 دقائق | $5 | $12.50 |
| كتابة ذاكرة مؤقتة 1 ساعة | $8 | $20 |
| قراءة من الذاكرة المؤقتة | $0.20 | $0.25 |
| إدخال/إخراج بالجملة | خصم 50% | خصم 50% |
افترض أن عبء العمل يستهلك 10 مليون رمز إدخال جديد و2 مليون رمز إخراج. دون تأثيرات الذاكرة المؤقتة:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
وفقًا لهذه الافتراضات، يكلف Opus 5.5 أقل بنسبة 60%. ومع ذلك، لا ينبغي الخلط بين هذا الرقم وبين تصريح Anthropic بأن Opus 5.5 يكلف أقل بحوالي 40% للتشغيل مقارنة بـ Opus 5.
هاتان مقارنتان مختلفتان تمامًا. تتضمن نسبة 40% أسعار فئة Opus الأقل في Opus 5.5 وتقليل استهلاك الرموز لكل مهمة مقارنة بـ Opus 5. تأتي نسبة 60% مباشرة من مقارنة قوائم الأسعار القياسية لـ Opus 5.5 وFable 5.1.
تكلفة كل مهمة مكتملة
واجهة برمجة تطبيقات النموذج لا تبيع الرموز حقًا. المطورون يشترون عملًا مُنجزًا.
فريق البرمجة لا يهتم بأن النموذج استهلك 6.2 مليون رمز. ما يهمه هو ما إذا كان النموذج قد أصلح الخلل، أكمل عملية الترحيل، اجتاز مجموعة الاختبارات، أو أنهى مهمة البحث.
توضح Anthropic هذه النقطة مباشرة في تحليلها ما تكلفة المهمة على Opus 5.5: يمكن أن تكون تكلفة المهمة مختلفة جدًا حتى مع أسعار متشابهة إذا كان أحد النماذج يحتاج لعدد أكبر من الأدوار، أو يعيد قراءة سياق أكثر، أو يعيد المحاولة أكثر، أو يولد رموز تفكير أكثر.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
العنصر الأخير غالبًا ما يُتجاهل. نموذج أرخص يفشل مرتين قد يصبح أكثر تكلفة من نموذج أغلى يُكمل المهمة في تشغيل واحد. بالمثل، قد يخفض إعداد جهد مرتفع إجمالي التكلفة إذا تجنب عشر دورات إعادة محاولة.
اقتصاديات التخزين المؤقت
الوكلاء المعتمدون على التخزين المؤقت يعيدون استخدام تعريفات الأدوات، وسياق المستودع، وتعليمات النظام، وسجل المحادثة، ومخرجات الاختبار بشكل متكرر. نظرًا لأن تسعير قراءة الذاكرة المؤقتة هو $0.20/M لـ Opus 5.5 و$0.25/M لـ Fable 5.1، فإن الفجوة أصغر بكثير من فرق $6/M في تسعير الإدخال الجديد. لذا ينبغي للفرق تتبع الإدخال الجديد، قراءات وكتابات الذاكرة المؤقتة، الإخراج، الأدوار الأدواتية، وإعادات المحاولة بشكل منفصل.
اقتصاديات مستويات الجهد
محتمل، نعم. اختبر Artificial Analysis خمسة إعدادات جهد لـ Opus 5.5 ووجد منحنى واضحًا بين القدرة والتكلفة.
| جهد Opus 5.5 | مؤشر الذكاء لدى Artificial Analysis | تكلفة لكل مهمة على المؤشر |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
يُعد مستوى medium نقطة بداية معقولة لتغييرات الشفرة الروتينية، وإعادة الهيكلة المعروفة، وتصحيح الأخطاء تحت الإشراف. قد تُبرر مستويات high أو xhigh لإخفاقات النظام الغامضة، أو عمليات الترحيل الليلية، أو المهام التي يؤدي فيها المخطط الخاطئ إلى إعادة عمل كبيرة.
مقارنة السلامة والموثوقية
لا ينبغي وصف أي نموذج بأنه أكثر أمانًا solely من معايير القدرة. تتطلب مقارنة قابلة للدفاع إعدادات مطابقة للمطالبات، والأدوات، والأذونات، ومستويات الجهد، وحدود إعادة المحاولة، ومعايير القبول. قد تقلل القدرة الأعلى من الأخطاء العرضية، لكن زيادة الاستقلالية وطول التنفيذ يزيدان أيضًا من أثر الخطة السيئة، أو حقن المطالبات، أو استدعاء أداة غير آمن، أو الانحراف غير الملحوظ.
| بُعد السلامة | مقارنة عملية | تحكم إنتاجي |
|---|---|---|
| الاستدلال والجهد | Opus 5.5 يعرض مستويات جهد متعددة، بينما يبدأ Fable 5.1 من وضع جهد أعلى. المزيد من الاستدلال ليس بديلًا عن إنفاذ السياسات. | ثبّت سياسة الجهد حسب عبء العمل وأعد اختبار سلوك السلامة كلما تغير. |
| الاستقلالية طويلة الأمد | يتموضع Fable 5.1 للعمل الصعب وغير الخاضع للإشراف؛ كما يدعم Opus 5.5 سير العمل الوكائيلي. يزداد الخطر مع المدة، الأذونات، وعدد الإجراءات غير القابلة للعكس. | استخدم نقاط تفتيش، بوابات موافقة، حدود زمنية وتكلفة، وشروط تراجع أو إيقاف تلقائي. |
| استخدام الأدوات والحاسوب | كلا النموذجين يمكنهما تشغيل الأدوات، لذا اختيار النموذج وحده لا يتحكم في كشف البيانات أو الأفعال المدمرة. | طبّق مبدأ أقل امتياز، قوائم سماح، sandboxing، عزل الأسرار، والتأكيد قبل الأفعال الخارجية أو غير القابلة للعكس. |
| التقييم وقابلية التدقيق | درجات المعايير العامة لا تُثبت جودة الرفض، أو مقاومة حقن المطالبات، أو معدلات الحوادث الإنتاجية. | سجّل استدعاءات الأدوات وقرارات السياسات؛ قِس معدل الامتثال غير الآمن، حالات الرفض الكاذبة، نجاح الحقن، تسرب الأسرار، المحاولات المدمرة، وجودة الاسترداد. |
قاعدة سلامة عملية: ابدأ بأقل تهيئة امتياز لـ Opus 5.5 تلبي المهمة، وتصعّد إلى Fable 5.1 فقط بعد اجتياز نفس مجموعة السلامة. بالنسبة لسير العمل عالية الأثر، اطلب موافقة بشرية بغض النظر عن أي نموذج يسجل أعلى في اختبارات القدرة.
- شغّل اختبارات حقن مطالبات عدائية واستخراج بيانات باستخدام مجموعة أدوات الإنتاج الحقيقية.
- افصل أذونات القراءة والكتابة والنشر والحذف والمالية بدلًا من منح دور أداة عريض واحد.
- عرّف محفزات للتراجع عند انتهاكات السياسة، وإخفاقات الأدوات المتكررة، والتوسع غير المتوقع في النطاق، وتجاوزات التكلفة.
- أعد التحقق بعد أي تغييرات في النموذج، أو موجه النظام، أو الجهد، أو الأدوات، أو الأذونات، أو التوجيه.
كيفية الاختيار بين Opus 5.5 وFable 5.1
| عبء العمل | نقطة البداية الموصى بها | شرط التصعيد |
|---|---|---|
| البرمجة اليومية ومراجعة الشفرة | Opus 5.5، مستوى medium | صعّد فقط للحالات الصعبة أو عالية المخاطر بشكل غير اعتيادي |
| عمل الميزات متعددة الملفات | Opus 5.5، medium أو high | استخدم Fable عندما تهيمن إخفاقات التخطيط المتكررة على التكلفة |
| ترحيل على مستوى المستودع | اختبر Opus 5.5 على high أو xhigh أولًا | صعّد لأصعب المشاريع غير الخاضعة للإشراف |
| تشغيلات ليلية ذاتية | Opus 5.5 مع نقاط تفتيش صارمة | فضّل Fable عندما تكون كلفة الاتجاه الخاطئ شديدة |
| حركة مرور API عالية | Opus 5.5 | صعّد فقط للنسبة الأقل من المهام المعرضة للفشل |
| نشر Fable مُتحقق قائم | احتفظ بالنشر الحالي أثناء الاختبار | بدّل فقط بعد أن يحقق Opus نفس عتبات القبول |
اختبار إنتاجي عملي
شغّل نفس المهام الممثلة، والمطالبات، والأدوات، وسياسة الجهد، ومعايير القبول، وحدود إعادة المحاولة عبر كلا النموذجين. سجّل معدل المهام المقبولة، والزمن، والإدخال الجديد والمخزّن، ورموز الإخراج والتفكير، واستدعاءات الأدوات، وإعادات المحاولة، والتصحيحات البشرية، وإجمالي التكلفة لكل نتيجة مقبولة. ضمّن المهام الروتينية وحالات الفشل الصعبة.
إرشادات ترحيل لمستخدمي Claude Opus 5 الحاليين
يجب على مستخدمي Opus 5 الحاليين اختبار Opus 5.5 بوصفه خليفة بدلًا من افتراض أن تبديل معرف النموذج خالٍ من المخاطر. قارن عمق التخطيط، وأنماط استدعاء الأدوات، وطول الاستجابة، والالتزام بالتنسيق، والزمن، وسلوك ذاكرة التخزين المؤقت للموجه، والتعافي من استدعاءات الأدوات الفاشلة، وتوجيه السلامة، وتكلفة إكمال المهمة. احتفظ بمعايير التراجع والنموذج الحالي متاحًا حتى يجتاز Opus 5.5 اختبارات قبول شبيهة بالإنتاج.
لا يحتاج مستخدمو Fable 5.1 الحاليون إلى قسم ترحيل عام. ينبغي لهم بدلًا من ذلك التعامل مع Opus 5.5 كمرشح أمثل وتقييمه وفق نفس معايير القبول الإنتاجية قبل تغيير نشر مُتحقق.
الوصول عبر CometAPI
يمكن للمطورين الذين يقيّمون أيًا من النموذجين مراجعة الأدلة ذات الصلة لـ Claude Opus 5.5 وClaude Fable 5.1. عند الدمج عبر أي مزود API متوافق، أكد معرّف النموذج الدقيق، ومعاملات الجهد المدعومة، وسلوك التخزين المؤقت، وحدود المعدل، والتوافر الإقليمي، والسعر الحالي قبل النشر الإنتاجي.
استخدم claude-opus-5-5 لـ Opus 5.5 وclaude-fable-5-1 لـ Fable 5.1 حيثما كانت هذه المعرفات مدعومة. تجنب توجيه كلا فئتي أعباء العمل بصمت عبر مستوى جهد ثابت واحد؛ ينبغي تهيئة اختيار النموذج وسياسة الجهد بشكل مستقل.
بايثون — واجهة Anthrop ic Messages API عبر CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
الخلاصة
يغيّر Claude Opus 5.5 الحدود العملية بين نموذج Anthropic اليومي الحدّي وطبقة التصعيد المميزة. فهو أرخص بكثير بأسعار الرموز القياسية، ويتصدر العديد من معايير البرمجة والمهام الوكيلية المنشورة، ويقدم مرونة كافية في مستويات الجهد لتغطية نطاق إنتاجي واسع.
لا يزال Claude Fable 5.1 ذا صلة عندما تكون المهمة صعبة، عالية القيمة، طويلة الأمد، أو ذاتية وغير خاضعة للإشراف حيث تتجاوز تكلفة الفشل فاتورة الاستدلال الأعلى. بالنسبة لمعظم الفرق، أفضل سياسة هي البدء بـ Opus 5.5، قياس نتائج المهام المكتملة، ثم التصعيد بشكل انتقائي.
الأسئلة الشائعة
كيف ينبغي للفرق تصميم اختبار A/B إنتاجي لـ Opus 5.5 وFable 5.1؟
استخدم نفس المهام الممثلة، والمطالبات، والأدوات، وسياسة الجهد، ومعايير القبول، وحدود إعادة المحاولة لكلا النموذجين. سجّل معدل المهام المقبولة، والزمن، والإدخال الجديد والمخزّن، ورموز الإخراج والتفكير، واستدعاءات الأدوات، وإعادات المحاولة، والتصحيحات البشرية، وإجمالي التكلفة لكل نتيجة مقبولة. شغّل عددًا كافيًا من المهام لالتقاط العمل الروتيني وكذلك حالات الفشل الصعبة.
متى قد تفشل أسعار الرموز الأقل في خفض تكلفة المهمة الإجمالية؟
قد يظل النموذج الأقل سعرًا أكثر تكلفة إذا تطلب أدوارًا إضافية، أو أعاد قراءة سياق أكثر، أو أنتج رموز تفكير أكثر، أو احتاج لإعادات محاولات متكررة. كما أن سلوك الذاكرة المؤقتة مهم: تضيق فجوة سعر الإدخال في الجلسات الطويلة التي تهيمن عليها قراءات الذاكرة المؤقتة. قارن تكلفة المهمة المكتملة بدلًا من الاعتماد على السعر المُعلن فقط.
ماذا ينبغي توثيقه عندما تختلف نتائج المعايير؟
سجل إصدار النموذج، ومستوى الجهد، وأداة القياس، وإعدادات السقوط الاحتياطي والسلامة، وعدد المحاولات، وإصدار المهمة، والخطأ المعياري، وحد التكلفة. صنّف كل نتيجة بأنها رسمية أو مستقلة وتجنب دمج الدرجات من تهيئات غير متطابقة في تصنيف واحد.
ما مخاطر الترحيل التي ينبغي لمستخدمي Fable 5.1 الحاليين مراقبتها؟
راقب تغييرات عمق التخطيط، وأنماط استدعاء الأدوات, طول الاستجابة، الالتزام بالتنسيق، الزمن، سلوك ذاكرة التخزين المؤقت للموجه، التعافي من إخفاقات الأدوات، وتوجيه السلامة. احتفظ بالنشر الحالي متاحًا أثناء التقييم، وضع معايير للتراجع، وارحل فقط بعد أن يحقق Opus 5.5 نفس عتبات القبول على مهام شبيهة بالإنتاج.
بيانات تحسين محركات البحث
Meta title: Claude Opus 5.5 مقابل Fable 5.1: الشفرة، التكلفة، والمعايير
Meta description: Compare Claude Opus 5.5 وClaude Fable 5.1 عبر معايير البرمجة، تسعير API، السرعة، التخزين المؤقت، إعدادات الجهد، تكلفة المهمة المكتملة، وملاءمة عبء العمل.
Keywords: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, Claude coding benchmarks, Claude API pricing, CometAPI, AI coding models
URL slug: claude-opus-5-5-vs-claude-fable-5-1