
الملخص
أعلنت Z.AI علناً عن اسم GLM-6.0 وجعلت التدريب الذاتي الكامل في صلب خارطة الطريق للجيل التالي. يربط الاتجاه المُفصح عنه الخبرة المُولَّدة ذاتياً عبر ما قبل التدريب وأثناء التدريب وما بعد التدريب بالتقييم الذاتي والتصحيح، محولاً التدريب إلى حلقة تغذية راجعة محكومة بدلاً من كونه مروراً واحداً لإنتاج البيانات.
الجزء الصعب هو التحكم: سيحتاج GLM-6.0 إلى تنقية البيانات الاصطناعية، واكتشاف الأخطاء وإصلاحها، وإيقاف التكرارات غير المثمرة، ومنع مُقيِّمه من مكافأة الطرق المختصرة. تثير تلك الآليات أسئلة عملية حول التحقق المستقل، والسلامة، والتكلفة، والحوكمة. ولأنه لا توجد بطاقة نموذج كاملة، أو مجموعة قياسية، أو مواصفة API، أو سعر، أو تاريخ إصدار معلن، فإن المقالة تقيّم بنية التدريب وأدلته—not المواصفات الافتراضية.
الخلاصات الرئيسية لـ GLM 6.0؟
- أقوى الأدلة العامة تتعلق بنظام التدريب الذاتي الكامل، لا بعدد معلمات مُسرَّب أو نتيجة معيارية.
- يغطي الاتجاه المُفصح عنه بيانات مُنتَجة ذاتياً، وبيئات تدريب مُشيَّدة ذاتياً، وتحسين البنية التحتية بمساعدة النموذج.
- تمتد حلقة التغذية الراجعة المقصودة عبر ما قبل التدريب وأثناء التدريب وما بعد التدريب بدلاً من التعامل مع التدريب الذاتي كتقنية لما بعد التدريب فقط.
- النمذجة متعددة الوسائط الأصلية، والتعلم المعزز بعيد الأفق، والتخطيط، واستخدام الأدوات، والاسترداد، والتحقق هي اتجاهات بحثية ذات صلة، لكنها ليست بعد مواصفات منشورة لـ GLM 6.0.
- Ox Alpha ليس دليلاً على أداء GLM 6.0 مُسرَّب؛ حددته Z.AI كهوية ما قبل الإصدار لـ GLM-5.3-Flash.
ما الذي أكدته Z.AI فعلياً عن GLM 6.0؟
تُثبت مواد Z.AI العامة أربع إشارات ملموسة: اسم GLM-6.0، التدريب الذاتي الكامل كاتجاه تدريبي مركزي، حلقة مقصودة عبر ما قبل التدريب وأثناء التدريب وما بعد التدريب، وآلية للتقييم الذاتي والتصحيح. كما تُصرّح الشركة بأن نحو 60% من صافي العائدات مُخصَّصة لدعم نماذج الجيل التالي، والتدريب الذاتي الكامل، والتدريب واسع النطاق، والاستدلال، والحوسبة، والبنية التحتية ذات الصلة.
إطار التدريب الذاتي الكامل لدى Z.AI
يُعرض التدريب الذاتي الكامل بوصفه الفكرة المنظمة لـ GLM-6.0، لا كميزة صغيرة لما بعد التدريب. سيتولى النظام المقصود توليد خبرة تدريبية، والتعلم من النتائج، وتنقية العينات الضعيفة، وتكرار الدورة تحت ضوابط جودة صريحة.
التدريب الذاتي في GLM-6.0 عبر ما قبل وأثناء وما بعد التدريب
تُشير السلسلة المُفصح عنها—ما قبل التدريب، وأثناء التدريب، وما بعد التدريب—إلى أن الخبرة المُولَّدة ذاتياً يمكن أن تؤثر في المعرفة الأساسية، وتشكيل القدرات، ومواءمة المهام بدلاً من الظهور فقط أثناء الضبط النهائي. لم تفصح Z.AI عن مجموعات البيانات أو حدود المراحل أو نسب المزج، لذا ينبغي التعامل مع هذا بوصفه اتجاهاً مؤكداً لا وصفة مكتملة.
آلية التقييم الذاتي والتصحيح في GLM-6.0
يربط المخطط التدريبي التدريبَ الذاتي الكامل بالتقييم الذاتي، واكتشاف الأخطاء، والتصحيح، وتنقية البيانات ذاتياً. عملياً، سيحتاج النموذج إلى الحكم على المسارات، ومراجعة الخطوات الفاشلة، واستبعاد البيانات غير الموثوقة، وتقرير موعد توقف التكرار حين لا يعود يُحسّن الأداء المُقاس بشكل مستقل. لا تزال بنية المُقيِّم وقواعد الإيقاف غير مُفصح عنها.
يجب قراءة إفصاح GLM-6.0 والتدريب الذاتي الكامل مع تخصيص العائدات العامة من Z.AI.
ما نعرفه مقابل ما لا نعرفه
السجل العام يدعم خارطة طريق، لا مواصفة منتهية. يفصل الجدول الاتجاه المؤكد عن الأسئلة المفتوحة حتى لا يحول المقالُ النية المُفصح عنها إلى ادعاء منتج غير مدعوم.
| الادعاء | حالة الأدلة | ما تدعمه الأدلة | ما يزال غير معروف |
|---|---|---|---|
| اسم GLM-6.0 | مُعلن علناً | سمت Z.AI نموذج الجيل التالي GLM-6.0. | تاريخ الإصدار والتموضع النهائي. |
| التدريب الذاتي الكامل | خارطة طريق مؤكدة | أولوية استراتيجية مُعلنة. | تفاصيل التنفيذ وسلوكية التوسيع. |
| ما قبل التدريب → أثناء التدريب → ما بعد التدريب | اتجاه مُؤكد | التدريب الذاتي مُعتزم امتداده عبر دورة حياة التدريب. | مجموعات البيانات، المُحققون، حدود المراحل، ونِسَب البيانات. |
| التقييم الذاتي والتصحيح | هدف مُؤكد | تتضمن الخارطة التنقية الذاتية، واكتشاف الأخطاء، والتصحيح. | الموثوقية، والتحقق المستقل، ومعايير الإيقاف. |
| المواصفات | غير مُفصح عنها | لا توجد مواصفة عامة مكتملة. | المعلمات، نافذة السياق، الوسائط، السعر، ومعرّف الـ API. |
| المعايير القياسية | غير مُفصح عنها | لا توجد مجموعة نتائج رسمية لـ GLM-6.0. | الدرجات، المنهجية، والنتائج القابلة لإعادة الإنتاج بشكل مستقل. |
ما هو التدريب الذاتي الكامل وكيف يعمل
التدريب الذاتي الكامل حلقة تعلم مغلقة يساعد فيها النموذج على إنشاء المهام أو البيئات، ومحاولة حلها، وتقييم المسارات الناتجة، وتصحيح الخطوات الضعيفة، وإعادة إدخال الخبرة المقبولة في التدريب. التحول المهم هو الانتقال من خط أنابيب بيانات اصطناعية لمرة واحدة إلى عملية مُدارة بشكل مستمر.
- توليد: بناء المشكلات، وبيئات الأدوات، ومسارات الحل المرشحة.
- الفعل: إكمال المهام وحفظ الإجراءات والمشاهدات والاستدلالات الوسيطة كمسارات.
- التقييم والتصحيح: تسجيل النتائج عبر المُتحققين، واكتشاف الأخطاء، ومراجعة الخطوات الفاشلة، ورفض العينات منخفضة الثقة.
- التدريب والإيقاف: التعلم من الخبرة المقبولة، ثم الاستمرار فقط ما دامت التقييمات المستقلة تُظهر تحسناً مفيداً.
يمكّن توسيع هذه الحلقة عبر ما قبل وأثناء وما بعد التدريب GLM-6.0 من تحسين جودة البيانات، وتشكيل القدرات، ومواءمة المهام في مراحل مختلفة. ولا تزال البنية تعتمد على مُقيِّمين موثوقين: بدون تحقق مستقل، قد يُكافئ التدريب الذاتي نقاط عمى النظام نفسه.
كيف قد يغيّر التدريب الذاتي الكامل GLM 6.0؟
يُفهَم التصميم المُفصح عنه على أنه بنية نظام أكثر من كونه كتلة Transformer جديدة واحدة. يحاول إغلاق الحلقة حول النموذج بحيث يساعد النموذج بشكل متزايد على توليد الموارد اللازمة لدورة التدريب التالية.
كيف قد يُنتج GLM 6.0 بيانات التدريب؟
الحلقة الأولى هي الإنتاج الذاتي للبيانات. بدلاً من الاعتماد فقط على مجموعات بيانات مكتوبة بشرياً أو مُجمّعة خارجياً، يمكن للنماذج استخدام اللعب الذاتي، والتحققات القائمة على القواعد، ونتائج التنفيذ، وحُكم النموذج، وفحوصات بشرية انتقائية لتوليد أمثلة جديدة وتصفيةها. ثم تتدفق الأمثلة المقبولة إلى ما قبل التدريب وأثناءه وما بعده.
القيد المهم هو التحقق: يكون التوليد الاصطناعي منخفض التكلفة مفيداً فقط عندما يستطيع النظام تحديد أمثلة صحيحة ومتنوعة وغير منحرفة. حلقة عملية هي توليد النموذج → تنفيذ المهمة → تحقق بالقواعد أو الأدوات → تصفية → إعادة تدريب.
كيف قد يُشيّد GLM 6.0 بيئات التدريب؟
الحلقة الثانية هي التشييد الذاتي للبيئات. يمكن للوكلاء جمع مهام العالم الحقيقي أو تحويلها، ومحاولة تلك المهام، وإنشاء مُحققين، والتحقق مما إذا كانت المهمة قابلة للحل فعلاً قبل أن تصبح مادة تدريبية. وهذا مهم خصوصاً بالنسبة للبرمجة وعمل الوكلاء، حيث تُوفر حالة الطرفية، ومخرجات الأدوات، وحالة المتصفح، ونتائج الاختبار، واسترداد الفشل إشرافاً أقوى من إجابات نصية فقط.
يتحول هدف التقييم من ما إذا كان الجواب يبدو مقنعاً إلى ما إذا كان الفعل ينجح، والنتيجة قابلة للتحقق بشكل مستقل، ويمكن للوكيل الاسترداد بعد الفشل.
كيف قد يُحسّن GLM 6.0 بنيته التحتية للتدريب؟
الحلقة الثالثة هي التحسين الذاتي للبنية التحتية. عملياً، يُفسَّر ذلك على أنه هندسة نظم بمساعدة الذكاء الاصطناعي: يقترح نموذج برمجة قوي تغييرات على المُشغّلات، والنوى، والجدولة، والتخزين المؤقت، أو شفرة التقديم، بينما تُحدد المعايير المؤتمتة والتحقق الخاضع لتحكم بشري أيّ تغييرات تُقبل.
الدورة الناتجة هي نموذج أفضل → مقترحات أنظمة أفضل → مكاسب كفاءة مُتحقق منها → تجارب تدريب أكثر → نموذج أفضل. تبقى المراجعة البشرية والمعايير القابلة لإعادة الإنتاج نقاط تحكم وليست إضافات اختيارية.
ماذا يخبرنا خط الأساس الحالي GLM 5.3 Flash عن GLM 6.0؟
لأنه لا توجد بطاقة نموذج عامة لـ GLM 6.0، فإن المقارنة الأكثر دفاعاً تفصل القدرات الحالية المقاسة لـ GLM عن اتجاه الجيل التالي. تصف Z.AI GLM-5.3-Flash بأنه نموذج MoE بإجمالي 320B ونشط 18B مُدرَّب على مُدَوَّنة متعددة الوسائط من 30T رمزاً. هذه مواصفات GLM-5.3-Flash، لا مواصفات GLM 6.0.
| بُعد المقارنة | واجهة GLM-5.3-Flash في CometAPI | الاتجاه المُفصح عنه لـ GLM 6.0 |
|---|---|---|
| حالة الإصدار | متاح | قيد التطوير؛ الاسم النهائي للمنتج غير مُثبَت بشكل مستقل بواسطة الإيداع المُشار إليه |
| المعلمات | إجمالي 320B / نشط 18B | غير مُفصح عنها |
| البنية الأساسية | MoE؛ انتباه متناثر هجين + انتباه خطي؛ mHC | غير مُفصح عنها على مستوى الكتلة |
| بيانات التدريب | مُدَوَّنة متعددة الوسائط من 30T رمزاً | بيانات مُنتَجة ذاتياً مُعتزم دخولها في حلقة متكررة |
| تعدد الوسائط | إدخال متعدد الوسائط أصيل | النمذجة متعددة الوسائط الموحدة اتجاه بحثي، لا مواصفة منشورة |
| مراحل التدريب | وصف مُعلن لوصفة تدريب مُمرحلة | تدريب ذاتي عبر ما قبل وأثناء وما بعد التدريب |
| بيئات التدريب | بيئات مصممة ومُقاسة من الباحثين | يساعد الوكلاء في تشييد البيئات والتحقق منها |
| التحقق | خطوط تقييم وتدريب قائمة | حُكم ذاتي أقوى، وتغذية راجعة من التنفيذ، وتحقق ذاتي |
| البنية التحتية | رُزمة استدلال مُحسَّنة | تُسهم النماذج في تحسين البنية التحتية |
| تفاصيل الـ API | مُعرّف نموذج منشور وواجهة مباشرة | غير مُفصح عنها |
تُبلغ نصوص إصدار Z.AI عن انخفاض يقارب 3.0× في حوسبة الانتباه و4.4× في حجم ذاكرة KV لـ GLM-5.3-Flash مقارنةً بـ GLM-5.3 API. تُوسِم الرسومية الرسمية المصاحبة مقارنة المليون رمز بـ 3.40× لحوسبة الانتباه و3.80×故 لحجم ذاكرة KV لكل طبقة. وبما أن الأصلين الرسميين يستخدمان أرقاماً مختلفة، ينبغي الإبلاغ عنهما بسياقاتهما الخاصة بدلاً من دمجهما في قياس واحد.
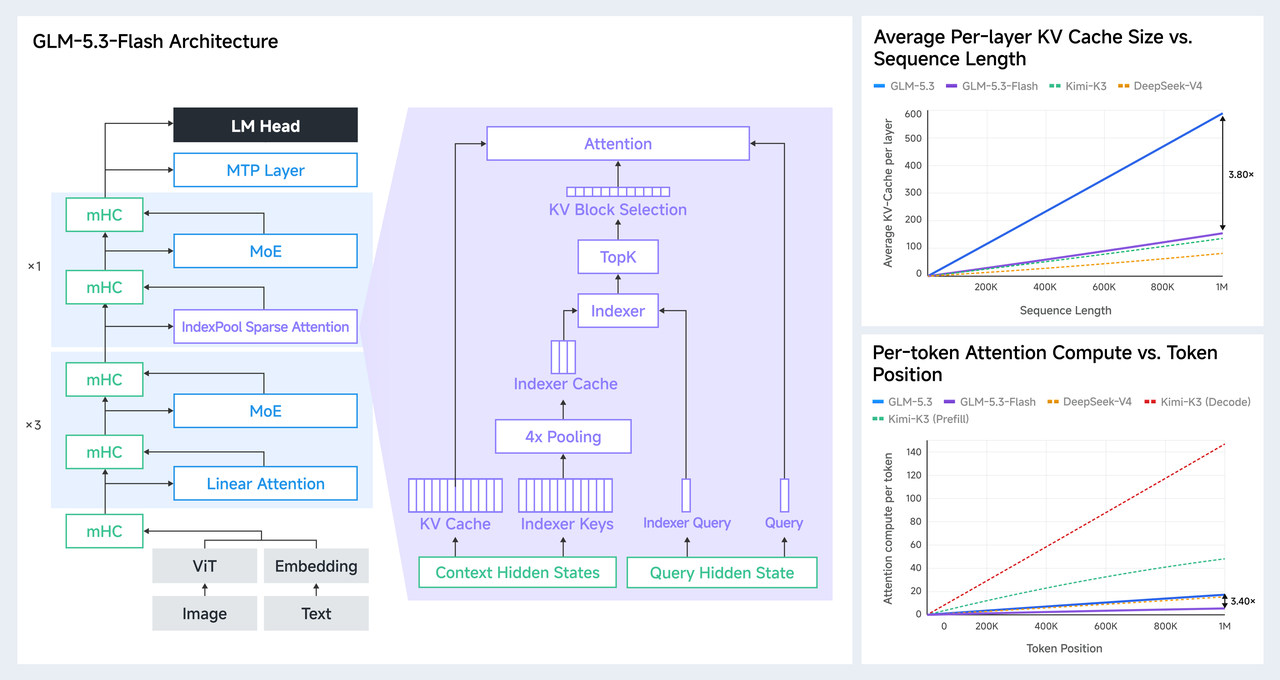
المخطط الرسمي لبنية GLM-5.3-Flash ومقارنة الكفاءة المنشور من Z.AI
أي نتائج معيارية تُشكّل خط أساس GLM 6.0؟
لا توجد جدول معايير مُتحقق منه علناً لـ GLM 6.0. الجيل الحالي من GLM مفيد فقط كخط أساس لأن التقييمات أدناه تقيس التخطيط، والبرمجة، واستخدام الأدوات، والأتمتة، والتنفيذ بعيد الأفق—القدرات الأكثر صلة باتجاه التدريب الذاتي الكامل المُفصح عنه.
| تقييم Z.AI الرسمي | GLM-5.3-Flash | GLM-5.2 | الفارق المُعلن |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
المقارنة متعددة الأبعاد وليست تصنيفاً بنقطة واحدة. يُظهر GLM-5.3-Flash أكبر مكاسبه المُعلنة على AutomationBench (+22.6) وToolathlon Verified (+18.5) وDeepSWE (+17.2)، بينما فرق HLE-with-Tools هو +0.6 فقط. يوحي هذا النمط بمكاسب أقوى في مهام الوكلاء كثيفة التنفيذ مقارنة بكل أشكال الاستدلال المدعوم بالأدوات. لا تتنبأ هذه النتائج بدرجات GLM 6.0.
لماذا تهم هذه المعايير
تكون المعايير مُهمة هنا فقط إذا كشفت عن القدرات التي يُفترض أن يُحسّنها التدريب الذاتي الكامل. تُشكّل الفئات الست في الجدول المُضمَّن تدرجاً من إنتاج عمل صحيح إلى الحفاظ على سلوك فعّال في بيئات حقيقية. تختبر البرمجة ما إذا كان النموذج قادراً على تنفيذ مهمة معقدة؛ ويختبر استخدام الأدوات ما إذا كان يمكنه تحويل الفعل إلى تغذية راجعة واختيار الخطوة التالية؛ وتختبر الأتمتة ما إذا كان يمكنه الحفاظ على تلك الحلقة عبر سير عمل طويل.
| فئة المعيار | لماذا تهم لـ GLM-6.0 |
|---|---|
| البرمجة | تختبر تنفيذ المهام المعقدة |
| استخدام الأدوات | تختبر حلقة الفعل إلى التغذية الراجعة |
| الأتمتة | تختبر تنفيذ سير العمل بعيد الأفق |
| HLE | تختبر حل مشكلات معقدة بمستوى خبير |
| GDPval | تختبر جودة العمل المهني |
| متعدد الوسائط | يختبر استخدام التغذية البصرية |
ترفع HLE صعوبة المشكلات قيد الحل، ويسأل GDPval ما إذا كان الناتج مفيداً في العمل المهني، ويختبر التقييم متعدد الوسائط ما إذا كانت الملاحظات البصرية يمكن أن توجه الإجراءات اللاحقة. عند قراءتها معاً، تنتقل الفئات الست من الكفاءة المعزولة إلى إتمام المهام طرفاً لطرف: توليد خطة، الفعل، ملاحظة التغذية الراجعة، تصحيح الأخطاء، والمتابعة حتى تحقيق الهدف.
لذا سيكون أي نتيجة مستقبلية لـ GLM-6.0 ذات مغزى ليس لأنها تُنتج درجة إجمالية أعلى، بل لأن المكاسب عبر هذه الأبعاد ستُظهر أن الخبرة التدريبية المُولَّدة ذاتياً تنتقل إلى تنفيذ واقعي موثوق. الهدف النهائي للتدريب الذاتي الكامل ليس تحسين الدرجات الاختبارية، بل تحسين قدرة النموذج على إتمام المهام الواقعية.
لماذا قد يهم التدريب الذاتي الكامل لـ GLM 6.0؟
الوعد الحقيقي ليس أن GLM 6.0 سيقوم "بتدريب نفسه" ببساطة. التغيير الأكثر مغزى هو أن أجزاء أكبر من خط أنابيب التطوير قد تصبح مُولّدة ومُتحقَّقة آلياً. اليوم، لا يزال الباحثون يقومون بكثير من العمل حول النموذج: جمع البيانات، وتصميم المهام، وبناء المُقيِّمين، وتشييد البيئات، وتشخيص الإخفاقات، وضبط برمجيات الأنظمة. يدفع التدريب الذاتي الكامل بالنموذج إلى مزيد من تلك المراحل.
إذا نجح النهج، يُصبح متغير القياس المهم أقل ارتباطاً بعدد المعلمات التي يمكن إضافتها وأكثر بعدد دورات التعلم المفيدة والمُتحقق منها التي يمكن تنفيذها لكل وحدة حوسبة. هذا تفسير عملي للتحسين الذاتي التكراري بدلاً من النسخة الخيالية للتحوير الذاتي المستقل غير المقيد.
يجب تقييم الاستراتيجية المُفصح عنها على أنها نظام تغذية راجعة مُهندَس مع مُحققين، وبيئات قابلة لإعادة الإنتاج، ومعايير للبنية التحتية، وضوابط بشرية—not كدليل على تحسين ذاتي مستقل غير مقيد.
ما الذي قد يخطئ في التدريب الذاتي الكامل؟
يمكن لحلقة التدريب الذاتي أن تُضخّم الأخطاء بالكفاءة نفسها التي تُضخّم بها الخبرة المفيدة. تستحق أربعة أنماط فشل اهتماماً خاصاً:
- تضخيم الأخطاء: قد تصبح المسارات الاصطناعية الضعيفة بيانات تدريب مستقبلية، مما يسمح لأنماط مقنعة لكنها خاطئة بأن تعزز نفسها.
- اللعب بالمكافأة والمُقيِّم: إذا كان النظام ذاته يُنتج العمل ويحكم عليه، فقد يُحسّن فجوات المُتحقق بدلاً من نجاح المهمة الحقيقي.
- تضييق التوزيع: التعلم المتكرر من بيانات مولدة نموذجياً قد يقلل التنوع ويجعل الحالات الواقعية غير الشائعة أصعب معالجة.
- ضغط التكلفة والأمن والحوكمة: تشييد البيئات، والوصول إلى الأدوات، والتكرار المستمر يزيد الطلب الحوسبي ويوسّع سطح الهجوم.
لذا يحتاج تنفيذ موثوق لـ GLM-6.0 إلى مُحققين مستقلين، وأصل بيانات، وعَتبات قبول، واختبارات فرق حمراء، وتدقيقات بشرية، وقواعد إيقاف صريحة. يكون التصحيح الذاتي مفيداً فقط عندما تكون إشارة التصحيح أكثر موثوقية من السلوك الجاري تصحيحه.
متى قد تصبح واجهة GLM 6.0 متاحة؟
لم تنشر Z.AI تاريخ إصدار واجهة GLM 6.0، أو مُعرّف النموذج، أو نافذة السياق، أو الحد الأقصى للإخراج، أو سعر الرموز، أو التزام الأوزان المفتوحة، أو متطلبات النشر. أي قيمة محددة ستكون حالياً تخميناً.
يمكن للمطورين تقييم الاتجاه الحالي عبر GLM-5.3-Flash API في CometAPI لأحمال العمل متعددة الوسائط أصالة والموجهة للكفاءة، أو GLM-5.3 API في CometAPI للفرع الرئيسي الحالي، أو GLM-5.2 API في CometAPI كخط أساس مقارنة للجيل السابق.
الخلاصة
يهم GLM-6.0 باعتباره اختباراً لما إذا كانت Z.AI تستطيع تحويل التدريب الذاتي الكامل إلى نظام هندسي قابل للتكرار أكثر منه كمنتج مُعلن. تربط خارطة الطريق الخبرة المُولَّدة ذاتياً، والتدريب المُمرحَل، والتقييم الذاتي، والتصحيح، والتكرار المُتحكم به؛ وسيكون الدليل الحاسم ما إذا كانت تلك الآليات تُحسّن الموثوقية في سير عمل واقعية طويلة، مدعومة بالأدوات.
لا يزال ذلك الدليل غير مكتمل. لم تنشر Z.AI بطاقة نموذج GLM-6.0، أو تاريخ إصدار، أو مُعرّف API، أو تسعيراً، أو مجموعة معايير. حتى وجود تلك الوثائق، يبقى الاستنتاج المُدافع عنه ضيقاً: كشفت الشركة عن اتجاه تدريبي، لا ملف قدرات منتهٍ.
الهدف النهائي للتدريب الذاتي الكامل ليس تحسين الدرجات الاختبارية، بل تحسين قدرة النموذج على إتمام المهام الواقعية.