
الملخص
GPT-6 Astra يسجّل نتائج رئيسية استثنائية؛ تظهر أكبر المكاسب عندما يجب تحويل الاستدلال إلى إجراءات: تشغيل الطرفية، استخدام البرمجيات، الأتمتة، الاسترجاع في سياق طويل، سير العمل العلمي، والأمن السيبراني. في الاختبارات الأكاديمية المشبعة بالفعل، يكون التحسّن مقارنة بجيل OpenAI السابق أصغر بكثير غالبًا.
يجمع النموذج بين نافذة سياق بحجم 1,050,000 رمز ودعم واسع للأدوات. تشير معايير التنفيذ المنشورة من OpenAI إلى أن الترقية العملية أقوى في العمل طويل الأفق، لكن تصميم الحاضنة، وجهد الاستدلال، والكمون، وإمكانية الوصول إلى الأدوات تؤثر ماديًا على النتيجة.
أهم الخلاصات
- المكاسب الأوضح لدى Astra هي في التنفيذ القائم على الوكلاء، لا في كل أشكال الإجابة عن الأسئلة.
- تظهر نتائج Terminal-Bench وAutomationBench واستخدام الحاسوب وترحيل قواعد البيانات حركة أكبر بكثير من GPQA أو DeepSWE.
- يبرهن ARC-AGI-3 أن حالة النموذج وإدارة السياق وحاضنة التقييم يمكن أن تهيمن على الدرجة النهائية.
- لا تهم نافذة السياق الكبيرة إلا عندما يبقى المعلومات قابلة للاسترجاع قرب الحد؛ MRCR أكثر إفادة من السعة المعلَن عنها وحدها.
- لا تعني أسعار الرموز الأعلى تلقائيًا تكلفة مهمة أعلى إذا احتاج النموذج إلى رموز أقل أو دورات أقل أو محاولات إعادة أقل أو تصحيحات بشرية أقل.
- يجب أن تقارن قرارات الإنتاج معدل النجاح والوقت المنقضي والتكلفة الإجمالية وموثوقية الأدوات وعبء التصحيح معًا.
لمحة سريعة عن GPT-6 Astra
تحدّد OpenAI ما يصل إلى 128,000 رمز إخراج، وإدخال نص وصور، وإخراج نص، وجهد استدلال من منخفض حتى أقصى حد. تتيح هذه المواصفات سير عمل كبيرة متعددة الخطوات، لكنها لا تثبت أن النموذج سيسترجع الأدلة الصحيحة أو يُكمل المهمة بشكل موثوق.
| المواصفات الرسمية | GPT-6 Astra في CometAPI | الدلالة العملية |
|---|---|---|
| معرّف النموذج | gpt-6-astra | معرّف ثابت لتوجيه طلبات واجهة البرمجة |
| نافذة السياق | 1,050,000 رمز | يدعم المستودعات الكبيرة والأرشيفات وتواريخ الوكلاء |
| الحد الأقصى للإخراج | 128,000 رمز | يسمح بتقارير كبيرة وتصحيحات وأصول مُهيكلة |
| حدّ المعرفة | 30 أبريل 2026 | الحقائق الأحدث تتطلب أدوات أو مصادر مُزوّدة |
| الإدخال | نصوص وصور | يدعم المستندات ولقطات الشاشة والمخططات والأدلة المُختلطة |
| الإخراج | نص | يُنتج نثرًا وكودًا ونصوصًا مُهيكلة |
| جهد الاستدلال | منخفض، متوسط، عالٍ، عالٍ جدًا، أقصى | يُوازن بين الكمون والتكلفة مقابل بحثٍ أعمق |
| قدرات الوكيل | استدعاء دوال، مخرجات مُهيكلة، استخدام الحاسوب، بحث ويب/ملفات، صدفة مُستضافة، Apply Patch، MCP | يمكّن سير عمل شاملة من طرف إلى طرف بدلًا من إجابات معزولة |
| سعر الإدخال القياسي لدى OpenAI | $10 لكل مليون رمز | حجم الإدخال وإعادة استخدام الذاكرة المخبأة يؤثران على التكلفة |
| الإدخال المخزّن لدى OpenAI | $1 لكل مليون رمز | يُطبّق عندما يُعاد استخدام بادئة المِحفظة من الذاكرة |
| كتابة الذاكرة لدى OpenAI | $12.50 لكل مليون رمز | تُحتسب بنسبة 1.25× من معدل الإدخال غير المخزّن |
| سعر الإخراج القياسي لدى OpenAI | $50 لكل مليون رمز | يمكن أن تهيمن المخرجات الإسهاب على تكلفة المهمة |
| الطلبات فوق 272K رمز إدخال | معدلات الإدخال والمخبأ ×2؛ معدل الإخراج ×1.5 | تُطبَّق المعدلات الأعلى على الطلب كاملًا |
حد السياق يقيس السعة، لا الاسترجاع القابل للاستخدام. قائمة الأدوات تقيس التوفّر، لا التنفيذ الناجح. تُعدّ المعايير ضرورية لاختبار ما إذا كانت هذه المواصفات تُترجم إلى عمل مُكتمل.
ماذا تُظهر نتائج المقارنة الخاصة بـ GPT-6 Astra؟
تُظهر المحفظة نمطًا غير متساوٍ. بالكاد يتجاوز Astra Sol في بعض اختبارات الأكاديميا واستدلال البرمجيات، لكنه يُحقق مكاسب مزدوجة الأرقام في عمل الطرفية والأتمتة وترحيل قواعد البيانات والتفاعل البصري والاسترجاع طويل السياق والرياضيات المتقدّمة.
| معيار منشور | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra مقابل Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 نقطة |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 نقطة |
| مهام ترحيل قواعد البيانات | 63.9% | 42.7% | 57.8% | +21.2 نقطة |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 نقطة |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 نقطة |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 نقطة |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 نقطة |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 نقطة |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 نقطة |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 نقطة |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 نقطة |
تبرز ثلاثة عناقيد. أولًا، الفجوتان عند 1.4 نقطة في DeepSWE وGPQA تدلّان على حركة إضافية محدودة في المهام التي تؤدّي فيها النماذج القوية أداءً جيدًا بالفعل. ثانيًا، المكاسب فوق 20 نقطة في Terminal-Bench وAutomationBench وترحيل قواعد البيانات واسترجاع مليون رمز تُظهر تغييرًا أكبر بكثير في التنفيذ. ثالثًا، يُعد ARC-AGI-3 حالة شاذة تعتمد قراءتها على الحاضنة.
نتائج اختبار مستقل
تفيد Artificial Analysis بأن Astra وSol يبلغان نحو 61 على مؤشر الذكاء الخاص به، بينما تُظهر مكسبًا أوضح على مؤشر الوكيل البرمجي الخاص به. هذا يعزز بشكل مستقل النمط في بيانات OpenAI: يتركّز أكبر تحسّن في التنفيذ القائم على الوكلاء.
عند الجهد الأقصى في حاضنة Codex، يُقال إن Astra يستخدم حوالي ثلث عدد الرموز مقارنة بـ Sol على مؤشر الوكيل البرمجي. ينخفض استخدام الرموز في مؤشر الذكاء بنحو 10% فقط. وبما أن معدل الرمز لدى Astra أعلى، تُنشئ هاتان الكفاءتان اقتصاديات مختلفة.
| تقييم مستقل | النتيجة المرصودة | تفسير الإنتاج |
|---|---|---|
| مؤشر الذكاء | فصل بسيط عن Sol | قد لا يُبرّر الاستدلال العام علاوة سعر كبيرة |
| مؤشر الوكيل البرمجي | تحسّن وكالي واضح | يمكن لرموز أقل أن تُعوّض معدل الرمز الأعلى |
| AA-Omniscience | انخفاض معدل الهَلوسة من 92% إلى 51% عند الجهد الأقصى | الامتناع الأفضل قد يهم أنظمة البحث والاسترجاع |
| عمل معرفي طويل الأفق | تقدّم مُختلط عبر المهام | التقييم المحلي يبقى ضروريًا |
لا يُصدّق أي معيار مستقل على الحقائق أو السلامة الإنتاجية. ينبغي للفرق أن تُسجّل على نحو منفصل الإجابات الصحيحة، واللايقين المُبرّر، والادعاءات غير المدعومة، والإخفاقات في اتباع قيود المصادر.
لماذا تُناسب Astra العمل الوكالي طويل الأفق بشكل أفضل؟
يضيف GPT-6 Astra ثلاثة ضوابط مصمّمة للعمل الذي يتغيّر أثناء تشغيله. تعتمد موثوقية التشغيل الطويل أيضًا على نظام السياق بالكامل: تحدّد نافذة السياق السعة؛ يتحكّم الضغط في كيفية تكثيف المواد الأقدم؛ يحمل الاستدلال المُستدام حالة النموذج ذات الصلة؛ يُبقي الاسترجاع الأدلة السابقة قابلة للبحث؛ ويجب على التطبيق الحفاظ على مخرجات الأدوات المهمة ونتائج الاختبار والمحاولات الفاشلة ومتطلبات المستخدم. ينبغي اختبار هذه الآليات مع حاضنة الوكيل.
- استدعاء أدوات غير متزامن: يمكن لـ Astra متابعة الاستدلال المستقل أو استدعاء أدوات أخرى أثناء تنفيذ التطبيق لأداة طويلة التشغيل.
- التوجيه منتصف الدورة: يمكن للتطبيق إرسال تصحيح أو متطلب جديد عبر WebSocket دون تجاهل العمل المُنجز.
- تعديل الاستدلال أثناء المحادثة: يمكن لتحديث الإعدادات رفع أو خفض جهد الاستدلال مع الحفاظ على بادئة المِحفظة المُخبّأة.
أين تتحسّن GPT-6 Astra بالفعل
البرمجة الوكالية: عمل الطرفية هو الترقي الأكبر
يقيس Terminal-Bench 4.0 ما إذا كان الوكيل يستطيع العمل عبر مهام طرفية صعبة بدلًا من مجرد توليد إجابة كودية معزولة. يصل Astra إلى 57.9%، بزيادة 20.6 نقطة عن Sol وبزيادة 2.1 نقطة عن Fable. هذا تحسّن كبير من جيل إلى آخر لـ OpenAI، لكنه تفوّق أضيق على نظام وكالي حدودي آخر.
يروي DeepSWE قصة مختلفة: 74.1% لـ Astra و72.7% لـ Sol. تُحذّر الفجوة عند 1.4 نقطة من التعميم انطلاقًا من معيار برمجة واحد. يبدو أن Astra يكسب أكثر عندما تتطلّب البرمجة تفاعلًا مع البيئة، وتكرارًا، وحفظًا للحالة، والتحقّق.
تعزّز مهام ترحيل قواعد البيانات ذلك التفسير. النتيجة 63.9% تفوق Sol بـ 21.2 نقطة وFable بـ 6.1 نقطة. يجمع عمل الترحيل فهم الكود، واستخدام الأدوات، والتسلسل، والحكم التشغيلي—وهو نوع سير العمل المركّب حيث يمكن لتحسينات الاستدلال الصغيرة أن تتراكم إلى مكاسب إكمال أكبر بكثير.
بالنسبة للوكلاء البرمجيين، قيّموا النموذج والحاضنة معًا. تسهم تعليمات المستودع، وأدوات الطرفية، وسلوك إعادة المحاولة، والحفاظ على السياق، وتنفيذ الاختبار جميعًا في النتيجة المقاسة.
استخدام الحاسوب: معدل النجاح ووقت التشغيل كلاهما مهم
في Agents’ Last Exam، يُسجّل GPT-6 Astra نسبة 59.3%، مقارنةً بـ 53.6% لدى GPT-5.6 Sol: مكسب 5.7 نقطة. يُضيف هذا نتيجة أوسع لمهام الوكلاء إلى درجات OSWorld 2.0 وScreenSpot-Pro في نظرة المعايير أعلاه.
إلى جانب الدقة، تُضيف مقارنة وقت التشغيل في OSWorld بُعدًا عمليًا آخر: تُبلغ OpenAI بنحو 40 دقيقة لكل مهمة لـ Astra مقابل نحو 75 دقيقة لـ Sol، أي أقل بنحو 47% من الوقت المنقضي مع زيادة نجاح المهمة أيضًا.
يمكن لوكيل ينجح قليلًا أكثر وينهي المهمة أسرع بكثير أن يُقدّم تحسّنًا كبيرًا في الإنتاجية. ينبغي أن تُبلّغ اختبارات الشراء عن معدل النجاح والوقت المنقضي واستدعاءات الأدوات وإعادة المحاولات والتدخلات البشرية—لا الدقة وحدها.
الأتمتة والعمل الاحترافي
ترتفع AutomationBench من 18.1% إلى 41.4%، مكسب 23.3 نقطة. لا تزال الدرجة المطلقة بعيدة عن التشغيل الذاتي الموثوق، لكن تغيير ملف الإخفاق أكثر مغزى من حركة نقطة واحدة قرب التشبّع. على BenchCAD، يصل Astra إلى 95.9%، متفوّقًا على Sol بـ 12.6 نقطة وعلى Fable بـ 11.6 نقطة.
تدعم هذه النتائج ادعاءً محددًا: Astra أفضل في تحويل التعليمات إلى تسلسلات من إجراءات مُتحقَّقة. لا تُثبت مكاسب متساوية لكل سير عمل تجاري. قد يُدخل المسار الإنتاجي خطوات مصادقة وواجهات خاصة وسياسات غامضة أو تنسيقات بيانات غير موجودة في المعيار.
العلم
يُعد العلم أحد مكاسب القدرة الأوضح لدى Astra. في FrontierMath Tier 4 v2، يصل Astra إلى 97.6%، مقارنةً بـ 83.0% لدى Sol و87.8% لدى Fable. التفوّق بـ 14.6 نقطة على Sol كبير، رغم أن المعيار يُغطّي توزيع مهام مُنتقى لا سير العمل العلمي الكامل.
الأمن السيبراني
الأمن السيبراني مكسب رئيسي ثانٍ، مع رهانات أعلى من حركة عادية في قوائم الصدارة. على ExploitBench المُغطّي الفترة من يونيو حتى أغسطس 2026، يُسجّل Astra 39.0% مقابل 5.5% لدى Sol. تُبلغ OpenAI أن هذه المجموعة الأحدث تستهدف ثغرات من الأشهر الثلاثة السابقة لتقليل التعرّض التاريخي. في تقييم الأمن السيبراني لدى OpenAI، أظهر Astra القدرة على اكتشاف واستغلال ثغرتين صفريتي اليوم غير معروفتين سابقًا أثناء اختبار مُتحكَّم. تكمن أهمية النتيجة في أن التقييم صُمّم حول ثغرات مُعلنة حديثًا بدلًا من مشكلات أمنية معروفة منذ زمن، مما يُقلّل احتمال أن الأداء في المعيار كان ببساطة بسبب أمثلة محفوظة. أسهمت النتيجة في وصول Astra إلى عتبة القدرة الأمنية السيبرانية الحرِجة لدى OpenAI وبالتالي غيّرت الضوابط اللازمة للنشر. الدلالة ليست أن Astra يستطيع تنفيذ عمليات سيبرانية غير مقيّدة بشكل مستقل، بل أن مستوى قدرته يغيّر متطلبات ضوابط النشر. الأنظمة ذات قدرة أقوى على اكتشاف الثغرات واستغلالها تتطلب ضوابط وصول أشدّ، ورصدًا، وحاويات عزل، وآليات مراجعة بشرية.
المهام طويلة التشغيل: نافذة السياق ليست القصة كاملة
تصف نافذة السياق بحجم 1,050,000 رمز لدى Astra السعة، لا الاستمرارية. يعتمد الأداء طويل التشغيل أيضًا على الضغط، والحالة المُستدامة، والسياق السابق القابل للبحث، وحالة الاستدلال المُحتفَظ بها، والحفاظ على مخرجات الأدوات. في MRCR v2، يُسجّل Astra 100.0% عند 256K–512K و96.3% عند 512K–1M، بينما يُسجّل Sol 91.5% و73.8%. تُظهر الفجوة عند 22.5 نقطة في المدى الأطول أن الاسترجاع القابل للاستخدام قرب الحد يهم أكثر من السعة المعلَن عنها وحدها.
يبقى MRCR اختبار استرجاع اصطناعيًا، لذا ينبغي للتقييم الإنتاجي أن يحفظ الأدلة التي غالبًا ما تفقدها الملخصات: لماذا فشل الإصلاح السابق، سلوك مُكوّن محدّد، نتائج الاختبار، المتطلبات التاريخية، والتفاصيل المدفونة في مخرجات الأدوات. يجب أيضًا اختبار المستودعات وأرشيفات البحث بأسماء مكرّرة، ومراجع متقاطعة، وسياسات قديمة، ومصادر متناقضة، ومقاطع مُلهية طويلة. هذا يفصل السعة الخام للسياق عن سلوك الحفاظ على السياق والاسترجاع الذي يحتاجه الوكيل طويل الأفق فعليًا.
الحفاظ على السياق: لماذا تختلف Astra عن الأنظمة التقليدية ذات السياق الطويل
تتبع سير العمل التقليدية للسياق الطويل عادةً نمطًا:
context → compaction → summary → continue
يُقلّل هذا النهج استخدام الرموز، لكنه يُدخل مخاطرة حرجة: قد تختفي معلومات وسيطة مهمة أثناء التلخيص.
غالبًا ما تكون المعلومات المفقودة ليست الإجابة النهائية ذاتها، بل التفاصيل التشغيلية المطلوبة للقرارات المستقبلية:
- لماذا فشل إصلاح سابق؛
- أي مُكوّن أظهر سلوكًا غير طبيعي؛
- أي نتيجة اختبار غيّرت اتجاه التنفيذ؛
- أي متطلبٍ للمستخدم أُضيف لاحقًا؛
- أي مخرجات أداة احتوت على أدلة مهمة.
يعالج GPT-6 Astra هذا القيد من خلال الجمع بين آليات الحفاظ على السياق والاسترجاع داخل سير عمل الوكلاء طويلة التشغيل.
بدلًا من الاعتماد فقط على الملخصات المضغوطة، يمكن للنظام الحفاظ على ملاحظات مهمة، واسترجاع المعلومات السابقة عند الحاجة، والحفاظ على الاستمرارية بين تفاعلات أدوات متعددة.
بالنسبة للوكلاء البرمجيين مثل Codex، يعني هذا أن مهمة تصحيح أخطاء طويلة يمكنها الاحتفاظ بـ:
- تجارب سابقة فاشلة؛
- تغييرات المستودع؛
- مخرجات الاختبار؛
- القرارات المعمارية؛
- القضايا غير المحسومة.
لذلك، فإن قيمة نافذة سياق 1M رمز لدى Astra ليست فقط كمية المعلومات التي يمكن أن تستقبلها، بل ما إذا كان النظام يستطيع الحفاظ على المعلومات الصحيحة واستعادتها بعد ساعات من التفاعل.
الاستدلال والتفسير
ARC-AGI-3: الحاضنة جزء من النتيجة
يُقدّم ARC-AGI-3 البرهان الأوضح على أن معيارًا حدوديًا يمكن أن يقيس نظامًا بدلًا من نموذجٍ معزول. يُبلغ ARC Prize عن 62.7% مع الحاضنة القياسية عند الجهد الأقصى و99.9% مع موائم المزوّد عند الجهد العالي.
| تقييم ARC Prize | الحاضنة القياسية | موائم المزوّد | مكسب الموائم |
|---|---|---|---|
| أقصى | 62.7% | 98.6% | +35.9 نقطة |
| عالٍ جدًا | 59.3% | 98.4% | +39.1 نقطة |
| عالٍ | 54.8% | 99.9% | +45.1 نقطة |
| متوسط | 38.6% | 98.4% | +59.8 نقطة |
| منخفض | 17.5% | 98.0% | +80.5 نقطة |
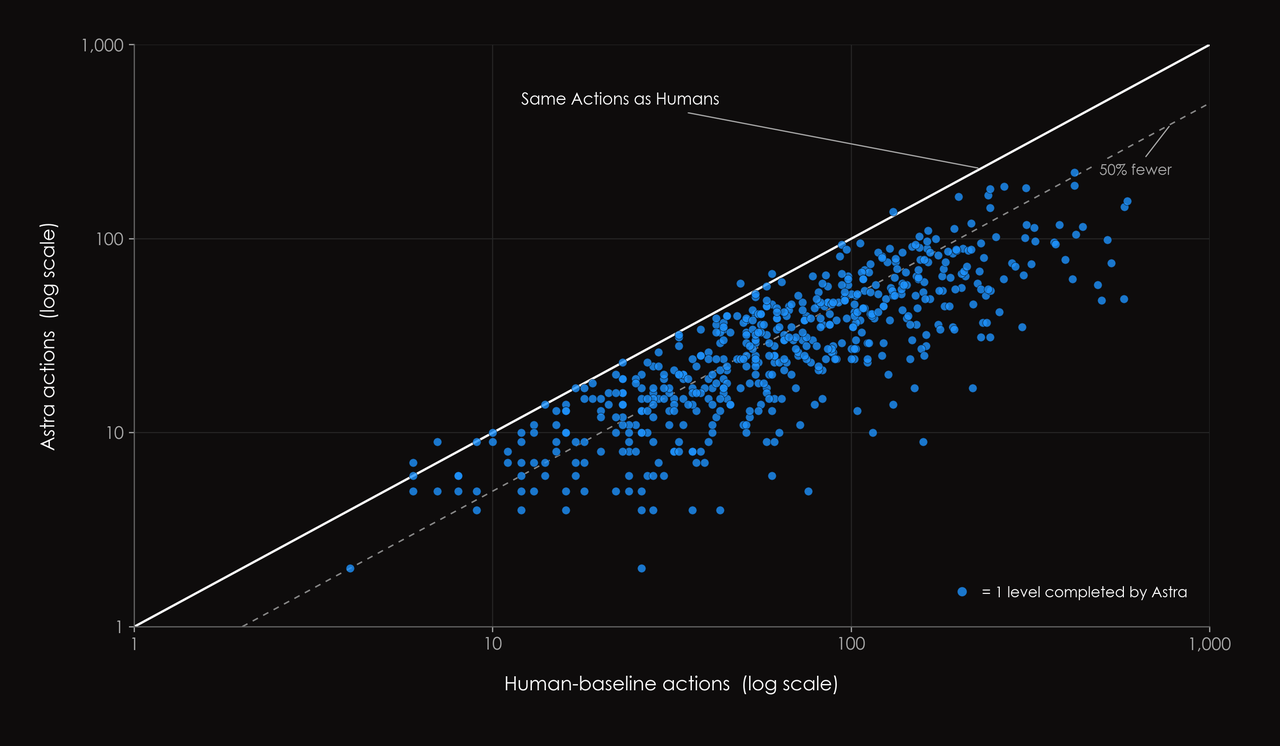
مقارنة ARC Prize لكفاءة إجراءات Astra عبر حاضنات التقييم
تتطلب سياسة الحاضنة المحايدة للمزوّد من النموذج الحفاظ على معلومات مهمة في حالة مرئية. يحتفظ موائم المزوّد بحالة استدلال إضافية ويستخدم إدارة سياق خاصة بالمزوّد. عبر أزواج التفكير-اللعبة المشتركة المحلولة، يُبلغ ARC Prize عن تنفيذ أسرع بـ 3.66× واستخدام رموز أقل بنسبة 49% مع الموائم.
تُقيس نتيجة 99.9% نظامًا محدّدًا يجمع نموذجًا-مزوّدًا-موائمًا، ولا ينبغي التعامل معها كمقياس مستقل عن الحاضنة لذكاء النموذج الخام. بنية السياق جزء من النظام المُقاس.
جهد الاستدلال لا يتدرّج خطيًا
يُظهر جدول ARC أيضًا أن الجهد الأقصى لا يُنتج دائمًا الدرجة الأعلى. يصل الجهد العالي إلى 99.9% مع موائم المزوّد، بينما يصل الأقصى إلى 98.6%. في الحاضنة القياسية، يُؤدّي الأقصى أفضل أداء.
تلاحظ OpenAI أن أرقام جدول الإطلاق تستخدم عمومًا أفضل إعداد استدلال مُلاحَظ. يُقدّر هذا النهج سقف الأداء، لكنه لا يُحدّد أفضل تهيئة إنتاجية. ينبغي للفرق اختبار عدة مستويات جهد وحساب الجودة الحدّية المكتسبة مقابل كل ثانية ودولار إضافيين.
الرياضيات والاستدلال الأكاديمي
يرتفع FrontierMath Tier 4 v2 من 83.0% إلى 97.6%، مكسب 14.6 نقطة. هذا تحسّن معياري كبير، لكنه ليس دليلًا على أن رياضيات الحدود حُلّت. يُغطّي التقييم توزيع مهام مُنتقى ولا يقيس كل مرحلة من البحث الرياضي، بما في ذلك اختيار المسائل والتحقق الرسمي من البرهان وتطوير البرامج طويلة الأمد أو المراجعة النظيرة الخصامية.
يُقدّم GPQA Diamond النمط المعاكس: 96.0% لـ Astra، 94.6% لـ Sol، 93.7% لـ Fable، و95.3% لـ Gemini 3.8 Flash. تتكتّل النماذج بالقرب من السقف. الإبلاغ عن الفارق بين Astra–Sol عند 1.4 نقطة دقيق، لكن وصفه بأنه ثورة ذكاء عامة سيكون بالغًا في التقدير.
قدرة حرِجة + ضوابط حماية
| تقييم الأمن السيبراني | Astra | Sol | المكسب المطلق |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 نقطة |
| ExploitGym | 42.4% | 30.3% | +12.1 نقطة |
| ExploitBench، يونيو–أغسطس 2026 | 39.0% | 5.5% | +33.5 نقطة |
| SRE-Bench | 88.0% | 55.9% | +32.1 نقطة |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 نقطة |
أنشأت OpenAI ExploitBench (يونيو–أغسطس 2026) من ثغرات مُعلنة خلال الأشهر الثلاثة السابقة، مما يُقلّل احتمال أن التعرّض التاريخي للثغرات رفع النتيجة. يُسجّل Astra 39.0% على هذه المجموعة مقابل 5.5% لدى Sol، وتُبلغ OpenAI أن Astra وجد واستغلّ ثغرتين صفريتي اليوم غير معروفتين سابقًا. أسهمت هذه النتائج في أن يصبح Astra أول نموذج مُنتشر على نطاق واسع لدى OpenAI يصل إلى عتبة القدرة الأمنية السيبرانية الحرِجة، وهو ما أثّر مباشرة على الضوابط وسياسة الوصول.
كيف نقرأ الدرجات قرب التشبّع
تتطلب الدرجات فوق 90% لغة أكثر حذرًا من النتائج متوسطة النطاق. الانتقال من 50% إلى 60% يُحلّ عشر مهام إضافية لكل مئة. الانتقال من 95% إلى 96% يُحلّ مهمة واحدة إضافية لكل مئة فقط، رغم أنه يُقلّل عدد الأخطاء المتبقية من خمسة إلى أربعة—خفض بنسبة 20% في الأخطاء. كلا الوصفين صحيحان رياضيًا، لكنهما يدعمان عناوين مختلفة للغاية.
ينطبق التحذير المعاكس على المعايير منخفضة الدرجات. يبقى الارتفاع من 18.1% إلى 41.4% بعيدًا عن التشغيل الذاتي الموثوق، لكنه يُضاعف عدد الحالات الناجحة وأكثر ويمكن أن يُحوّل سير عمل مُشرف. تُحدّد الدرجة المطلقة ما إذا كان النظام جاهزًا؛ تُشير حجم التحسّن إلى مدى سرعة تغيّر القدرة. تحتاج قرارات الإنتاج إلى كلاهما.
مقارنة متعددة الأبعاد
| البعد | Astra | Sol | Fable | إشارة القرار |
|---|---|---|---|---|
| الاستدلال الأكاديمي العام | ممتاز؛ غالبًا قرب التشبّع | قريب خلفه | منافس | فجوات صغيرة نادرًا ما تحسم النشر وحدها |
| تنفيذ الطرفية | من الطراز الأول | فجوة جيلية كبيرة | منافس قريب | اختبر حاضنة البرمجة كاملة |
| استخدام الحاسوب | نجاح أعلى ووقت تشغيل أقل | أبطأ وأقل دقة | بيانات غير كافية للمقارنة في جدول الإطلاق | قِس النجاح لكل ساعة |
| الاسترجاع طويل السياق | قوي قرب 1M رمز | تدهور مادي قرب الحد | بيانات غير كافية قابلة للمقارنة مباشرةً | استخدم اختبارات استرجاع مُشكّلة إنتاجيًا |
| التحكم في الاستدلال | منخفض حتى أقصى | مغلف جهد مختلف | نهج تفكير تكيّفي | عدّل التهيئة لا اسم النموذج فقط |
| القدرة السيبرانية | طبقة مخاطر نوعية أعلى | نتائج منشورة أقل | غير مُقارن هنا | الضوابط وسياسة الوصول مهمة |
| اقتصاديات الرموز | معدل أعلى؛ أحيانًا رموز أقل | معدل أقل | يعتمد على عبء العمل | قارن التكلفة لكل مهمة ناجحة |
تعتمد النتيجة على عبء العمل. يكون Astra الأكثر إقناعًا عندما تتطلب المهمة تفاعلًا مستدامًا مع الأدوات والبيئات، والتعافي بعد الفشل، أو الاسترجاع الموثوق عبر سياقات كبيرة جدًا. قد يبقى Sol أكثر اقتصادية للعمل المحدود بسياق معتدل وتكرار محدود. يُعد Fable منافسًا قريبًا في عمل الطرفية ويتفوّق في بعض تقييمات الأكاديميا الخارجية، لذا يكون معيار على مستوى التطبيق أكثر فائدة من خلاصة على مستوى المزوّد.
من ينبغي أن يستخدم GPT-6 Astra؟
| حالة الاستخدام | التوصية |
|---|---|
| تصنيف بسيط | ليس بالضرورة يستحق استخدام Astra |
| تلخيص بسيط | ليس بالضرورة يستحق استخدام Astra |
| RAG قياسي | قيّم التكلفة مقابل الأداء أولًا |
| تركيب وتحليل مستندات طويلة | يستحق اختبار Astra |
| البرمجة الوكالية | يُوصى بشدة باختباره |
| استخدام الحاسوب | يُوصى بشدة باختباره |
| الأتمتة متعددة الخطوات | يُوصى بشدة باختباره |
| بحث معقّد | يستحق الاختبار |
| الحوسبة العلمية / برمجيات متخصصة | يستحق الاختبار |
| الأمن السيبراني | قدرات قوية، لكنها تتطلب ضوابط سلامة مناسبة |
| مهام عالية الإنتاجية وبسيطة | قد تكون النماذج الأقل تكلفة أكثر فعالية من حيث التكلفة |
هل تبرر مكاسب أداء GPT-6 Astra السعر الأعلى؟
يُعد GPT-6 Astra أغلى بكثير من GPT-5.6 Sol، لكن تحسّن المعايير ليس موزّعًا بالتساوي عبر أعباء العمل. لذلك لا يمكن الإجابة عن سؤال التسعير بمقارنة معدلات الرموز وحدها.
| السيناريو | مكسب الأداء | تبرير التكلفة |
|---|---|---|
| سؤال وجواب بسيط | تحسّن صغير | عادةً لا يستحق العلاوة |
| وكيل برمجي | تحسّن كبير | يمكن تبرير العلاوة |
| تحليل سياق طويل | تحسّن كبير | يعتمد على احتياجات الاسترجاع |
| أتمتة الحاسوب | تحسّن قوي | غالبًا يستحق الاختبار |
| الاستدلال العام | تحسّن محدود | قارن التكلفة بعناية |
عند المعدلات القياسية لدى OpenAI، تبلغ تكلفة إدخال GPT-6 Astra $10 لكل مليون رمز، والإدخال المخزّن $1 لكل مليون رمز، وكتابة الذاكرة $12.50 لكل مليون رمز، وإخراج $50 لكل مليون رمز. يبلغ الإدخال والإخراج القياسيان 2.5× من معدلات $4 و$20 لدى GPT-5.6 Sol. عندما يتجاوز طلب 272K رمز إدخال، يتضاعف معدل إدخال ومخبأ Astra ويرتفع معدل الإخراج بـ 1.5× للطلب كاملًا.
يتّسق سعر العلاوة بوضوح أكبر مع العمل الوكالي. يكسب Astra أكثر من 20 نقطة في Terminal-Bench وAutomationBench وترحيل قواعد البيانات وMRCR في النطاق الأطول؛ تُبلغ الاختبارات المستقلة أيضًا عن نحو ثلث استخدام الرموز لدى Sol على مؤشر الوكيل البرمجي. يكون التطابق أضعف في الاستدلال العام، حيث يكاد يتعادل مؤشر الذكاء ويهبط استخدام الرموز بنحو 10% فقط. ينبغي أن تُقارن قرار الشراء التكلفة لكل مهمة ناجحة، بما يشمل الإخراج ونشاط الذاكرة والأدوات والوقت المنقضي وإعادة المحاولات والإخفاقات والتصحيح البشري.
التكلفة لكل مهمة ناجحة
التكلفة لكل مهمة ناجحة = (تكلفة الإدخال + تكلفة الإخراج + تكلفة الأدوات + تكلفة إعادة المحاولة + تكلفة المراجعة البشرية) / المهام الناجحة
التكلفة المتوقعة للأعمال
التكلفة المتوقعة للأعمال = تكلفة واجهة البرمجة + تكلفة الأدوات + تكلفة إعادة المحاولات + تكلفة المراجعة البشرية + تكلفة الإخفاق
ينبغي أن يكون مقياس القرار هو التكلفة الإجمالية مقسومة على المهام الناجحة، مُقيمةً عند عتبة جودة مقبولة—لا سعر الملصق لكل مليون رمز.
كيف ينبغي للمطورين معايرة Astra
ينبغي أن تُحدّد قوائم الصدارة العامة ما يستحق الاختبار، لا أن تتّخذ قرار النشر النهائي. ابنوا مجموعة مهام ممثلة بحالات روتينية، حالات صعبة، حالات سياق مفقود، إخفاقات أدوات، وتعليمات خصامية. استخدموا نفس مِحفظة الإنتاج والأذونات والملفات المصدرية وميزانية الوقت ومعايير الإكمال لكل نموذج.
| بُعد التقييم | القياس | لماذا يهم |
|---|---|---|
| نجاح المهمة | استيفاء معايير القبول | يمنع الأجوبة المُقنعة لكنها غير مكتملة من احتسابها كنجاح |
| الموثوقية | توزيع النجاح عبر تشغيلات مُكرّرة | يكشف الانتصارات غير المستقرة لمرة واحدة |
| تنفيذ الأدوات | إجراءات ناجحة مُتحقّقة | يفصل استدعاءات الأدوات عن النتائج الصحيحة |
| الحقائق | ادعاءات واقعية مدعومة | يقيس جودة الأدلة والامتناع |
| الكمون | زمن الإكمال الوسيط وطرفي | يلتقط الإنتاجية التشغيلية |
| التكلفة | التكلفة الإجمالية لكل مهمة ناجحة | تشمل إعادة المحاولات والمحاولات الفاشلة |
| الجهد البشري | دقائق التصحيحات والمراجعة | كثيرًا ما يهيمن على تكلفة النشر الفعلية |
| قابلية التوجيه | التعافي بعد تغيّر المتطلبات | يختبر سلوك الوكيل طويل التشغيل |
تستخدم واجهة Astra في CometAPI معرّف النموذج gpt-6-astra. تجعل واجهة برمجة متعددة النماذج تشغيل نفس التقييم عبر Astra وSol وFable وGemini عمليًا دون إعادة تصميم المعيار حول مخطط عناوين مزوّد واحد. وجّهوا المهام الوكالية المُتطلبة إلى النموذج الذي يستحق علاوته، واستخدموا نماذج أقل تكلفة حيث يختفي التفوق المقاس.
الخلاصة
ورقة معايير Astra مُبهرة، لكن الدرجات الأكثر روعة ليست تلقائيًا الأكثر فائدة. يُظهر ARC-AGI-3 إمكانية حاضنة وكيل خاصة بالمزوّد؛ تُظهر درجة الحاضنة القياسية مدى مساهمة البنية التحتية بقوة. يُظهر GPQA ومؤشر الذكاء المستقل أن مكاسب الاستدلال العادي يمكن أن تكون متواضعة. يروي عمل الطرفية والأتمتة واستخدام الحاسوب والاسترجاع طويل السياق وسير العمل العلمي والأمن السيبراني القصة الأهم.
الإصدار أقل عن روبوت محادثة يصبح أكثر ذكاءً بنسبة متناسبة في كل سؤال وأكثر عن ذكاء حدودي يصبح أفضل في إكمال العمل. يعتمد ما إذا كانت هذه الترقية تستحق الدفع عليها على تهيئة النظام بالكامل واقتصاديات المهام الإنتاجية الناجحة.