
الخلاصة تُظهر المعايير المسربة واختبارات Arena.ai السرّية في منتصف سبتمبر 2026 أن نموذج Google غير المُعلن Gemini 4 Pro يتصدر الجبهة الجديدة، متفوقًا على GPT-6 Astra وClaude Fable 5.1 عبر هندسة البرمجيات، المهام الوكيليّة، أعمال المعرفة، الاستدلال، ومعايير متعددة الوسائط.
أبرز النقاط
- Gemini 4 Pro يتصدر التقييمات المسربة على DeepSWE v1.1 (88.7%) وGDPval-AA v2 (تصنيف Elo عند 2064) وTerminal-bench 2.1 (95.3%) وOSWorld-2.0 (86.8%) والعديد من مجموعات المهام الوكيليّة/الاستدلال الأخرى.
- يقلّ سعره المعلن عن GPT-6 Astra ($12/$60) وClaude Fable 5.1 ($10/$50) بينما يضاهي أو يتجاوز نوافذ السياق من فئة 1M الخاصة بهما.
- أسفرت الاختبارات المتخفية على Arena.ai تحت أسماء نائبة (مثل gemini-3.8-flash) عن عروض مبهرة في SVG وThree.js وبرمجة وكيليّة.
- تنتشر شائعات حول RSI (التحسّن الذاتي التكراري) لكنها تفتقر إلى أدلة عامة على تحسين ذاتي مغلق الحلقة لنموذج Gemini 4 نفسه.
- أكدت Google استثمارًا كثيفًا في نموذج Gemini 4 أساسي أكبر؛ توقيت الإطلاق العام لا يزال غير رسمي.
- منصات مثل CometAPI تجمع بالفعل Gemini وGPT-6 Astra وClaude Fable/Opus ومئات النماذج الأخرى خلف نقطة نهاية متوافقة مع OpenAI بأسعار تنافسية—وهي مثالية لقياس الجبهة الجديدة حال طرحها.
ماذا نعرف عن Gemini 4؟ (تسريبات، مصادر، وسياق موثّق)
حتى 20 سبتمبر 2026، لم يحصل Gemini 4 Pro على إعلان رسمي من Google أو بطاقة نموذج أو نقطة نهاية API عامة. كل ما يتجاوز تصريحات Google السابقة حول الاستثمار في "نموذج أساسي أكبر لـ Gemini 4" (أرباح يوليو 2026) يأتي من تسريبات المجتمع واختبارات Arena.ai العمياء وجداول معايير متداولة.
تشمل المصادر والمزاعم الرئيسية ما يلي:
- أشار المسرِّب Pankaj Kumar ومنشورات لاحقة (حوالي أوائل إلى منتصف سبتمبر) إلى نقطة تحقق داخلية من نسخة Pro مع توقع إطلاق عام في أكتوبر وربما نسخة Flash-Lite في وقت أبكر.
- أفاد مطورون عديدون بسحب نموذج عالي القدرات موسومًا باسم "gemini-3.8-flash" (أو أسماء نائبة مشابهة) على Arena.ai. شملت المخرجات توليد SVG معقد (مثل طائر البجع على دراجة، وفراشات ميكانيكية في Three.js) وتوليد JSON طويل غير متكرر وسلوك وكيلي قوي. ادعى بعض المستخدمين تفاصيل خلفية مثل سياق بملايين الرموز، سقف مخرجات 256k، ذاكرة عبر الجلسات، وقدرات أصلية على الأدوات/الإنترنت.
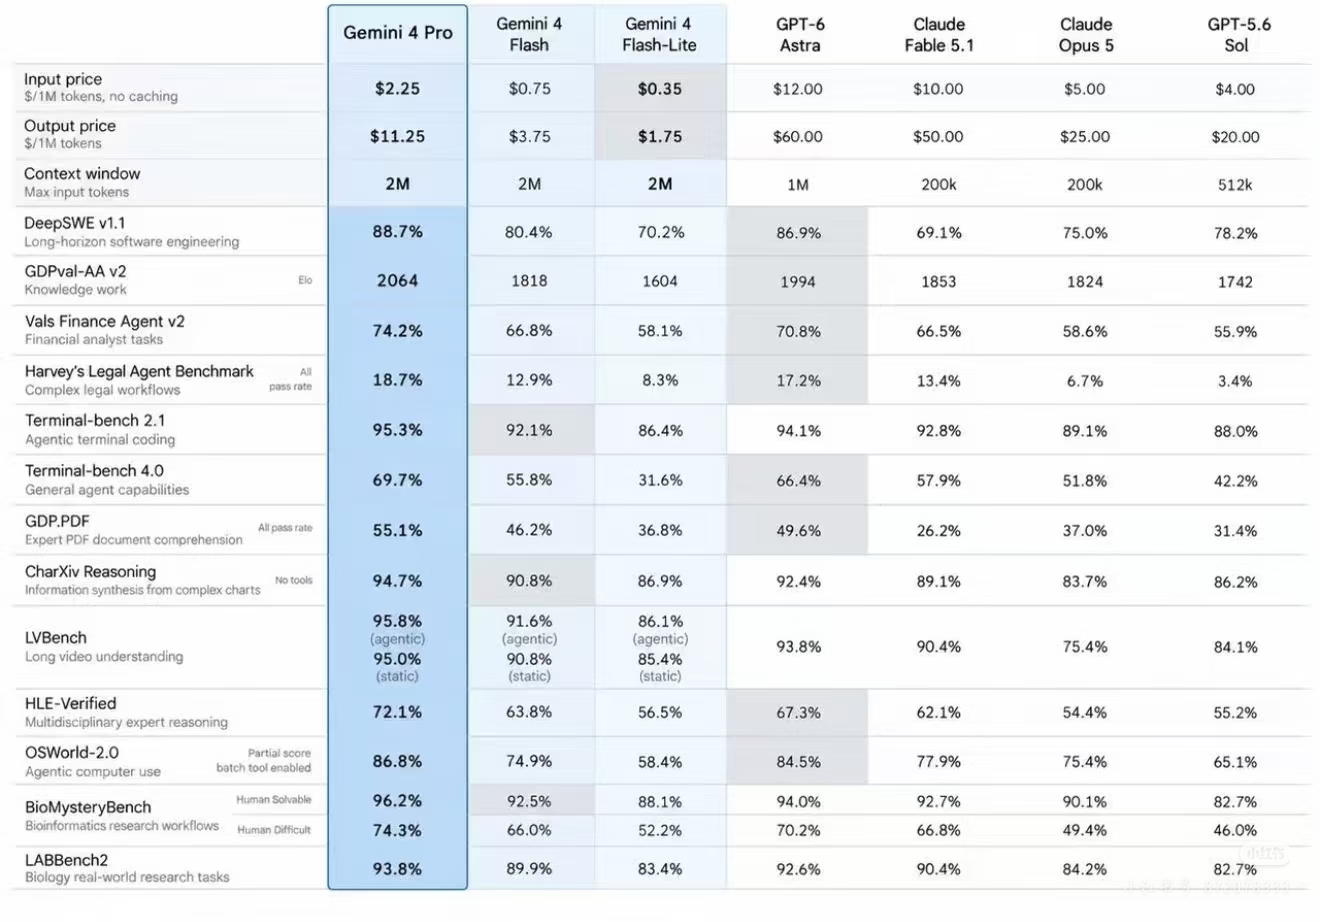
- يسرد جدول مقارنة متداول على نطاق واسع Gemini 4 Pro مقابل Gemini 4 Flash وGemini 4 Flash-Lite وGPT-6 Astra وClaude Fable 5.1 وClaude Opus 5 وGPT-5.6 Sol.
- لم تؤكد Google اختبارات Arena أو الجدول. يُظهر النمط التاريخي أن الشركة غالبًا ما تجري تقييمات سرية على منصات عامة قبل أسابيع من الإطلاقات الرسمية.
نافذة السياق
يُظهر الجدول المسرب حدًا أقصى يبلغ 2M من رموز الإدخال لعائلة Gemini 4—وهو ضعف 1M في GPT-6 Astra وأعلى بكثير من 200k في سلسلة Claude Fable/Opus 5 (قدمت بعض نسخ Claude نوافذ فعّالة أكبر عبر آليات أخرى). طُرحت مزاعم توجيه خفي تشير إلى سقوف 10M؛ ولا تزال غير مُتحقق منها.
سعر Gemini 4 (أرقام مُسربة)
يسرد الجدول المتداول:
- Gemini 4 Pro: $2.25 للإدخال / $11.25 للإخراج لكل 1M رمز (من دون تخزين مؤقت).
- Gemini 4 Flash: $0.75 / $3.75.
- Gemini 4 Flash-Lite: $0.35 / $1.75.
هذه الأرقام أقل بكثير من أسعار GPT-6 Astra المعلنة $12/$60 وClaude Fable 5.1 $10/$50 (يقدم Fable 5.1 خصومات قوية على قراءة ذاكرة التخزين المؤقت يمكن أن تخفض التكلفة الفعلية لأعباء العمل الوكيليّة). تسعير Gemini 3.x Pro الرسمي الحالي يقع في نطاق $2–$4 للإدخال / $12–$18 للإخراج حسب طول السياق، لذا تبدو أرقام Pro المسربة معقولة كتعديل للجيل التالي.
لن يُعرف التسعير العام الفعلي إلا عند الإطلاق. تاريخيًا، استخدمت Google أسعار رموز تنافسية وطبقات مجانية لدفع عجلة الاعتماد.
أداء Gemini 4 Pro: قراءة معمّقة في المعايير المسربة
يضع الجدول المتداول Gemini 4 Pro في صدارة كل فئة تقريبًا. هذه الأرقام غير رسمية وغير مُتحقق منها من Google أو مختبرات طرف ثالث مستقلة وقت الكتابة. ينبغي التعامل معها على أنها إشارات اتجاهية لا تصنيفات قاطعة.
هندسة البرمجيات والبرمجة الوكيليّة
- DeepSWE v1.1 (هندسة برمجيات بعيدة المدى): 88.7% (مقابل GPT-6 Astra عند 86.9% وClaude Fable 5.1 عند 69.1% وClaude Opus 5 عند 75.0%).
- Terminal-bench 2.1 (برمجة وكيليّة على الطرفية): 95.3% (مقابل Astra 94.1% وFable 92.8%).
- Terminal-bench 4.0 (قدرات الوكلاء العامة): 69.7% (أكبر فجوة نسبية مقارنة بـ Flash والمنافسين).
أعمال المعرفة والمهام المهنية
- GDPval-AA v2 (Elo، أعمال المعرفة): 2064 (النموذج الوحيد فوق 2000؛ Astra عند 1994 وFable عند 1853).
- Vals Finance Agent v2: 74.2%.
- Harvey’s Legal Agent Benchmark (مهام قانونية معقدة، معدل النجاح الشامل): 18.7%.
الاستدلال، متعدد الوسائط والمتخصص
- CharXiv Reasoning (تركيب المعلومات من مخططات معقدة، من دون أدوات): 94.7%.
- LVBench (فهم الفيديو الطويل): 95.8% وكيلي / 95.0% ثابت.
- HLE-Verified (استدلال خبير متعدد التخصصات): 72.1%.
- OSWorld-2.0 (استخدام الحاسوب وكيليًا، درجة جزئية، مع تمكين الأدوات الدفعية): 86.8%.
- BioMysteryBench وLABBench2 (علم المعلومات الحيوية وسير أبحاث البيولوجيا): نتائج رائدة على المجموعات القابلة للحل بشريًا والصعبة.
تُظهر هذه النتائج—إذا كانت اتجاهيًا دقيقة—قوة خاصة في أعباء العمل الوكيليّة طويلة الأمد متعددة الخطوات مع استخدام الأدوات؛ وهو المجال تحديدًا الذي وُضع فيه GPT-6 Astra وClaude Fable 5.1 كقادة بعد إصداراتهما في أوائل سبتمبر.
تعزّز اختبارات Arena النوعية هذه الصورة: اعتُبرت عمليات توليد SVG وThree.js المعقدة من النموذج المتخفي متفوقة أو تنافسية للغاية مقابل Astra في مقارنات المجتمع جنبًا إلى جنب.
كيف سيعمل Gemini 4؟
نظرًا لأن Gemini 4 (Pro) لم يُطرح بعد، فإن أي وصف لـ"كيف سيعمل" يستند بالضرورة إلى تصريحات Google الرسمية، والتفاصيل المسربة المحدودة حول نقطة تحقق داخلية مبكرة، ومسار سلسلة Gemini 3.x، وافتراضات هندسية معقولة. لا ينبغي اعتبار أي مما يلي مواصفات مؤكدة.
نهج التدريب الأساسي ومقياس الحجم
وصفت Google Gemini 4 بأنه "أكثر عمليات التدريب الأولي طموحًا حتى الآن"، مبني على نموذج أساسي أكبر بكثير من الأجيال السابقة. الهدف الصريح هو البقاء تنافسيًا على الجبهة، خاصة في الترميز والوكلاء المستقلين.
وهذا يعني:
- عدد معلمات أكبر أو سعة أكثر فاعلية (عبر مزيج الخبراء، وتناثر أفضل، أو تحجيم أكثر كثافة).
- استثمار حوسبي أثقل أثناء التدريب الأولي.
- استمرار التركيز على بيانات تدريب متعددة الوسائط (نص، صورة، فيديو، صوت، شيفرة، مسارات استخدام الأدوات).
من المتوقع أن يعمل النموذج كخط أساس عالي القدرات تُشتق منه لاحقًا نسخ على نمط Flash الأسرع.
أسلوب الاستدلال والتشغيل
تشير أوصاف مسرّبة لنقطة تحقق مبكرة باسم "argon" إلى وضع "جهد تفكير عالٍ" يستغرق نحو 2.4 دقيقة لتوليد واحد ويدعم حدًا أعلى للمخرجات بشكل كبير (أُبلغ عنه عند 256k رمز مقابل ~64k سابقًا).
يشير ذلك إلى:
- مسارات استدلال اختيارية كثيفة الحوسبة (على غرار أوضاع التفكير الممتد أو "أقصى جهد" في النماذج المنافسة).
- قدرة على إنفاق مزيد من الحسابات الداخلية على المسائل الصعبة قبل إنتاج إجابة.
- دعم أفضل لمخرجات طويلة متماسكة مثل قواعد شيفرة كاملة أو خطط متعددة الخطوات أو تقارير مطولة.
من المرجح أن يتمكن المستخدمون من ضبط المفاضلة بين السرعة/التكلفة وعمق الاستدلال، تمامًا كما هو الحال مع نماذج Gemini Flash الحالية التي تقدم مستويات تفكير منخفضة/متوسطة/عالية.
مجالات التركيز الرئيسية للقدرات
- الترميز وهندسة البرمجيات: أداء أقوى بعيدة المدى؛ إعادة هيكلة عبر ملفات متعددة، وتصحيح أخطاء عبر المستودعات، وحلقات تصحيح ذاتي، ومعدلات إكمال أعلى للمهام البرمجية الواقعية.
- السلوك المستقل/الوكيلي: قدرة محسّنة على التخطيط واستخدام الأدوات وملاحظة النتائج الوسيطة والتعافي من الأخطاء والمتابعة نحو هدف عبر خطوات كثيرة. يبني مباشرة على ميزات استخدام الحاسوب والسلوك الوكيلي الموجودة مسبقًا في Gemini 3.5/3.8 Flash.
- موثوقية السياق الطويل: تذكر تقارير المجتمع أهدافًا في نطاق 1.5 مليون رمز (أو أعلى). الهدف العملي ليس مجرد نوافذ أكبر بل استرجاع أدق وتراجعًا أقل عند العمل مع مستندات طويلة جدًا أو قواعد شيفرة أو آثار وكلاء متعددة الساعات.
- الفهم والتوليد متعدد الوسائط: معالجة أصلية للنص + الصورة + الفيديو + الصوت، مع مكاسب متوقعة في الاستدلال المكاني وفهم الفيديو وتفاعلات الصوت/الوكلاء في الزمن الحقيقي (استنادًا إلى نماذج Gemini 3.8 Live في سبتمبر 2026).
- استخدام الأدوات والمخرجات المُهيكلة: استدعاء دوال أكثر متانة، وتنفيذ الشيفرة، والإسناد إلى نتائج البحث، ومخرجات مُهيكلة على نمط JSON/XML لدمج موثوق في التطبيقات والوكلاء.
كيف يختلف عن Gemini 3.x
- المقياس: نموذج أساسي أكبر صراحة بدلًا من تحسين تدريجي.
- سعة المخرجات: حدود رموز أعلى مسرّبة تتيح توليدات أطول في مرور واحد.
- عمق الاستدلال: أوضاع جهد عالٍ أكثر بروزًا للمسائل الصعبة.
- التركيز الوكيلي: تركيز أكبر على عمل مستقل مستدام متعدد الخطوات بدلًا من المهام أحادية الدوران أو قصيرة الأمد.
- التموضع: مقصود به أن يكون نموذج Pro على الجبهة الجديدة، بينما تواصل سلسلة Flash وتيرتها السريعة من أجل السرعة وكفاءة التكلفة.
العلاقة مع التحسّن الذاتي التكراري (RSI)
ربط مسؤولو Google علنًا بين نفقات الشركة الرأسمالية الكبيرة في الذكاء الاصطناعي وبين الهدف الأطول أمدًا للتحسّن الذاتي التكراري—أنظمة يمكنها تحسين نفسها أو العمليات التي تنتج الجيل التالي على نحو ملموس. تُظهر أبحاث ذات صلة (مثل ورقة Dream-RSI) وكلاء يحسّنون استراتيجيات الاستكشاف الخاصة بهم دون تغيير أوزان النموذج.
هل سيتفوق Gemini 4 Pro على GPT-6 وClaude Fable 5.1؟
| الفئة | Gemini 4 Pro | GPT-6 Astra | Claude Fable 5.1 | ملاحظات |
|---|---|---|---|---|
| سعر الإدخال/الإخراج | $2.25 / $11.25 | $12.00 / $60.00 | $10.00 / $50.00 | Gemini 4 Pro أرخص بنحو 5× من Astra |
| نافذة السياق | 2M | 1M | 200k | أفضلية كبيرة لـ Gemini |
| DeepSWE v1.1 | 88.7% | 86.9% | 69.1% | تفوق قوي في الترميز |
| GDPval-AA v2 (Elo) | 2064 | 1994 | 1853 | متصدر أعمال المعرفة |
| Terminal-bench 4.0 | 69.7% | 66.4% | 57.9% | قدرات الوكلاء العامة |
| OSWorld-2.0 | 86.8% | 84.5% | 77.9% | استخدام الحاسوب |
| HLE-Verified | 72.1% | 67.3% | 62.1% | استدلال خبير |
| LVBench (فيديو) | 95.8% / 95.0% | 93.8% | 90.4% | قوة متعددة الوسائط |
| أبحاث Bio / LAB | أعلى النتائج | قوي | تنافسي | سير عمل علمية |
يتصدر Gemini 4 Pro كل صف رئيسي في الجدول، وغالبًا بهامش ملحوظ، بينما تسعيرُه المزعوم أكثر عدوانية بكثير من GPT-6 Astra أو Claude Fable 5.1.
محاذير مهمة
- هذا الجدول ليس إصدارًا رسميًا من Google. حتى 20 سبتمبر 2026، لم تنشر Google بطاقة نموذج أو نقطة نهاية API أو تسعيرًا أو معايير مؤكدة لـ Gemini 4 Pro. تنبع الأرقام من مصادر المجتمع/مشاهدات Arena/تسريبات نقطة تحقق داخلية (مرتبطة بالاسم الرمزي "argon").
- وُسِمت بعض الجداول المتداولة سابقًا لاحقًا بأنها تنبؤية أو منسوخة جزئيًا. تعامل مع كل نسبة محددة والتسعير على أنها غير مُتحقق منها حتى تؤكدها Google.
- تُسرد نافذة سياق Claude Fable 5.1 هنا عند 200k، وهو أقل من رقم 1M الشائع في وثائق Anthropic الرسمية. قد يعكس ذلك إعداد تقييم محددًا أو خطأً في الجدول المسرب.
- يظل GPT-6 Astra وClaude Fable 5.1 النموذجين الوحيدين على الجبهة اللذين طُرحا علنًا وتقييمهما مستقلًا بالكامل حتى الآن. لا تزال جهات تتبع طرف ثالث تظهر أنهما متقاربان إجمالًا (مع نقاط قوة مختلفة).
الواقع العملي الحالي (20 سبتمبر 2026)
| النموذج | الحالة | الأفضل لـ | مستوى السعر |
|---|---|---|---|
| Gemini 4 Pro | غير مُطلق (يدّعى أنه قوي) | السياق الطويل، الترميز، الوكلاء، تعدد الوسائط، التكلفة | شديد التنافسية (مزعوم) |
| GPT-6 Astra | مُطلق | الرياضيات، استخدام الحاسوب، الطرفية، الأتمتة، الأمن السيبراني | مرتفع |
| Claude Fable 5.1 | مُطلق | وكلاء بعيدة المدى، الاستدلال، جودة الترميز، كفاءة الكاش | مرتفع |
| Gemini 4 Flash / Flash-Lite | أشقاء مزعومون | أعباء عمل حساسة للسرعة والتكلفة | منخفض جدًا |
خلاصات سريعة
- مهيمن عبر المجالات كافة: يحتل Gemini 4 Pro المرتبة الأولى في كل فئة مدرجة، وغالبًا بهامش واضح.
- نقاط قوة خاصة: الترميز/الوكلاء بعيدة المدى (DeepSWE، Terminal-bench)، أعمال المعرفة، التعددية الوسائط (الفيديو + المخططات)، والمجالات المتخصصة (التمويل، القانون، الأحياء، استخدام الحاسوب).
- التموضع السعري: نحو خُمس سعر GPT-6 Astra وClaude Fable 5.1 على الإدخال والإخراج، مع تقديم درجات أعلى.
يركز Astra على استخدام الحاسوب وعتبات الأمن السيبراني والاكتشاف العلمي؛ يركز Fable 5.1 على أعمال معرفة طويلة التشغيل والترميز مع ضوابط مُصقولة وتكاليف قراءة كاش أقل. تبدو صورة Gemini 4 Pro المسربة الأقوى في هندسة البرمجيات الوكيليّة العامة والاستدلال متعدد الوسائط.
كيف يستعد المطوّرون: توصيات CometAPI
أثناء انتظار الوصول الرسمي إلى Gemini 4 Pro، تستفيد الفرق من بوابة موحّدة تدعم بالفعل الجبهة الحالية (سلسلة Gemini 3.x وGPT-6 Astra وClaude Fable 5.1/Opus 5 وأكثر من 500 نموذجًا آخر). توفر CometAPI ذلك تمامًا: نقطة نهاية واحدة متوافقة مع OpenAI، ومفتاح API واحد، وفوترة حسب الاستخدام أقل عادةً بنسبة 20–40% من أسعار المورّد المباشرة، والقدرة على تبديل النماذج بتغيير معلمة واحدة.
سير عمل عملي:
- اصنع نماذج أولية لخطوط الأنابيب الوكيليّة على Gemini Flash/Pro الحالية وGPT-6 Astra وClaude Fable 5.1 عبر CometAPI.
- قِس المطالبات نفسها عبر النماذج لتأسيس خطوط أساس.
- عند ظهور Gemini 4 Pro (ومتغيرات Flash الخاصة به) في كتالوج CometAPI—تاريخيًا تضيف المنصة نماذج Google الجديدة بسرعة—بدّل معرّف النموذج وأعد تشغيل التقييمات بأدنى تغييرات في الشيفرة.
- استخدم لوحة تكلفة لتتبع إنفاق الرموز عبر المورّدين ووجّه حركة المرور عالية الحجم أو الحساسة لزمن الاستجابة إلى النموذج الأكثر اقتصادية وكفاءة.
يقضي هذا النهج على إدارة مفاتيح متعددة، ويقلل مخاطر الارتهان لمورّد واحد، ويضع الفرق لتبنّي Gemini 4 Pro في اليوم الأول من الإتاحة العامة.
إذا كانت التسريبات صحيحة اتجاهيًا، يمثل Gemini 4 Pro أقوى محاولة لـ Google حتى الآن لاستعادة الجبهة في هندسة البرمجيات الوكيليّة والسياقات الطويلة متعددة الوسائط. إن الجمع بين الأداء المزعوم، والسياق الكبير، والتسعير العدواني سيجعل منه خيارًا افتراضيًا لكثير من أعباء العمل الإنتاجية. حتى تصل الإطلاقات الرسمية والتقييمات المستقلة، يبقى النهج الحصيف هو القياس المستمر عبر نماذج الجبهة الحالية—ويمكن القيام بذلك بسهولة عبر المنصات التي توحّد الوصول بالفعل. ترقّبوا الإعلان الرسمي؛ من المرجح أن الأسابيع القليلة المقبلة ستوضح مقدار ما سيتحول من الضجة إلى واقع إنتاجي.
الأسئلة الشائعة
هل تم إطلاق Gemini 4 Pro؟
لا. وفقًا لأحدث الكتالوج وتصريحات Google (منتصف إلى أواخر سبتمبر 2026)، لم يُطرح علنًا بعد ولم يُدرج بمعرّف نموذج رسمي.
ما موعد الإطلاق المتوقع لـ Gemini 4 Pro؟
يشير المسرِّبون إلى أكتوبر 2026 (مع بعض التكهنات بأواخر سبتمبر). لم تعلن Google تاريخًا رسميًا. اعتبره نافذة زمنية رهن التأكيد عبر كتالوج API أو منشور مدونة.
هل حققت Google RSI مع Gemini 4 Pro؟
تُظهر الأدلة العامة استخدامًا متقدمًا لحلقات وكيليّة لتحسين النموذج وأبحاثًا في التحسّن التكراري على مستوى الاستراتيجية (مثل Dream-RSI). الادعاءات بتحسّن ذاتي كامل أنتج النموذج غير مدعومة بتحقق مستقل.
كيف يقارن مع GPT-6 Astra وClaude Fable 5.1 على المعايير؟
تدّعي مخططات المجتمع المسربة الصدارة على عدة مجموعات وكيلة/ترميز. لا توجد درجات رسمية مستقلة لنموذج Gemini 4 Pro مُطلق حتى الآن. تُفضِّل البيانات العامة الحالية تقييم النماذج المتاحة (Astra وFable 5.1) على مهامك.
هل ينبغي أن أنتظر Gemini 4 Pro قبل البناء؟
لا. شغّل بقدرات اليوم الأقوى المتاحة (عبر CometAPI أو واجهات مباشرة)، واحتفظ بمجموعات التقييم جاهزة، وتبنَّ النموذج الجديد إذا وعندما تبرر الاختبارات المستقلة والداخلية التحوّل.
أين يمكنني الوصول بسهولة إلى نماذج الجبهة الحالية؟
المزوّدون الموحّدون مثل CometAPI يوفّرون وصولًا متوافقًا مع OpenAI إلى فئة GPT-6 Astra وClaude Fable 5.1 ونماذج Gemini الحالية وغيرها مع تبسيط الفوترة والتبديل. تحقّق من قائمة النماذج الحية والوثائق لأحدث المعرفات والتسعير.