

الخلاصة
Muse Wonder وClaude Opus 5.5 وGPT-6 Sol هي نماذج عالية القدرات متموضعة للعمل في الترميز وسير عمل الوكلاء. يركّز Muse Wonder الجديد من Meta على الذاكرة الدائمة والتنفيذ المستمر؛ يقود Opus 5.5 مؤشر الذكاء التجميعي المذكور؛ يقدّم GPT-6 Sol أدنى أسعار الإدخال والإخراج القياسية لفئة السياق القصير في هذه المقارنة، بينما يتم تسعير فئة السياق الطويل بشكل منفصل. اختَر بناءً على جودة المهام التمثيلية والموثوقية والتكلفة الكلية، وليس وفق نتيجة لوحة متصدرين واحدة.
أهم الخلاصات
- الذكاء العام: سجّل Claude Opus 5.5 قيمة 58 مقابل 52 لـ Muse Wonder على Intelligence Index v4.3 المبلّغ عنه.
- البرمجة طويلة الأفق: حقق Muse Wonder نتيجة 78.8 على DeepSWE 1.1 و53.1 على SWE-Marathon؛ سجّل Opus 5.5 نتائج 74.2 و46.3 في جدول Meta.
- الاستدلال منخفض التكلفة: يبدأ GPT-6 Sol من $2 إدخال / $10 إخراج لكل مليون رمز عبر واجهة OpenAI القياسية للسياق القصير.
- وكلاء متمحورون حول الذاكرة: يقدّم Muse Wonder ميّزتي Active Memory وActive Focus.
- توافر الوصول مهم: Muse Wonder Full منتج منفصل وأكثر تقييداً مقارنة بـ Muse Wonder القياسي المتاح للمطورين.
Muse Wonder مقابل Claude Opus 5.5 مقابل GPT-6 Sol بنظرة سريعة
اختر Muse Wonder للوكلاء الدائمين والهندسة طويلة التشغيل، وClaude Opus 5.5 للبرمجة العامة والأعمال الثقيلة على الطرفية، وGPT-6 Sol لانخفاض أسعار الرموز القياسية في فئة السياق القصير.
| عامل القرار | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| ابدأ الاختبار بـ | وكلاء دائمون وهندسة ممتدة | برمجة كثيفة الاعتماد على الطرفية وسير عمل احترافي | برمجة وأتمتة حساسة للتكلفة |
| نافذة السياق | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| نقطة القوة المنشورة | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Standard input/output $2/$10 per 1M tokens |
| إدخال/إخراج قياسي لكل 1M رمز | $4 / $20 | $4 / $20 | $2 / $10; فئة السياق القصير |
| الوصول عبر المزوّد | Meta Model API; Full منتج اشتراك منفصل | Anthropic API | OpenAI API |
| مقياس الاختيار | جودة المهام المقبولة والتكلفة الكلية | جودة المهام المقبولة والتكلفة الكلية | جودة المهام المقبولة والتكلفة الكلية |
| المطوّر | Meta | Anthropic | OpenAI |
| الإصدار | 12 أكتوبر 2026 | 22 سبتمبر 2026 | 16 سبتمبر 2026 |
| طرائق الإدخال | نص، صورة، صوت، فيديو؛ مُوثَّق دعم إدخال PDF | نص، صورة | نص، صورة |
| المخرجات | نص | نص | نص |
| قدرة مميزة | Active Memory وActive Focus | سير عمل الأدوات والوكلاء الفرعيين | جهد استدلال قابل للضبط وأدوات API |
يلخّص هذا العرض المواصفات المؤرخة والنتائج المنشورة التي جرت مراجعتها أدناه. تستخدم صفوف الاختبارات أساليب تقييم مختلفة، كما أن انخفاض أسعار الرموز لا يعني بالضرورة انخفاض التكلفة لكل مهمة ناجحة. يشكّل Muse Wonder القياسي وMuse Wonder Full خياري وصول متميزين.
تم التحقق من المواصفات في 13 أكتوبر 2026. تعتمد الطرائق والميزات المدعومة على نقطة النهاية وسطح الإصدار المختار، بما في ذلك توفر الصوت. قدرات النموذج على مستوى المنتج لا تضمن الدعم عبر كل مسار وصول.
Muse Wonder مقابل Claude Opus 5.5 مقابل GPT-6 Sol: نظرة عامة ومواصفات
Muse Wonder: سير عمل الوكلاء الدائمين
قدّمت Meta Muse Wonder وMuse Wonder Full في 12 أكتوبر 2026. يركّز Muse Wonder القياسي على المهام المهنية طويلة التشغيل، وذاكرة الوكيل الدائمة، والتعافي من العقبات. تهدف Active Memory إلى استرجاع السياق السابق المفيد، بينما صُممت Active Focus للحفاظ على التقدم عبر العمل متعدد الخطوات. تصف Meta البرمجة والبحث والتحليل المالي والمساعدة الشخصية كسيناريوهات رئيسية.
Claude Opus 5.5: برمجة مهنية واستخدام الأدوات
يستهدف Claude Opus 5.5 الترميز والاستدلال وسير العمل المهني متعدد الأدوات. أصدرته Anthropic في 22 سبتمبر 2026. نافذة سياقه مليون رمز، بينما تُظهر نتائج البرمجة المبلغ عنها أدناه نقاط قوة تختلف حسب الاختبار.
GPT-6 Sol: استدلال واعٍ بالتكلفة
يسعى GPT-6 Sol إلى الجمع بين الاستدلال القوي واستخدام الأدوات مع استدلال ذي تكلفة معقولة نسبياً. يدعم سير العمل البرنامجي عبر نظام OpenAI البيئي. أسعاره القياسية لفئة السياق القصير أدنى من أسعار Claude Opus 5.5 المدرجة، رغم أن الاقتصاديات الشاملة تعتمد أيضاً على الإعادات واستخدام رموز الاستدلال.
تصف OpenAI GPT-6 Sol بأنه نموذج لأعمال الترميز المعقّدة وسير العمل المعتمدة على الوكلاء؛ وتوفر إعلانه عن الإصدار نتائج التقييم المستخدمة أدناه. تقارن هذه المقالة نسخ النماذج المحددة، وليس كل نموذج أحدث ضمن تشكيلة كل بائع.
البنية وعناصر التحكم في الاستدلال
لا توفّر المصادر المذكورة تفصيلاً قابلاً للمقارنة لعدد المعاملات والبنية لجميع النماذج الثلاثة. وبالتالي لا مبرر لترتيب كثيف مقابل خليط خبراء. تصف Active Memory وActive Focus قدرات الوكلاء لدى Meta؛ وليستا بديلاً عن بنية عصبية مُفصح عنها. يوفّر GPT-6 Sol جهداً للاستدلال قابلاً للضبط، كما تعتمد النتائج المبلغ عنها لدى Meta وClaude أيضاً على الجهد وإعدادات التقييم. اعتبر تلك الإعدادات جزءاً من التهيئة قيد المقارنة، لا كمعايير حساب قابلة للتبادل.
نتيجة المقارنة: تقدم النماذج الثلاثة نوافذ سياق كبيرة وواجهات برمجة تطبيقات للمطورين. يوثّق Muse Wonder طرائق إدخال أوسع على مستوى النموذج؛ بينما يركّز Opus 5.5 وGPT-6 Sol على سير عمل النص والصورة. لا بد من التحقق من سعة السياق وتوافر الميزات على نقطة النهاية المختارة.
Muse Wonder مقابل Claude Opus 5.5 مقابل GPT-6 Sol: الأداء
المعايير المنشورة وحدود المصادر
تقدم بطاقة نموذج Meta الرسمية مقارنات مباشرة بين Muse Wonder وClaude Opus 5.5. تنشر OpenAI نتائج GPT-6 Sol بشكل منفصل، لذا لا يمكن وضع النماذج الثلاثة على لوحة متصدرين محكومة تماماً دون توحيد حوامل التقييم والإصدارات والإعدادات.
| Benchmark | Muse Wonder | Claude Opus 5.5 | الأعلى |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
تُميز منهجية بطاقة النموذج الرسمية بين الاختبارات الداخلية والتقييمات الخارجية والدرجات التي يبلّغ عنها مزودو النماذج المنافسة. يعيد هذا الجدول إنتاج القيم المبلغ عنها؛ ولا يُنشئ تجربة موحّدة ومستقلة عبر جميع الصفوف.
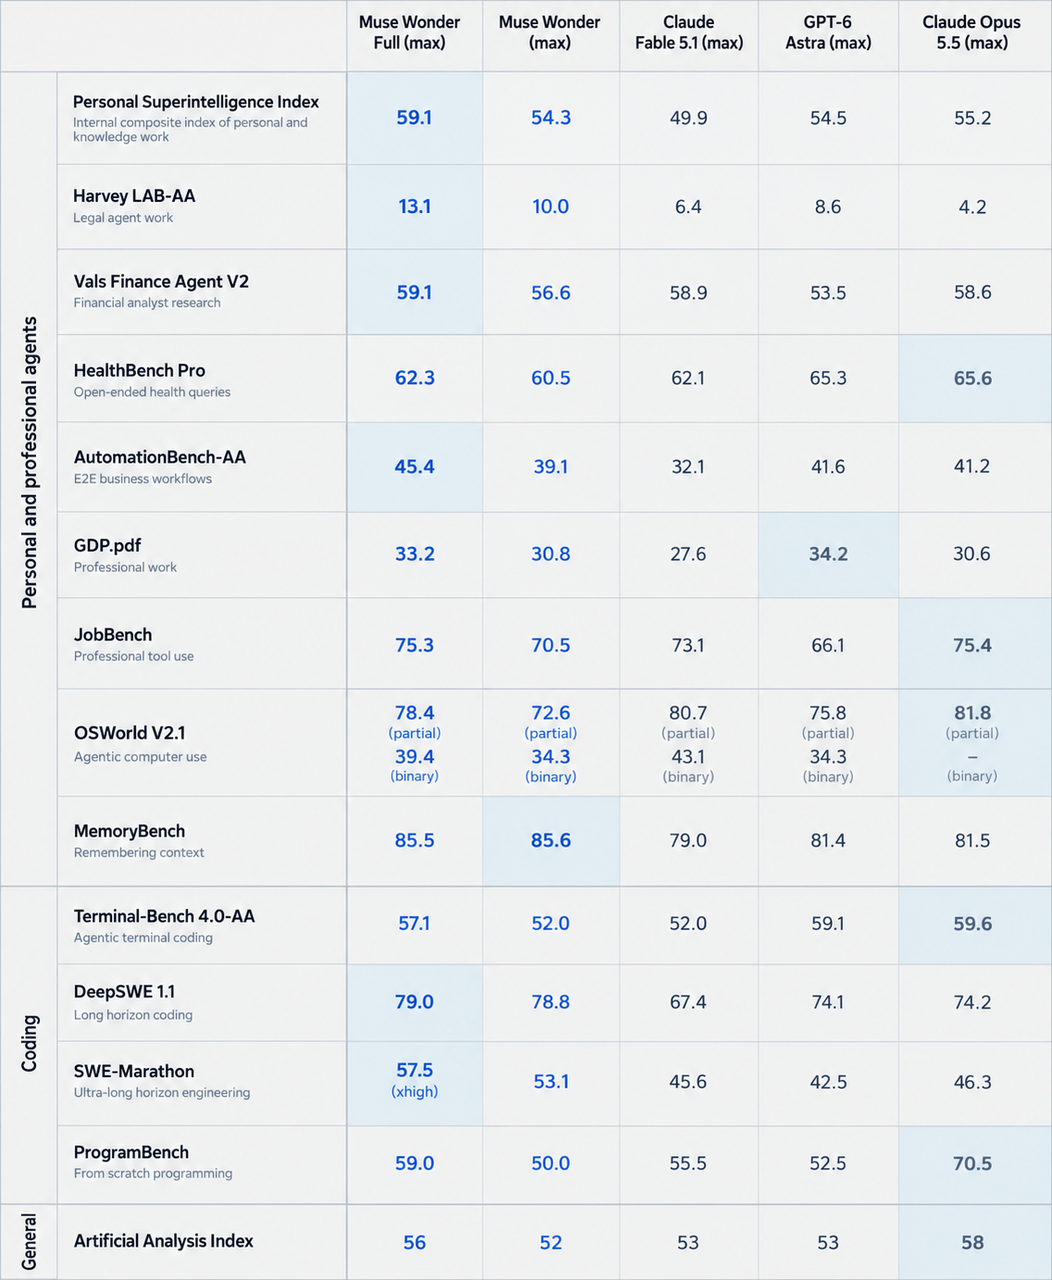
بطاقة الدرجات الأصلية للاختبارات من بطاقة نموذج Muse Wonder لدى Meta، مُعاد إنتاجها دون إعادة رسم. النموذج الإضافي من OpenAI الظاهر في هذه الصورة الرسمية هو GPT-6 Astra، وليس GPT-6 Sol. تحدد الجداول المحيطة النماذج ذات الصلة بهذه المقالة.
ظروف التقييم
يغطي DeepSWE v1.1 عدد 113 مهمة عبر 91 مستودعاً وخمس لغات، وتُقيّم بواسطة اختبارات وظيفية واختبارات انحدار باستخدام pass@1؛ تستخدم بطاقة نتائج Meta بيانات Datacurve لكل من Muse Wonder وOpus 5.5. يستخدم SWE-Marathon اختبارات المشاريع ويبلغ pass@1 من Abundant AI؛ تختلف حوامل الوكلاء، وتُعلَّم نتيجة Wonder Full بـ xhigh. يستخدم ProgramBench mini-swe-agent ويقيس تشغيلات تجتاز ما لا يقل عن 95% من الاختبارات المخفية، مع تعطيل الإنترنت بعد الإعداد. لا ينبغي دمج هذه البيئات والمؤشرات في نتيجة دقة عامة واحدة.
البرمجة والهندسة البرمجية
يتصدر Muse Wonder نتائج DeepSWE 1.1 وSWE-Marathon المبلغ عنها. يتصدر Claude Opus 5.5 نتائج Terminal-Bench 4.0-AA وProgramBench. يشير هذا الانقسام إلى أن الهندسة طويلة الأفق واستخدام أدوات سطر الأوامر وإعادة بناء البرامج تضغط على مهارات مختلفة.
نتائج GPT-6 Sol وقابلية المقارنة عبر المصادر
| Published OpenAI evaluation | GPT-6 Sol | الإعداد المبلغ عنه |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maximum reasoning |
| AutomationBench 1.0.6 | 33.2% | xhigh reasoning |
| Agents' Last Exam V1 | 56.4% | Maximum reasoning |
| OSWorld 2.0 offline | 60.5% | xhigh reasoning |
تُبلغ نتائج تقييم OpenAI المنشورة عن الدرجات أعلاه. نتيجة OSWorld هي مكافأة جزئية على مجموعة v2026.08.08 دون اتصال، وليست معدل إكمال صارماً للمهام. تشير OpenAI إلى أن التقييمات استخدمت بيئة أبحاثها أو واجهة API؛ وقد تختلف تهيئات الإنتاج.
تشير نتائج DeepSWE المبلغ عنها إلى فجوة 10.0 نقطة مئوية بين Muse Wonder وGPT-6 Sol، وفجوة 5.4 نقطة بين Opus 5.5 وGPT-6 Sol. هذه فوارق حسابية بين منشورات، وليست تقديرات مضبوطة لأفضلية النموذج وحده. يمكن أن تؤثر إعدادات الوكلاء والمطالبات ومستويات الجهد وميزانيات الأدوات المختلفة على النتيجة.
الذاكرة والوكلاء طويلو التشغيل
يستهدف Muse Wonder الوكلاء الذين يجب أن يتذكروا القرارات السابقة، ويستعيدوا السياق، ويواصلوا العمل المتقطع. يمكن أن تساعد Active Memory مساعد الأبحاث على تذكر حقائق خاصة بالمشروع، بينما تدعم Active Focus اتخاذ إجراءات تكرارية عندما لا ينجح المخطط السابق. لا تستبدل هذه القدرات التحقق من الحالة أو الأذونات أو سجلات التدقيق أو التأكيد البشري الإلزامي للإجراءات الحساسة.
أداء Muse Wonder Full
يُعد Muse Wonder Full خيار منتج منفصل. توفر Meta Muse Wonder القياسي عبر واجهتها، بينما Full مقيّد بخططي اشتراك Power Usage وMaximum Usage في Muse Code. الدرجة الأعلى لا تجعل Full بديلاً لواجهة API الخاصة بالنموذج القياسي.
تبلغ Meta عن نتائج Wonder Full بقيمة 56 على Intelligence Index، و59.1 على Personal Superintelligence، و13.1 على Harvey LAB-AA، و45.4 على AutomationBench-AA. كما يحقق 79.0 على DeepSWE 1.1 و57.5 على SWE-Marathon و85.5 على MemoryBench و75.3 على JobBench. تصف هذه النتائج المنشورة منتج Full الذي يتم الوصول إليه بشكل منفصل؛ وليست قياسات جديدة من مقارنة ضمن حاضنة موحّدة.
مقارنةً بنتائج Muse Wonder القياسي أعلاه، تحسن Full في سبعة من هذه المقاييس الثمانية المبلغ عنها؛ بينما MemoryBench أقل قليلاً عند 85.5 مقابل 85.6. لا يزال Opus 5.5 يتصدر قيمة Intelligence Index المبلغ عنها عند 58.
الكمون والموثوقية
لا توفر الأدلة المذكورة مقارنة كمون متطابقة للنماذج الثلاثة. قم بقياس زمن الوصول لأول مخرج مفيد، والمدة النهائية المتوسطة وعند النسبة المئوية 95 لإتمام المهمة من طرف إلى طرف، وتكرار انتهاء المهلة، والإكمال دون تدخل. ثبّت مدخلات المهمة وأذونات الأدوات والتوازي ومعايير القبول؛ وسجّل إعدادات الجهد وميزانيات الإعادة. إن سرعة توليد الرموز وحدها لا تثبت بالضرورة إكمالاً أسرع لمهمة متعددة الخطوات.
نتيجة المقارنة: يتصدر Muse Wonder اختبارات الهندسة المستدامة المذكورة، بينما يتصدر Opus 5.5 اختبارات الطرفية وإعادة بناء البرامج المذكورة. يظل GPT-6 Sol مرشحاً منخفض سعر الرموز، لكن المنشورات المتاحة لا تثبت ترتيب جودة أو سرعة متكافئاً في بيئة موحّدة عبر النماذج الثلاثة.
Muse Wonder مقابل Claude Opus 5.5 مقابل GPT-6 Sol: التكلفة
أسعار الرموز الرسمية لواجهات API
| السعر لكل 1M رمز | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| الإدخال القياسي | $4 | $4 | $2 |
| الإخراج القياسي | $20 | $20 | $10 |
| الإدخال المخبأ | $0.20 | $0.20 | $0.20 |
| إدخال سياق طويل | $4 | $4 | $4 |
| إخراج سياق طويل | $20 | $20 | $15 |
| إدخال مخبأ للسياق الطويل | $0.20 | $0.20 | $0.40 |
تنشر Meta أسعار $4 للإدخال و$20 للإخراج و$0.20 لنجاحات ذاكرة التخزين المؤقت لكل مليون رمز. تسرد Anthropic أسعار Opus 5.5 عند $4 للإدخال و$20 للإخراج و$0.20 لنجاحات التخزين المؤقت لكل مليون رمز. تسرد جدول التسعير الخاص بـ OpenAI أسعار GPT-6 Sol عند $2/$10 للإدخال/الإخراج للسياق القصير و$4/$15 للسياق الطويل؛ كما تختلف أسعار الإدخال المخبأ حسب الفئة. طبّق فئة السياق ذات الصلة لكل طلب، ووضع المعالجة، وشروط نقطة النهاية قبل تقدير عبء العمل.
بالنسبة إلى GPT-6 Sol، تُفرض أسعار أعلى على الطلبات التي تحتوي على أكثر من 272,000 رمز إدخال:
- رموز الإدخال: 2× السعر القياسي، من $2 إلى $4 لكل مليون رمز.
- رموز الإدخال المخبأة: 2× السعر القياسي، من $0.20 إلى $0.40 لكل مليون رمز.
- رموز الإخراج: 1.5× السعر القياسي، من $10 إلى $15 لكل مليون رمز.
تنطبق هذه الأسعار الأعلى على الطلب بأكمله، وليس فقط الرموز التي تتجاوز 272,000. لذا يدخل الطلب الذي يحتوي على 272,001 رمز إدخال ضمن فئة تسعير السياق الطويل لجميع رموز الإدخال والإدخال المخبأ والإخراج فيه.
بالمقارنة، لا يفرض Muse Wonder وClaude Opus 5.5 علاوة تسعير مكافئة للسياق الطويل ضمن أسعار واجهتهما القياسية.
يُعد هذا الفارق مهماً خصوصاً لتحليل المستندات الكبيرة، والترميز على مستوى المستودع، ووكلاء الذكاء الاصطناعي طويلو التشغيل، حيث قد يضيق تفوق تسعير GPT-6 Sol في فئة السياق القصير مع زيادة حجم الطلبات.
تسعير CometAPI وشروط الفوترة
وقت المراجعة، سردت CometAPI سعر Opus 5.5 عند $3.20 للإدخال / $16 للإخراج وGPT-6 Sol عند $1.60 للإدخال / $8 للإخراج لكل مليون رمز. هذه أسعار مستقلة لـ CometAPI ولا ينبغي خلطها مع الأسعار الرسمية للمزودين المذكورة أعلاه. أكد مسار الوصول وفئة السياق وشروط فوترة الحساب المعمول بها قبل تقدير التكلفة؛ فقد تتغير الأسعار والشروط.
التكلفة لكل مهمة مقبولة
احسب التكلفة لكل مهمة مقبولة على أنها إجمالي إنفاق النموذج والأدوات المفوترة، بما في ذلك الإعادات والنماذج الاحتياطية المحمّلة بالتكلفة، مقسوماً على عدد المخرجات التي تستوفي معايير القبول المحددة مسبقاً. سجّل وقت المراجعة البشرية بشكل منفصل أو حوّله باستخدام معدل أجور صريح. تتبّع الطلبات الفاشلة والرسوم الفعلية بشكل مستقل: الفشل وحده لا يثبت ما إذا كان الطلب قد تم فوترة تكلفته.
نتيجة المقارنة: يمتلك GPT-6 Sol أدنى أسعار الإدخال والإخراج القياسية في فئة السياق القصير، بينما يشترك Muse Wonder وOpus 5.5 في نفس الأسعار الأساسية المدرجة. تعتمد التكلفة الفعلية لكل مهمة مقبولة على مسار الفوترة المختار، واستخدام التخزين المؤقت، وفئات السياق، ورسوم الأدوات، وإعادات المحاولة، وجهد المراجعة.
Muse Wonder مقابل Claude Opus 5.5 مقابل GPT-6 Sol: المقارنة والاختيار
اختيار يستند إلى القدرات وعبء العمل
- للبرمجة العامة وسير العمل المعتمد بشكل كبير على الطرفية، ابدأ بـ Claude Opus 5.5 لأنه يتصدر Intelligence Index وTerminal-Bench وProgramBench المذكورة. تحقّق منه في مهام إعادة الهيكلة وتنفيذ الأدوات واتساق البرامج على مستوى المشروع.
- للمشاريع الهندسية الممتدة، ابدأ بـ Muse Wonder لأن نتائجه المبلغ عنها في DeepSWE وSWE-Marathon أقوى من Opus 5.5. قِس استكمال المهام، والتعافي من العقبات، والتكلفة الكلية للمهمة.
- للوكلاء الشخصيين الدائمين، ابدأ بـ Muse Wonder لأنه يوفّر Active Memory وActive Focus ولديه نتيجة MemoryBench أعلى من Opus 5.5. اختبر التذكّر والتصحيحات والاستمرارية وعزل المشاريع.
- لسير العمل متعدد الخطوات باستخدام الأدوات، قيّم النماذج الثلاثة. يوفّر Muse Active Focus، ويؤكد Opus على تنسيق الأدوات، ويدعم GPT-6 Sol أدوات Responses API. قارن حزمة الوكيل الكاملة، بما في ذلك أذونات الأدوات وإعادات المحاولة والتعامل مع الحالة.
- للمستندات المهنية والتحليل، قيّم Muse Wonder أو Claude Opus 5.5. يمتلك Muse نقاط قوة متخصصة، بينما يمتلك Opus المؤشر التجميعي الأقوى المذكور. استخدم مستندات تمثيلية ومعايير قبول خاصة بالمهمة.
- للأتمتة عالية الحجم والحساسة للتكلفة، ابدأ بـ GPT-6 Sol لأنه يمتلك أدنى أسعار الإدخال والإخراج القياسية للسياق القصير. تحقّق من تكلفة المهمة المقبولة وفئات السياق والكمون والإعادات.
- لخيار Meta الأعلى، قيّم Muse Wonder Full إذا كان متاحاً لك. لديه درجات أعلى على عدة مهام متخصصة، لكنه منفصل عن نموذج واجهة API القياسي. أكد الوصول إلى الاشتراك والملاءمة قبل الاختبار.
البرمجة المهنية
يُعد Claude Opus 5.5 خياراً جيداً للفرق التي تحتاج إلى مساعد هندسي شامل، خصوصاً حيث يهم تنفيذ الأدوات وإعادة الهيكلة واتساق البرامج على مستوى المشروع. تعزّز أفضلية Terminal-Bench وProgramBench المبلغ عنها هذه الحالة، رغم وجوب التحقق من حزمة الوكيل كاملة بدلاً من النموذج فقط.
الأتمتة عالية الحجم
يُعد GPT-6 Sol جذاباً عندما تكون الطلبات كثيرة والحساسية للتكلفة عالية. قد يكون العجز الطفيف في الجودة مقبولاً للمهام منخفضة المخاطر وسهلة التحقق مثل صياغة الوثائق، واستخراج الحقول المهيكلة، أو شرح الشيفرة. بالنسبة للتشغيلات الذاتية الطويلة، تتبّع الجودة والرموز والكمون والإعادات معاً.
قائمة التحقق لتقييم الإنتاج
ينبغي أن يتتبّع تقييم الإنتاج ستة مقاييس: الدقة، مُقاسة بالإجابات المقبولة أو الاختبارات الناجحة؛ الموثوقية، مُقاسة بالمهام المكتملة دون إنقاذ بشري؛ الكمون، مُقاساً بمدة المهمة من طرف إلى طرف؛ استخدام الرموز، مُقاساً بإجمالي الإدخال والإخراج المفوتر؛ كفاءة الوكيل، مُقاسة باستدعاءات الأدوات وإعادات التصحيح؛ والتكلفة الفعالة، محسوبةً كإجمالي الإنفاق مقسوماً على المهام المقبولة.
نتيجة المقارنة: قصّر القائمة على Muse Wonder لسلوك الوكلاء الدائمين والهندسة الممتدة، وOpus 5.5 لسير عمل البرمجة العامة مع متطلبات طرفية قوية، وGPT-6 Sol عندما تكون تكلفة الرموز قيداً رئيسياً. روِّج لمرشح فقط بعد أن يلبي عتبات الجودة والموثوقية الخاصة بالمهمة.
أين يمكنك الوصول إلى Muse Wonder وClaude Opus 5.5 وGPT-6 Sol؟
وصول المزودين الرسميين
استخدم Meta Model API لـ Muse Wonder القياسي، وAnthropic API لـ Opus 5.5، أو OpenAI API لـ GPT-6 Sol. يتاح Muse Wonder Full عبر خطط اشتراك Muse Code المحددة بدلاً من كونه بديلاً جاهزاً للنموذج القياسي لواجهة API. تحقّق من وصول الحساب وحدود الاستخدام والميزات المدعومة للطلبات عبر المسار الذي تختاره.
الوصول عبر CometAPI
يمكن لبوابة موحّدة تبسيط المصادقة والفوترة والتوجيه. استخدم نموذجاً أعلى أداءً لمراجعة البنى المعقّدة ونموذجاً أرخص للصياغة المتكررة منخفضة المخاطر. يجب دائماً التحقق من معرّف النموذج وصيغة الطلب المدعومة مقابل نقطة نهاية واجهة API المستهدفة.
يمكن للمطورين الوصول إلى واجهة Claude Opus 5.5 في CometAPI وواجهة GPT-6 Sol في CometAPI لتقييم أعباء عمل تمثيلية. أكّد سطح واجهة API المدعوم لكل نموذج بدلاً من افتراض أن البوابة المشتركة تجعل جميع صيغ الطلبات قابلة للتبادل.
تغطي مسارات CometAPI المذكورة في هذه المقالة Opus 5.5 وGPT-6 Sol. لا تُنشئ هذه المقالة مسار CometAPI لـ Muse Wonder أو Wonder Full؛ استخدم مسار المزود المؤكد عند تقييم تلك المنتجات.
الخلاصة
لا يفوز نموذج واحد عبر كل أعباء العمل. يُعد Muse Wonder أقوى مرشح للاختبار من أجل سلوك الوكلاء الدائمين والمهام الهندسية طويلة التشغيل. يُعد Claude Opus 5.5 مرشحاً قوياً للبرمجة العامة وسير العمل الثقيل على الطرفية والعمل المعرفي، وهو يتصدر قيمة Artificial Analysis Intelligence Index التي ذكرتها Meta. يقدّم GPT-6 Sol أدنى أسعار الرموز القياسية لفئة السياق القصير، وهو جذاب للأتمتة الحساسة للتكلفة. ينبغي على فرق الإنتاج اتخاذ القرار النهائي باستخدام جودة المهام المقبولة والموثوقية والكمون والإعادات واستخدام الأدوات والتكلفة الكلية على أعباء عمل تمثيلية.
الأسئلة الشائعة
كيف يمكن للفرق اختبار Muse Wonder وOpus 5.5 وGPT-6 Sol بشكل عادل؟
استخدم مجموعة مهام حقيقية محجوبة عن الضبط مع معايير قبول ثابتة ومصنوعات إدخال متطابقة وأذونات أدوات موثقة. سجّل كل نسخة نموذجية وإعداد الجهد وحاضنة الوكيل والمهلة وميزانية الرموز. نفّذ تجارب متكررة حيث تختلف المخرجات، وأبلغ عن الإخفاقات وكذلك النجاحات، وافصل بين مقارنة ضمن حاضنة موحّدة ومقارنة أفضل نظام مُهيأ. ينتج ذلك أدلة تنطبق على سير عملك بدلاً من إعداد اختبار فريق آخر.
هل يمكن لبوابة API الحفاظ على حالة الوكيل عند تبديل النماذج؟
لا يضمن عنوان بوابة مشترك بمفرده حالة محادثة قابلة للنقل أو معرّفات استدعاء الأدوات أو مراجع الردود المخزنة. احتفظ بسجل قياسي على جانب التطبيق للرسائل ومخرجات الأدوات وحالة المهام المُتحقق منها. اختبر حالة المسار ودلالات الأدوات لكل مسار قبل توجيه مهمة جارية إلى نموذج آخر؛ وإلا قد يفقد نموذج احتياطي أرخص معلومات لازمة للإكمال الصحيح.
كيف ينبغي أن تخصّص الفرق ميزانية لإعادات المحاولة والمراجعة البشرية؟
عرّف نتيجة مقبولة قبل الاختبار، ثم اقسم إجمالي إنفاق النموذج والأدوات المفوترة على النتائج المقبولة. أبلغ عن عمل المراجعة بشكل منفصل أو ضمّه باستخدام معدل أجور مُعلن. احسب المحاولات الفاشلة والنداءات التصحيحية والنماذج الاحتياطية، وقارن بين المهام النمطية والمهام مرتفعة التكلفة. هذا يمنع اعتبار انخفاض سعر الرموز انخفاضاً مضموناً في تكلفة العمل المفيد.
ماذا يجب أن يتضمن تقييم وكيل حساس للذاكرة؟
اختبر ما إذا كان الوكيل يسترجع الحقائق ذات الصلة، ويدمج التصحيحات، ويتجاهل التعليمات القديمة، ويحافظ على عزل المشاريع المختلفة. ضمّن متابعات مؤجلة وتحديثات متناقضة بدلاً من مجرد مطالبة طويلة واحدة. تحقق من سلوك الذاكرة على مستوى التطبيق وكذلك على مستوى النموذج، لأن الاستمرارية والاسترجاع والحذف تعتمد على النظام المُنَشَّر.