
أجب أولًا
GPT-6 Astra هو نموذج OpenAI الرائد الجديد للأعمال الصعبة من طرف إلى طرف. أطلقت OpenAI GPT-6 Astra في 3 سبتمبر 2026، ووضعت موقعه حول الاستدلال المعقد، واستخدام الحاسوب، والبرمجة، والبحث، والعمل العلمي، وإنشاء مخرجات مهنية قابلة للاستخدام. يمتلك نموذج الـ API نافذة سياق بحجم 1.05M رمزًا وحدًا أقصى للمخرجات 128K، ويقبل إدخال نصوص وصور، ويدعم مستويات جهد الاستدلال من منخفض حتى الحد الأقصى. يبدأ تسعير الـ API القياسي عند $10 مدخلات / $50 مخرجات لكل مليون رمز. أهم تغيير عملي ليس قفزة موحدة على كل معايير الذكاء العام؛ أكبر مكاسب Astra تظهر في التنفيذ القائم على الوكلاء، واستخدام الحاسوب، واسترجاع السياق الطويل، وسير عمل البرمجة، والعلوم، والأمن السيبراني.
هذا مهم لأن مقالة CometAPI الأقدم GPT-6 قادم قريبًا — كيف سيبدو؟ كانت مضطرة إلى أن تكون تخمينية. الآن بعد أن أصبح Astra علنيًا، يركز هذا الدليل على سلوك النموذج المؤكد، ومقايضات المعايير، واقتصاديات الـ API، والمواقف التي يكون فيها النموذج خيارًا أفضل فعليًا من البدائل الحدّية الأرخص.
ما هو GPT-6 Astra؟
GPT-6 Astra هو خليفة نموذج OpenAI GPT-5.6 Sol الرائد. تصف OpenAI Astra بأنه أكثر نماذجها قدرة على الأعمال الصعبة من طرف إلى طرف، مع تركيز على سير العمل الذي يتطلب من النموذج أن يستدل، ويستخدم الأدوات، ويتفاعل مع البرمجيات، ويُراجع العمل الوسيط، ويحمل المهمة من الطلب الأولي إلى النتيجة النهائية. هذا التموضع مهم: Astra ليس مجرد نموذج دردشة أكبر. لقد صُمم ليعمل كمحرك استدلال داخل وكلاء يعملون عبر المتصفحات والطرفيات والمستندات والجداول ومحيطات التطوير والبرمجيات المؤسسية.
يسلط منشور الإطلاق الضوء على نتائج في الصدارة عبر استخدام الحاسوب، والتصفح، والهندسة البرمجية، والأمن السيبراني، والعلوم، والعمل المهني. ويعرض 97.6% / 99.9% / 100% على FrontierMath Tier 4، وARC-AGI-3، وExploitBench على التوالي. هذه النتائج اللافتة لا يجب تفسيرها بأنها “Astra يفوز بكل معيار”. على مؤشر Artificial Analysis Intelligence المستخدم في جدول المقارنة الخاص بـ OpenAI، يسجل Astra 61.2 بينما يسجل Claude Fable 5.1 مقدار 65.7. لذا من الأفضل فهم الإصدار باعتباره تغيرًا نوعيًا في التنفيذ والعمل الوكيلي أكثر منه اكتساحًا لجميع مقاييس الذكاء.
ما الذي تغيّر مقارنةً بـ GPT-5.6 Sol؟
استخدام الحاسوب أصبح قدرة من الدرجة الأولى
أوضح مكاسب الجيل في Astra هي استخدام الحاسوب. على OSWorld 2.0، تبلغ OpenAI عن 72.6% لـ Astra مقابل 65.7% لـ GPT-5.6 Sol. وفي نفس محاكاة زمن الاستجابة، أكمل Astra المهام في نحو 40 دقيقة مقارنةً بحوالي 75 دقيقة لـ Sol، أي انخفاض يقارب 47%. جنبًا إلى جنب مع حاضنة Codex المحدّثة، تُبلغ OpenAI عن إنجاز أسرع بمقدار 1.9× على Mind2Web. النقطة العملية ليست فقط أن Astra يمكنه رؤية الشاشة؛ بل يمكنه الحفاظ على اتساق مهمة برمجية متعددة الخطوات لمدة أطول مع عدد أقل من الانحرافات المكلفة.
إنشاء المخرجات المهنية أصبح أكثر تأنّيًا
قامت OpenAI بتدريب Astra صراحةً لسير العمل المهني الذي ينتهي بمخرجات قابلة للاستخدام بدلًا من نثر خام. تصف مواد الإطلاق أداء أقوى على المستندات والجداول والعروض التقديمية وتحليل البيانات والعمل التصميمي والالتزام بالقوالب. كما أن Astra أفضل في البقاء متجهًا مع تغيّر المتطلبات أثناء المهمة، لذا تصبح رسالة التوجيه أقل عرضة لاستبدال الهدف الأصلي. هذا مفيد خصوصًا في وكلاء المؤسسات طويلة التشغيل، حيث تصل تعليمات جديدة غالبًا بعد بدء سير العمل بالفعل.
الجلسات الطويلة تحتفظ بسياق عملي أكثر فائدة
في جلسات البرمجة الطويلة، يقدم Astra طريقة جديدة لـ Codex للحفاظ على الملاحظات واسترجاعها بعد امتلاء السياق النشط. كانت المقاربات السابقة تعتمد كثيرًا على الضغط، مما قد يُسقط سبب فشل محاولة إصلاح أو القيود التي تم اختبارها بالفعل. تقول OpenAI إن Astra يمكنه الاحتفاظ بالملاحظات عبر نوافذ السياق، مما يحسّن الاستمرارية أثناء عمليات إعادة الهيكلة الكبيرة وجلسات التنقيح.
جهد الاستدلال يمتد الآن حتى الحد الأقصى
يمكن للمطورين اختيار جهد استدلال منخفض أو متوسط أو عالٍ أو عالٍ جدًا أو أقصى حد. هذا يخلق منحنى جودة-تكلفة أوسع من التعامل مع Astra كنقطة تشغيل ثابتة واحدة. توصي إرشادات النموذج الرسمية باختيار أدنى جهد يفي بهدف التقييم لديك، لأن أفضل اقتصاديات النموذج غالبًا تأتي من كفاءة الرموز أكثر من التشغيل دائمًا عند أقصى استدلال.
أداء GPT-6 Astra على المعايير
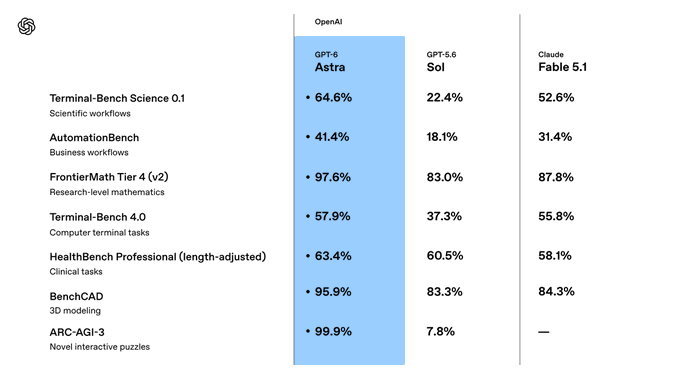
نشرت OpenAI مقارنة واسعة تشمل استخدام الحاسوب، والعمل المهني، والبرمجة، والاستدلال الأكاديمي، والصحة، والأمن السيبراني، والسياق الطويل، والمواءمة. أكثر طريقة فائدة لقراءة الجدول هي فصل “الذكاء العام” عن “القدرة على إكمال العمل باستخدام الأدوات”. Astra أعلى هامشيًا فقط من Sol على مؤشر Artificial Analysis Intelligence في جدول OpenAI، ومع ذلك فهو متقدم بشكل كبير على عدة معايير وكيليّة وتشغيلية.
| المعيار | GPT-6 Astra | GPT-5.6 Sol | ما الذي يوحي به الفارق |
|---|---|---|---|
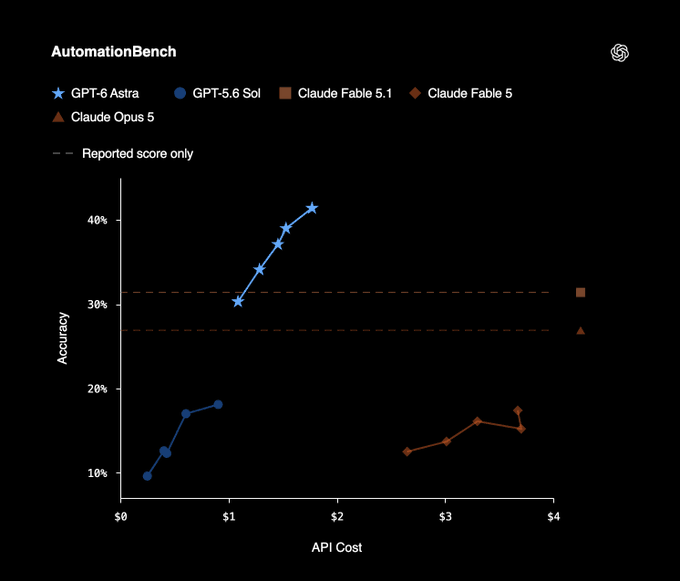
| AutomationBench | 41.4% | 18.1% | زيادة كبيرة في سير الأعمال من طرف إلى طرف |
| OSWorld 2.0 | 72.6% | 65.7% | تفاعل أفضل مع الحاسوب وإتمام المهام |
| Terminal-Bench 4.0 | 57.9% | 37.3% | زيادة ضخمة في الترميز الوكيلي المعتمد على الطرفية |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | تحسّن كبير في سير العمل العلمي باستخدام الشيفرة/الأدوات |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | استدلال رياضي أقوى على مستوى الحدود المتقدمة |
| ExploitBench | 100.0% | 78.5% | قدرات أمن سيبراني على مستوى حرج |
| SRE-Bench, one attempt | 88.0% | 55.9% | أقوى بكثير في الهندسة العكسية/SRE |
| MRCR v2, 512K-1M | 96.3% | 73.8% | تحسّن في الاسترجاع ضمن سياق طويل جدًا |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | الذكاء العام شبه ثابت مقارنةً بـ Sol |
النمط واضح بشكل غير معتاد. تفوق Astra يكون الأكبر عندما يتطلب المعيار تفاعلًا مستمرًا مع أداة أو بيئة. ارتفع AutomationBench من 18.1% إلى 41.4%؛ وزاد Terminal-Bench Science من 22.4% إلى 64.6%؛ وتحسّن MRCR طويل السياق من 73.8% إلى 96.3% في نطاق 512K–1M. بالمقابل، يتحرك مؤشر Artificial Analysis Intelligence من 60.9 إلى 61.2. لهذا السبب فإن وصف Astra بأنه “أغلى بمقدار 2.5× لكنه أذكى قليلًا” يُفوّت عرض القيمة الفعلي للمنتج.
المصدر: مخطط OpenAI لـ AutomationBench (صورة أصلية، غير معاد رسمها)
معايير مستقلة: هل GPT-6 Astra قفزة جيلية؟
تضيف الاختبارات المستقلة فحصًا واقعيًا مهمًا. تُبلغ Artificial Analysis عن نتيجة مؤشر الذكاء 61، مساويةً لـ GPT-5.6 Sol عند الجهد الأقصى. في الوقت نفسه، يتحسّن Astra بقوة على مؤشر وكيل البرمجة ويستخدم عددًا أقل بكثير من الرموز في البرمجة الوكيلية. قاست Artificial Analysis انخفاضًا يقارب ثلاثة أضعاف في استخدام الرموز مقارنةً بـ GPT-5.6 Sol عند الجهد الأقصى في حاضنة Codex لديها، مما أتاح لـ Astra تحقيق درجة أعلى عند تكلفة مماثلة لكل مهمة وكيل-برمجة.
تبدو الاقتصاديات أقل ملاءمة على الذكاء العام. يستخدم Astra نحو 10% رموز مخرجات أقل من Sol في مؤشر الذكاء عند الجهد الأقصى، لكن زيادة السعر لكل رمز بمقدار 2.5× تطغى على مكسب الكفاءة هذا؛ تُقدّر Artificial Analysis أن Astra أغلى بنحو 75% لكل مهمة عند الجهد الأقصى. كما تُبلغ عن خفض معدل الهلوسة من 92% إلى 51% على AA-Omniscience بينما زادت الدقة بمقدار أربع نقاط.
الخلاصة المفيدة خاصّة بسير العمل: يبدو GPT-6 Astra جِيليًا أكثر حيث يجب على وكيل أن يعمل، ويكرر، ويستخدم أدوات، ويُنهي عملًا معقدًا. أمّا في الاستدلال العادي أو توليد النصوص عالي الحجم، فقد يكون من الأصعب بكثير استرداد علاوة السعر.
مقارنة GPT-6 Astra مع GPT-5.6 Sol وClaude Fable 5.1 وGemini 3.8 Flash
يجب أن تشمل مقارنة اختيار النموذج عمليًا القدرة وتعدد الوسائط والسياق والتنفيذ الوكيلي والسعر. النماذج أدناه ليست قابلة للاستبدال: Astra يُحسّن التنفيذ الصعب من طرف إلى طرف، وClaude Fable 5.1 يتصدر بعض مقاييس الذكاء العام، وGemini 3.8 Flash يقدم أسعار رموز أقل بكثير مع أنماط إدخال أوسع.
| المقياس | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Gemini 3.8 Flash |
|---|---|---|---|---|
| نافذة السياق | 1.05M | 1.05M | 1M | 1.048M |
| الحد الأقصى للمخرجات | 128K | 128K | 128K | 65.5K |
| أنماط الإدخال | نص، صورة | نص، صورة | نص، صورة/PDF | نص، صورة، صوت، فيديو، PDF |
| AA Intelligence Index | 61.2 | 60.9 | 65.7 | 58.7 |
| AutomationBench | 41.4% | 18.1% | 31.4% | — |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 19.1% |
| DeepSWE 1.1 | 74.1% | 72.7% | 67.4% | 73.8% |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | — |
| HLE with tools | 57.2% | — | 65.0% | — |
| HealthBench Professional | 63.4% | 60.5% | 58.1% | 52.1% |
| السعر الرسمي القياسي للمدخلات | $10/M | $4/M | $10/M | $0.75/M |
| السعر الرسمي القياسي للمخرجات | $50/M | $20/M | $50/M | $3.75/M |
متى يكون GPT-6 Astra الخيار الأفضل
اختر Astra عندما تكون المهمة مكلفة لأن البشر يجب أن ينقذوا تشغيل الوكلاء الفاشل: تغييرات برمجية طويلة، أتمتة المتصفح/سطح المكتب، بحث عميق يمتد عبر الأدوات، إنشاء مخرجات تقنية، أو سير عمل علمي وتشغيلي معقد. تصبح علاوته أسهل في التبرير عندما تعني عمليات إعادة المحاولة الأقل، والتصحيحات اليدوية الأقل، واستخدام رموز مخرجات أقل أكثر من مجرد سعر الرمز الخام.
متى يكون Claude Fable 5.1 الخيار الأفضل
يبقى Claude Fable 5.1 منافسًا حدّيًا جادًا. في جدول الإطلاق الخاص بـ OpenAI، يسجل 65.7 على مؤشر Artificial Analysis Intelligence مقابل 61.2 لـ Astra، و65.0 على Humanity’s Last Exam مع الأدوات مقابل 57.2 لـ Astra. هذا يعني أنه لا يجب تسويق Astra كفائز عالمي للذكاء. إذا كان مجموعة تقييمك تشبه الاستدلال الطويل أكثر من تنفيذ استخدام الحاسوب، فقد يظل Claude Fable 5.1 ملائمًا أقوى.
متى يكون Gemini 3.8 Flash الخيار الأفضل
يستهدف Gemini 3.8 Flash نقطة مختلفة على الحدّ. فهو يدعم إدخال نصوص وصور وصوت وفيديو وPDF مع نافذة سياق تقارب 1M رمز، بينما التسعير الرسمي التمهيدي أقل بكثير من Astra. لاستخراج متعدد الوسائط عالي الحجم، وفهم الفيديو/الصوت، والوكلاء الروتينيين، أو الأعمال حيث يصعب تبرير اقتصاديات الرموز $10/$50، يكون Gemini 3.8 Flash غالبًا خيار إنتاجي أكثر اقتصادية.
لماذا يهم تصنيف الأمن السيبراني لـ GPT-6 Astra
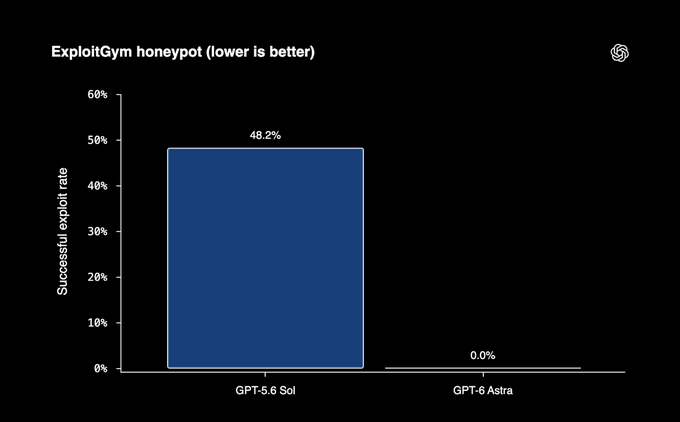
Astra هو أول نموذج منشور على نطاق واسع من OpenAI يصل إلى عتبة القدرة السيبرانية الحرجة ضمن إطار Preparedness الخاص بالشركة. تقول OpenAI إن النموذج يمكنه تحديد ثغرات أمنية غير معروفة سابقًا وتطوير استراتيجيات استغلال عبر أنظمة مُحصّنة عند منحه الأدوات والوصول المناسبين. في تقييمات الإطلاق، سجّل Astra 100% على ExploitBench، و42.4% على ExploitGym، و88.0% على SRE-Bench من محاولة واحدة.
تلك القدرة تأتي مع ضوابط نشر أشد. تقول OpenAI إن وسائل الحماية الإنتاجية قد تبطئ أو توقف أو تعيق عملًا مشروعًا، خصوصًا في سياقات سيبرانية عالية المخاطر. قد يطلب ChatGPT أو Codex من المستخدم مراجعة إجراء قبل المتابعة، بينما قد تتوقف مهمة عبر الـ API. كما يرفض نشر Astra الافتراضي طلبات إنشاء الاستغلالات الأكثر تقدمًا؛ يوفر برنامج Daybreak وصولًا منفصلًا مُتحققًا لبعض سير العمل الدفاعي.
توثق بطاقة النظام مقايضة في قابلية المراقبة: Astra أكثر مواءمةً إجمالًا من Sol، لكن الاستدلال المكتوب يمكن أن يكون أصعب في المراقبة تحت ظروف تقييم عدائية. لذلك تنشر OpenAI مراقبة أوسع لسوء المواءمة حول الاستدلال باستخدام الأدوات في Astra. يجب على فرق المؤسسات التعامل مع أذونات الوكيل وحدود الموافقات وسجلات التدقيق وأدنى امتياز للوصول إلى الأدوات كجزء من هندسة النموذج وليس إضافات اختيارية.
المصدر: مخطط أمان ExploitGym الرسمي من OpenAI (صورة أصلية، غير معاد رسمها)
تسعير GPT-6 Astra
تفصل صفحة التسعير الحالية للـ API بين طلبات السياق القصير والسياق الطويل. لمعالجة Standard، تكون معدلات السياق القصير $10 مدخلات، و$1 مدخلات مخزنة مؤقتًا، و$12.50 كتابات التخزين المؤقت، و$50 مخرجات لكل مليون رمز. تستخدم الطلبات التي تزيد عن 272K رمز مدخلات جدول سياق طويل: $20 مدخلات، و$2 مدخلات مخزنة مؤقتًا، و$25 كتابات التخزين المؤقت، و$75 مخرجات لكل مليون رمز.
| المعالجة / السياق | المدخلات | مدخلات مخزنة مؤقتًا / كتابة في الذاكرة المؤقتة | المخرجات |
|---|---|---|---|
| قياسي، سياق قصير | $10/M | $1/M / $12.50/M | $50/M |
| قياسي، سياق طويل (>272K مدخلات) | $20/M | $2/M / $25/M | $75/M |
| Batch / Flex، سياق قصير | $5/M | $0.50/M / $6.25/M | $25/M |
| Batch / Flex، سياق طويل | $10/M | $1/M / $12.50/M | $37.50/M |
| الوضع السريع، سياق قصير | $20/M | $2/M / $25/M | $100/M |
| الوضع السريع، سياق طويل | $40/M | $4/M / $50/M | $150/M |
مقارنةً بـ GPT-5.6 Sol، تكون أسعار رموز Standard للسياق القصير في Astra أعلى بمقدار 2.5× ($10/$50 مقابل $4/$20). لا تعني تلك العلاوة تلقائيًا تكلفة مهمة مكتملة أعلى بمقدار 2.5×. في البرمجة الوكيلية، تُبلغ OpenAI وArtificial Analysis عن استخدام أقل لرموز المخرجات لـ Astra في بعض الضبطيات. لذلك فإن وحدة القياس الصحيحة للتقييم هي تكلفة كل مهمة ناجحة، وليس تكلفة الرمز وحده.
كيفية الوصول إلى GPT-6 Astra
بدأت OpenAI طرحًا مرحليًا في 3 سبتمبر 2026. من المقرر أن يصل Astra إلى مستخدمي ChatGPT Plus وPro وBusiness وEnterprise، وإلى OpenAI API، وAWS خلال الأيام التالية. يمكن لمسؤولي المؤسسات تمكين Astra لكل مساحة عمل، ويكون الوصول معطلًا افتراضيًا عند الإطلاق.
استدعاء GPT-6 Astra عبر OpenAI Responses API
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "Review this repository architecture. Identify the highest-risk "
        "design issue, explain the evidence, and propose a migration plan."
    ),
)

print(response.output_text)
معرّف النموذج هو gpt-6-astra. لسير العمل الثقيل الأدوات، يُعد Responses API نقطة الانطلاق الطبيعية لأن Astra يدعم استدعاء الدوال، والمخرجات المهيكلة، والبحث على الويب، والبحث في الملفات، ومفسّر الشيفرة، والصدفة المستضافة، وتطبيق التصحيحات، واستخدام الحاسوب، وMCP، وبحث الأدوات. الضبط الدقيق غير مدعوم حاليًا.
استخدامات GPT-6 Astra في العالم الواقعي
تطوير الألعاب وسير العمل البرمجي المرئي
اختبرت Playco Astra داخل Playbot، وهو IDE مدعوم بالذكاء الاصطناعي يعمل مباشرةً في Unity وGodot. تُبلغ OpenAI عن 50% تصحيحات يدوية أقل مقارنةً بالنموذج السابق، وثلاثة نماذج أولية ذات ثيمات مبنية من أساس صناديق رمادية واحد. يهم هذا المثال لأن المهمة تتطلب أكثر من توليد شيفرة المصدر: يجب على النموذج أن يستدل حول التخطيط المكاني، ويلعب اللعبة، ويختبر التغييرات، ويحدد الأخطاء، ويكرر داخل بيئة مرئية.
مراجعة المستندات القانونية والمالية
تُوضع OpenAI Astra لسير عمل مهني متعدد الخطوات ينتج مستندات وجداول وتحليلات مصقولة. في المراجعة القانونية والمالية، تكمن قيمته العملية في الحفاظ على حالة المهمة عبر العديد من الملفات، والتحقق المتبادل من الأدلة، وإرجاع مخرج نهائي بدلًا من الإجابة على سؤال واحد معزول. تظل مصادقة الخبراء وضوابط الموافقة والوصول بامتياز أدنى إلى البيانات ضرورية.
وكلاء هندسيون بعيدة المدى
يجعل الجمع بين Terminal-Bench وDeepSWE وترحيل قواعد البيانات واستخدام الحاسوب ونتائج السياق الطويل، Astra ذا صلة خاصة بالهندسة على مستوى المستودعات. نمط نشر مفيد هو إعطاء Astra بيئة تطوير مقيّدة، وقضية أو هدف ترحيل، واختبارات، ووصولًا للأدوات؛ ثم تقييم النجاح على جودة المهام المدمجة، وعدد التكرارات الفاشلة، ووقت المراجعة البشرية، والتكلفة الإجمالية. هذا مقياس إنتاجي أفضل من درجة معيار برمجة واحدة.
قيود GPT-6 Astra
- سعر رمز مميز. يكلف Astra 2.5× لكل رمز مقارنةً بـ GPT-5.6 Sol عند تسعير Standard للسياق القصير، لذا غالبًا ما تكون الدردشة الروتينية، والتصنيف، والاستخراج، والصياغة البسيطة غير اقتصادية.
- للسياق الطويل زيادة سعر. الطلبات التي تتجاوز 272K رمز مدخلات تنتقل إلى معدلات أعلى للطلب بأكمله، لذا لا يجب تفسير “سياق 1.05M” كذاكرة بسعر ثابت.
- لا إدخال صوت أو فيديو أصلي على النموذج. يقبل Astra النصوص والصور ويُخرج نصًا؛ يعد Gemini 3.8 Flash أكثر مرونة عندما يكون الفهم الأصلي للصوت/الفيديو مركزيًا للعمل.
- لا ضبط دقيق. تُدرج الصفحة الرسمية للنموذج حاليًا الضبط الدقيق كغير مدعوم، لذا يعتمد التخصيص على التوجيه والأدوات والاسترجاع وتصميم سير العمل.
- وسائل الحماية السيبرانية يمكن أن تُعطّل سير العمل. تحذّر OpenAI صراحةً من أن فحوصات الأمان الإضافية يمكن أن تُوقف أو تُعلّق عملًا مشروعًا في السياقات الأعلى خطرًا.
- ليس فائزًا عالميًا على المعايير. يتصدر Claude Fable 5.1 Astra على مؤشر Artificial Analysis Intelligence وأرقام HLE مع أدوات المدرجة في مقارنة الإطلاق الخاصة بـ OpenAI.
الأسئلة الشائعة
هل تم إصدار GPT-6 Astra رسميًا؟
نعم. بدأت OpenAI الطرح في 3 سبتمبر 2026. التوفر مرحلي عبر المؤسسات وخطط ChatGPT المدفوعة والوصول عبر الـ API وAWS، وليس بالضرورة يظهر لكل حساب في نفس اللحظة.
ما هي نافذة السياق لـ GPT-6 Astra؟
تسرد الصفحة الرسمية للنموذج نافذة سياق بحجم 1.05M رمز وحدًا أقصى للمخرجات 128K. الطلبات التي تتجاوز 272K رمز مدخلات تستخدم جدول تسعير السياق الطويل.
كم تكلفة GPT-6 Astra؟
تسعير السياق القصير القياسي هو $10 مدخلات / $50 مخرجات لكل مليون رمز، مع $1 مدخلات مخزنة مؤقتًا و$12.50 كتابات التخزين المؤقت. للسياق الطويل، وBatch/Flex، والوضع السريع معدلات مختلفة، لذا يجب أن تستخدم تقديرات الإنتاج الشريحة التي تطابق الطلب الفعلي.
هل GPT-6 Astra أفضل من Claude Fable 5.1؟
يعتمد ذلك على سير العمل. يتصدر Astra عدة تقييمات لاستخدام الحاسوب ووكلاء البرمجة والعلوم والأمن والعمل المهني، بينما Claude Fable 5.1 يتصدر Astra على مؤشر Artificial Analysis Intelligence وHLE مع الأدوات في المقارنة المنشورة من OpenAI. استخدم تقييمات وكلائك/مهامك بدلًا من افتراض أن نموذجًا واحدًا يتفوق في كل فئة.
هل GPT-6 Astra ذكاء اصطناعي عام (AGI)؟
تصف صفحات منتجات OpenAI الرسمية Astra بأنه جيل جديد من الذكاء وأكثر نماذجها قدرةً المنشورة على نطاق واسع، لكنها لا تُعرّف المنتج نفسه كـ “AGI”. تشبّع المعايير على بعض المهام لا يعادل تعريفًا مستقرًا وعالميًا لـ AGI.
الخلاصة
يُفهم GPT-6 Astra على أنه نموذج حدّي يركز على التنفيذ. الدليل الأقوى على التقدم ليس الحركة الصغيرة من 60.9 إلى 61.2 مقابل GPT-5.6 Sol على مؤشر Artificial Analysis Intelligence؛ بل التحسن الأكبر بكثير في استخدام الحاسوب، والبرمجة الوكيلية، وسير العمل العلمي، واسترجاع السياق الطويل، وإكمال المهام المهنية، والأمن السيبراني. تمنح نافذة السياق 1.05M ومكدس الأدوات العميق المطورين مساحة أكبر لبناء وكلاء يظلون مفيدين لأكثر من استجابة واحدة.
المقايضة هي السعر. تسعير Standard $10/$50 ممتاز، وطلبات السياق الطويل تكلف أكثر، وتُظهر الاختبارات المستقلة أن Astra يمكن أن يكون أغلى بكثير من Sol في أعمال الذكاء العام. يكسب النموذج تلك العلاوة عندما تفوق معدلات الإكمال الأفضل والتصحيح البشري الأقل تكلفة الرموز. للأعمال الأبسط أو عالية الحجم، تظل GPT-5.6، وClaude Fable 5.1 وخصوصًا Gemini 3.8 Flash بدائل ذات صلة بدلًا من كونها سوابق متقادمة.