Hvad er GPT-Image-1.5 API'et?
GPT-Image-1.5 er det nyeste medlem af OpenAI’s GPT Image-familie og modellen bag ChatGPT’s forbedrede Images-oplevelse. Den er designet til at flytte billedgenerering fra eksperimentel novelty til produktionsklare kreative værktøjer: højere fotorealisme, finere kontrol til iterative redigeringer og hurtigere inferens, der understøtter interaktive og enterprise-workflows.
gpt-image-1.5 API'et er et multimodalt billedmodel-endpoint, der accepterer et eller flere billedinput (fil‑identifikatorer eller bytes) plus en tekstprompt og returnerer genererede eller redigerede billeder. Det understøtter:
- Tekst-til-billede-generering (opret ud fra prompt),
- Billedredigering / inpainting / komposition (anvend instruktioner på eksisterende billeder; flere billedinput tilladt), og
- Iterative, fleromgangsredigerings-workflows via Responses API (muliggør “tweak & iterate”-grænseflader).
API'et håndterer billedprompter anderledes end de gamle DALL·E‑begrænsninger: GPT-billedmodeller accepterer væsentligt længere tekstprompter (32k-tegn-retningslinjen), hvilket gør komplekse, constraint-tunge instruktioner mulige.
Hovedfunktioner (praktisk)
- Forbedret redigerbarhed / fleromgangskonsistens: bevarer karakterudseende, belysning og nøgleattributter på tværs af iterative redigeringer. Dette gør “samme model, gentagne redigeringer” mere pålideligt til workflows som produktkataloger eller brand‑assets.
- Hurtigere throughput — 4× hastighedsforbedringer over GPT Image 1, målrettet lavere latens i iterative kreative workflows.
- Omkostningsoptimeringer — omkostninger for billede input/output reduceret med cirka 20% vs. GPT Image 1, hvilket sænker omkostningen pr. billediteration for brugere med høj volumen.
- Multi-billede-komposition og stilreferencer — accepterer flere referencebilleder til at kompositere scener eller overføre stil/belysning.
- Kvalitet/fidelitetsknapper — API-parametre, der afvejer hastighed vs. fidelitet (brug lavere kvalitet til masseproduktion; højere kvalitet til produktions‑assets).
- Fleromgangsredigering / Responses API-integration — muliggør trinvise workflows (bed om ændringer, og “lav tweaks” med bevaring af state).
Tekniske muligheder
- Grænse for tekstprompt (billedmodeller): op til 32.000 tegn (bemærk: OpenAI dokumenterer dette som tekstlængdetilladelsen for GPT-billedmodeller). Brug dette til lange, constraint-tunge prompter.
- Billedinput: accepterer File IDs (foretrukket til fleromgangsflows) eller rå bytes; flere billeder kan leveres til komposition og reference.
- Outputs: PNG/JPEG eller platformens standard billedartefakter returneret af API'et (eller som vedhæftninger i ChatGPT). Output kan inkludere flere kandidatbilleder og understøtte iterative forespørgsler for at forfine et output.
- Genereringstilstande: tekst-til-billede, billedredigering (inpaint/udvid med instruktioner) og varianter. Fleromgangsredigering understøtter “tilføj/fjern/kombinér”-style instruktioner.
- Instruktionsbevist redigering: modellerne er optimeret til instruktionsfidelitet (bevaring af specificerede invarianter som “ændr ikke logoet”, “behold positur og lys”). Prompt-teknikker (eksplicitte invarianter gentaget i hver iteration) reducerer semantisk drift.
Benchmark-ydelse
- Leaderboard-placering: En samlet rapport nævner GPT Image 1.5 som førende i tekst-til-billede-rangeringer med ~1264 point på et Artificial Analysis‑leaderboard, foran den næste model med en målbar margin.
- Opgaveniveau-metrics (redigering og bevaring): et Microsoft Foundry‑resumé af evalueringsmetrics viser, at GPT-Image-1.5 opnår næsten perfekt binær modifikationssucces (100% på en enkeltomgangs BinaryEval) og stærke ansigtsbevaringsscore (omkring 90% på AuraFace‑målinger) i deres sammenligningstabel versus konkurrenter og tidligere OpenAI-modeller. Disse sammenlignende metrics placerer GPT-Image-1.5 foran nogle rivaler på bevaring og redigeringsfidelitet.
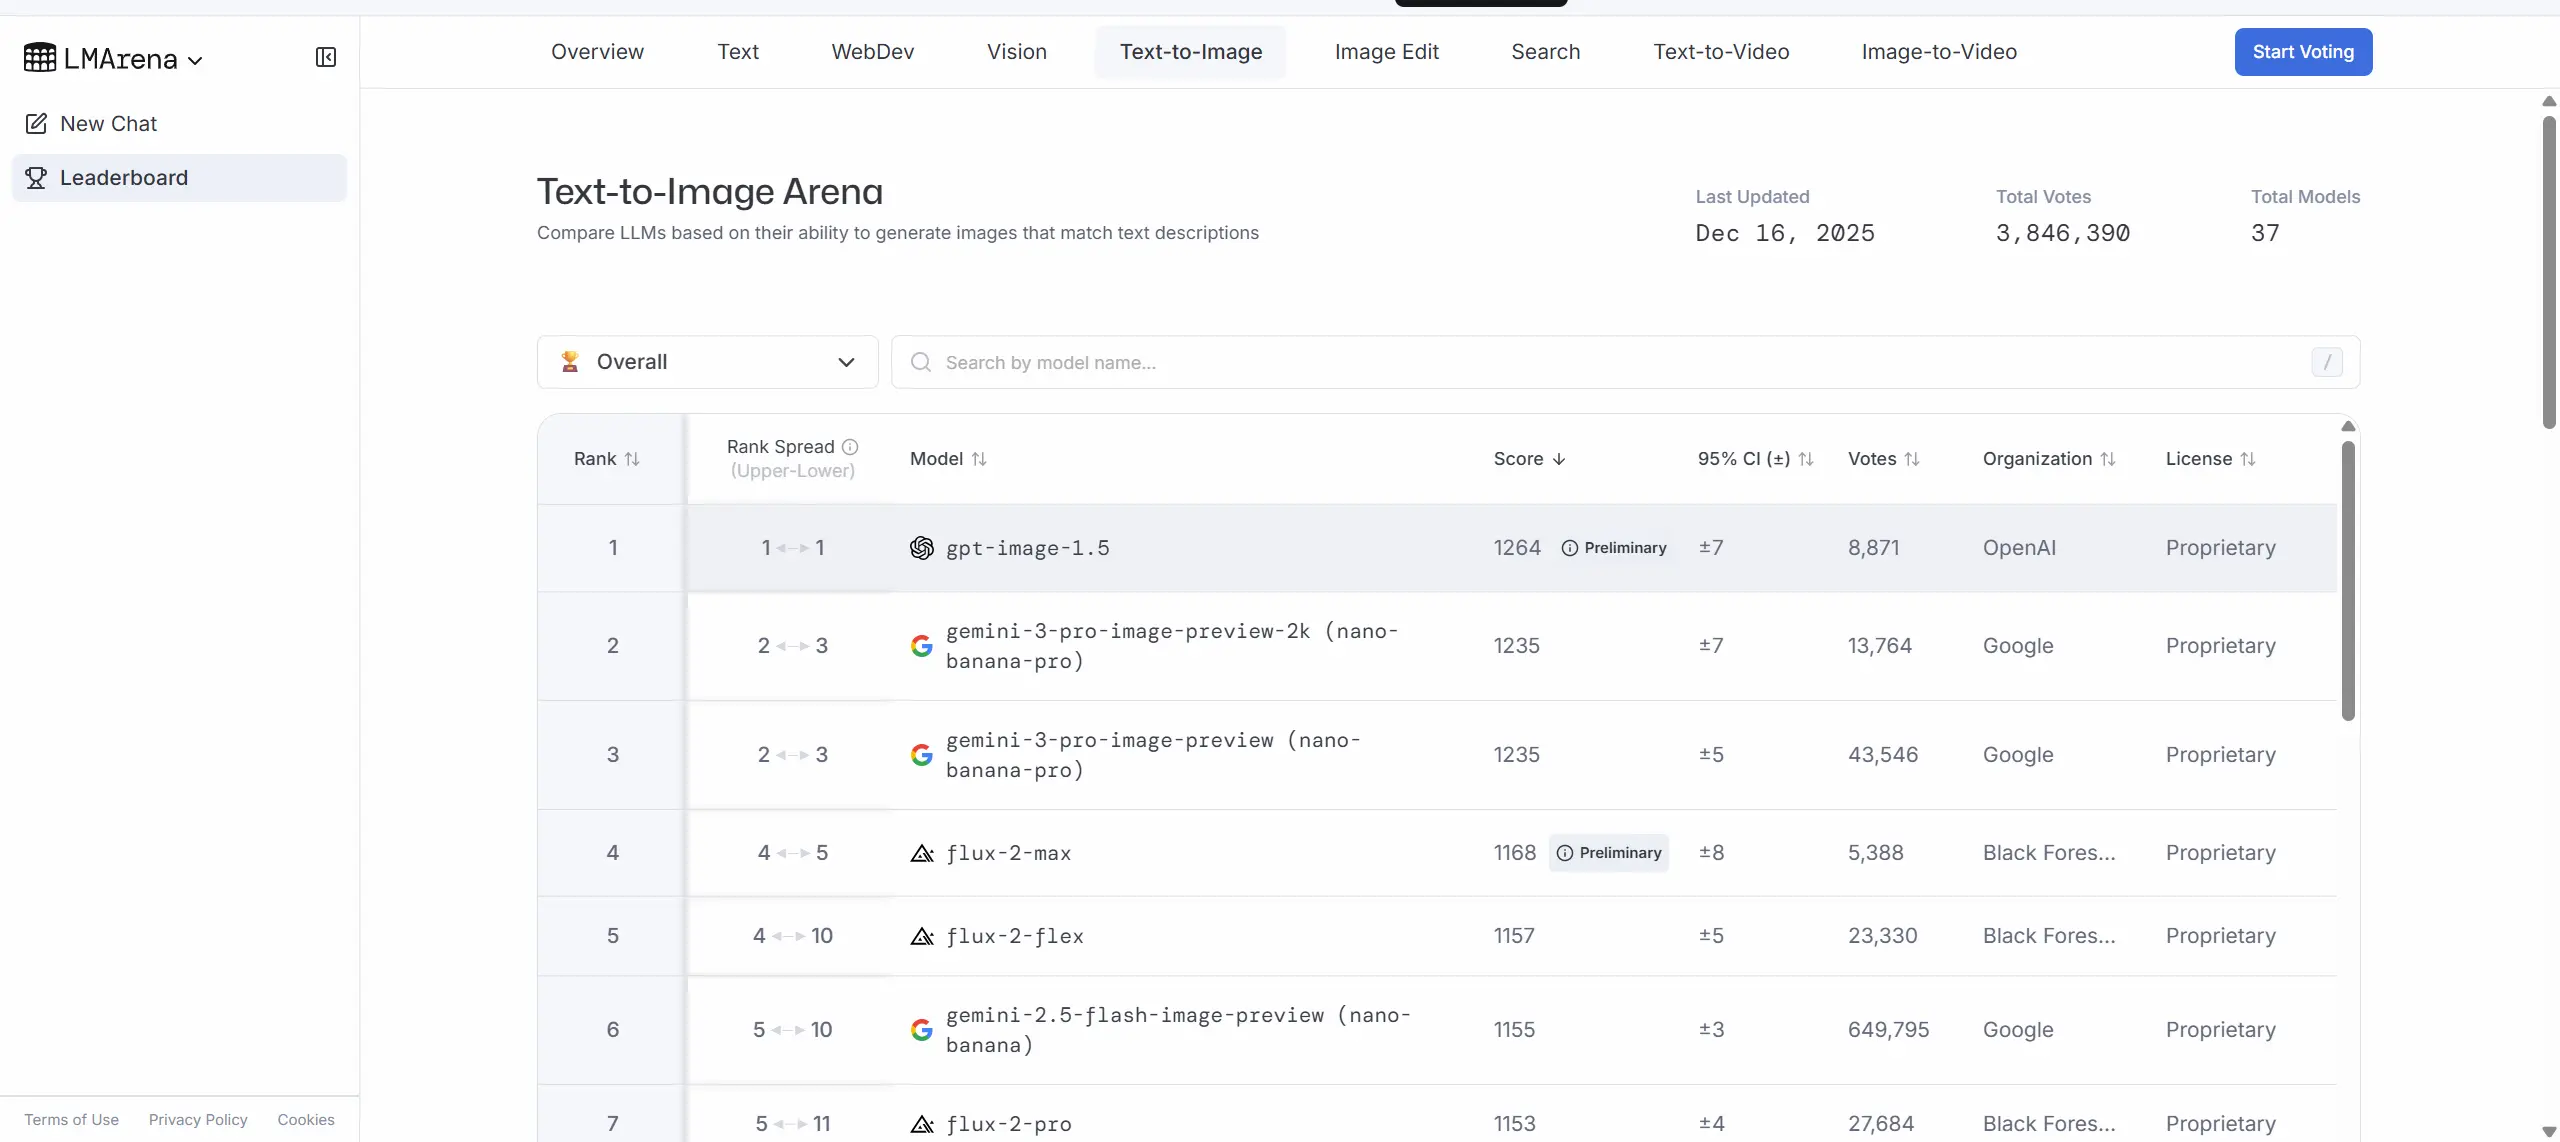
Hvordan GPT-Image-1.5 sammenlignes med jævnbyrdige
- Vs. GPT Image 1 (tidligere OpenAI-generation): hurtigere (op til 4×), billigere (~20% lavere billede‑IO‑omkostninger) og stærkere redigeringsfidelitet — målrettet flytningen fra “prototype/demo” til “produktionsvenlige” billed‑workflows.
- Vs. Google’s Nano Banana Pro / Gemini-billedmodeller: GPT-Image-1.5 og Google’s Nano Banana Pro / Gemini 3‑familie er nære rivaler — hver har styrker i forskellige promptklasser. OpenAI’s budskaber fremhæver redigeringsfidelitet og iterationshastighed; Google’s tilbud er blevet rost for studie‑niveau realisme i nogle eksempler.
- Vs. Qwen Image og andre åbne/lukkede modeller: GPT-Image-1.5 overgår Qwen Image på flere redigerings- og bevaringsmetrics i enkeltomgangsevalueringer, men forskelle udlignes i fleromgangs- eller andre domænespecifikke tests.
Hvor GPT-Image-1.5 er stærk
- E‑commerce produktbilleder: massevarianter, baggrundsudskiftning, konsistente produktkataloger fra ét foto (bevaring af brand/logo).
- Kreativ- og marketing‑asset‑produktion: hurtige konceptiterationer, fotorealistiske mockups, kontrollerede stilovertagelser.
- Fotoretouchering og redaktionelle workflows: realistiske tøj-/frisure‑try‑ons, selektiv retouchering, der bevarer identitet og belysning.
- Integration i designværktøjer: plug‑in til designplatforme eller CMS for on‑demand billedvarianter (fidelitetsknapper hjælper med omkostningskontrol).
- Flertrins kompositionspipelines: multi‑billedinput muliggør komposition og referencebaseret generering til komplekse scener.
Sådan får du adgang til GPT Image 1.5 API
Trin 1: Tilmeld dig for API‑nøgle
Log ind på cometapi.com. Hvis du endnu ikke er bruger, skal du registrere dig først. Log ind i din CometAPI‑konsol. Hent adgangslegitimationen API‑nøgle til interfacet. Klik på “Add Token” ved API‑token i personcentret, få token‑nøglen: sk-xxxxx og indsend.
Trin 2: Send forespørgsler til GPT Image 1.5 API
Vælg “gpt-image-1.5” endpointet for at sende API‑forespørgslen og angiv request‑body. Forespørgselsmetoden og request‑body fås fra vores websteds API‑dokumentation. Vores websted tilbyder også Apifox‑test for din bekvemmelighed. Erstat <YOUR_API_KEY> med din faktiske CometAPI‑nøgle fra din konto. basis‑URL er Billeder (https://api.cometapi.com/v1/images/generations) og [Billedredigering]
Indsæt dit spørgsmål eller din anmodning i content‑feltet — dette er det, modellen vil svare på. Behandl API‑svaret for at få det genererede svar.
Trin 3: Hent og verificér resultater
Behandl API‑svaret for at få det genererede svar. Efter behandlingen svarer API'et med opgavestatus og outputdata.
Se også Gemini 3 Pro Preview API